
כל כמה חודשים צץ מנתח HTML מהיר יותר, המדדים מסתובבים ברשת, ומישהו מכריז שהדור הישן כבר לא רלוונטי. ואז מגיע הרגע שבו צריך לבחור כל פסקה שמכילה מילה מסוימת, או לשלוף את ההורה של צומת תואם, ומבינים למה lxml עדיין פתוח בטאב השני.
lxml הוא binding בן 20 שנה ל-libxml2. הוא לא מלהיב. הוא לא חדש. אבל למשימה אחת מאוד ספציפית — כל דבר שדורש XPath אמיתי — כמעט שום דבר ב-Python המיינסטרימי לא באמת מתחרה בו. זו סקירה מעשית של מה הוא עושה, איפה הוא מנצח בשקט, ואילו שתיים-שלוש נקודות ברירת מחדל עלולות לעקוץ אם לא יודעים שהן שם.
lxml במשפט אחד: מה הוא בעצם
lxml הוא binding של Python לספריות C בשם libxml2 ו-libxslt. זהו פרסר ומסדר-פלט, לא סקרייפר ולא דפדפן — הוא ממיר markup לעץ שאפשר לשאול ולערוך, ואז מחזיר את העץ לבייטים. הוא מספק API תואם ל-ElementTree, מנוע מלא ל-XPath 1.0, תמיכה ב-XSLT 1.0, ואימות סכמות, ומתוחזק על ידי Stefan Behnel תחת הסלוגן "the most feature-rich and easy-to-use library for processing XML and HTML in the Python language".
כך הוא נראה נכון ל-snapshot שנמשך מ-GitHub ו-PyPI בתאריך 2026-07-14:
| שדה | ערך |
|---|---|
| מאגר | lxml/lxml |
| כוכבים | 3,043 |
| Forks | 620 |
| בעיות פתוחות | 16 |
| רישיון | BSD-3-Clause |
| נוצר | 2011-02-11 |
| דחיפה אחרונה | 2026-07-02 |
| גרסה יציבה ב-PyPI | 6.1.1 (2026-05-18) |
| מנוע כלול | libxml2 2.14.6 + libxslt 1.1.43 |
דבר אחד שחשוב להבהיר כבר עכשיו, לפני שמישהו יאשים אותי בהייפ: אין כאן שום סודות. lxml ותיק מספיק כדי שכל התנהגות שמתוארת כאן כבר מופיעה איפשהו ב-תיעוד של lxml, ביומן שינויים של libxml2, או בדיון ב-launchpad. לא מצאתי טריק בלעדי ולא מתועד, ואין בכוונתי להמציא אחד. הערך של מה שמופיע בהמשך הוא בסידור שיטתי, כימות, וארגון סביב lxml כנושא — לא בזה שזו ידיעה חדשה.
סביבת הבדיקה (ולמה מספרי הזמנים מושאלים)
שתי קטגוריות של נתונים נכנסות לביקורת הזו, והן מגיעות משני מקורות שונים, אז חשוב להיות גלוי לגבי מה הגיע מאיפה.
בדיקות היכולות — התנהגות XPath, שני ממשקי הפרסר, namespaces, קידוד, מחזור חיים של צמתים — הורצו מחדש על מכונה אחת: macOS arm64, Python 3.14.2, lxml 6.1.1, libxml2 2.14.6. כל מספר בקובצי artifacts/raw/*.json חושב על ידי הרצה של סקריפט, לא נכתב ידנית. בדיקות יכולת הן בוליאנים ו-enums דטרמיניסטיים, ולכן ריצה יחידה יציבה — עומס מכונה לא משנה אם //a/@href מחזיר מחרוזת של מאפיין.
מספרי הזמן ושטח הזיכרון אינם מתוך החבילה הזו. הם מושאלים כפי שהם מחבילת הבנצ'מרק הקודמת של selectolax — אותה מכונה, אותה סביבה וירטואלית, אותו build של lxml ו-libxml2, בנצ'מרקים נכון ל-2026-07-13 — ולא הרצתי אותם מחדש כאן. זה מכוון. הרצת בנצ'מרקים של זמן יחד עם אצווה של סקריפטי יכולת עלולה ליצור תחרות על CPU שתזהם את המספרים המושאלים, ובנוסף זו גם עבודה כפולה: lxml כבר שימש שם כספריית בקרה שנמדדה במלואה. שימוש חוזר באותם נתוני בנץ' שומר על השוואה בין תפוחים לתפוחים, במקום להכניס מדידה שנייה, מעט שונה. לכן כשאתם רואים למטה מספר במילישניות, קראו אותו כ-"אותו מערך בדיקה, נכון ל-2026-07-13", לא כ-"מדדתי את זה היום מחדש."
לממצאים יש תגית אמון: single-observation לבדיקות היכולת הדטרמיניסטיות, triple-run להתפלגויות הזמן המושאלות, ו-hypothesis כשאני מציע מנגנון שלא בידדתי.
XPath: הדבר האחד שאין ל-selectolax ול-BeautifulSoup
זה הכותרת הראשית, אז אתחיל כאן.
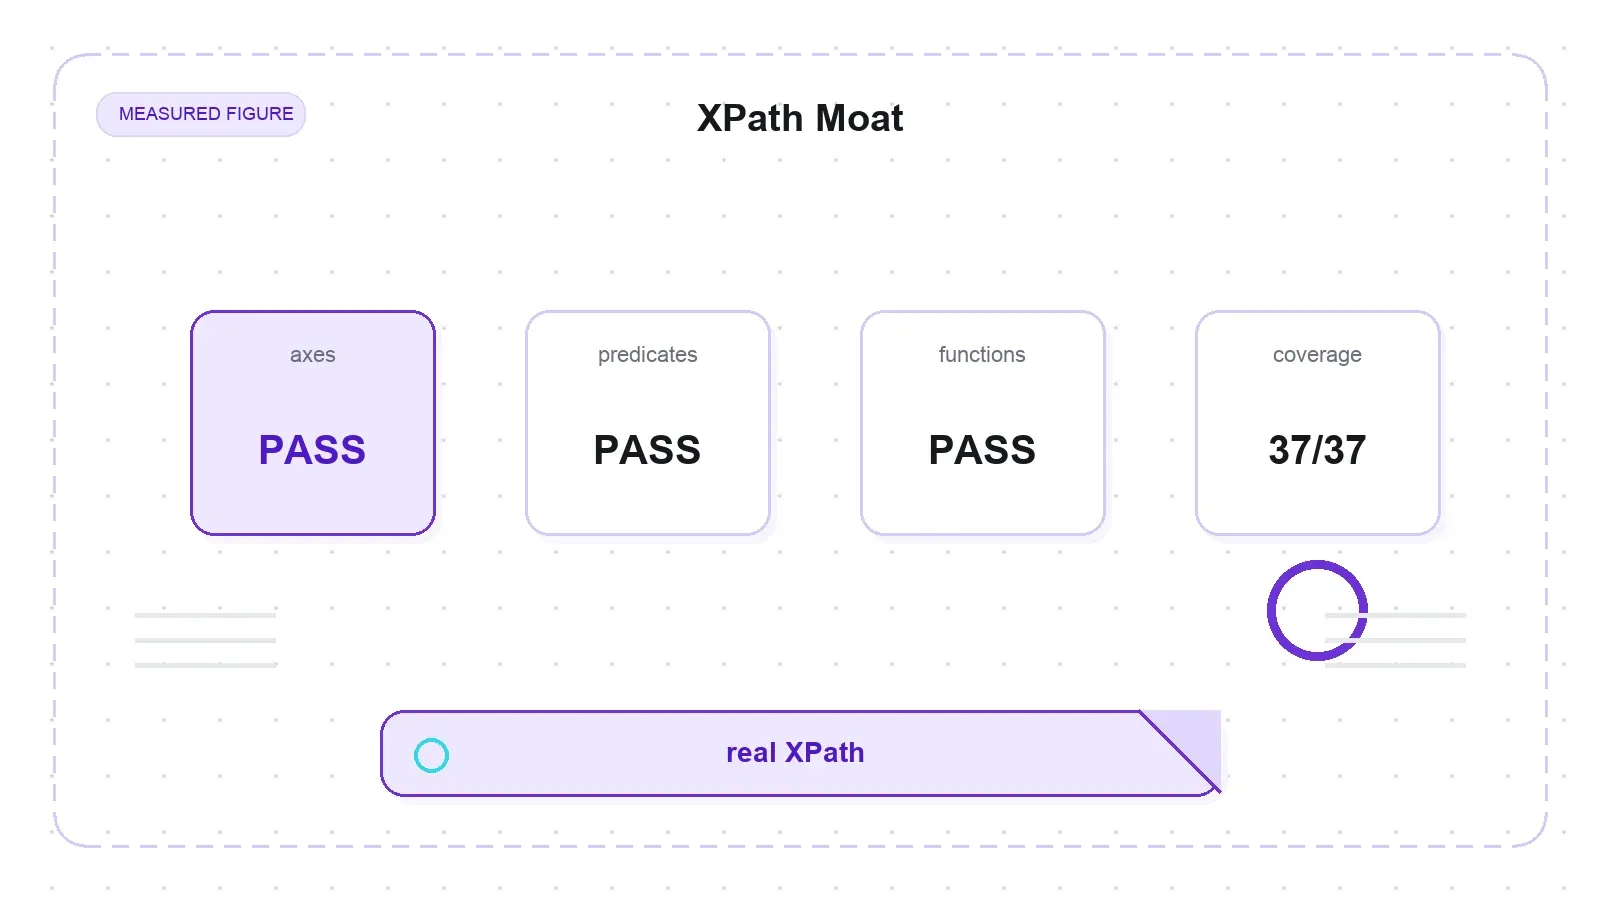
הרצתי את xpath() של lxml דרך מטריצה של 37 פריטים שנרשמה מראש — התוצאה הצפויה לכל מקרה נכתבה בקוד לפני שהבדיקה הופעלה, כך שלא יכולתי בטעות לתת ניקוד נדיב. עשרה axes, תשעה סגנונות predicates, עשרה functions מובנים, שלושה סוגי החזרה סקלריים, וחמישה מקרי מלכודת מכוונים באמצעות תחביר XPath 2.0 בלבד, שאותו מנוע 1.0 של lxml אמור לדחות.
| קטגוריה | כיסוי | תוצאה |
|---|---|---|
| Axes | child / descendant / parent / ancestor / following-sibling / preceding-sibling / self / attribute / following / preceding | 10/10 עברו |
| Predicates | [1] / last() / position()<n / השוואת מאפיינים / קיום מאפיין / and / or / nested [.//a] / not() | 9/9 עברו |
| Functions | text() / contains() / starts-with() / count() / string-length() / normalize-space() / concat() / substring() / name() / string() | 10/10 עברו |
| סוגי החזרה | boolean / number scalars | 3/3 עברו |
| מקרי מלכודת | matches() / sequences / if-then-else / except / שגיאת תחביר | 5/5 נדחו כראוי |
הציון הוא 37/37, והעמודה של המלכודות היא החלק החשוב. matches(), ביטויי sequence, if/then/else, ו-except הם כולם תחביר XPath 2.0, ומנוע 1.0 של libxml2 לא תומך בהם חלקית — הוא מרים XPathEvalError ומסרב, במקום להחזיר בשקט סט צמתים שגוי. כלומר זה ציון מושלם אחרי ניסיון לשבור את המערכת, לא ציון מושלם שנבנה משאלות קלות. כל התנהגות כאן תואמת בדיוק למה ש-תיעוד XPath של lxml מתאר, וזוהי בדיוק הנקודה.
אודה על טעות אחת שההרצה גילתה, כי זו הגרסה של "37/37" שאפשר באמת לסמוך עליה. קבוצת התוצאות הצפויה הראשונה שלי עבור //div[.//a[@href]] ניבאה שתי התאמות; בפועל התקבלה אחת. הנחתי ש-lxml טועה בערך שלושים שניות, ואז בדקתי את ה-fixture וגיליתי שהאלמנט השני היה <footer>, לא <div> — כלומר ההנחה שלי הייתה שגויה, לא המנוע. תיקנתי את קבוצת התוצאות הצפויה והשארתי את הטעות כהערת קוד. זה סדר האשמה הנכון: קודם לחשוד בבדיקה שלך, ורק אחר כך בספריית C ותיקה בת 20 שנה.
XPath מול CSS: מה פשוט אי אפשר לבטא ב-CSS
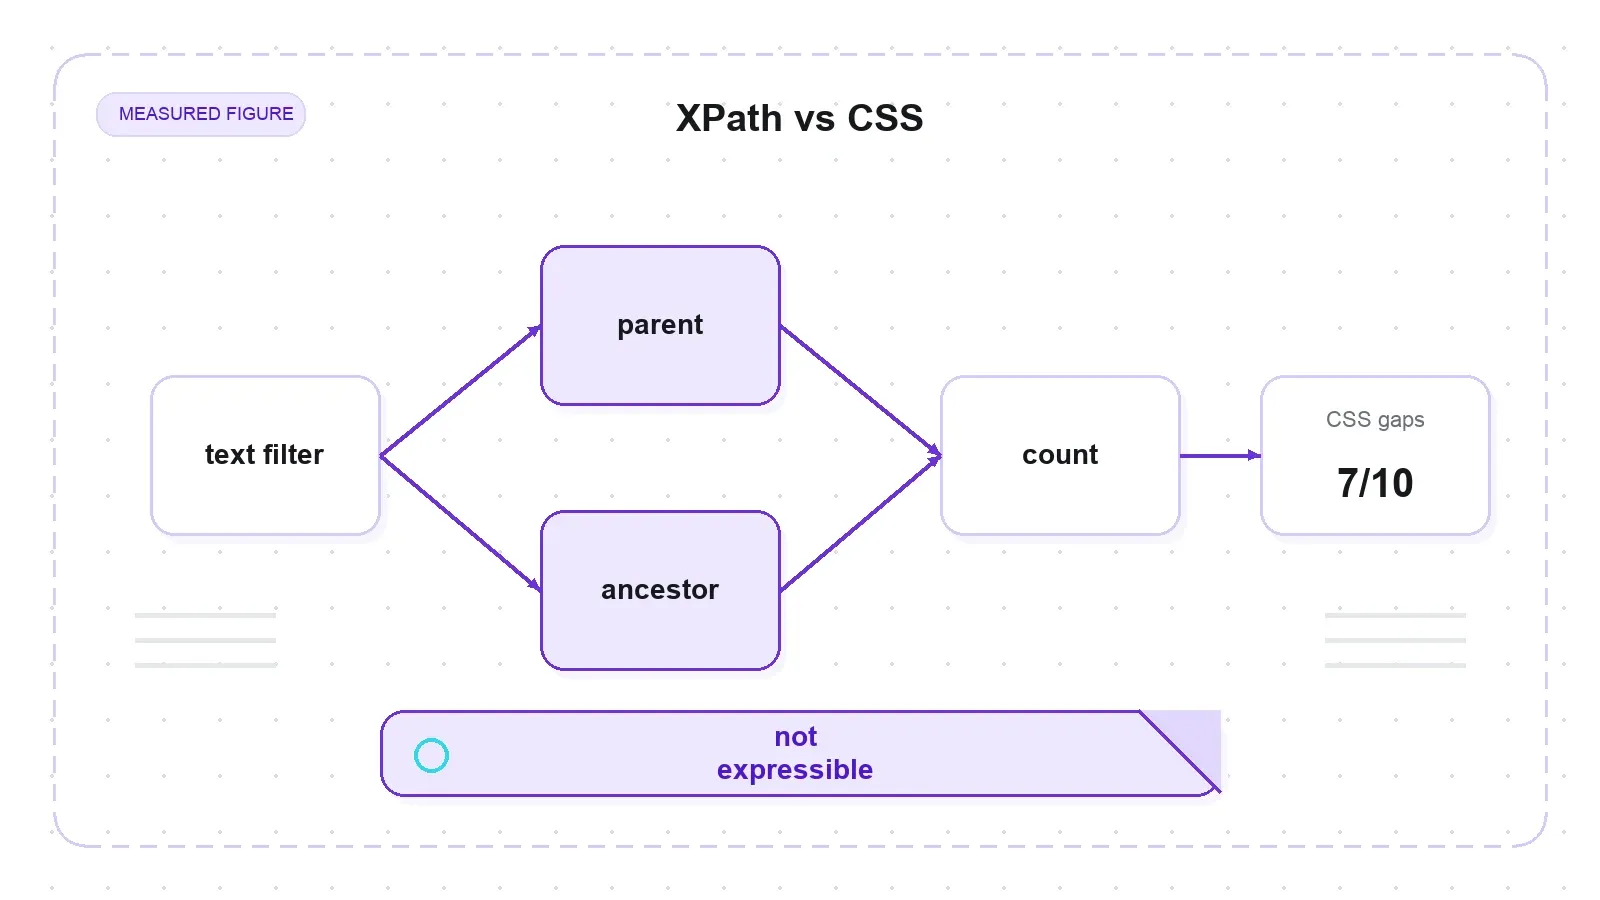
הטענה המופשטת ש-"XPath חזק יותר" ראויה למספר קונקרטי, אז כימותי את הפער. lxml נותן גם .xpath() וגם .cssselect() (האחרון מתרגם CSS ל-XPath מאחורי הקלעים). לקחתי עשר מטרות בחירה ובדקתי אילו מהן CSS באמת יודע לנסח.
| מטרה | XPath | CSS (cssselect) |
|---|---|---|
סינון לפי תוכן טקסט (contains(text(),"bargain")) | כן | אין predicate לטקסט |
בחירת הורה מתוך ילד (//b/parent::p) | כן | אין selector להורה |
החזרת ערך מאפיין (//a/@href) | כן | רק elements |
החזרת text node (//p/text()) | כן | אין text nodes |
ancestor axis (//td/ancestor::div) | כן | אין ניווט כלפי מעלה |
סינון הורה לפי ספירת ילדים (//ul[count(li)=4]) | כן | אין count predicate |
סינון לפי אורך טקסט (string-length(text())>5) | כן | אין length predicate |
nth-child / last-child / sibling סמוך | כן | כן (3 בסיסיים) |
לשבע מתוך עשר המטרות אין כלל מקבילה ב-CSS. סינון לפי תוכן טקסט, ניווט כלפי מעלה להורים ולאבות-קדומים, שליפת ערך מאפיין או text node גולמי כתוצאה, predicates על בסיס ספירה — CSS פשוט לא מסוגל לבטא את זה. רק שלוש (nth-child, last-child, ו-sibling סמוך) עובדות בשתיהן. זו התשובה הכמותית לשאלה "מה אני באמת מרוויח כשאני בוחר ב-lxml". selectolax הוא CSS-only ואין לו בכלל xpath(), כך שסוגי השאילתות הללו שם הופכים ללולאות Python מרובות שלבים או פשוט לא מתבצעים. אם הלוגיקה של הסקרייפינג שלכם נשענת על אחד מהם, זו כבר ההחלטה שלכם.
(וכן, ההרצה תפסה אותי בפעם השנייה כאן: ניבאתי סט ריק עבור string-length(text())>5, אבל שתי מחרוזות באורך שש תווים התאימו. תיקנתי את הציפייה, לא את הכלי.)
שלושה מצבי קשיחות: etree מול recover מול lxml.html
XPath היא הסיבה לבחור ב-lxml. שלושת מצבי הקשיחות הם הסיבה להמשיך להשתמש בו.
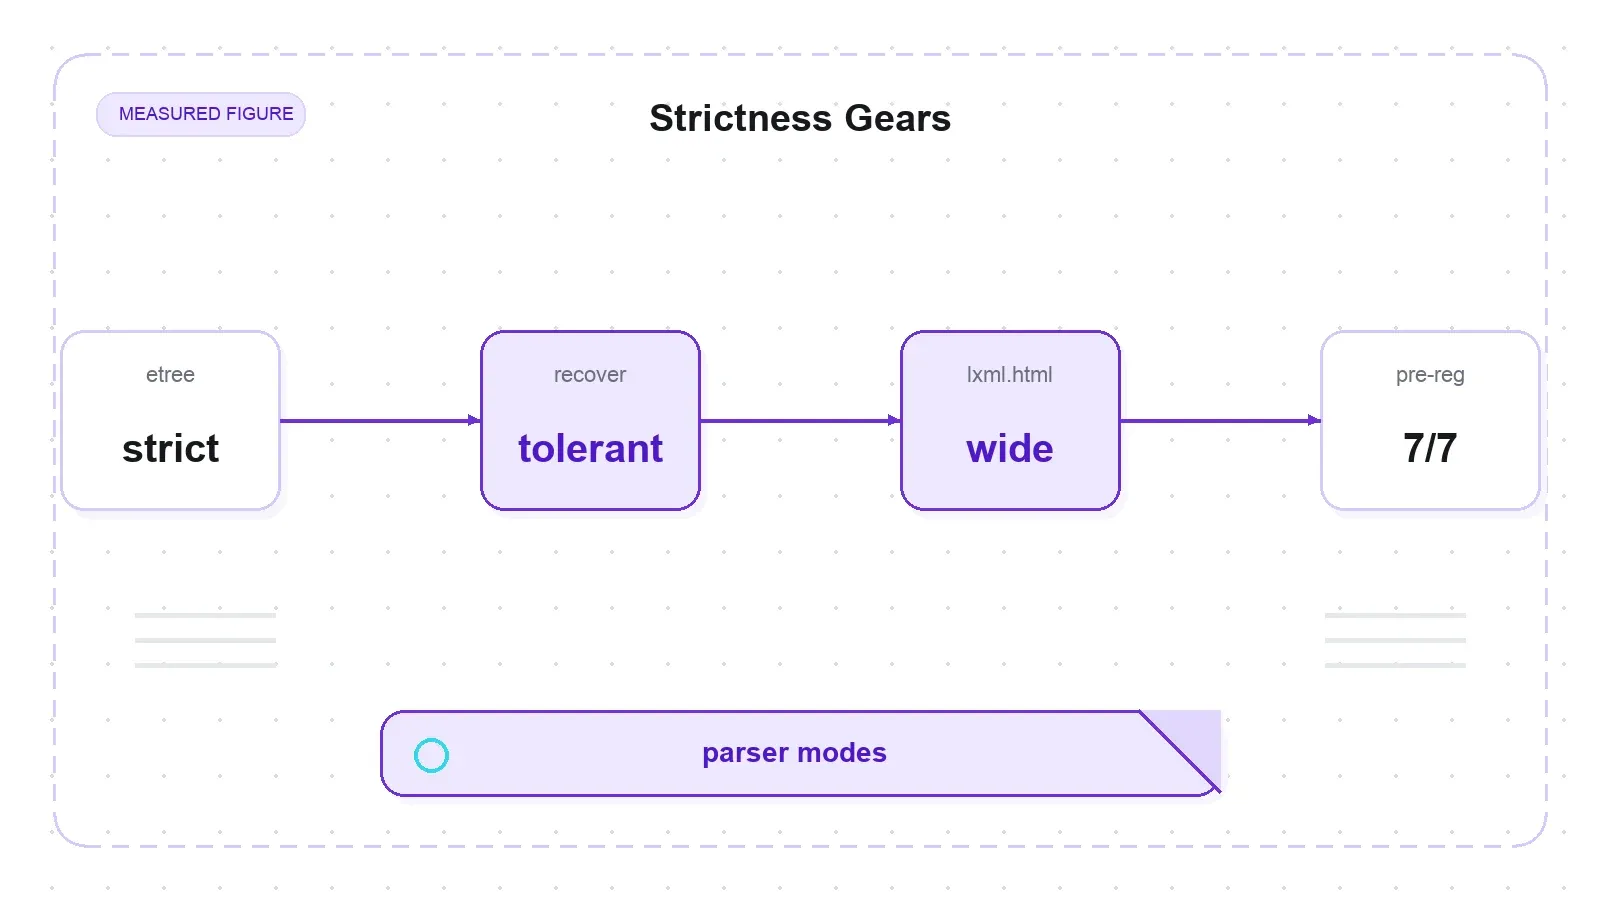
רוב הפרסרים נותנים התנהגות אחת עבור קלט שבור. lxml נותן שלוש, והן צפויות מספיק כך שהרצתי שש מחלקות של markup פגום דרך כל אחת מהן ורשמתי מראש איך כל מסלול אמור להתנהג.
| קלט פגום | lxml.etree (strict) | etree + recover=True | lxml.html (lenient) |
|---|---|---|---|
תג לא סגור <root><a>x</root> | זורק שגיאה | משחזר | מקבל |
קינון שגוי <b><i></b></i> | זורק שגיאה | משחזר | מקבל |
ישות לא מוגדרת | זורק שגיאה | משחזר | מקבל |
אמפרסנד בודד & (Tom & Jerry) | זורק שגיאה | משחזר | מקבל |
כמה שורשים <a>1</a><b>2</b> | זורק שגיאה | משחזר | מקבל |
| XML תקין | מקבל | מקבל (0 errors) | מקבל |
מאפיין בוליאני <input disabled> | זורק שגיאה | משחזר | מקבל |
שבעה מתוך שבעה התאימו לציפייה שנרשמה מראש. lxml.etree מרים XMLSyntaxError על כל שש המחלקות הפגומות. הוספת recover=True לאותו פרסר גורמת לו לבלוע את השגיאות ולבנות עץ שמיש — וזה החלק הלא מוערך מספיק — ואז parser.error_log מפרט את כל השגיאות שנבלעו. lxml.html מקבל הכול בלי תלונה.
המסווג שקובע "נזרק / שוחזר / התקבל" מונע בעצמו על ידי אורך error_log בזמן הריצה, ולא באופן קשיח, ולכן מסמך תקין שמורץ תחת recover=True מסומן נכון כ-"accepts" (יומן ריק) ולא כ-"recovers". הגרסה הראשונה שלי לסיווג הזה סימנה כל תוצאה של recover=True כ-"recovers" וסיווגה לא נכון קלט נקי; קריאת error_log בפועל תיקנה זאת.
מה זה נותן בפועל: אם יש לכם feed שבור שצריך להיכשל בקול, השתמשו ב-lxml.etree. אם מדובר ב-HTML מלוכלך מהעולם האמיתי שרק צריך לשרוד, השתמשו ב-lxml.html. והאמצע שרוב הכלים לא יודעים לעשות — "להיות סלחני, אבל להגיד לי בדיוק מה היה שבור כדי שאוכל לרשום לוג" — דורש recover=True וקריאה של ה-error log. ל-selectolax יש את המצב הסלחני בלבד, בלי strict mode ובלי error log.
iterparse: מצב הסטרימינג שאין בכלל ל-selectolax
זו שורת יכולת, לא כפתור מהירות. selectolax בולע מחרוזת שלמה בלבד — אין לו ממשק הדרגתי. iterparse של lxml מחזיר אלמנטים כשהם נסגרים, ובשילוב עם תבנית fast_iter הקלאסית (קריאה ל-elem.clear() ומחיקת האחים הקודמים תוך כדי) הוא שומר על זיכרון שטוח בלי קשר לגודל המסמך.
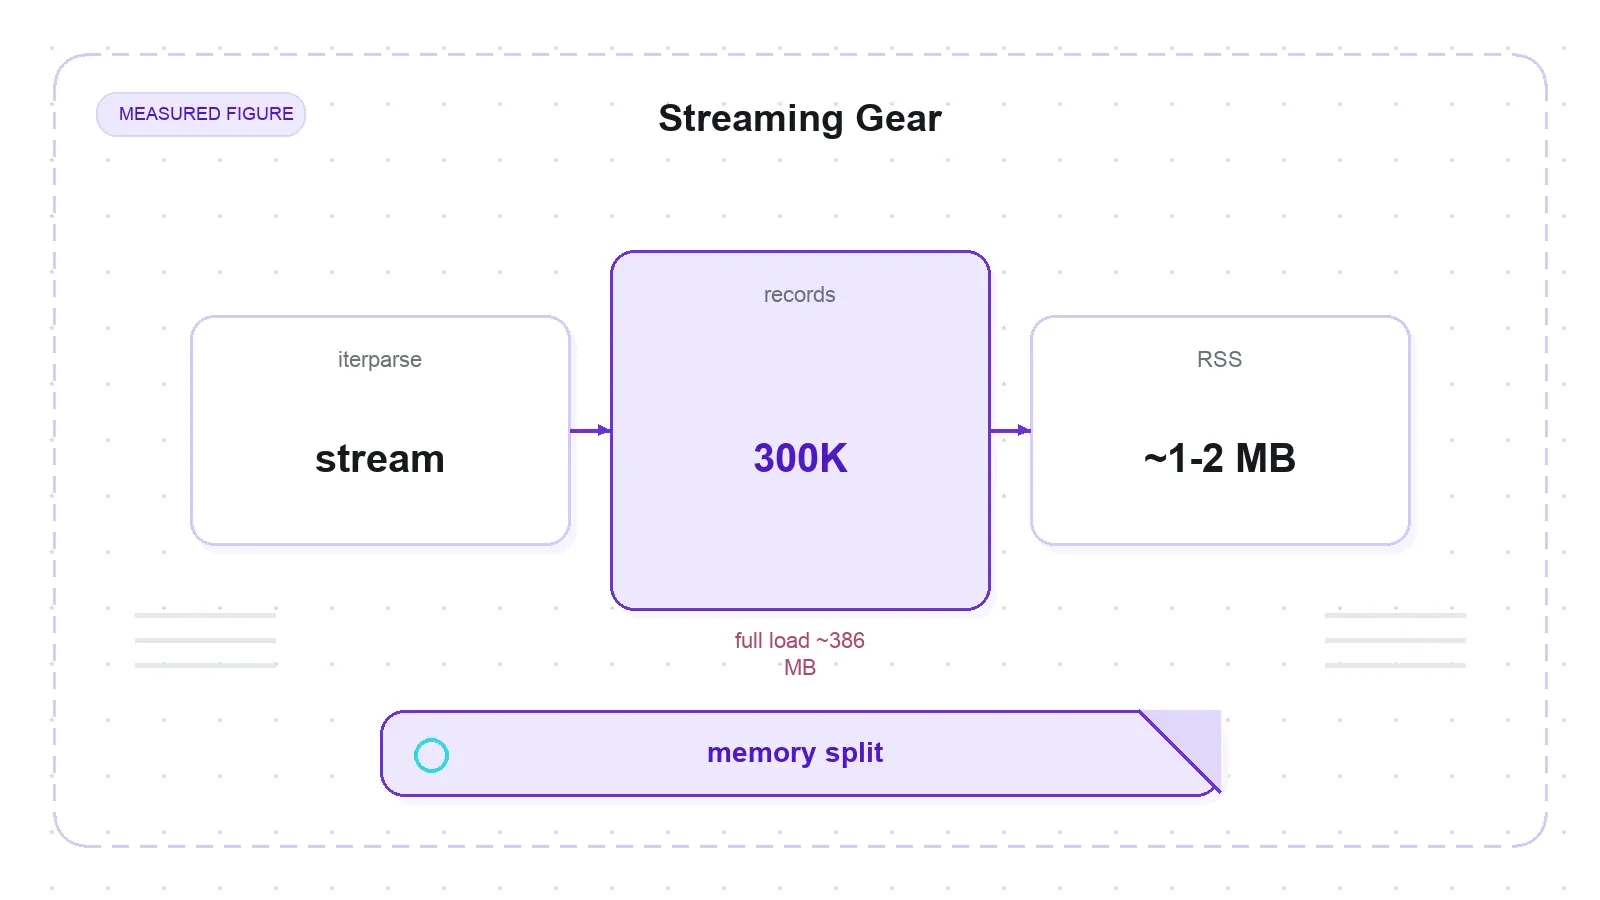
מדדתי את מאפיין הזיכרון ישירות — peak RSS באמצעות ru_maxrss, כל נבדק בתהליך טרי משלו, על 300,000 אלמנטים מסוג <record> במשקל כולל של כ-26.7 MB (26,744,801 bytes).
| מצב | שינוי שיא RSS | הערות |
|---|---|---|
iterparse + clear (fast_iter) | ~1-2 MB | משתחרר תוך כדי; שטוח בלי קשר לכמות |
iterparse בלי clear | ~386 MB | שומר references; כבד כמו טעינה מלאה |
etree.parse (טעינה מלאה, עוגן) | ~386 MB | כבד ידוע; מוכיח שהמדד קולט סדר גודל |
המצב המוגבל מחזיק את שינוי שיא ה-RSS בערך על 1-2 MB מול כ-386 MB בטעינה מלאה — פער סדר גודל של 0.3-0.4% — והאירוע של הרשומה הראשונה קופץ עוד לפני שהקובץ סיים להיקרא, כך שזה באמת סטרימינג הדרגתי ולא הצגה מזויפת. הקו המלמד הוא האמצעי. הריצו את אותה לולאת iterparse אבל דלגו על clear(), והזיכרון מיד מטפס שוב לכ-386 MB, כי אתם מחזיקים references לכל דבר. הניצחון יושב ב-clear(), לא ב-iterparse לבדו. עוגן הטעינה המלאה הגבוה משמעותית גם מאשר שה-RSS meter באמת רואה את הפער בסדרי הגודל ולא קורא באפלה. (מבחן הזיכרון הזה כן הורץ בחבילה הזו — זו מדידת footprint, נפרדת ממספרי הזמן המושאלים.)
הגרסה בעולם האמיתי: ייצוא XML רב-ג'יגה שלא נכנס ל-RAM פשוט לא קיבל מסלול ב-selectolax. זה lxml עם parser זורם, או שפה אחרת.
Namespaces: RSS, SVG, ומלכודת ה-default namespace
תריסר מקרי namespace, כולל RSS על פני שלושה namespaces, SVG עם default namespace ו-xlink, ו-XML עם default namespace. כולם עברו.
lxml שולף //dc:creator/text() מפיד RSS בדיוק כ-["Alice", "Bob"], פותר //atom:link/@href ו-//content:encoded על פני שלושה namespaces נפרדים באותו מסמך, מטפל ב-//s:rect ו-//s:use/@xlink:href ב-namespace השני של SVG, מחלק שמות בסגנון Clark notation {uri}local באמצעות QName, ומספק introspection דרך nsmap. זו ההתנהגות המתוחזקת והממוסמכת, וזה ממד שלם ש-selectolax בכלל לא נוגע בו, כי selectolax הוא HTML5-only ולא מעבד XML namespaces שרירותיים.
יש מלכודת אחת מתועדת שכדאי לזכור בעל פה. ל-XPath אין מושג של default namespace. אם מצביעים //book על מסמך שמצהיר xmlns="urn:...", מתקבל אפס פגיעות — prefix ריק לא מוגדר ב-XPath, כפי שמוסבר ב-תיעוד של lxml. צריך לקשור prefix מלאכותי (//c:book עם namespaces={"c": "urn:..."}, וזה מצא את שלושת הפריטים) או לחזור ל-//*[local-name()='book'] (גם שלושה). זו לא תקלה — זה ה-XPath spec, ממומש נאמנה. פשוט כולם מופתעים מזה פעם אחת.
דפי אינטרנט מלוכלכים באמת: דיוק על 11 סקרייפים אמיתיים
בדיקות סינתטיות הן נקיות; האינטרנט לא. השתמשתי מחדש באחד-עשר דפים אמיתיים שנלכדו מתוך סט ה-fixtures של חבילת selectolax (נכון ל-2026-07-10, לקריאה בלבד) והרצתי עליהם את lxml.html עם lxml כנושא.
| Fixture | גודל | קישורים | שגיאות libxml2 ששוחזרו | XML strict |
|---|---|---|---|---|
| news_bbc.html | 398 KB | 255 | 4 | ok |
| docs_mdn_array.html | 243 KB | 508 | 0 | raised |
| wiki_scraping.html | 227 KB | 460 | 0 | raised |
| gov_whitehouse.html | 289 KB | 154 | 0 | raised |
| oldstyle_craigslist.html | 561 KB | 351 | 0 | raised |
| forum_reddit.html | 129 KB | 318 | 0 | raised |
| docs_python.html | 80 KB | 341 | 2 | raised |
| ecommerce_books.html | 51 KB | 94 | 0 | raised |
| news_hackernews.html | 35 KB | 229 | 0 | raised |
| ecommerce_webscraper_allinone.html | 16 KB | 35 | 0 | raised |
| spa_quotes_js.html | 6 KB | 5 | 0 | raised |
כל אחד מ-11 המסמכים נפרס בהצלחה באמצעות lxml.html, ומספרי הקישורים, הכותרות והתמונות התאימו בדיוק למספרי lxml המושאלים מחבילת selectolax בכל אחד מ-11 המקרים — cross-check true. ההסכמה הזו היא מה שאומר לי שהשימוש החוזר הוא באמת תפוחים-לתפוחים ולא שתי מדידות שונות עם אותה תווית.
הממצא המשני: הפרסר המחמיר של XML נפל על עשרה מתוך אחד-עשר העמודים. דפי אינטרנט אמיתיים הם ברובם המכריע לא XML תקין, וזו בדיוק הסיבה שמצב ה-recovery של libxml2 קיים — כדי לבלוע אותם. החריג היחיד היה BBC News, שנבנה ב-Next.js והיה תקין מספיק כדי לשרוד XML strict. לא כל מה שמסומן "HTML" צריך את מסלול השחזור.
עוד הערת ספירה שקל להיתקל בה. ב-docs_python.html, //a[@href] (קיום מאפיין) ספר 343, בעוד שחבילת selectolax ספרה 341 באמצעות if n.get("href") (ערך אמיתי/לא ריק). שתי ההתאמות הנוספות הן קישורי href="" ריקים. זה הבדל בין מוסכמת ספירה — מאפיין קיים מול מאפיין שאינו ריק — ולא הבדל בהתנהגות של lxml, והמספרים מסתדרים ברגע שמיישרים את ה-predicate. חשוב לדעת את זה כשמגרדים נתונים: השאלה אם href ריק נספר היא בחירה של הפילטר שלכם, לא של הפרסר.
מגבלת העומק שנראית כמו באג (אבל לא)
בחבילת selectolax נרשם ש-lxml מאבד את התוכן העמוק ביותר ב-markup מקונן של 1,000 ו-5,000 רמות <div>, והדבר הוצג כ-"lxml silently loses the deepest content." רציתי להבין את המנגנון, אז הרצתִי את הפרסר ברירת המחדל מול huge_tree=True.
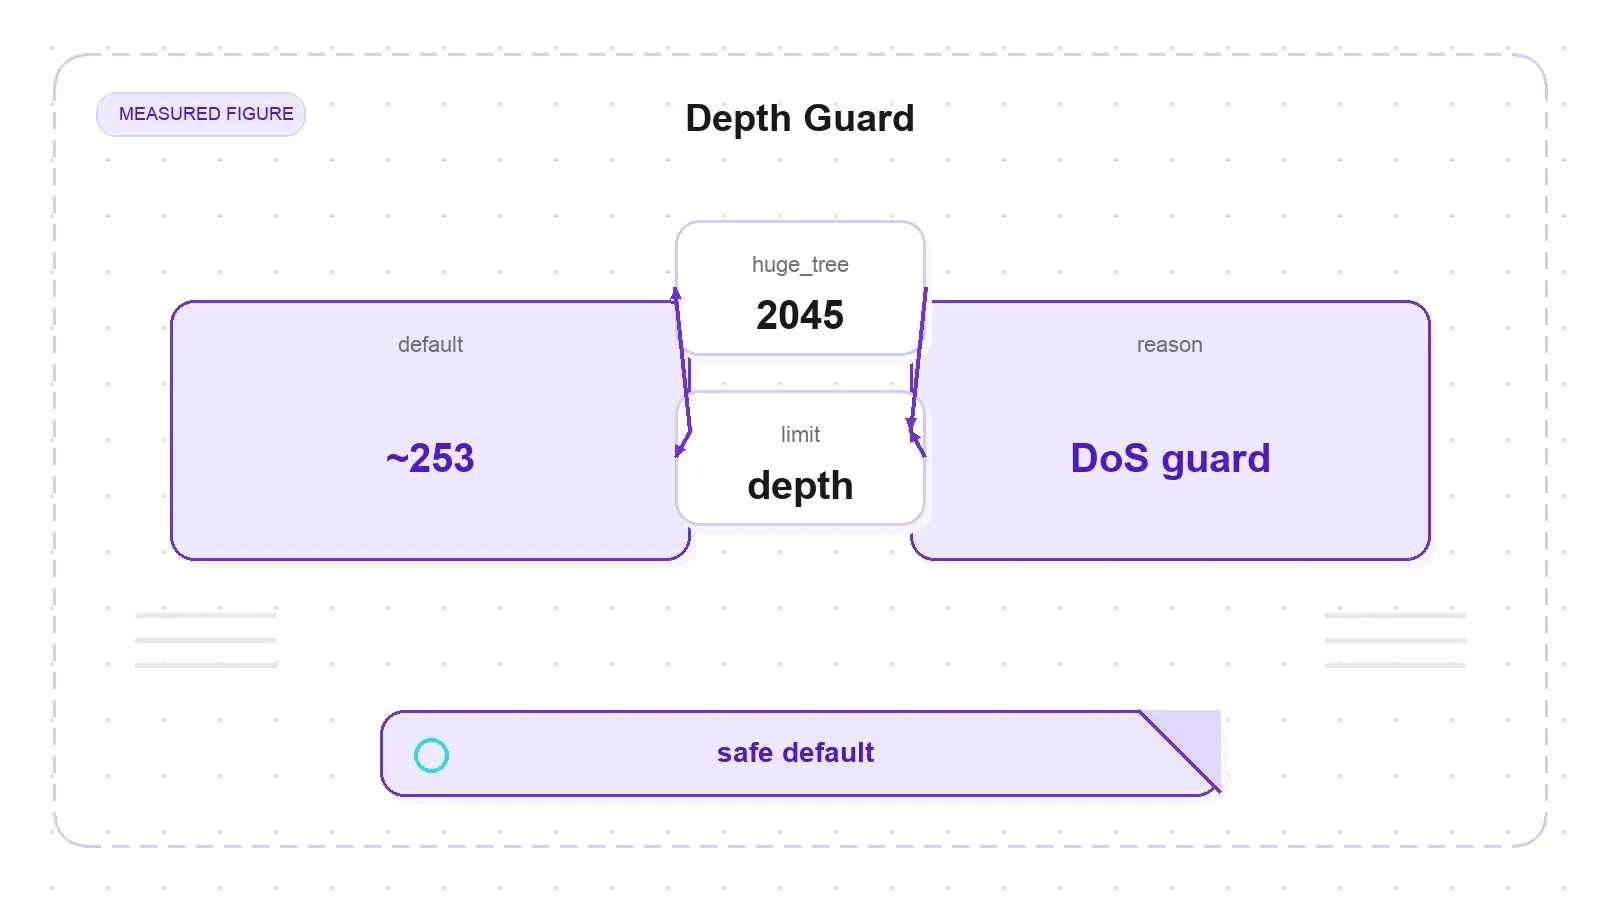
| עומק מבוקש | פרסר ברירת המחדל מגיע ל | huge_tree=True מגיע ל |
|---|---|---|
| 300 | 253 (שאר העץ נחתך) | 299 (שוחזר) |
| 1000 | 253 (שאר העץ נחתך) | 999 (שוחזר) |
| 5000 | 253 (שאר העץ נחתך) | 2045 (עדיין נחתך) |
פרסר ברירת המחדל קוטע בערך ב-253 רמות וזורק בשקט כל מה שמעבר. זו לא תקלה — זו הגנת DoS של libxml2, תקרת קינון של בערך 256 רמות שנועדה למנוע ממסמך עוין לשבור את ה-stack, והיא מתועדת ב-שרשור ה-launchpad של lxml על XML_PARSE_HUGE. הגדירו huge_tree=True ועומקים של 300 ו-1,000 חוזרים במלואם. אבל בעומק 5,000 מגיעים רק ל-2,045 גם עם huge_tree פעיל — יש תקרת רקורסיה שנייה וקשה יותר ב-libxml2, מעל זו שניתנת להגדרה, ו-huge_tree לא מבטל אותה.
לכן פעולת ההמשך ברורה: כשאתם מנתחים markup עמוק ממקור שאתם סומכים עליו, השתמשו ב-lxml.html.HTMLParser(huge_tree=True). מה שהחבילה הזו מוסיפה מעל התצפית המושאלת הוא המנגנון (תקרת בטיחות, לא שחיתות נתונים), התיקון (huge_tree), והעובדה שיש תקרה שנייה שהתיקון לא מגיע אליה.
DOM לקריאה/כתיבה, Serialization, Encoding
lxml הוא עץ מלא לקריאה/כתיבה, לא חולץ מידע לקריאה בלבד, ואימתתי את משטח העריכה מקרה אחר מקרה. כל שמונה פעולות ה-DOM עברו: SubElement, insert, remove, replace, strip_tags (הסרת תגיות תוך שמירת הטקסט שלהן), strip_elements (הסרת תגיות וגם הטקסט שלהן), drop_tree (ייחודי ל-lxml.html), ומודל ה-text/tail הכפול שמבלבל מתחילים — ב-<p>head<b>bold</b>tail</p>, הערך p.text הוא "head", הערך b.text הוא "bold", ו-b.tail הוא "tail".
ה-serialization עבר חמש מתוך חמש: tostring במצב XML ובמצב HTML (ב-HTML אלמנטי void נשארים ללא self-closing), pretty_print, קנוניקליזציה C14N (method="c14n", עוד בלעדי ל-lxml), ו-round-trip נקי.
ה-encoding הוא המקום שבו lxml נבדל בשקט. הזינו לו בייטים שאינם UTF-8 — "<p>café éè</p>".encode("latin-1") דרך lxml.html.fromstring — והוא שחזר את café éè בשלמותו, בלי תווי החלפה U+FFFD ובלי בייטים שנעלמו. זו בדיוק ההתנהגות שתפקדה כ-"reference clean" בחבילת selectolax, שבה אותו קלט הושחת בשקט בשני המנועים האחרים (Lexbor ייצר תווי החלפה, Modest פשוט חתך בייטים). הזיהוי של charset ב-libxml2 פשוט יציב יותר כאן.
הצד השני הוא הקשיחות לגבי איך מכריזים על encoding. encoding="latin-1" בהצהרת XML מרים XMLSyntaxError: Unsupported encoding: latin-1, בעוד ש-encoding="ISO-8859-1" התקני לפי IANA נפרס בלי בעיה ומחזיר café. libxml2 מקבל רק שמות קידוד קנוניים, לא כינויים — פרט שתועד כבר ב-launchpad #613302. מעצבן אם לא יודעים, טריוויאלי ברגע שיודעים.
ולבסוף, מחזור החיים של הצומת. הרצתי שלושה תרחישי handle מיושן בתהליכי subprocess מבודדים (קריסה קשה הייתה מתבטאת ביציאה לא-אפסית): החזקת צומת אחרי שהעץ שלו נאסף על ידי ה-garbage collector, קריאת handle אחרי drop_tree(), ושימוש בצומת אחרי remove(). לא היו segfaults באף אחד מהם — lxml שומר על ההפניה של צומת לעץ שלו כדי למנוע use-after-free. אותו ציון עובר נקי קיבל גם selectolax בבדיקה הזו.
מהירות וזיכרון (מושאלים, ובכנות מלאה לגביהם)
כל מה שבסעיף הזה מושאל מחבילת selectolax, נכון ל-2026-07-13. החבילה הזו לא הפיקה אף מספר זמן משלה, ואני מעדיף לומר את זה פעמיים מאשר שתחשבו שמדדתי משהו מחדש.
| מימד | ערך lxml | קריאה |
|---|---|---|
| Pure parse p50 (10 MB) | 77.9 ms | מהיר בכ-33-34% מ-selectolax-Lexbor |
| Full parse + extract p50 (1 MB / 10 MB) | 14.18 ms / 172.9 ms | בערך שקול ל-Lexbor בגדלים קטנים |
| 100k-node CSS throughput | 3,002,646 nodes/s | השכבה המהירה ביותר מבין שלושת מנועי ה-C |
| שינוי RSS ב-10 MB | 128.9 MB | חסכוני ביותר מבין שישה פרסרים, בערך פי 1.7 יותר חסכוני מ-BeautifulSoup |
| עלות cold start של import | 14.1 ms | מהיר בערך פי 2.3 מ-imports בסגנון parsel |
מספרי pure parse והתפוקה חזקים, ו-lxml הוא החסכוני ביותר בזיכרון מבין ששת הפרסרים שנמדדו. עם זאת, תמונת ה-threading דורשת הסתייגות. הנתונים המושאלים מראים שיפור של 1.21x בלבד בזמן wall-clock ב-4 threads, מסומן כבלתי חד-משמעי — אבל זו דרך השימוש עם default parser משותף. שאלות ותשובות של lxml מבהירות שה-GIL משתחרר במהלך parsing רק כשכל thread משתמש בפרסר משלו (או בעותק של ברירת המחדל); פרסר משותף פשוט מסדר גישה בטור. אימתתי מבנית שקיימים ה-APIs הדרושים כדי לעשות את זה נכון (XMLParser.copy() קיים, גם get/set_default_parser קיימים, ו-XPathEvaluator נושא מנעול פנימי), אבל לא מדדתי את השיפור עם פרסר נפרד לכל thread — זו הייתה מדידת זמן חדשה, והחבילה הזו לא מפיקה כאלו. לכן קראו את "1.21x" כ-"במסלול המשותף והנאיבי", לא כתקרת ה-threading של lxml.
ועוד כוכבית אחת על כל זה: אלו מספרים מפלטפורמה אחת בלבד, macOS arm64. הטענה ש-lxml מהיר יותר מ-Lexbor ב-pure parse הולכת נגד הקונצנזוס הרגיל שלפיו הפרסר המבוסס Lexbor הוא המהיר ביותר, ולכן היא באמת דורשת בדיקה חוזרת על Linux x86_64 לפני שמישהו יתייחס אליה כמוסכמת.
רישוי: הניצחון המשעמם
lxml מופץ תחת BSD-3-Clause, וספריות ה-C שהוא כולל — libxml2 ו-libxslt — הן שתיהן MIT. זהו שרשור permissive לחלוטין, בלי copyleft בשום מקום, וזו נקודה חשובה ברגע שמפיצים את המוצר שלכם הלאה. להשוואה, חבילת הגלגל של selectolax כוללת את Modest ברישיון LGPL-2.1 ואת Lexbor ברישיון Apache-2.0, כך של-lxml יש סיפור נקי יותר לשילוב במוצר סגור.
יש גם יתרון התקנה פרקטי: lxml מפרסם wheels מוכנים מראש שמקשרים סטטית את libxml2 ו-libxslt, כך ש-pip install lxml בדרך כלל לא דורש libxml2 מערכתית ולא compiler על המכונה — חוויה שונה מבנייה מהמקור.
איפה lxml משתלב — ואיפה שכבת שליפת AI משתלטת
זה הזמן להבהיר את הגבול, כי קל לבלבל קטגוריות. lxml הוא ספריית parsing. הוא נותן לכם עץ ומנוע שאילתות מעולה, וכל מה שסביב העץ עדיין באחריותכם: הבאת הדף, הרצת JavaScript, התמודדות עם anti-bot, כתיבה ותחזוקה של XPath, והמבנה של התוצאה. זו שכבה שונה משירות שליפה מתארח, והשניים אינם ממש יריבים אלא שכנים.
עבור מפתח שלא רוצה להחזיק בעצמו את כל ה-stack של fetch-render-select-maintain, השכבה העליונה הזו היא המקום שבו Thunderbit נכנס — ולפלח הזה, הממשק הרלוונטי הוא ה-API, שרת ה-MCP, וה-CLI, לא תוסף הדפדפן. ה-Thunderbit Open API חושף את POST /distill כדי להפוך דף ל-Markdown נקי ואת POST /extract כדי לשלוף נתונים מובנים לפי JSON Schema, עם מתג renderMode ומשימות batch לנפח. אותו מנוע זמין גם כשרת MCP (thunderbit_suggest_fields, thunderbit_distill, thunderbit_extract) עבור agents ועוזרי קוד, וגם כ-CLI שאפשר להריץ ישירות מהטרמינל דרך npx @thunderbit/thunderbit-cli. הוא מטפל ב-JS rendering, anti-bot, ו-CAPTCHAs כברירת מחדל ומחזיר JSON תואם סכימה — כלומר זו השכבה שמעל parsing, לא תחליף לו.
נסו את Thunderbit לחילוץ נתוני אינטרנט
המסגור כאן פשוט. בחרו ב-lxml כשאתם שולטים ב-pipeline ורוצים שליטה כירורגית ב-XPath מעל עץ שאתם מבינים. בחרו ב-API של חילוץ מבוסס AI כשאתם מעדיפים לא לתחזק selectors ו-rendering בעצמכם. בהרבה מערכות אמיתיות משתמשים בשניהם — lxml עבור הפידים המובנים שבשליטתם, ושירות חילוץ עבור הדפים המבולגנים והארוכים שאינם בשליטתם.
מה הביקורת הזו לא בדקה
זו ביקורת זמנית, לא לוח ניקוד סופי, ולכן הנה מה שהיא לא מכסה.
כל מספרי הזמן והזיכרון מושאלים, חד-פלטפורמיים (macOS arm64, Python 3.14), ומאמצים את ההסתייגויות של החבילה שממנה הושאלו — התוצאה ש-"lxml מהיר יותר ב-pure parsing" סותרת את הקונצנזוס הרגיל ודורשת בדיקה חוזרת על Linux x86_64. שיפור ה-threading עם פרסר נפרד לכל thread לא נבדק (הוא היה דורש מדידת זמן חדשה). מדדתי את זיכרון iterparse על 300k רשומות אבל לא על XML אמיתי בגודל ג'יגה, לא iterparse על HTML לעומת XML, ולא soak של כמה שעות. XSLT 1.0 של lxml, האימות דרך RelaxNG / XMLSchema / DTD, והרחבות EXSLT — כולם לא נבדקו כאן כלל; זהו משטח יכולות גדול, אבל מעבר לליבת parsing וה-selection. זיהיתי את תקרת העומק השנייה ב-2,045 אך לא קבעתי במדויק את קבוע הרקורסיה של libxml2. נבדקה רק הגרסה היציבה 6.1.1, לא אלפא 7.0.0. Windows, בניות מקור, וה-build החופשי-ל-threads של 3.14t לא נבדקו. ובתוך XPath עצמו, כיסיתי functions מובנים אבל לא משתני XPath, פונקציות הרחבה ב-Python, או שימוש חוזר באובייקטים מוכנים מראש מסוג etree.XPath.
פסק הדין
lxml הוא לא הדבר החדש והמהיר, וזה בדיוק היתרון שלו. זהו binding ל-libxml2 בן שני עשורים, עם מנוע XPath 1.0 מלא שאף חלופה מיינסטרימית ב-Python לא משתווה אליו, שלושה מצבי קשיחות צפויים של parsing עם error log באמצע, parser זורם אמיתי למסמכים שלא נכנסים לזיכרון, טיפול נכון ב-multi-namespace וב-encoding, ורישיון permissive לחלוטין. שתי הנקודות החדות — מגבלת העומק של ~253 רמות ומספר ה-threading עם פרסר משותף — הן תופעות מתועדות, ניתנות להגדרה, וכעת גם מוסברות.
אם אתם שומרים על צינור ה-scraping שלכם ונשענים על XPath, lxml עדיין הפרסר שאליו פונים. אם אתם מעדיפים לא לתחזק selectors ו-rendering, בשביל זה קיימת שכבת שליפה מבוססת AI כמו Thunderbit API, MCP, ו-CLI — חלוקת עבודה נקייה, לא תחרות. כך או כך, התייחסו למספרים האלה כאל זמניים ובדקו מחדש את ה-timing בפלטפורמה שלכם לפני שאתם מצטטים אותם במסמך תכנון.
נסו את Thunderbit לחילוץ נתוני אינטרנט Get Started Free
שאלות נפוצות
האם lxml הוא web scraper?
לא. lxml הוא פרסר ומסדר פלט — binding של Python ל-libxml2/libxslt שממיר markup לעץ שניתן לעריכה ולשאילתות. הוא לא מביא דפים, לא מרנדר JavaScript, ולא מתמודד עם anti-bot; אתם מספקים את שכבת הבקשה (באמצעות requests, httpx, דפדפן headless, או שירות סקרייפינג) ומעבירים את הבייטים ל-lxml.
מתי כדאי להשתמש ב-lxml במקום BeautifulSoup או selectolax? בחרו ב-lxml כשאתם צריכים XPath. BeautifulSoup יכול להשתמש ב-lxml כ-parser backend, אבל אין לו XPath מקורי, ו-selectolax הוא CSS-only ומהיר רק בנישה הצרה שלו. אם לוגיקת הבחירה שלכם צריכה סינון לפי תוכן טקסט, ניווט להורה או לאב-קדמון, חילוץ של מאפיינים או text nodes, או predicates של ספירה — מנוע XPath של lxml הוא האפשרות המיינסטרימית היחידה ב-Python שמבטאת זאת ישירות.
למה lxml לפעמים זורק תוכן מקונן עמוק בלי להתריע?
פרסר ברירת המחדל שלו מגביל קינון לכ-253 רמות — הגנת DoS של libxml2 מפני מסמכים עוינים, לא באג. הגדירו huge_tree=True (למשל lxml.html.HTMLParser(huge_tree=True)) והוא ישחזר לחלוטין עומקים של 300 ו-1,000. שימו לב שיש תקרת רקורסיה שנייה וקשה יותר סביב 2,045 רמות, ש-huge_tree לא מבטל.
האם lxml משחרר את ה-GIL בעת parsing מרובה threads? רק בתנאים הנכונים. ה-FAQ של lxml קובע שה-GIL משתחרר בזמן parsing כאשר כל thread משתמש בפרסר משלו או בעותק של פרסר ברירת המחדל; פרסר משותף מסדר את הגישה בטור. שיפור ה-4 threads של 1.21x שהשתמשנו בו כאן משקף את המסלול הנאיבי עם פרסר משותף, לא את התקרה עם פרסר נפרד לכל thread, שלא נמדדה כאן.
האם lxml עדיין מתוחזק ב-2026? כן. הגרסה היציבה 6.1.1 יצאה ב-2026-05-18, המאגר עודכן לאחרונה ב-2026-07-02, וקיימת אלפא 7.0.0 בתהליך. עם בערך 3,000 כוכבים ב-GitHub ו-libxml2 שמתוחזקת באופן פעיל מתחתיו, זו עדיין ספרייה עדכנית ומסופקת היטב, לא שריד היסטורי.




