
“האם מותר לגלוש נתונים מאתרים?” — זו שאלת מיליון הדולר שאני שומע מצוותי מכירות, תפעול ושיווק כמעט כל שבוע. עם Web Scraping שמניע היום הכול, מיצירת לידים ועד לאינטליגנציה תחרותית, ברור למה כולם רוצים תשובה חד־משמעית. אבל בפועל? המצב המשפטי ברור בערך כמו כוס קפה מאתמול. רק תסתכלו על הכותרות: בית משפט אחד אומר שאיסוף נתונים ציבוריים הוא לגיטימי, ואחר מזהיר מפני “איסוף נתונים בלתי חוקי”. לא פלא שכל כך הרבה צוותים חוששים לחצות את הקו.
והאמת היא שיותר משני שלישים מהארגונים משתמשים כיום ב-Web Scraping כדי להזין פרויקטים של אנליטיקה ו-AI, ו-78% מחברות המסחר האלקטרוני נשענות עליו כדי לקבל תובנות תמחור. אבל כשיש גם תביעות מתוקשרות כמו LinkedIn מול hiQ Labs, ברור שההימור מעולם לא היה גבוה יותר. אז איך מנצלים את הערך של נתוני רשת — בלי להיקלע לצרות משפטיות? בואו נפרק את המסגרות המשפטיות, בדיקות הציות ושיטות העבודה שכל משתמש עסקי חייב להכיר. וכן, אראה לכם גם איך Thunderbit הופך Scraping תואם־כללים להרבה יותר פשוט.
הבנת המרחב המשפטי: האם מותר לגלוש נתונים מאתרים?
נסו את ה-Web Scraper התואם-ציות של Thunderbit ה-Web Scraper האוטונומי של Thunderbit קורא דפים ציבוריים בעצמו ומחלץ נתונים בלחיצה אחת, תוך התחשבות בצרכי צוותים שמקפידים על ציות. Get Started Free
ניגש ישר לעניין: החוקיות של Web Scraping תלויה במה אתם אוספים, איך אתם אוספים, ובאיזה אזור אתם פועלים. אין חוק אחד עולמי שאומר “Scraping מותר” או “Scraping אסור”. במקום זאת, אתם מתמודדים עם פסיפס של כללים — חוקים נגד פריצה, תקנות פרטיות, זכויות יוצרים, ואפילו תנאי השימוש של האתר (Thunderbit Blog).
אלו הגורמים המרכזיים שקובעים אם פרויקט ה-Scraping שלכם נמצא בצד הנכון של החוק:
- מידע ציבורי מול פרטי: איסוף נתונים שפתוחים לכולם (ללא התחברות, ללא חומת תשלום) נחשב בדרך כלל בטוח יותר. אם אתם מנסים לגשת לתוכן שמאחורי התחברות, אתם כנראה כבר נכנסים לשטח מסוכן.
- סוג המידע: מידע אישי (כמו שמות, אימיילים או פרופילים חברתיים) ותוכן מוגן בזכויות יוצרים (כתבות, תמונות) מסוכנים הרבה יותר מאשר איסוף מידע עובדתי (מחירים, מפרטי מוצר, רישומי עסקים).
- השימוש המיועד: שימוש פנימי בנתונים שנאספו (לניתוח או מחקר) פחות מסוכן בהרבה מאשר פרסום מחדש או מכירה שלהם.
- עמידה בכללי האתר: הפרה של תנאי השימוש או התעלמות מקובץ robots.txt עלולות להכניס אתכם לצרות — גם אם המידע ציבורי.
- הגישה הטכנית: איסוף בקצב דמוי-אנושי, בלי לעקוף אמצעי אבטחה (כמו CAPTCHAs או חסימות IP), שומר אתכם על קרקע יציבה יותר.
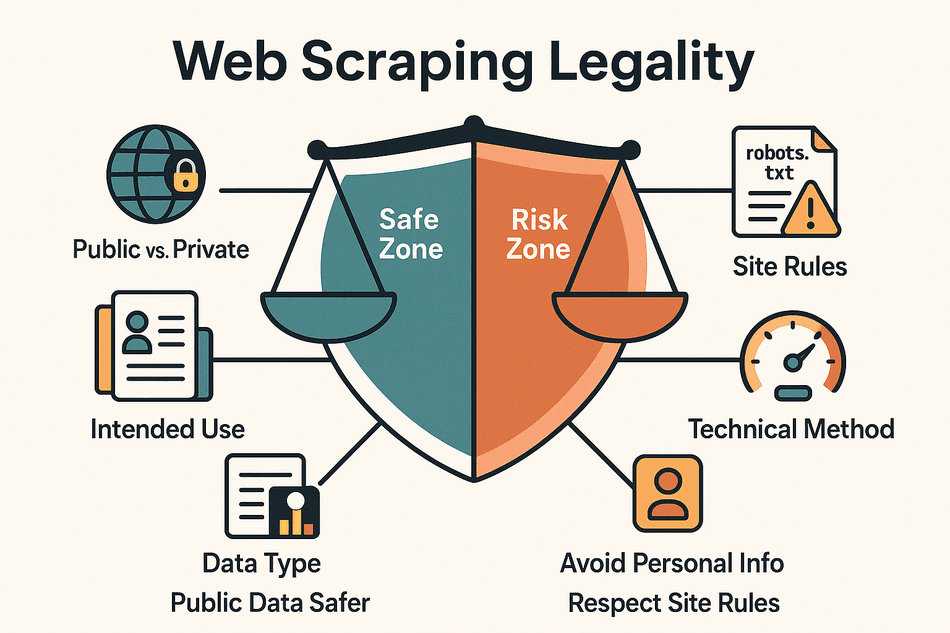

השורה התחתונה? איסוף נתונים ציבוריים ולא-אישיים לשימוש פנימי מקובל באופן רחב באזורים רבים, אבל יש הסתייגויות משמעותיות — במיוחד כשמדובר בפרטיות, בזכויות יוצרים ובאגרסיביות של האיסוף (Thunderbit Blog).
המסגרת המשפטית של איסוף נתונים: סקירה של רגולציות עולמיות מרכזיות
 בואו נעבור בקצרה על המסגרות המשפטיות המרכזיות בעולם ל-Web Scraping:
ארצות הברית: CFAA, זכויות יוצרים וחוזים
- Computer Fraud and Abuse Act (CFAA): חוק נגד פריצה שמונע גישה למערכות מחשב “ללא הרשאה”. אבל בתי המשפט הבהירו ש-Scraping של אתרים ציבוריים אינו מפר את CFAA, משום שאין צורך ב“הרשאה” כדי לגשת אליהם (California Lawyers Association).
- פסק דין מכונן: ב-hiQ Labs v. LinkedIn, בית המשפט המחוזי של ה-Ninth Circuit קבע ש-Scraping של פרופילים ציבוריים ב-LinkedIn אינו מהווה הפרה של CFAA. עם זאת, LinkedIn עדיין יכלה לתבוע בגין הפרת חוזה (הפרת תנאי שימוש) או הפרת זכויות יוצרים.
- סיכונים נוספים: אם אתם מבצעים Scraping אגרסיבי (כמו הבוט ב-eBay v. Bidder’s Edge שביצע 100,000 בקשות ביום), אתם עלולים להיחשף לעוולה של “trespass to chattels” — כלומר, הפרעה לשרתים של מישהו אחר (Wikipedia).
האיחוד האירופי: GDPR וזכויות על מאגרי מידע
- GDPR: תקנת הגנת הפרטיות האירופית חלה גם על מידע אישי ציבורי. אם אתם מגרדים כל מידע שמזהה אדם, אתם צריכים בסיס חוקי (כמו הסכמה או אינטרס לגיטימי) וחייבים לעמוד בכללי פרטיות מחמירים.
- Database Directive: האיחוד האירופי גם מגן על מסדי נתונים כשלם. איסוף “חלק מהותי” ממסד נתונים מובנה (כמו כל הרישומים באתר נדל”ן) עלול להפר זכויות על מסד נתונים — גם אם העובדות הבודדות אינן מוגנות בזכויות יוצרים (Thunderbit Blog).
בריטניה: UK GDPR וחוק הגנת המידע
- UK GDPR: לאחר הברקזיט, הכללים בבריטניה דומים מאוד לאלה של האיחוד האירופי. Scraping של מידע ציבורי ולא-אישי בדרך כלל תקין, אבל איסוף מידע אישי מוסדר בקפדנות.
- Computer Misuse Act: בדומה ל-CFAA, חוק זה יכול להפוך גישה לא מורשית לעבירה פלילית.
סין: PIPL וחוק אבטחת המידע
- Personal Information Protection Law (PIPL): דורש הסכמה לאיסוף מידע אישי. Scraping של אתרים סיניים לצורך איסוף מידע אישי בלי אישור הוא קו אדום ברור.
- Data Security Law: משמש לאכיפה נגד Scraping שפוגע בבעלי המידע או יוצר תחרות לא הוגנת.
אזורים נוספים
- קנדה, אוסטרליה, APAC: ברובם יש חוקים נגד פריצה ותקנות פרטיות הדומות לאלה של האיחוד האירופי והבריטניה. תמיד בדקו את הדין המקומי לפני Scraping.
מסר מרכזי: הבחירה הבטוחה ביותר היא לאסוף נתונים ציבוריים ולא-אישיים לשימוש פנימי, ותמיד לבדוק את הכללים באזור שלכם (Thunderbit Blog).
רשימת בדיקות ציות: איך מוודאים שאיסוף הנתונים שלכם חוקי?
לפני שמתחילים לאסוף נתונים, עברו על רשימת הבדיקות הזו:
- קראו את תנאי השימוש של האתר: אם בתנאים כתוב “אין Scraping”, שקלו לעצור או לבקש אישור מראש (Thunderbit Blog).
- היצמדו לנתונים ציבוריים: אל תאספו מידע שמאחורי התחברות או חומת תשלום בלי הרשאה מפורשת.
- בדקו robots.txt: היכנסו ל-
site.com/robots.txtכדי לראות אם בוטים חסומים מאזורים מסוימים. זה לא בהכרח מחייב משפטית, אבל זו נימוס בסיסי לכבד אותו. - הימנעו ממידע אישי: אל תאספו שמות, אימיילים או PII אחר בלי בסיס חוקי ותוכנית פרטיות.
- אל תעתיקו תוכן יצירתי: היצמדו לעובדות ולנתונים. פרסום מחדש של כתבות, תמונות או חלקים גדולים מתוכן עלול לעורר תביעות זכויות יוצרים.
- השתמשו ב-API רשמי כשיש כזה: אם האתר מציע API, עדיף להשתמש בו — זה בטוח יותר ולעיתים גם יציב יותר.
- איסוף עדין: אל תעמיסו על השרתים. עבדו בקצב דמוי-אנושי והימנעו מעקיפת אמצעים טכניים.
- תעדו את התהליך: שמרו רישום של מה נאסף, מתי ולמה. זה יעזור אם יתעוררו שאלות בהמשך.
- היו מוכנים לעצור: אם מתקבל מכתב cease-and-desist, עצרו את ה-Scraping מיד והעריכו מחדש את המצב.
שיטות האיסוף התואמות לציות של Thunderbit: איך להפוך חילוץ נתונים לבטוח ואמין יותר
כשבנינו את Thunderbit, נושא הציות היה במרכז. כך Thunderbit עוזר לכם להישאר בצד הנכון של החוק:
- Scraping מבוסס דפדפן: Thunderbit אוסף רק את מה שאפשר לראות בדפדפן — בלי קריאות API נסתרות, בלי פריצה לתוך התחברות. אם אי אפשר לראות את זה, Thunderbit לא יאסוף את זה (Thunderbit Blog).
- אזהרות מובנות: אם תנסו לאסוף נתונים מאתר עם מדיניות אנטי-Scraping נוקשה, Thunderbit יציג אזהרה. זה כמו לקבל מומחה ציות שמביט לכם מעבר לכתף.
- חילוץ בלחיצה אחת: ה-AI של Thunderbit סורק את הדף וממליץ רק על השדות הרלוונטיים — וכך עוזר להימנע מאיסוף לא מכוון של מידע רגיש או מיותר (Thunderbit Blog).
- קצב דמוי-אנושי: בין אם אתם אוספים מקומית או בענן, Thunderbit פועל בקצב שלא מעמיס על השרתים.
- הנתונים לא נשמרים בשרתים שלנו: הנתונים שנאספו עוברים ישירות אליכם — Thunderbit לא שומר עותק, וזה מצוין מבחינת פרטיות וציות.
- ייצוא ידידותי לציות: ייצוא ישיר ל-Google Sheets, Excel, Airtable או Notion — מושלם לשימוש פנימי.
- טיפול בתתי-עמודים ובעימוד: Thunderbit מנווט באתר כמו משתמש אמיתי, נכנס לעמודים ולתתי-עמודים בלי “לשבור” את נקודות הקצה.
- Scraping מתוזמן במתינות: אפשר להגדיר איסופים מתוזמנים במרווחים אחראיים, כדי לא “להפגיז” אתר כל דקה.
- תמיכה בריבוי שפות: הממשק של Thunderbit זמין כעת ב-55 שפות ב-Chrome Web Store, כך שהנחיות ציות ורמזי שדות נשארים קריאים גם לצוותים שאינם דוברי אנגלית (Chrome Web Store listing).
בקיצור, Thunderbit “מטמיע ציות בתוך המוצר”, כך שמקבלים הכוונה לאיסוף אחראי — גם אם אינכם מומחי משפט (Thunderbit Blog).
נסו את Thunderbit ל-Web Scraping תואם-ציות התקינו את תוסף Chrome החינמי של Thunderbit וחלצו נתונים מכל דף ציבורי בלחיצה אחת. Get Started Free
Scraping מול שימוש חוזר בנתונים: איפה עובר הגבול המשפטי?
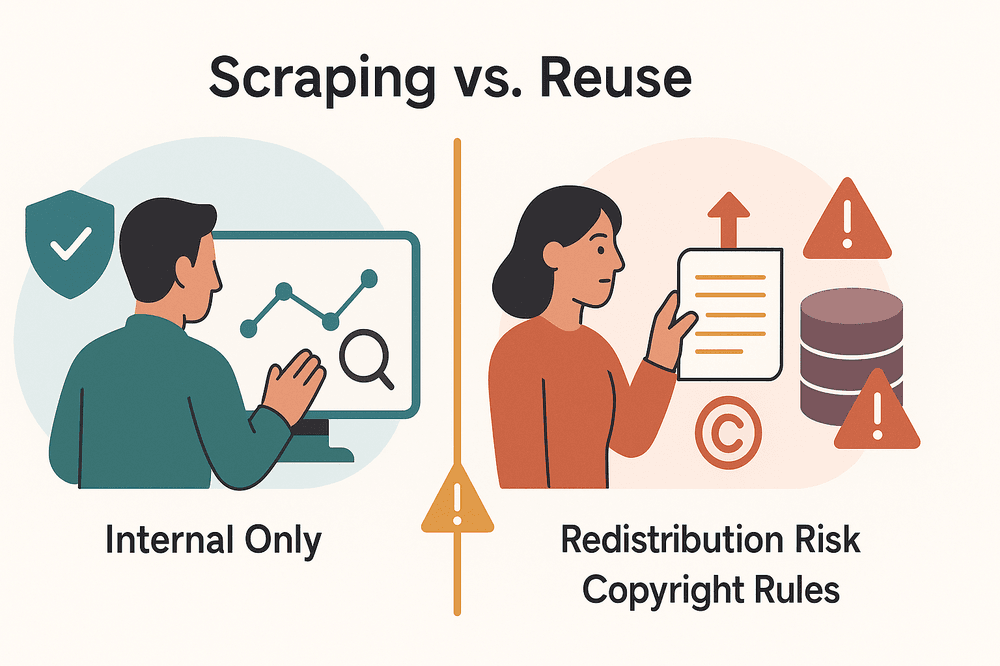 זה דבר אחד לאסוף נתונים לשימוש פנימי, ודבר אחר לפרסם אותם מחדש, למכור אותם או להשתמש בהם מחדש בדרכים אחרות. כאן הגבול המשפטי נעשה חד יותר:
- שימוש פנימי: איסוף נתונים ציבוריים לניתוח פנימי (כמו לידים למכירות או מעקב מחירים) בדרך כלל בטוח — כל עוד אינכם אוספים מידע אישי או מפרים חוקי פרטיות.
- הפצה מחדש או מכירה: פרסום מחדש של נתונים שנאספו (באתר שלכם, במוצר, או במכירה שלהם) עלול לעורר טענות של זכויות יוצרים, זכויות על מסד נתונים או הפרת חוזה.
- זכויות יוצרים וזכויות על מסדי נתונים: בארה”ב עובדות אינן מוגנות בזכויות יוצרים, אבל הבחירה או הסידור של הנתונים עשויים להיות. באיחוד האירופי/בריטניה, איסוף “חלק מהותי” ממסד נתונים עלול להפר זכויות sui generis על מסד נתונים.
- Fair Use: החוק האמריקאי מכיר ב-“fair use” במקרים מסוימים (כמו ביקורת או ניתוח), אבל פשוט להעתיק ולהדביק כמויות גדולות של תוכן כמעט אף פעם לא ייחשב fair use.
- ייחוס מקור: תמיד ציינו מקורות אם אתם משתמשים בנתונים שנאספו באופן פומבי — אבל זכרו, ייחוס לא הופך את השימוש לחוקי אם אתם מפרים זכויות אחרות.
- אל תמכרו נתונים גולמיים: מכירת מאגרי נתונים שנאספו ולא עברו עיבוד היא מסוכנת במיוחד. השתמשו בנתונים ליצירת תובנות, לא כמוצר בפני עצמו.
טיפ פרקטי: השתמשו בנתונים שנאספו עבור מודיעין פנימי וקבלת החלטות. אם צריך לשתף החוצה, עדיף לצבור או לעבד אותם, ותמיד לבדוק אם נדרש אישור (Thunderbit Blog).
מקרי בוחן מהתעשייה: איך מצמצמים סיכונים משפטיים
בואו נסתכל על כמה מקרים אמיתיים — כי אין כמו לראות מה השתבש לאחרים כדי להבין ציות:
LinkedIn מול hiQ Labs
- מה קרה: hiQ Labs אספה פרופילים ציבוריים מ-LinkedIn כדי לבנות אנליטיקה על עזיבת עובדים. LinkedIn ניסתה לחסום אותם, אבל בית המשפט קבע ש-Scraping של נתונים ציבוריים אינו הפרה של CFAA.
- לקח: איסוף נתונים ציבוריים הוא בר-הגנה משפטית בארה”ב, אבל עדיין צריך להיזהר מתנאי שימוש ומטענות פרטיות (California Lawyers Association).
eBay מול Bidder’s Edge
- מה קרה: Bidder’s Edge אספה באגרסיביות את רשימות המכירה הפומביות של eBay (100,000 בקשות ביום), תוך הפרת תנאי השימוש ו-robots.txt. בית המשפט הוציא צו מניעה בגין “trespass to chattels”.
- לקח: גם Scraping של נתונים ציבוריים יכול להיות בלתי חוקי אם הוא אגרסיבי או מפר כללים מפורשים של האתר (Wikipedia).
Facebook (Meta) מול Power Ventures
- מה קרה: Power Ventures אספה נתונים מ-Facebook בהסכמת משתמשים, אבל אחרי ש-Facebook ביטלה את הגישה וחסמה את כתובות ה-IP שלה, Power Ventures המשיכה לאסוף. בית המשפט קבע שמדובר ב-“גישה לא מורשית”.
- לקח: אם בעל האתר אומר לכם להפסיק — חייבים לעצור. אחרת, אתם עלולים להפר חוקים נגד פריצה.
סיפורי הצלחה של ציות
אתרי השוואת מחירים רבים באיחוד האירופי פועלים כחוק בכך שהם אוספים רק נתונים עובדתיים, מכבדים אפשרויות opt-out ואינם אוספים מסדי נתונים שלמים. העובדה שאין נגדם תביעות רבות מראה שהתמקדות בנתונים ציבוריים ולא-אישיים, יחד עם ציות לכללי האתר, עובדת.
איך Thunderbit עוזר
האזהרות המובנות של Thunderbit, מגבלות הקצב והגישה המבוססת על דפדפן היו יכולים למנוע הרבה מהטעויות המשפטיות האלה — על ידי התרעה על אתרים מסוכנים ואכיפת Scraping מנומס כברירת מחדל.
רשימת בדיקה עצמית לציות באיסוף נתונים בתרחישים עסקיים
הנה צ'ק ליסט מעשי לביקורת עצמית בפרויקט ה-Scraping הבא שלכם:
- האם הנתונים ציבוריים? (אין צורך בהתחברות)
- מה אומרים תנאי האתר? (יש סעיפים נגד Scraping?)
- בדקתם robots.txt? (האם האזור היעד חסום?)
- האם אתם אוספים מידע אישי? (אם כן, יש לכם תוכנית פרטיות?)
- האם אתם אוספים חלק גדול מהאתר? (להימנע מאיסוף של מסדי נתונים שלמים)
- מה המטרה שלכם? (שימוש פנימי = בטוח יותר; שימוש מחדש פומבי = מסוכן יותר)
- האם אתם אוספים בעדינות? (קצב דמוי-אנושי, בלי עקיפה טכנית)
- בדקתם אם יש API? (להשתמש בו אם קיים)
- האם אתם מוכנים לעצור אם יבקשו? (תוכנית ל-cease-and-desist)
- איך תאחסנו ותאבטחו את הנתונים? (הגבלת גישה, הגנת פרטיות)
- האם אתם מתעדים את התהליך? (שמירת רישום לצורכי ציות)
אם עניתם “לא” או שאתם לא בטוחים לגבי אחד הסעיפים, עצרו והבהירו את הנושא לפני שממשיכים (Thunderbit Blog).
דוגמת תהליך עבודה ל-Scraping תואם-ציות עבור משתמשי Thunderbit
 בואו נעבור על תהליך טיפוסי, ידידותי לציות, ב-Thunderbit:
- בדיקת קדם-איסוף: היכנסו ל-robots.txt ולתנאי השימוש של האתר. אין שפה נגד Scraping? אפשר להמשיך.
- פתחו את Thunderbit: נווטו לעמוד היעד והפעילו את תוסף Chrome של Thunderbit.
- חילוץ בלחיצה אחת: תנו ל-AI של Thunderbit להמליץ על שדות רלוונטיים ולא רגישים. בדקו שוב שאין מידע אישי, אלא אם יש לכם בסיס חוקי לכך.
- התאמת שדות: ערכו את העמודות וסוגי הנתונים לפי הצורך — אספו רק מה שבאמת דרוש.
- איסוף: לחצו “Scrape”. Thunderbit מחלץ נתונים בקצב דמוי-אנושי ומכבד את מבנה האתר.
- Scraping של תתי-עמודים: אם צריך, השתמשו ביכולת תתי-העמודים של Thunderbit כדי להעשיר את הנתונים — שוב, רק למידע ציבורי.
- ייצוא: שלחו את הנתונים ישירות ל-Google Sheets, Excel, Airtable או Notion לניתוח פנימי.
- תזמון (אופציונלי): הגדירו איסופים מתוזמנים במרווחים סבירים — לא בתדירות גבוהה מדי.
- תיעוד: שמרו רישום של מה נאסף, מתי ולמה.
הממשק של Thunderbit ינחה אתכם בכל שלב אם יש שיקולי ציות — כך שלא תצטרכו לנחש.
למדו עוד על יכולות הציות של Thunderbit התוכנית החינמית כוללת 6 עמודים בחודש, ללא צורך בכרטיס אשראי — דרך בעלת סיכון נמוך לבדוק חילוץ מדפים ציבוריים. Get Started Free
מסקנה והמלצות מרכזיות: לנצל את הערך של נתונים בבטחה ובציות מלא
Web Scraping הוא כלי עוצמתי לצמיחה עסקית — אבל הוא לא “אזור ללא חוקים”. המרחב המשפטי מורכב, אבל עקרונות הליבה ברורים:
- כדאי לאסוף נתונים ציבוריים ולא-אישיים לשימוש פנימי בכל פעם שאפשר.
- תמיד לבדוק תנאי אתר, robots.txt והחוקים הרלוונטיים לפני שמתחילים.
- להימנע מאיסוף מידע אישי או תוכן יצירתי אלא אם יש בסיס חוקי ותוכנית פרטיות.
- להשתמש בכלים ידידותיים לציות כמו Thunderbit כדי להנחות את העבודה ולצמצם סיכונים.
- לתעד את התהליך ולהיות מוכנים לעצור אם מתבקשים.
כשציות הופך להרגל, אפשר למצות את הערך של נתוני רשת — בלי כאבי הראש המשפטיים. ואם אתם רוצים לראות כמה פשוט יכול להיות Scraping תואם־כללים, נסו את Thunderbit. גם היועצים המשפטיים שלכם וגם העתיד שלכם יודו לכם.
לעוד מדריכים מעמיקים על Web Scraping, ציות ואוטומציה, בקרו ב-Thunderbit Blog.
נסו את ה-Web Scraper האוטונומי לחילוץ נתונים תואם-ציות Get Started Free
שאלות נפוצות
1. האם מותר לגלוש נתונים מכל אתר?
לא תמיד. איסוף נתונים ציבוריים ולא-אישיים לשימוש פנימי הוא בדרך כלל חוקי באזורים רבים, אבל איסוף מידע אישי, תוכן מוגן בזכויות יוצרים או מידע שמאחורי התחברות עלול להיות מסוכן או אפילו בלתי חוקי. תמיד בדקו את תנאי האתר והחוקים המקומיים לפני האיסוף (Thunderbit Blog).
2. מה ההבדל בין Scraping לבין שימוש חוזר בנתונים?
Scraping הוא פעולת האיסוף; שימוש חוזר פירושו פרסום, מכירה או הפצה אחרת של הנתונים. שימוש פנימי בטוח הרבה יותר. פרסום מחדש או מכירה של נתונים שנאספו עלולים לעורר טענות של זכויות יוצרים, זכויות על מסד נתונים או הפרת חוזה (Thunderbit Blog).
3. איך Thunderbit עוזר לשמור על ציות?
Thunderbit אוסף רק את מה שנראה בדפדפן, מזהיר מפני אתרים מסוכנים, מציע שדות רלוונטיים ולא-רגישים, ומווסת בקשות כדי לא להעמיס על שרתים. בנוסף, הוא לא שומר את הנתונים שלכם, ואפשרויות הייצוא שלו מיועדות לשימוש פנימי (Thunderbit Blog).
4. מה לעשות אם קיבלתי מכתב cease-and-desist?
עצרו את ה-Scraping מיד והעריכו מחדש את הפרויקט. המשך פעילות אחרי בקשה מפורשת להפסיק עלול להפוך אזור אפור להפרה ברורה של חוקי אנטי-פריצה או תנאי חוזה (Thunderbit Blog).
5. האם אפשר לאסוף מידע אישי אם הוא ציבורי?
לא בלי בסיס חוקי. חוקי פרטיות כמו GDPR ו-CCPA חלים גם על מידע אישי ציבורי. תצטרכו הסכמה או אינטרס לגיטימי חזק, וצריך לטפל בנתונים באחריות (Thunderbit Blog).
המדריך הזה נועד למידע כללי בלבד ואינו מהווה ייעוץ משפטי. בפרויקטים מורכבים או בעלי סיכון גבוה, מומלץ להתייעץ עם עורך דין מוסמך שמכיר את דיני המידע והפרטיות בתחומכם.
קראו עוד




