
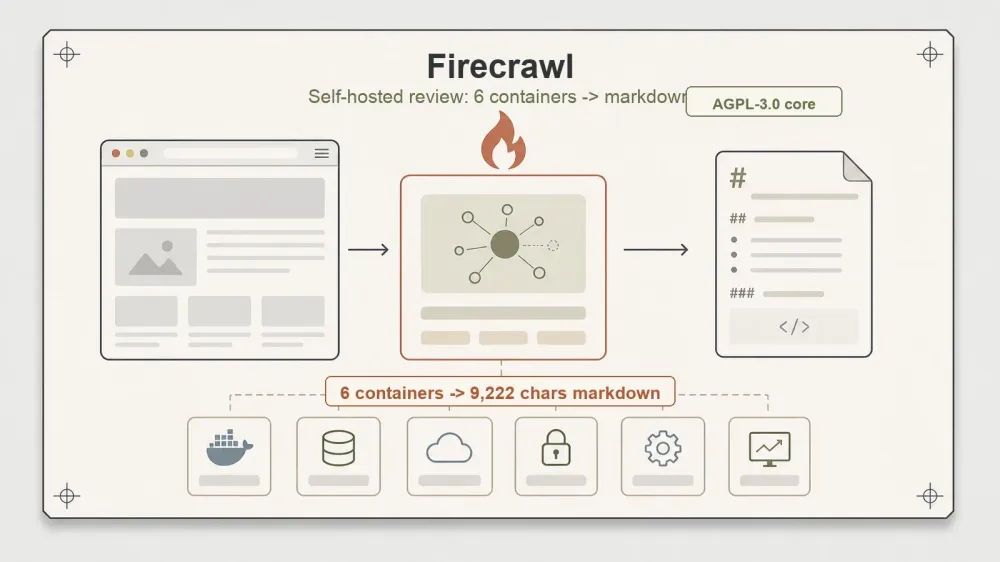
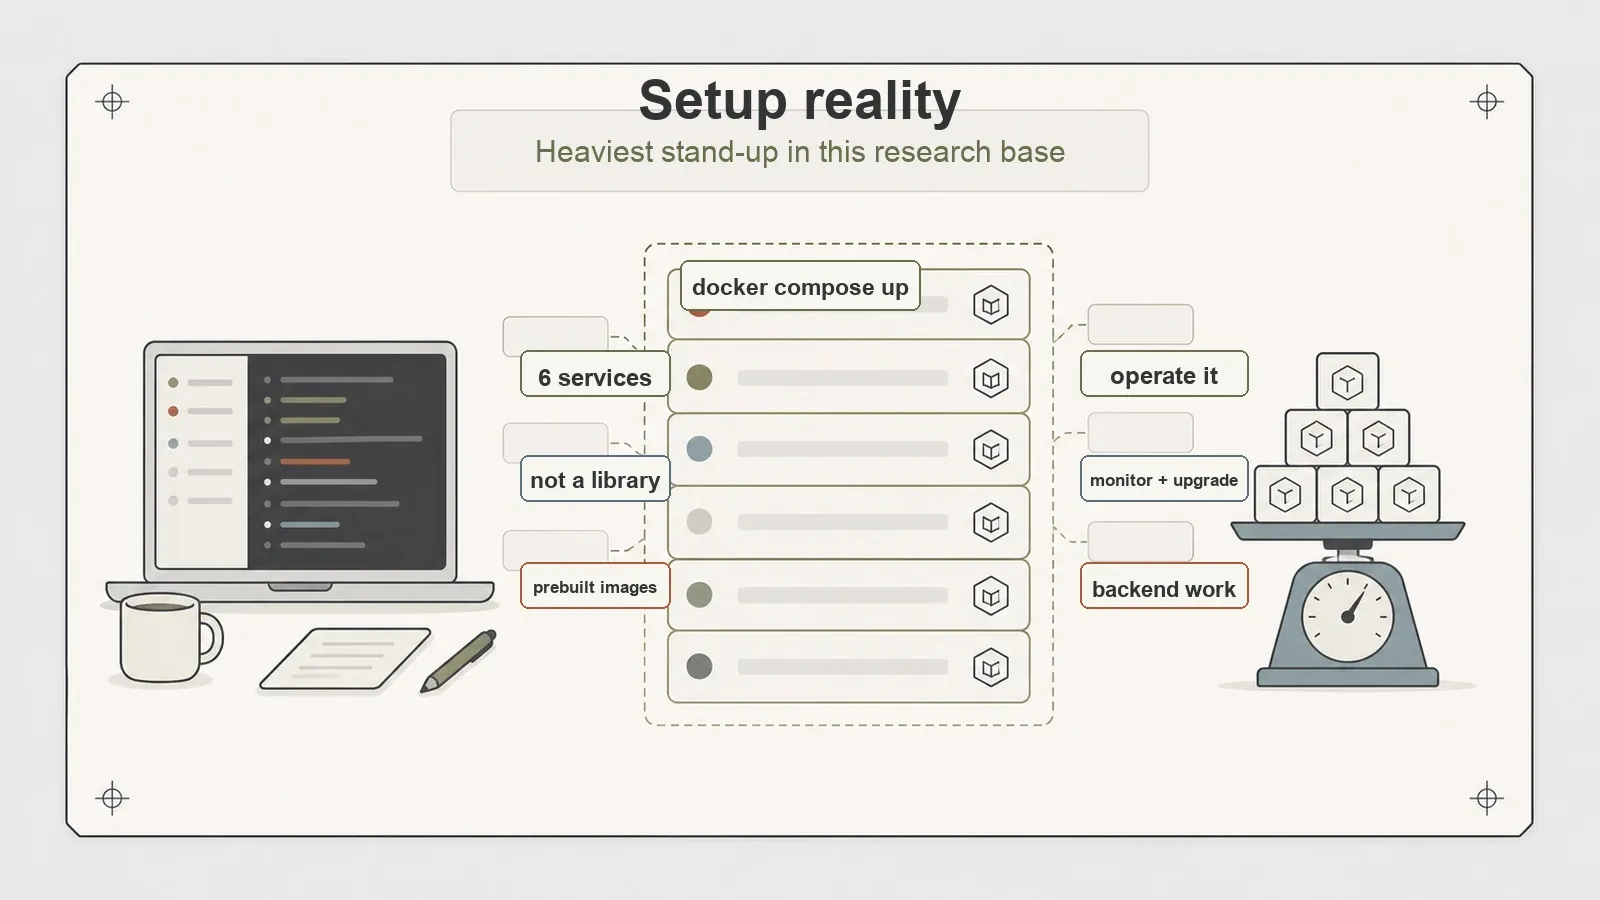
רוב האנשים נוטים למקם את Firecrawl באותה קטגוריה עם ספריות גירוד רגילות – אלה שדורשות pip install, כתיבת סקריפט קצר וזהו. אבל זו טעות, וההבדל הוא עצום עוד לפני שאתם מקלידים פקודה אחת. Firecrawl בהתקנה עצמית הוא לא סתם ספרייה שאתם מייבאים; זהו שירות שלם שאתם מפעילים, וההקמה שלו דורשת הרצה של שישה קונטיינרים של Docker שמתקשרים ביניהם.
הפעלתי את המערכת בהתקנה עצמית על Mac (arm64, Docker דרך colima) בלי מפתח ענן, כיוונתי את נקודת הקצה /v1/scrape שלו לכמה אתרי הדגמה ידידותיים לגירוד, וצפיתי בתוצאות. בקיצור: ההבטחה המרכזית התקיימה – דף נכנס, ויצא Markdown נקי ומוכן ל-LLM – אבל ההתקנה הייתה הכי כבדה מכל כלי שבדקתי במסגרת המחקר הזה. זוהי בדיקה ראשונית, לא דירוג סופי, ואפרט במפורש מה בדקתי ומה לא.
Firecrawl הוא שירות, לא ספרייה
המודל המנטלי שצריך לתקן קודם כל הוא זה. כלי הגירוד שרוב המפתחים משתמשים בהם הם ספריות: אתם מוסיפים תלות, קוראים לפונקציה, ומקבלים בחזרה HTML או נתונים מנותחים בתוך התהליך שלכם. Firecrawl בהתקנה עצמית הוא חיה אחרת לגמרי. זוהי פלטפורמה פועלת עם API משלה, ואתם מתקשרים איתה באמצעות HTTP.
המיצוב הרשמי הוא "ה-API לחיפוש, גירוד ואינטראקציה עם האינטרנט בקנה מידה", וצורת המוצר היא בדיוק זו – דפים נכנסים, Markdown נקי או נתונים מובנים יוצאים. כשאתם מארחים בעצמכם, אתם לא מקשרים ל-Firecrawl. אתם מפעילים ערימת docker compose ופונים לנקודת קצה, באותו אופן שבו הייתם פונים לכל מיקרו-שירות פנימי.
הערימה שהפעלתי כללה שישה שירותים:
- api — הממשק ה-HTTP שאתם קוראים לו בפועל
- playwright-service — דפדפן ללא ממשק משתמש (headless browser) לעיבוד JavaScript
- redis — תור ומטמון
- rabbitmq — מתווך הודעות
- nuq-postgres — גרסת Postgres למצב משימות
- foundationdb — אחסון מפתח-ערך מבוזר
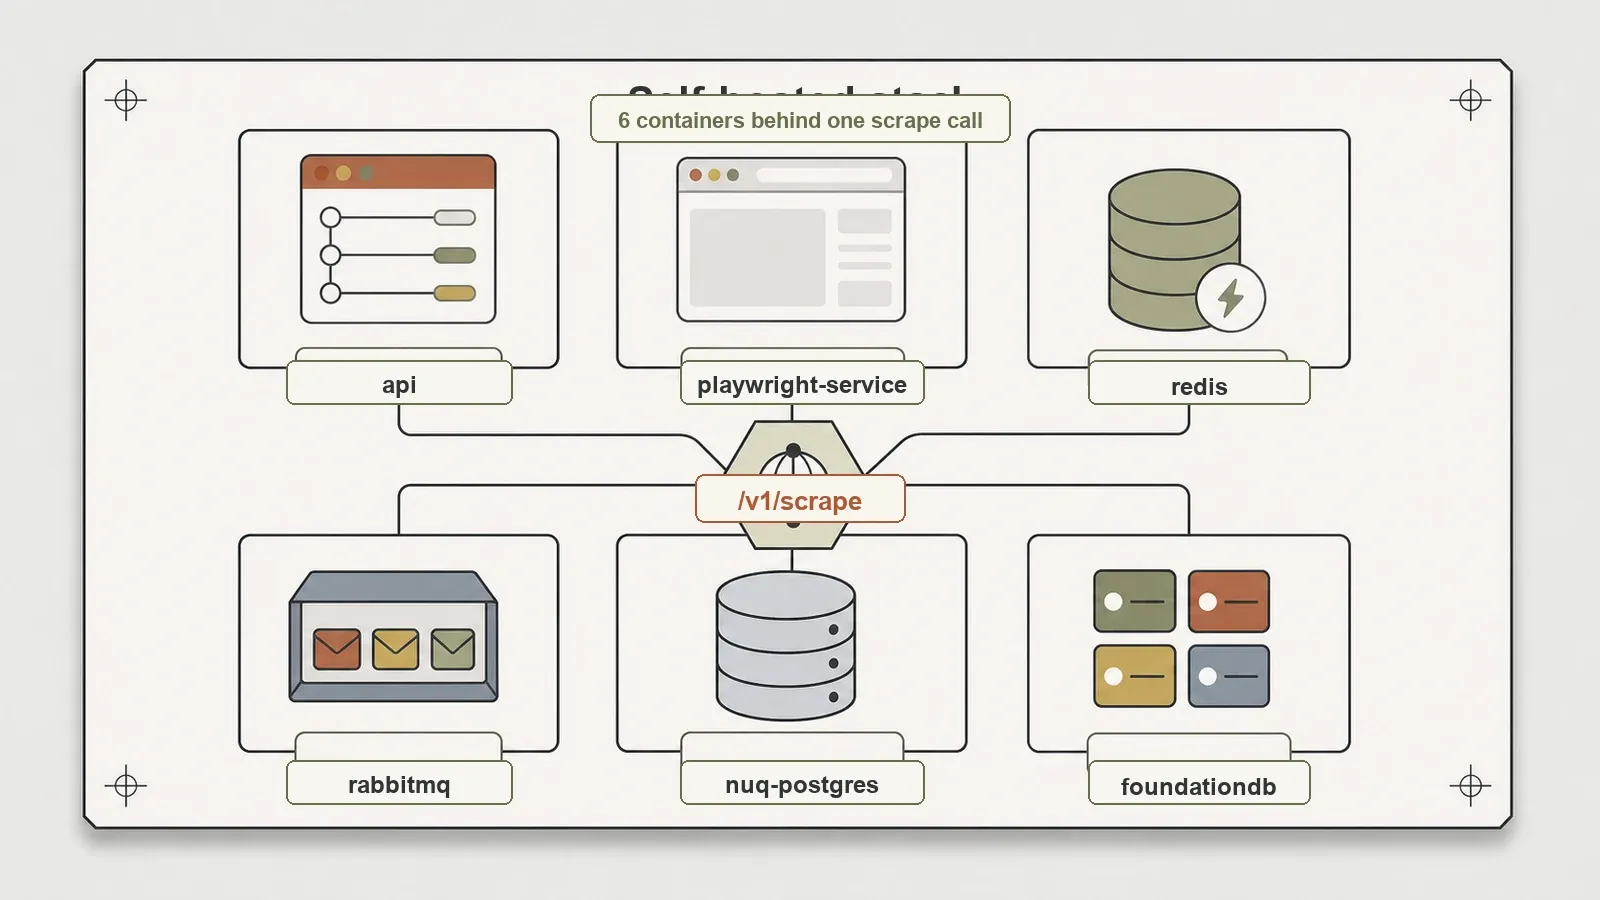
זהו backend אמיתי, לא סקריפט עזר. Redis, RabbitMQ, Postgres ו-FoundationDB הם כולם תשתיות ברמה תעשייתית בפני עצמם. היתרון הוא ש-Firecrawl מטפל בחלקים המורכבים של הגירוד – תורים, עיבוד, ניסיונות חוזרים – מאחורי קריאת API אחת. העלות היא שאתם מפעילים כעת את ששת הקונטיינרים הללו. זכרו את היתרון והחיסרון הזה; זהו קו המנחה של כל הסקירה הזו.
למען הסר ספק, בדקתי מול ה-SDKs firecrawl-py 4.32.0 ו-firecrawl-js 4.30.0, ומשכתי את התמונה הרשמית המוכנה מראש ghcr.io/firecrawl/firecrawl:latest בתאריך 2026-07-09. הריפוזיטורי עומד על כ-148 אלף כוכבים נכון לתאריך זה (התייחסו לזה כמטא-דאטה, לא ציון איכות), תחת רישיון AGPL-3.0 – פרט שאחזור אליו, מכיוון שהוא משנה את החישוב לשימוש מסחרי.
הבדיקה המרכזית: דף הופך ל-Markdown נקי
כל הסיבה לקיומו של Firecrawl היא להפוך דף אינטרנט ל-Markdown ש-LLM יכול לקרוא בפועל. אז זה הדבר הראשון שבדקתי.
כיוונתי את /v1/scrape ל-books.toscrape.com, קטלוג סטטי שנבנה במיוחד לתרגול גירוד. התוצאה: 9,222 תווים של Markdown נקי, מוכן ל-LLM, עם כותרת הדף All products | Books to Scrape מנותחת נכון. לא HTML גולמי שנזרק למחרוזת – אלא Markdown מובנה, עם כותרות, קישורים והפניות לתמונות שלמים. סוג הפלט שתוכלו להכניס ישירות ל-צינור אחזור או להזין למודל ללא מעבר ניקוי שני.
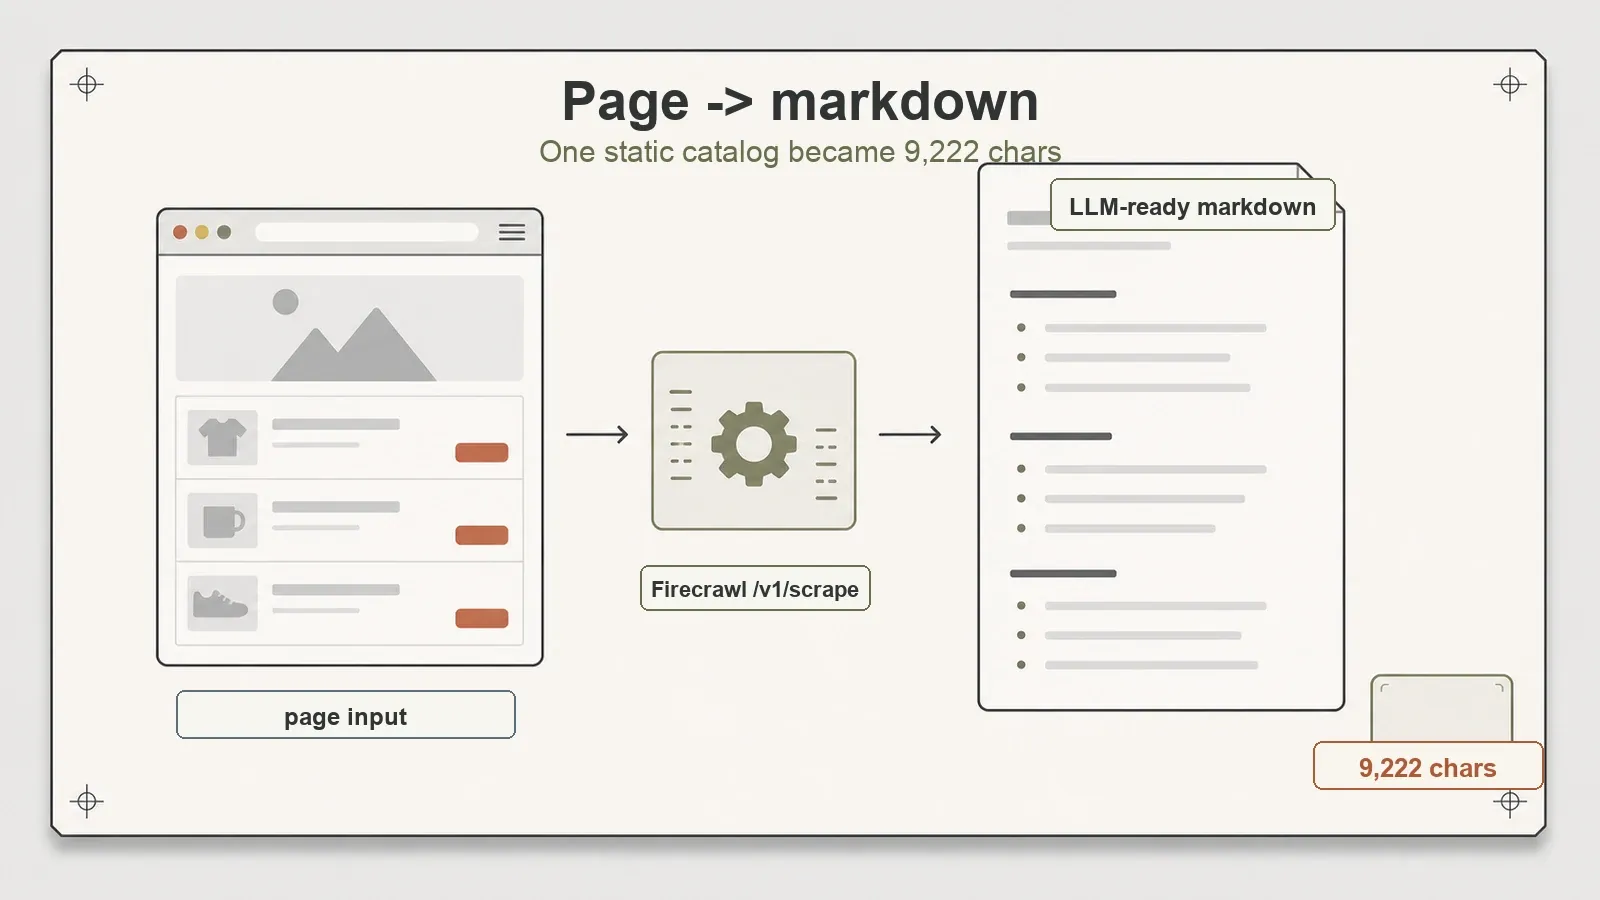
זוהי נקודת החוזק העיקרית של Firecrawl, וההתקנה העצמית סיפקה אותה ללא דרמות. אם תפקידכם הוא "תן לי את התוכן הקריא של דף זה כ-Markdown", דף סטטי חזר בדיוק כפי שפורסם. זוהי פרימיטיבה שימושית באמת, וזו הסיבה שלכלי יש את העוקבים שיש לו.
חשוב לדייק לגבי היקף: הפעלתי את נתיב /v1/scrape לדף בודד. לא בדקתי את /v1/crawl, הזחלן מרובה הדפים שסורק אתר שלם. זוהי יכולת נפרדת עם מצבי כשל משלה, ואני לא אתיימר לטעון שהיא עובדת כשלא הפעלתי אותה.
דפי JavaScript: הדפדפן המצורף מצדיק את הקונטיינר שלו
דף סטטי הוא המקרה הקל. השאלה הקשה יותר עבור כל כלי גירוד היא מה קורה כאשר התוכן מופיע רק לאחר הרצת JavaScript – מה שקורה ברוב המקרים באינטרנט המודרני.
כאן קונטיינר ה-playwright-service מפסיק להיות תקורה ומתחיל להיות העיקר. כיוונתי את כלי הגירוד ל-quotes.toscrape.com/js/, גרסה של אתר ההדגמה שמעבד את הציטוטים בצד הלקוח. אם Firecrawl היה פשוט שולף את ה-HTML הגולמי, הציטוטים לא היו שם – הם לא קיימים עד שהדפדפן מבצע את הסקריפט של הדף.
הגירוד חזר עם 1,574 תווים של Markdown, וציטוט איינשטיין היה בו. ציטוט זה הוא תוכן לאחר JavaScript: נוכחותו היא הוכחה לכך ש-playwright-service אכן עיבד את הדף במנוע דפדפן אמיתי לפני חילוץ הטקסט, במקום לתפוס את המעטפת הריקה שלפני העיבוד.
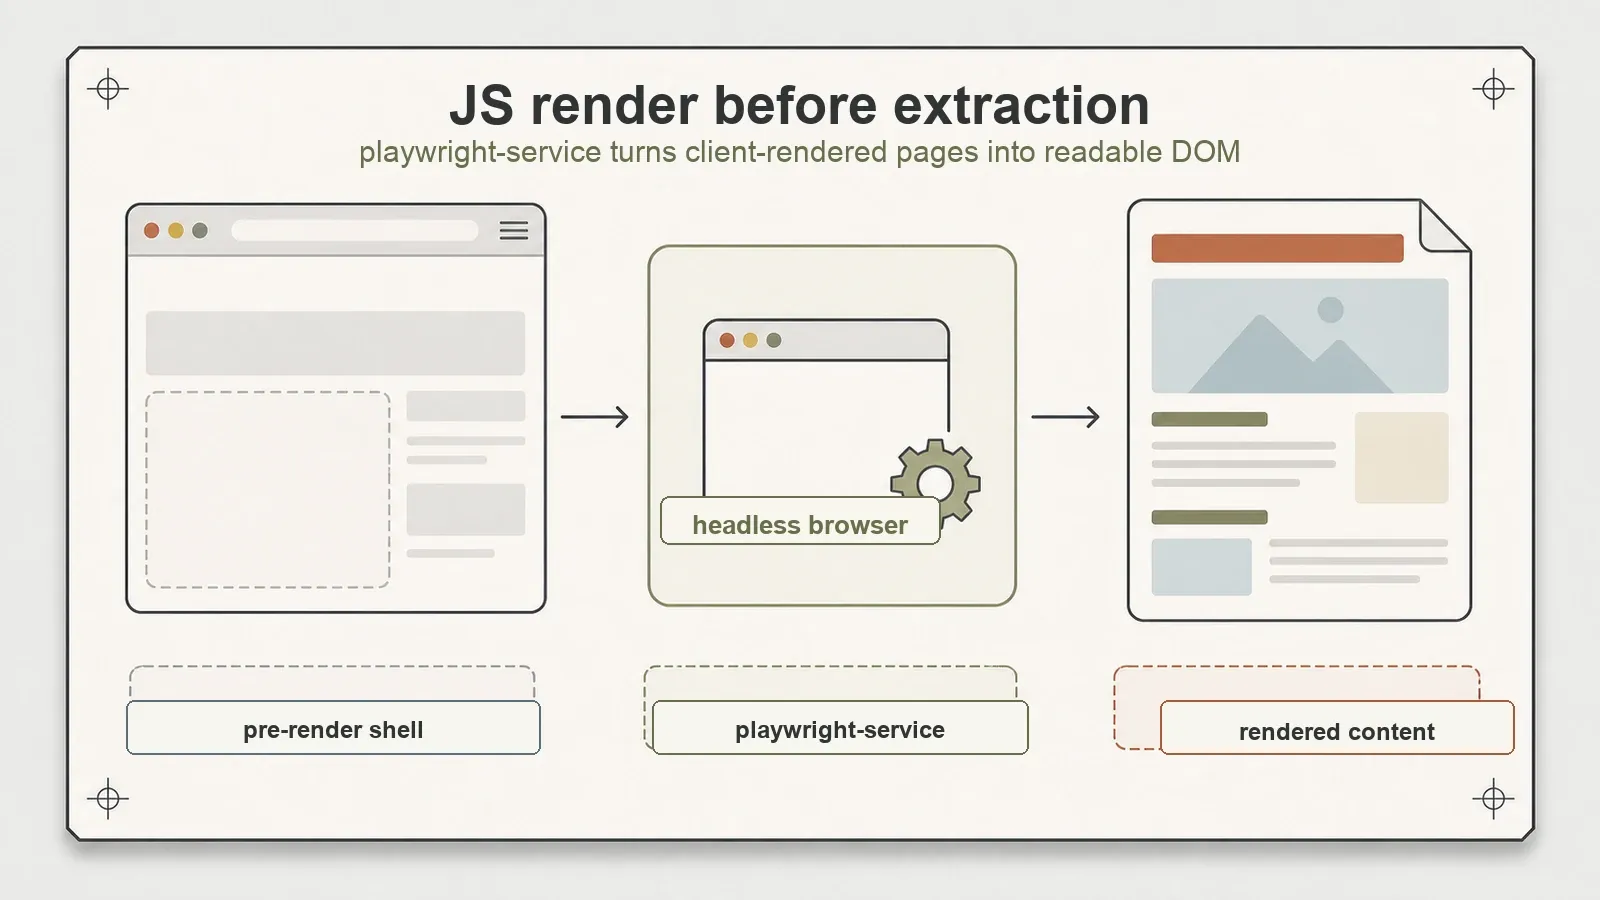
אז אחד מששת הקונטיינרים הוא דפדפן ללא ממשק משתמש, והוא עושה את העבודה שלשמה הוא נועד. זוהי ההצדקה הקונקרטית לארכיטקטורה הכבדה יותר: אתם לא רק משלמים על קונטיינרים, אתם משלמים על היכולת לעבד דפים עתירי JS מבלי לחבר אוטומציה משלכם לדפדפן. עבור יעדים רבים בעולם האמיתי, זה ההבדל בין פלט שמיש לבין דיבים ריקים.
כאשר היעד גרוע: שגיאות מובנות, ללא קריסה
כלי גירוד מבלים חלק מפתיע מחייהם כשהם מכוונים לדברים שאינם עובדים – מארחים מתים, כתובות URL שגויות, שרתים שנתקעים. האופן שבו כלי נכשל מעיד לא פחות מהאופן שבו הוא מצליח.
הזנתי ל-API מארח לא חוקי בכוונה. הוא החזיר HTTP 500 מובנה והמשיך לפעול – ללא עקבות מחסנית שנפלטו ללקוח, ללא קונטיינר שנופל, ללא תהליך שנתקע. השגיאה חזרה כתגובה נקייה שהקורא יכול להסתעף עליה.
זוהי ההתנהגות המשעממת והנכונה שאתם רוצים ממשהו שתכניסו לצינור. כלי גירוד שנכנס לפאניקה על יעד גרוע הוא כלי גירוד שאי אפשר לבצע סביבו אוטומציה. זה החזיר שגיאה שאתם יכולים לתפוס ולהמשיך הלאה. בדקתי רק מקרה שגיאה אחד, אז קראו זאת כ-"טיפל בכשל היחיד שזרקתי עליו נכון", לא ביקורת עמידות ממצה – אבל נקודת הנתונים היחידה הייתה התוצאה הנכונה.
מציאות ההתקנה: המשימה הכבדה ביותר בבסיס
עכשיו החלק שאף אחד לא מצלם עבור ציוץ ההשקה. Firecrawl בהתקנה עצמית היה, ללא הגזמה, ההתקנה המורכבת ביותר מכל כלי בבסיס מחקר זה – והקמתי רבים מהם.
שישה קונטיינרים הם העלות הבסיסית. אבל נתקלתי גם בשני מכשולים בדרך למעלה, ואני רוצה לדייק לגבי מי אשם בהם – לא Firecrawl, כפי שמתברר.
מכשול ראשון: בנייה מהמקור. בניית התמונות מהמקור נכשלה בתוך ה-VM של colima שלי עקב שגיאת snapshotter של containerd. זוהי אינטראקציה ידועה ורעועה בין הבנייה לשכבת האחסון של colima – תקלה תשתיתית בסביבה שלי, לא באג ב-Firecrawl. קובץ ה-compose מתעד חלופה: השתמשו בתמונות הרשמיות המוכנות מראש ghcr.io/firecrawl/* במקום לבנות מקומית. עברתי לאלו, וכל הערימה עלתה בצורה נקייה. אם אתם משתמשים ב-Docker daemon סטנדרטי ולא ב-colima, ייתכן שלעולם לא תראו זאת; אני מציין זאת כאזהרה סביבתית, ואימות בניית התורם על daemon נקי נמצא ברשימת הפערים שלי.
מכשול שני: הגנת ה-SSRF. הגירודים הראשונים שלי נחסמו על ידי הגנת ה-IP הפרטי / SSRF של Firecrawl. למה? הרשת של colima ממפה שמות מארחים ציבוריים לכתובות 198.18.x.x, שנמצאות בטווח שמור ש-Firecrawl מתייחס אליו נכון כפרטי – כך ששכבת האבטחה שלו עשתה את עבודתה וסירבה לשלוף מה שנראה כיעד פנימי. כדי לעקוף זאת לצורך בדיקות מקומיות בלבד, הגדרתי ALLOW_LOCAL_WEBHOOKS=true.
דגל זה מועתק ומוכנס לייצור וגורם לתקלות, אז היו מדויקים לגבי מה שהוא: הגנת ה-SSRF היא תכונה, לא מכשול. היא זו שמונעת משירות גירוד להיות מרומה לפגוע ברשת הפנימית שלכם. השבתתי אותה מכיוון שמוזרות של ה-DNS של colima גרמה ליעדים הציבוריים הלגיטימיים שלי להיראות פרטיים בתוך ה-VM. אל תשביתו את הגנת ה-SSRF בפריסה אמיתית. אם אתם לוקחים הערה תפעולית אחת מסקירה זו, קחו אותה.
שני המכשולים, לומר זאת בפשטות, היו תוצאה של הפעלת Docker דרך colima על מחשב נייד – לא פגמים בתוכנה. מצד שני, משקל ההתקנה עצמו אמיתי והוא של Firecrawl לפי תכנון. זה לא הכלי שאתם משתמשים בו כשאתם רוצים סקריפט מקומי מהיר; זה הכלי שאתם מקימים כשאתם רוצים שירות גירוד בעל יכולת עיבוד ואתם מוכנים להפעיל עבורו תשתית.
מה שלא בדקתי, ומה שהוא לא עושה
הנה מה שלא כיסיתי, ומה שהכלי לא נותן לכם.
לגרסה בהתקנה עצמית אין Fire-engine. מוצר הענן של Firecrawl כולל את Fire-engine, שכבת האנטי-חסימה הקניינית שלו למעבר הגנות בוטים. לפי ה-SELF_HOST.md של הפרויקט עצמו, מופעים בהתקנה עצמית אינם מקבלים אותו. אז אם אתם מדמיינים את Firecrawl בהתקנה עצמית פורץ דרך מערכות אנטי-בוט אגרסיביות מהקופסה, תקנו את התמונה – יכולת זו קיימת בשכבת הענן, והיא לא הייתה חלק ממה שהפעלתי.
ה-API בענן לא נבדק כאן. לא היה לי מפתח ענן, אז כל מה שלעיל הוא רק ערימת ההתקנה העצמית. שירות הענן המנוהל – עם Fire-engine, קנה מידה מאוחסן ותכונות ה-AI – הוא מוצר אחר, ואני לא מתכוון לאפיין את ביצועיו מבחוץ. התייחסו לכל טענת ענן כאל מחוץ לתחום סקירה זו.
תכונות AI דורשות מפתח. פורמט הפלט המובנה json ונקודת הקצה /extract נשענים על LLM, מה שאומר שיש להביא מפתח OpenAI או לחבר את Ollama. זה מכניס את בחירת המודל לחשבון החומרים: לפני התחייבות להתקנה, השוו את תמחור ה-API הנוכחי של הספקים שתוכלו להביא. לא הפעלתי את הנתיבים הללו, כך ש-/extract ופלט json מובנה נמצאים גם הם בעמודת הלא נבדקים.
פרוקסי הם אזהרה, לא כותרת. Firecrawl תומך בתצורת פרוקסי, אך אני מציין זאת כהערת שוליים בכוונה – זהו כפתור שאתם יכולים לסובב, לא סיבה לבחור בכלי, ולגרסה בהתקנה עצמית עדיין חסרה שכבת האנטי-חסימה של הענן בכל מקרה.
AGPL-3.0 היא החלטת ציות אמיתית. זה ראוי להתייחסות נפרדת.
הרישיון: קרא את AGPL-3.0 לפני שאתה מפיץ
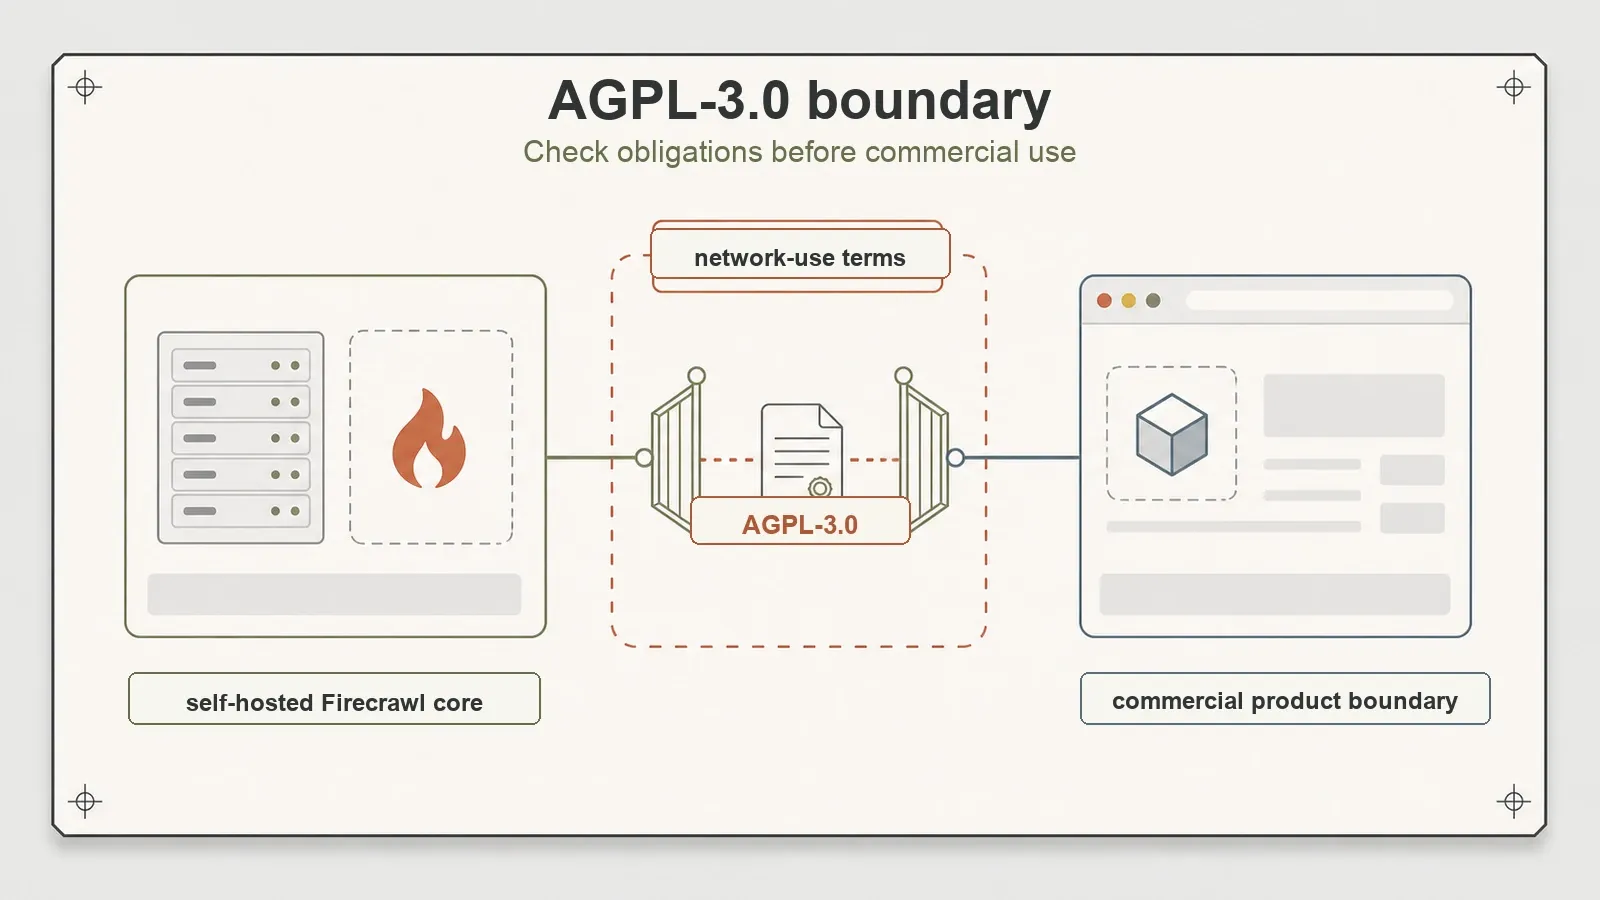
Firecrawl מורשה תחת AGPL-3.0. זו לא שורה זניחה בתחתית קובץ README – זוהי הגבלת העתקה חזקה עם סעיף שימוש ברשת, והיא יכולה להשפיע ישירות על האם תוכלו לבנות מוצר מסחרי על גבי מופע בהתקנה עצמית.
בקיצור: חובות GPL סטנדרטיות מופעלות בהפצה. AGPL הולך רחוק יותר – הוראת השימוש ברשת פירושה שהצעת פונקציונליות התוכנה למשתמשים דרך רשת יכולה להיחשב כסוג השימוש הנושא חובות זמינות קוד מקור. אם אתם משלבים Firecrawl בהתקנה עצמית בתוך שירות שלקוחותיכם מגיעים אליו דרך האינטרנט, סעיף זה נמצא במפורש בתחום, ו-"מעולם לא הפצנו בינארי" אינו פתח מילוט שאנשים מניחים שהוא.
אני לא עורך הדין שלכם, ופרשנות הרישיון תלויה באופן שבו אתם פורסים. אבל עבור כל המלצה מסחרית, AGPL-3.0 היא שיקול ראשון במעלה, לא אותיות קטנות. צרפו את מי שאחראי על רישוי בחברה שלכם לפני שאתם בונים על זה. ציון זה אינו פגיעה ב-Firecrawl – כלים מצוינים רבים הם AGPL – זו פשוט עובדה שאתם צריכים על השולחן מוקדם.
היכן משתלב ערימת המפתחים של Thunderbit
נסה את Thunderbit לחילוץ נתוני אינטרנט
אם המטרה האמיתית שלכם היא "דף ← Markdown מוכן ל-LLM" או "דף ← נתונים מובנים", ושאלת ששת הקונטיינרים התפעוליים בתוספת שאלת ה-AGPL אינן דברים שאתם רוצים להיות הבעלים שלהם, זהו בדיוק הפער שעבורו נבנתה ערימת המפתחים של Thunderbit. אותו מנוע AI מאחורי 100,000+ משתמשי ההרחבה שלנו, חשוף בשלוש דרכים לעבודה טכנית – כשהתשתית נשמרת בצד שלנו של הקו.
- Open API (REST).
POST /distillהופך דף ל-Markdown נקי ומוכן ל-LLM;POST /extractמחזיר נתונים מובנים מול JSON Schema שאתם מגדירים. עיבוד JS, טיפול באנטי-בוטים ותוכן דינמי מטופלים בצד השרת – אין קונטיינר דפדפן שאתם צריכים להפעיל. דגלrenderMode(none/basic/full) שולט במידת העיבוד, ונקודות קצה של אצווה מטפלות בעד 100 כתובות URL לזיקוק. - שרת MCP. שרת Model Context Protocol רשמי, כך שסוכן AI בתוך Claude או Cursor יכול לגרד באמצע משימה:
thunderbit_suggest_fieldsלתכנון חילוץ (חינם),thunderbit_distillעבור Markdown,thunderbit_extractעבור נתונים מובנים. הסוכן מחליט מתי למשוך נתונים מבלי לעזוב את סביבתו. - CLI.
npx -y @thunderbit/thunderbit-cliמריץ גירודים מהטרמינל, סקריפטים, CI או cron – ללא דפדפן, ללא ערימה לטפל בה. העבירו אותו ישירות לכלים אחרים:thunderbit distill "$URL" -f markdown | claude -p "summarise".
הניגוד ל-Firecrawl בהתקנה עצמית ברור. Firecrawl בהתקנה עצמית נותן לכם שליטה מלאה ובעלות תפעולית מלאה: שישה קונטיינרים, משקל ההתקנה, תנאי ה-AGPL, וללא Fire-engine לאנטי-חסימה. ה-API/MCP/CLI של Thunderbit מחליף את השליטה הזו במנוע מאוחסן שמחזיר JSON מובנה התואם לסכימה – לא רק Markdown גולמי – עם הקונטיינרים, שכבת האנטי-בוטים וחובות ה-copyleft שהוסרו מהצלחת שלכם. כלים שונים לתיאבון שונה לתשתית.
הנה היתרון והחיסרון בתצוגה אחת:
| שיקול | Firecrawl בהתקנה עצמית | ערימת מפתחים של Thunderbit (API · MCP · CLI) |
|---|---|---|
| צורת פריסה | שירות שאתה מפעיל (6 קונטיינרים) | API מאוחסן שאתה קורא לו |
| כדי להתחיל לפעול | docker compose מפעיל ערימה של 6 שירותים | מפתח API, ואז בקשה |
| עיבוד JS | playwright-service מצורף (אתה מפעיל אותו) | בצד השרת, דגל renderMode |
| פלט מובנה | דורש מפתח LLM (/extract, json) | POST /extract עם JSON Schema |
| שכבת אנטי-בוטים | אין בהתקנה עצמית (Fire-engine הוא רק בענן) | מטופל בצד השרת |
| רישיון | AGPL-3.0 (copyleft לשימוש ברשת) | API מסחרי, ללא copyleft על הקוד שלך |
| הטוב ביותר כאשר | אתה רוצה שליטה מלאה ותפעיל תשתית | אתה רוצה Markdown/נתונים מובנים ללא תפעול |
אף אחד מהם אינו "טוב יותר" באופן אוניברסלי. אם הפעלת הפלטפורמה היא העיקר עבורכם – שליטה מלאה בנתונים, ללא תלות חיצונית, ו-AGPL מתאים למצבכם – Firecrawl בהתקנה עצמית היא בחירה מוכשרת ומתוחזקת באופן פעיל. אם אתם מעדיפים לבצע קריאת API ולדלג על חיי ששת הקונטיינרים, זוהי ההצעה לערימת Thunderbit.
מי באמת צריך לארח את Firecrawl בעצמו
הסירו את ההייפ והתמונה ברורה מספיק כדי למיין לפי צורך.
אחסנו את Firecrawl בעצמכם אם אתם רוצים שליטה מלאה על תשתית הגירוד שלכם, אתם מרגישים בנוח להפעיל Redis / RabbitMQ / Postgres / FoundationDB בייצור, צרכי העיבוד שלכם מצדיקים את קונטיינר ה-playwright-service, ו-AGPL-3.0 מתאים לאופן שבו אתם פורסים. היכולת המרכזית אמיתית: קיבלתי Markdown נקי, מובנה ומוכן ל-LLM גם מדף סטטי וגם מדף שעובד ב-JS, וכל הערימה רצה על תמונות מוכנות מראש.
חפשו במקום אחר אם אתם רוצים סקריפט מקומי מהיר (זו ההתקנה הכבדה ביותר בבסיס, נקודה), אתם צריכים אנטי-חסימה ברמת ענן מבלי להפעיל אותה בעצמכם (לגרסה בהתקנה עצמית אין Fire-engine), או שסעיף השימוש ברשת של AGPL מתנגש עם התוכניות המסחריות שלכם. עבור המקרה של "אני רק צריך Markdown או נתונים מובנים מכתובת URL, ללא תפעול", API מאוחסן כמו /distill ו-/extract של Thunderbit מכסה את אותו שטח ללא הקונטיינרים.
הקריאה הראשונית שלי: ליבה חזקה, מחויבות תפעולית כבדה, ורישיון שאתם חייבים לאשר לפני בנייה מסחרית. הוא מרוויח את מקומו עבור צוותים שרוצים להיות הבעלים של כל הצינור – והוא דורש הרבה מכל השאר. אחזור לכך לאחר שאריץ את /v1/crawl, אפעיל את /extract עם מפתח LLM, ואאמת את הבנייה מהמקור על daemon שאינו colima; אלו הן השאלות הפתוחות בין זה לבין פסק דין סופי.
נסה את Thunderbit לחילוץ נתוני אינטרנט Get Started Free
שאלות נפוצות
האם Firecrawl בהתקנה עצמית זהה לגרסת הענן?
לא. התקנה עצמית נותנת לכם את מנוע הגירוד ל-Markdown המרכזי ועיבוד JavaScript באמצעות ה-playwright-service המצורף, אך היא אינה כוללת את Fire-engine, שכבת האנטי-חסימה הקניינית של מוצר הענן. תכונות AI כמו נקודת הקצה /extract ופלט json דורשות גם מפתח LLM משלכם (OpenAI או Ollama). בסקירה זו בדקתי רק את ערימת ההתקנה העצמית; ה-API בענן היה מחוץ לתחום.
כמה קונטיינרים Firecrawl בהתקנה עצמית באמת צריך? שישה: api, playwright-service, redis, rabbitmq, nuq-postgres, ו-foundationdb. זוהי ערימת שירות מלאה, לא בינארי בודד – וזו הסיבה שהיא הייתה ההתקנה הכבדה ביותר מכל כלי בבסיס מחקר זה. תכננו את התקורה התפעולית של הפעלת תשתית מתווך הודעות, מטמון ומסד נתונים, לא רק סקריפט.
האם Firecrawl יכול לטפל בדפים עתירי JavaScript כאשר הוא מותקן בעצמו? כן, בבדיקות שלי. ה-playwright-service המצורף מעבד דפים במנוע דפדפן אמיתי לפני החילוץ. אישרתי זאת ב-quotes.toscrape.com/js/, שם ציטוט איינשטיין – תוכן שקיים רק לאחר הרצת JavaScript – הופיע ב-Markdown שהוחזר. יכולת עיבוד זו היא בדיוק הסיבה שאחד מששת הקונטיינרים הוא דפדפן ללא ממשק משתמש.
האם רישיון AGPL-3.0 משפיע על שימוש מסחרי? הוא יכול, ואתם צריכים להתייחס אליו כשאלה ראשונה במעלה. AGPL-3.0 הוא copyleft חזק עם סעיף שימוש ברשת, מה שאומר שהצעת פונקציונליות התוכנה למשתמשים דרך רשת יכולה לשאת חובות זמינות קוד מקור – גם אם לעולם לא תפיצו בינארי. אם אתם מתכננים לבנות מוצר מסחרי על מופע בהתקנה עצמית, דברו עם מי שמטפל ברישוי בחברה שלכם לפני שאתם מתחייבים. סקירה זו מציינת את הרישיון; זו אינה עצה משפטית.
מה ההבדל בין Firecrawl לכלי המפתחים של Thunderbit?
Firecrawl בהתקנה עצמית הוא שירות שאתם מפעילים – שישה קונטיינרים שאתם מריצים בעצמכם, עם תנאי AGPL-3.0 וללא שכבת אנטי-חסימה מובנית. ערימת המפתחים של Thunderbit (Open API, שרת MCP, CLI) היא מנוע מאוחסן שאתם קוראים לו: POST /distill עבור Markdown, POST /extract עבור נתונים מובנים בפורמט JSON-Schema, עם עיבוד JS וטיפול באנטי-בוטים בצד השרת וללא חובת copyleft על הקוד שלכם. Firecrawl מתאים לצוותים שרוצים שליטה מלאה בתשתית; Thunderbit מתאים למי שרוצה את הפלט ללא העומס התפעולי.




