
Docling מופיע לא פעם ברשימות של כלי web scraping, אבל זו קטגוריה לא נכונה. זהו כלי להמרת מסמכים שפותח ב-IBM Research וכיום פועל כפרויקט של LF AI & Data Foundation. הוא מקבל קבצים שכבר נמצאים אצלכם — PDF, DOCX, PPTX, XLSX, HTML ותמונות — וממיר אותם ל-Markdown או ל-JSON. במילים אחרות: הוא מכין מסמכים לעבודה עם gen AI; הוא לא אוסף אותם מהאינטרנט.
הסקירה הזו בוחנת ממיר, לא crawler. כל המדידות בוצעו על מחשב יחיד ללא GPU, עם macOS arm64, Python 3.14.2 ו-Docling 2.111.0. התוצאות חושבו בסקריפטים, וגם כישלונות נספרו ככישלונות. המאגר משתנה כמעט מדי יום: בזמן הבדיקה היו לו 63,069 stars, 4,449 forks ו-push שבוצע באותו יום. לכן מספרי גרסאות ו-issues במאמר הם תמונת מצב, לא נתונים קבועים.
מה Docling עושה — ומה הוא לא עושה
יחידת העבודה המרכזית היא DoclingDocument. Docling מנתח קובץ למבנה הזה, ולאחר מכן אפשר לייצא ממנו Markdown, HTML, DocTags או JSON ללא אובדן מידע. הקוד מופץ ברישיון MIT, אף שלמודלים מסוימים עשויים להיות רישיונות נפרדים. הפרויקט התחיל ב-IBM Research Zurich, ובזמן הכתיבה הגרסה העדכנית הייתה v2.112.0, שפורסמה יומיים לפני הרצת הבדיקה.
היכולת המעניינת באמת נמצאת במסלול של PDF ותמונות. זה אינו parser פשוט של מחרוזות, אלא רצף של מודלי machine learning: מודל הפריסה RT-DETR, מודל מבנה הטבלאות TableFormer, מודל vision-language אופציונלי ו-RapidOCR למסמכים סרוקים. יחד הם משחזרים את פריסת העמוד, סדר הקריאה ומבנה הטבלה. בדיקה שמסתפקת ב-HTML לא תחשוף את היכולות האלה.
הגבול חשוב: Docling לא מביא תוכן מ-URL, לא מרנדר JavaScript, לא עוקף מערכות anti-bot ולא סורק אתר. המשתמש מספק את הקובץ, ו-Docling מפרש אותו. לכן הוא אינו תחליף ל-Firecrawl; ברוב מערכי העבודה שני הכלים ממלאים תפקידים שונים ומשלימים זה את זה.
עלות ההתקנה וההפעלה הראשונה
pip install docling הושלם ללא בעיה ב-Python 3.14.2, אבל סביבת ה-venv שנוצרה שקלה 1.3 GB. חבילת ברירת המחדל מתקינה את כל שכבת ה-ML כתלויות חובה, גם אם השימוש היחיד המתוכנן הוא המרת HTML.
| תלות | נפח בדיסק (MiB, לפי du) |
|---|---|
| torch (2.13.0) | 536 |
| opencv (cv2) | 119 |
| transformers (5.8.1) | 101 |
| scipy | 99 |
| sympy | 76 |
| pandas | 72 |
| rapidocr (+ bundled models) | 72.1 |
| docling_parse | 30 |
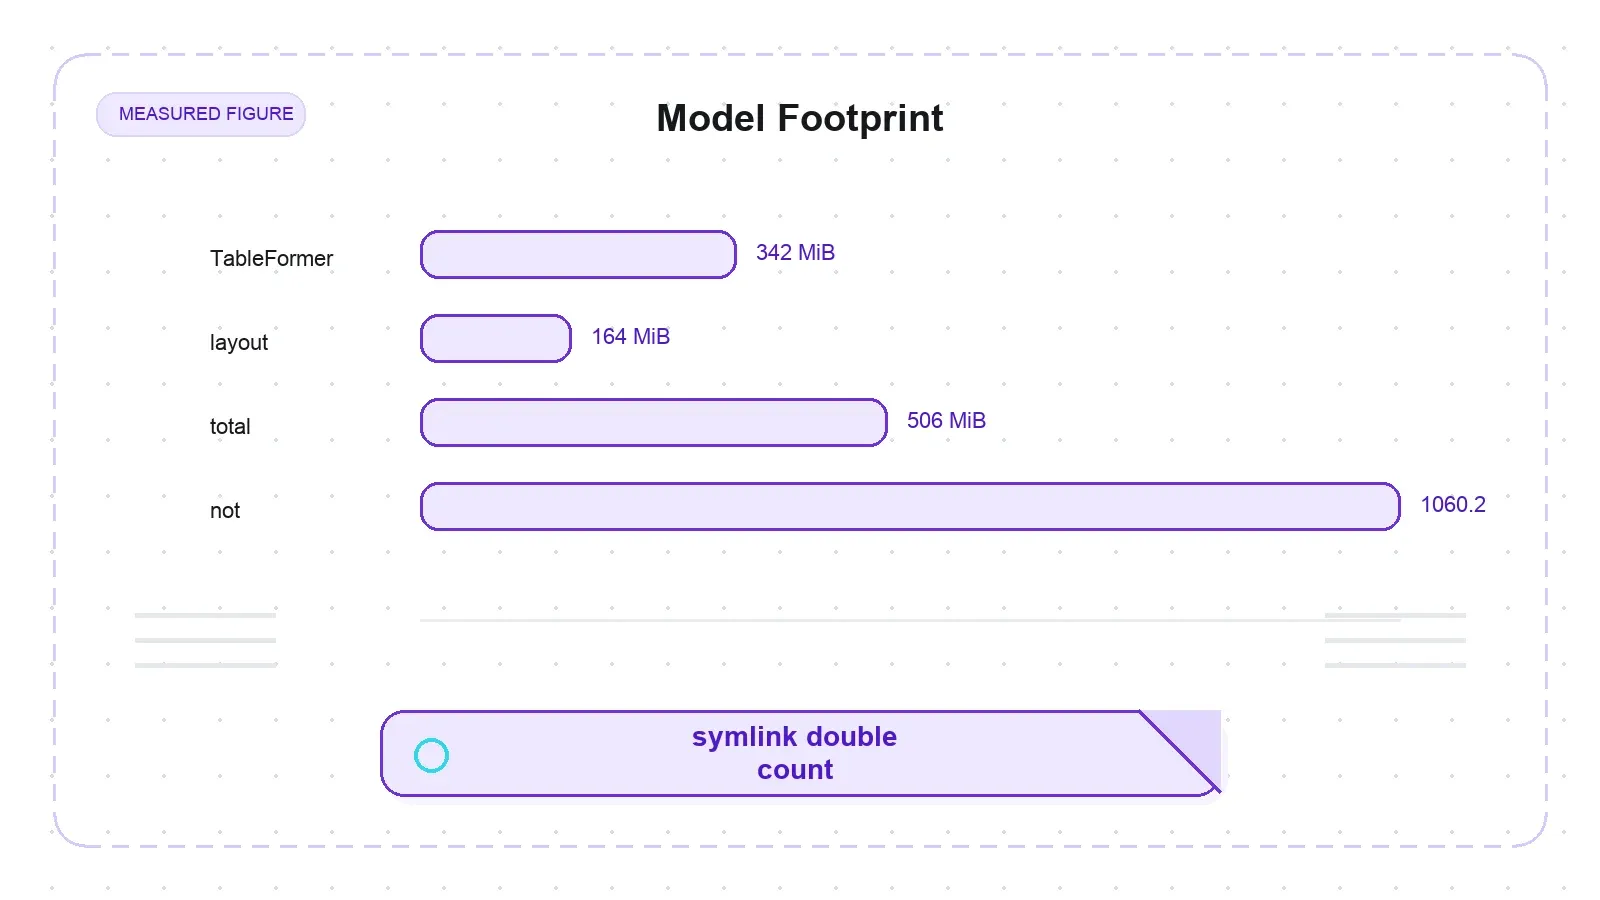
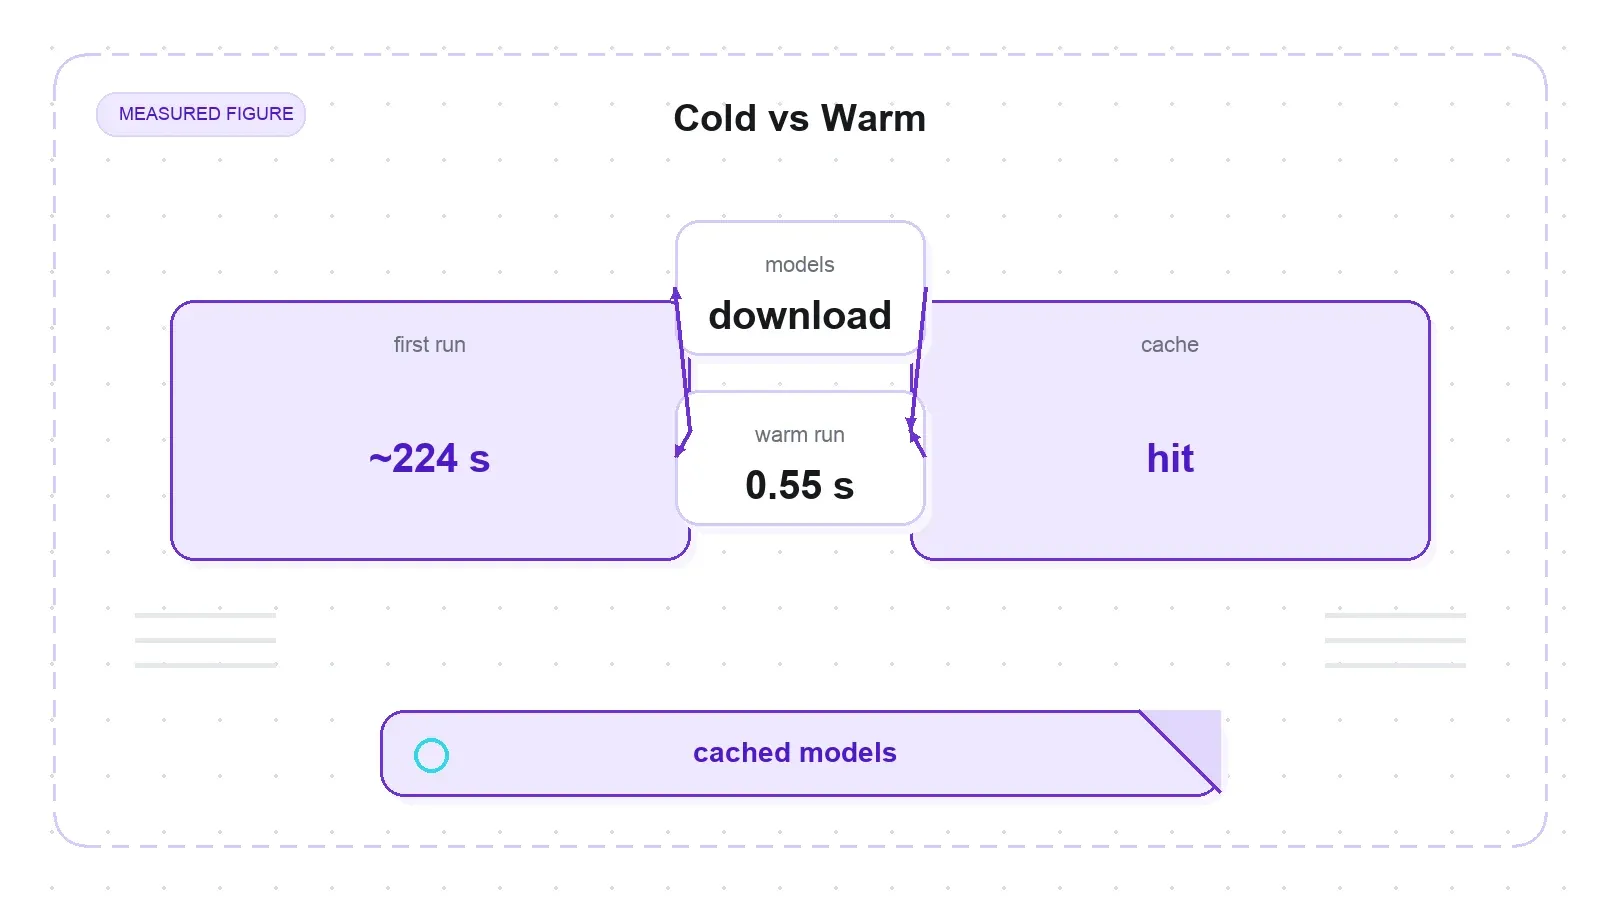
וזה עוד לפני המרת ה-PDF הראשון. בהרצה הראשונה Docling מוריד את המודלים, ולכן על cache חדש ומבודד של HuggingFace ההמרה הראשונה נמשכה כ-224 שניות. כמעט כל הזמן הוקדש להורדה, לא לחישוב. מודל הפריסה ו-TableFormer תפסו יחד כ-506 MiB בדיסק — 342 MiB ל-TableFormer ועוד 164 MiB לפריסה, לפי du. RapidOCR הוריד בנוסף כ-40 MB של משקלי PP-OCRv4 לתוך site-packages. ההמרה השנייה של אותו קובץ נמשכה 0.55 שניות בלבד, משום שהמודלים כבר היו ב-cache.
נתון אחד עלול להטעות: סקריפט ה-cold start דיווח על model_download_mb של 1060.2. זה אינו הנפח האמיתי. הסקריפט השתמש ב-os.walk שעוקב אחר symlinks; HuggingFace שומר כל קובץ פעם אחת תחת blobs/ וחושף אותו שוב דרך symlink תחת snapshots/. כך 14 קובצי מודל נספרו פעמיים. המדידה התואמת ל-du, לאחר הסרת הכפילות, היא כ-506 MiB; תיקיית ה-blobs לבדה שקלה 505.4 MiB. בבנצ'מרק נכון צריך לדווח בנפרד על נפח ההורדה ועל הנפח בדיסק.
ב-container יש עוד פרט תפעולי: המשקלים נשמרים בשני מקומות ובשני מועדים. מודלי הפריסה ו-TableFormer מכבדים את HF_HOME ויורדים בהמרת ה-PDF הראשונה. מודלי RapidOCR מתעלמים מהגדרת ה-cache ונשמרים ב-…/site-packages/rapidocr/models/. מי שבונה image מוכן מראש או סביבה ללא חיבור לרשת חייב לטפל בשני המיקומים; HF_HOME לבדו אינו מספיק.
עם זאת, יש חלופה קלה. הפרויקט מציע את docling-slim, ליבה של כ-50 MB. למשל, pip install docling-slim[format-html] מאפשר לעבוד עם HTML בלי להתקין torch. משקל ה-1.3 GB של חבילת docling הרגילה אמיתי, אבל כיום אפשר לבחור במסלול מודולרי; הנושא מתועד ב-issue #2393.
נתקלתי גם בחיכוך קטן למפתחים: import docling; docling.__version__ מחזיר AttributeError: module 'docling' has no attribute '__version__', משום שהמודול אינו חושף את הגרסה. הבדיקה שעובדת היא importlib.metadata.version("docling"), שהחזירה '2.111.0'. זהו עניין קטן של DX, שפתוח ב-upstream מאז יולי 2026 כ-issue #3733.
איכות הטבלאות: המקום שבו TableFormer מצדיק את עצמו
כדי לבדוק טבלאות יצרתי שבעה קובצי PDF עם ground truth קריא למכונה והשוויתי את התוצאה ברמת התא הבודד. השתמשתי בשני מדדים שונים. Cell recall מודד איזה חלק מערכי האמת הופיע במקום כלשהו בטבלה שזוהתה. In-row rate מודד איזה חלק מהם שובץ בשורה הנכונה. מדידה של recall בלבד הייתה מציגה תמונה מחמיאה מדי.
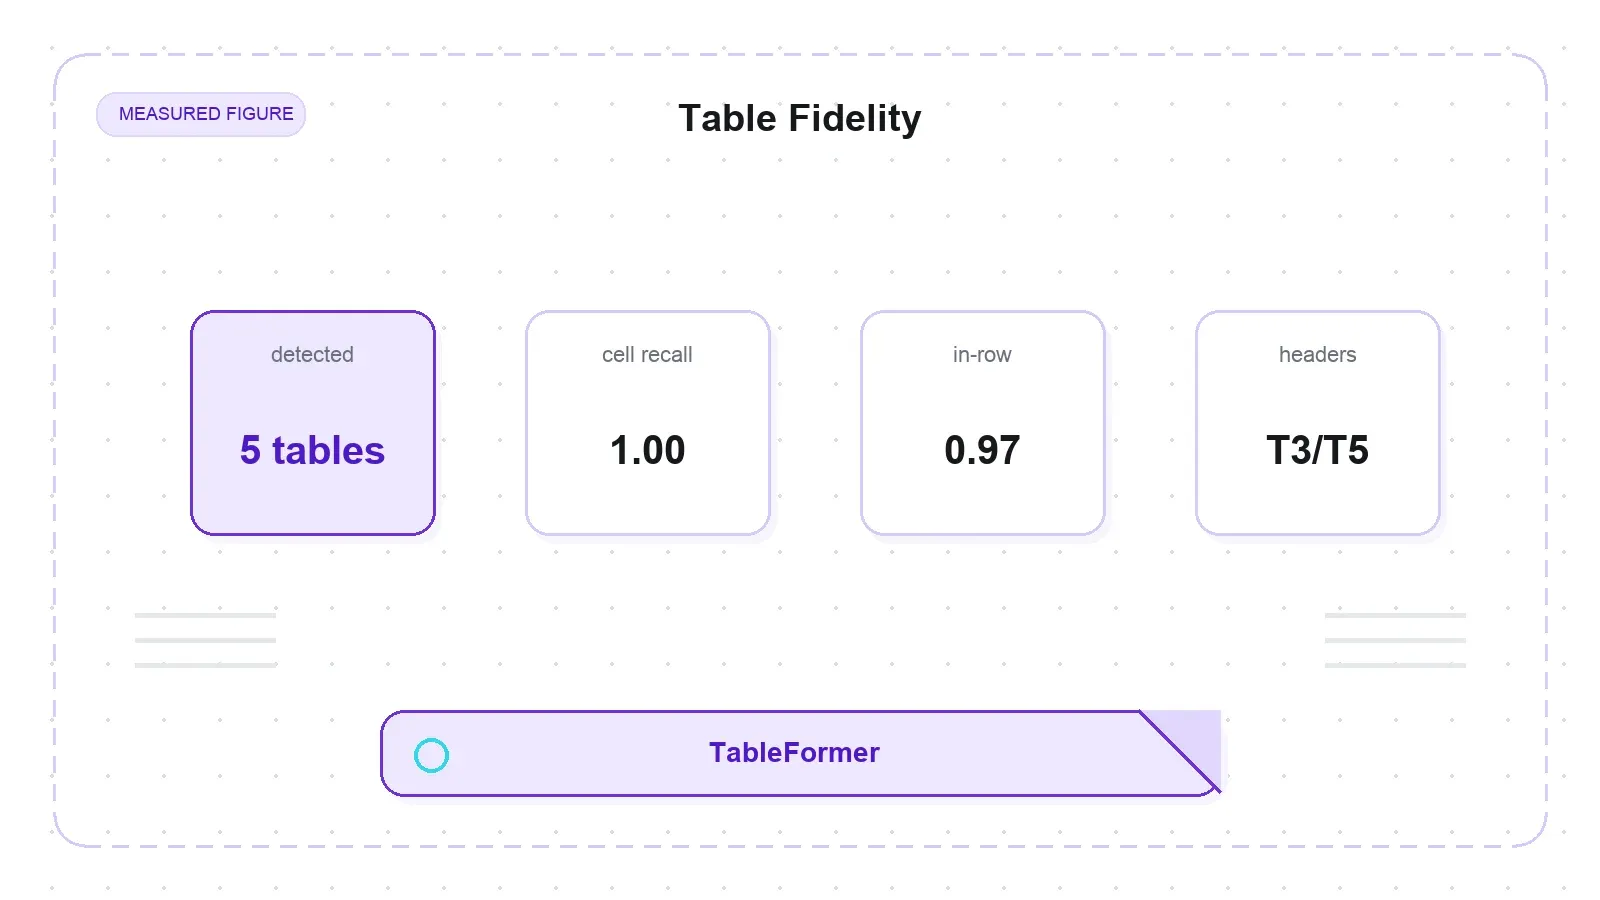
| טבלה ותנאי הבדיקה | זוהתה | Cell recall | In-row rate | הערה |
|---|---|---|---|---|
| T1 רשת פשוטה עם מסגרת (8 שורות × 5 עמודות), לבדה בעמוד | לא | 0.0 | — | סווגה כ-<!-- image -->; כל התאים אבדו |
| T2 ללא מסגרת, עם קו כותרת בלבד | כן | 1.00 | 1.00 | רשת מדויקת לחלוטין |
| T3 כותרת colspan ב-2 מפלסים | כן | 1.00 | 0.97 | כל הערכים נמצאו; ערך כותרת אחד זז שורה |
| T4 תווית שורה עם rowspan, לבדה בעמוד | לא | 0.0 | — | סווגה כ-<!-- image --> |
| T5 כותרת colspan ללא מסגרת | כן | 1.00 | 0.97 | כל הערכים נמצאו; אותה תזוזת כותרת כמו ב-T3 |
| T6 נתונים פיננסיים, עמודה ריקה ויישור לימין | כן | 1.00 | 1.00 | העמודה הריקה נשמרה ולא זזה |
| T7 רשת רחבה של 12 עמודות | כן | 1.00 | 1.00 | אין תזוזת עמודות גם בטבלה רחבה |
בכל חמש הטבלאות ש-Docling זיהה, כל ערכי ה-ground truth הופיעו: cell recall של 1.00 בכל המקרים. בשלוש מהן כל ערך גם נשאר בשורה הנכונה. ב-T3 וב-T5, שבהן כותרת רב-מפלסית, ערך כותרת אחד זז שורה ו-in-row rate ירד ל-0.97. כלומר הנתונים נשמרו, אך מיפוי השורה לא היה מושלם.
גם מבנים מורכבים יחסית עבדו היטב. כותרת colspan דו-מפלסית הושטחה נכון ל-GitHub-flavored Markdown: התווית “Q1 2026” חזרה מעל שתי העמודות שעליהן היא נפרשה. T2, ללא מסגרת מלבד קו הכותרת, נשמרה בדיוק. בטבלה בת 12 העמודות לא הייתה תזוזה, ועמודה פיננסית ריקה נשארה כתאים ריקים במקום להיעלם. התוצאה מתיישבת עם ציוני TEDS הרשמיים של TableFormer: 95.4 לטבלאות פשוטות, 90.1 למורכבות ו-93.6 בכלל המדגם, לעומת 73.0 ל-Camelot ו-88.3 ל-EDD בכרטיס המודל.
עם merged cells צריך להישאר מדויקים. Issue #3698 מתאר כשלים של V1 ו-V2 בשורות ובעמודות ממוזגות. בבדיקות כאן, colspan פשוט ב-T3 וב-T5 וערכי rowspan נשמרו, מלבד תזוזת הכותרת. ה-cases ב-#3698 עוסקים במיזוגים לא סדירים על פני כמה שורות ועמודות וב-טבלאות רב-עמודיות, שהם קצה קשה יותר. המסקנה המצומצמת היא שמיזוגים פשוטים עבדו בבדיקה הזו; מיזוגים מורכבים עדיין מתועדים כבעיה פתוחה.
המלכודת: טבלה לבדה בעמוד עלולה להיעלם
T1 ו-T4 לא זוהו כלל. Docling פלט <!-- image --> ואיבד את כל התאים, ללא שגיאה. T1 הייתה רשת רגילה של 8 שורות ו-5 עמודות. כדי להבין אם הבעיה נמצאת ב-TableFormer או בשלב מוקדם יותר, בניתי בדיקת A/B שבה אותו תוכן רונדר בשני הקשרים שונים.
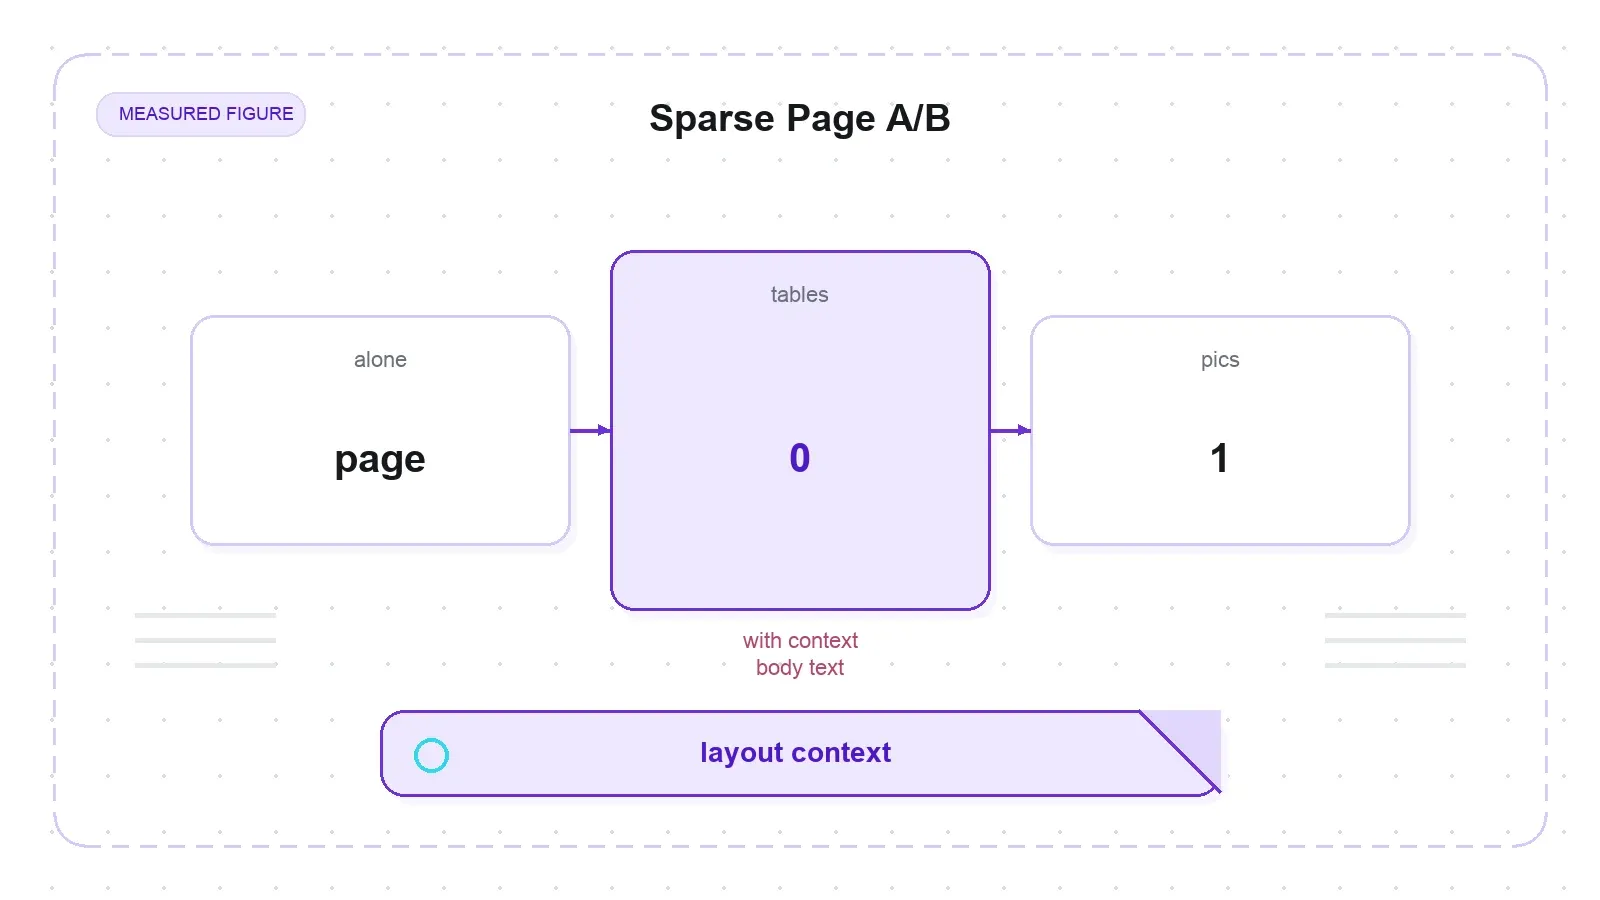
תחילה נשללו ההסברים הפשוטים. שכבת הטקסט הייתה תקינה: pypdfium2 קרא 327 תווים מ-T1 ו-221 מ-T4, ולכן אלה קובצי PDF דיגיטליים ולא סריקות. גם ביטול OCR באמצעות do_ocr=False לא שינה את התוצאה. בבדיקה ישירה של DoclingDocument התקבל len(doc.tables) == 0 לצד len(doc.pictures) == 1. מודל הפריסה סיווג את אזור הטבלה כולו כ-Picture.
בשלב הבא רונדרתי שוב את T1 ואת T4, הפעם עם כמה פסקאות רגילות מסביב. שתי הטבלאות זוהו במלואן: len(doc.tables) == 1, נוצרו טבלאות GFM תקינות, ותווית ה-rowspan North ב-T4b חזרה נכון בשלוש שורות. הטבלה עצמה לא השתנתה; המשתנה היחיד היה אם היא הופיעה לבדה בעמוד כמעט ריק או בתוך הקשר טקסטואלי.
לכן החולשה אינה בהכרח TableFormer. מודל הפריסה RT-DETR משתמש בהקשר העמוד, וטבלה קטנה בעמוד דל עלולה להיות מסווגת בשקט כתמונה. זהו תרחיש מציאותי לחשבוניות, דפי מפרט וייצוא חתוך. הפתרון המעשי הוא להוסיף הקשר לעמוד, או לבדוק לאחר ההמרה את doc.tables ולסמן כל עמוד שבו המספר אפס. התופעה קרובה ל-issue #3495, שבו טבלה מזוהה גם כ-Table וגם כ-Picture, אך את הטריגר הספציפי של עמוד דל — אותה טבלה נכשלת לבד ומצליחה בתוך טקסט — לא מצאתי מתועד. זו תוצאה מדודה, לא טענה שכל בעיות הטבלאות נפתרו.
OCR בסריקות אמיתיות: RapidOCR, לא EasyOCR
בדקתי שני מסמכים סרוקים עם שכבת טקסט של 0 תווים לפי מדידה. pypdfium2 לא הצליח להחזיר מהם שום תו, ולכן כל טקסט שהתקבל הגיע מ-OCR ולא משכבה נסתרת.
הקובץ החד-עמודי ocr_test.pdf הומר על CPU בתוך 14.3 שניות, והמשפט “Docling bundles PDF document conversion to JSON and Markdown in an easy self contained package,” שוחזר במדויק. בקובץ בן ארבעת העמודים nemotron_multipage.pdf, OCR הופעל בכל העמודים ונמשך 70.1 שניות בסך הכול, או 17.5 שניות לעמוד. לא נדרש flag או שינוי הגדרה; ברירת המחדל הופעלה אוטומטית.
הפרט שמתיישן בהרבה סקירות הוא שם המנוע. ברירת המחדל כיום היא RapidOCR, לא EasyOCR. אפשר היה לראות זאת בהורדת משקלי PP-OCRv4 בפורמט .pth בהרצה הראשונה. EasyOCR הוא כעת תוסף אופציונלי. האזהרה שכן נשארת נכונה היא ש-OCR הוא המסלול האיטי בקנה מידה גדול. המספרים כאן הם תקרת CPU; GPU צפוי לקצר אותם משמעותית.
סדר קריאה וזמן לעמוד במסמכי PDF אמיתיים
Fixtures סינתטיים מבודדים התנהגות, אך מסמך אמיתי בודק אם השרשרת כולה עובדת. הרצתי את הדוח הטכני של Docling, בן 9 עמודים, ואת “Attention Is All You Need”, בן 15 עמודים. שניהם PDF דיגיטליים בשתי עמודות, עם טבלאות ונוסחאות.
במאמר בן 15 העמודים הופיעו חמשת סמני הפרקים — Abstract, Introduction, Background, Conclusion ו-References — בסדר המקורי של המסמך בתוך ה-Markdown הליניארי. גם כל מילות הבדיקה, Transformer, encoder, BLEU ו-multi-head, נמצאו, וארבע טבלאות התוצאות מרובות העמודות זוהו כטבלאות. זו יכולת חשובה ל-RAG: אם linearizer מערבב שתי עמודות, גם ה-chunking שאחריו מאבד משמעות.
זמן העיבוד לעמוד הושפע מצפיפות המבנה יותר מאורך המסמך. הדוח הצפוף בן 9 העמודים נמשך 14.95 שניות לעמוד, לעומת 5.99 שניות לעמוד במאמר בן 15 העמודים. בדוח היו 3 טבלאות ב-9 עמודים ובמאמר 4 טבלאות ב-15 עמודים, אך בדוח היו יותר טבלאות ואיורים לכל עמוד, ולכן יותר inference של פריסה ו-TableFormer. זוהי הרצה אחת על CPU, ולכן כדאי לראות במספרים תקרה ניסויית ולא נתון production.
תמיכה בפורמטים והטענה ל-JSON ללא אובדן
כדי לבדוק את רוחב התמיכה יצרתי קובצי DOCX, XLSX ו-PPTX עם תוכן ידוע. בדקתי אם נקודות הבקרה מופיעות ב-Markdown ואם הן שורדות round trip ל-JSON דרך export_to_dict().
| קובץ | זמן המרה בשניות | נקודות בקרה שנמצאו ב-MD | מספר טבלאות ב-MD | נקודות הבקרה נשמרו ב-JSON |
|---|---|---|---|---|
report.docx (כותרות, טבלת "Total" ממוזגת ו-bullets) | 0.137 | 7/7 | 1 | כן |
workbook.xlsx (2 sheets ועמודה ריקה) | 0.016 | 6/6 | 2 | כן |
deck.pptx (3 slides, bullets וטבלה) | 0.038 | 6/6 | 1 | כן |
כל נקודות הבקרה הופיעו ב-Markdown. הטבלאות נשמרו, כולל שורת “Total” הממוזגת ב-DOCX ושני ה-sheets ב-XLSX, וכל הנקודות נשארו גם ב-JSON. זו ראיה לטענת ה-DoclingDocument ללא אובדן, לפחות בקבצים נקיים. פורמטים אלה משתמשים ב-backends ייעודיים ולא במודלי ה-ML, ולכן ההמרה נמשכת עשרות אלפיות שנייה ועובדת במצב offline. המדגם כלל קובץ נקי אחד לכל פורמט, ולא stress test לקובצי Office חריגים.
HTML: נאמן למסמך, לא נקי מתבנית האתר
Docling ממיר את כל מסמך ה-HTML ואינו מבצע main-content extraction בסגנון readability. כדי לכמת את ההבדל ספרתי שורות של ניווט, TOC, הודעת cookies ו-footer שנשארו בפלט.
| עמוד | שורות MD שאינן ריקות | שורות boilerplate | שיעור boilerplate | תחילת המאמר בשורה |
|---|---|---|---|---|
| Wikipedia "Web scraping" | 255 | 34 | 13.3% | 28 |
| scrapethissite/forms | 63 | 1 | 1.6% | — |
| books.toscrape | 65 | 0 | 0.0% | — |
| quotes.toscrape | 35 | 0 | 0.0% | — |
ב-Wikipedia, אתר עם הרבה chrome, כ-13% משורות ה-Markdown היו ניווט, תוכן עניינים או footer, והמאמר התחיל רק בשורה 28. הפלט נפתח ב-“move to sidebar / Contents / Toggle the table of contents” והסתיים ב-“CS1 maint… / Search Wikipedia”. בעמודים נקיים כמו books ו-quotes שיעור ה-boilerplate היה כמעט אפס. זו בעיית template chrome, לא תוספת קבועה בכל עמוד. Docling מחזיר Markdown נאמן למסמך המלא, לא מאמר נקי בלבד. הנושא מופיע ב-issue #1865 שנסגר וב-issue #1930 שעדיין פתוח.
חשוב גם לדייק מה פועל מאחורי הקלעים. בהמרת HTML אין שימוש במודלי ML; זהו backend של BeautifulSoup על pipeline פשוט. מודלי הראייה, הפריסה ו-TableFormer רלוונטיים ל-PDF ולתמונות. במסלול PDF כן נעשה ניסיון לסווג header ו-footer, ולכן הטענה ש-Docling לעולם אינו מסיר boilerplate תהיה רחבה מדי. הבעיה המתוארת כאן שייכת במיוחד ל-HTML backend.
Docling מול Firecrawl — ואיפה Thunderbit נכנס
נסו את Thunderbit לחילוץ נתוני Web
Firecrawl הוא הכלי שאליו משווים את Docling לעיתים קרובות. הטבלה הבאה היא השוואת מיצוב על בסיס מסמכי Firecrawl, לא benchmark על אותו מחשב. רק עמודת Docling מבוססת על המדידות שבוצעו כאן.
| ציר השוואה | Firecrawl, לפי התיעוד שלו | Docling, לפי המדידות כאן |
|---|---|---|
| תפקיד מרכזי | crawl ו-scrape של ה-web החי ל-Markdown | המרת מסמך שכבר נמצא אצלכם ל-Markdown או JSON |
| הבאת תוכן, רינדור JS ו-anti-bot | כן, באמצעות hosted browser | לא; המשתמש מספק את הקובץ |
| חילוץ התוכן המרכזי | כן | לא; נשמר המסמך המלא, כולל כ-13% chrome ב-Wikipedia |
| מבנה טבלאות PDF באמצעות ML | מוגבל | כן; TableFormer עם TEDS רשמי 93.6 ו-cell recall של 1.00, in-row 0.97–1.00 בטבלאות שזוהו |
| PDF סרוק ו-OCR | מוגבל | כן; RapidOCR כברירת מחדל שיחזר סריקה ללא שכבת טקסט |
| רוחב פורמטים | עמודי web | PDF, DOCX, PPTX, XLSX, HTML, EPUB ותמונות |
| פריסה | hosted API וגם self-host | ספריית pip מקומית, offline וללא API key |
| משקל ההתקנה | API key ו-client קל | התקנה רגילה של 1.3 GB ועוד כ-506 MiB מודלים, או docling-slim |
| רישיון | מסחרי / source-available | MIT |
אם המקור נמצא ב-web ודורש crawling, רינדור JavaScript וניקוי התוכן המרכזי, Firecrawl הוא הכלי המתאים. אם הקובץ כבר אצלכם, במיוחד PDF, סריקה או מסמך Office עשיר בטבלאות, Docling מספק המרה מקומית ששומרת מבנה ומבינה טבלאות ו-OCR. pipeline מציאותי יכול לסרוק עם כלי אחד ולהמיר מסמכים עם האחר.
Thunderbit שייך לצד של ה-web החי, לא לצד של המסמך המקומי. למפתחים הוא מציע AI scraping API, MCP server ו-CLI. POST /distill הופך URL ל-Markdown נקי ומוכן ל-LLM תוך טיפול ברינדור JS, anti-bot ו-CAPTCHA — פעולות ש-Docling אינו מבצע. POST /extract מחזיר JSON מובנה לפי JSON Schema שהוגדר מראש. לעמודי web אפשר להשתמש ב-API, בכלי MCP (thunderbit_suggest_fields, thunderbit_distill, thunderbit_extract) או ב-CLI (npx @thunderbit/thunderbit-cli). ל-PDF ולסריקות שכבר נמצאים בדיסק, Docling מתאים יותר. כשמאגר המקורות כולל את שני הסוגים, משלבים ביניהם.
פסק הדין: חזק בתחומו, עם בדיקות שחייבים להשלים
ציון יחיד מ-0 עד 100 היה מטעה, משום שהוא היה מעניש את Docling על יכולות שהוא אינו מתיימר לספק, כמו crawling. התוצאות לפי ממד ברורות יותר:
- התקנה והרצה ראשונה: כבדות — venv של 1.3 GB, כ-506 MiB מודלים, כ-224 שניות ל-PDF ראשון וכ-0.55 שניות לאחר חימום.
docling-slimמאפשר להימנע מהמסלול הכבד. - איכות טבלאות שזוהו: גבוהה במדגם; cell recall של 1.00 בחמש מתוך חמש הטבלאות שזוהו, ו-in-row של 0.97–1.00.
- עמידות הזיהוי: קיימת מלכודת sparse page. טבלה מבודדת יכולה להפוך ל-Picture, ולכן יש לבדוק את
doc.tables. - סריקות ו-OCR: עבדו היטב עם RapidOCR כברירת מחדל, אך זהו המסלול האיטי בקנה מידה גדול.
- מספר פורמטים: התוצאה טובה, כולל round trip תקין ל-JSON.
- HTML: נאמן למסמך אך אינו מחלץ רק את התוכן המרכזי.
- חוויית מפתח: API תמציתי ומבנה
DoclingDocumentנקי, למעט היעדר__version__ישיר.
Docling מתאים לצוותים שבונים RAG או data pipelines על PDF, סריקות וקובצי Office וצריכים המרה offline ששומרת מבנה. הוא פחות מתאים למי שצריך crawling של web חי או חילוץ מאמר נקי מתוך HTML; אלה משימות של כלי אחר.
היקף הבדיקה כאן מוגבל: שבע טבלאות סינתטיות ושני PDF אמיתיים על מחשב CPU יחיד, לא benchmark מלא בקנה מידה של TEDS. לפני הטמעה ב-production כדאי לבדוק גם את מסלול ה-VLM האופציונלי GraniteDocling, את הנפח בפועל של docling-slim, ביצועים על GPU, merged cells לא סדירים וטבלאות רב-עמודיות, דיוק המרת נוסחאות ל-LaTeX, וכן גידול זיכרון בעיבוד batch, סקיילינג של threads/GIL ומחזור החיים של אובייקטים לאורך אלפי המרות. המסקנה היא ש-Docling מספק תוצאות חזקות ומדידות בתחום שהוא מגדיר לעצמו, אבל יש לתקצב את ההורדה הראשונה, לזכור את מלכודת העמוד הדל ולמדוד בעצמכם התנהגות בקנה המידה שלכם.
נסו את Thunderbit לחילוץ נתוני Web Get Started Free
שאלות נפוצות
האם Docling הוא web scraper או crawler?
לא. Docling ממיר מסמכים שכבר נמצאים אצלכם — PDF, DOCX, PPTX, XLSX, HTML ותמונות — ל-Markdown או JSON. הוא אינו מביא URLs, אינו מרנדר JavaScript ואינו מטפל ב-anti-bot. crawling של web חי מתבצע בכלים כמו Firecrawl או web API של Thunderbit.
מה נפח ההתקנה וההורדה בהפעלה הראשונה?
חבילת docling הרגילה יוצרת venv של כ-1.3 GB, משום שכל שכבת ה-ML מותקנת כתלות חובה; torch לבדו תופס 536 MiB. בהמרת ה-PDF הראשונה יורדים כ-506 MiB של מודלי פריסה ו-TableFormer ועוד כ-40 MB של משקלי RapidOCR. ההרצה הראשונה נמשכה כ-224 שניות, כמעט כולן הורדה, וההמרה השנייה כ-0.55 שניות. לפורמטים קלים אפשר להשתמש בליבת docling-slim של כ-50 MB.
האם Docling מפעיל OCR, ובאיזה מנוע?
כן. בסריקת PDF ללא שכבת טקסט, OCR הופעל אוטומטית ושחזר את הטקסט היטב בבדיקה. ברירת המחדל היא RapidOCR, לא EasyOCR; EasyOCR הוא תוסף אופציונלי. בעבודה בקנה מידה גדול OCR הוא בדרך כלל המסלול האיטי, במיוחד על CPU.
למה Docling הפך טבלה לתמונה או העלים אותה?
הסיבה האפשרית היא sparse-page effect. מודל הפריסה RT-DETR משתמש בהקשר העמוד, ולכן טבלה קטנה לבדה בעמוד כמעט ריק עלולה להיות מסווגת כ-Picture ולהיעלם ללא שגיאה. אותה טבלה בתוך טקסט יכולה לעבור כראוי. אפשר להוסיף הקשר, או לבדוק את doc.tables לאחר ההמרה ולסמן עמודים שבהם המספר אפס.
Docling או Firecrawl — במה לבחור?
אלה תפקידים שונים. Firecrawl סורק את ה-web החי, מרנדר JavaScript ומחלץ תוכן מרכזי. Docling ממיר מסמכים שכבר נמצאים אצלכם, עם מבנה טבלאות PDF ו-OCR, ועובד offline. לעמודי web השתמשו בכלי web כמו Firecrawl או API/MCP/CLI של Thunderbit; ל-PDF, סריקות וקובצי Office השתמשו ב-Docling. מערכי עבודה רבים משתמשים בשניהם.




