
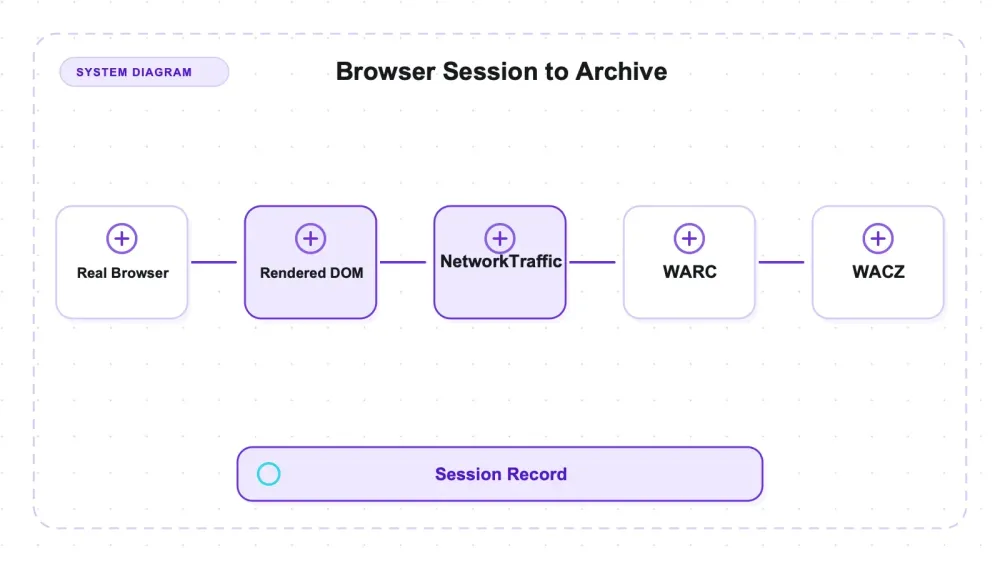
Browsertrix Crawler הוא הזחלן לארכוב של Webrecorder: תמונת Docker אחת שמריצה Chromium אמיתי דרך Puppeteer, מתעדת כל מה שהדפדפן שלף, וכותבת הכול ל‑WARC — פורמט הארכיון הסטנדרטי של הרשת — עם אפשרות לארוז את הכול כחבילת WACZ הכוללת אינדקס, רשימת דפים ולוגים. המטרה שלו היא בדיוק מה שמבדיל אותו מכלי web scraping שהוא דומה להם רק לכאורה. סקרייפר יוצא להביא נתונים ומוותר על הדף ברגע שיש לו את השדות; ארכיבר שומר את הביקור עצמו — הבתים, הכותרות, סדר ההגעה שלהם — כך שאפשר לפתוח את הדף מחדש גם הרבה אחרי שהאתר השתנה או נעלם. Webrecorder מתחזקת את שכבת התשתית הזו של הרשת, כולל הפורמטים ומנגנון ההפעלה מחדש, עוד הרבה לפני שארכוב נראה כמו קטגוריית מוצר, ומוסדות, מערכות חדשות וחוקרים נשענים עליו.
הרצתי את v1.14.0 בתוך Docker מול fixture מקומי עם ארבעה סוגי נקודות קצה שנבנו בכוונה להיות שונים, ובדקתי את שני צדי הסריקה: רשומות WARC עבור תוכן הארכיון ומונה פניות בצד השרת עבור בקשות בפועל. ההבחנה החשובה לא הייתה רק בין סטטי לדינמי. Browsertrix תפס קישור שנוצר בזמן ריצה ו‑fetch() שנשלח על ידי העמוד, אבל הוא לא ביקש שתי כתובות לוגיות שהופיעו בתוך פונקציית JavaScript שלא הופעלה.
הקובץ המקושר app.js כן אוחסן במלואו, כולל שני הנתיבים הלוגיים, אבל אף אחד מהקצוות האלה לא יצר רשומת תגובה, רשומת בקשה או פנייה לשרת. הפונקציה שהכילה אותם פשוט לא רצה. לכן המאמר הזה בוחן את Browsertrix כארכיבר של סשן דפדפן, לא כמלאי של כל URL שמוזכר בקוד המקור.
מהו Browsertrix Crawler בפועל
לא מעט אנשים מגיעים מצפים לסקרייפר ועוזבים מאוכזבים. שום דבר בברירת המחדל של הצינור הזה לא ייתן לכם CSV של מחירי מוצרים, ולצפות לזה זה קצת כמו לצפות ממצלמת דרך שתפיק דוח תנועה. הפלט הוא תיעוד שניתן להפעלה מחדש של סשן גלישה, וכל החלטת עיצוב בהמשך נגזרת מזה.
בדקתי את v1.14.0 ב‑27 ביולי 2026: webrecorder/browsertrix-crawler:latest עם digest sha256:9d6800a8…, כשהפקודה crawl --version מאשרת את ה-build. הפרויקט הוא AGPL-3.0. כל המדידות רצו בתוך Docker דרך Colima על macOS arm64 מול ה‑fixture המקומי המבוקר; מונה הפניות בצד השרת סיפק ראיה בלתי תלויה בלוגים של Browsertrix ובניתוח הארכיון.
ל‑AGPL-3.0 מגיעה התייחסות נפרדת. זהו copyleft חזק עם תנאי שימוש ברשת. אם Browsertrix Crawler אמור לשבת בתוך מוצר מסחרי ולא להיות מופעל ככלי עצמאי, כדאי שמישהו יקרא את הרישיון כמו שצריך לפני ההפצה. זו נורה אדומה, לא ייעוץ משפטי.
הארכיון מתעד את הסשן, לא את קוד המקור
ה‑fixture שלי סיפק ארבעה סוגי נקודות קצה, מופרדים במכוון כי ארכיבר מתייחס אליהם בצורה שונה לגמרי:
- Class A —
<a href>רגיל ב‑HTML. ארבעה דפים ושרשרת עומק של שלוש רמות. כל זחלן בעולם ימצא את אלה. - Class B — לוגיקות URL בתוך פונקציה שלא רצה. שני נתיבים,
/api/js-endpoint-7ו‑/api/js-endpoint-8, שמופיעים כמחרוזות בתוךloadData()שלא הופעלה בתוךapp.jsמקושר. - Class C — קישור שנבנה בזמן ריצה. תגית
<a href>שהורכבה מחלקים ב‑JavaScript ('endpoint' + (6 * 7)) והוזרקה ל‑DOM. הנתיב הרציף/runtime-only/endpoint42לא מופיע באף בייט שמוגש מהשרת. - Class D —
fetch()שהעמוד באמת שולח. נתיב שהורכב באותו אופן ('runtime-xhr-' + (33 * 3)), ואז נשלח בפועל בעת טעינת העמוד.
במחלקות C ו‑D, הנתיבים המלאים לא הופיעו כמחרוזות רציפות בקבצים המוגשים. הפניות בצד השרת ורשומות התגובה שלהם הן לכן הוכחה לכך שהבניית זמן הריצה ונתיבי הבקשה אכן הופעלו ב‑fixture הזה.
מה נלכד ומה לא
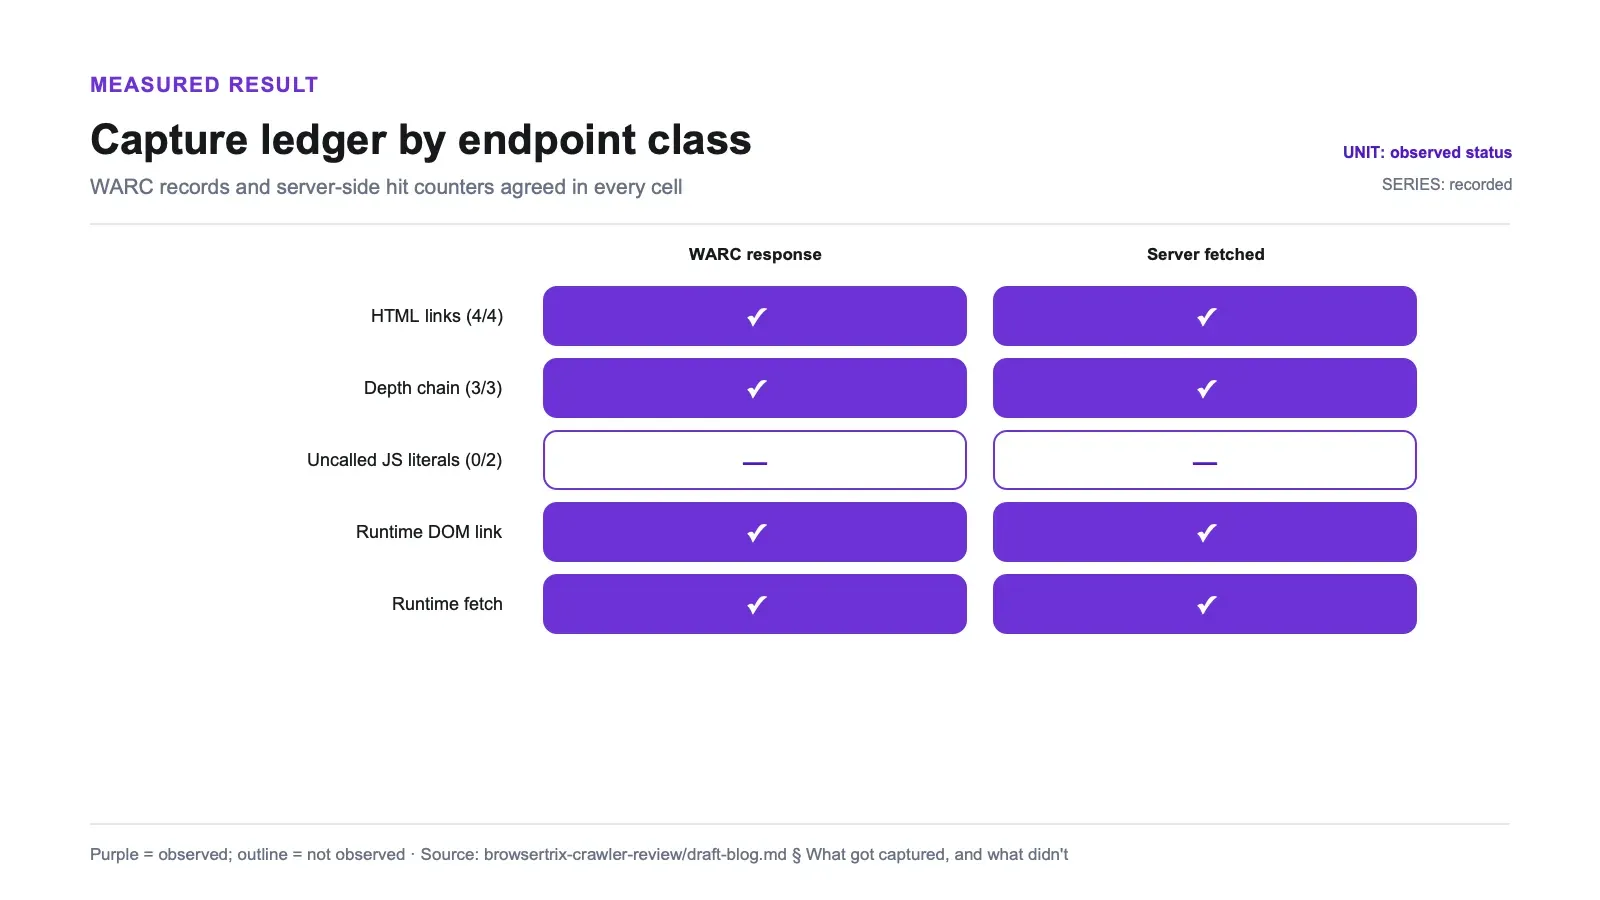
שני מכשירי המדידה, שנבדקו זה מול זה בכל תא: רשומות תגובה ב‑WARC (מה יש בארכיון) ומונה הפניות בצד השרת שמבוסס על (Host header, path) (מה באמת התבקש). הם הסכימו בכל מקום.
| מחלקת נקודת קצה | רשומת תגובה ב‑WARC | נשלף בפועל (בצד השרת) | מסקנה |
|---|---|---|---|
A — HTML <a href> | 4/4 | 4/4 | נלכד |
| A — שרשרת עומק (3 רמות) | 3/3 | 3/3 | נלכד |
| B — לוגיקת URL ב‑JS שלא רצה | 0/2 | 0/2 | לא נלכד |
| C — קישור שהוזרק בזמן ריצה | כן | כן | נלכד |
D — fetch() בזמן ריצה | כן | כן | נלכד |
מחלקה C היא זו שמבדילה בין דפדפן אמיתי לבין זחילה סטטית. חילוץ הקישורים כברירת מחדל קורא את ה‑DOM המוצג (a[href]->href, לפי תיעוד האפשרויות הנפוצות), כך שקישור שמופיע רק אחרי ש‑JavaScript רץ עדיין ייכנס לתור, יישלף ויאורכב. מחלקה D נכנסת מסיבה אחרת — העמוד עצמו שלח את הבקשה, והארכיבר יושב על נתיב הרשת ומתעד כל מה שעובר בו.
גבול כנה אחד לגבי מחלקה C: הקישור שלי הוזרק סינכרונית בזמן טעינת העמוד. קישורים שמופיעים מאוחר יותר, במהלך behaviors של Browsertrix, הם מקרה נפרד, ויש על כך issue פתוח — #723, "Links on pages that are discovered during behaviors are not extracted". לא בדקתי את התרחיש הזה, ולכן לא טענתי לגביו דבר.
הקובץ נארכב. נקודות הקצה לא.
האישור שהחמצת Class B היה אמיתי דרש מעבר רשומה־אחר־רשומה בתוך ה‑WARC, ולא ספירה מסכמת.
app.js כן נמצא בארכיון — רשומת תגובה אחת, גוף JavaScript בגודל 222 בייט — ושתי המחרוזות של Class B מופיעות בו ככתבן. לעומת זאת, אף אחד מהנתיבים /api/js-endpoint-7 או /api/js-endpoint-8 אינו URI יעד של ולו רשומה אחת בכל הקובץ: אפס רשומות תגובה, אפס רשומות בקשה. כל מחרוזת ליטרלית מופיעה בדיוק פעם אחת בכל הארכיון, ושתי ההופעות נמצאות בתוך גוף הקובץ השמור של app.js.
זה שולל את ההסבר המשעמם (“app.js פשוט לא נשלף”). הארכיבר שמר את הקובץ שמפנה לנקודות הקצה האלה ולא שלח בקשה אליהן, כי loadData() לא נקראה. ברירות המחדל של Browsertrix היו פעילות — autoplay, autofetch, autoscroll, siteSpecific — וגם autofetch לא הציל אותן, וזה הגיוני אם קוראים מה autofetch עושה: הוא מחפש img srcset, גיליונות סגנון ו‑URLs מסוג data-*, לא מחרוזות ליטרליות שקבורות בתוך גוף פונקציות.
לשם השוואה באותו fixture, הרצתי גם את Katana v1.6.1 כ‑katana -u <seed> -jc -silent -nc -d 4. סיכום הגילוי הגולמי שלו מציג תוצאה הפוכה על שתי מחלקות ה‑JavaScript שבנינו בכוונה:
| מה רוצים למצוא | Browsertrix v1.14.0 | Katana v1.6.1, -jc סטנדרטי |
|---|---|---|
| קישורים ב‑HTML שמוגש | נמצא | נמצא |
| קישור שהוזרק ל‑DOM בזמן ריצה | נמצא (חילוץ מתוך DOM מוצג) | הוחמץ בלי headless |
fetch() שהעמוד באמת שולח | נמצא (נרשם כתעבורת רשת) | הוחמץ — שום דבר לא רץ |
| לוגיקת URL ב‑JS שלא רצה | הוחמץ (0/2) | נמצא (2/2 על אותו fixture) |
| קובץ ה‑JS שמכיל את המחרוזת | אוחסן במלואו | נותח, אך לא נשמר |
שתי הפקודות השתמשו באותו fixture ובאותם שמות נקודות קצה. הטבלה אינה דירוג כללי של דפדפן מול זחילה סטטית; היא מראה למה גילוי נקודות קצה ושימור סשן דורשים בדיקות כיסוי שונות.
"דפדפן אמיתי, אז הוא תופס הכול ש‑JavaScript עושה" הוא משפט שתראו חוזר בלא מעט כתבות. זה מוגזם. הוא תופס תעבורה שבוצעה בפועל. קוד שמפנה ל‑URL בלי לקרוא לו לעולם לא יוצר תעבורה, ובלי תעבורה אין רשומה.
גופי הרפליי קיימים, עם דבר אחד שלא בדקתי
עבור שתי נקודות הקצה שנוצרו בזמן ריצה, שלפתי מתוך ה‑WARC את גופי התגובה ה‑HTTP השמורים ואישרתי שהם מכילים את ה‑JSON שהוגש: 206 בייט ליעד של הקישור שהוזרק בזמן ריצה, 201 בייט ליעד של fetch() בזמן ריצה. כלומר, אלה לא מצביעי אינדקס ריקים — התוכן עצמו נמצא בארכיון, וזה תנאי מקדים לכך שרפליי יוכל להגיש אותו.
מה לא עשיתי הוא להעלות pywb או replayweb.page ולרנדר את הארכיון. גוף קיים בארכיון ורפליי נכון שמוצג כמו שצריך הם שני דברים שונים, והבדיקה הזו מכסה רק את הראשון. התנהגות רפליי, בקרות אותנטיות, שרשרת שמירה ואמינות ראייתית דורשות אימות נפרד.
לכידת ייצור צריכה מבחן קבלה רחב יותר
ה‑fixture עונה בצורה נקייה על שאלה צרה: האם קישור סינכרוני שנוצר בזמן ריצה ובקשה שנשלחה על ידי העמוד הפכו לתעבורת רשת ולרשומות ארכיון? משימת שימור אמיתית בדרך כלל יכולה להיכשל בעוד כמה דרכים ועדיין להפיק WACZ תקין.
צריך להתחיל מרפליי. פתחו את החבילה במערכת הרפליי שבאמת תשתמשו בה להשוואה מול סט קבוע של דפים מול הפניה מזמן הלכידה. בדקו טקסט מוצג, תמונות, סגנונות, ניווט וכל אינטראקציה שרלוונטית לרשומה. אחר כך בדקו את פאנל הרשת של הדפדפן ברפליי כדי לזהות משאבי משנה שחסרים. גוף תגובה יכול להיות קיים ב‑WARC ועדיין הרפליי ייכשל כי שכתוב, אינדקסים, תזמון, מקורות או תלויות לא יושבים יחד. הסקירה הזו לא חצתה את הגבול הזה.
התנהגות דינמית ראויה לסט fixture משלה. קישור Class C כאן הופיע סינכרונית בזמן טעינת העמוד. יישומים אמיתיים עשויים לחשוף תוכן אחרי טיימרים, גלילה, סגירת חלון הסכמה, שינויי route, רכיבים מותאמים או שרשראות API ארוכות. יש לשתול יעד ידוע מאחורי כל behavior שאתם תלויים בו ולאמת גם את הפנייה לשרת וגם את הגוף ששמור בארכיון. ברירות המחדל של Browsertrix הן קלט שימושי לבדיקה הזו, לא הוכחה לכך שכל מצב מושהה אכן הושג. issue #723 חשוב במיוחד אם קישורים מופיעים במהלך behaviors ולא במהלך ביצוע העמוד הראשוני.
לכידות מאומתות מוסיפות שאלות של סשן. ודאו שמצב ההתחברות נכנס לפרופיל הדפדפן, שורד את הניווטים הדרושים, ולא דולף לאוספים שאמורים להיות מבודדים. הפעילו רענון טוקנים ונתיבי logout. אם הארכיון מכיל חומר פרטי או אישי, בדקו בקרות גישה ושמירה על הקבצים המתקבלים כחלק מאותו תכנון קבלה. לכידה מלאה מבחינה טכנית עדיין עלולה להיות מנוהלת לא נכון אחרי האיסוף.
Service workers, מדיה זורמת, WebSockets, הורדות, frames בין‑מקוריים ו‑signed URLs — כל אחד מהם צריך דף מייצג אם הוא חשוב ליעד. ה‑fixture בן 11 הדפים לא אומר עליהם כלום. הוא גם לא קובע איך הזחלן מתנהג כשדף נשאר פעיל דקות, שולח בקשות אחרי חלון ה‑settle הרגיל או דורש מחוות משתמש. אל תהפכו את "Chromium אמיתי" לטענת כיסוי גורפת; הגדירו אילו התנהגויות דפדפן האוסף חייב לשמר, והפכו כל אחת מהן לניתנת לצפייה.
ולבסוף, שמרו את הראיות הדרושות לאבחון החמצות. שימרו את digest המדויק של התמונה ואת הפקודה, את לוגי Browsertrix, את רשימות הדפים, את האינדקסים, את checksum של WARC/WACZ, ראיות בקשות בצד השרת כשיש, ו‑manifest קטן של ground truth. בלכידות חוזרות, תעדו זמן, קונפיגורציה וסביבה לצד הארטיפקט. הרשומות האלה לא יוצרות קבילות משפטית, אבל הן הופכות טענה טכנית לשחזורית וחושפות האם הבדל מאוחר יותר נבע מהיעד, מהזחלן או מסטאק הרפליי.
כמה עלה ה‑fixture הזה בבייטים
ה‑fixture הזה מגיש רק כמה מאות בייטים לכל דף, ולכן אין להשליך את יחסיי התקורה שלו על אתרים כבדי נכסים. בתוך הטווח הצר הזה, מדדתי את הרכב הארכיון ולא רק את הגודל הסופי:
| סוג רשומת WARC | כמות | בייטים של תוכן | נתח |
|---|---|---|---|
request | 14 | 6,912 | 40.6% |
response (מטען העמוד בפועל) | 13 | 5,339 | 31.4% |
resource (JSON מסוג urn:pageinfo:, אחד לכל דף) | 11 | 4,527 | 26.6% |
revisit (קישור מת שכבר הוסר בדופליקציה) | 1 | 154 | 0.9% |
warcinfo | 1 | 92 | 0.5% |
| סך תוכן הרשומות | 40 | 17,024 | 100% |
ספירות וסך הבייטים לפי סוג מופיעים ב‑capture-summary.json הציבורי; האחוזים מחושבים לפי סך של 17,024 בייט של תוכן רשומות.
בריצה הזו, שבה גופי התוכן קטנים מאוד, רשומות הבקשה גברו על תוכן התגובה, והבייטים של הבקשות יחד עם urn:pageinfo: היו בערך פי 2.1 ממטען התגובה. זה מתאר את תמהיל הרשומות של ה‑fixture הזה, לא יחס WARC כללי.
על הדיסק, בשלוש ריצות מבודדות:
| מדד | מינימום | חציון | מקסימום |
|---|---|---|---|
| זמן ריצה כולל של הסריקה (שניות) | 28.22 | 29.75 | 30.27 |
| WARC.gz בבייטים | 24,174 | 24,250 | 24,262 |
| WACZ בבייטים | 53,446 | 53,523 | 53,533 |
| מטען תגובה שנלכד (בייטים) | 5,339 | 5,339 | 5,339 |
אם לוקחים חציונים, מתקבלים ארבעה יחסים:
| מדד נגזר (חציונים) | ערך |
|---|---|
| WARC דחוס מול מטען התגובה שנלכד | פי 4.5 |
| WACZ מול מטען התגובה שנלכד | פי 10 |
| WARC לכל דף | ~2.2 KB |
| WACZ לכל דף | ~4.9 KB |
ובתוך ה‑WACZ עצמו:
| רכיב WACZ | נתח מהחבילה |
|---|---|
| WARC | 45% |
| אינדקס CDX | 16% |
| לוג הסריקה | 30% |
השורה האחרונה היא זו שהפתיעה אותי. כמעט שליש מחבילת הארכיון, בסריקה קטנה, הוא תיעוד הסריקה ולא הרשת עצמה.
המדידה הייתה יציבה: מטען התגובה חזר זהה בבייטים בכל שלוש הריצות (5,339 B בכל פעם), בעוד ש‑WARC.gz ו‑WACZ השתנו בפחות מ‑0.4%.
היחסים האלה לא עוברים אחד לאחד לדפים אמיתיים עם תמונות, פונטים וחבילות JavaScript גדולות. אבל הנקודה המבנית כן עוברת: רשומות בקשה ו‑page-info יוצרות תקורה שאינה תלויה בגודל המטען. מדדו מדגם מייצג לפני תכנון אחסון לייצור; אל תכפילו את יחס ה‑10× של ה‑fixture בהערכת קורפוס.
ההתקנה, והדיסק שכדאי לתכנן עבורו
ברגע ש‑Docker או Colima מותקנים ופועלים, ההתקנה הספציפית ל‑Browsertrix היא docker pull webrecorder/browsertrix-crawler:latest, ואז docker run … crawl --url … --generateWACZ. התמונה כוללת Chromium, כך שלא היה צורך בדפדפן נפרד או בסביבת Python.
מה העלות של הנוחות הזו, בריצות שנמדדו כאן:
| על מה צריך לתקצב | נמדד |
|---|---|
| הורדת התמונה | ~1 GB |
| התמונה לאחר פריסה על הדיסק | 3.51 GB |
עץ crawls/ (WARCs, WACZs, נתוני פרופיל דפדפן) אחרי כמה ריצות של 11 דפים על fixture שמגיש כמה קילובייטים של תוכן | ~116 MB |
| זמן שעון, סריקת fixture של 11 דפים | 28–30 שניות |
המכולה היא המקום שבו החיכוך יושב, והשורה של הורדה ופריסה היא המחיר של צרור דפדפן. הרצתי עם --shm-size 1g, ומכיוון שה‑fixture שלי ישב על המארח בזמן שהסריקה רצה במכולה, הייתי צריך גם --add-host=host.docker.internal:host-gateway וגם fixture שמקושר ל‑0.0.0.0 במקום ל‑loopback. אם אתם סורקים את הרשת הציבורית תדלגו על שלב הרשת הזה, אבל אם אתם מאחסנים משהו על המחשב שלכם או על שרת staging פנימי, תכננו לזה חצי יום.
ספריית הפלט היא השורה שהכי קל לזלזל בה. אקסטרפולציה של הצמיחה הזו לסריקה אמיתית, ותכננו אחסון לפני שמתחילים — לא אחרי שהדיסק מתמלא בשלוש בלילה.
סביר שהעלאת הדפדפן תורמת באופן מהותי לסריקה של 11 דפים בלבד שנמשכת 28–30 שניות, אבל לא בידדתי את זמן ההפעלה מזמן הניווט או האריזה. אין מכאן מסקנת תפוקה לדף.
תכנון אחסון בלי להתעלל ביחסי ה‑fixture
הדרך הנכונה לתמחר אוסף היא אמפירית. בוחרים דפים שמייצגים את ההתפלגות האמיתית של היעד: מעטפות יישום דקיקות, דפי נחיתה עתירי תמונות, הורדות מסמכים, מאמרים ארוכים ותצוגות מאומתות אם הן חלק מההיקף. לוכדים כל מחלקה עם ההתנהגויות והגדרות האריזה המתאימות. מודדים מטען תגובה, WARC, WACZ, אינדקסים, לוגים, שאריות של פרופיל הדפדפן וכל workspace זמני שנשאר במהלך הריצה. שימוש שיא בדיסק חשוב לא פחות מהחבילה הסופית אם האריזה שומרת זמנית כמה עותקים במקביל.
יש להפריד בין רכיבים קבועים ומשתנים. תמונת הקונטיינר בגודל 3.51 GB היא תקורת פריסה שיכולה להתחלק בין הרבה לכידות על אותו worker. רשומות בקשה, רשומות page-info, אינדקסים ורשימות דפים גדלים עם פעילות הסריקה. גופי תגובה תלויים מאוד ביעד, בעוד שלוגים תלויים באורך הריצה ובמידת הוורבוזיות. מדיניות שמירה ושכפול מכפילות אחר כך את האוסף הסופי בנפרד מהתנהגות הסריקה. מודל קיבולת שמקבץ את הכול ל"בייטים לדף" יהיה שביר.
דחיסה והסרת כפילויות גם הן דורשות תוכן מייצג. מטען התגובה של ה‑fixture הזה היה זהה בבייטים בשלוש ריצות, אבל זה לא מתאר דפים עם פרסומות משתנות, חותמות זמן, תגובות מותאמות אישית או כתובות נכסים עם cache-busting. אם לכידות חוזרות הן חלק מהתוכנית, מדדו לכידות עוקבות של אותם דפים ובדקו רשומות revisit במקום להניח שדפים שנראים זהים אכן ניתנים לדדופ יעיל. באותה מידה, בדקו אם לוגים ואינדקסים נשמרים באותה רמת שכפול כמו מטען השימור.
מבחינה תפעולית, קבעו ספי אזהרה לפני תחילת האוסף. עקבו אחרי שטח פנוי, צמיחה לפי אוסף, כישלונות באריזה וגודל פרופילי הדפדפן או ספריות זמניות. הפעילו תרגולת שחזור מתוך ה‑WACZ השמור, לא רק בדיקת checksum. היחסים שלמעלה שימושיים כי הם מגלים אילו רכיבים קיימים; המדגם המייצג הוא זה שאומר לכם כמה גדולים הם יהיו עבור האתר שלכם.
תעדו את ההנחות האלה לצד הערכת הקיבולת וחזרו אליהן אחרי סריקת הפיילוט.
משמעת היקף, נבדקה עם שני בקרות
זחלני ארכוב שנודדים הם סיכון תפעולי אמיתי — אפשר להסתיים גם בבעיה משפטית וגם בחשבון אחסון באותו זמן. דף הבית שלי קישר ל‑http://outofscope.test:<port>/page/out, hostname אחר שמצביע לאותו fixture, כך שפנייה עם Host header כזה הייתה מוכיחה שליפה מחוץ להיקף בלי שום תעבורה לאינטרנט האמיתי.
| תצורה | האם נשלף host מחוץ להיקף? | פניות בצד השרת |
|---|---|---|
--scopeType prefix (ברירת המחדל) | לא | 0 |
--scopeType any | כן | 2 |
השורה השנייה היא מה שהופך את הראשונה למשמעותית. תחת any הקישור נגש פעמיים, כך שהוא היה נגיש — האפס תחת ה‑prefix scope בברירת המחדל הוא משמעת היקף אמיתית, לא קישור שהזחלן פשוט פספס. יש דיווח פתוח על ביקורים מחוץ להיקף בתצורות אחרות, #788, שלא שיחזרתי תחת prefix ברירת המחדל על ה‑fixture הזה. טוב לדעת שזה קיים; לא טוב שאטען שראיתי את זה.
העמידות הייתה לא מרשימה במובן הטוב. נתיב שהחזיר HTTP 500 וקישור שבור שניהם נשלפו, הסריקה הסתיימה בצורה נקייה עם WARC ו‑WACZ תקינים, והקישור המת נשמר כרשומת revisit כפולה במקום להפיל משהו.
יתרונות וחסרונות
יתרונות
- לוכד קישורי DOM שהוזרקו בזמן ריצה וקריאות
fetch()של העמוד — שניהם אושרו גם בארכיון וגם בצד השרת, בנתיבים שלא מופיעים בשום מקום כליטרלים. - HTML סטטי וניווט עומק הושלמו במלואם: 4/4 קישורים, 3/3 בשרשרת העומק, בלי החמצות.
- ברגע ש‑Docker/Colima פעלו, פקודת
docker runאחת יצרה WARC ו‑WACZ; Chromium הגיע עם התמונה. - היקף
prefixכברירת מחדל החזיק עם אפס שליפות מחוץ להיקף;anyהרחיב כפי שמסומן בתיעוד, כך שהמתג אכן עושה מה שהוא מבטיח. - הפלט הוא ארכיון מבוסס תקן (WARC, ארוז כ‑WACZ עם אינדקס CDX ורשימת דפים) ולא blob קנייני.
- ארכיונים כמעט דטרמיניסטיים: מטען זהה בבייטים בשלוש ריצות, וגודל על הדיסק השתנה בפחות מ‑0.4%.
- התנהגות כשל נקייה: נתיב 500 וקישור שבור לא עצרו את הסריקה.
חסרונות
- לוגיקות URL ב‑JavaScript שלא רץ פשוט לא מתגלות (0/2), גם כשהקובץ שמכיל אותן כן מאורכב. זה נכון לפי התכנון, ועדיין פער כיסוי אמיתי אם המטרה היא גילוי נקודות קצה.
- טביעת רגל כבדה: כ‑1 GB להורדה, 3.51 GB על הדיסק, ותיקיות פלט שגדלות מהר.
- התקורה בבייטים משמעותית על דפים קטנים — בקשה יחד עם pageinfo חרגו ממטען התגובה, וכ‑30% מה‑WACZ היה לוג הסריקה.
- AGPL-3.0 אומרת שעבודת ציות אמיתית דרושה לשילוב מסחרי.
- זה לא כלי לנתונים מובנים. אין סכימה, אין מיפוי שדות, ואין בסוף שורות נקיות.
- תפוקה לדף מתונה מטבעה, כי כל דף עובר דרך דפדפן אמיתי.
מי צריך להפעיל אותו, ומי לא
Browsertrix מיועד לצוותים שהארטיפקט הנדרש שלהם הוא ארכיון של משאבים שנשלפו על ידי דפדפן, ולא שורות שחולצו. ב‑fixture הזה, גופי תגובה שנשלפו בזמן ריצה היו נוכחים ב‑WARC ונארזו ל‑WACZ. ספריות, חדרי חדשות וחוקרים הם משתמשים סבירים, אבל אימוץ בייצור צריך לבדוק בנפרד רפליי מוצג, אימות, service workers, זרימות הסכמה, התנהגויות מושהות, נכסי streaming ובקרות שמירה, וכל דרישת טיפול בראיות.
דלגו עליו אם מה שאתם באמת צריכים הוא נתונים. אם המטרה היא "תביאו לי כל מוצר ומחיר מ‑400 הדפים האלה כגליון אלקטרוני", ארכיבר הוא דרך משונה להגיע לשם — תארכבו ג׳יגה־בייטים ואז עדיין תצטרכו לכתוב קוד חילוץ מול קבצי WARC. דלגו גם אם אתם ממפים surface של API באפליקציה, כי תוצאת Class B אומרת במפורש ש‑parser סטטי של JavaScript ימצא נקודות קצה ש‑Browsertrix בכלל לא נוגע בהן. ואם Docker לא בא לכם טוב או שאתם עובדים במקום שבו תמונת 3.5 GB היא בעיה, זה לא הכלי שיתכופף עבורכם.
הרשאה ושמירה
בקרות היקף אינן מספקות הרשאה. הגדירו מראש hosts מורשים, מדיניות שמירה וגישה לארכיון לפני סריקה, במיוחד כשבלכידות מתמשכות עשוי להיכלל מידע אישי. בדיקת prefix/any מראה ששינוי קונפיגורציה משנה את טווח הרשת; היא לא קובעת איזה טווח מותר מבחינה חוקית עבור אוסף מסוים.
סקירה קשורה: הצד המשפטי של web scraping וארכוב.
חלופות לפי סוג הפלט הנדרש
בחרו לפי הארטיפקט. Browsertrix מכוון לשימור ב‑WARC/WACZ. ספריית אוטומציה לדפדפן כמו Playwright נותנת page שניתן לתכנת, אבל משאירה לכם את אריזת הלכידה. זחלני גילוי נקודות קצה מונים URLs, בעוד שכלי חילוץ מחזירים טקסט או רשומות מובנות. הקטגוריות האלה יכולות לחלוק דפדפן ועדיין לפתור משימות שונות.
סקירה קשורה: סקירת Heritrix.
גילוי נאות: Thunderbit הוא המוצר של המוציא לאור ולא נבדק ב‑fixture הזה של Browsertrix. הוא שייך לקטגוריית החילוץ המנוהל, ומפיק טקסט עמוד או נתונים מובנים במקום ארכיון מבוסס תקן. הסקירה הזו תומכת רק בגבול הפלט, לא בטענת ביצועים או יכולת השוואתית.
נסו את Thunderbit לחילוץ נתוני רשת
מסקנה
השתמשו ב‑Browsertrix Crawler כשפלט היעד הוא לכידת WARC/WACZ ו‑Chromium בקונטיינר מתאים לפריסה. ב‑fixture הזה, רשומות הארכיון והפניות בצד השרת הסכימו לגבי DOM בזמן ריצה שנבנה סינכרונית ו‑fetch שנשלח על ידי העמוד, היקף prefix ברירת המחדל חסם את host השני, ונתיבי כשל לא מנעו יצירת ארכיון תקין.
לפני שימוש בייצור, אמתו רפליי, התנהגות מושהית, סשנים מאומתים, service workers, הרכב האחסון על דפים מייצגים, וחובות רישוי. גבול הבדיקה כאן צר יותר: הפניות בקוד שמעולם לא רצות לא יצרו לא בקשה ולא רשומת ארכיון ליעד שלהן, גם כשהסקריפט המכיל אותן נשמר.
נסו את Thunderbit לחילוץ נתוני רשת Get Started Free
שאלות נפוצות
מה ההבדל בין WARC ל‑WACZ כאן? WARC מכיל את רשומות הבקשה, התגובה והקשרים הנלווים שנלכדו. WACZ עוטף את WARC יחד עם אינדקסים, רשימות דפים, מטא־דאטה ולוגים עבור הפצה וכלי רפליי. הסקירה הזו בדקה את שני הפורמטים, אבל לא ביצעה רנדר לרפליי.
איך כדאי להעריך אחסון? מדדו דפים מייצגים ושימרו את ההרכב המלא של ה‑WACZ, כולל לוגים ואינדקסים, במדגם. היחסים במאמר הזה נובעים מגופי תגובה קטנים במיוחד ואינם מתאימים להכפלה לפי כמות URL בייצור.
האם הוא יסטה מהאתר שאליו כיוונתי אותו?
לא בהגדרת ברירת המחדל, בבדיקות שלי. עם --scopeType prefix, קישור ל‑hostname אחר נשלף אפס פעמים; מעבר ל‑--scopeType any שלף אותו פעמיים, מה שמוכיח שהקישור היה נגיש ושאפס השליפות בברירת המחדל נבע ממשמעת היקף אמיתית. יש דיווח פתוח upstream על ביקורים מחוץ להיקף בתצורות אחרות שלא שיחזרתי תחת ברירת המחדל, אז בדקו את הגדרות ההיקף שלכם במקום להניח.
מה צריך לבדוק לפני שטוענים לנאמנות רפליי? טענו את ה‑WACZ במערכת הרפליי המיועדת והשוו דפים מוצגים, אינטראקציות ומשאבי משנה נדרשים מול הלכידה החיה או המדגמית. נוכחות גוף ב‑WARC היא הכרחית, אבל היא לא מאמתת רפליי מוצג בפני עצמה.
האם Browsertrix הופך עמוד מאורכב לשורות מובנות? לא. הפלט שלו הוא חבילת ארכיון, לא טבלה של שדות נבחרים. אם התוצר הנדרש הוא מוצרים, מחירים, אנשי קשר או סכימה אחרת, עדיין צריך שלב חילוץ אחרי הלכידה — או כלי אחר שהפלט העיקרי שלו הוא נתונים מובנים.




