
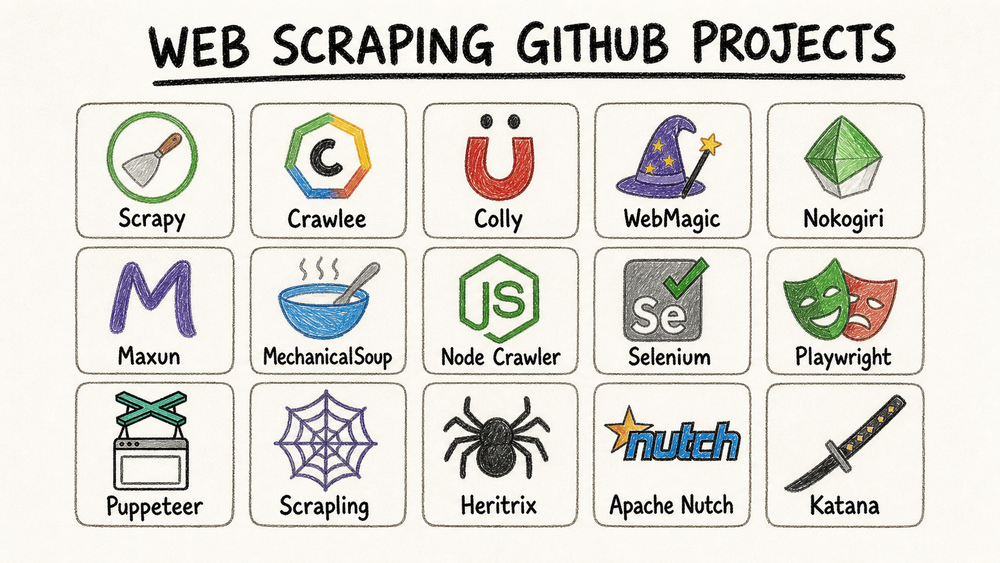
האינטרנט עדיין מלא בנתונים בעלי ערך גם ב‑2026, אבל לרוב הצוותים לא באמת צריך "סקרייפר" באופן כללי. הם צריכים תשובה מעשית לאחת משלוש שאלות: איזה פרויקט קוד פתוח עדיין שווה לבנות עליו, איזה סטאק מסוגל להתמודד עם אתרים מודרניים עתירי JavaScript, והאם מי שאינו מפתח צריך לדלג בכלל על GitHub ולעבור במקום זאת לזרימת עבודה ללא קוד.
העדכון הזה נבנה בדיוק סביב מסלול ההחלטה הזה. בדקתי מחדש דפי ריפוזיטורי ציבוריים ב‑GitHub, ספירות כוכבים ופעילות ב‑commit feed ב‑6 באוגוסט 2026, ואז השוויתי את הפרויקטים שלמטה לפי מורכבות ההקמה, תמיכה ב‑JavaScript, סימני תחזוקה, נוחות ייצוא והתאמה לקהל היעד.
התשובה הקצרה
- בחרו ב‑Scrapy אם אתם רוצים את מסגרת ה‑Python הבשלה ביותר לסריקה מובנית בהיקף גדול.
- בחרו ב‑Crawlee אם הצוות שלכם עובד ב‑JavaScript או TypeScript ורוצה סטאק אחד גם ל‑HTTP וגם לסריקה מבוססת דפדפן.
- בחרו ב‑Playwright או Puppeteer אם האתר כבד ב‑JavaScript והדרישה האמיתית היא אוטומציה מלאה של דפדפן.
- בחרו ב‑Maxun אם אתם רוצים שכבת No‑Code בקוד פתוח, ויזואלית וניתנת לאירוח עצמי, במקום לכתוב קוד סריקה מאפס.
- בחרו ב‑Heritrix, Apache Nutch או Katana רק אם זו משימה מתמחה: סריקת ארכיון, סריקה מבוזרת או איסוף מידע לצורכי אבטחה.
- בחרו ב‑Thunderbit אם אתם לא באמת מנסים לבנות משהו על GitHub, אלא פשוט רוצים נתונים מהירים ל‑Sheets, Airtable, Notion, CSV או JSON.
נסו סקרייפר ללא קוד לפני שאתם מתחייבים לסטאק קוד
השוואה מהירה
כוכבי GitHub וסימני ה‑last commit שלמטה נבדקו מול דפי ריפוזיטורי ציבוריים ו‑commit feeds ב‑6 באוגוסט 2026.
| פרויקט | שפה / מודל | הקמה | תמיכה ב‑JS | הכי מתאים ל | כוכבי GitHub | סימן ל‑Last Commit |
|---|---|---|---|---|---|---|
| Scrapy | מסגרת Python | בינונית | אין תמיכה מקורית ב‑JS | ספיידרים בקנה מידה גדול, ecommerce, חדשות | 63.7k | 6 באוגוסט 2026 |
| Crawlee | מסגרת Node.js / TypeScript | בינונית | כן | סריקה סטטית + דינמית באותו סטאק | 25.2k | 6 באוגוסט 2026 |
| Maxun | פלטפורמת No‑Code בקוד פתוח | בינונית בפריסה, קלה למשתמשים | כן | משתמשים עסקיים שרוצים שליטה של קוד פתוח | 17.1k | 5 באוגוסט 2026 |
| MechanicalSoup | ספריית Python | קלה | לא | טפסים, סשנים ואתרים סטטיים פשוטים | 4.9k | 4 באוגוסט 2026 |
| Node Crawler | סורק Node.js | בינונית | לא | סריקה סטטית מהירה ואיגוד פידים | 6.8k | 18 ביוני 2026 |
| Heritrix | סורק ארכיון ב‑Java | מתקדמת | לא | ארכוב אתרים ולכידה בהיקף דומיין | 3.3k | 5 באוגוסט 2026 |
| Apache Nutch | סורק מבוזר ב‑Java | מתקדמת | לא | סריקה בסגנון מנוע חיפוש וביג דאטה | 3.3k | 5 באוגוסט 2026 |
| Selenium | אוטומציית דפדפן רב‑שפתית | בינונית | כן | תהליכים עתירי אינטראקציה ונאמנות דפדפן | 34.3k | 6 באוגוסט 2026 |
| Playwright | אוטומציית דפדפן רב‑שפתית | בינונית | כן | אתרים דינמיים מודרניים וסקריפטים חזקים | 94.1k | 6 באוגוסט 2026 |
| Puppeteer | אוטומציית דפדפן ב‑Node.js | בינונית | כן | אוטומציה וסריקה שמבוססות Chrome קודם כול | 95.4k | 6 באוגוסט 2026 |
| Scrapling | ערכת סריקה חמקנית ב‑Python | בינונית | כן | סריקה מבוססת דפדפן עם רגישות לאנטי‑בוט | 72.8k | 30 ביולי 2026 |
| Katana | סורק Go / CLI | בינונית | אופציונלי, headless | סריקת אבטחה וגילוי כתובות URL | 17.3k | 5 באוגוסט 2026 |
| Colly | מסגרת Go | בינונית | לא | סריקה סטטית עם ביצועים גבוהים | 25.4k | 18 ביוני 2026 |
| WebMagic | מסגרת Java | בינונית | אין תמיכה מקורית ב‑JS | צינורות סריקה כלליים ב‑Java | 11.7k | 20 בדצמבר 2025 |
| Nokogiri | מנתח Ruby | קלה | לא | אפליקציות Ruby וזרימות ניתוח מותאמות אישית | 6.3k | 3 באוגוסט 2026 |
| Thunderbit | הרחבת Chrome עם AI וללא קוד | plug and play | כן | צוותים לא טכניים שרוצים נתונים שימושיים מהר | N/A | מוצר מנוהל, מעודכן באופן רציף |
לפני שבוחרים פרויקט GitHub, כדאי לשאול אם בכלל רוצים זרימת עבודה עם קוד
Thunderbit הוא לא פרויקט GitHub, ודווקא בגלל זה הוא שייך למדריך ההחלטה הזה. חלק גדול מהאנשים שמחפשים "best web scraping GitHub projects" לא באמת רוצים לתחזק סטאק של סורק. הם רוצים היום נתונים מובנים מאתר חי.
Thunderbit הוא המסלול הכי נקי ממחקר סריקה שמבוסס קוד לביצוע שמוכן לעסק:
- מתאים במיוחד ל: איתור לקוחות פוטנציאליים במכירות, ניטור ecommerce, איסוף נתוני נדל״ן, מחקר גיוס עובדים ועבודת תפעול שמבוססת דפדפן.
- מה בולט בו: הצעת שדות מבוססת AI, העשרה של תתי‑עמודים, טיפול בדפים דינמיים וייצוא ל‑Sheets, Airtable, Notion, CSV ו‑JSON בלי לכתוב לוגיקת סריקה.
- מה לשים לב אליו: אם העבודה שלכם היא פלטפורמת סריקה פנימית ארוכת טווח עם תשתית מותאמת אישית, מסגרת קוד פתוח עדיין תיתן יותר שליטה.
אם אתם רוצים לראות את המסלול ללא קוד לפני שאתם מחליטים להישאר בתוך GitHub, ההדגמה הנוכחית של Thunderbit היא בדיקת המציאות המהירה ביותר:
נסו את Thunderbit AI Web Scraper בחינם
איך הערכתי את פרויקטי ה‑GitHub האלה לסריקה
לא כל פרויקט GitHub לסריקה באמת בר‑השוואה. חלקם מסגרות מלאות. חלקם ספריות אוטומציית דפדפן. חלקם מנתחים. חלקם סורקים נישתיים שנבנו לארכיונים או לצוותי אבטחה.
כדי לשמור על הרשימה שימושית, נתתי עדיפות לפרויקטים שעדיין עומדים בארבעה מסננים מעשיים:
- יש מאחוריהם עדיין מציאות שוק.
כמות כוכבים גבוהה בלבד לא מספיקה, אבל אימוץ נמוך לצד תחזוקה מיושנת הוא בדרך כלל סימן רע. - יש להם עדיין תנועה נראית לעין בפרויקט.
בעדכון הזה בדקתי מחדש פעילות ציבורית של commit feeds ב‑6 באוגוסט 2026 במקום להסתמך על מספרים ישנים מסיכומי עבר. - הם פותרים משימת סריקה אמיתית.
השמטתי ריפוזיטוריז נאים אך לא ברורים, שלא מתאימים טוב לזרימות עבודה עסקיות או מחקריות אמיתיות. - הם שונים מספיק כדי להיכנס לרשימה מצומצמת.
המטרה היא לא להטיל עליכם 50 ריפוזיטוריז, אלא לעזור לכם לבחור בין מסגרות, סטאקים לדפדפן, כלים בקוד פתוח ללא קוד וסורקים מתמחים.
ממדי ההשוואה הם אותם אלה שבדרך כלל מכריעים הצלחה או כישלון בפועל:
- מורכבות הקמה: כמה מהר משתמש חדש יכול להגיע לסריקה עובדת.
- תמיכה ב‑JavaScript: האם הפרויקט מסוגל להתמודד עם אתרים מודרניים שמרונדרים בצד הלקוח.
- בריאות הפרויקט: האם הריפוזיטורי עדיין נראה חי מספיק כדי לסמוך עליו.
- טיפול בנתונים: האם הפרויקט מפיק פלט מובנה או משאיר לכם יותר עבודה.
- התאמה לקהל היעד: האם הפרויקט באמת מיועד למתחילים, למהנדסי דאטה, לצוותי אבטחה או למפעילים לא טכניים.
מורכבות הקמה: כמה מהר אפשר להתחיל?
הטקסונומיה של ההקמה עדיין מחזיקה, אבל המסגור השימושי ב‑2026 פשוט יותר:
- Plug and play: Thunderbit למשתמשים עסקיים; MechanicalSoup או Nokogiri לסקריפטים קלים שמבוססי קוד.
- בינונית: Scrapy, Crawlee, Maxun, Selenium, Playwright, Puppeteer, Colly, Katana, Scrapling, WebMagic ו‑Node Crawler כולם דורשים קצת קוד, CLI או עבודה של פריסה.
- מתקדמת: Heritrix ו‑Apache Nutch הגיוניים רק אם אתם באמת צריכים ארכוב או סריקה מבוזרת מבוססת Java.
Maxun ראוי כאן לאזכור מיוחד, כי הוא יושב בדיוק באמצע. הפלטפורמה עצמה דורשת פריסה, אבל חוויית המשתמש הקצה קלה הרבה יותר מעבודה ישירה מול Scrapy או Playwright.
תמיכה בתוכן דינמי: אילו פרויקטים באמת מתמודדים עם הרשת המודרנית?
אתרים מודרניים מלאים ב‑React, ב‑Vue, ב‑infinite scroll, בקריאות API ברקע ובתהליכי login כבדים. זה הקו שמפריד בין "קיבלתי HTML" לבין "קיבלתי את הנתונים שבאמת הייתי צריך".
הפרויקטים ברשימה מתחלקים לשלוש קבוצות:
- אוטומציית דפדפן מלאה: Selenium, Playwright ו‑Puppeteer מריצים JavaScript במלואו ועדיין הם הבחירות הכי אמינות לאתרים עתירי אינטראקציה.
- תמיכה היברידית או דרך wrapper: Crawlee יכול לעבור בין סריקת HTTP קלה לבין סריקה מבוססת דפדפן. Scrapling מוסיף שכבת כלים עם דגש על stealth מול יעדים קשים. Maxun משתמש בגישה מבוססת דפדפן מאחורי ממשק ויזואלי.
- HTML סטטי בלבד כברירת מחדל: Scrapy, MechanicalSoup, Node Crawler, Colly, WebMagic, Nokogiri, Heritrix ו‑Apache Nutch לא פותרים לבדם בעיות רינדור מודרניות.
אם הספק הכי גדול שלכם הוא "האם הסטאק הזה יכול להתמודד עם דפים כבדי JavaScript בלי שאצטרך לבנות ידנית כל שלב בדפדפן?", ההדרכה הנוכחית על סריקה עם Playwright היא בדיקת המציאות הטובה ביותר באמצע המאמר:
בריאות הפרויקט: אילו ריפוזיטוריז עדיין נראים אמינים ב‑2026?
גרסת 2025 של המאמר הזה נשענה על ספירות כוכבים וכמה הערות עדכון ישנות. זה כבר לא מספיק. בדקתי גם את ספירות הכוכבים העדכניות וגם את אותות ה‑commit האחרונים ב‑6 באוגוסט 2026.
החלוקה הבריאה נראית כך:
- פעילים בבירור כרגע: Scrapy, Crawlee, Maxun, MechanicalSoup, Heritrix, Apache Nutch, Selenium, Playwright, Puppeteer, Scrapling, Katana ו‑Nokogiri דחפו commits ציבוריים בתוך השבועיים שלפני הבדיקה הזו.
- חיים אבל זזים לאט יותר: Colly ו‑Node Crawler דחפו לאחרונה ב‑18 ביוני 2026. הם עדיין נראים שמישים, אבל מתעדכנים בגלים מדי פעם ולא בקצב שבועי כמו Playwright או Crawlee.
- דורשים יותר זהירות: WebMagic הוא הפער האמיתי היחיד ברשימה הזאת. סימן ה‑commit הציבורי האחרון שמצאתי היה 20 בדצמבר 2025, ולכן הייתי מתייחס אליו כיציב ולא ככזה שמתפתח באופן פעיל.
זה חשוב, כי סגנון התחזוקה צריך להשפיע על הרשימה המצומצמת שלכם:
- אם אתם רוצים ברירת מחדל בטוחה לבנייה הנדסית חדשה, העדיפו את הריפוזיטוריז הפעילים יותר לעין.
- אם הכלי פשוט ומקרה השימוש שלכם צר, גם קצב עדכונים איטי יותר הוא סביר.
- אם הפרויקט מתמחה, תשפטו אותו קודם לפי ההתאמה למשימה, ולא לפי האם הוא משחרר גרסאות כל שבוע.
15 פרויקטי GitHub הטובים ביותר ל‑Web Scraping ב‑2026
מסגרות לסריקה כללית או בהיקף גדול
1. Scrapy
Scrapy עדיין התשובה הסטנדרטית ב‑Python כשהמשימה גדולה יותר מסקריפט מהיר. אם אתם רוצים spiders, pipelines, middleware, throttling, retries ואקו‑סיסטם בוגר, זו עדיין ההימור הבטוח ביותר בקוד פתוח ברשימה הזאת.
- הקמה: בינונית
- מתאים במיוחד ל: קטלוגי ecommerce, סריקת מדריכים, איסוף חדשות ומערכות סריקה פנימיות ארוכות טווח
- תמיכה ב‑JS: אין רינדור מקורי; משלבים עם Playwright או Selenium כשצריך
- למה לבחור בו: ארכיטקטורה בשלה, תיעוד חזק ואחד מיחסי הכוח‑לקהילה הטובים ביותר בעולם הסריקה בקוד פתוח
- מה לשים לב אליו: עקומת הלמידה אמיתית אם לא עבדתם בעבר בתוך מסגרת crawler
אם אתם רוצים להבין לפני ההתחייבות האם מסלול Scrapy מתאים לכם, ההדרכה המתחילה הנוכחית עדיין שימושית:
2. Crawlee
Crawlee הפך לבחירה האטרקטיבית ביותר ב‑JavaScript או TypeScript כשאתם רוצים פרויקט אחד שיכול לכסות גם סריקה קלה וגם סריקה מבוססת דפדפן. היכולת לעבור בין HTTP‑first לבין workflows שמונעים על ידי Playwright או Puppeteer היא היתרון האמיתי.
- הקמה: בינונית
- מתאים במיוחד ל: צוותי JS ו‑TS, יעדים סטטיים ודינמיים מעורבים וכלים פנימיים עם הרבה אוטומציה
- תמיכה ב‑JS: כן
- למה לבחור בו: מודל ריצה גמיש, עזרי anti-blocking וחוויית דפדפן נוחה יותר מסטאקים ישנים שמבוססים רק על crawler
- מה לשים לב אליו: הוא הכי הגיוני אם הצוות שלכם כבר מרגיש בנוח ב‑Node.js
3. Colly
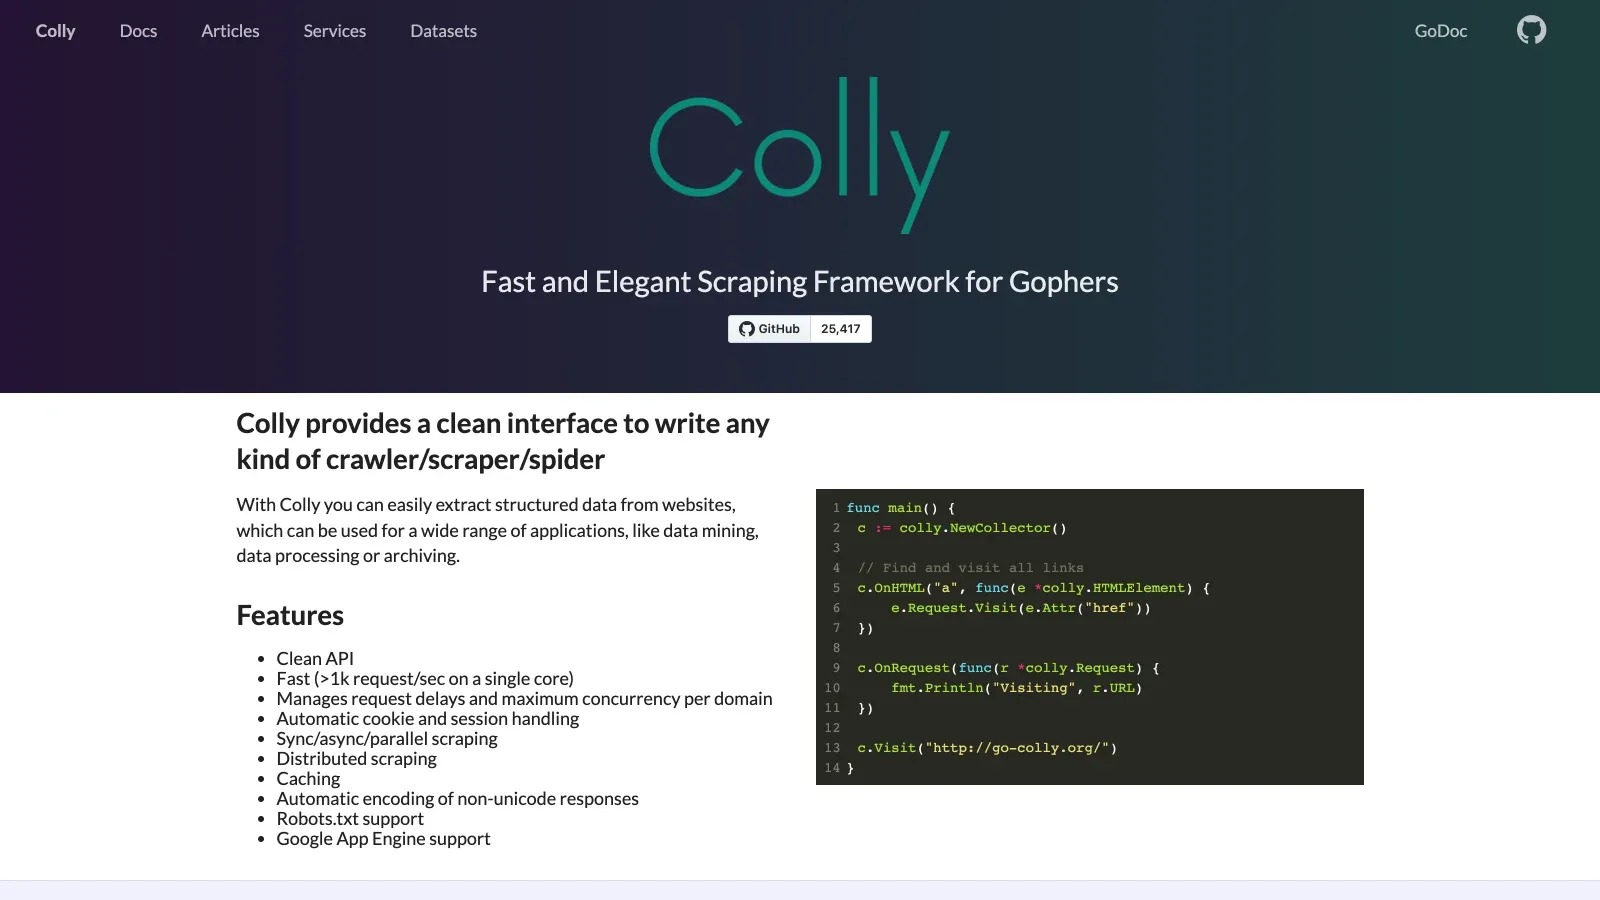
Colly עדיין אחת האפשרויות הנקיות והמהירות ביותר לצוותי Go שלא צריכים רינדור דפדפן כברירת מחדל. הוא מהיר, אלגנטי ומעשי כשהחסם הוא נפח ולא מורכבות הממשק.
- הקמה: בינונית
- מתאים במיוחד ל: מפתחי Go שבונים סורקים סטטיים מהירים
- תמיכה ב‑JS: אין רינדור מקורי
- למה לבחור בו: מקביליות, rate limiting ו‑API נוח למשימות עתירות תעבורה
- מה לשים לב אליו: לא הבחירה הנכונה כשהדרישה האמיתית היא אוטומציית דפדפן
4. WebMagic
WebMagic עדיין מקבילת ה‑Java למי שאוהב את מודל Scrapy אבל רוצה להישאר בתוך אקוסיסטם JVM. הוא עדיין הגיוני לצוותי Java, גם אם תשומת הלב סביבו קטנה יותר מאשר סביב אפשרויות מבוססות Python או Node.
- הקמה: בינונית
- מתאים במיוחד ל: צינורות סריקה מבוססי Java
- תמיכה ב‑JS: אין רינדור מקורי
- למה לבחור בו: schedulers, pipelines ומבנה מסגרת פשוט להבנה
- מה לשים לב אליו: האקו‑סיסטם שקט יותר מהאפשרויות הגדולות ב‑Python וב‑Node, וסימן ה‑commit הציבורי האחרון שמצאתי היה 20 בדצמבר 2025, לכן עדיף להתייחס אליו כיציב ולא כפעיל מאוד
5. Nokogiri
Nokogiri הוא לא מסגרת crawler. זהו המנתח שמפתחי Ruby עדיין פונים אליו כשהם צריכים טיפול נקי ב‑HTML או ב‑XML בתוך סקריפט מותאם אישית או בתוך זרימת עבודה של אפליקציה.
- הקמה: קלה
- מתאים במיוחד ל: אפליקציות Ruby ו‑Rails שצריכות parsing ולא מסגרת crawler מלאה
- תמיכה ב‑JS: לא
- למה לבחור בו: מהיר, יציב ועם ברירת מחדל בטוחה לניתוח
- מה לשים לב אליו: עדיין צריך להביא לבד שכבת HTTP, סשן או דפדפן
פרויקטים קלים וידידותיים למתחילים לסריקה סטטית
6. Maxun
Maxun הוא התשובה בקוד פתוח לאנשים שאוהבים את הרעיון של סריקה ללא קוד אבל עדיין רוצים אירוח עצמי ושליטה ברמת GitHub. הוא הרבה יותר נגיש למי שאינו מפתח ממסגרת טהורה, אבל עדיין מדובר בפרויקט קוד פתוח אמיתי ולא ב‑SaaS סגור.
- הקמה: בינונית לפריסה, קלה יותר למשתמש הקצה אחרי ההקמה
- מתאים במיוחד ל: צוותים שרוצים ממשק ויזואלי עם שליטה של קוד פתוח
- תמיכה ב‑JS: כן
- למה לבחור בו: חילוץ בלחיצה, תהליכים מרובי שלבים ונגישות טובה יותר מאשר כתיבת קוד מאפס
- מה לשים לב אליו: שלב הפריסה עדיין כבד יותר מהרחבת דפדפן מנוהלת במלואה
7. MechanicalSoup
MechanicalSoup עדיין ראוי למקום כי לא כל סריקה צריכה דפדפן headless. אם הבעיה האמיתית היא טיפול בסשנים, שליחת טפסים או מעבר בזרימה סטטית מאחורי login, הוא נשאר קטן ונוח להבנה.
- הקמה: קלה
- מתאים במיוחד ל: טפסים פשוטים, דפים סטטיים מוגני התחברות וסקריפטי אוטומציה מהירים ב‑Python
- תמיכה ב‑JS: לא
- למה לבחור בו: מעט חיכוך, קוד קריא ומסלול כניסה עדין למשתמשי Python
- מה לשים לב אליו: הוא מפסיק להיות שימושי מהר באתרי JS כבדים
8. Node Crawler
Node Crawler עדיין רלוונטי אם היעד שלכם הוא HTML סטטי ואתם בעיקר דואגים למקביליות, תורים וניתוח בסגנון Cheerio. לא הייתי בוחר בו לפרויקט חדש עם הרבה דפדפן, אבל הוא עדיין יכול להתאים לאיסוף בסגנון פידים ואתרים סטטיים.
- הקמה: בינונית
- מתאים במיוחד ל: סריקה ואיגוד מהירים של תוכן סטטי
- תמיכה ב‑JS: לא
- למה לבחור בו: בקרת מקביליות וזרימת parsing מוכרת בסגנון jQuery
- מה לשים לב אליו: סימן ה‑commit הציבורי האחרון שמצאתי היה 18 ביוני 2026, והמרווחים בין עדכונים ארוכים, לכן זה לא המקום שבו הייתי מתחיל סטאק חדש וארוך‑טווח לאתר דינמי
פרויקטים לאתרים דינמיים ואוטומציית דפדפן
9. Selenium
Selenium ותיק יותר מ‑Playwright, אבל הוא עדיין חשוב כשהתנהגות מדויקת של דפדפן ונאמנות אינטראקציה עדיפים על אלגנטיות. הוא נשאר רלוונטי במיוחד במקומות שבהם סריקה חופפת ל‑QA, אוטומציית רגרסיה או אתרים שדורשים התנהגות דפדפן מילולית מאוד.
- הקמה: בינונית
- מתאים במיוחד ל: תהליכים עתירי אינטראקציה, אוטומציית דפדפן מדור קודם וצוותים שכבר משתמשים ב‑Selenium לבדיקות
- תמיכה ב‑JS: כן
- למה לבחור בו: תמיכה רחבה בדפדפנים, אקו‑סיסטם ענק ובשלות ארוכת שנים
- מה לשים לב אליו: סטאקים חדשים יותר לאוטומציה מרגישים לעיתים נקיים ומהירים יותר לפרויקטי scraping חדשים
10. Playwright
Playwright הוא ברירת המחדל המודרנית שלי לצוותי פיתוח שצריכים סריקת דפים דינמיים. השילוב של תמיכה בכמה דפדפנים, התנהגות המתנה חזקה ו‑APIs נקיים הופך אותו לפרויקט אוטומציית הדפדפן הכי קל להמליץ עליו באופן רחב כאן.
- הקמה: בינונית
- מתאים במיוחד ל: אפליקציות ווב מודרניות, תהליכי login ואתרים כבדי JavaScript
- תמיכה ב‑JS: כן
- למה לבחור בו: שליטה חוצת‑דפדפנים, פרימיטיבים חזקים לאוטומציה ותחזוקה פעילה
- מה לשים לב אליו: עדיין אתם אחראים לסלקטורים, לתשתית הדפדפן, ל‑retries ולאיכות הפלט
11. Puppeteer
Puppeteer עדיין הקלאסיקה של Chrome‑first. אם הצוות שלכם כבר עובד ב‑Node.js ורוב היעדים שלכם הם תהליכים תואמי Chromium, זו עדיין אפשרות מעשית ומובנת היטב.
- הקמה: בינונית
- מתאים במיוחד ל: אוטומציה ממוקדת Chrome, צילומי מסך, PDF וחילוץ תוכן דינמי
- תמיכה ב‑JS: כן
- למה לבחור בו: שליטה עשירה בדפדפן והרבה מאוד דוגמאות מהקהילה
- מה לשים לב אליו: Playwright הפך לברירת המחדל החזקה יותר אם אתם רוצים תמיכה רחבה יותר בדפדפנים או סיפור מודרני יותר חוצה‑דפדפנים
12. Scrapling
Scrapling הוא המצטרף המודרני המתמחה ביותר בקבוצה הזו. הוא מיועד לאנשים שכבר יודעים שרינדור דפדפן הוא לא הבעיה היחידה. הם גם צריכים stealth, מודעות ל‑proxy וגישה חזקה יותר מול אנטי‑בוט.
- הקמה: בינונית
- מתאים במיוחד ל: סריקה חמקנית, יעדים רגישים לאנטי‑בוט ועבודה דינמית ב‑Python
- תמיכה ב‑JS: כן
- למה לבחור בו: פיתוח פעיל והתמקדות חדה יותר בחיכוך סריקה שמסגרות פשוטות יותר נוטות להתעלם ממנו
- מה לשים לב אליו: מוגזם לאתרים סטטיים פשוטים ופחות ידידותי למתחילים מאשר MechanicalSoup או Scrapy
סורקים מתמחים למחקר, אבטחה ותשתיות
13. Heritrix
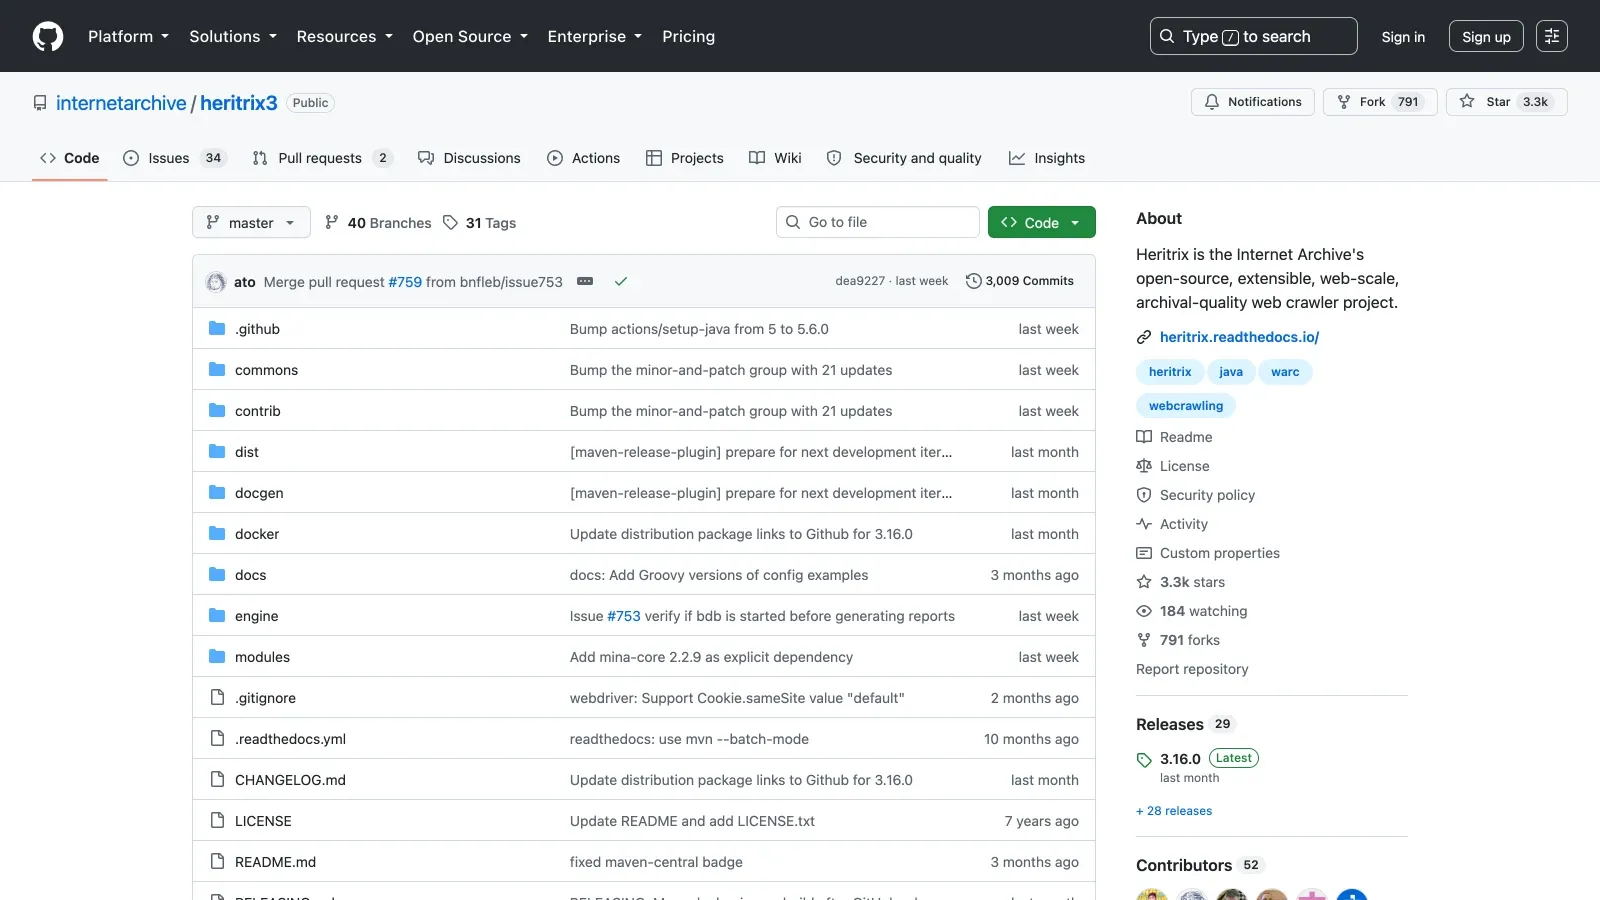
Heritrix הוא לא סקרייפר להשוואת מוצרים. זהו crawler לארכיון שנבנה עבור מוסדות שחשובים להם שימור מלא של אתרים ולכידה העומדת בתקנים.
- הקמה: מתקדמת
- מתאים במיוחד ל: ארכיונים, ספריות וזרימות עבודה של שימור בהיקף גדול
- תמיכה ב‑JS: לא
- למה לבחור בו: היוחסין של Internet Archive וזרימות ארכוב מוכוונות WARC
- מה לשים לב אליו: כלי לא נכון לסריקת רשימות ממוקדות או מחירי מוצרים
14. Apache Nutch
Apache Nutch עדיין הגיוני לצוותים שחושבים במונחים של סריקה מבוזרת, אינדוקס או איסוף נתונים בסגנון מנוע חיפוש, ולא בסריקות עסקיות חד‑פעמיות.
- הקמה: מתקדמת
- מתאים במיוחד ל: סריקה מבוזרת, מערכי מחקר ואיסוף בסגנון search engine
- תמיכה ב‑JS: לא
- למה לבחור בו: מודל פלאגינים והיכרות ארגונית בסגנון Apache
- מה לשים לב אליו: כבד מדי לרוב העבודות שמתחילות בגיליון אלקטרוני או בדפדפן
15. Katana
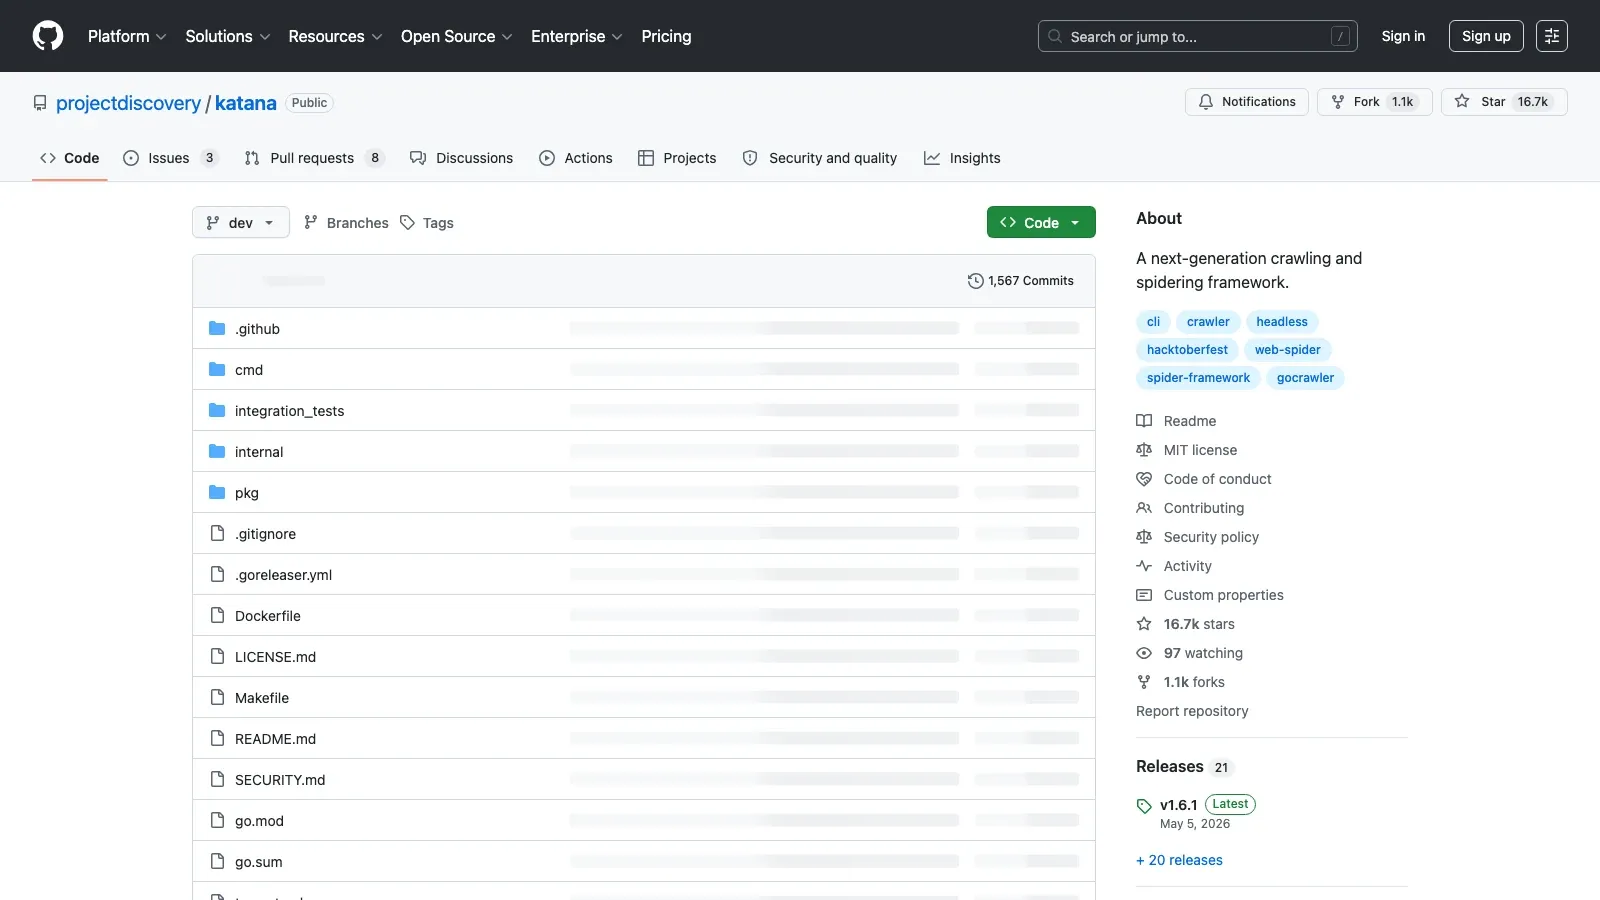
Katana שייך לכאן כי סריקת אבטחה היא מקרה שימוש בפני עצמו. אם המשימה היא reconnaissance, גילוי נקודות קצה או חשיפת המבנה של יעד במהירות, Katana הוא התאמה טובה בהרבה ממסגרת סריקה כללית.
- הקמה: בינונית
- מתאים במיוחד ל: סיור אבטחתי, גילוי קישורים ויצירת מלאי כתובות URL
- תמיכה ב‑JS: מצב headless אופציונלי
- למה לבחור בו: מהירות, מקביליות ומודל סריקה ממוקד אבטחה
- מה לשים לב אליו: הוא לא נועד להיות סטאק מלוטש לחילוץ נתונים עסקיים
הרשימה המצומצמת שלי לפי סוג צוות
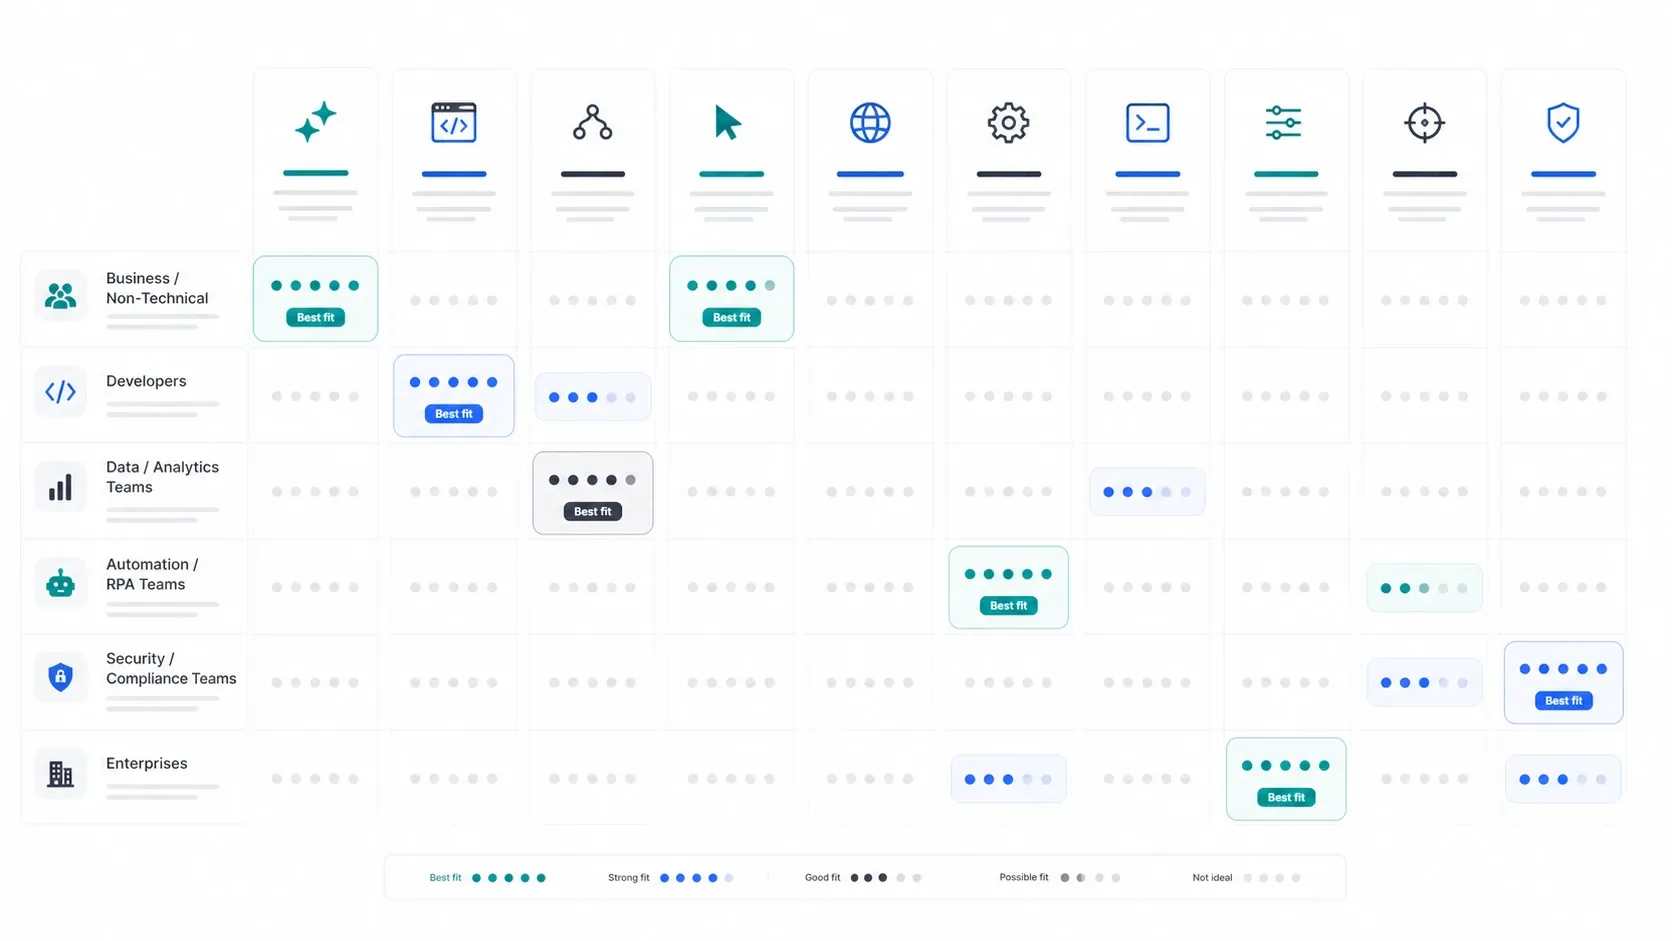
- מפתחי Python: התחילו עם Scrapy למסגרות, עם MechanicalSoup לזרימות סטטיות קטנות יותר, ועם Scrapling אם stealth או חיכוך מול אנטי‑בוט הם כבר חלק מהבעיה.
- צוותי JavaScript או TypeScript: התחילו עם Crawlee כמסגרת, עם Playwright לאוטומציית דפדפן, ועם Puppeteer אם workflow שמבוסס Chrome מספיק.
- צוותי Go: Colly לסריקה, Katana לסריקה אבטחתית עם דגש על גילוי.
- צוותי Java: WebMagic לסריקה כללית, Heritrix ללכידת ארכיון, Apache Nutch לסריקה מבוזרת בסגנון search.
- מפעילים לא טכניים: Maxun אם אתם רוצים אירוח עצמי בקוד פתוח, או Thunderbit אם אתם רוצים workflow מנוהל ללא קוד שמגיע מהר יותר לפלט שמיש.
באיזה פרויקט רוב האנשים באמת צריכים להתחיל?
הנה התשובה הפרגמטית:
- אם אתם רוצים לבנות ולהחזיק סקרייפר משלכם, התחילו עם Scrapy או Crawlee.
- אם אתם צריכים לשלוט בדפדפן אמיתי, התחילו עם Playwright.
- אם אתם צריכים שכבה ויזואלית בקוד פתוח, התחילו עם Maxun.
- אם אתם צריכים ארכוב מתמחה או סריקת אבטחה, בחרו ב‑Heritrix, Nutch או Katana רק משום שמקרה השימוש שלכם באמת דורש אותם.
- אם אתם רוצים לדלג על קוד ולקבל את הנתונים עכשיו, אל תכריחו את עצמכם להתחיל מ‑GitHub. השתמשו ב‑Thunderbit.
השורה התחתונה
פרויקט ה‑GitHub הטוב ביותר ל‑Web Scraping ב‑2026 תלוי פחות בכמות הכוכבים ויותר בעומס שאתם מוכנים לשאת על עצמכם. Scrapy עדיין ברירת המחדל הבטוחה ביותר ב‑Python. Crawlee הוא הבחירה המודרנית הטובה ביותר במסגרת JavaScript. Playwright הוא ברירת המחדל החזקה ביותר לאוטומציית דפדפן. Maxun הוא מסלול ה‑No‑Code בקוד פתוח המעניין ביותר. Heritrix, Apache Nutch ו‑Katana הם כלים מתמחים שמצטיינים רק כשהמשימה עצמה מתמחה.
הדבר החשוב הוא לא לבלבל בין "הכי חזק" לבין "הכי מתאים". אם הצוות שלכם צריך רק נתונים נקיים בגיליון אלקטרוני, ייתכן ש‑GitHub בכלל לא צריך להיות נקודת ההתחלה.
דלגו על עומס התחזוקה והתחילו לסרוק מהר יותר Get Started Free



