
תעבורה אוטומטית כבר מהווה 53% מהווב, יותר מבני אדם, ומערכות נגד בוטים נלחמות חזרה חזק מאי פעם.
ראיתי מקרוב איך טעות אחת קטנה — כמו שימוש ב-user agent שגוי — יכולה להפוך פרויקט דאטה שלך לקיר של שגיאות 403. עבור צוותי מכירות, ecommerce ותפעול, חסימה פירושה לידים שהתפספסו, תמחור לא מעודכן או אובדן הכנסות.
הנה מה שלמדתי על user agents ל-scraping — שיטות העבודה שחייבים להכיר, הטעויות הנפוצות, ואיך כלים כמו Thunderbit מטפלים בכל זה אוטומטית.

למה חשוב לבחור את ה-User Agent הכי טוב ל-Scraping
נתחיל מהבסיס: מה זה בכלל user agent? תחשבו עליו כמו על תעודת הזהות של הדפדפן שלכם. בכל פעם שאתם מבקרים באתר — בין אם אתם בני אדם ובין אם בוטים — הדפדפן שולח מחרוזת User-Agent בכותרות הבקשה. זה סוג של היכרות קצרה שאומרת: “היי, אני Chrome על Windows” או “אני Safari על iPhone” (ScraperAPI). הנה איך נראה user agent טיפוסי של Chrome:
Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36
אתרים משתמשים במידע הזה משתי סיבות מרכזיות:
- כדי להציג את התוכן הנכון (למשל פריסה למובייל מול דסקטופ).
- כדי לזהות בוטים ו-scrapers.
אם ה-user agent שלכם אומר “python-requests/2.28.1” או “Scrapy/2.9.0”, זה בערך כמו לענוד תג עם הכיתוב “שלום, אני בוט!”. אתרים מחזיקים רשימות חסימה למזהים הברורים האלה, והם יסגרו לכם את הדלת מהר יותר ממה שתספיקו להגיד “403 Forbidden”. מצד שני, שימוש ב-user agent עדכני של דפדפן נפוץ עוזר לכם להתמזג בתוך התנועה הרגילה.
בקיצור: ה-user agent שלכם הוא התחפושת. ככל שהתחפושת טובה יותר, כך גדל הסיכוי לקבל את הנתונים שאתם צריכים.
התפקיד של User Agent בהצלחת Web Scraping
למה לבחירת user agent יש השפעה כל כך גדולה? כי זו בדרך כלל שכבת ההגנה הראשונה של רוב מערכות ההגנה נגד בוטים. הנה מה שעלול להשתבש אם בוחרים לא נכון:
- חסימות מיידיות (שגיאות 403/429): שימוש ב-UA ברירת מחדל של ספריית scraping יגרום לחסימה עוד לפני שתראו את דף הבית (Webmasters StackExchange).
- מידע ריק או מזויף: חלק מהאתרים מגישים דפים ריקים או “דמה” ל-user agents חשודים.
- CAPTCHA או הפניות: UA שנראה כמו בוט מפעיל אתגרי “האם אתה אדם?” או לולאות כניסה אינסופיות.
- האטה וחסימות: אם תבקרו באתר שוב ושוב עם אותו UA, אתם עלולים להאט את קצב הבקשות או להיחסם ברמת IP.
בואו נראה איך user agents שונים מתנהגים בפועל:
| מחרוזת User Agent | התוצאה ברוב האתרים (2026) |
|---|---|
python-requests/2.28.1 | נחסם מיד, מסומן כבוט |
Scrapy/2.9.0 (+https://scrapy.org) | נחסם או מקבל תוכן מזויף |
Mozilla/5.0 (Windows NT 10.0; Win64; x64)... | מזוהה כמשתמש אמיתי, מקבל גישה |
AhrefsBot/7.0 (+http://ahrefs.com/robot/) | נחסם, crawler מוכר |
| UA ריק או ג'יבריש | לפעמים עובר, אבל לרוב מחשיד |
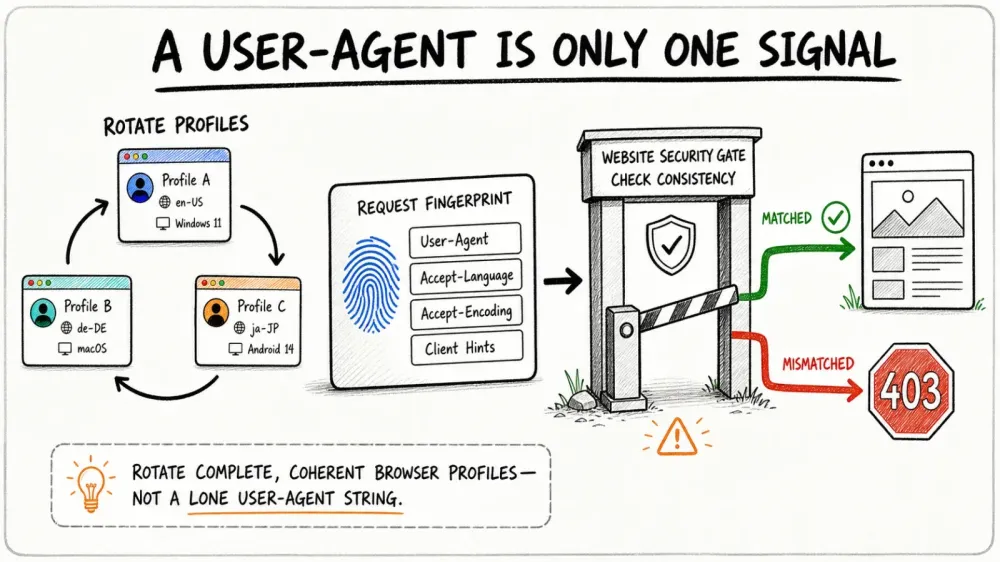
המסקנה? בחרו את התחפושת שלכם בחוכמה. ואל תשכחו — מערכות מודרניות נגד בוטים לא מסתכלות רק על ה-user agent. הן בודקות גם אם שאר כותרות הבקשה, כמו Accept-Language או Referer, תואמות. אם אתם מצהירים שאתם Chrome אבל לא שולחים את הכותרות הנכונות, עדיין תיתפסו (ScraperAPI).
חלצו נתונים מכל אתר בעזרת AI ה-Web Scraper הסוכן של Thunderbit מטפל ברינדור ובמבנה הדף בעצמו, כך שלא צריך לנהל User Agents ידנית. Get Started Free
כאן Thunderbit נכנס לתמונה. דיברתי עם כל כך הרבה משתמשים עסקיים — אנשי מכירות, מנהלי ecommerce, סוכני נדל"ן — שפשוט רוצים את הנתונים, לא קורס מזורז בכותרות HTTP. לכן בנינו את Thunderbit כך שניהול ה-user agent יהיה שקוף ואוטומטי.
Thunderbit: הופכים את ניהול ה-User Agent לפשוט לכולם
עם scraping בלחיצה אחת של Thunderbit, אתם בכלל לא צריכים לבחור user agent. מנוע ה-AI שלנו עושה זאת בשבילכם, ובוחר את החתימה הכי מציאותית ועדכנית של דפדפן לכל אתר. בין אם אתם משתמשים ב-Thunderbit Chrome Extension (שפשוט משתמש ב-UA האמיתי של Chrome) ובין אם אתם מבצעים scraping בענן (שם ה-AI שלנו מחליף בין כמה UAs עדכניים של דפדפנים), אתם תמיד נטמעים בתוך תנועה רגילה.
וזה לא רק ה-user agent. Thunderbit שולח סט מלא ועקבי של כותרות — Accept-Language, Accept-Encoding, Client Hints, ועוד — כך שהבקשות שלכם נראות ומתנהגות כמו דפדפן אמיתי. בלי התאמות לא תואמות, בלי דגלים אדומים של “בוט”.
והכי טוב? לא צריך להגדיר שום דבר. ה-AI של Thunderbit מטפל בכל הפרטים הטכניים מאחורי הקלעים, כך שאתם יכולים להתמקד במה שבאמת חשוב: קבלת דאטה אמינה ואיכותית.
נסו את Thunderbit Agentic Web Scraper בחינם התקינו את תוסף ה-Chrome החינמי וחלצו נתונים מובנים מכל דף בלחיצה אחת, בלי צורך בזיוף כותרות. Get Started Free
למה רוטציה דינמית של User Agent היא Best Practice שחייבים להכיר
נניח שמצאתם את ה-user agent המושלם. כדאי להשתמש בו בכל בקשה? לא כל כך מהר. ב-2026, שימוש חוזר באותו UA שוב ושוב הוא סימן ברור מדי. למשתמשים אמיתיים יש דפדפנים, גרסאות ומכשירים שונים. אם ה-scraper שלכם פוגע באתר 500 פעמים ברצף עם אותו UA, זה כמו לשלוח מצעד של תאומים זהים — אף אחד לא באמת מתבלבל.
לכן רוטציה דינמית של user agents היא כבר סטנדרט בתעשייה. הרעיון פשוט: מחליפים בין רשימה של user agents מציאותיים ועדכניים לכל בקשה או סשן. כך ה-scraper שלכם נראה כמו קהל מגוון של מבקרים אמיתיים, ולא כמו סקריפט אוטומטי יחיד (Capsolver).
ה-rotation שמבוסס AI של Thunderbit לוקח את זה צעד קדימה. עבור סריקות מרובות עמודים או עבודות מתוזמנות, Thunderbit מחליף אוטומטית user agents ואפילו משלב אותם עם כתובות proxy שונות. אם אתר מתחיל לחשוד, Thunderbit מסתגל בזמן אמת — מחליף UA, מתאים כותרות, או מאט בקשות לפי הצורך. כל זה קורה מאחורי הקלעים, כך שה-scraping נשאר לא מזוהה והדאטה ממשיך לזרום.
User Agent וכותרות בקשה: הכוח של עקביות
טיפ מקצועי: user agent הוא רק חלק אחד מה“טביעת האצבע” של הבקשה שלכם. מערכות מודרניות נגד בוטים בודקות אם ה-UA תואם לכותרות אחרות כמו Accept-Language, Accept-Encoding ו-Referer. אם אתם מצהירים שאתם Chrome על Windows אבל שולחים Accept-Language בצרפתית מכתובת IP בניו יורק, זה דגל אדום (ScraperAPI).
Best practice:
- תמיד שלחו סט מלא של כותרות שמתאים ל-user agent שלכם.
- שמרו על עקביות בין Accept-Language ו-Accept-Encoding לבין ה-UA שלכם ו(אם אפשר) מיקום ה-IP.
- השתמשו בכלי המפתחים של הדפדפן כדי לבדוק בקשות אמיתיות ולהעתיק את כל סט הכותרות עבור ה-UA שבחרתם.
Thunderbit מטפל בכל זה בשבילכם. ה-AI שלנו מוודא שכל בקשה היא התאמה מושלמת — user agent, כותרות, ואפילו browser fingerprinting. אתם מקבלים פרופיל בקשה שדומה לאדם אמיתי בלי להזיז אצבע.
איך להימנע מטעויות נפוצות: מה לא לעשות עם User Agents
ראיתי לא מעט פרויקטים של scraping נכשלים מאותן סיבות. הנה הטעויות הגדולות שכדאי להימנע מהן:
- שימוש ב-UA ברירת מחדל של ספריות scraping: מחרוזות כמו
python-requests/2.x,Scrapy/2.9.0אוJava/1.8הן טריגר חסימה מיידי. - גרסאות דפדפן מיושנות: לטעון שאתם Chrome 120 ב-2026? מחשיד — הבילד הזה כבר בן יותר משנתיים. תמיד השתמשו ב-UA מהערוץ היציב העדכני (Chrome 147 בזמן הכתיבה); רשימה שהתיישנה ב-12 חודשים כבר מסגירה בוט.
- כותרות לא תואמות: אל תשלחו UA של Chrome עם Accept-Language, Accept-Encoding או Client Hints חסרים או לא מתאימים.
- UA של crawler מוכר: כל דבר עם “bot”, “crawler”, “spider” או שמות כלים (כמו AhrefsBot) הוא דגל אדום.
- UA ריק או ג'יבריש: לפעמים עובר, אבל לרוב מחשיד ולא אמין.
צ'קליסט מהיר ל-user agents בטוחים:
- השתמשו ב-UA אמיתיים ועדכניים של דפדפנים (Chrome, Firefox, Safari).
- בצעו rotation בין כמה UAs.
- שמרו על עקביות של הכותרות מול ה-UA.
- עדכנו את רשימת ה-UA מדי חודש (דפדפנים מתעדכנים מהר).
- הימנעו מכל דבר שצועק “אוטומציה”.
Thunderbit בפעולה: תרחישים אמיתיים לצוותי מכירות ותפעול
בואו נהיה פרקטיים. כך ניהול ה-user agent של Thunderbit עוזר לצוותים אמיתיים:
| Use Case | הדרך הישנה: Scraping ידני | עם Thunderbit | התוצאה |
|---|---|---|---|
| Sales Lead Gen | חסימות תכופות, דאטה חסר | ה-AI בוחר UA טוב, מבצע rotation, ומחקה גלישה אמיתית | יותר לידים, איכות גבוהה יותר, פחות bounced |
| Ecommerce Monitoring | הסקריפט נשבר, חסימות IP | scraping בענן עם UA דינמי ו-rotation של proxy | מעקב אמין אחרי מחירים ומלאי |
| Real Estate Listings | התאמות ידניות מייגעות, חסימות | ה-AI מתאים UA/כותרות, ומטפל בעמודי משנה אוטומטית | רשימות נכסים מלאות ועדכניות |

צוות מכירות אחד שהשתמש ב-Thunderbit חילץ אלפי אתרים לצורך לידים וראה שיעור bounce של אימיילים של כ-8% בלבד — לעומת 15–20% מרשימות קנויות (Reddit). זה הכוח של scraping טרי, שנראה כמו בן אדם.
צעד-אחר-צעד: איך לבצע Scraping עם ה-User Agent הכי טוב בעזרת Thunderbit
כך קל להתחיל עם Thunderbit — בלי צורך בידע טכני:
- התקינו את תוסף ה-Chrome של Thunderbit.
- עברו לאתר היעד שלכם. התחברו אם צריך — Thunderbit עובד גם על דפים מאובטחים עם התחברות.
- לחצו על “One Click Extract”. ה-AI של Thunderbit סורק את הדף ומציע את העמודות הטובות ביותר לחילוץ.
- עברו על השדות והתאימו אותם אם תרצו. אפשר לשנות שם, להוסיף או להסיר עמודות לפי הצורך.
- לחצו על “Scrape”. Thunderbit מחלץ את הנתונים, תוך כדי רוטציה של user agents וכותרות מאחורי הקלעים.
- ייצאו את הנתונים. שלחו ישירות ל-Excel, Google Sheets, Airtable, Notion, או הורידו כ-CSV/JSON.
אין צורך לבחור או לעדכן user agents — ה-AI של Thunderbit עושה את הכול, ומתאים את עצמו לכל אתר כדי למקסם הצלחה.
Scrape עם רוטציה של User Agent מבוססת AI Thunderbit מריץ משימות scraping דרך התשתית שלו, כך שלחיצה אחת מחליפה סקריפטים ידניים של רוטציית user-agent. Get Started Free
השוואה בין Thunderbit לבין ניהול מסורתי של User Agent
בואו נראה איך Thunderbit משתווה לגישה הישנה והידנית:
| Feature/Task | הגישה הידנית ל-Scraping | הגישה של Thunderbit |
|---|---|---|
| הגדרת User Agent | מחקר והגדרה בקוד | אוטומטי, נבחר על ידי AI לכל אתר |
| עדכון UAs | ידני, קל לשכוח | AI מעדכן אוטומטית לפי מגמות הדפדפנים |
| רוטציה של UA | כתיבת לוגיקת rotation עצמאית | מובנית, חכמה ואוטומטית |
| עקביות בכותרות | התאמה ידנית של הכותרות ל-UA | ה-AI מבטיח סט מלא ועקבי של כותרות |
| טיפול בחסימות/CAPTCHAs | החלפות ידניות, תחזוקה גבוהה | ה-AI מסתגל, מנסה שוב ומבצע rotation לפי הצורך |
| רמת ידע טכני נדרשת | גבוהה (קוד, ידע ב-HTTP) | לא נדרש — מיועד למשתמשים עסקיים |
| זמן לבדיקות ותיקון תקלות | תדיר ומתסכל | מינימלי — מתמקדים בדאטה, לא בכאבי הראש של scraping |
Thunderbit בנוי לכל מי שרוצה scraping אמין וסקיילבילי — בלי המטען הטכני.
ראו איך עובד Agentic Web Scraping ה-AI של Thunderbit קורא דף כמו בן אדם ומחלץ נתונים בלחיצה אחת, בלי צורך בכיוונון ידני של scraper. Get Started Free
מסקנות מרכזיות: בניית אסטרטגיית User Agent שתישאר רלוונטית גם בעתיד
הנה מה שלמדתי — לפעמים בדרך הקשה — על ניהול user agents ב-2026:
- לעולם אל תשתמשו ב-user agents ברירת מחדל או מיושנים. זו הסיבה מספר 1 לכך ש-scrapers נחסמים.
- בצעו rotation דינמי של user agents. גיוון הוא חבר שלכם — אל תתנו ל-scraper שלכם להיראות כמו מצעד רובוטים.
- שמרו על כותרות עקביות ומציאותיות. ה-user agent שלכם טוב רק כמו החברה שהוא נמצא בה.
- הישארו מעודכנים. גרסאות הדפדפנים משתנות מהר; גם רשימת ה-UA שלכם צריכה להשתנות.
- תנו ל-AI לטפל בחלקים הקשים. כלים כמו Thunderbit בונים את best practices לתוך המערכת, כך שאתם יכולים להתמקד בתוצאות, לא בבקשות.
אם נמאס לכם להיחסם, לתקן סקריפטים, או פשוט אתם רוצים לבצע scraping כמו מקצוענים בלי כאב ראש, נסו את Thunderbit. ה-Web Scraper הסוכן שלנו זוכה לאמון של אלפי משתמשים ברחבי העולם, ונועד להפוך נתוני ווב לנגישים לכולם — בלי כאבי ראש טכניים.
לטיפים נוספים, מדריכים וסקירות עומק על web scraping, בקרו ב-Thunderbit Blog.
שאלות נפוצות
1. מה זה user agent ולמה הוא חשוב ב-web scraping?
User agent הוא מחרוזת שנשלחת עם כל בקשת ווב ומזהה את הדפדפן ומערכת ההפעלה שלכם. אתרים משתמשים בו כדי להציג את התוכן הנכון ולזהות בוטים. שימוש ב-user agent הנכון עוזר ל-scraper שלכם להשתלב בתעבורה הרגילה ולהימנע מחסימות.
2. למה לא להשתמש ב-user agent ברירת המחדל של ספריית ה-scraping שלי?
User agents ברירת מחדל כמו python-requests/2.x הם חתימות בוט מוכרות, ולעיתים קרובות נחסמים מיד. תמיד עדיף להשתמש ב-user agents מציאותיים ועדכניים של דפדפנים.
3. איך Thunderbit מטפל ברוטציה של user agent?
ה-AI של Thunderbit מחליף אוטומטית בין מאגר של user agents עדכניים ומציאותיים של דפדפנים לכל בקשה או סשן. כך ה-scraping שלכם נראה כמו תנועה אמיתית ומגוונת של משתמשים.
4. האם אני צריך להגדיר ידנית כותרות כמו Accept-Language או Referer עם Thunderbit?
ממש לא! ה-AI של Thunderbit דואג שכל הכותרות יהיו עקביות ויתאימו ל-user agent שלכם, כך שהבקשות נראות ומתנהגות כמו דפדפן אמיתי.
5. מה קורה אם אתר בכל זאת מתחיל לחסום את הבקשות שלי?
Thunderbit מזהה חסימות או CAPTCHAs ומסתגל בזמן אמת — מחליף user agents, מתאים כותרות או מנסה שוב לפי הצורך. אתם מקבלים דאטה אמין בלי צורך בתיקון ידני.
מוכנים ל-scrape חכם יותר? הורידו את Thunderbit ותנו ל-AI שלנו לנהל עבורכם את משחק החתול והעכבר של ה-user agents. בהצלחה ב-scraping!
מידע נוסף
- מה הם AI Agents? איך זה עובד ואיך משתמשים בזה
- מהו Manus AI Agent? איך זה עובד ואיך משתמשים בו
- מדריך למתחילים: איך לבנות AI Agent צעד אחר צעד
- מדריך ל-Vertical AI Agents: מושגים ושימושים בעולם האמיתי
- הבנת סטטיסטיקות של AI Agent: מדיוק ועד סקיילביליות
נסו Agentic Web Scraper Get Started Free



