
웹 스크래핑에 가장 좋은 언어는 무엇일까? 이건 프로젝트에 따라 달라진다. 그리고 잘못된 언어를 골랐다가 답답함만 쌓인 끝에 그냥 포기하는 개발자들도 정말 많이 봤다.
웹 스크래핑 소프트웨어 시장은 2024년 10억 1천만 달러 규모에 도달했고, 2032년까지 그보다 두 배 이상 성장할 것으로 예상된다. 제대로 고르면 시간도 아끼고, 결과도 더 빨라지고, 유지보수 부담도 줄어든다. 반대로 잘못 고르면? 깨진 스크레이퍼와 날아간 주말만 남는다.
나는 수년간 자동화 도구를 만들어 왔다. 여기서는 내가 실제로 스크래핑에 써본 7가지 언어를 소개하겠다. 코드 예시와 진짜 장단점, 그리고 아예 코딩을 포기하고 대신 Thunderbit을 쓰는 게 나은 경우까지 함께 다룬다.
웹 스크래핑에 가장 좋은 언어를 고르는 기준
웹 스크래핑에서는 모든 프로그래밍 언어가 똑같지 않다. 나는 프로젝트가 성공한 경우도, 망한 경우도 여러 번 봤는데, 그 차이는 대체로 아래 핵심 요소에서 갈렸다.
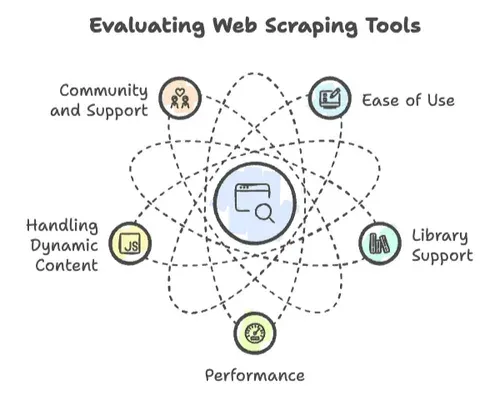
- 사용 편의성: 얼마나 빨리 시작할 수 있는가? 문법이 친절한가, 아니면 “Hello, World” 찍으려면 컴퓨터공학 박사학위가 필요한 수준인가?
- 라이브러리 지원: HTTP 요청, HTML 파싱, 동적 콘텐츠 처리에 쓸 수 있는 강력한 라이브러리가 있는가? 아니면 직접 바퀴를 다시 만들어야 하는가?
- 성능: 이 언어가 수백만 페이지를 감당할 수 있는가, 아니면 몇백 페이지에서만 무너지는가?
- 동적 콘텐츠 처리: 요즘 사이트는 JavaScript를 좋아한다. 이 언어가 그 속도를 따라갈 수 있는가?
- 커뮤니티와 지원: 막히는 순간은 반드시 온다. 그때 도와줄 커뮤니티가 있는가?
이 기준을 바탕으로, 그리고 밤샘 테스트를 수없이 거친 끝에, 내가 정리한 7가지 언어는 다음과 같다.
- Python: 초보자와 전문가 모두가 가장 선호하는 선택.
- JavaScript & Node.js: 동적 콘텐츠의 강자.
- Ruby: 깔끔한 문법, 빠른 스크립트 작성.
- PHP: 서버 사이드에서의 단순함.
- C++: 순수 속도가 필요할 때.
- Java: 엔터프라이즈에 적합하고 확장성도 좋음.
- Go (Golang): 빠르고 병렬 처리에 강함.
그리고 만약 “나는 코딩 자체가 싫은데?”라고 생각한다면, 끝까지 읽어보자. Thunderbit가 있다.
Python으로 웹 스크래핑: 초보자에게도 친절한 강력한 선택
먼저 모두가 좋아하는 Python부터 보자. 데이터 관련 사람들로 가득한 방에 들어가서 “웹 스크래핑에 가장 좋은 프로그래밍 언어가 뭐예요?”라고 물으면, Taylor Swift 콘서트 후렴처럼 Python이 돌아온다.
왜 Python인가?
- 초보자도 읽기 쉬운 문법: Python 코드는 소리 내서 읽어도 거의 영어처럼 들린다.
- 라이브러리 지원이 매우 강함: HTML 파싱용 BeautifulSoup, 대규모 크롤링용 Scrapy, HTTP 요청용 Requests, 브라우저 자동화용 Selenium까지 다 있다.
- 거대한 커뮤니티: 웹 스크래핑과 Python 관련해서만 Stack Overflow에 33,000개가 넘는 질문이 있다.
Python 코드 예시: 페이지 제목 가져오기
import requests
from bs4 import BeautifulSoup

response = requests.get("<https://example.com>")
soup = BeautifulSoup(response.text, 'html.parser')
title = soup.title.string
print(f"Page title: {title}")
장점:
- 빠르게 개발하고 프로토타입을 만들 수 있다.
- 자료와 답변이 정말 많다.
- 데이터 분석과도 잘 맞는다. Python으로 수집하고, pandas로 분석하고, matplotlib로 시각화하면 된다.
- 라이브러리도 계속 진화한다. 2026년 1월에 나온 Scrapy 2.14는 프레임워크 전반에
async/await를 기본 지원으로 넣어, 비동기 처리가 이제 Selenium/Playwright만의 이야기가 아니게 됐다.
단점:
- 아주 무거운 작업에서는 컴파일 언어보다 느릴 수 있다.
- 특히 동적인 사이트를 다룰 때는 다소 번거로울 수 있다. 물론 Selenium과 Playwright가 많은 부분을 해결해 준다.
- 초고속으로 수백만 페이지를 긁는 데는 덜 적합하다.
결론:
처음 시작하는 사람이거나, 그냥 빨리 결과를 보고 싶은 사람이라면 Python이 웹 스크래핑에 가장 좋은 언어다. 이견이 거의 없다. 웹 스크래핑에서 Python이 왜 강한지 더 보기.
JavaScript와 Node.js: 동적 사이트를 능숙하게 긁어오기
Python이 스위스 아미 나이프라면, JavaScript(그리고 Node.js) 는 전동 드릴이다. 특히 JavaScript가 잔뜩 들어간 최신 사이트를 스크래핑할 때 그렇다.
왜 JavaScript/Node.js인가?
- 동적 콘텐츠에 최적화: 브라우저 안에서 돌아가기 때문에, React, Angular, Vue로 만들어진 사이트라도 사용자가 보는 그대로 볼 수 있다.
- 기본적으로 비동기 처리에 강함: Node.js는 수백 개의 요청도 동시에 다룰 수 있다.
- 웹 개발자에게 익숙함: 웹사이트를 만들어 본 적이 있다면, JavaScript는 이미 낯설지 않을 것이다.
핵심 라이브러리:
- Playwright: Chromium, Firefox, WebKit까지 지원하는 멀티 브라우저 자동화 도구. 자동 대기 기능과 context별 프록시 분리도 제공한다. 2026년 기준 새 Node 스크레이퍼를 시작한다면 기본 추천이다.
- Puppeteer: Chrome DevTools Protocol을 이용한 Chrome 헤드리스 자동화 도구. Chrome 중심 작업이나 리소스를 더 아끼고 싶을 때 여전히 훌륭하다.
- Cheerio: 실제 브라우저가 필요 없을 때 쓰는, Node용 jQuery 스타일 HTML 파서.
Node.js 코드 예시: Puppeteer로 제목 가져오기
const puppeteer = require('puppeteer');

(async () => {
  const browser = await puppeteer.launch();
  const page = await browser.newPage();
  await page.goto('<https://example.com>', { waitUntil: 'networkidle2' });
  const title = await page.title();
  console.log(`Page title: ${title}`);
  await browser.close();
})();
장점:
- JavaScript로 렌더링되는 콘텐츠를 자연스럽게 처리한다.
- 무한 스크롤, 팝업, 인터랙티브 사이트에 강하다.
- 대규모 병렬 스크래핑에도 잘 맞는다.
단점:
- 비동기 프로그래밍은 초보자에게 어렵게 느껴질 수 있다.
- 헤드리스 브라우저는 너무 많이 돌리면 메모리를 꽤 먹는다.
- Python에 비해 데이터 분석용 도구는 적다.
JavaScript/Node.js가 웹 스크래핑에 가장 좋은 경우는?
대상 사이트가 동적이거나, 브라우저 동작 자체를 자동화해야 할 때다. Node.js로 동적 콘텐츠를 긁는 방법 더 보기.
Ruby: 빠른 웹 스크래핑용으로 깔끔한 문법
Ruby는 단지 Rails용 언어가 아니다. 아름다운 코드 스타일로 유명하지만, 웹 스크래핑에서도 꽤 괜찮은 선택이다. 특히 코드가 시처럼 흐르길 바란다면 더 그렇다.
왜 Ruby인가?
- 읽기 쉬운 표현력 있는 문법: Ruby로 만든 스크레이퍼는 거의 장보기 목록처럼 읽힌다.
- 프로토타입에 매우 적합: 빨리 작성하고, 수정도 쉽다.
- 핵심 라이브러리: 파싱용 Nokogiri, 탐색 자동화용 Mechanize.
Ruby 코드 예시: 페이지 제목 가져오기
require 'open-uri'
require 'nokogiri'

html = URI.open("<https://example.com>")
doc = Nokogiri::HTML(html)
title = doc.at('title').text
puts "Page title: #{title}"
장점:
- 읽기 편하고 코드가 간결하다.
- 작은 프로젝트, 일회성 스크립트, 또는 이미 Ruby를 쓰고 있다면 특히 좋다.
단점:
- 대규모 작업에서는 Python이나 Node.js보다 느리다.
- 스크래핑 관련 라이브러리와 커뮤니티 지원이 상대적으로 적다.
- JavaScript가 많은 사이트에는 이상적이지 않다. 그래도 Watir나 Selenium은 쓸 수 있다.
가장 잘 맞는 경우:
Ruby 개발자이거나 빠르게 스크립트를 하나 만들어야 한다면 Ruby는 정말 편하다. 하지만 대규모이면서 동적인 스크래핑이라면 다른 선택이 더 낫다.
PHP: 서버 사이드에서 데이터를 간단하게 가져오기
PHP는 예전 인터넷의 유물처럼 느껴질 수도 있지만, 아직도 충분히 살아 있다. 특히 서버에서 바로 데이터를 긁어와야 할 때는 꽤 실용적이다.
왜 PHP인가?
- 거의 어디서나 실행 가능: 대부분의 웹 서버는 이미 PHP를 지원한다.
- 웹 앱과 통합하기 쉽다: 스크래핑한 데이터를 같은 흐름 안에서 바로 보여줄 수 있다.
- 핵심 라이브러리: HTTP용 cURL, 요청용 Guzzle, 헤드리스 브라우저 자동화용 Symfony Panther.
PHP 코드 예시: 페이지 제목 가져오기
<?php
$ch = curl_init("<https://example.com>");
curl_setopt($ch, CURLOPT_RETURNTRANSFER, true);
$html = curl_exec($ch);
curl_close($ch);

$dom = new DOMDocument();
@$dom->loadHTML($html);
$title = $dom->getElementsByTagName("title")->item(0)->nodeValue;
echo "Page title: $title\n";
?>
장점:
- 웹 서버에 배포하기 쉽다.
- 웹사이트의 일부 기능으로 스크래핑을 넣기에 좋다.
- 단순한 서버 사이드 스크래핑 작업에 빠르다.
단점:
- 고급 스크래핑용 라이브러리 지원이 상대적으로 제한적이다.
- 고도의 병렬 처리나 대규모 스크래핑에는 맞지 않는다.
- JavaScript 중심 사이트 처리는 복잡해질 수 있다. Panther가 어느 정도 도와준다.
가장 잘 맞는 경우:
이미 PHP 스택을 쓰고 있거나, 웹사이트 안에서 바로 데이터를 가져와 보여주고 싶다면 PHP는 꽤 실용적인 선택이다. 웹 스크래핑에서 PHP와 Python 비교.
C++: 대형 프로젝트용 고성능 웹 스크래핑
C++는 프로그래밍 언어 세계의 머슬카다. 순수 속도와 세밀한 제어가 필요하고, 손이 많이 가는 일도 감수할 수 있다면 C++는 강력하다.
왜 C++인가?
- 매우 빠르다: CPU 의존 작업에서는 대부분의 언어보다 뛰어나다.
- 정밀한 제어 가능: 메모리, 스레드, 성능 최적화를 직접 관리할 수 있다.
- 핵심 라이브러리: HTTP용 libcurl, 파싱용 htmlcxx.
C++ 코드 예시: 페이지 제목 가져오기
#include <curl/curl.h>
#include <iostream>
#include <string>

size_t WriteCallback(void* contents, size_t size, size_t nmemb, void* userp) {
    std::string* html = static_cast<std::string*>(userp);
    size_t totalSize = size * nmemb;
    html->append(static_cast<char*>(contents), totalSize);
    return totalSize;
}

int main() {
    CURL* curl = curl_easy_init();
    std::string html;
    if(curl) {
        curl_easy_setopt(curl, CURLOPT_URL, "<https://example.com>");
        curl_easy_setopt(curl, CURLOPT_WRITEFUNCTION, WriteCallback);
        curl_easy_setopt(curl, CURLOPT_WRITEDATA, &html);
        CURLcode res = curl_easy_perform(curl);
        curl_easy_cleanup(curl);
    }

    std::size_t startPos = html.find("<title>");
    std::size_t endPos = html.find("</title>");
    if(startPos != std::string::npos && endPos != std::string::npos) {
        startPos += 7;
        std::string title = html.substr(startPos, endPos - startPos);
        std::cout << "Page title: " << title << std::endl;
    } else {
        std::cout << "Title tag not found" << std::endl;
    }
    return 0;
}
장점:
- 대규모 프로젝트에서 압도적인 속도를 낸다.
- 고성능 시스템에 스크래핑을 통합하기 좋다.
단점:
- 학습 곡선이 가파르다. 커피는 필수다.
- 메모리를 직접 관리해야 한다.
- 고수준 라이브러리가 적고, 동적 콘텐츠에는 약하다.
가장 잘 맞는 경우:
수백만 페이지를 긁어야 하거나, 성능이 정말 절대적으로 중요할 때다. 그 외에는 디버깅에 더 많은 시간을 쓸 수도 있다.
Java: 엔터프라이즈용으로 준비된 웹 스크래핑
Java는 엔터프라이즈 세계의 대표적인 일꾼이다. 오래 돌려야 하고, 엄청난 데이터를 다뤄야 하고, 좀비 아포칼립스가 와도 버텨야 한다면 Java는 믿을 만하다.
왜 Java인가?
- 강력하고 확장 가능: 대규모 장기 스크래핑 프로젝트에 잘 맞는다.
- 강한 타입 시스템과 좋은 오류 처리: 운영 환경에서 예측 가능성이 높다.
- 핵심 라이브러리: 파싱용 Jsoup, 브라우저 자동화용 Selenium WebDriver, HTTP용 Apache HttpClient.
Java 코드 예시: 페이지 제목 가져오기
import org.jsoup.Jsoup;
import org.jsoup.nodes.Document;

public class ScrapeTitle {
    public static void main(String[] args) throws Exception {
        Document doc = Jsoup.connect("<https://example.com>").get();
        String title = doc.title();
        System.out.println("Page title: " + title);
    }
}
장점:
- 성능이 좋고 병렬 처리에도 강하다.
- 큰 코드베이스를 오래 유지보수하기 좋다.
- Selenium이나 HtmlUnit을 통해 동적 콘텐츠도 잘 다룰 수 있다.
단점:
- 문법이 길고, 스크립트 언어보다 설정이 더 필요하다.
- 작은 일회성 작업에는 과할 수 있다.
가장 잘 맞는 경우:
엔터프라이즈급 데이터 수집, 또는 높은 신뢰성과 확장성이 필요한 프로젝트.
Go (Golang): 빠르고 병렬 처리에 강한 웹 스크래핑
Go는 비교적 새로운 편이지만, 빠르고 병렬 처리가 쉬워서 이미 존재감이 크다.
왜 Go인가?
- 컴파일 언어 수준의 빠른 속도: C++에 가깝다.
- 내장 병렬 처리: Goroutines 덕분에 병렬 스크래핑이 쉽게 느껴진다.
- 핵심 라이브러리: 스크래핑용 Colly, 파싱용 Goquery.
Go 코드 예시: 페이지 제목 가져오기
package main

import (
    "fmt"
    "github.com/gocolly/colly"
)

func main() {
    c := colly.NewCollector()
    c.OnHTML("title", func(e *colly.HTMLElement) {
        fmt.Println("Page title:", e.Text)
    })
    err := c.Visit("<https://example.com>")
    if err != nil {
        fmt.Println("Error:", err)
    }
}
장점:
- 매우 빠르고 대규모 스크래핑에 효율적이다.
- 배포가 쉽다. 단일 바이너리로 충분하다.
- 병렬 크롤링에 아주 잘 맞는다.
단점:
- Python이나 Node.js보다 커뮤니티가 작다.
- 고급 스크래핑 라이브러리는 상대적으로 적다.
- JavaScript 중심 사이트는 추가 설정이 필요하다. Chromedp나 Selenium이 필요할 수 있다.
가장 잘 맞는 경우:
대규모로 빠르게 수집해야 하거나, Python 속도로는 부족할 때다. Go와 Python의 웹 스크래핑 성능 비교.
웹 스크래핑에 가장 좋은 프로그래밍 언어 비교
이제 전체를 정리해 보자. 2026년에 웹 스크래핑에 가장 좋은 언어를 고르는 데 도움이 되도록, 아래 표로 한눈에 비교해 보자.
| 언어/도구 | 사용 편의성 | 성능 | 라이브러리 지원 | 동적 콘텐츠 처리 | 추천 사용 사례 |
|---|---|---|---|---|---|
| Python | 매우 높음 | 보통 | 매우 우수 | 좋음 (Selenium/Playwright) | 범용, 초보자, 데이터 분석 |
| JavaScript/Node.js | 보통 | 높음 | 강함 | 매우 우수 (기본 지원) | 동적 사이트, 비동기 스크래핑, 웹 개발자 |
| Ruby | 높음 | 보통 | 무난함 | 제한적 (Watir) | 빠른 스크립트, 프로토타입 |
| PHP | 보통 | 보통 | 무난함 | 제한적 (Panther) | 서버 사이드, 웹 앱 통합 |
| C++ | 낮음 | 매우 높음 | 제한적 | 매우 제한적 | 성능이 중요한 대규모 작업 |
| Java | 보통 | 높음 | 좋음 | 좋음 (Selenium/HtmlUnit) | 엔터프라이즈, 장기 서비스 |
| Go (Golang) | 보통 | 매우 높음 | 성장 중 | 보통 (Chromedp) | 빠르고 병렬성이 높은 스크래핑 |
코딩을 건너뛰고 싶다면: Thunderbit 같은 노코드 웹 스크래핑
Thunderbit Agentic Web Scraper를 사용해 보세요 비즈니스 사용자, 마케터, 영업팀을 위한 AI 기반 노코드 웹 스크래핑. Get Started Free
솔직히 말하자면, 가끔은 그냥 데이터만 있으면 된다. 코딩도, 디버깅도, “왜 이 셀렉터가 안 먹지?” 같은 고통도 필요 없다. 바로 그럴 때 Thunderbit가 유용하다.
Thunderbit 공동창업자로서, 나는 웹 스크래핑을 배달 음식 주문처럼 쉽게 만들고 싶었다. Thunderbit의 특징은 다음과 같다.
- 원클릭 설정: “One Click Extract”만 누르면 된다. HTTP 요청, 프록시, 봇 차단 우회 같은 걸 신경 쓸 필요가 없다.
- 스마트 템플릿: 하나의 scraper 템플릿으로 여러 페이지 레이아웃을 처리할 수 있다. 사이트가 조금 바뀌었다고 스크레이퍼를 매번 다시 쓸 필요가 없다.
- 브라우저/클라우드 스크래핑: 로그인해야 하는 사이트면 브라우저에서, 공개 데이터라면 더 빠른 클라우드에서 돌릴 수 있다.
- 동적 콘텐츠 대응: Thunderbit의 AI는 실제 브라우저를 제어하므로 infinite scroll, 팝업, 로그인 같은 것도 다룰 수 있다.
- 어디로든 내보내기: Excel, Google Sheets, Airtable, Notion, 또는 클립보드로 바로 내보낼 수 있다.
- 유지보수 부담 없음: 사이트 구조가 바뀌어도 AI 제안을 다시 실행하면 된다. 밤샘 수정 작업이 없다.
- 예약 및 자동화: cron job이나 서버 설정 없이 정해진 시간에 자동으로 스크래퍼를 돌릴 수 있다.
- 전용 추출기: 이메일, 전화번호, 이미지가 필요하다면 버튼 한 번으로 추출하는 도구도 있다.
가장 좋은 점은? 코드를 한 줄도 몰라도 된다는 것이다. Thunderbit는 비즈니스 사용자, 마케터, 영업팀, 부동산 종사자처럼 데이터를 빨리 필요로 하는 사람들을 위해 만들어졌다.
Thunderbit를 직접 보고 싶다면? Chrome 확장 프로그램을 다운로드하거나 YouTube 채널에서 데모를 확인해 보자.
Thunderbit Agentic Web Scraper를 무료로 사용해 보세요 프로그래밍 언어 고민은 그만. Thunderbit의 agentic web scraper가 페이지를 읽고 한 번의 클릭으로 데이터를 추출합니다. 코딩은 필요 없습니다. Get Started Free
결론: 2026년에 웹 스크래핑에 가장 좋은 언어를 고르는 법
Agentic Web Scraping과 코딩의 차이를 확인해 보세요 Thunderbit의 AI는 페이지를 읽고 필요한 필드를 스스로 선택해서, 스크래핑 스크립트를 몇 시간 걸려 짤 일을 한 번의 클릭으로 끝냅니다. Get Started Free
2026년의 웹 스크래핑은 그 어느 때보다 더 쉽고, 동시에 더 강력해졌다. 자동화 현장에서 오래 일하며 내가 얻은 교훈은 이렇다.
- 빠르게 시작하고 자료도 풍부한 환경을 원한다면 Python이 여전히 웹 스크래핑에 가장 좋은 언어다.
- JavaScript가 많은 동적 사이트를 긁어야 한다면 JavaScript/Node.js가 가장 강하다.
- 빠른 스크립트나 웹 통합이 필요하면 Ruby와 PHP가 좋다. 특히 이미 익숙하다면 더 그렇다.
- 속도와 확장성이 중요하다면 **C++**와 Go가 강하다.
- 엔터프라이즈급, 장기 프로젝트라면 Java가 유력한 선택이다.
- 그리고 코딩을 완전히 건너뛰고 싶다면? Thunderbit가 비장의 카드다.
시작하기 전에 스스로에게 물어보자.
- 내 프로젝트는 얼마나 큰가?
- 동적 콘텐츠를 처리해야 하는가?
- 나는 기술적으로 어느 정도 익숙한가?
- 나는 직접 만들고 싶은가, 아니면 그냥 데이터를 받고 싶은가?
위의 코드 예시 중 하나를 직접 써 보거나, 다음 프로젝트에서 Thunderbit를 써 보자. 더 깊이 파고들고 싶다면 Thunderbit Blog에서 더 많은 가이드, 팁, 현장 스크래핑 이야기를 볼 수 있다.
즐거운 스크래핑 하길 바란다. 그리고 데이터는 항상 깔끔하고, 구조적이고, 클릭 한 번이면 손에 들어오길.
P.S. 새벽 2시에 웹 스크래핑 미궁에 갇힌다면, 기억해 두자: Thunderbit도 있고, 커피도 있고, 둘 다 함께일 수도 있다.
지금 Thunderbit Agentic Web Scraper를 사용해 보세요 Get Started Free
자주 묻는 질문
1. 2026년에 웹 스크래핑에 가장 좋은 프로그래밍 언어는 무엇인가요?
Python은 여전히 가장 유력한 선택이다. 읽기 쉬운 문법, 강력한 라이브러리들(예: BeautifulSoup, Scrapy, Selenium), 그리고 큰 커뮤니티 덕분이다. 특히 초보자와 전문가 모두에게 좋고, 데이터 분석과 함께 쓰기에도 이상적이다.
2. JavaScript가 많은 사이트를 긁기에 가장 좋은 언어는 무엇인가요?
JavaScript(Node.js)가 가장 적합하다. Puppeteer와 Playwright 같은 도구를 쓰면 브라우저를 완전히 제어할 수 있고, React, Vue, Angular로 로드되는 콘텐츠도 다룰 수 있다.
3. 코딩 없이 웹 스크래핑할 수 있나요?
가능하다. Thunderbit는 동적 콘텐츠 처리부터 예약 실행까지 다 되는 노코드 agentic web scraper다. “One Click Extract”만 누르면 바로 데이터를 수집할 수 있다. 영업, 마케팅, 운영팀처럼 구조화된 데이터가 빨리 필요한 팀에 특히 잘 맞는다.
4. AI agent가 스크레이퍼 코드를 대신 써 준다면, 그래도 언어를 골라야 하나요?
2026년 기준으로는 꽤 타당한 질문이다. Claude Code, Cursor, OpenAI Codex 같은 도구는 짧은 프롬프트만으로 Scrapy spider, Playwright 스크립트, 또는 Go + Colly 크롤러를 알아서 만들어 준다. 그래서 “어떤 언어부터 배워야 하나?”라는 부담은 2년 전보다 훨씬 줄었다. 하지만 결국 agent가 생성하는 건 여전히 어떤 언어의 코드이고, 그 코드를 읽고, 고치고, 배포하는 일은 여전히 당신이나 다음 담당자의 몫이다. 그러니 언어 선택은 여전히 중요하다. 다만 예전보다 유지보수 관점에서 더 중요해졌을 뿐이다. 코드를 아예 건드리고 싶지 않다면, Thunderbit가 그 차이를 아예 없애 준다.
더 읽을거리:




