
קישורים שבורים. דפים יתומים. עמוד “בדיקה” מ־2019 שגוגל איכשהו אינדקסה. אם אתם מנהלים אתר, אתם מכירים את הכאב הזה מקרוב.
סורק טוב מוצא את כל זה — וממפה את האתר כולו כך שאפשר באמת לטפל בבעיות. אבל הרבה אנשים מבלבלים בין “web crawler” ל־“web scraper”. זה לא אותו דבר בכלל.
בדקתי 10 סורקים חינמיים על אתרים אמיתיים. חלקם מצוינים לבדיקות SEO. אחרים טובים יותר לחילוץ נתונים. הנה מה שעבד — ומה לא.
מהו Website Crawler? הבסיסים שכדאי להכיר
בואו נשים את זה על השולחן: website crawler הוא לא אותו דבר כמו web scraper. נכון, המונחים האלה נזרקים לאוויר כל הזמן, אבל בפועל מדובר בכלים שונים לגמרי. אפשר לחשוב על סורק כעל הקרטוגרף של האתר שלכם — הוא חוקר כל פינה, עוקב אחרי כל קישור, ובונה מפה של כל הדפים. התפקיד שלו הוא לגלות: למצוא כתובות URL, למפות את מבנה האתר ולאנדקס תוכן. ככה פועלים מנועי חיפוש כמו Google עם הבוטים שלהם, וככה כלי SEO בודקים את מצב האתר (Thunderbit Blog: What Is a Web Crawler?).
לעומת זאת, web scraper הוא כורה הנתונים. הוא לא מתעניין במפה כולה — הוא רק רוצה לחלץ את הזהב: מחירי מוצרים, שמות חברות, ביקורות, אימיילים, מה שתרצו. סקרייפרים שולפים שדות ספציפיים מתוך הדפים שהסורקים מוצאים (Thunderbit Blog: How to Web Crawl a Site?).
אנלוגיה קצרה:
- Crawler: מי שמסתובב בכל המעברים בסופר ורושם מלאי של כל המוצרים.
- Scraper: מי שהולך ישר למדף הקפה ורושם את המחיר של כל תערובת אורגנית.
למה זה חשוב? כי אם אתם רק רוצים למצוא את כל הדפים באתר שלכם (למשל לצורך בדיקת SEO), אתם צריכים crawler. אם אתם רוצים לשלוף את כל מחירי המוצרים מהאתר של המתחרה, אתם צריכים scraper — או, עדיף, כלי שיודע לעשות את שניהם.
למה להשתמש ב־Online Web Crawler? היתרונות העסקיים העיקריים
אז למה בכלל להתעסק עם web crawler? ובכן, האינטרנט לא בדיוק נהיה קטן יותר. למעשה, יותר מ־54% ממותגי הארגונים משתמשים בפלטפורמות סריקה ייעודיות כדי לייעל את האתרים שלהם, וחלק מכלי ה־SEO סורקים 7 מיליארד דפים ביום.
הנה מה שסורקים יכולים לעשות בשבילכם:
- בדיקות SEO: למצוא קישורים שבורים, כותרות חסרות, תוכן כפול, דפים יתומים ועוד (SEO.ai).
- בדיקת קישורים ו־QA: לאתר שגיאות 404 ולולאות הפניה לפני שהמשתמשים נתקלים בהן (Screaming Frog).
- יצירת Sitemap: לבנות אוטומטית מפת אתר XML עבור מנועי חיפוש ותכנון (PowerMapper).
- מיפוי תוכן: ליצור רשימה של כל הדפים באתר, ההיררכיה שלהם והמטא־דאטה.
- ציות ונגישות: לבדוק כל דף מבחינת WCAG, SEO ודרישות משפטיות (SiteOne Crawler).
- ביצועים ואבטחה: לסמן דפים איטיים, תמונות כבדות או בעיות אבטחה (SiteOne Crawler).
- נתונים ל־AI ולניתוח: להזין נתונים שנסרקו לכלי אנליטיקה או AI (Thunderbit Blog: Crawl4AI Review).
הנה טבלה מהירה שממפה מקרי שימוש לתפקידי עבודה:
| מקרה שימוש | מתאים במיוחד ל | תועלת / תוצאה |
|---|---|---|
| SEO ובדיקת אתר | שיווק, SEO, בעלי עסקים קטנים | איתור בעיות טכניות, שיפור מבנה, שיפור דירוג |
| מיפוי תוכן ו־QA | מנהלי תוכן, מנהלי אתרים | בדיקת תוכן או מעבר אתר, איתור קישורים/תמונות שבורים |
| יצירת לידים (Scraping) | מכירות, פיתוח עסקי | אוטומציה של איתור לקוחות פוטנציאליים, מילוי CRM בלידים חדשים |
| מודיעין תחרותי | מסחר אלקטרוני, מנהלי מוצר | מעקב אחרי מחירי מתחרים, מוצרים חדשים, שינויים במלאי |
| שכפול מפת אתר ומבנה | מפתחים, DevOps, יועצים | שכפול מבנה אתר לצורך עיצוב מחדש או גיבוי |
| איסוף תוכן | חוקרים, מדיה, אנליסטים | איסוף נתונים ממספר אתרים לצורך ניתוח או מעקב אחרי מגמות |
| מחקר שוק | אנליסטים, צוותי אימון ל־AI | איסוף מערכי נתונים גדולים לצורכי ניתוח או אימון מודלים של AI |
(Thunderbit Blog: How to Web Crawl a Site?)
איך בחרנו את כלי ה־Website Crawler החינמיים הטובים ביותר
השקעתי לא מעט לילות מאוחרים (ועוד יותר קפה ממה שאני מוכן להודות) בחפירה בין כלי סריקה, בקריאת תיעוד ובהרצת סריקות בדיקה. הנה מה שבדקתי:
- יכולת טכנית: האם הוא מסתדר עם אתרים מודרניים (JavaScript, התחברויות, תוכן דינמי)?
- קלות שימוש: האם הוא ידידותי גם לאנשים לא טכניים, או שצריך פה קסמים של שורת פקודה?
- מגבלות בתוכנית החינמית: האם הוא באמת חינמי, או רק דוגמית?
- זמינות אונליין: האם זה כלי ענן, אפליקציית דסקטופ או ספריית קוד?
- תכונות ייחודיות: האם יש לו משהו מיוחד — כמו חילוץ בעזרת AI, מפות אתר ויזואליות או סריקה מונעת אירועים?
בדקתי כל כלי, עברתי על משוב משתמשים והשוויתי תכונות זו מול זו. אם כלי גרם לי לרצות לזרוק את הלפטופ מהחלון — הוא לא נכנס לרשימה.
טבלת השוואה מהירה: 10 סורקי האתרים החינמיים הטובים ביותר במבט אחד
| כלי וסוג | תכונות מרכזיות | מקרה שימוש מתאים | דרישות טכניות | פרטי התוכנית החינמית |
|---|---|---|---|---|
| Bright Data (ענן/API) | סריקה ברמת ארגונים, פרוקסי, עיבוד JS, פתרון CAPTCHA | איסוף נתונים בקנה מידה גדול | קצת ידע טכני מועיל | שכבה חינמית: 5,000 רשומות בחודש ב־Web Scraper API, בלי כרטיס אשראי |
| Crawlbase (ענן/API) | סריקת API, אנטי־בוט, פרוקסי, עיבוד JS | מפתחים שצריכים תשתית סריקה בצד השרת | אינטגרציית API | חינם: עד 20,000 בקשות להתחלה, בלי כרטיס אשראי; לאחר מכן תשלום לפי בקשה |
| ScraperAPI (ענן/API) | סיבוב פרוקסי, עיבוד JS, סריקה אסינכרונית, נקודות קצה מוכנות | מפתחים, מעקב מחירים, נתוני SEO | התקנה מינימלית | חינם: 5,000 קריאות API ל־7 ימים, ואז 1,000 בחודש |
| Diffbot Crawlbot (ענן) | סריקה וחילוץ בעזרת AI, Knowledge Graph, עיבוד JS | נתונים מובנים בקנה מידה גדול, AI/ML | אינטגרציית API | חינם: 10,000 קרדיטים בחודש ל־Extract APIs; את Crawl עצמה כוללת רק תוכנית Plus |
| Screaming Frog (דסקטופ) | בדיקות SEO, ניתוח קישורים/מטא, Sitemap, חילוץ מותאם אישית | בדיקות SEO, מנהלי אתרים | אפליקציית דסקטופ, GUI | חינם: 500 כתובות URL לכל סריקה, רק הפונקציות הבסיסיות |
| SiteOne Crawler (דסקטופ) | SEO, ביצועים, נגישות, אבטחה, ייצוא אופליין, Markdown | מפתחים, QA, העברה, תיעוד | דסקטופ/CLI, GUI | חינם וקוד פתוח, 1,000 כתובות URL בדוח GUI (ניתן להגדרה) |
| Crawljax (Java, קוד פתוח) | סריקה מונעת אירועים לאתרים כבדי JS, ייצוא סטטי | מפתחים, QA של יישומי ווב דינמיים | Java, CLI/קונפיגורציה | חינם וקוד פתוח, ללא מגבלות |
| Apache Nutch (Java, קוד פתוח) | מבוזר, מבוסס תוספים, אינטגרציה עם Hadoop, חיפוש מותאם | מנועי חיפוש מותאמים, סריקה בקנה מידה גדול | Java, שורת פקודה | חינם וקוד פתוח, רק עלות תשתית |
| YaCy (Java, קוד פתוח) | סריקה וחיפוש peer-to-peer, פרטיות, אינדוקס ווב/אינטרה־נט | חיפוש פרטי, ביזור | Java, ממשק דפדפן | חינם וקוד פתוח, ללא מגבלות |
| PowerMapper (דסקטופ/SaaS) | מפות אתר ויזואליות, נגישות, QA, תאימות לדפדפנים | סוכנויות, QA, מיפוי ויזואלי | GUI, פשוט לשימוש | ניסיון חינם: 30 יום, 100 דפים (דסקטופ) או 10 דפים (אונליין) לכל סריקה |
הערת אזהרה לפני שממשיכים: “חינם” אומר דברים מאוד שונים בעמודה האחרונה. SiteOne, Crawljax, Nutch ו־YaCy הם קוד פתוח — חינמיים בלי תקרה, מלבד החומרה שלכם. Screaming Frog חינמי לנצח, אבל מוגבל ל־500 כתובות URL לכל סריקה. Bright Data, ScraperAPI ו־Diffbot מציעים שכבות חינמיות קבועות שהן אמיתיות אבל קטנות, ובמקרה של Diffbot הסורק עצמו הוא החלק שלא נכלל בתוכנית החינמית. Crawlbase נותנת בלוק אחד של בקשות חינם בהתחלה ואז מחייבת לפי בקשה. PowerMapper הוא הניסיון החינמי היחיד ברשימה — כשה־30 יום נגמרים, משלמים.
Bright Data: סורק אתרים בענן ברמת ארגונים
Bright Data היא ה־“heavyweight” של עולם סריקת האתרים. זו פלטפורמת ענן עם רשת פרוקסי ענקית, עיבוד JavaScript, פתרון CAPTCHA ו־IDE לסריקות מותאמות אישית. אם אתם מבצעים איסוף נתונים בקנה מידה גדול — למשל מעקב אחר מאות אתרי e-commerce לצורך מחירים — קשה להתחרות בתשתית של Bright Data (aimultiple.com).
חוזקות:
- מתמודדת היטב עם אתרים קשים שכוללים מנגנוני אנטי־בוט
- מתאימה להיקפים של ארגונים
- תבניות מוכנות מראש לאתרים נפוצים
מגבלות:
- השכבה החינמית אמיתית אבל קטנה: 5,000 רשומות בחודש ב־Web Scraper API
- עלולה להיות מוגזמת עבור בדיקות פשוטות
- יש עקומת למידה מסוימת למשתמשים לא טכניים
אם אתם צריכים לסרוק את הרשת בקנה מידה גדול, Bright Data דומה לשכירת מכונית פורמולה 1. 5,000 הרשומות החודשיות החינמיות יאפשרו לכם לעשות סיבוב קצר; מעבר לזה — המחיר מחושב לפי שימוש (Bright Data Pricing).
Crawlbase: סורק ווב חינמי למפתחים, מונע API
Crawlbase (לשעבר ProxyCrawl) מתמקדת בסריקה פרוגרמטית. אתם שולחים להם API עם כתובת URL, והוא מחזיר את ה־HTML — תוך טיפול בפרוקסי, geotargeting ו־CAPTCHAs מאחורי הקלעים (Capterra).
חוזקות:
- שיעורי הצלחה גבוהים מאוד (99%+)
- מסתדר עם אתרים כבדי JavaScript
- מצוין לשילוב בתוך אפליקציות או תהליכי עבודה משלכם
מגבלות:
- דורש אינטגרציה מסוימת עם API או SDK
- תוכנית חינמית: עד 20,000 בקשות להתחלה (בלי כרטיס אשראי), ואז תשלום לפי בקשה
אם אתם מפתחים שרוצים לסרוק (ואולי גם לסקרייפ) בקנה מידה גדול בלי לנהל פרוקסי בעצמכם, Crawlbase היא בחירה חזקה (Crawlbase Pricing).
ScraperAPI: פשטות בסריקה של אתרים דינמיים
ScraperAPI היא ה־API של “פשוט תביא לי את זה”. אתם נותנים לה URL, והיא מטפלת בפרוקסי, דפדפנים headless ואמצעי אנטי־בוט, ומחזירה את ה־HTML (או נתונים מובנים עבור חלק מהאתרים). היא מתאימה במיוחד לדפים דינמיים, אבל חלק ה“חינם” צנוע: 5,000 קרדיטי API ל־7 הימים הראשונים, בלי צורך בכרטיס, ואז 1,000 קרדיטים בחודש בתוכנית החינמית המתמשכת (ScraperAPI Pricing).
חוזקות:
- פשוטה מאוד למפתחים (רק קריאת API)
- מטפלת ב־CAPTCHA, חסימות IP ו־JavaScript
- חינם: 5,000 קריאות API ל־7 ימים, ואז 1,000 בחודש
מגבלות:
- אין דוחות סריקה ויזואליים
- תצטרכו לכתוב לוגיקה לסריקה אם אתם רוצים לעקוב אחרי קישורים
אם אתם רוצים לשלב web crawling בקוד שלכם בתוך דקות, ScraperAPI היא פתרון כמעט מובן מאליו.
Diffbot Crawlbot: גילוי אוטומטי של מבנה אתר
Diffbot Crawlbot הוא המקום שבו הדברים מתחילים להיות חכמים באמת. הוא לא רק סורק — הוא משתמש ב־AI כדי לסווג דפים ולחלץ נתונים מובנים (מאמרים, מוצרים, אירועים וכו’) ל־JSON. זה כמו להעסיק עוזר רובוטי שבאמת מבין את מה שהוא קורא (Diffbot Free Plan).
חוזקות:
- חילוץ מבוסס AI, לא רק סריקה
- מסתדר עם JavaScript ותוכן דינמי
- חינם: 10,000 קרדיטים בחודש, בלי כרטיס אשראי, כולל Extract, Natural Language, Knowledge Graph ו־Search
מגבלות:
- מיועד בעיקר למפתחים (אינטגרציית API)
- לא כלי SEO ויזואלי — יותר לפרויקטי נתונים
- ה־Crawlbot עצמו — החלק שסורק אתר שלם — נמצא בתוכנית Plus ומעלה; הקרדיטים החינמיים מכסים את ה־APIs של החילוץ (Diffbot Pricing)
אם אתם צריכים נתונים מובנים בקנה מידה גדול, במיוחד עבור AI או אנליטיקה, Diffbot הוא כוח רציני.
Screaming Frog: סורק SEO חינמי לדסקטופ
Screaming Frog הוא הקלאסיקה של סורקי הדסקטופ לבדיקות SEO. הוא סורק עד 500 כתובות URL בכל סריקה (בגרסה החינמית) ונותן לכם כמעט הכול: קישורים שבורים, תגי מטא, תוכן כפול, מפת אתר ועוד (Screaming Frog User Guide).
חוזקות:
- מהיר, מקיף ואמין בעולם ה־SEO
- בלי קוד — פשוט מזינים URL ומתחילים
- חינם עד 500 כתובות URL לכל סריקה
מגבלות:
- רק לדסקטופ (אין גרסת ענן)
- תכונות מתקדמות (כמו עיבוד JS ותזמון) דורשות רישיון בתשלום
אם SEO חשוב לכם באמת, Screaming Frog הוא כלי חובה — רק אל תצפו שיסרוק בחינם אתר של 10,000 דפים.
SiteOne Crawler: ייצוא אתר סטטי ותיעוד
SiteOne Crawler הוא ה־Swiss Army knife של בדיקות טכניות. הוא בקוד פתוח, חוצה פלטפורמות, ויכול לסרוק, לבדוק ואפילו לייצא את האתר שלכם ל־Markdown לצורכי תיעוד או שימוש אופליין (SiteOne Crawler).
חוזקות:
- מכסה SEO, ביצועים, נגישות ואבטחה
- מייצא אתרים לארכוב או להעברה
- חינם וקוד פתוח, בלי מגבלות שימוש
מגבלות:
- טכני יותר מכמה כלים גרפיים אחרים
- דוח הבדיקה בממשק GUI מוגבל כברירת מחדל ל־1,000 כתובות URL (ניתן לשינוי)
אם אתם מפתחים, QA או יועצים שרוצים תובנות עמוקות ואוהבים קוד פתוח, SiteOne הוא פנינה נסתרת.
Crawljax: סורק Java בקוד פתוח לדפים דינמיים
Crawljax הוא מומחה: הוא נועד לסרוק יישומי ווב מודרניים וכבדי JavaScript על ידי סימולציה של אינטראקציות משתמש (קליקים, מילוי טפסים וכו’). הוא מונע אירועים ואפילו יכול להוציא גרסה סטטית של אתר דינמי (Wikipedia: Crawljax).
חוזקות:
- מעולה במיוחד לסריקת SPA ואתרים עתירי AJAX
- בקוד פתוח וניתן להרחבה
- בלי מגבלות שימוש
מגבלות:
- דורש Java וקצת תכנות/קונפיגורציה
- לא מתאים למשתמשים לא טכניים
אם אתם צריכים לסרוק אפליקציית React או Angular כמו משתמש אמיתי, Crawljax הוא חבר טוב.
Apache Nutch: סורק אתרים מבוזר וניתן להרחבה
Apache Nutch הוא ה־granddaddy של סורקי הקוד הפתוח. הוא מיועד לסריקות ענק מבוזרות — למשל לבניית מנוע חיפוש משלכם או לאינדוקס של מיליוני דפים (Martechvibe).
חוזקות:
- מתרחב למיליארדי דפים עם Hadoop
- ניתן להגדרה ולהרחבה ברמה גבוהה
- חינם וקוד פתוח
מגבלות:
- עקומת למידה חדה (Java, שורת פקודה, קונפיגורציות)
- לא מתאים לאתרים קטנים או למשתמשים מזדמנים
אם אתם רוצים לסרוק את הרשת בקנה מידה גדול ולא נרתעים מעבודה עם ה־command line, Nutch הוא הכלי שלכם.
YaCy: סורק ווב ומנוע חיפוש peer-to-peer
YaCy הוא סורק ומנוע חיפוש מבוזר וייחודי. כל מופע סורק ומאנדקס אתרים, ואפשר להצטרף לרשת peer-to-peer כדי לשתף אינדקסים עם אחרים (TechRadar: YaCy).
חוזקות:
- ממוקד פרטיות, בלי שרת מרכזי
- מצוין לבניית חיפוש פרטי או אינטרה־נט
- חינם וקוד פתוח
מגבלות:
- התוצאות תלויות בכיסוי של הרשת
- נדרשת התקנה מסוימת (Java, ממשק דפדפן)
אם ביזור מעניין אתכם או שאתם רוצים מנוע חיפוש משלכם, YaCy היא אפשרות מרתקת.
PowerMapper: מחולל מפת אתר ויזואלית ל־UX ול־QA
PowerMapper מתמקד בהמחשה של מבנה האתר. הוא סורק את האתר שלכם ומייצר מפות אתר אינטראקטיביות, ובנוסף בודק נגישות, תאימות לדפדפנים ואלמנטים בסיסיים של SEO (Slickplan Review).
חוזקות:
- מפות אתר ויזואליות נהדרות לסוכנויות ומעצבים
- בודק נגישות ועמידה בדרישות
- ממשק GUI פשוט, בלי צורך בידע טכני
מגבלות:
- רק ניסיון חינם (30 יום, 100 דפים בדסקטופ / 10 דפים אונליין לכל סריקה)
- הגרסה המלאה בתשלום
אם אתם צריכים להציג מפה ללקוח או לבדוק ציות לדרישות, PowerMapper הוא כלי שימושי מאוד.
איך לבחור את סורק הווב החינמי המתאים לצרכים שלכם
עם כל כך הרבה אפשרויות, איך בוחרים? הנה המדריך הקצר שלי:
- לבדיקות SEO: Screaming Frog (אתרים קטנים), PowerMapper (ויזואלי), SiteOne (בדיקות עומק)
- לאפליקציות ווב דינמיות: Crawljax
- לסריקה בקנה מידה גדול או לחיפוש מותאם: Apache Nutch, YaCy
- למפתחים שצריכים גישת API: Crawlbase, ScraperAPI, Diffbot
- לתיעוד או לארכוב: SiteOne Crawler
- לקנה מידה ארגוני עם שכבה חינמית קטנה: Bright Data, Diffbot
גורמים מרכזיים שכדאי לשקול:
- סקיילביליות: כמה גדול האתר או משימת הסריקה שלכם?
- קלות שימוש: אתם נוחים עם קוד, או מעדיפים קליק-קליק?
- ייצוא נתונים: אתם צריכים CSV, JSON או אינטגרציה עם כלים אחרים?
- תמיכה: יש קהילה או תיעוד שיעזרו אם נתקעים?
כש־Web Crawling פוגש Web Scraping: למה Thunderbit היא בחירה חכמה יותר
חלץ נתונים מכל אתר בעזרת AI ה־web scraper הסוכן של Thunderbit קורא כל אתר שצריך לסרוק ומחלץ נתונים מובנים בלחיצה אחת — חינם ל־6 דפים בחודש. Get Started Free
בואו נדבר תכל’ס: רוב האנשים לא סורקים אתרים רק כדי ליצור מפות יפות. בדרך כלל המטרה האמיתית היא לקבל נתונים מובנים — בין אם מדובר ברשימות מוצרים, פרטי קשר או מלאי תוכן. כאן Thunderbit נכנסת לתמונה.
Thunderbit היא לא רק crawler או scraper — זו תוסף Chrome מבוסס AI שמשלב את שניהם. כך זה עובד:
- AI Crawler: Thunderbit חוקרת את האתר, בדיוק כמו crawler.
- Waterfall Crawling: אם המנוע של Thunderbit לא מצליח להגיע לדף (אולי יש שכבת אנטי־בוט קשוחה), הוא עובר אוטומטית לשירותי סריקה צד שלישי — בלי הגדרה ידנית.
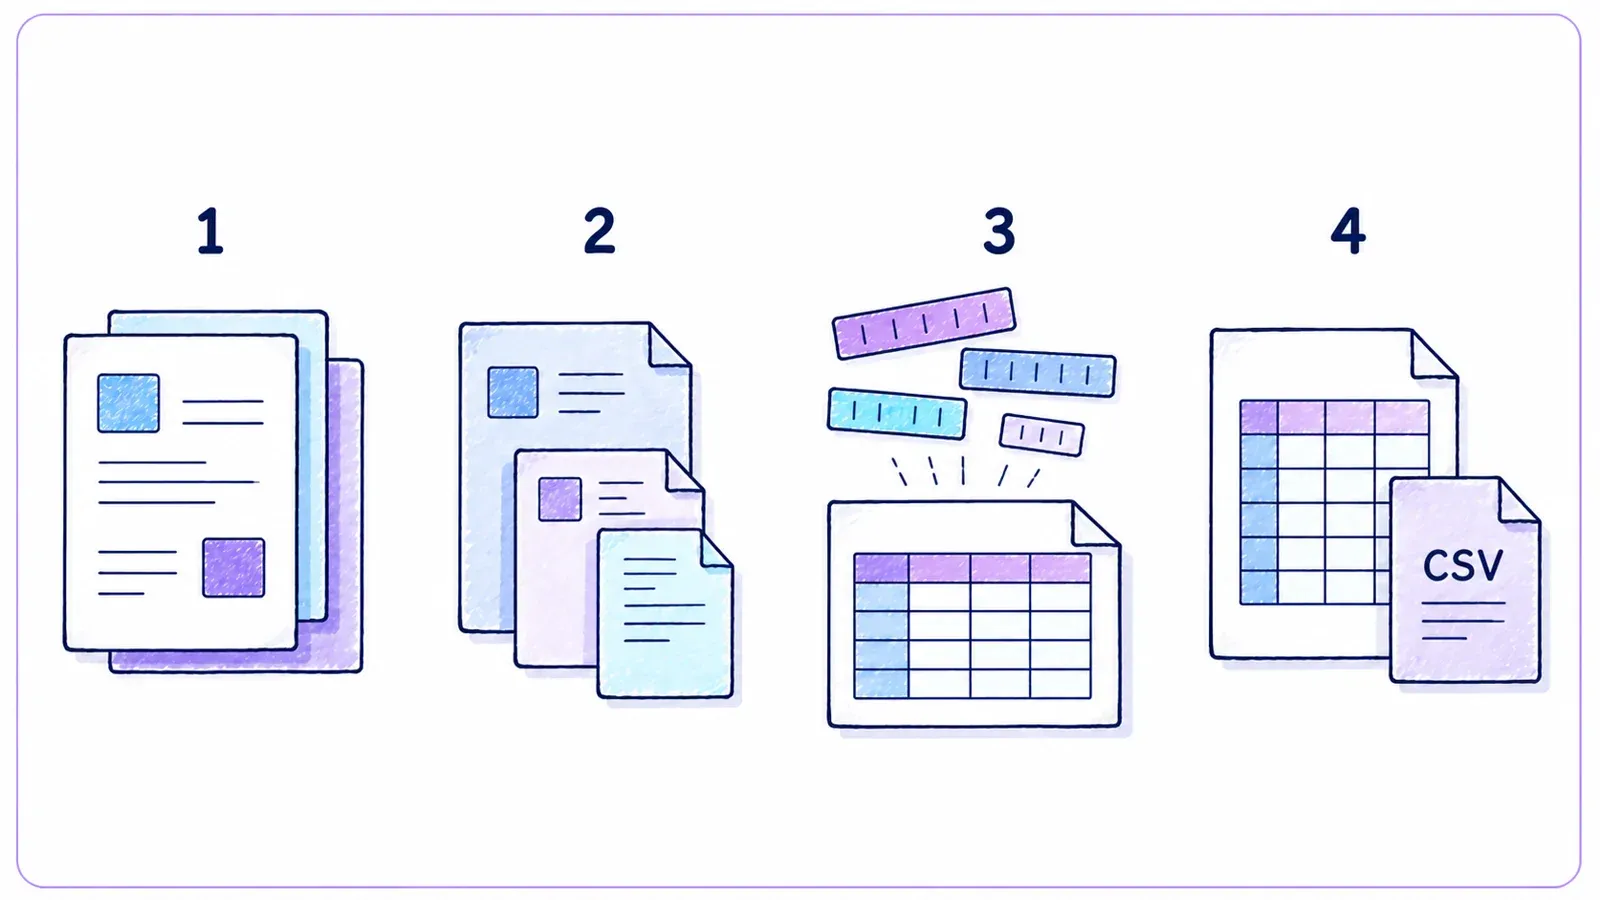
- AI Data Structuring: אחרי שה־HTML בידיה, ה־AI של Thunderbit מציע את העמודות הנכונות ומחלץ נתונים מובנים (שמות, מחירים, אימיילים וכו’) בלי שתצטרכו לכתוב אפילו סלקטור אחד.
- Subpage Scraping: צריכים פרטים מכל דף מוצר? Thunderbit יכולה לבקר אוטומטית בכל דף משנה ולהעשיר את הטבלה שלכם.
- ניקוי וייצוא נתונים: היא יכולה לסכם, לסווג, לתרגם ולייצא את הנתונים ל־Excel, Google Sheets, Airtable או Notion בלחיצה אחת.
- פשטות ללא קוד: אם אתם יודעים להשתמש בדפדפן, אתם יודעים להשתמש ב־Thunderbit. בלי קוד, בלי פרוקסי, בלי כאב ראש.
מתי כדאי לבחור ב־Thunderbit במקום בסורק מסורתי?
- כשמטרת הסיום שלכם היא גיליון מסודר ושימושי — לא רק רשימת URL-ים.
- כשאתם רוצים לאוטומט את כל התהליך (סריקה, חילוץ, ניקוי, ייצוא) במקום אחד.
- כשאתם מעריכים את הזמן והשפיות שלכם.
אפשר להוריד את תוסף Chrome של Thunderbit כאן ולראות בעצמכם למה כל כך הרבה משתמשים עסקיים עוברים אליו.
נסו את Thunderbit בחינם – Agentic Web Scraper התקינו את תוסף Chrome החינמי והתחילו לסרוק כל אתר בלחיצה אחת, בלי צורך בקוד. Get Started Free
מסקנה: להפיק את המקסימום מסורקי אתרים חינמיים
ראו איך Agentic Web Scraping עובד ה־AI של Thunderbit קורא דף כמו אדם ומחליט מה לחלץ, במקום להסתמך על הגדרה ידנית של הסורק. Get Started Free
סורקי אתרים עברו כברת דרך. בין אם אתם אנשי שיווק, מפתחים או פשוט רוצים לשמור על האתר שלכם בריא — יש עבורכם כלי חינמי (או לפחות חינמי לניסיון). מפלטפורמות ארגוניות כמו Bright Data ו־Diffbot, דרך פנינים בקוד פתוח כמו SiteOne ו־Crawljax, ועד כלים ויזואליים כמו PowerMapper — המבחר מגוון מתמיד.
אבל אם אתם מחפשים דרך חכמה ומשולבת יותר לעבור מ“אני צריך את הנתונים האלה” ל“הנה הגיליון שלי”, שווה לנסות את Thunderbit. היא נבנתה עבור משתמשים עסקיים שרוצים תוצאות, לא רק דוחות.
מוכנים להתחיל לסרוק? הורידו כלי, הריצו סריקה ותראו מה פספסתם. ואם אתם רוצים לעבור מסריקה לנתונים שאפשר לפעול לפיהם בלחיצה אחת, בדקו את Thunderbit.
לתכנים מעמיקים ומדריכים מעשיים נוספים, בקרו ב־Thunderbit Blog.
חלצו נתוני אתר בעזרת AI בלחיצה אחת הגדירו את Thunderbit לעקוב אחרי דפי משנה ולפעול לפי לוח זמנים, כך שהסריקה תישאר מעודכנת בלי הרצות ידניות חוזרות. Get Started Free
נסו Agentic Web Scraper Get Started Free
שאלות נפוצות
מה ההבדל בין website crawler ל־web scraper?
Crawler מגלה וממפה את כל הדפים באתר (תחשבו: יצירת תוכן עניינים). Scraper מחלץ שדות נתונים ספציפיים (כמו מחירים, אימיילים או ביקורות) מהדפים האלה. Crawler מחפש, scraper חופר (Thunderbit Blog: What Is a Web Crawler?).
איזה web crawler חינמי הכי מתאים למשתמשים לא טכניים?
לאתרים קטנים ובדיקות SEO, Screaming Frog ידידותי לשימוש. למיפוי ויזואלי, PowerMapper מצוין בזמן הניסיון. Thunderbit היא האפשרות הקלה ביותר אם המטרה שלכם היא נתונים מובנים וחוויה מבוססת דפדפן בלי קוד.
האם יש אתרים שחוסמים web crawlers?
כן — חלק מהאתרים משתמשים בקובצי robots.txt או באמצעי אנטי־בוט כמו CAPTCHAs או חסימות IP כדי לעצור סורקים. כלים כמו ScraperAPI, Crawlbase ו־Thunderbit (עם waterfall crawling) יכולים לעיתים להתגבר על זה, אבל חשוב לסרוק באחריות ולכבד את חוקי האתר (Bright Data Pricing).
האם לסורקי אתרים חינמיים יש מגבלות על מספר דפים או תכונות?
ברוב המקרים כן. למשל, הגרסה החינמית של Screaming Frog מוגבלת ל־500 כתובות URL לכל סריקה; הניסיון של PowerMapper מוגבל ל־100 דפים. כלים מבוססי API כוללים לרוב מגבלות קרדיטים חודשיות. כלים בקוד פתוח כמו SiteOne או Crawljax בדרך כלל לא מוגבלים בצורה קשיחה, אבל אתם כן מוגבלים על ידי החומרה שלכם.
האם שימוש ב־web crawler חוקי ותואם לפרטיות?
בדרך כלל, סריקה של דפי ווב ציבוריים היא חוקית, אבל תמיד כדאי לבדוק את תנאי השימוש של האתר ואת robots.txt. אל תסרקו נתונים פרטיים או מוגני סיסמה בלי רשות, והיו מודעים לחוקי פרטיות אם אתם מחלצים מידע אישי (Crawlbase Guide).



