
סיכום מנהלים
משכנו את קובץ robots.txt של כל דומיין ברשימת Tranco top 10,000 של אתרי האינטרנט בעלי התעבורה הגבוהה בעולם. לאחר מכן ניתחנו כל קובץ באמצעות מפרש תואם RFC 9309, סיווגנו את הקובץ לפי מדיניות הבוטים של AI שאותה האתר אימץ, וספרנו כמה מהאתרים הנצפים ביותר בעולם אכן מנסים לחסום את ChatGPT, Claude, Perplexity, Gemini, Common Crawl, Bytespider, Apple Intelligence ושאר הסורקים שמאמנים ומשרתים מודלים שפתיים גדולים בשנת 2026.
המספרים המרכזיים, על מדגם של 7,248 אתרים שאת robots.txt שלהם הצלחנו לקרוא בצורה נקייה:
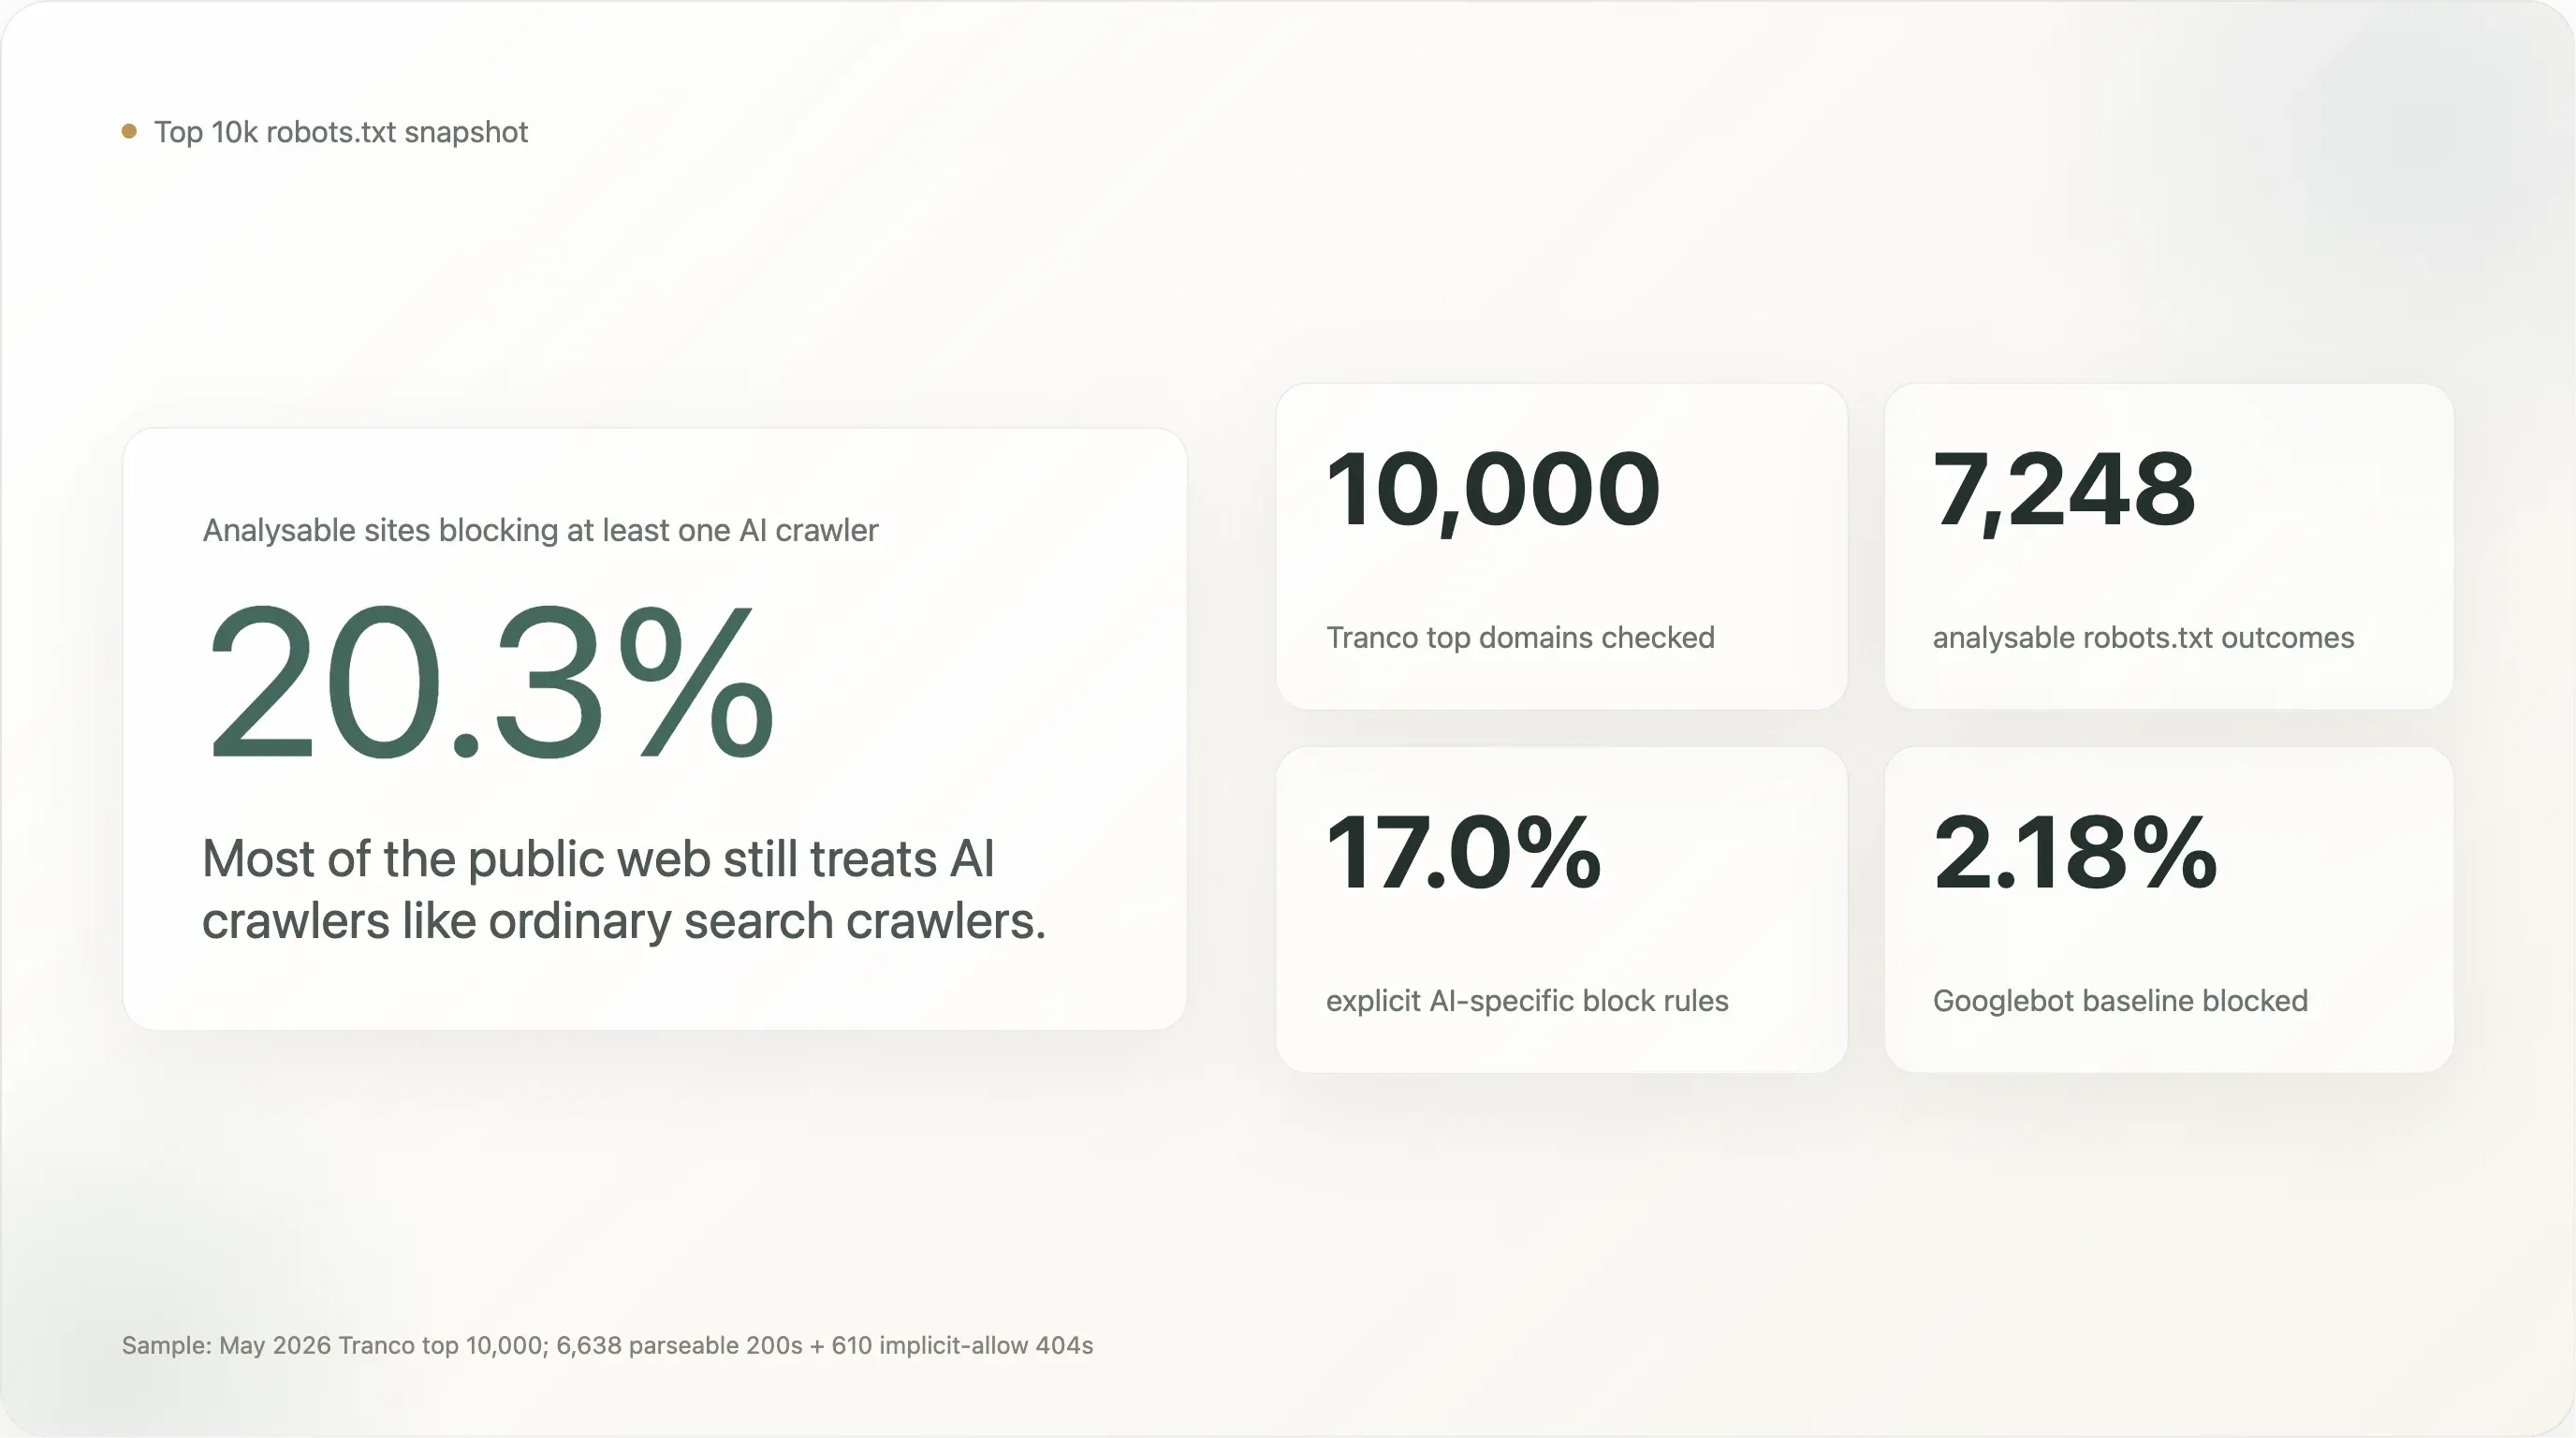
20.3% מהאתרים ב־10,000 המובילים בעולם חוסמים לפחות סורק AI אחד. ל־17.0% יש כלל מפורש וספציפי ל־AI שנכתב בכוונה. שאר 80% משאירים את סורקי ה־AI רצויים בדיוק כמו Googlebot.
שישה ממצאים שמשנים את צורת הסיפור:
- ארגוני חדשות חוסמים בשיעור של 47% — הגבוה ביותר מבין כל המגזרים. החדשות הגרמניות מובילות עם 88%, הצרפתיות עם 80%, והרוסיות עם 0%. המשטר המשפטי, לא הטכנולוגיה ולא הכלכלה הענפית, הוא המניע העיקרי.
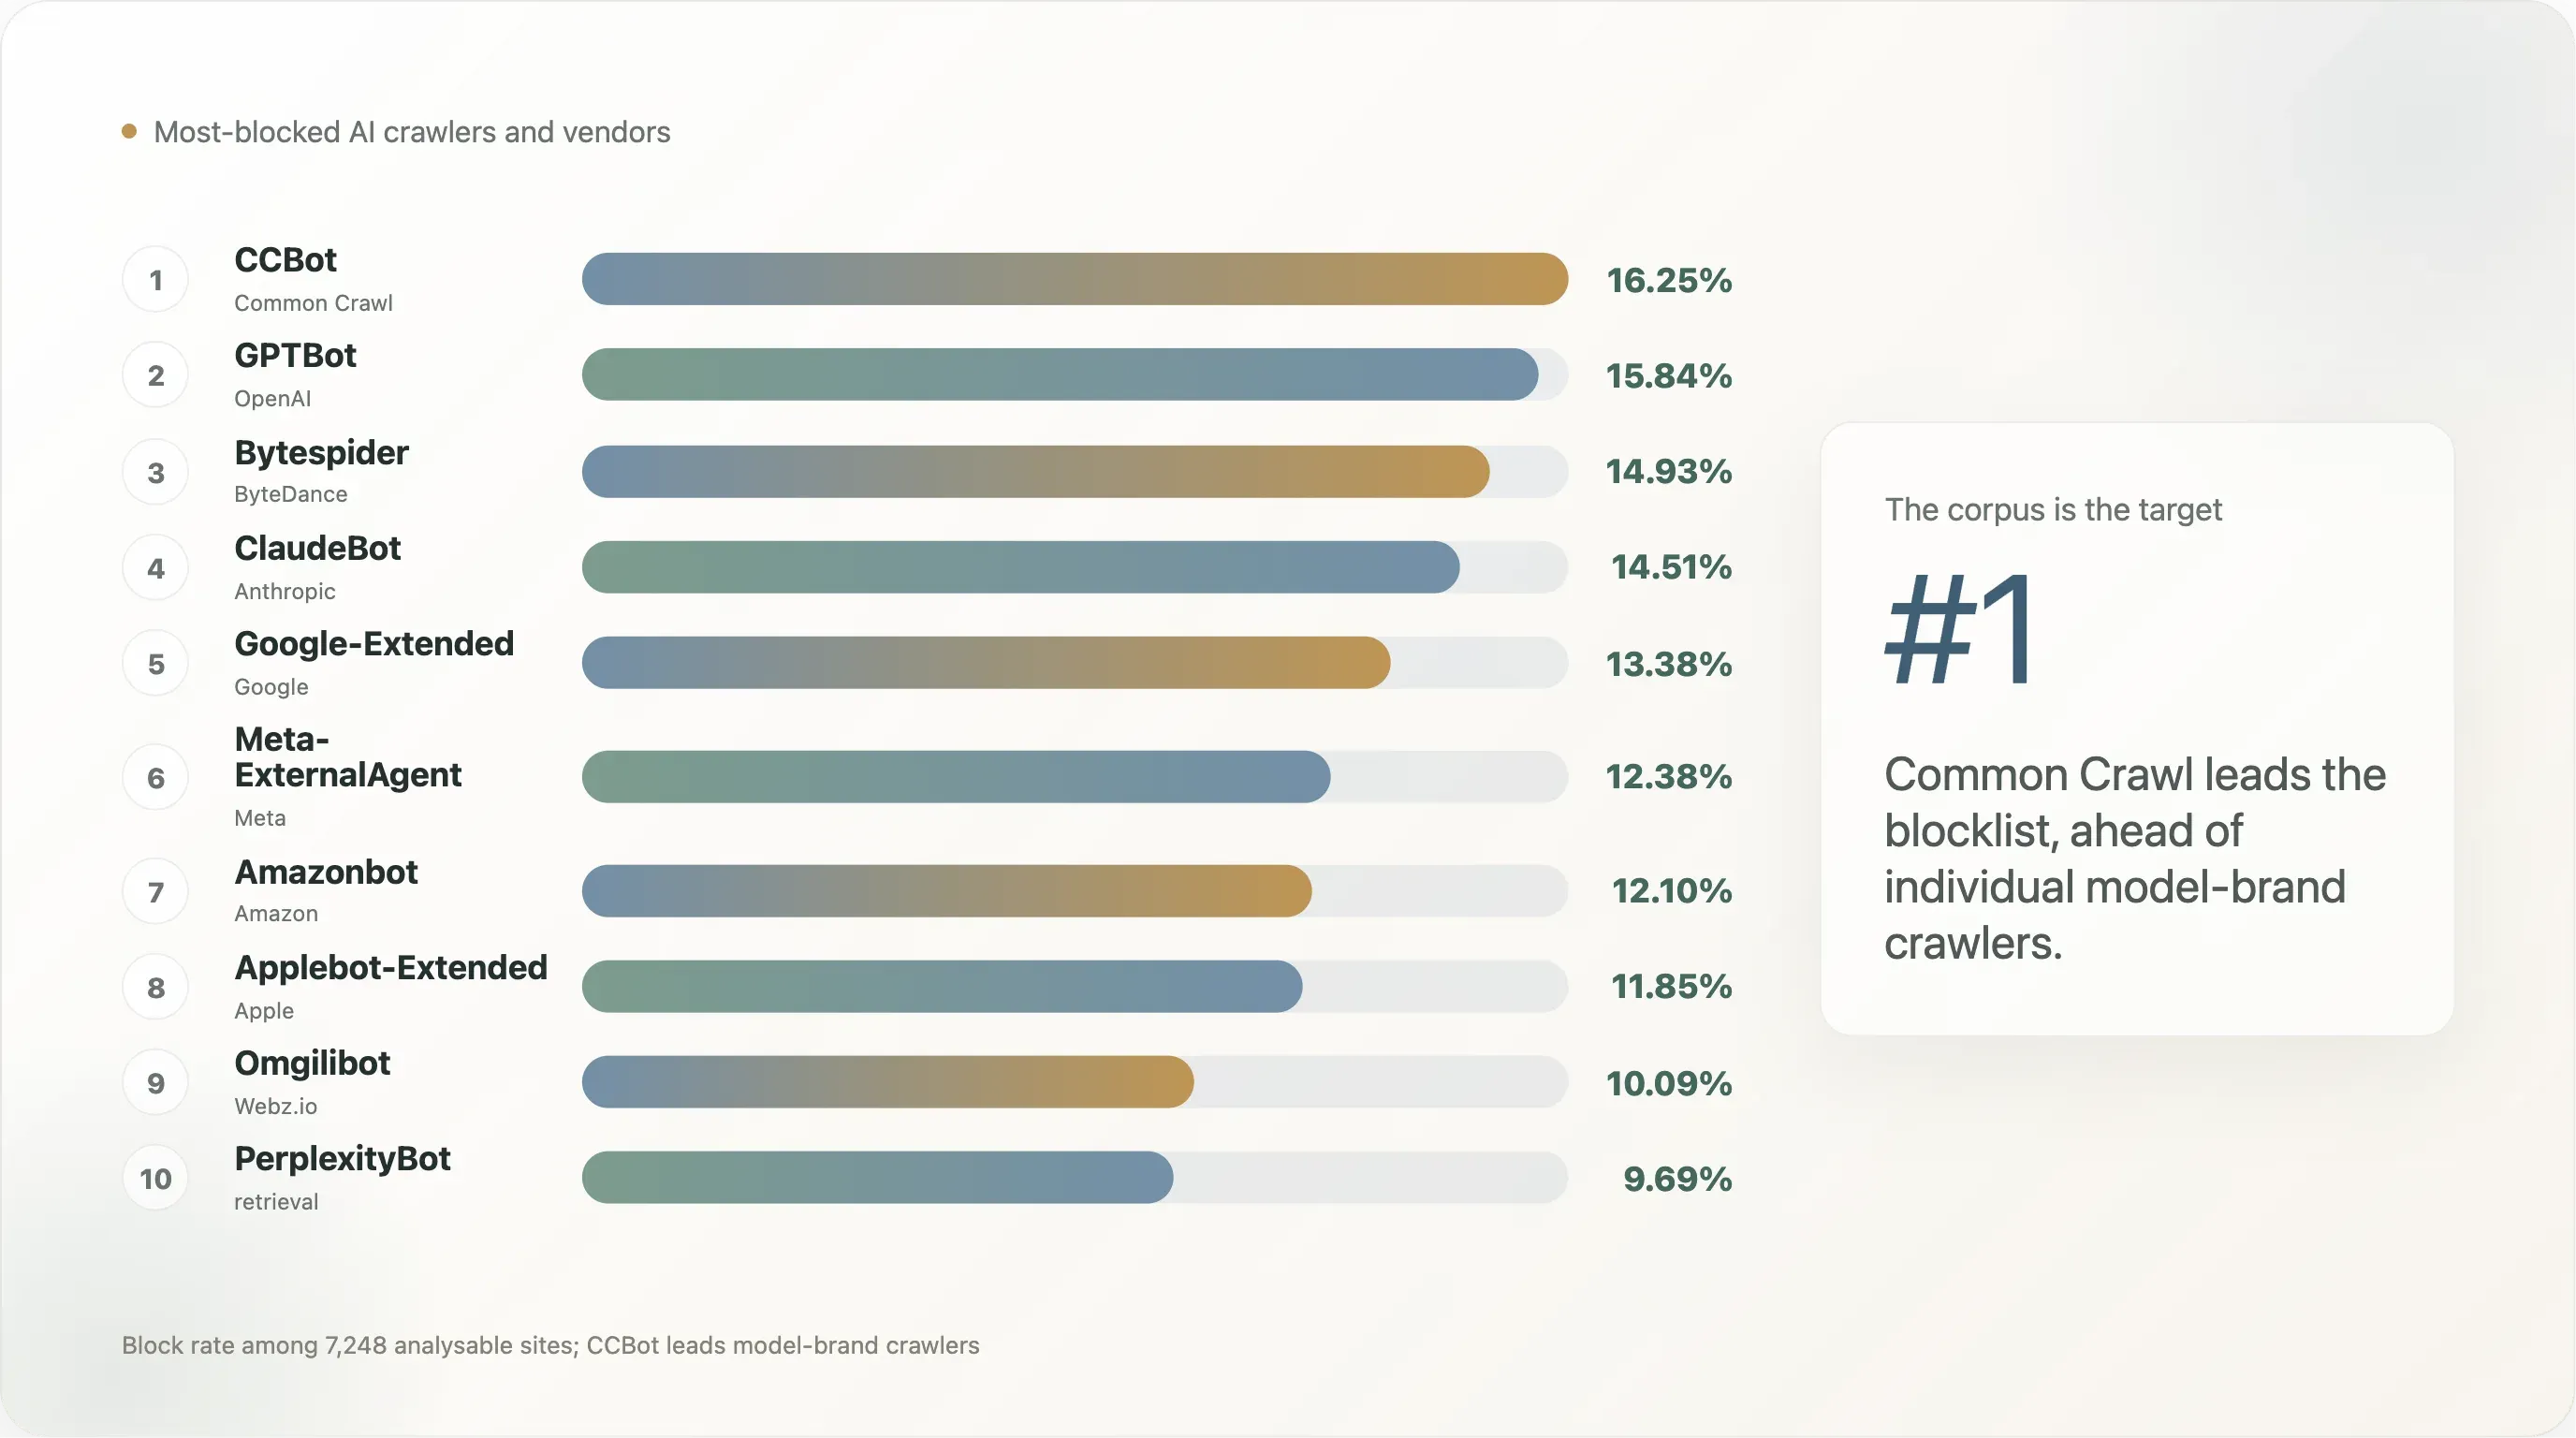
CCBot(Common Crawl) הוא הבוט החסום ביותר, עם 16.3% — לפניGPTBot(15.8%) ו־Bytespider(14.9%). המו״לים מכוונים אל קורפוס האימון, לא אל מותג המודל. הכלל הסלקטיבי הנפוץ ביותר הוא "חסמו אתCCBot, אפשרו אתGooglebot" (14.1% מהאתרים).- צרפת מובילה את כל המדינות עם 50.6% חסימה ל־AI באתרים תחת
.fr; אשכול האיחוד האירופי גבוה ב־16 נקודות מהבסיס הגלובלי. 275 קובציrobots.txtמצטטים במפורש את הנחיית האיחוד האירופי 2019/790. סעיף 4 הוא המשטר המשפטי היחיד שמזיז את המספרים באופן גלוי. - 17.8% כתבו כללי AI משלהם; 4.5% מריצים את תבנית הספק של Cloudflare; 75.7% לא אומרים דבר. אתרים גדולים כותבים את המדיניות בעצמם; הזנב הארוך משתמש במתג. The Atlantic וגם
cloudflare.comעצמו נמצאים ברשימת Cloudflare Managed. - 108 אתרים מאפשרים במפורש את
GPTBot— WordPress.org, Kaspersky, Norton, Avast, Sophos, The Verge, The Atlantic, NBA.com, The Sun, Branch.io. תחומי אבטחה וכלי פיתוח מיוצגים יתר על המידה. - מדיניות AI לא נעשית אגרסיבית יותר דווקא בראש העקומה. Top 100, 101–1000, 1001–5000, 5001–10000 כולם נעים בין 19% ל־23%. שיעור הכותרת הוא תכונה של הרשת הפתוחה בשנת 2026, לא אינדיקציה לגודל של אתר מסוים.
הסיפור כבר לא עוסק בשאלה אם האינטרנט "מחזיר מלחמה". הוא עוסק בשאלה אילו תעשיות, אילו מדינות, אילו משטרים משפטיים ואילו ספקי AI הם היעד של מדיניות פעילה — ואילו לא.
I. רקע: איך robots.txt הפך לחפץ מדיניות של AI
שלושה כוחות עיצבו מחדש את המשמעות של robots.txt מאז ש־OpenAI השיקה את GPTBot באוגוסט 2023.
ספקי ה־AI התרבו. Google-Extended של גוגל, ClaudeBot של Anthropic, Bytespider של ByteDance, Applebot-Extended של Apple, Amazonbot של Amazon, Meta-ExternalAgent של Meta — כולם הצטרפו. גם CCBot הקיים של Common Crawl הפך ליעד החסימה בעל המינוף הגבוה ביותר, משום שהארכיון שלו מזין את רוב המודלים בקוד פתוח. הופיעו גם בוטים שאינם של ספקי מודלים: AI2Bot, cohere-ai, PerplexityBot, YouBot, DuckAssistBot, Diffbot, Omgili. רשימת חסימות מקיפה לשנת 2026 מונה כ־25 שמות.
סעיף 4 להוראת זכויות היוצרים של האיחוד האירופי 2019/790 יצר חריג סטטוטורי ל־text and data mining, שאינו חל אם בעל הזכויות "שמר במפורש" על זכויותיו באופן "קריא למכונה". לאורך 2024–2025 המו״לים האירופיים והיועצים המשפטיים שלהם התכנסו סביב robots.txt כדרך הקנונית לבטא את השמירה הזו. מערך הנתונים שלנו מראה ש־275 אתרים מצטטים במפורש את הנחיה 2019/790 ו־87 מזכירים "TDM" — בעיקר באתרי חדשות אירופיים, שם זה מופיע כהקדמה משפטית בת 4–8 שורות.
Cloudflare הפכה את המתג למוצר. ב־2024–2025 Cloudflare השיקה לוח מחוונים של "AI Audit", מתג "Block AI Bots", ותבנית robots.txt מנוהלת עם אוצר המילים Content-Signal: search=yes,ai-train=no יחד עם ניסוח סטנדרטי של EU 2019/790. עד מאי 2026 התבנית פועלת על 4.5% מהאתרים שניתן לנתח ב־top 10k. מפת הדרכים של Cloudflare מדברת בפומבי על הפיכת המתג לברירת מחדל לחשבונות חדשים — מה שיזיז את שיעור החסימה הגלובלי ב־5–8 נקודות בלי שאף מו״ל בודד יקבל החלטה.
robots.txt בשנת 2026 הוא כבר לא קובץ התצורה הלא-זוהר שהיה ב־2022. זהו מנגנון לשמירת זכויות יוצרים עם גיבוי אמנותי באיחוד האירופי, חפץ מדיניות מעוצב בידי ספק לאורך הזנב הארוך, וחזית המשא ומתן האיטי בין מי שמפעילים אתרים לבין מי שמאמנים מודלים.
II. מתודולוגיה
ניסינו להפוך את זה למשעמם ולשחזור ככל האפשר. כל הצינור המלא (סקריפטי Python, קובצי CSV מנותחים, ארכיון robots.txt גולמי, תרשימים) פורסם יחד עם הדוח.
מדגם
התחלנו מ־רשימת Tranco נכון למאי 2026, שהורדה כ־top-1m.csv.zip, וחתכנו את 10,000 השורות הראשונות. Tranco מאגד ארבע דירוגי מקור (Cisco Umbrella, Majestic, Farsight ו־Cloudflare Radar), מסנן יציבות לאורך חלון של 30 יום, ומסיר רעש מובהק של סוררים/CDN. הרשימה שהוא מייצר היא הדבר הקרוב ביותר ל־"top-10k גלובלי של תעבורת רשת" שקיים במרחב הפתוח, והיא המדגם הסטנדרטי למחקר רשת אקדמי (ששימש ביותר מ־600 מאמרים שעברו ביקורת עמיתים מאז השקתו ב־KU Leuven ב־2018).
הרשימה כוללת תערובת של (א) אתרי ליבה שאנשים מבקרים בהם, (ב) דומיינים של תשתית / API / DNS / CDN שאין בהם /, ו־(ג) דומיינים המשמשים באופן פנימי בפלטפורמות גדולות (למשל gvt1.com, apple-dns.net, googleusercontent.com). במקום לסנן אותם מראש, השארנו את כולם וסימנו אותם בקטגוריית infrastructure בשכבת הניתוח. הם נושרים באופן טבעי כשמגבילים ל־"אתרים שהחזירו robots.txt שניתן לנתח".
שליפה
עבור כל אחד מ־10,000 הדומיינים ביצענו GET /robots.txt אסינכרוני דרך HTTPS, עם fallback ל־HTTP, הפניות עד ארבעה hops, timeout כולל של 12 שניות, מגבלת גוף של 500KB, ומחרוזת User-Agent של דפדפן אמיתי עם Accept-Language: en-US. מקביליות הוגבלה ל־80 בקשות במקביל. העבודה רצה מ־IP ביתי יחיד בסן פרנסיסקו.
תוצאות השליפה:
| סטטוס | כמות | פרשנות |
|---|---|---|
200 OK | 6,638 | גוף robots.txt הוחזר וניתן לניתוח. |
404 Not Found | 610 | אין robots.txt. RFC 9309 מגדיר זאת כ־"אפשר הכול" באופן משתמע. |
403 Forbidden | 563 | המקור דוחה באופן פעיל בקשות ל־robots.txt. הוחרג מהניתוח. |
429 Too Many Requests | 7 | כמעט ואין ויסות ברמת CDN בטווח דירוג זה. |
fetch_failed (שגיאת TLS / DNS / TCP) | 2,065 | בעיקר דומייני apex של CDN (akamai.net, cloudfront.net, fastly.net, gtld-servers.net, apple-dns.net) שלא מריצים שרת אינטרנט על /. זה לא "חסום" — פשוט אין להם robots.txt להגיש. |
| אחר 4xx/5xx | 117 | מעורב — שגיאות שרת, geofencing, תגובות שגויות. |
זה נותן לנו 7,248 אתרים במדגם הניתן לניתוח (6,638 200 + 610 404). ה־2,065 של fetch_failed הם דומיינים אמיתיים, אבל הם נקודות Apex של CDN/DNS, לא אתרים שאנשים מבקרים בהם, ולטפל בהם כאילו יש להם "מדיניות AI" פשוט לא הגיוני. הם נמצאים במערך הנתונים כסטטיסטיקת נגישות נפרדת.
ניתוח
כל גוף 200 נותח באמצעות protego, מימוש ב־Python של RFC 9309, המשמש בייצור על ידי Scrapy. לכל זוג (אתר, בוט) חישבנו שלושה דברים:
can_fetch_root— האם הבוט רשאי לגשת ל־/, עם סמנטיקת קבוצות הרשומות של התקן, קדימות של כלל ה־longest-match, והעקיפה שלUser-agent: *על ידי חסימה של בוט ספציפי כאשר שניהם קיימים.has_specific_rule— האם הקובץ מכיל שורתUser-agent:שמציינת בדיוק את הבוט הזה (ללא תלות באותיות גדולות/קטנות).disallow_count— כמה הנחיותDisallow:יש בבלוק המתאים, כדי להבחין בין חסימה מלאה של האתר לבין הגבלות ברמת נתיב.
השילוב חשוב, כי "שיעור חסימה" בכותרת מסתיר שני תופעות שונות לגמרי: מותגים שכתבו במכוון User-agent: GPTBot \n Disallow: / כי החליטו להדוף, ומותגים שבלוק גנרי שלהם User-agent: * \n Disallow: / (שהוגדר שנים קודם לסביבת staging או תחזוקה) פשוט חוסם גם כל בוט AI שלא היה קיים בזמן כתיבת התבנית. לאורך הדוח הזה המספר "כל חסימה של AI" כולל את שני הסוגים; המספר "חסימת AI מפורשת" הוא תת־הקבוצה המכוונת.
בוטים שנכללו
עקבנו אחרי 25 בוטים, מקובצים לשלוש קטגוריות:
- סוררי אימון AI (16):
GPTBot,ClaudeBot,anthropic-ai,CCBot,Google-Extended,Meta-ExternalAgent,Bytespider,Applebot-Extended,Diffbot,Amazonbot,ImagesiftBot,FacebookBot,cohere-ai,AI2Bot,Omgili,Omgilibot. - בוטים להסקה / שליפה בזמן אמת (7):
PerplexityBot,Perplexity-User,ChatGPT-User,OAI-SearchBot,ClaudeBot(שמשמש גם לאימון וגם להסקה),YouBot,DuckAssistBot. - בסיס חיפוש (6):
Googlebot,Bingbot,DuckDuckBot,Slurp(Yahoo),Baiduspider,YandexBot.
כמה בוטים חוצים את קו האימון/הסקה. ClaudeBot הוא הבולט ביותר — Anthropic הוציאה משימוש ב־2024 את ה־UA הישן anthropic-ai וכעת משתמשת ב־ClaudeBot גם לאימון וגם לשליפה חיה, כך שכלל Disallow: ClaudeBot כבר לא ממפה בצורה נקייה ל־"חסימת אימון אך שמירת נראות". השארנו את הסיווג כפי שהוא וציינו את ההשלכה בהמשך.
סיווג תעשיות
סיווגנו כל דומיין לאחת מ־16 קופסאות תעשייה (news, social, streaming, ecommerce, search, finance, infrastructure, saas, academia, dev, gov, adult, gambling, travel, telecom, unknown) באמצעות גישה רב־שכבתית:
- מילון דומיינים ידוע — מיפוי ידני של כ־500 דומיינים בעלי תעבורה גבוהה לתעשיות.
- דפוסי TLD / סיומת —
.gov→gov,.eduו־.ac.*→academia, סיומות CDN מוכרות →infrastructure. - מילות מפתח בשם הדומיין — news, post, shop, bank, porn, casino וכו' כאיתותי fallback.
- סריקת דף הבית — עבור אתרים שהשלוש הראשונות לא הצליחו לסווג ושחזרו
robots.txtמסוג200, שלפנו HTML של דף הבית, חילצנו<title>,<meta name="description">,<meta property="og:type">, והרצנו ניקוד מילות מפתח מול רמזים קטגוריאליים בסגנון מודלי שפה.
התוצאה הייתה 3,407 אתרים (34%) עם תגיות תעשייה בטוחות ו־6,593 שנותרו כ־unknown. הקטגוריה unknown נשלטת על ידי פורטלים אזוריים שאינם באנגלית, אתרי מותגים ב־.com שלא נכנסים בבירור לאף קופסה אחת, ומו״לים מסורתיים בשווקים לשפות קטנות שלא היו לנו עבורם ערכים במילון. כאשר הדוח מצטט אחוז לפי תעשייה, המכנה הוא תת־המדגם המסווג של אותה תעשייה, לא כל 10,000 האתרים.
III. ממצאים
ממצא 1 — אתר אחד מכל חמישה מאתרי התנועה הגבוהה חוסם לפחות בוט AI אחד
מתוך 7,248 האתרים הניתנים לניתוח, 1,472 (20.31%) חוסמים לפחות בוט AI אחד. 1,230 (16.97%) כוללים כלל AI מכוון ומפורש. בסיס Googlebot הוא 2.18% (158 אתרים — רובם חסמו הכול כברירת מחדל לתחזוקה או, בשלושה מקרים, מדובר במנועי חיפוש שחוסמים מתחרים).
שיעור ה־20% בכותרת הוא פי 9 מבסיס Googlebot. זהו אכן אות אמיתי — אתרי תנועה גבוהה נוטים פי סדר גודל לחסום סורק AI מאשר סורק חיפוש — אבל זה גם מספר קטן משמעותית מהנרטיב "חסימת AI מגיעה לאימוץ אוניברסלי" שרץ בתקשורת מאז 2024. אפילו ב־10,000 האתרים הנצפים ביותר ברשת, הרוב של 5 מתוך 6 שותק לגבי AI.
הפער בין "כל חסימת AI" (20.3%) לבין "חסימת AI מפורשת" (17.0%) קטן במונחים אבסולוטיים, אבל חשוב מושגית. פער של 3.3 נקודות הוא שיעור האתרים שחוסמים בוטי AI רק כי כלל ה־User-agent: * \n Disallow: / הקיים שלהם תופס את כל מה שעובר, כולל בוטים שלא היו קיימים כשהכלל נכתב. המספר המכוון של 17.0% הוא הקריאה הנקייה יותר של "כמה מהאתרים הגדולים בעולם קיבלו החלטה ספציפית לגבי AI".
בהשוואה לספרות קודמת:
| מקור | תאריך | מדגם | שיעור חסימה |
|---|---|---|---|
| Originality.ai | מרץ 2025 | 1,000 אתרי חדשות פופולריים (אנגלית) | 35.7% חוסמים GPTBot |
| Palewire | אוג׳ 2024 | 1,500 ארגוני חדשות | 36.0% כל סורק AI |
| Reuters Institute | אביב 2025 | 50 מותגי חדשות מובילים, 10 מדינות | 78% כל סורק AI |
| WIRED / NYT | סוף 2023 | 50 אתרי חדשות מובילים בארה״ב | 26% חוסמים GPTBot |
| דוח זה (Thunderbit) | מאי 2026 | Tranco top 10,000 (כל המגזרים) | 20.3% / 17.0% מפורש |
ה־17.0% המפורש שלנו נמוך מכל מחקר שהתמקד רק בחדשות, כי שני שלישים מהמדגם שלנו אינם חדשות. כשהמצמצמים ל־650 אתרי חדשות, מקבלים 47% — בתוך אותו טווח כמו המחקרים הקודמים, אחרי שמחשבים את הרכב המדגם. התמונה המבנית עקבית: קבוצת החדשות חוסמת AI בשיעור הגבוה פי 3–4 מהשאר.
ממצא 2 — צלילות עומק לפי תעשייה: פער של פי 12 מחדשות ועד טלקום
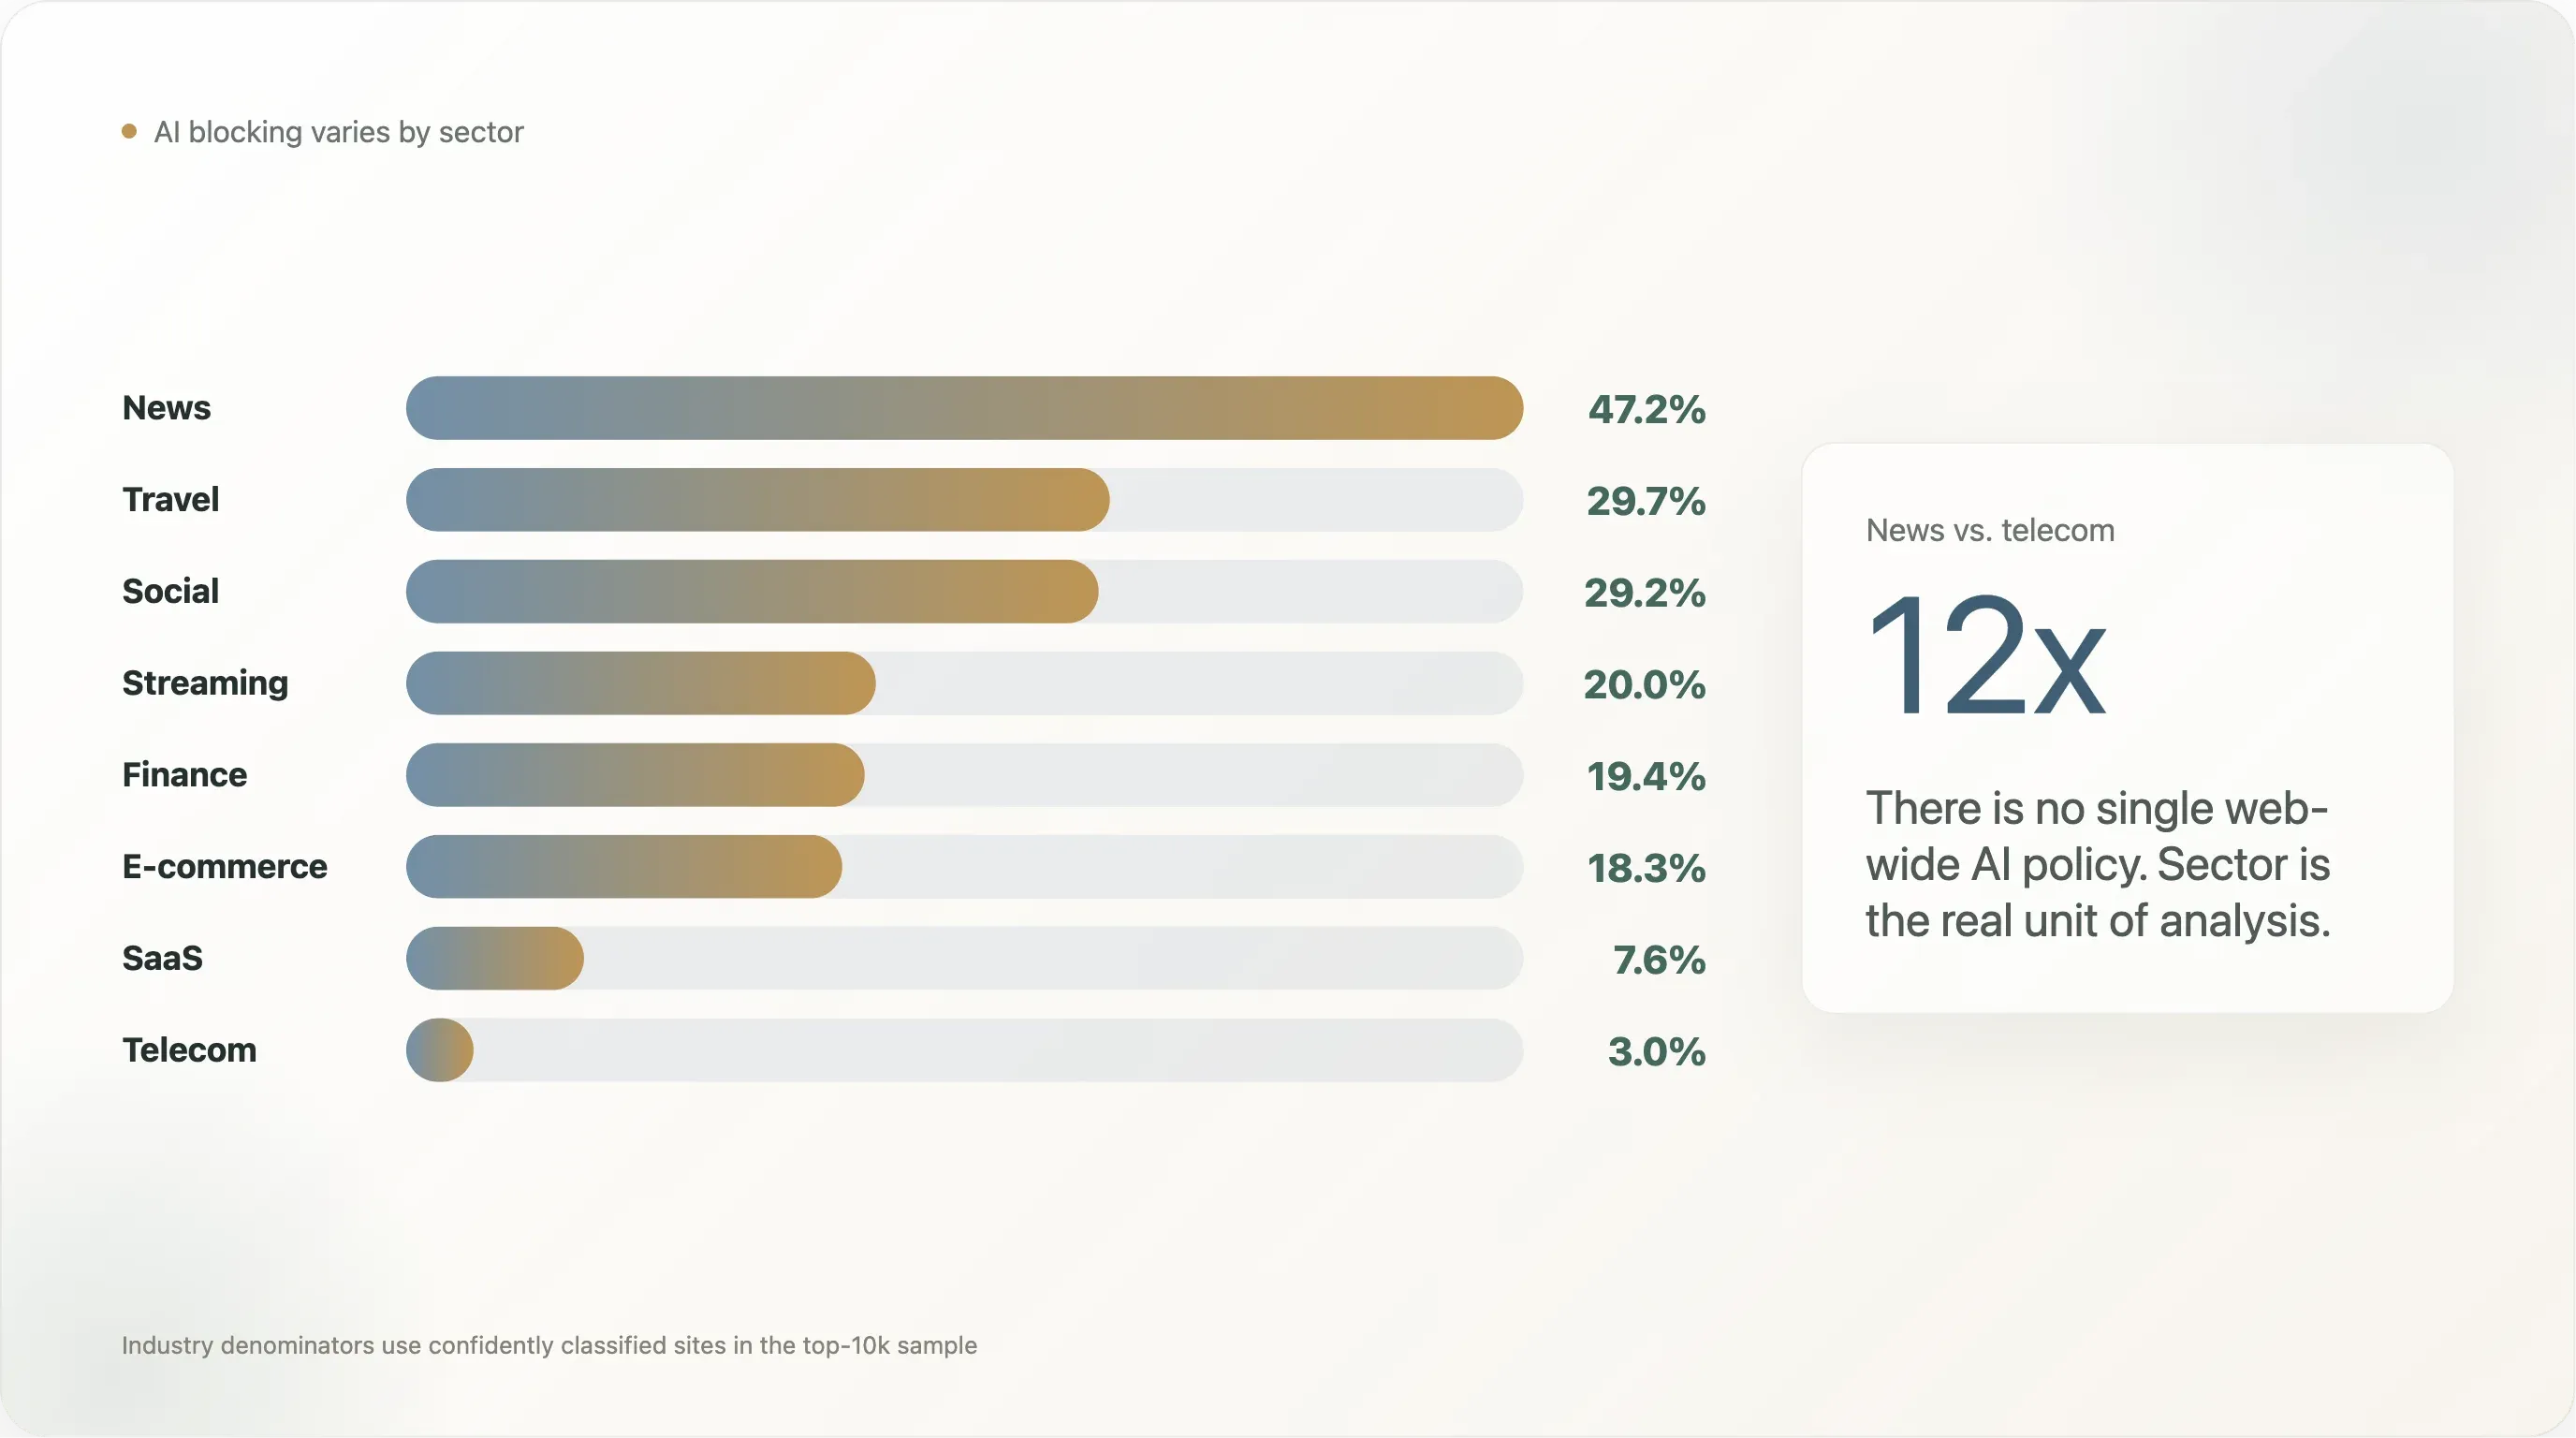
הממצא המצוטט ביותר בשנתיים של כיסוי "AI scraping" היה 80% מארגוני החדשות חוסמים GPTBot מתוך Originality.ai ו־Palewire. החיתוך שלנו נותן מספר קטן יותר, אך עדיין מובחן: 47.2% מאתרי החדשות ב־top 10,000 חוסמים לפחות בוט AI אחד, ו־45.2% כותבים כלל AI מפורש.
אבל "חדשות מול כל השאר" הוא חיתוך גס מדי. הפירוט המלא (בתעשיות עם n ≥ 10 במדגם) מספר סיפור עשיר הרבה יותר:
| תעשייה | n | כל חסימת AI | מפורש | Googlebot חסום | כללי DIY | Cloudflare Managed | שקט |
|---|---|---|---|---|---|---|---|
| חדשות | 650 | 47.2% | 45.2% | 1.5% | 46.9% | 1.5% | 48.5% |
| תיירות | 64 | 29.7% | 29.7% | 0.0% | 35.9% | 3.1% | 54.7% |
| חברתי | 65 | 29.2% | 23.1% | 4.6% | 23.1% | 6.2% | 66.2% |
| סטרימינג | 440 | 20.0% | 17.7% | 0.7% | 16.8% | 3.6% | 75.5% |
| פיננסים | 129 | 19.4% | 12.4% | 0.8% | 14.7% | 2.3% | 75.2% |
| E-commerce | 224 | 18.3% | 17.4% | 0.4% | 24.1% | 1.3% | 66.1% |
| Adult | 254 | 17.3% | 14.6% | 0.4% | 10.2% | 7.9% | 79.5% |
| חיפוש | 12 | 16.7% | 0.0% | 0.0% | 0.0% | 0.0% | 100.0% |
| אקדמיה | 268 | 14.6% | 13.8% | 0.4% | 13.4% | 3.4% | 77.2% |
| הימורים | 100 | 14.0% | 13.0% | 0.0% | 18.0% | 4.0% | 77.0% |
| כלי פיתוח | 129 | 10.1% | 7.8% | 0.0% | 8.5% | 5.4% | 77.5% |
| SaaS | 369 | 7.6% | 6.2% | 0.3% | 9.5% | 0.8% | 87.5% |
| ממשלה | 172 | 5.2% | 3.5% | 0.0% | 4.1% | 0.6% | 83.1% |
| Infrastructure | 47 | 4.3% | 0.0% | 0.0% | 4.3% | 2.1% | 72.3% |
| טלקום | 33 | 3.0% | 3.0% | 0.0% | 12.1% | 0.0% | 78.8% |
הפער של פי 12 בין חדשות לטלקום הוא הסיבה ש־"מדיניות ה־AI של הרשת" היא יחידת ניתוח שגויה. אין מספר אחד; יש מספרים מגזריים שנבדלים בסדר גודל. להלן ארבעת הממצאים הבולטים ביותר.
חדשות: 47% חסימה, 47% DIY. החדשות הן הקבוצה שכתבה את ספר ההוראות. Cloudflare Managed פועל רק ב־1.5% מהחדשות — המו״לים האלה אינם מפקידים את הכלל אצל צד שלישי. הטקסט עשיר במיוחד: NYT נפתח בפתיח משפטי בן 14 שורות שמצטט את "Art. 4 of the EU Directive"; ה־BBC עם "Please use our site like a human, not a robot... TL;DR: Browse, read, watch, enjoy — like a human."; The Sun עם "The Sun does not permit the unlicensed use of our content for large language models." זהו robots.txt כהצהרת מדיניות, לא כתצורה.
תיירות ב־30% — ההפתעה. Booking, Expedia, TripAdvisor, Kayak וחברות התעופה הגדולות חוסמות בשיעור של כשני שלישים משיעור החדשות. הדפוס הסלקטיבי עקבי: החוסם הממוצע בתיירות חוסם 5–7 UAs של אימון אך משאיר את UAs של ההסקה (PerplexityBot, ChatGPT-User, OAI-SearchBot) ללא פגיעה. נתוני מחירים אגרגטיביים וביקורות הם החפיר; ציטוטים חזרה לאתר הם התועלת. זהו הדפוס הנקי ביותר של "האימון בחוץ, ההסקה בפנים" בכל תעשייה בודדת.
Adult ב־17% — גם זה מפתיע. במדגמים קטנים קודמים התקבל 0%. נתוני המדגם המלא מראים ש־1 מתוך 6 אתרי adult חוסם לפחות בוט AI אחד, עם שיעור Cloudflare Managed הגבוה ביותר מכל מגזר (7.9%). יותר ממחצית מחסימות ה־AI של אתרי adult מגיעות ממתג Cloudflare, לא מהחלטה של מו״ל. אימון של יצירת תמונות הוא האיום המשתמע — מודלים בסגנון StableDiffusion לומדים סגנון חזותי מהר יותר ממודלי טקסט שלומדים סגנון כתיבה.
SaaS ב־7.6% הוא ממצא נגד-אינטואיטיבי. ספקי תוכנה הם המגזר הקולני ביותר בשיח על מדיניות AI, אבל ה־robots.txt שלהם פתוח לרווחה. הקריאה הנכונה: צוותי שיווק SaaS זיהו נכון ש־AI search הוא ערוץ הפצה. הספקים שבאמת חשבו על זה בוחרים להצטרף, לא לצאת — רשימת Allow-GPTBot המפורשת (ממצא 12) נשלטת בידי Security ו־dev-tooling SaaS.
ממשלה 5.2%, טלקום 3.0%, תשתיות 4.3%, dev 10.1%. חובות רישום ציבורי הופכים את Disallow: / לבעייתי מבחינה משפטית ב־.gov. אתרי שיווק של טלקום רוצים נראות. דומייני apex של CDN אינם צריכים להגן על דבר. כלי פיתוח מצטרפים במפורש (הערך של התוכן שלהם גדל כשהמודלים מצטטים אותו).
המסקנה: אין מספר אחד של "האינטרנט חוסם/לא חוסם AI" שאינו מאבד יותר ממה שהוא מוסר. דיווח לפי מגזר הוא הדרך הכנה היחידה לדון בנתונים.
ממצא 3 — לפי ספק AI: מי נחסם הכי הרבה?
חתך טבעי נוסף של הנתונים הוא לפי חברת AI ולא לפי בוט. כמה ספקים מריצים כמה בוטים (OpenAI מריצה שלושה: GPTBot, ChatGPT-User, OAI-SearchBot; Anthropic מריצה שניים: ClaudeBot, anthropic-ai; Meta מריצה שניים: Meta-ExternalAgent, FacebookBot). אגרגציה ברמת הספק היא הקירוב הטוב ביותר שלנו ל־"מה חושב האינטרנט הציבורי על כל חברת AI?"
| ספק AI | בוטים מאוגדים | אתרים החוסמים ≥ בוט 1 | % מהמדגם הניתן לניתוח |
|---|---|---|---|
| Common Crawl | CCBot | 1,178 | 16.25% |
| OpenAI | GPTBot, ChatGPT-User, OAI-SearchBot | 1,172 | 16.17% |
| Anthropic | ClaudeBot, anthropic-ai | 1,111 | 15.33% |
| ByteDance | Bytespider | 1,082 | 14.93% |
| Meta | Meta-ExternalAgent, FacebookBot | 989 | 13.65% |
Google-Extended | 970 | 13.38% | |
| Amazon | Amazonbot | 877 | 12.10% |
| Apple | Applebot-Extended | 859 | 11.85% |
| Webz.io (Omgili) | Omgili, Omgilibot | 731 | 10.09% |
| Cohere | cohere-ai | 717 | 9.89% |
| Perplexity | PerplexityBot, Perplexity-User | 715 | 9.86% |
| Diffbot | Diffbot | 684 | 9.44% |
| You.com | YouBot | 563 | 7.77% |
| AI2 (Allen AI) | AI2Bot | 487 | 6.72% |
| DuckDuckGo | DuckAssistBot | 482 | 6.65% |
Common Crawl הוא היישות הבודדת המותקפת ביותר למרות שהוא ארכיון אינטרנט ללא מטרות רווח, ולא מפעיל LLM. הסיבה היא מינוף: CCBot מזין כמעט כל מודל בקוד פתוח וחלק גדול מהמודלים הסגורים. חסימת CCBot תחילה היא כלל הכיסוי הגבוה ביותר שמו״ל יכול לכתוב.
OpenAI, Anthropic, ByteDance מתקבצות סביב 14–16%. היתרון של OpenAI הוא חלקית תוצר ספירה (שלושה בוטים של OpenAI לעומת בוט יחיד של ByteDance). 14.9% של Bytespider הוא אפקט ה"התנהגות של Bytespider" — תועד מאז 2024 שהוא מתעלם מ־robots.txt, והמו״לים חוסמים אותו כאות ציבורי, לא כי הם חוששים מ־TikTok.
Meta, Google, Amazon, Apple ב־12–14% הם הדרג השני — נכתבו באופן הגנתי יותר מאשר כהצהרת עמדה. ספקים קטנים (Webz.io, Cohere, Perplexity, Diffbot, You.com, AI2, DuckDuckGo) ב־6–10% נמשכים בעיקר כלפי מעלה על ידי רצפת catch-all של 3.8%; כללים מפורשים עבורם נמצאים בטווח 1–4%.
xAI (Grok), Mistral ורוב מעבדות המודלים האירופיות/סיניות חסרות מהטבלה — הן לא פרסמו UAs מתועדים לסוררי אימון. האקוסיסטם הנוכחי של robots.txt הוא דיאלוג בין ספקים אמריקאיים/סיניים שפרסמו UAs לבין מו״לים אמריקאיים/אירופיים שכתבו כללים; ספקים שלא פרסמו נשארים בלתי נראים במשא ומתן.
ממצא 4 — CCBot הוא הברק החדש שמושך אש, לא GPTBot
סדר הבוטים ב־top-10k נראה כך:
| דירוג | בוט | שיעור חסימה | שיעור כלל מפורש |
|---|---|---|---|
| 1 | CCBot (Common Crawl) | 16.25% | 12.90% |
| 2 | GPTBot (OpenAI) | 15.84% | 12.72% |
| 3 | Bytespider (ByteDance) | 14.93% | 11.35% |
| 4 | ClaudeBot (Anthropic) | 14.51% | 11.13% |
| 5 | Google-Extended | 13.38% | 10.18% |
| 6 | Meta-ExternalAgent | 12.38% | 8.95% |
| 7 | Amazonbot | 12.10% | 8.66% |
| 8 | Applebot-Extended | 11.85% | 8.72% |
| 9 | Omgilibot | 10.09% | 5.31% |
| 10 | anthropic-ai (הוצא משימוש) | 9.99% | 6.55% |
| 11 | cohere-ai | 9.89% | 6.42% |
| 12 | PerplexityBot | 9.69% | 6.40% |
| 13 | Diffbot | 9.44% | 5.95% |
| 14 | ChatGPT-User (הסקה) | 8.90% | 5.73% |
| 15 | YouBot (הסקה) | 7.77% | 4.29% |
| 16 | OAI-SearchBot (הסקה) | 6.83% | 3.66% |
| בסיס | Googlebot | 2.18% | — |
| בסיס | Bingbot | 2.27% | — |
הסיפור שהטבלה הזו מספרת הוא שהבוט שהרשת הציבורית חוסמת ראשון אינו מותג המודל — אלא הקורפוס. ארכיון 250 מיליארד הדפים של Common Crawl היה קלט האימון הגדול ביותר ל־GPT-3, GPT-4, Llama 1 / 2 / 3, Falcon, Mistral, BLOOM, ולרוב המודלים בקוד פתוח שיצאו מאז 2020. אתר שרוצה לצאת מ־"להיכלל במודל frontier הבא" ממקסם תועלת על ידי חסימת CCBot תחילה — ברגע שאינך ב־Common Crawl, אתה למעשה מודר מצינור האימון בקוד פתוח בחינם. GPTBot ו־ClaudeBot מגיעים אחר כך משום שהם החזית הגלויה של שני מוצרים מסחריים ספציפיים; ה־UA ברמת הקורפוס הוא היעד המבני.
גם הבוטים המדורגים נמוך יותר נותנים מידע. Omgilibot ב־10% הוא גבוה במיוחד עבור בוט שרוב הקוראים לא שמעו עליו — הוא מופעל בידי Webz.io, ברוקר תוכן-נתונים שמוכר ארכיוני רשת למפעילי LLM, וחלק ניכר מארגוני החדשות התחילו לציין אותו במפורש בקובצים שלהם. AI2Bot ב־6.7% (ובתוספת כלל Ai2Bot-Dolma באתרים של Squarespace) מצביע על כך שגם קהילת ה־LLM האקדמית מסומנת בידי מו״לים שלא בהכרח מבדילים בין "סורק מחקר ללא מטרות רווח" לבין "סורק מסחרי".
אשכול ההסקה — ChatGPT-User, OAI-SearchBot, YouBot, Perplexity-User — יושב 4–8 נקודות מתחת לאשכול האימון. הפער הזה הוא התשובה לשאלה מדיניות ארוכת שנים: כן, אתרי תנועה גבוהה מבדילים בין בוט שאוסף נתונים לאימון עתידי של מודל לבין בוט שמבצע שליפה חיה כדי לענות עכשיו על שאלה של משתמש. לא תמיד הם מבצעים את ההבחנה (כללי ה־catch-all לא), אבל חלק משמעותי כותב כללים שמכוונים במיוחד לצד האימון.
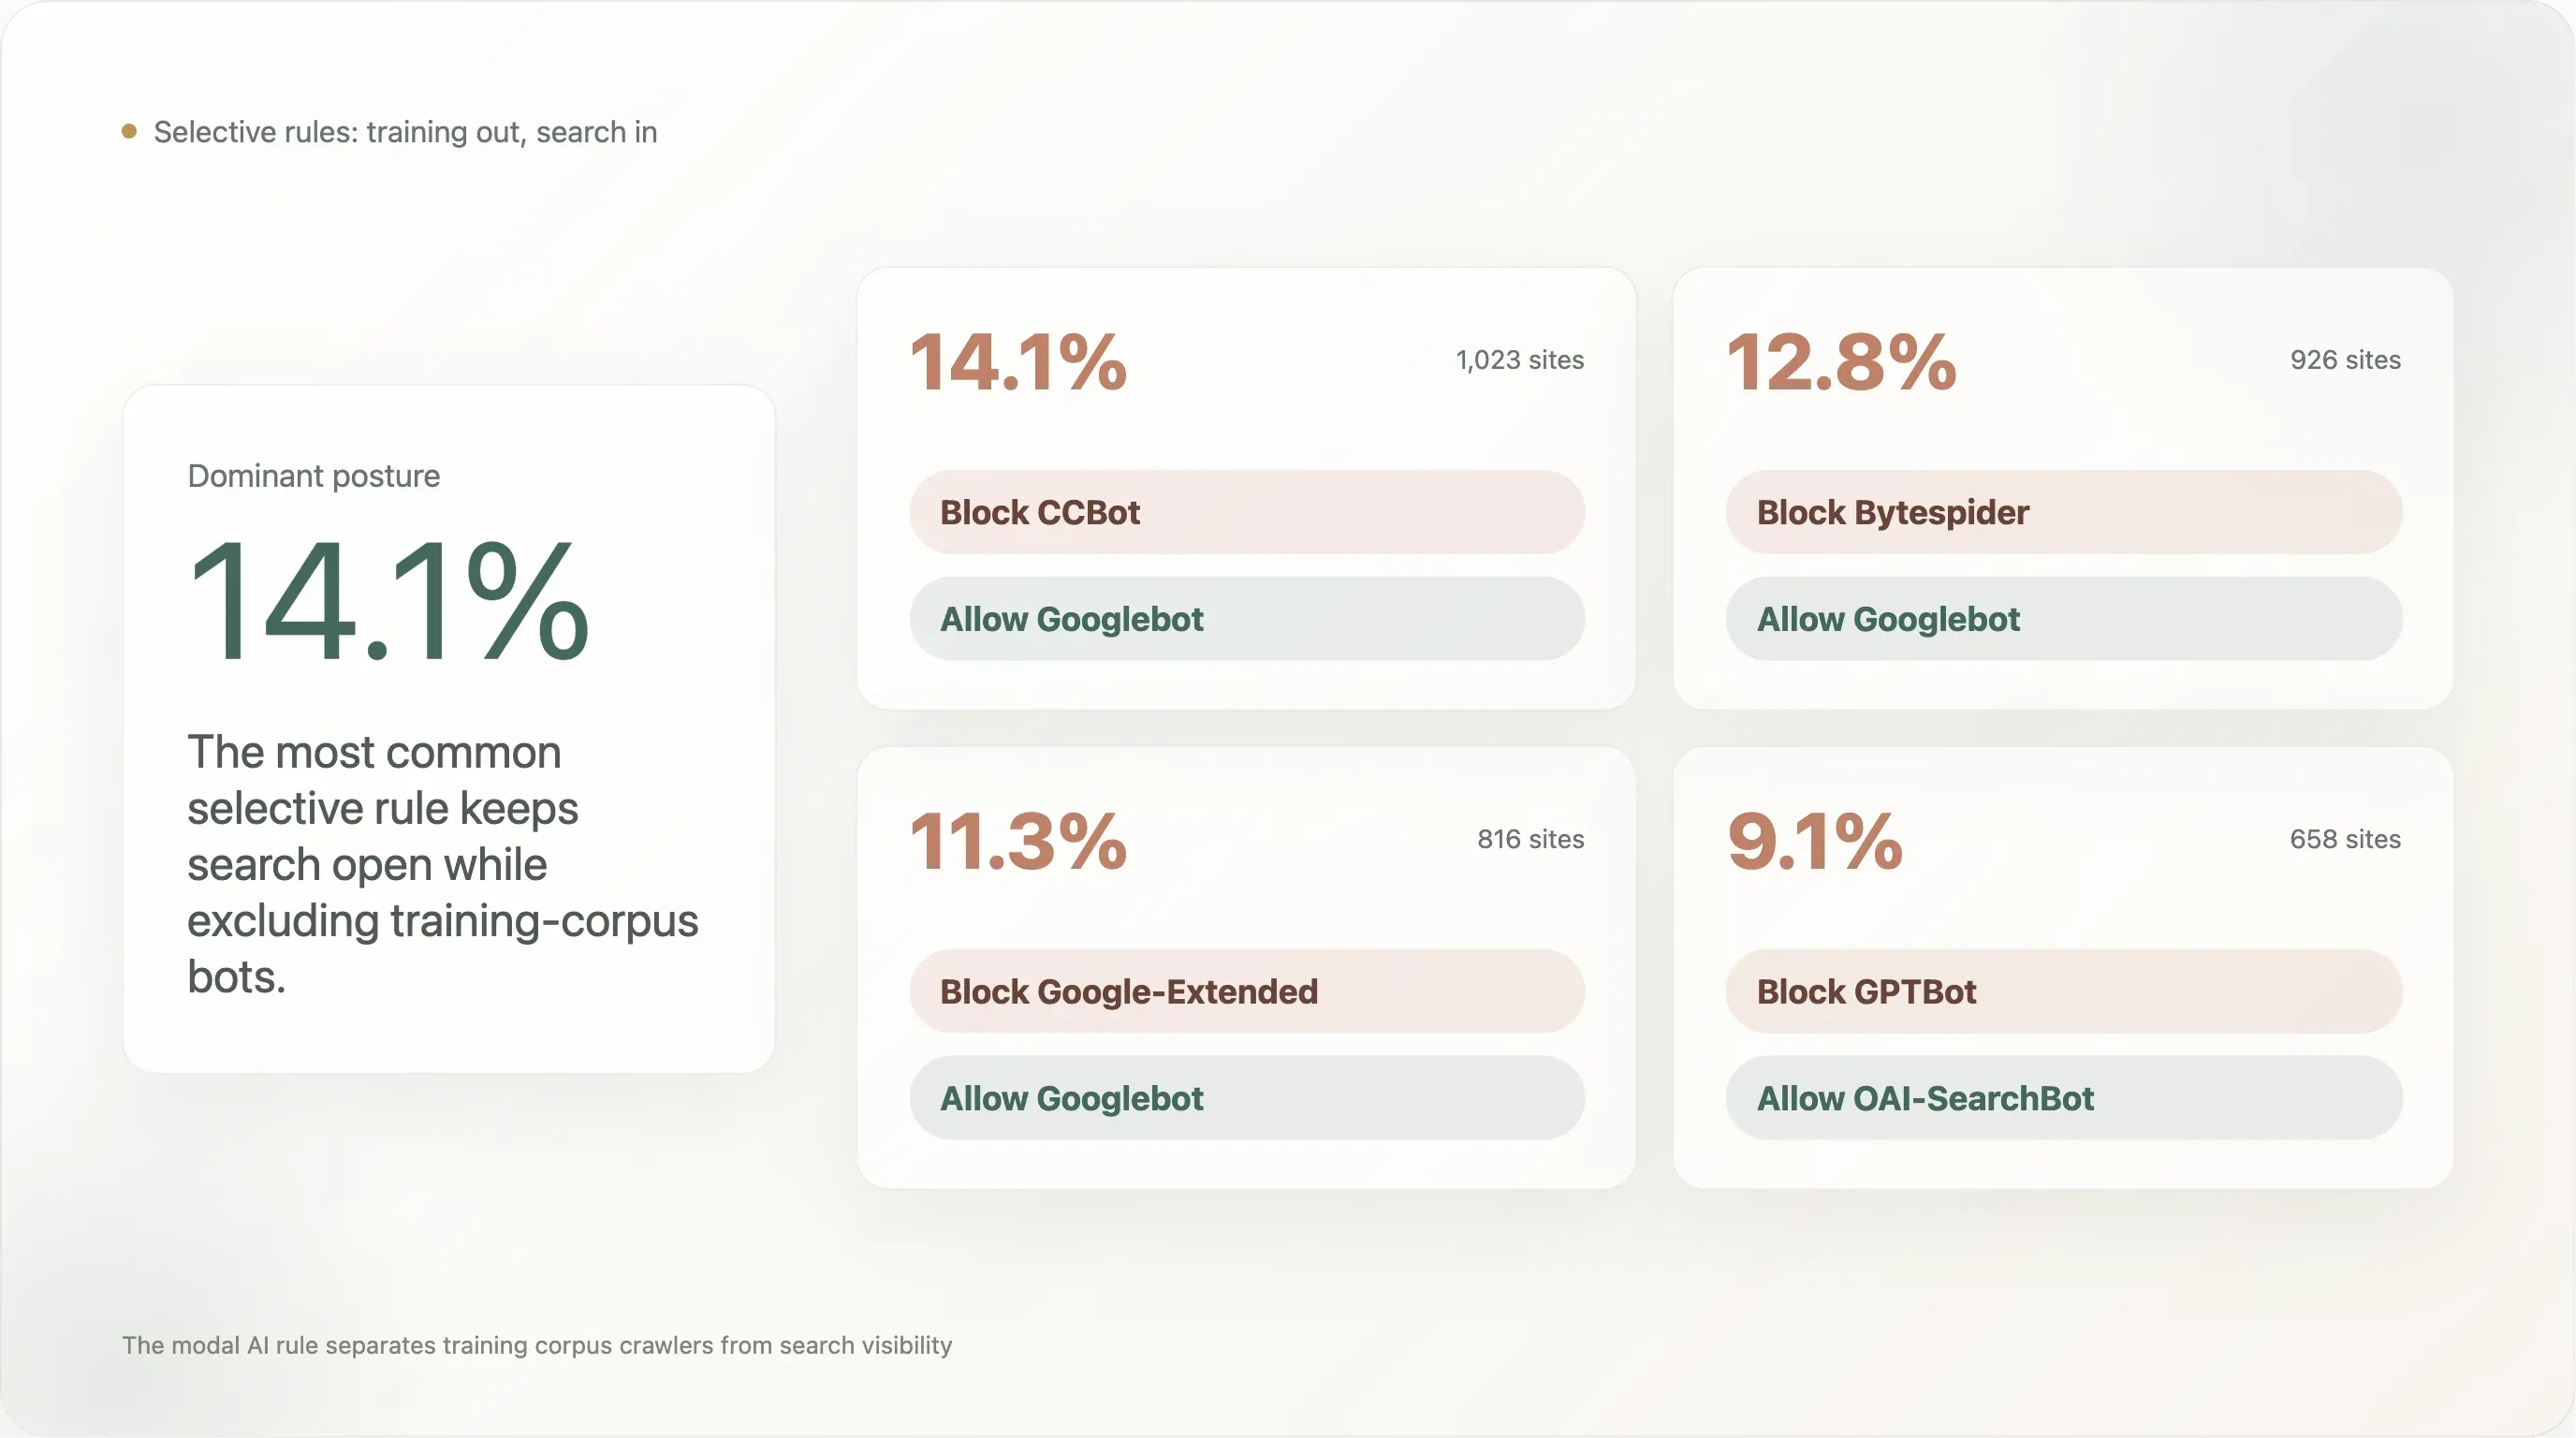
ממצא 5 — 14% חוסמים את CCBot אך משאירים את Googlebot רצוי — תבנית "חסום את הקורפוס, שמור את החיפוש"
הכלל הסלקטיבי בעל האימוץ הגבוה ביותר ב־top-10k:
| דפוס כלל | אתרים | % מהמדגם הניתן לניתוח |
|---|---|---|
חסום את CCBot, אפשר את Googlebot | 1,023 | 14.11% |
חסום את Bytespider, אפשר את Googlebot | 926 | 12.78% |
חסום את Google-Extended, אפשר את Googlebot | 816 | 11.26% |
חסום את GPTBot, אפשר את OAI-SearchBot | 658 | 9.08% |
חסום את GPTBot, אפשר את ChatGPT-User | 525 | 7.24% |
חסום את CCBot, אפשר את PerplexityBot | 519 | 7.16% |
חסום את anthropic-ai, אפשר את ClaudeBot | 59 | 0.81% |
הדפוס המאומץ ביותר (14.1%) הוא "חסום את Common Crawl, השאר נראות בחיפוש של Google." השני (12.8%) הוא "חסום את Bytespider, השאר נראות בחיפוש של Google" — כלומר חסימה של הסורק המסומן-מוניטין של ByteDance, תוך השארת בסיס החיפוש הלגיטימי שלם. השלישי (11.3%) הוא "חסום את ה־UA של אימון ה־AI של Google עצמה, אך השאר את ה־UA של החיפוש של Google" — וזה בדיוק הפיצול שלשמו Google תכננה את Google-Extended: המו״ל יוצא מאימון של Bard / Gemini בלי לאבד דירוג חיפוש.
שלושת המספרים יחד מתארים את עמדת המדיניות הדומיננטית ברשת top-10k: חסום את בוטי קורפוס האימון, השאר את בוטי החיפוש וההסקה ללא פגע. דפוס המיעוט של "חסום אימון אבל אפשר את ה־UA הספציפי של שליפה חיה של המודל הזה" — GPTBot ✗ / ChatGPT-User ✓ ב־7.2% — קיים, אבל קטן יותר מהחסימות ברמת הקורפוס.
השורה anthropic-ai / ClaudeBot ב־0.81% משקפת את הוצאת ה־UA של Anthropic משימוש ב־2024: ClaudeBot משרת כעת גם אימון וגם הסקה, ובכך מבטל את הביטוי הנקי של "חסום אימון, אפשר ציטוט" שהיה אפשרי עם ה־UA הישן anthropic-ai. זו כנראה אחת מהחלטות עיצוב ה־UA שפחות דוברו עליהן בשנים 2024–2025 — היא הסירה מקטגוריית robots.txt שלמה של ביטוי מדיניות.
ממצא 6 — פירוט חדשות: לפי מדינה ושפה
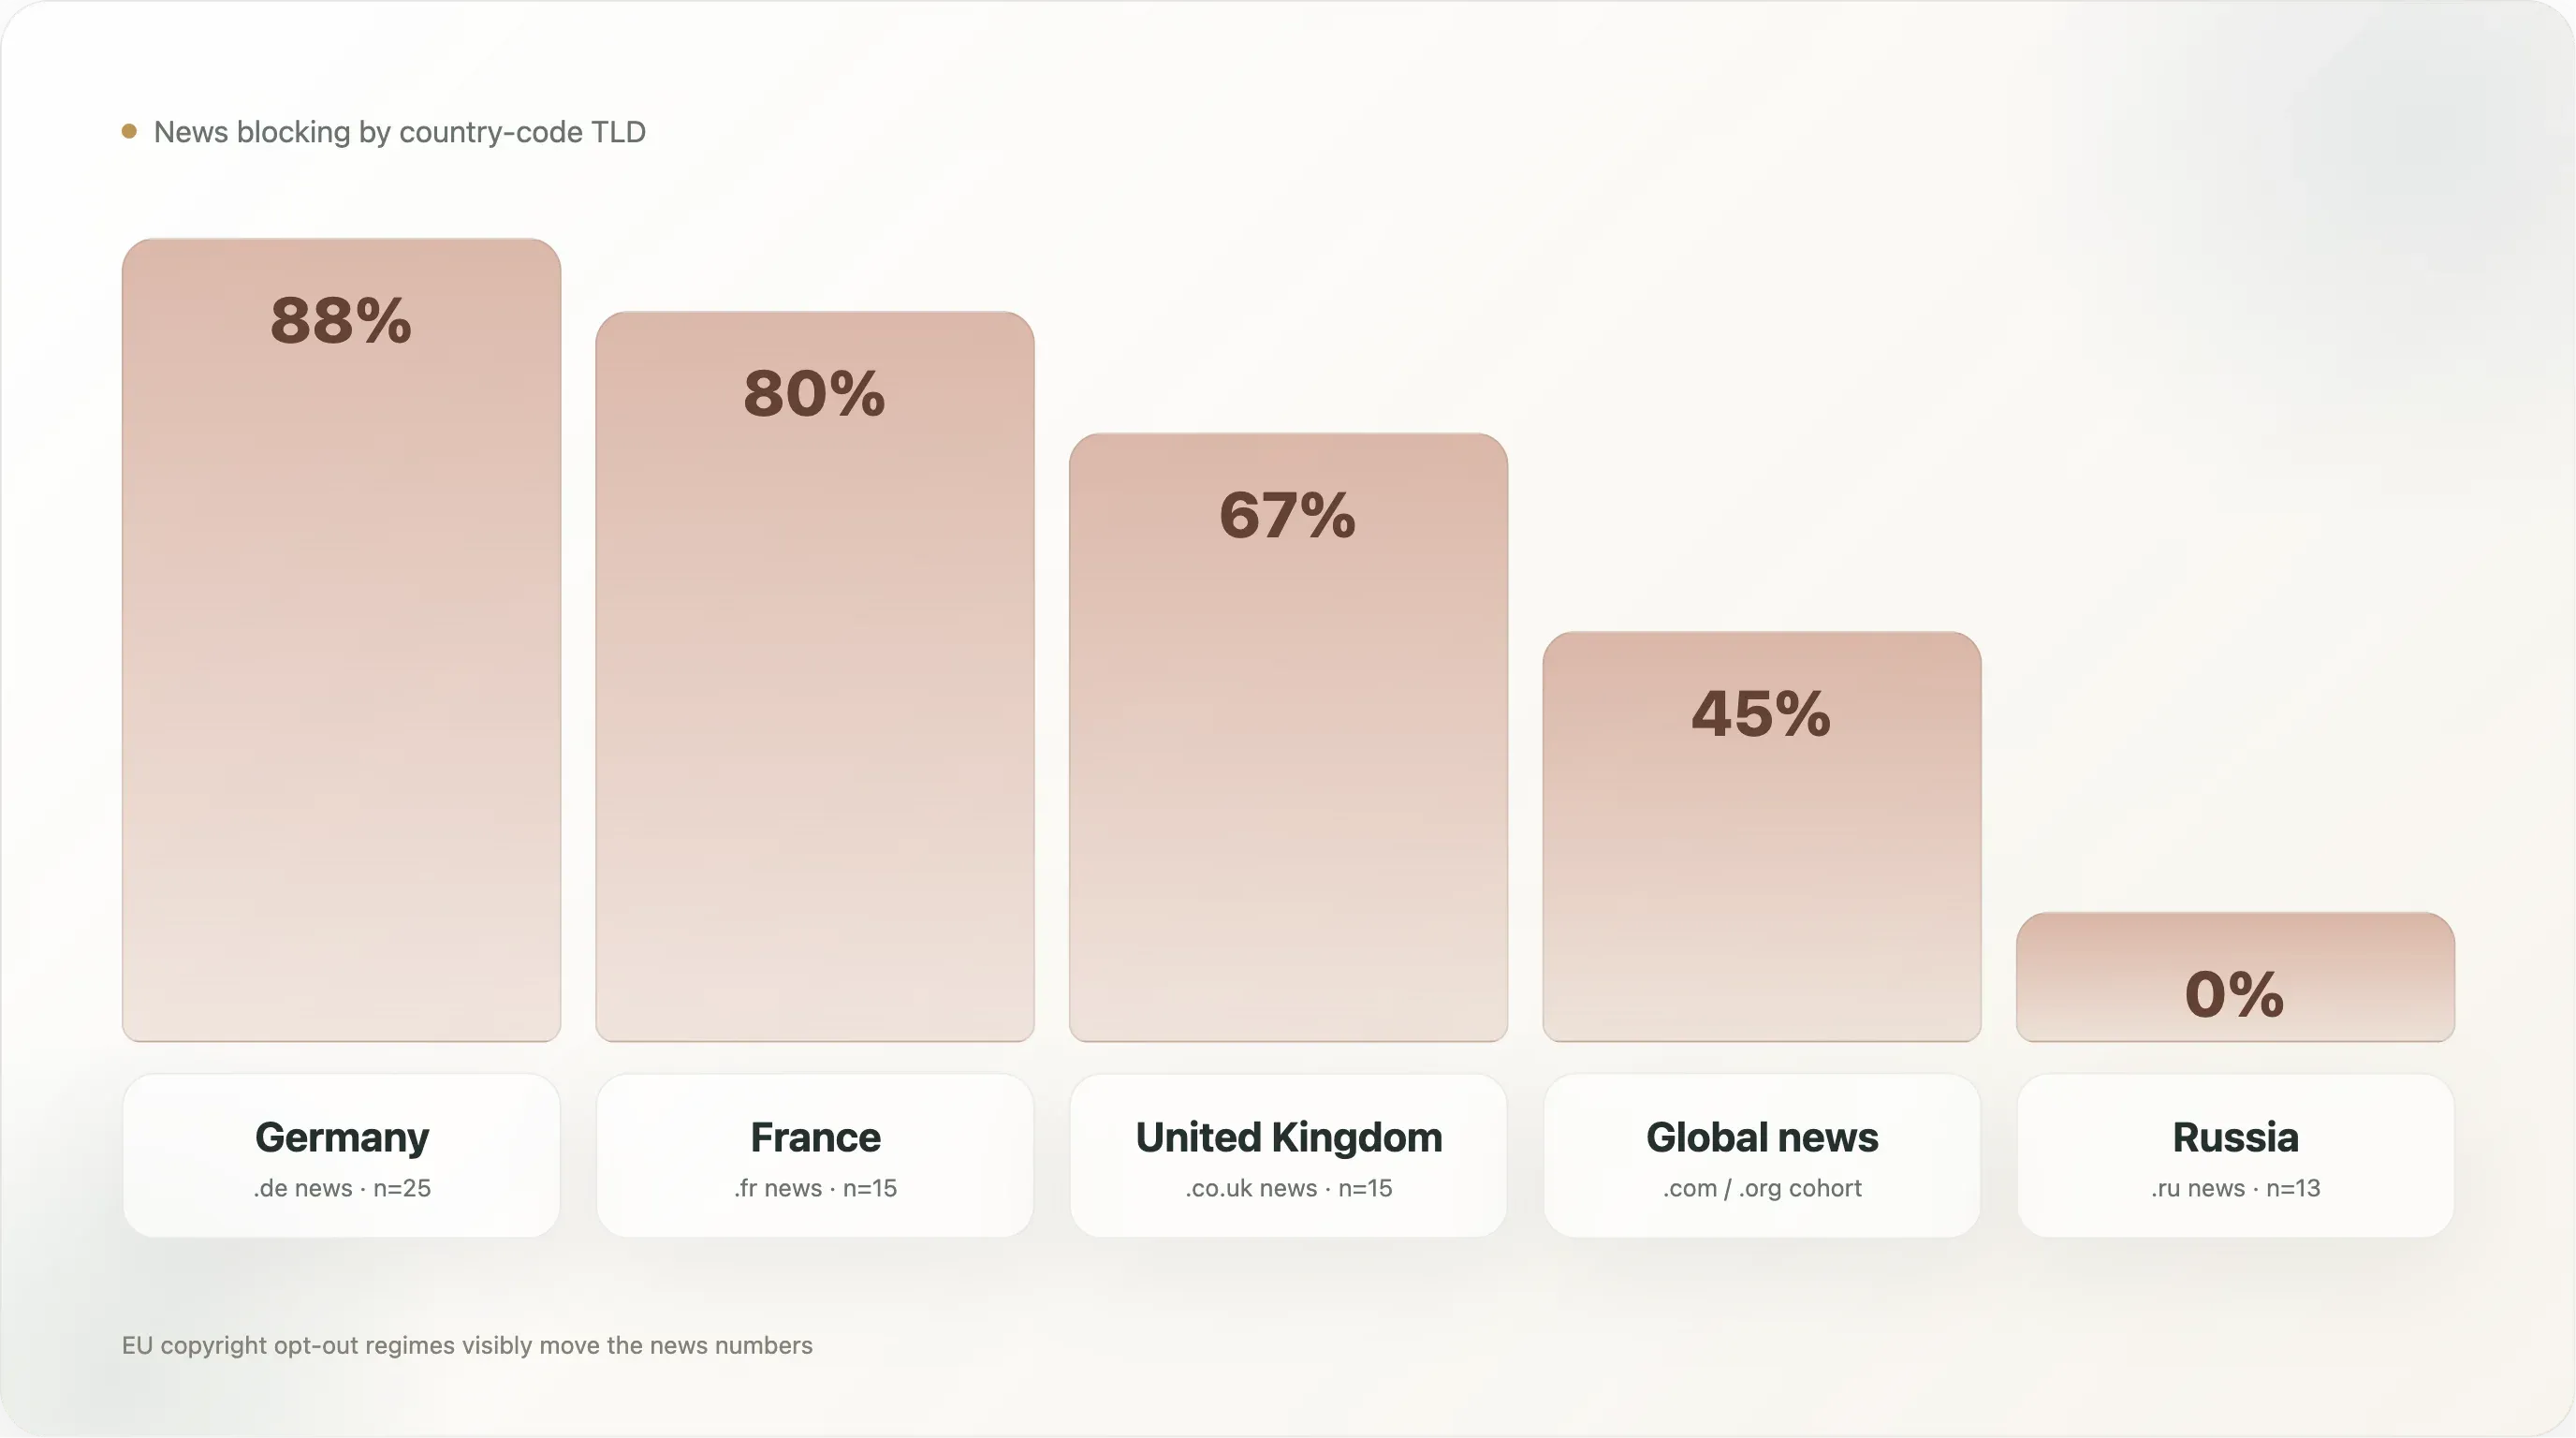
כאשר חותכים את קטגוריית החדשות לפי TLD של קוד מדינה — תוך זכירה שזה אומר .de לחדשות גרמניות, .fr לחדשות צרפתיות וכו', לא השפה המוגשת — הווריאציה בתוך החדשות גדולה יותר מהווריאציה בין חדשות לשאר הרשת:
| מדינה (חדשות בלבד) | n | כל חסימת AI | מפורש |
|---|---|---|---|
🇩🇪 גרמניה (.de) | 25 | 88.0% | 88.0% |
🇫🇷 צרפת (.fr) | 15 | 80.0% | 80.0% |
🇬🇧 בריטניה (.co.uk) | 15 | 66.7% | 53.3% |
🇪🇸 ספרד (.es) | 5 | 60.0% | 60.0% |
🇮🇹 איטליה (.it) | 13 | 53.8% | 53.8% |
חדשות גלובליות (.com/.org/וכו') | 500 | 45.0% | 42.8% |
🇵🇱 פולין (.pl) | 7 | 42.9% | 42.9% |
🇯🇵 יפן (.jp) | 12 | 25.0% | 25.0% |
🇷🇺 רוסיה (.ru) | 13 | 0.0% | 0.0% |
🇬🇷 יוון (.gr) | 6 | 0.0% | 0.0% |
החדשות הגרמניות הן תת־המקטע בעל שיעור החסימה הגבוה ביותר בכל מערך הנתונים — 88%, וכולן 88% מפורש. למעשה אין כמעט אתר חדשות גרמני ב־top 10k שמאפשר לסוררי אימון AI להגיע לארכיון שלו. את הקבוצה מובילים Spiegel, Bild, Welt, Zeit, FAZ, Süddeutsche, Heise, Golem, Stern, Focus — כל הממסד העיתונאי הגרמני המרכזי, יחד עם מו״לי טכנולוגיה שכתבו כללים באופן עצמאי. התשתית הפוליטית שמתחת לכך צפופה: VG Media, ארגון זכויות היוצרים הקולקטיבי של המו״לים הגרמניים, הייתה קבוצת התובעים האגרסיבית ביותר בליטיגציית זכויות היוצרים של AI באיחוד האירופי, וסעיף 4 של ההנחיה האירופית מיושם בחוק הגרמני כ־§44b UrhG עם לשון opt-out קריא־למכונה במפורש. עד שהספקים של AI הגיעו, המו״לים הגרמניים היו המוכנים ביותר מכל קבוצה לאומית לתרגם את העמדה המשפטית הזו לכללי robots.txt.
חדשות צרפתיות ב־80% הן מעט מתחת. הסביבה המשפטית הצרפתית דומה (הטמעת 2019/790 בחוק הצרפתי), וגם התנהגות הקבוצה דומה — lemonde.fr, lefigaro.fr, liberation.fr, lequipe.fr, 20minutes.fr, ouest-france.fr כולם חוסמים, כאשר הקובץ של Le Monde מצטט בנוסף את הזכות הצרפתית droit du producteur de base de données (סעיף L 342-1 בקוד הקניין הרוחני) כבסיס משפטי מקומי מקביל. לצרפת יש גם טוויסט נוסף: פסק דין מ־2024 של בית המשפט המסחרי בפריז שקבע ש־opt-outs מבוססי robots.txt מספיקים כהודעה לפי סעיף 4; זה מספק גיבוי תקדימי ישיר שאף תחום שיפוט אחר עדיין לא השיג.
בריטניה ב־67% נמוכה יותר, והסיבה היא שכמה מו״לים גדולים בבריטניה (thesun.co.uk, dailymail.co.uk, mirror.co.uk) משתמשים בבלוק deny-all של User-agent: * במקום בכללים ספציפיים ל־AI, מה שמוריד את המספר המפורש ל־53%. ההשפעה הכוללת זהה — האתרים האלה אינם מאפשרים סריקת AI — אבל המדיניות מוצגת כ־"אין רובוטים חוץ מרשימת allowlist ספציפית של מנועי חיפוש" ולא כ־disallow לבוטי AI נקובים. גם המסגרת המשפטית חלשה יותר: אחרי הברקזיט, בריטניה ירשה את היגיון סעיף 4, אבל הפסיקה המקומית המקבילה דלה יותר.
החדשות הרוסיות ב־0% הן השורה המפתיעה ביותר. שלושה עשר אתרי חדשות רוסיים בדומיין רוסי במדגם (dzen.ru, rbc.ru, ria.ru, kommersant.ru, tass.ru, lenta.ru, gazeta.ru, interfax.ru, kp.ru, tass.com, וכו') — אף אחד מהם לא חוסם שום סורק AI. ההסבר הסביר: אימון מודלי השפה ברוסית נשלט בידי מודלים בסגנון GPT של Yandex עצמה (שמשתמשים בסוררים פנימיים של Yandex, לא ב־Common Crawl), סביבה זכויות היוצרים הרוסית לא אימצה מקבילה לסעיף 4, והמו״לים הרוסיים הגדולים רואים במודלי השפה המערביים עניין שולי (בקרות הייצוא של ארה״ב כבר מגבילות שירותי OpenAI/Anthropic ברוסיה) ו־Yandex כבעלת עניין מקומי, לא כאויב. עמדת המדיניות שונה בפשטות.
חדשות יפניות ב־25% מציגות תבנית שלישית. ליפן יש חריגים מפורשים ל־text and data mining בחוק זכויות היוצרים המקומי (סעיף 30-4 לחוק זכויות היוצרים היפני, שתוקן ב־2018) שהם מתירניים יותר מסעיף 4 של ההנחיה האירופית — הם מאפשרים TDM למטרות "non-enjoyment", כולל אימון AI, בלי לדרוש הסכמה מבעלי הזכויות. למו״לים היפניים יש פחות עוגן משפטי ל־opt-out, ושיעורי ה־robots.txt תואמים לכך. ה־25% שכן חוסמים הם ברובם המו״לים הגדולים והבינלאומיים יותר (asahi.com, nikkei.com), שמוצבים כגלובליים יותר ממקומיים.
נתוני החדשות לפי מדינה הם ההוכחה הנקייה ביותר בדוח לכך שהמשטר המשפטי, לא הטכנולוגיה ולא הכלכלה הענפית, הוא המניע העיקרי של חסימת AI. אשכולות חדשות באיחוד האירופי נעים בין 54% ל־88%; אשכולות חדשות מחוץ לאיחוד (רוסיה, יפן, האשכול הגלובלי של .com) נעים בין 0% ל־45%. השיא של 88% נמצא במדינה עם היישום המפותח ביותר של סעיף 4; הרצפה של 0% נמצאת במדינה שכמעט אין בה חוק מדיניות AI כלל.
ממצא 7 — האיחוד האירופי מול השאר: פער של 16 נקודות
אם מרימים את עדשת המדינות לרמה גבוהה יותר, הפיצול הרחב בין האיחוד האירופי לשאר העולם חד:
| אזור | n | כל חסימת AI | מפורש |
|---|---|---|---|
ccTLDs של האיחוד האירופי (.fr, .de, .es, .it, .nl, .pl, .se, .dk, .fi, .be, .at, .cz, .hu, .ro, .gr, .pt, .ie, .sk, .bg) | 617 | 35.2% | 33.9% |
ccTLDs לאומיים מחוץ לאיחוד (.uk, .jp, .kr, .cn, .ru, .br, .in, .au, .mx, .ca, .tr, .ar, .cl, .co, .pe) | 897 | 17.2% | 13.6% |
גלובלי (.com, .net, .org, וכו') | 5,734 | 19.2% | 15.7% |
אתרי ccTLD של האיחוד האירופי חוסמים AI בשיעור כפול מהאשכול הלא-אירופי וכמעט פי שניים מבסיס .com הגלובלי. ההבדל עקבי בכל מדינות האיחוד (אין מדינה אחת שמניעה את הממוצע) ועקבי בכל התעשיות (.de חדשות ב־88%, .de SaaS בכ־12%, .de E-commerce בכ־25% — כולם גבוהים יותר מהמקבילות הגלובליות).
מצאנו 275 קובצי robots.txt ב־top-10k שמצטטים במפורש את הנחיה 2019/790 בתגובות שלהם — כ־3.8% מהמדגם הניתן לניתוח. הקבוצה נשלטת בידי מו״לים באיחוד האירופי, אך חורגת מהם: כמה מותגי חדשות אמריקאיים (ובעיקר NYT, שמצטטת ישירות "Art. 4 of the EU Directive"), כמה אתרי בריטניה, ומספר קטן של אתרי E-commerce אירופיים גדולים כולם משחזרים את הלשון המשפטית. 87 קבצים מזכירים "TDM" או "text and data mining" בשמם. 460 קבצים כוללים צורה כלשהי של לשון שמירת זכויות יוצרים ("expressly opts out," "all rights reserved," "no commercial use," "no machine learning") גם כאשר אינם מצטטים חוק מסוים.
שתי תצפיות נוספות מהחתך הזה:
אפקט האיחוד האירופי אינו רק בחדשות. כאשר מחזיקים חדשות קבועות, אתרים לא-חדשותיים באיחוד האירופי עדיין חוסמים AI בשיעורים גבוהים יותר מאתרים לא-חדשותיים מחוץ לאיחוד (בערך 28% מול 14%). חלק קטן אך ממשי של SaaS, E-commerce ואקדמיה באיחוד הפנים את מסגרת סעיף 4 גם למגזרים שלהם.
הלשון בסגנון האיחוד האירופי הופכת לתבנית דה־פקטו גם מחוץ לאיחוד. תבנית ה־robots.txt של Cloudflare Managed — שאומצה גלובלית — מצטטת במפורש "ARTICLE 4 OF THE EUROPEAN UNION DIRECTIVE 2019/790" בנוסח הסטנדרטי שלה. אתר אמריקאי שמפעיל את ההגדרה "Block AI Bots" של Cloudflare מצהיר, לעיתים מבלי לדעת, על שמירת זכויות סטטוטורית של האיחוד האירופי. זהו אחד מחפצי נדידת המדיניות המעניינים יותר שמצאנו: מושג משפטי אירופי הופך לגלובלי דרך ממשק מוצר של ספק תשתית אמריקאי.
ממצא 8 — תבניות ומקורות תבנית
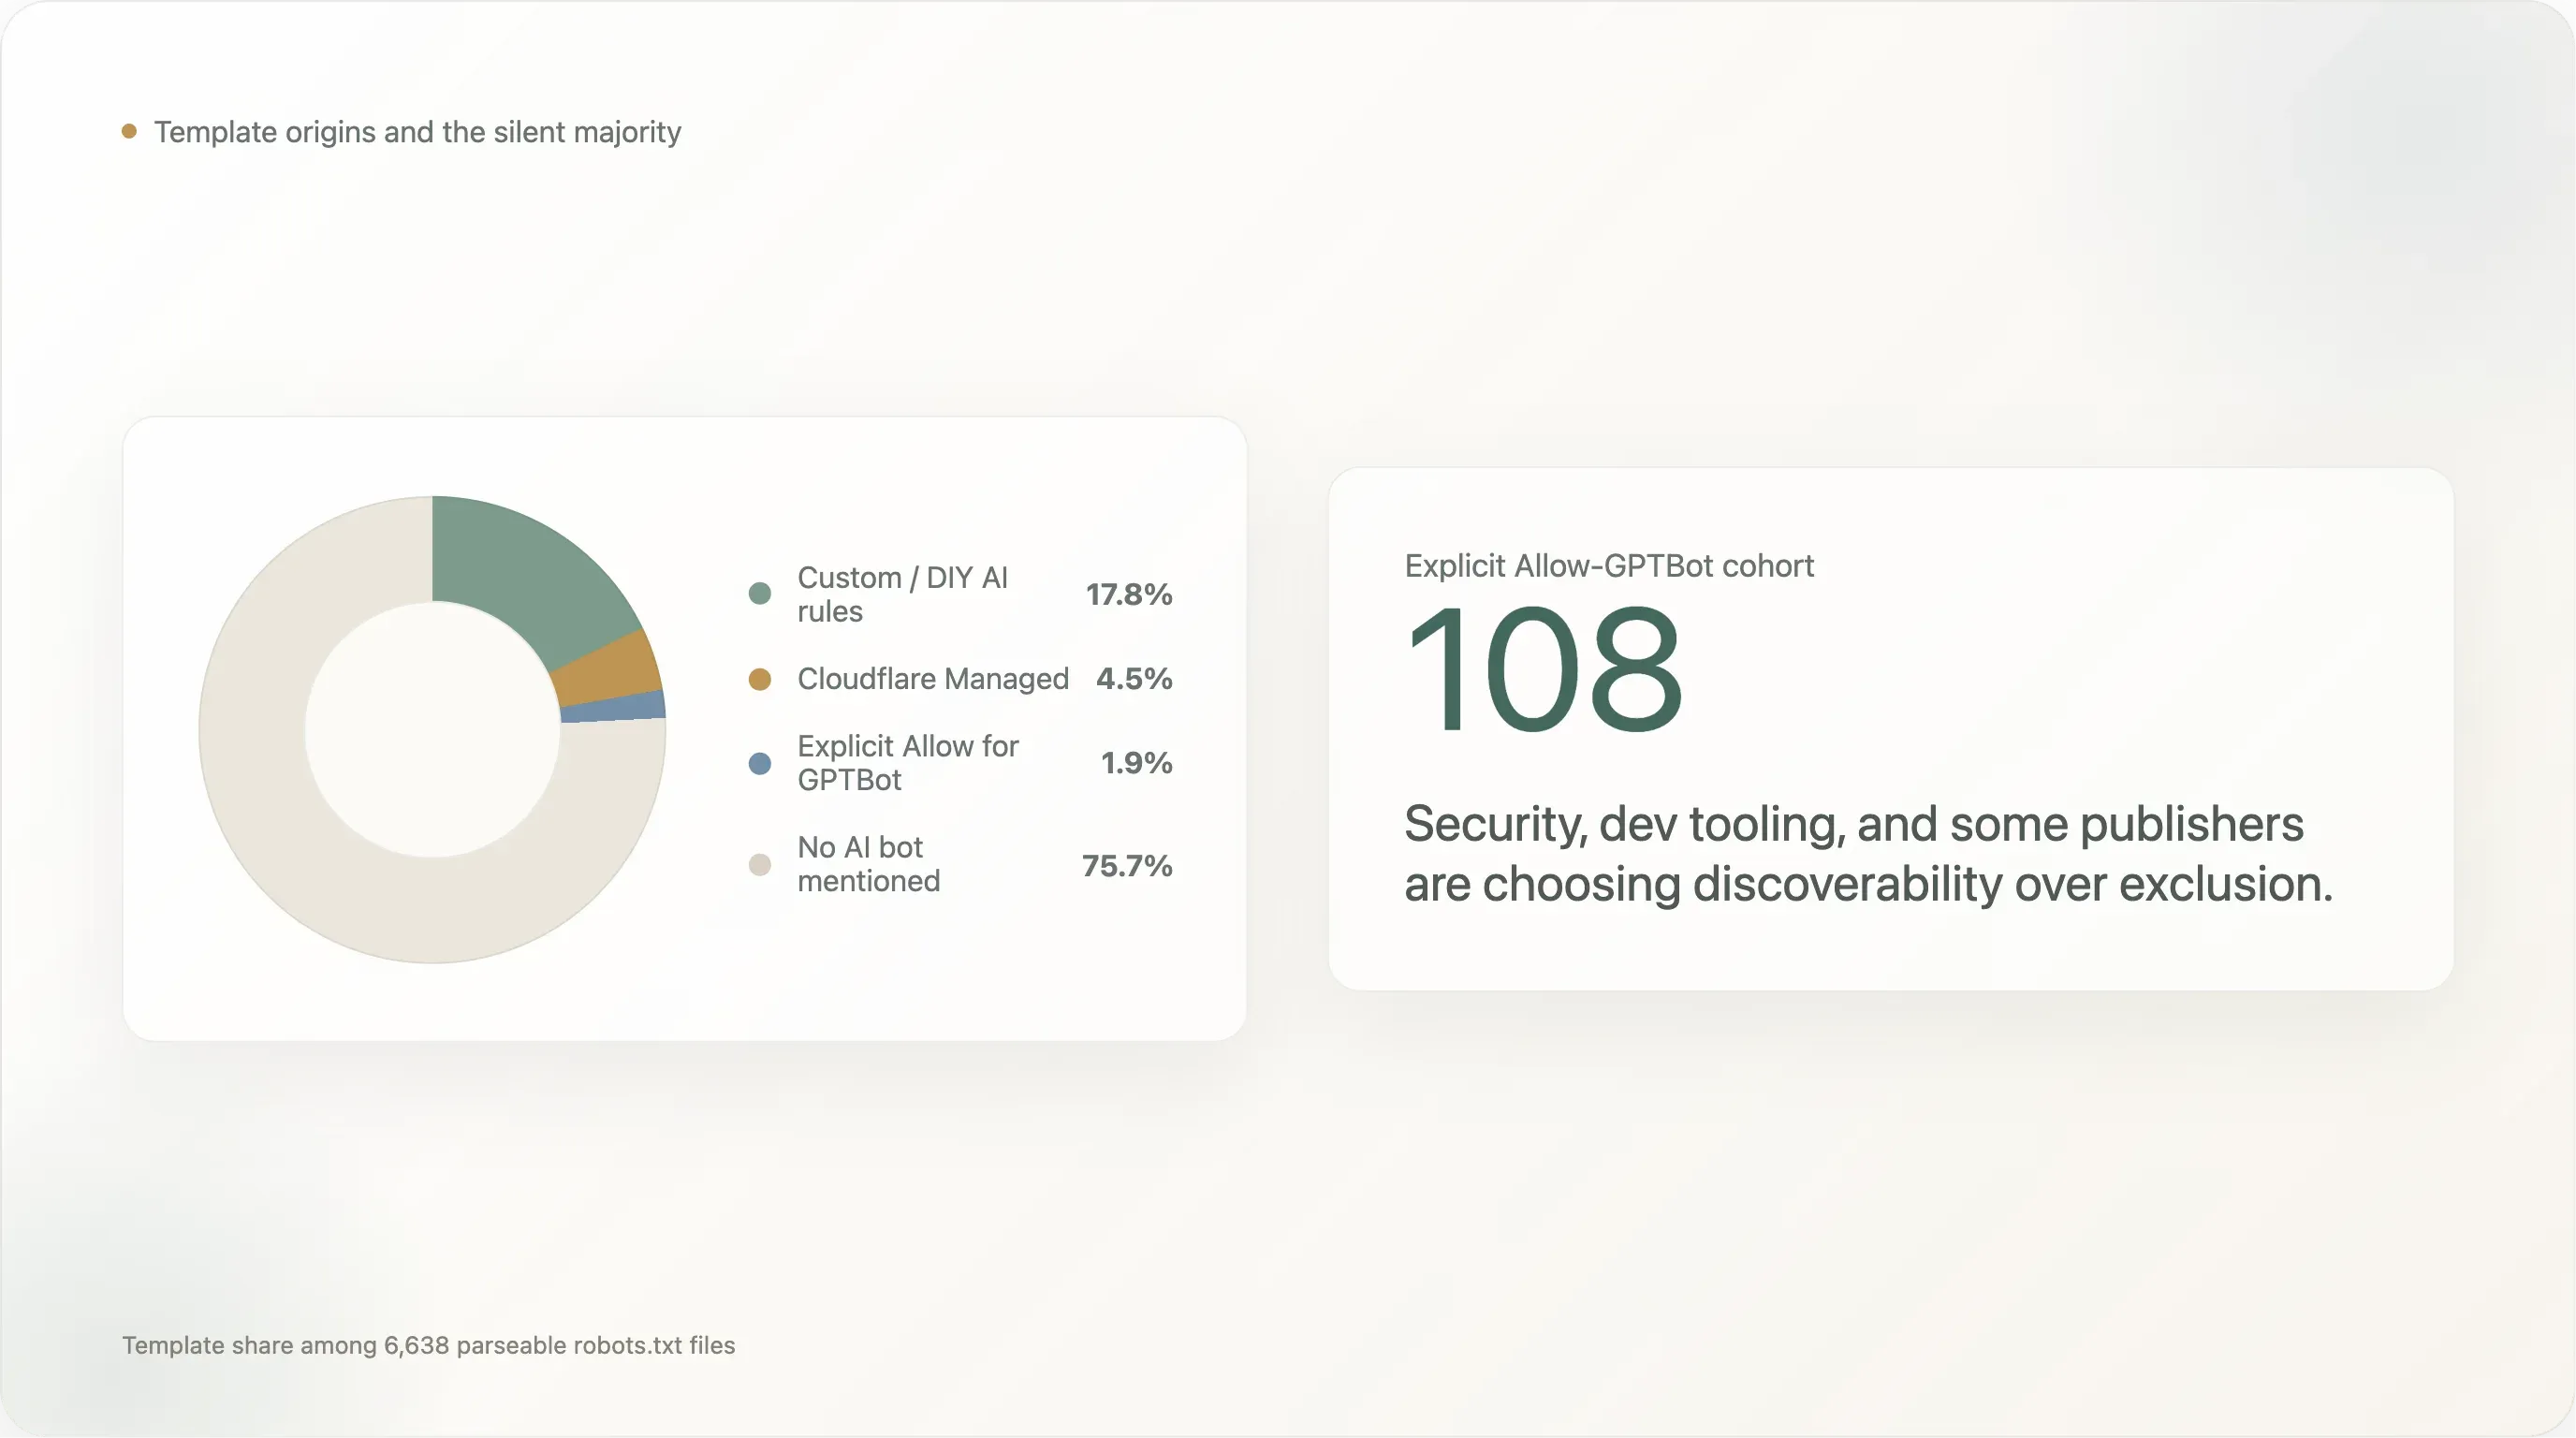
פירוט מקורות התבנית של 6,638 האתרים שהחזירו robots.txt שניתן לנתח:
| תבנית | אתרים | נתח |
|---|---|---|
| אין אזכור לבוט AI (ברירת מחדל בסגנון Shopify, Yoast, או כתיבה ידנית בלי התחשבות ב־AI) | 5,024 | 75.7% |
| כללי AI מותאמים / DIY | 1,183 | 17.8% |
Cloudflare Managed (Content-Signal: search=yes,ai-train=no) | 302 | 4.5% |
Allow: / מפורש עבור GPTBot | 124 | 1.9% |
| ברירת מחדל של Squarespace (28 UAs של AI בבלוק מוגבל-נתיב) | 5 | 0.1% |
כללי DIY שולטים עם 17.8%. קבוצת החוסמים שנכתבו ידנית מונה כמעט כל פלטפורמת מדיה חברתית (facebook.com, twitter.com, linkedin.com, whatsapp.com, tiktok.com, snapchat.com, pinterest.com, x.com, chatgpt.com עצמה), יעדי E-commerce הגדולים ביותר (amazon.com, amazonvideo.com), מותגי החדשות המרכזיים (nytimes.com, cnn.com, bbc.com, theguardian.com, forbes.com, reuters.com, bbc.co.uk, t-online.de, weather.com), סטרימינג / מדיה מרכזיים (netflix.com, vimeo.com, soundcloud.com, imdb.com), וזנב ארוך של אתרי שירותים מקצועיים (canva.com, medium.com).
Cloudflare Managed עומד על 4.5% — גבוה בהרבה מהחדירה של אותה תבנית בראש העקומה, ונמוך מהחדירה שלה בזנב הארוך מחוץ לחלון הדוח הזה. התבנית מאומצת במיוחד במקטע הדירוג 1001–10000 (4–5%) וכמעט שאינה קיימת בראש העקומה (Top 100: אתר אחד משתמש בה; Top 101–1000: 5 אתרים). הנכסים הגלובליים הגדולים כותבים את הכללים שלהם; הזנב הארוך משתמש במתג.
כמה אתרי Cloudflare Managed בולטים. cloudflare.com עצמו מריץ את התבנית, וזה עקבי (Cloudflare משתמשת במוצר שלה על הדומיין שלה). theatlantic.com מריץ את התבנית — מותג החדשות האמריקאי הגדול היחיד שמצאנו שלא כתב כלל מותאם אישית. spankbang.com מריץ את התבנית — אתר adult המדורג הגבוה ביותר שאימץ חסימת AI שהוזרקה על ידי Cloudflare. linktr.ee מריץ את התבנית, וחוסם אימון AI על פני כל כלכלת היוצרים המתארחת ב־Linktree בהחלטה של ספק יחיד. launchpad.net, nexusmods.com, vinted.fr, cookielaw.org, rustdesk.com, ורשימה ארוכה של נכסי מדיה קטנים יותר משלימים את קבוצת Cloudflare Managed הנראית לעין.
דפוס האימוץ של Cloudflare הוא ההוכחה המוחשית ביותר שראינו לכך שחלק גדול מ־"מדיניות ה־AI של הרשת" מוכרע על ידי ספקי תשתית. הנתח האבסולוטי קטן (4.5%), אבל זה חשוב מבחינה מבנית: זו ברירת המחדל ש־Cloudflare מספקת, והכיוון של on-by-default ל־12 החודשים הבאים הוא כלפי מעלה. אם Cloudflare תהפוך את המתג לברירת מחדל מופעלת לחשבונות חדשים, שיעור החסימה הגלובלי יזוז באופן מהותי בלי שאף מו״ל בודד יקבל החלטה.
ברירת המחדל של Squarespace (5 אתרים ב־top-10k, אבל קבוצה הרבה יותר גדולה מחוץ למדגם שלנו) היא דפוס אחר: Squarespace שולחת robots.txt שמונה 28 בוטי AI בבלוק אחד, אך אותם בוטים יורשים את מגבלות הנתיב של User-agent: * במקום לקבל איסור על כל האתר. סורקי AI יכולים לשלוף את /, דף הבית, דפי המוצר, הבלוג. הם פשוט לא יכולים לשלוף /config או /account. בעבר כבר סימנו זאת כמקור לקריאות שגויות של "AI block" בסריקות צד שלישי של אתרי Squarespace; אותה הסתייגות חלה גם כאן.
ממצא 9 — מדיניות AI אחידה לאורך התפלגות הדירוג
ההנחה המקובלת במחקר כזה היא שהאתרים הנצפים ביותר יאמצו את מדיניות ה־AI האגרסיבית ביותר — יש להם הכי הרבה להפסיד מהסטת האימון, הכי הרבה יכולת משפטית, והכי הרבה תשומת לב ציבורית. הנתונים לא תומכים בהנחה הזו.
| טווח דירוג | n | כל חסימת AI | מפורש | Cloudflare Managed |
|---|---|---|---|---|
| Top 100 | 67 | 22.4% | 17.9% | אתר אחד |
| Top 101–1,000 | 598 | 22.9% | 19.2% | 5 אתרים |
| Top 1,001–5,000 | 2,810 | 19.0% | 15.3% | 99 אתרים |
| Top 5,001–10,000 | 3,773 | 20.8% | 17.8% | 197 אתרים |
ארבעת הטווחים נעים בין 19% ל־23%. Top 100 אינו אגרסיבי יותר מהזנב הארוך של 5001–10000. נראה ששיעור הכותרת הוא תכונה של הרשת הציבורית בשנת 2026, לא אות לגודל או בולטות של אתר בודד.
שני גורמים תורמים לכך. ראשית, ראש העקומה נשלט על ידי דומייני תשתית / SaaS / חיפוש / פורטל (Microsoft, Apple, Google וכו') שמראש יש להם שיעורי חסימה נמוכים. שנית, הזנב הארוך כולל שיעור גבוה של מו״לי חדשות אזוריים ואתרי שיפוט של האיחוד האירופי ש — כפי ש־ממצא 6 ו־7 הראו — חוסמים AI באגרסיביות גבוהה מהממוצע הגלובלי. שני האפקטים מבטלים זה את זה בערך, והתוצאה היא כותרת אחידה.
עמודת Cloudflare Managed כן משתנה לאורך העקומה. ב־Top 1000 יש 6 אתרים מנוהלי Cloudflare (1.0%); ב־Top 1001–10000 יש 296 (5.7%). האתרים הגדולים כותבים בעצמם; הזנב הארוך משתמש במתג של הספק. זהו האות היחיד התלוי-דירוג בעל משמעות במערך הנתונים, והוא מרמז כי ככל שיורדים בעקומת התנועה מראש הרשת אל הזנב הארוך, חלקה של מדיניות ה־AI שנקבעת על ידי ספק ולא על ידי מו״ל עולה בהתמדה. אנו מצפים שהגרדיאנט הזה ימשיך גם מעבר ל־top 10k אל top 100k והלאה.
ממצא 10 — חמש אנטומיות: איך robots.txt נראה כשהוא באמת מדיניות
המספרים מתארים את צורת מערך הנתונים; האופי האמיתי של "מדיניות AI ברשת הציבורית" נחשף בצורה הטובה ביותר כשקוראים קבצים ספציפיים. הנה חמישה ששווה להתעכב עליהם, שנבחרו כדי לכסות את מרחב המדיניות.
אנטומיה 1 — ה־New York Times (nytimes.com)
14 השורות הראשונות של nytimes.com/robots.txt:
# New York Times content is made available for your personal, non-commercial
# use subject to our Terms of Service here:
# https://help.nytimes.com/hc/en-us/articles/115014893428-Terms-of-Service.
# Use of any device, tool, or process designed to data mine or scrape the content
# using automated means is prohibited without prior written permission from
# The New York Times Company. Prohibited uses include but are not limited to:
# (1) text and data mining activities under Art. 4 of the EU Directive on Copyright in
# the Digital Single Market;
# (2) the development of any software, machine learning, artificial intelligence (AI),
# and/or large language models (LLMs);
# (3) creating or providing archived or cached data sets containing our content to others; and/or
# (4) any commercial purposes.
# Contact https://nytlicensing.com/contact/ for assistance.
זהו robots.txt כראיה משפטית. הקובץ בנוי כך שיוכל לשמש ראיה ב־NYT v. OpenAI הליטיגציה שהוא צד לה. ההפניות ל־"Art. 4 of the EU Directive" — על ידי מו״ל אמריקאי — מדגימות את התצפית מממצא 7 שלפיה מסגרות משפטיות אירופיות דולפות אל השיח הגלובלי. האיסור המפורש על "creating or providing archived or cached data sets" מכוון ישירות ל־Common Crawl. הקובץ ארוך מ־60 שורות עם בלוקי User-agent נקובים עבור GPTBot, OAI-SearchBot, ChatGPT-User, anthropic-ai, ClaudeBot, CCBot, Google-Extended, Applebot-Extended, Bytespider, Diffbot, Meta-ExternalAgent, Amazonbot, Omgili, Omgilibot, ועוד חצי תריסר — לכל בוט נקוב יש Disallow: / משלו.
אנטומיה 2 — Der Spiegel (spiegel.de) — מתן הרשאה ברמת מקטעים
Der Spiegel הוא ה־robots.txt המתוחכם ביותר מבחינה תפעולית שמצאנו בכל מערך הנתונים. הבלוק הרלוונטי:
# TLP-6507: Testweise Freischaltung der OpenAI-Suchcrawler fuer ausgewaehlte Bereiche
User-agent: OAI-SearchBot
Allow: /ausland/
Allow: /partnerschaft/
Allow: /gesundheit/
Allow: /familie/
Allow: /reise/
Allow: /psychologie/
Allow: /stil/
Disallow: /

User-agent: ChatGPT-User
Allow: /ausland/
Allow: /partnerschaft/
Allow: /gesundheit/
Allow: /familie/
Allow: /reise/
Allow: /psychologie/
Allow: /stil/
Disallow: /
ההערה מתורגמת כ־"הפעלה ניסיונית של סוררי החיפוש של OpenAI עבור מקטעים נבחרים." Spiegel הלבינה שבע קטגוריות תוכן ספציפיות — חדשות בינלאומיות, שותפויות, בריאות, משפחה, נסיעות, פסיכולוגיה ולייף סטייל — עבור UAs של ההסקה של OpenAI, תוך חסימת כל השאר. מדורי הפוליטיקה, החדשות הלאומיות של גרמניה והעיתונות החוקרת מוחרגים במפורש בהמשך הקובץ. Common Crawl, Bytespider, Cohere, Webzio-Extended ושאר UAs של האימון מקבלים Disallow: / מלא בהמשך הקובץ.
זהו robots.txt כמדיניות עריכתית ברמת מקטע. התאוריה המשתמעת היא שתוכן לייף סטייל כולל סיכון נמוך יותר להסטת אימון וערך גבוה יותר לציטוט בהסקה, ולכן Spiegel מאפשרת ל־AI להציג את אותם מקטעים; הפוליטיקה והחקירה הם החפיר, ולכן AI מודר משם. לא ראינו דפוס כזה במקום אחר. זה מרמז על רמת תיאום פנימית בין צוותי עריכה, משפט ותשתית שרוב חדרי החדשות עדיין לא הגיעו אליה. אנו מצפים שסוג כזה של ביטוי מדיניות גרנולרי ברמת מקטע יתפשט במהלך 2026–2027 — הקובץ של Spiegel הוא למעשה אינדיקטור מוביל.
אנטומיה 3 — BBC (bbc.com) — צורת הצהרת המדיניות
ה־robots.txt של BBC נפתח כך:
# version: ec59bd036e5138eb4831a9ed44447b1ff310e235
# The BBC's Terms of Use: https://www.bbc.co.uk/terms
# - Explain the rules for using our services
# - Tell you what you can do with our content
#
# In short: Please use our site like a human, not a robot.
# That means:
# - No scraping, crawling, or systematic extraction of content
# - No use of BBC content for training or fine-tuning AI models, including LLMs
# - No retrieval-augmented generation (RAG), AI-powered search, agentic AI or
#   grounding using BBC content
# - No creating datasets from BBC content
# - No text and data mining (TDM) under Article 4 of the EU Directive on Copyright
# - No using BBC content to create summaries for your own use
# - No business use without permission
# - The BBC reserves all rights in its content and expressly opts out of any
#   statutory exceptions in any jurisdiction for text and data mining,
#   as permitted by law
#
# TL;DR: Browse, read, watch, enjoy - like a human.
ה־BBC מגִרסה את robots.txt שלה (ה־# version: ec59bd... הוא hash של commit), אוסרת על שמונת סוגי השימוש הספציפיים ב־AI שהיועצים המשפטיים שלה עוקבים אחריהם, ומסיימת בסיכום שורה אחת בקול המילולי שעליו בנוי המותג של ה־BBC. הביטוי "expressly opts out of any statutory exceptions in any jurisdiction" הוא שמירת זכויות גלובלית מכוונת — הוא אומר אנחנו לא סומכים על אף משטר משפטי אחד שיספק לנו את ההגנה הרצויה, ולכן אנחנו טוענים opt-out בכל מקום בו־זמנית. זהו ה־robots.txt המעוצב ביותר במערך הנתונים, והוא נקרא יותר כמו הודעה לעיתונות מאשר קובץ תצורה.
אנטומיה 4 — WordPress.org — ההזמנה המפורשת
השוו את כל האמור לעיל ל־wordpress.org:
User-agent: GPTBot
Allow: /

User-agent: ClaudeBot
Allow: /

User-agent: anthropic-ai
Allow: /

User-agent: Google-Extended
Allow: /

User-agent: Applebot-Extended
Allow: /

User-agent: PerplexityBot
Allow: /

User-agent: Bytespider
Allow: /

User-agent: CCBot
Allow: /

User-agent: Copilot
Allow: /
WordPress.org מצהירה במפורש שהיא מצרפת תשעה סוררי אימון AI, כולל שלושת (Bytespider, CCBot, anthropic-ai) שמסוננים לרוב במקומות אחרים. התאוריה המשתמעת היא שהמסמכים והאקוסיסטם של התוספים של WordPress הם טובת ציבור שערכה גדל כאשר עוזרי AI יכולים לענות שאלות לגביהם. בכל פעם שמישהו שואל את Claude "איך מגדירים permalinks ב־WordPress?" ו־Claude אומן על wordpress.org/documentation/, ייעוד WordPress הושג. נראה שהקרן החליטה להיות בתוך קורפוס האימון של כל מודל היא יתרון אסטרטגי, והן השתמשו בדקדוק ההבעתי של הקובץ כדי לומר זאת.
אנטומיה 5 — The Verge (theverge.com) — ההיבריד הספונסרי
עוד דפוס אחד שכדאי להראות. The Verge בונה את כללי ה־AI שלה כ־Disallow: / \ Allow: /sp/:
User-agent: GPTBot
Allow: /

User-agent: Applebot
Allow: /

User-agent: Google-Extended
Disallow: /
Allow: /sp/

User-agent: anthropic-ai
Disallow: /
Allow: /sp/

User-agent: Bytespider
Disallow: /
Allow: /sp/

User-agent: CCBot
Disallow: /
Allow: /sp/

User-agent: ChatGPT-User
Disallow: /
Allow: /sp/

User-agent: ClaudeBot
Disallow: /
Allow: /sp/
הנתיב /sp/ הוא אזור התוכן הממומן / השותפים של The Verge. תוכן עריכתי נחסם מאימון AI; תוכן ממומן מותר. ההיגיון הכלכלי ברור: נותני חסות משלמים כדי שהתוכן שלהם יהיה ניתן לגילוי, כולל באמצעות AI; ספינת הדגל העריכתית היא החפיר. GPTBot פתוח לגמרי (כנראה בשל קשר ישיר עם OpenAI), Applebot פתוח לגמרי כבסיס חיפוש, והיתר מקבלים טיפול היברידי. זהו המבנה היחיד מסוג "גישה מדורגת ל־AI" שמצאנו.
חמשת הקבצים הללו מתארים את טווח מדיניות ה־AI הנוכחי ב־robots.txt. רוב הקבצים ב־top 10k אינם דומים לאף אחד מהם — הם שותקים או משתמשים בתבנית של ספק. אלה שנראים כמו אחד מהם נכתבו בידי אנשים שהחליטו שהקובץ שווה קריאה זהירה.
הערה על גודל הקבצים: גוף ה־robots.txt החציוני במדגם שלנו הוא 858 בתים — קטן מדי כדי לקודד מדיניות AI משמעותית. הקצה הימני הוא המקום שבו הכללים חיים: 1,005 אתרים (15.3%) כוללים קובץ גדול מ־5KB, 273 גדולים מ־20KB, והמרבי היה 248KB. 460 קבצים כוללים לשון שמירת זכויות יוצרים; 275 מצטטים את EU 2019/790 בשם. robots.txt בשנת 2026 הוא יותר ויותר מסמך ממוספר, שעבר בדיקה משפטית, ולא שורת תצורה.
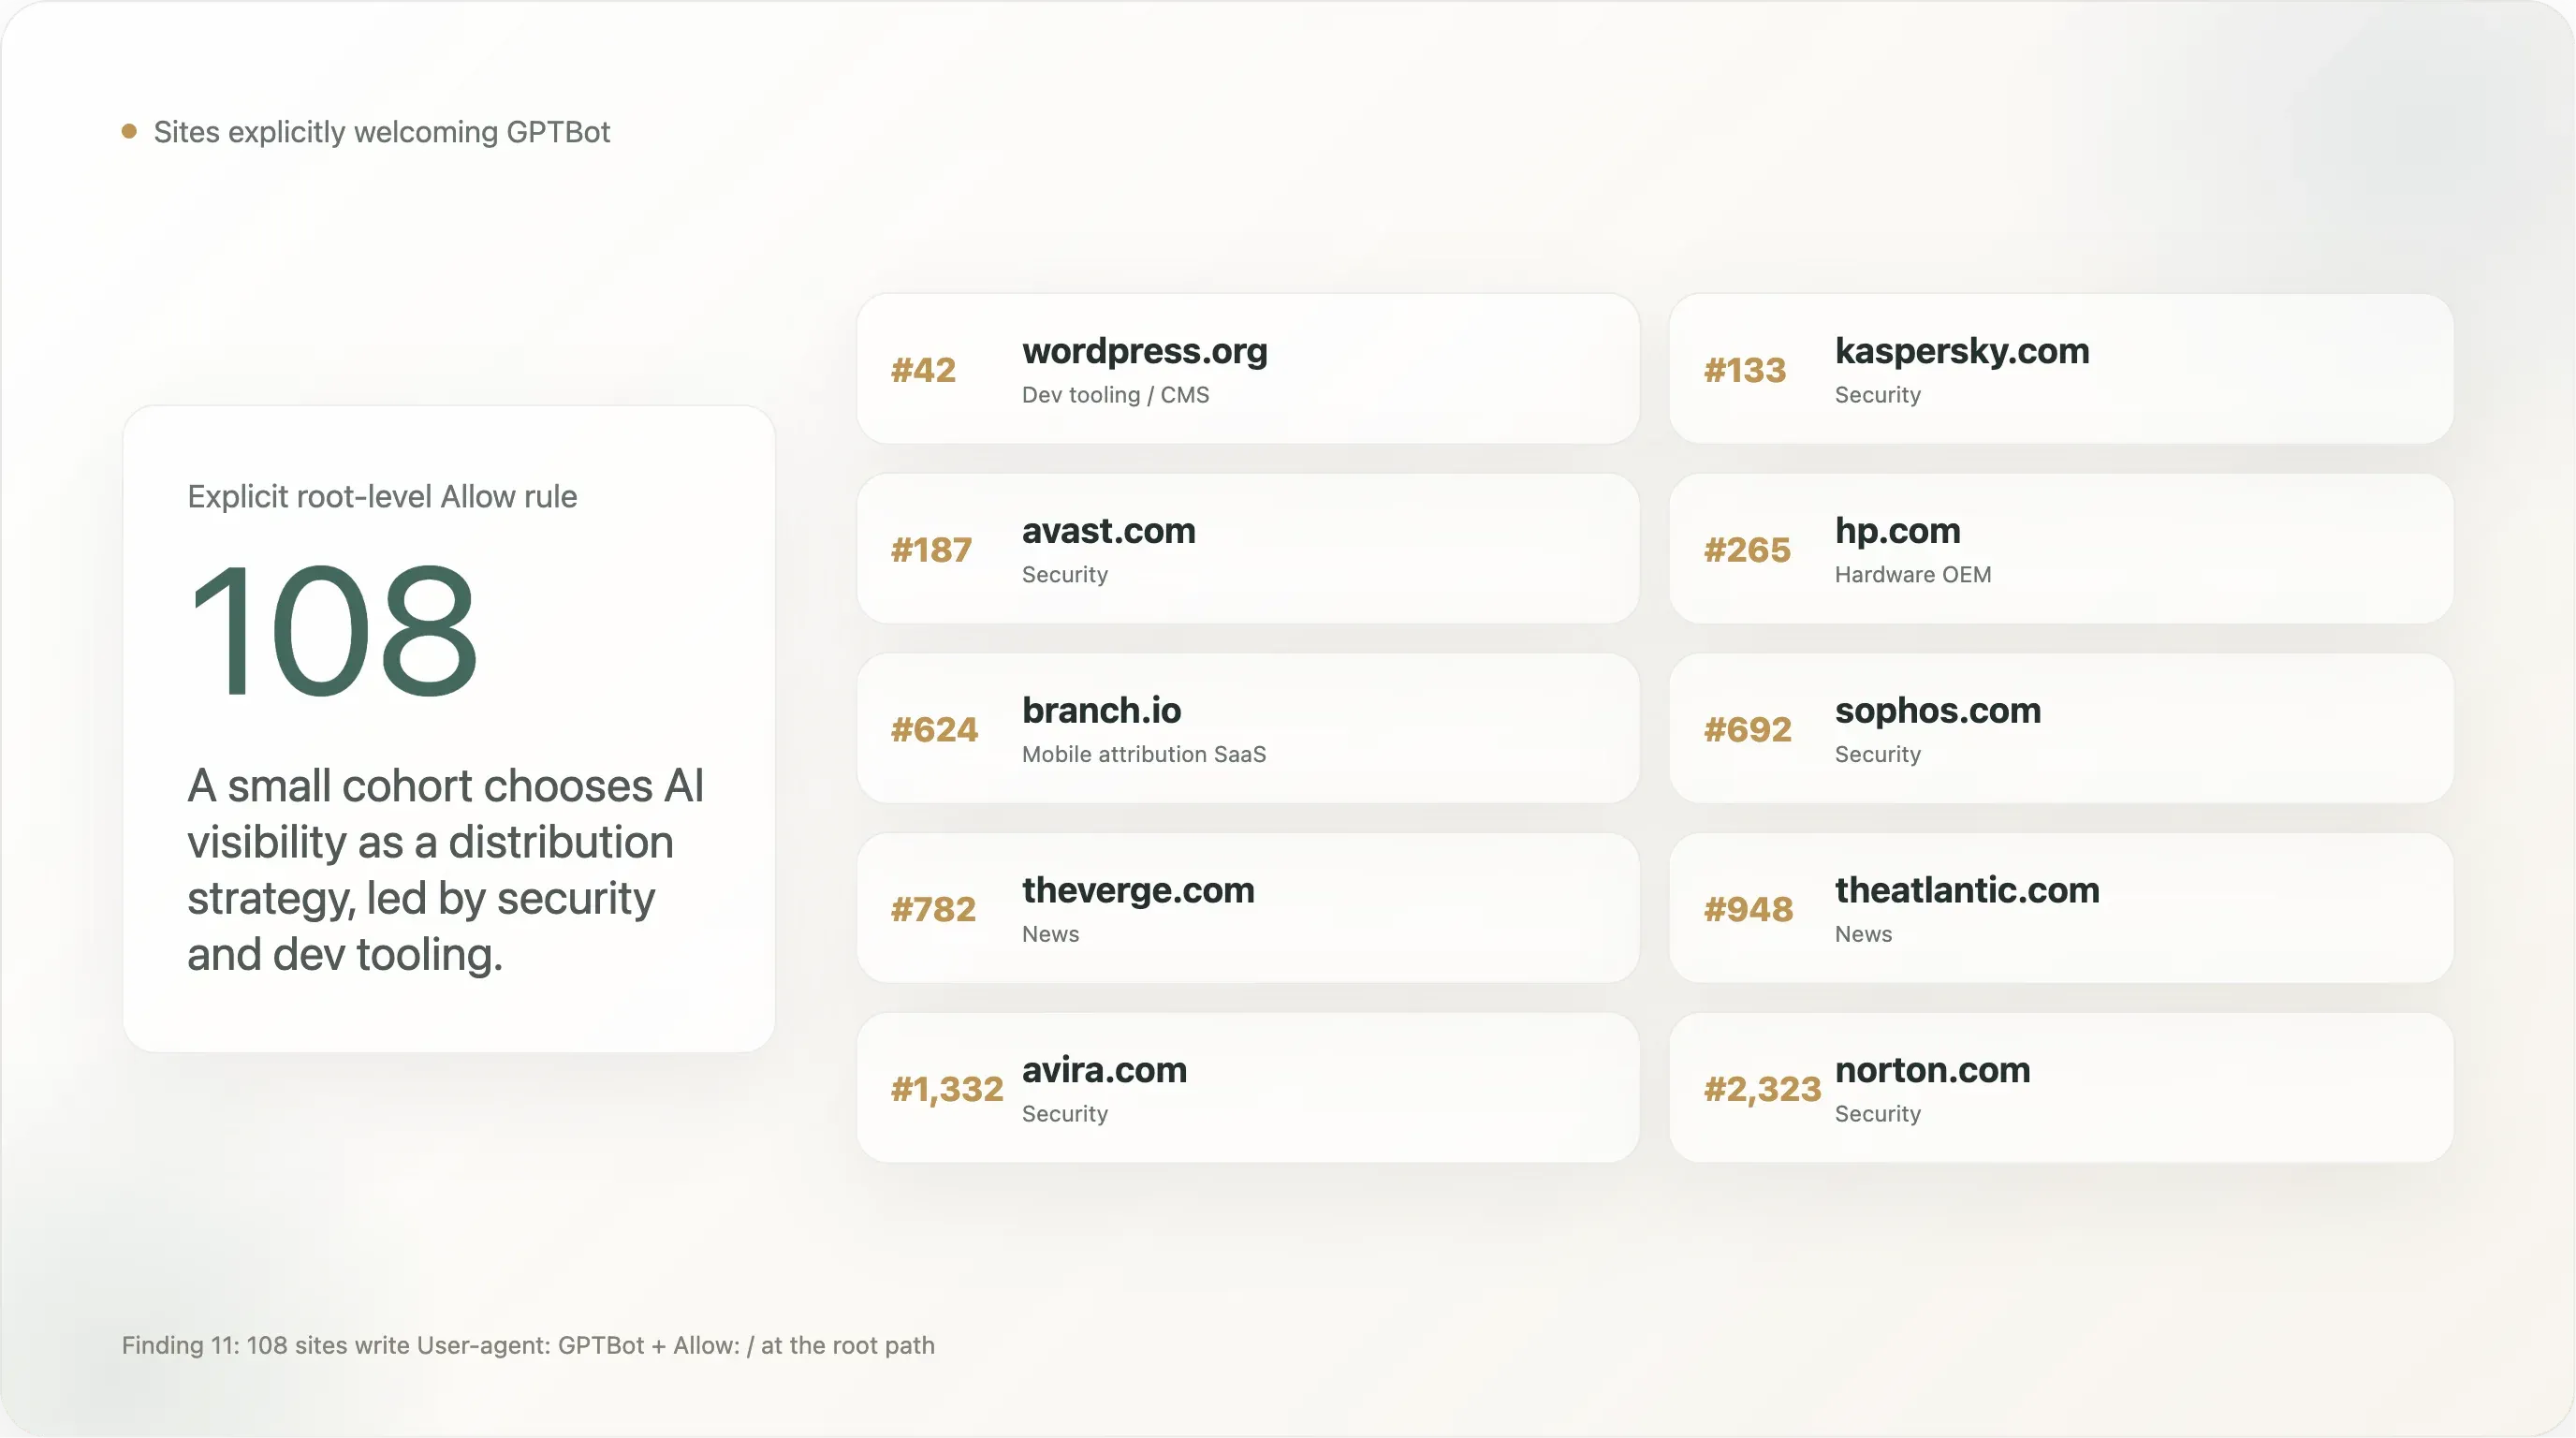
ממצא 11 — 108 אתרים מברכים במפורש את GPTBot
קבוצה קטנה אך גלויה כותבת כלל User-agent: GPTBot \n Allow: / — ההפך מה־"Disallow GPTBot" שמדובר בו יותר. הספירה המלאה במדגם שלנו היא 108 אתרים עם Allow מפורש ל־GPTBot בנתיב השורש. 25 הראשונים לפי דירוג Tranco:
| דירוג | דומיין | מגזר |
|---|---|---|
| 42 | wordpress.org | כלי פיתוח / CMS |
| 133 | kaspersky.com | אבטחה |
| 187 | avast.com | אבטחה |
| 265 | hp.com | יצרן חומרה |
| 624 | branch.io | SaaS לייחוס מובייל |
| 692 | sophos.com | אבטחה |
| 782 | theverge.com | חדשות |
| 905 | rambler.ru | פורטל רוסי |
| 945 | kleinanzeigen.de | מרקטפלייס גרמני |
| 948 | theatlantic.com | חדשות |
| 1,092 | lge.com | LG Electronics |
| 1,300 | justdial.com | חיפוש מקומי בהודו |
| 1,332 | avira.com | אבטחה |
| 1,412 | youm7.com | חדשות מצריות |
| 1,530 | goodreturns.in | פיננסים בהודו |
| 1,621 | publi24.ro | מודעות מסווגות רומניות |
| 1,807 | geocomply.com | SaaS תאימות |
| 1,908 | nba.com | ספורט |
| 1,956 | oneindia.com | חדשות בהודו |
| 1,974 | mindbox.ru | SaaS רוסי |
| 2,009 | thesun.co.uk | חדשות |
| 2,126 | vox.com | חדשות |
| 2,140 | mgid.com | פרסום נייטיב |
| 2,314 | ninjarmm.com | SaaS לניהול IT |
| 2,323 | norton.com | אבטחה |
כמה דפוסים:
חברות אבטחה מיוצגות יתר על המידה באופן בולט. Kaspersky, Avast, Sophos, Avira, Norton, NinjaRMM כולן מאפשרות במפורש את GPTBot. זהו מהלך הפצה מכוון: כשמשתמש שואל את ChatGPT "מה האנטי-וירוס הכי טוב למחשב Windows שלי?", העובדה שהמותג נמצא בקורפוס האימון של המודל משפיעה ישירות על ההמלצה. אבטחה היא אחת מקטגוריות ה־B2C הבודדות שבהן AI search כבר מחליף SEO כערוץ רכישה ראשי, והמותגים הללו נעו ראשונים. אנו מצפים לשאר קבוצת האבטחה ללכת בעקבותיהם בתוך 12 חודשים.
כמה מותגי חדשות גדולים נמצאים ברשימה הזו, לא ברשימת החסימות. The Verge, The Atlantic, Vox, The Sun, NBA.com. זו לא סתירה — נראה שמו״לים אלה החליטו שלהיות ניתנים לציטוט בתוך חיפוש ChatGPT בעל ערך גדול יותר מהגנה מפני אימון, והם כתבו את כלל ה־Allow המפורש כדי להגן מפני חסימת יתר עתידית מצד ה־CDN או ה־CMS שלהם. השוו לעמדה של NYT / Reuters / BBC / Forbes / Guardian של Disallow מפורש. שתי העמדות ניתנות להגנה; תעשיית החדשות אינה מונוליתית.
הנוכחות של The Sun בולטת כי אותו אתר משתמש במקום אחר בקובץ שלו ב־deny-all של User-agent: *. את מדיניות The Sun כדאי לקרוא כ־"אימון AI אסור, חיפוש AI מותר, ואנחנו הלבנו במפורש את GPTBot כאקסצפציה ל־deny-all כדי לוודא ש־ChatGPT יוכל לענות על שאלות ולצטט את The Sun." זהו כלל Allow-GPTBot המתוחכם ביותר משפטית — opt-out בתוספת opt-in לספק יחיד.
הנוכחות של WordPress.org היא בעלת ההשלכות הגדולות ביותר מבין כל הרשומות ברשימה. חלק לא מבוטל מאקוסיסטמת ה־CMS בקוד פתוח העולמית מפנה ל־WordPress.org עבור תיעוד או מארח משם תוספים. על ידי Allow מפורש ל־GPTBot ב־wordpress.org/robots.txt, קרן WordPress למעשה אמרה שאקוסיסטמת התיעוד של WordPress פתוחה לאימון — דבר שיש לו אפקטים משניים על כמה טוב Claude, Gemini ו־ChatGPT יכולים לענות על שאלות "איך אני..." לגבי WordPress.
83 האתרים הנותרים ברשימת Allow-GPTBot המלאה הם זנב ארוך של חדשות אזוריות, ספקי אבטחה קטנים יותר, פלטפורמות מודעות מסווגות בשווקים שאינם אנגלית, ו־B2B SaaS. ככל שנראה לנו, אין תיאום ענפי מקביל של "Allow-GPTBot" — הכלל מאומץ אתר אחר אתר, בידי מפעילים שהחליטו שלהיות בתוך הקורפוס היא העמדה האסטרטגית.
ממצא 12 — llms.txt הוא כמעט שמועה בקנה מידה הזה
llms.txt, פורמט הקובץ החלופי המוצע לגילוי תוכן ידידותי ל־LLM (שקיבל דחיפה מ־Mintlify, Anthropic, Vercel וכמה ספקי dev-tooling מאז סוף 2024), כמעט שלא אומץ באופן גלוי באף מקום במדגם שלנו.
מתוך 6,638 האתרים שהחזירו robots.txt שניתן לנתח, 83 (1.15%) מזכירים llms.txt — בדרך כלל כשורת Sitemap: https://example.com/llms.txt. זה נמוך בשתי דרגות גודל מאותו מדד שנמדד במדגמי מסחר עתירי dev-tooling שבהם ברירות המחדל של Vercel ו־Mintlify מנפחות את האימוץ.
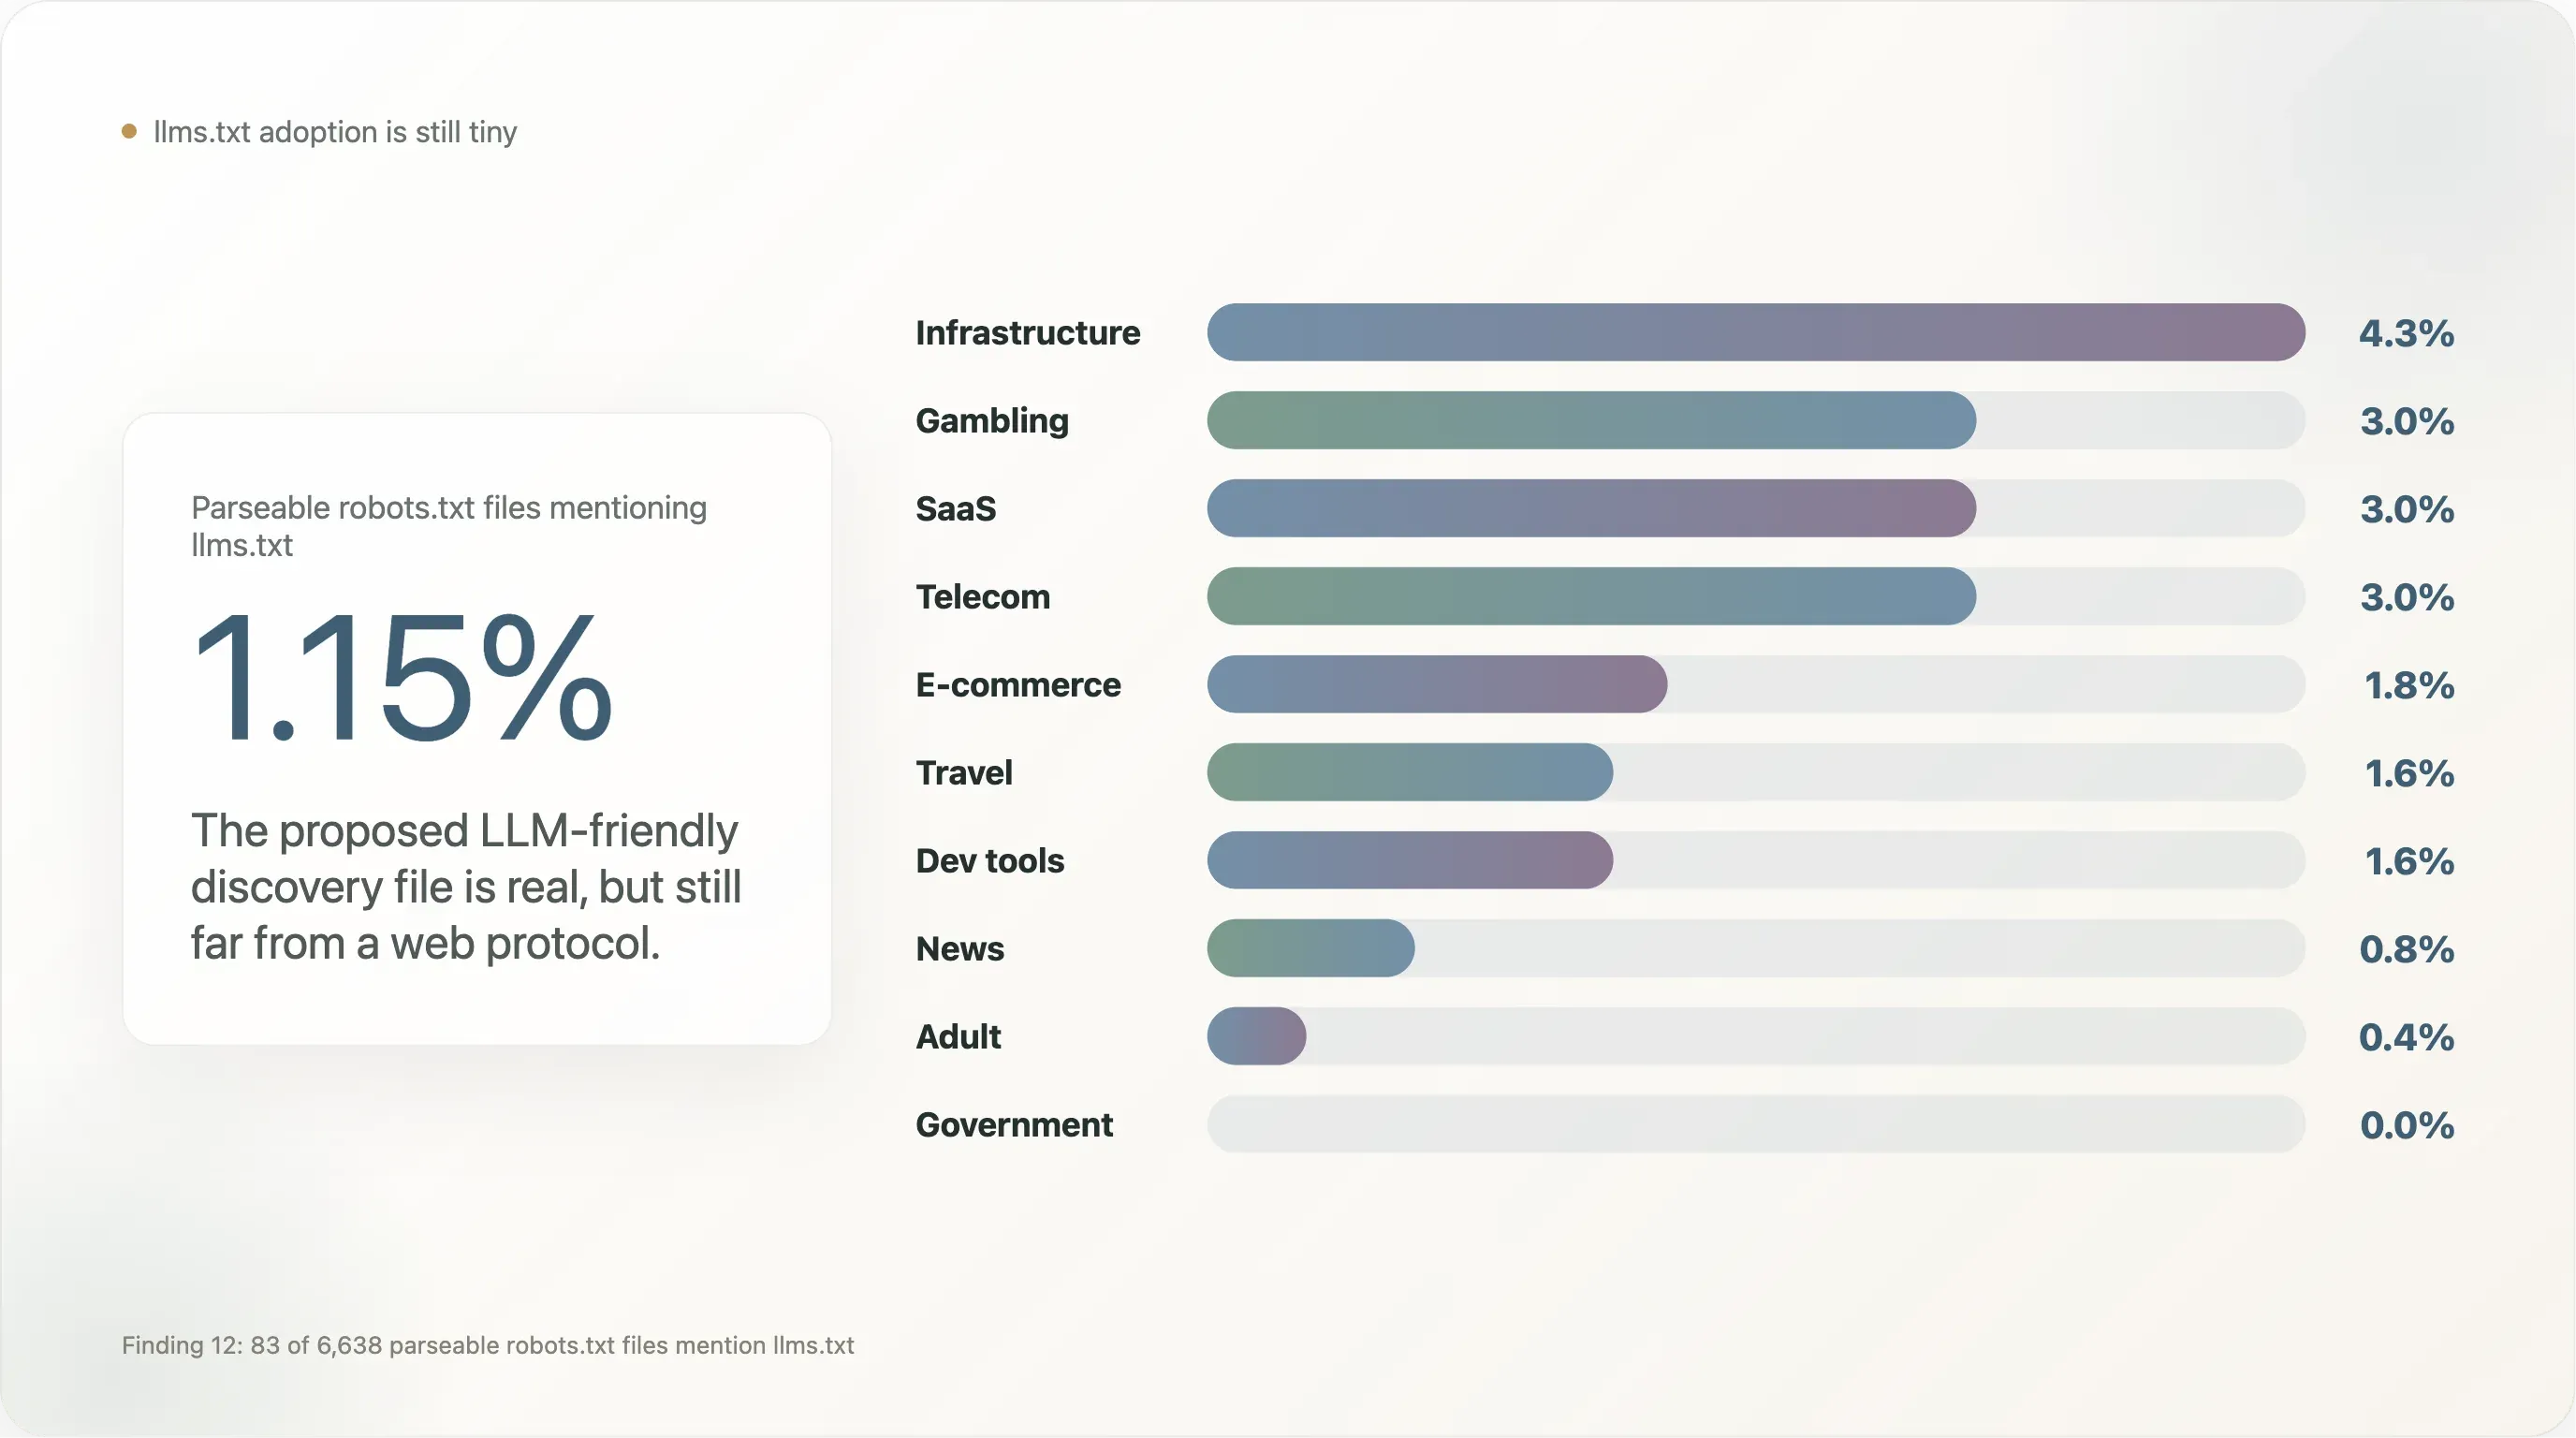
פירוט לפי קטגוריה:
| תעשייה | n | % שמזכירים llms.txt |
|---|---|---|
| Infrastructure | 47 | 4.3% |
| הימורים | 100 | 3.0% |
| SaaS | 369 | 3.0% |
| טלקום | 33 | 3.0% |
| E-commerce | 224 | 1.8% |
| תיירות | 64 | 1.6% |
| כלי פיתוח | 129 | 1.6% |
| חדשות | 650 | 0.8% |
| Adult | 254 | 0.4% |
| ממשלה | 172 | 0.0% |
| אקדמיה | 268 | 0.0% |
| חיפוש | 12 | 0.0% |
llms.txt מרוכז ב־SaaS סמוך ל־dev-tooling, בהימורים (שאימצו תכונות robots.txt עם אוצר מילים חדש מהר יותר מענפים מוסדרים אחרים כי יש להם צוותי תאימות שרגילים להוסיף מטה־דאטה), וב־B2B E-commerce. הוא כמעט לא קיים בחדשות ובממשלה — שני המקטעים שמעורבים ביותר במדיניות AI ושדרושים כדי שהתקן יעבור מ־"ניסוי של ספק" ל־"פרוטוקול רשת". עד אז, llms.txt הוא אמיתי אבל קטן, וביקורת המשך בסוף 2026 תהיה בדיקת־חוזרת שימושית.
הבעיה המבנית של llms.txt היא שהוא לא עבר תקינה על ידי תהליך IETF כלשהו והספקים הגדולים של AI לא התחייבו לכבד אותו. לכלל robots.txt יש 30 שנות תשתית סורקים סביבו; לכלל llms.txt אין אף אחת. עד שלפחות ספק מרכזי אחד (OpenAI, Anthropic, Google, Cloudflare) יצהיר על תמיכה רשמית, הקובץ הוא למעשה חפץ שיווקי של אקוסיסטמת Mintlify / Vercel. איננו מצפים שזה ישתנה ב־2026.
ממצא 13 — נגישות: robots.txt עדיין קריא לשני שלישים מהאתר המוביל
תצפית צד שלא נועדה להיות ממצא: 66% מ־10,000 האתרים המובילים החזירו robots.txt שניתן לנתח ל־IP מחקר יחיד, ו־רק 7 מתוך 10,000 (0.07%) החזירו 429 Too Many Requests. זו בשורה טובה ל־robots.txt כפרוטוקול ציבורי.
לשם השוואה, אותה צנרת שהופעלה על מדגם מסחר בינוני של 1,008 דומיינים חודשיים קודם לכן קיבלה 429 מ־52% מהדומיינים שנפתרו — Shopify ו־CDN של Cloudflare הגבילו קצב באגרסיביות כל UA שאינו של מנוע חיפוש מרכזי. הרשת של תעבורה גבוהה ידידותית הרבה יותר: אתרים מובילים נוטים יותר להיות עם (א) שכבות ניהול בוטים פחות אגרסיביות, או (ב) allowlists מפורשות לסוררי מחקר מוכרים, או שניהם.
שיעור ה־21% של fetch_failed ב־top-10k נשלט בידי דומייני apex של CDN (akamai.net, cloudfront.net, fastly.net, apple-dns.net, gtld-servers.net) שלא מפעילים שרת אינטרנט על /. הם לא חוסמים אותנו; אין להם מה להגיש. אם מוציאים אותם, שיעור הכשל האמיתי של "ניסינו לקרוא אבל לא הצלחנו" הוא באחוזים חד-ספרתיים נמוכים.
המשמעות היא שגרסאות עתידיות של הדוח הזה — תמונות מצב רבעוניות, השוואות משנה לשנה — יכולות לרוץ בזול ובאופן שחוזר על עצמו על מחשב יחיד. חלון הביקורת נשאר פתוח בראש העקומה. המקרה הא-סימטרי הוא הזנב הארוך ומגזר המסחר, שם הגבלת הקצב ברמת CDN כבר הפריטה בפועל את robots.txt. אנו מצפים שהפער הזה יעמיק: אתרים מובילים יישארו קריאים כי הם מאונדקסים בידי מנועי חיפוש שדורשים קריאות; מסחר בזנב הארוך יהפוך לפחות קריא ככל ששכבות הלחימה בבוטים של Cloudflare יהפכו אגרסיביות יותר. יכולת הביקורת הציבורית של robots.txt מתפצלת לאורך אותו קו שמפריד בין "הרשת הנראית" לבין "הרשת המוגנת תפעולית".
IV. מה כל זה אומר
ארבע טענות, לפי עוצמת התמיכה של הנתונים בהן.
1. לאינטרנט יש מדיניות AI לפי תעשייה, לא מדיניות אחת גלובלית. הפער של פי 12 בין חדשות לטלקום דומיננטי בכל מספר אגרגטיבי. דיווח על "X% מהרשת חוסמים AI" בלי חתך מגזרי מגזים ב־SaaS/ממשלה/dev וממעיט בחדשות/תיירות/חברתי. דיווח לפי מגזר הוא המסגור הכנה היחיד.
2. סעיף 4 להנחיית זכויות היוצרים של האיחוד האירופי הוא המשטר המשפטי היחיד שמזיז את המספרים באופן גלוי. אתרי ccTLD של האיחוד חוסמים ב־35% לעומת בסיס גלובלי של 19%. הליטיגציה בארה״ב (NYT נגד OpenAI, דו״ח ה־Copyright Office מינואר 2025) הזיזה את אשכול החדשות האמריקאי אך לא את כל הרשת האמריקאית. המסגור האירופי גם דולף גלובלית דרך תבנית Cloudflare, שמצטטת את הנחיה 2019/790 בנוסח הסטנדרטי שלה בלי קשר לתחום השיפוט של הלקוח.
3. שתי "מדיניות AI" מקבילות מקבלות ביטוי והן לא מסכימות זו עם זו. המדיניות המכוונת, הכתובה ביד (17.8%, בעיקר חדשות/חברתי/תיירות/E-commerce) והמדיניות המנוהלת בירושה על ידי Cloudflare (4.5%) חופפות במהות אך שונות בלגיטימציה. בעולם שבו מפעילי AI מחפשים כיסוי משפטי להתעלם מ־robots.txt, ההגנה של "אנחנו כתבנו ובדקנו את זה" חזקה מבנית יותר מ־"סתם הפעלתי את המתג". התמריץ בליטיגציה הוא להוביל את המדיניות מהקטגוריה השנייה לראשונה.
4. מה שהמו״לים חוסמים הוא הקורפוס, לא המודל. CCBot ב־16.3% — גבוה מכל בוט של מותג מודל — הוא ההצהרה הנקייה ביותר לכך. חסימת OpenAI לא מוציאה מו״ל מאימון-על; חסימת CCBot כן. 14.1% מהרשת ב־top-10k חוסמים את CCBot תוך שהם משאירים את Googlebot רצוי. הדפוס של "חסום אימון, שמור חיפוש" הוא כלל ה־AI השכיח ביותר ב־2026.
לאתרים ששוקלים את העמדה שלהם: העמדה החציונית היא שקט — 80% מה־top 10k לא אומרים דבר על AI. ה־17% שכותבים כללים מתרכזים סביב Disallow, אבל קבוצה קטנה וצומחת (רשימת Allow-GPTBot המפורשת של 1.5%, בהובלת ספקי אבטחה) בוחרת בפומבי את ההפך. אין קונצנזוס ענפי ולא יהיה כזה ב־12 החודשים הקרובים.
למפעילי AI: קשה יותר ויותר להמשיך לטעון ש־robots.txt הוא פרוטוקול מיושן עם סמנטיקה עמומה, כאשר 17% מהאתרים הגדולים בעולם כתבו כללים מפורשים ומכוונים תוך ציון בוטים בשמותיהם, ו־3.8% מהקבצים מצטטים סעיף סטטוטורי אירופי ספציפי לפי מספר. האם לכבד את הכללים האלה היא החלטה עסקית; האם הם קיימים — זו כבר עובדה אמפירית.
V. תחזית: מה אנו מצפים עד סוף 2026
שלוש מגמות שכבר נראות במערך הנתונים:
Cloudflare Managed תכפיל יותר מהכפלתה, ותגיע ככל הנראה ליותר מ־10% מה־top-10k שניתן לנתח. מפת הדרכים של Cloudflare מדברת בפומבי על Block AI Bots כברירת מחדל לחשבונות חדשים. אם המתג יושק כ־default-on, שיעור החסימה הגלובלי יעלה ב־5–8 נקודות אחוז בלי שאף מו״ל יקבל החלטה. נדע שזה קורה כשהנתח של Cloudflare Managed בטווח 5001–10000 יטפס מעל 5.7% הנוכחי שלו.
מדיניות AI ברמת מקטעים (בסגנון Spiegel) תתפשט בקרב ספינות הדגל המרכזיות של החדשות. ההיגיון הכלכלי — תן ל־AI לצטט תוכן בעל סיכון נמוך, הגן על תוכן החפיר — משכנע מספיק כדי שנצפה שלפחות 10 חדרי חדשות נוספים ישיקו כללים ברמת מקטע עד סוף 2026. כדאי לעקוב תחילה אחרי העיתונות הגרמנית והצרפתית הבינונית; המסגרת המשפטית מתגמלת שם ניסוי.
קבוצת ה־Allow-GPTBot המפורשת תגדל, בהובלת B2B SaaS וכלי פיתוח. כאשר חיפוש AI יהפוך לערוץ רכישה מדיד עבור ספקי תוכנה (כפי שכבר קורה באבטחה), ה־CMO השולי יכתוב User-agent: GPTBot \n Allow: / כדי להתחסן מפני חסימת יתר מקרית. אנו מצפים שרשימת 108 האתרים תכפיל בערך את גודלה עד סוף השנה.
מה לא מצפים לראות: שינוי משמעותי בחלק של הרוב השקט. 80% מהאינטרנט שלא אומרים דבר על AI כוללים מגזרים (ממשלה, טלקום, תשתיות, B2B SaaS) שאין להם סיבה כלכלית לכתוב כלל ואין עליהם לחץ משפטי לעשות זאת. מדיניות AI אוניברסלית אינה מגיעה.
VI. מגבלות
- הטיית תמונת יחיד. השליפות בוצעו בחלון של 36 שעות בתחילת מאי 2026. הקובץ משתנה מדי יום בראש ה־100; צפו לסטייה של 1–2 נקודות אחוז ברבעון במספרי הכותרת.
- חוסרי סיווג תעשייתי. 6,593 מתוך 10,000 אתרים נותרו
unknownאחרי המסווג בעל ארבע השכבות. האחוזים לפי תעשייה חזקים כאשר n גדול (חדשות: 650, סטרימינג: 440, saas: 369, אקדמיה: 268, adult: 254, ecommerce: 224, ממשלה: 172, פיננסים: 129, dev: 129) ורועשים יותר מתחת ל־n=30. חיתוך החדשות לפי מדינות מוגבל באופן דומה — DE/FR/UK עם n≥15, קוריאה/שבדיה/צ'כיה נשענות על n=20–25. robots.txtהוא וולונטרי.Disallowהוא בקשה, לא מחסום.Bytespider,PerplexityBotואחרים תועדו כמי שמתעלמים מכללים. מדדנו הצהרות מדיניות, לא אכיפת מדיניות.- ביקורת יחיד-IP, מבוססת ארה״ב. לא הצלחנו לקרוא 21% מהדומיינים שנפתרו. רובם נקודות apex של CDN ללא שרת אינטרנט; חלק קטן הם אתרים שה־CDN שלהם סימן אותנו לפני שהגענו למקור. זה מטה מעט את המדגם לטובת תשתיות ישנות יותר ולרעת אתרים שמוגנו גאוגרפית לפי מדינת המקור.
- סמנטיקת רשימת Tranco. Tranco מסנן ליציבות; זו לא באמת דירוג התנהגות משתמשים. המספרים האגרגטיביים יציבים ביחס לבחירת הרשימה; מיקומי הדירוג הספציפיים לא.
- אין נתוני תעבורה. מדדנו מדיניות
robots.txt, לא את תפוקת הבוטים של AI בפועל. מדיניות ותעבורה לא תמיד מסכימות.
VII. איך לשחזר את זה
כל מה ששימש ליצירת הדוח נמצא בתיקיית המסירה.
- tranco_top10k.csv — רשימת קלט
- out/sites.csv — דומיין × דירוג × תעשייה × שפה × סטטוס robots.txt (10,000 שורות)
- out/fetch_meta.csv — תוצאת השליפה לכל דומיין (סטטוס, סכימה, בתים, שגיאה)
- out/bot_status.csv — מטריצת דומיין × בוט (250,000 שורות: חסום, יש כלל, סטטוס שליפה)
- out/site_meta.csv — רשומת ניתוח אחת לכל אתר (תבנית, בוליאנים מסכמים)
- out/analysis.json — כל מדד שמצוטט בדוח
- 01_fetch_robots.py, 02_classify.py, 03_parse_and_analyze.py — צינור Python מלא
הורדת כל הסקריפטים ומערכי הנתונים
תיקוני מתודולוגיה, בעיות במערך הנתונים וניתוחים המשך יתקבלו בברכה בכתובת support@thunderbit.com. דוח זה פורסם באופן עצמאי מכל עמדה מסחרית של Thunderbit; אנו בונים web scraper מונע AI, ויש לנו עניין מבני בכך ש־robots.txt ימשיך להיות חוזה משמעותי וקריא למכונה ברשת הציבורית. הנתונים בדוח זה עומדים בפני עצמם. — צוות המחקר של Thunderbit, מאי 2026.
נסו את Thunderbit AI Web Scraper Get Started Free




