Raspador de Tumblr













Desbloquea los datos de Tumblr con Thunderbit
Extrae sin esfuerzo datos de Tumblr como el contenido de las publicaciones y el número de “me gusta”.
Consigue la historia completa de Tumblr
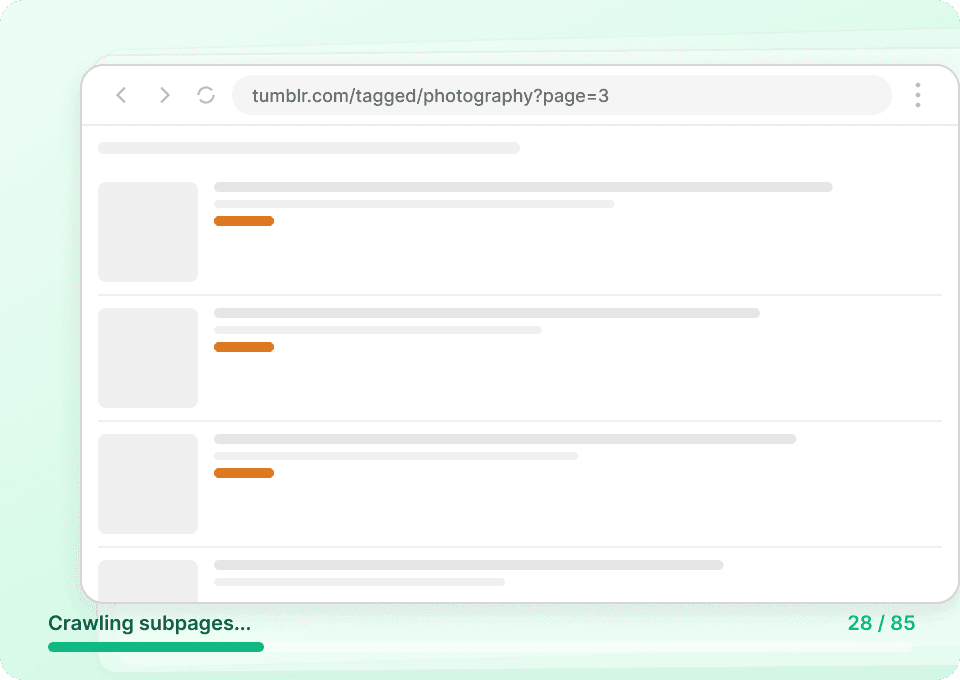
Las páginas de listado de Tumblr solo muestran fragmentos. Para ver el panorama completo, necesitas el contenido entero de la publicación, los detalles del autor y todos los metadatos asociados. Thunderbit visita automáticamente cada página enlazada del post, extrae la información completa y la añade como nuevas columnas, para que puedas capturar IDs de publicaciones, fechas de publicación y mucho más sin hacer clic manualmente.
Automatiza la recopilación de datos de Tumblr
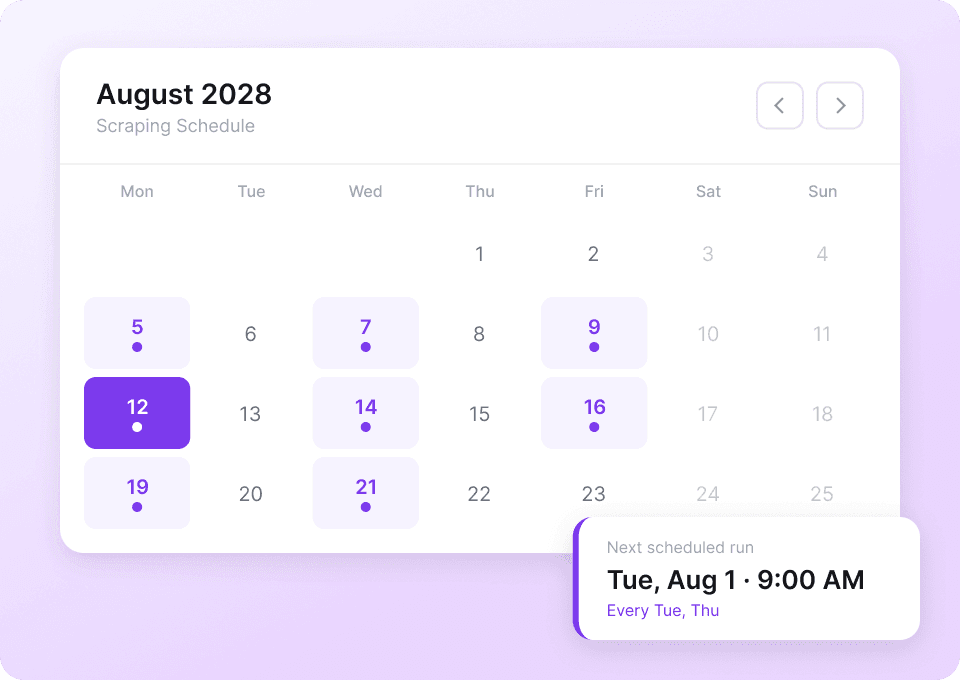
Los datos de Tumblr cambian constantemente. Volver manualmente a los mismos blogs para reextraer información es tedioso y propenso a errores. Con el scraping programado de Thunderbit, puedes configurar extracciones recurrentes en piloto automático. Recibe nuevos números de “me gusta” y contenido de publicaciones directamente en Google Sheets, sin trabajo manual.
Extrae publicaciones de Tumblr en dos clics
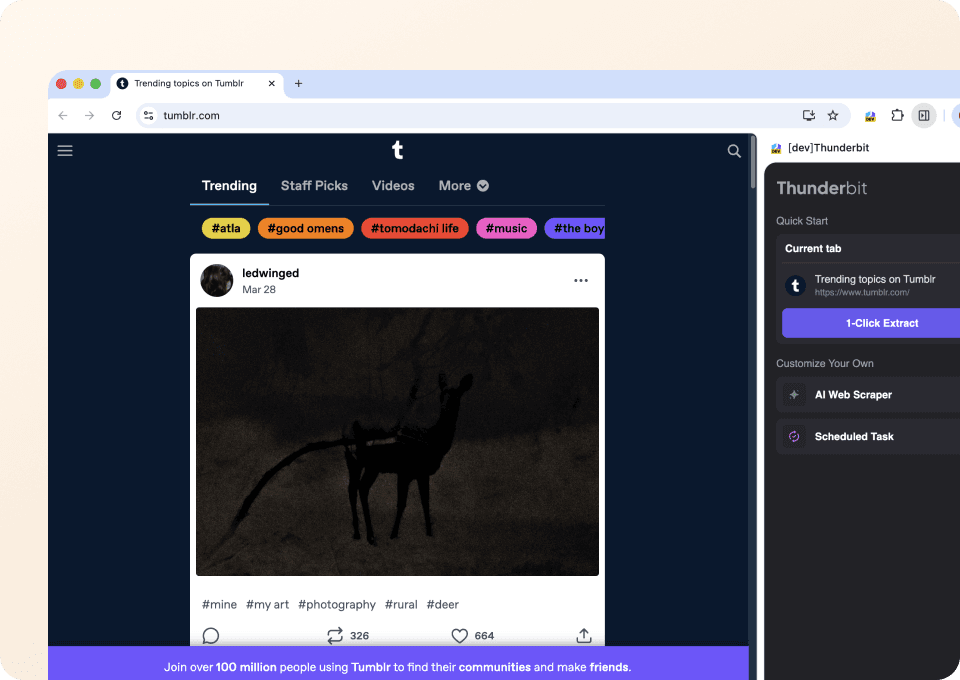
No necesitas código ni selectores CSS. Thunderbit te permite extraer datos de Tumblr en solo dos clics. Solo apunta a lo que quieres — tipo de publicación, autor, contenido, número de “me gusta” — y la IA semántica de Thunderbit detectará los campos relevantes y extraerá todo automáticamente.
¿Por qué Thunderbit es diferente de los scrapers tradicionales de Tumblr?
Extrae datos de Tumblr sin esfuerzo, incluso cuando el diseño cambia o se modifica de forma inesperada.
Scrapers tradicionales
La forma antigua de hacer las cosasIA de Thunderbit
El enfoque más inteligenteNo te quedes solo con nuestra palabra
Mira lo que nuestros usuarios dicen sobre Thunderbit.
Preguntas frecuentes
Relacionados casos de uso
Explora más casos de uso del web scraper de Thunderbit.
Raspador de Minds
El Raspador Web de Minds de Thunderbit te permite extraer información de los feeds de noticias y miembros de grupos en Minds, con sugerencias inteligentes de campos gracias a la IA. Recopila títulos de publicaciones, nombres de autores, likes, comentarios y detalles de miembros de grupos para investigación, marketing o análisis de comunidades. Exporta datos estructurados de Minds de forma rápida y eficiente.
Saber más ->
Raspador de MeWe
El Raspador Web de MeWe de Thunderbit te permite extraer datos de perfiles de usuario y publicaciones de grupos en MeWe, con sugerencias de campos impulsadas por IA. Recopila nombres de perfil, biografías, fechas de registro, contenido de publicaciones, 'me gusta' y comentarios para investigación, marketing o análisis. Es la herramienta perfecta para profesionales de marketing, investigadores y empresas que necesitan datos estructurados de MeWe.
Saber más ->
Raspador de Parler
El Raspador Web de Parler de Thunderbit te permite extraer información de los resultados de búsqueda y listas de hashtags de Parler, con sugerencias inteligentes de campos gracias a la IA. Recopila términos de búsqueda, publicaciones de usuarios, hashtags, niveles de popularidad y mucho más para investigación, marketing o análisis de contenido. Es la herramienta perfecta para profesionales de marketing, investigadores y empresas que necesitan datos estructurados de Parler.
Saber más ->
Raspador de Elementos
El Raspador Web de Element de Thunderbit te permite extraer información de la Sala de Administradores de Element Synapse con sugerencias inteligentes de campos impulsadas por IA. Recopila IDs de mensajes, nombres de remitentes, marcas de tiempo, contenido de mensajes y archivos adjuntos para análisis o monitoreo. Es la herramienta perfecta para desarrolladores, gestores de comunidades e investigadores que necesitan datos estructurados de Element.
Saber más ->
Raspador de Odnoklassniki
El Raspador Odnoklassniki de Thunderbit te permite extraer datos de grupos y listas de juegos de Odnoklassniki con sugerencias de campos impulsadas por IA. Recopila nombres de grupos, descripciones, cantidad de miembros, detalles de juegos, valoraciones y mucho más para investigación, marketing o análisis. Perfecto para profesionales de marketing, investigadores y empresas que necesitan datos estructurados de Odnoklassniki.
Saber más ->
Raspador de Triller
El Raspador Web de Triller de Thunderbit te permite extraer información de páginas de blogs y perfiles de creadores en Triller. Aprovecha las sugerencias inteligentes impulsadas por IA para recopilar rápidamente títulos de blogs, fechas de publicación, nombres de autores, biografías de creadores y cantidad de seguidores, ideal para investigación, marketing o análisis.
Saber más ->¿Listo para potenciar tu extracción de datos?
Únete a más de 200,000 profesionales que ya usan Thunderbit para automatizar sus flujos de web scraping.
La prueba gratuita ofrece créditos ilimitados para 8 páginas web.



