Raspador de Goodreads













Extrae datos de Goodreads en segundos, no en horas
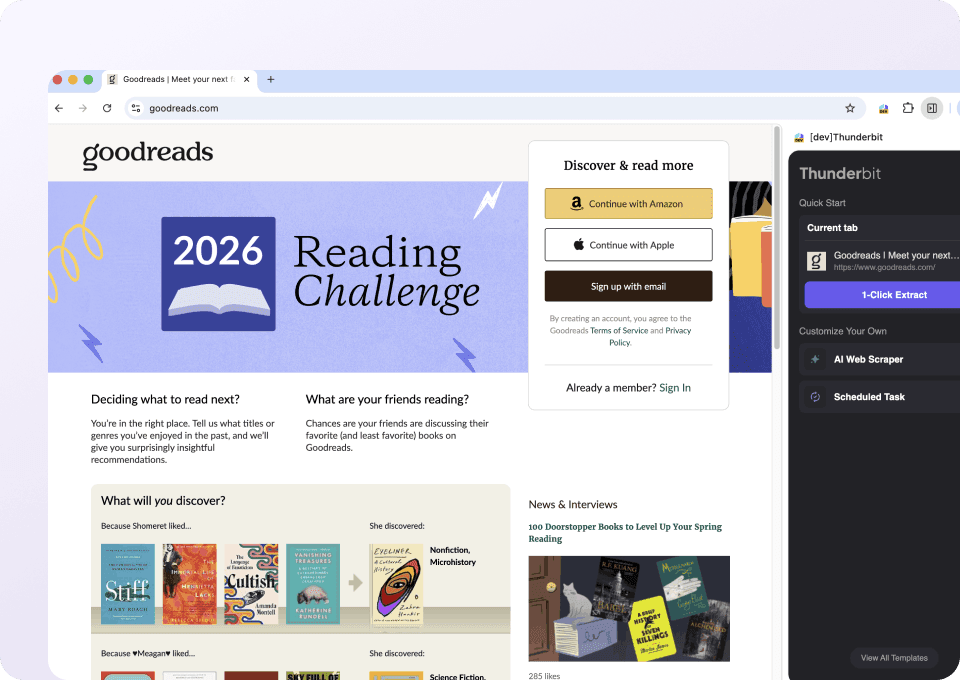
Dos clics para extraer datos de Goodreads
¿Cansado de copiar manualmente títulos de libros, nombres de autores, valoraciones y número de páginas desde Goodreads? Thunderbit te permite extraer los datos que necesitas en solo dos clics, sin código ni configuración. Solo señala los campos que quieres y la IA los detecta y captura automáticamente.
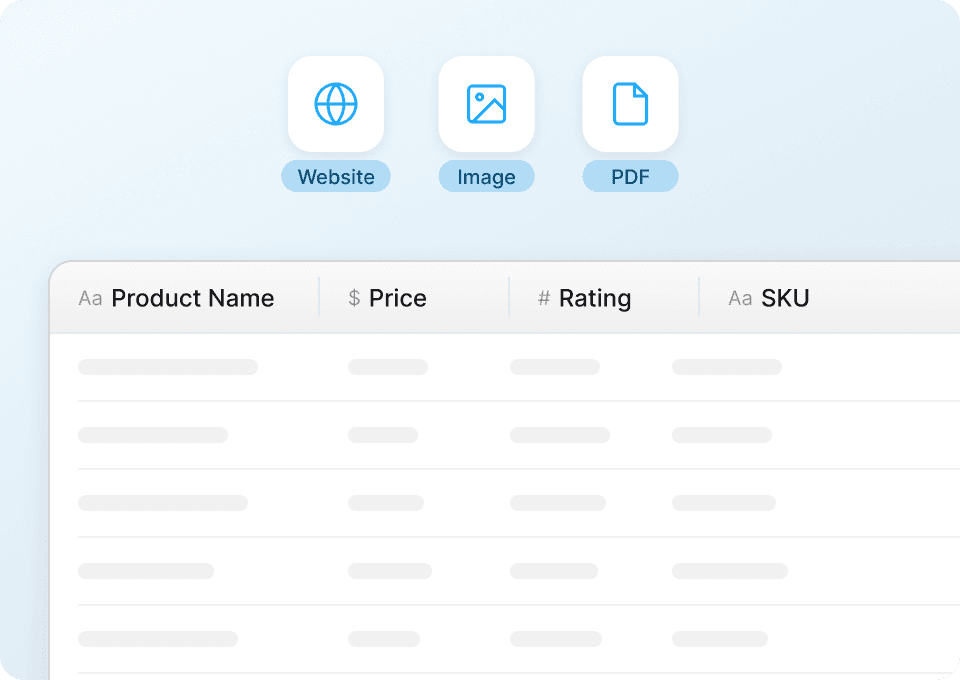
Datos de Goodreads limpios y listos para usar
Los datos de Goodreads pueden ser desordenados e inconsistentes. Thunderbit los limpia y estructura automáticamente al extraerlos, para que obtengas una hoja de cálculo perfectamente formateada con títulos, autores, valoraciones medias, número de reseñas y páginas, todo listo para analizar. Sin limpieza manual.
Extrae cientos de páginas de Goodreads
Visitar Goodreads página por página manualmente es lento y propenso a errores. Thunderbit se encarga de la extracción masiva automáticamente: solo proporciona una lista de URLs y extraerá títulos, autores, valoraciones y más en cientos de páginas de una sola vez, de forma rápida y sin interrupciones.
¿La extracción de Goodreads te está dando problemas?
Descubre cómo Thunderbit simplifica la extracción de datos de Goodreads.
Raspadores tradicionales
La forma de hacerlo de antesThunderbit
El enfoque más inteligenteNo te quedes solo con nuestra palabra
Mira lo que nuestros usuarios dicen sobre Thunderbit.
Preguntas frecuentes
Relacionados casos de uso
Explora más casos de uso del web scraper de Thunderbit.
Raspador de Flixster
El Raspador Web de Flixster de Thunderbit te permite extraer información de las listas de taquilla más populares y cines cercanos de Flixster. Aprovecha las sugerencias inteligentes impulsadas por IA para recopilar rápidamente títulos de películas, recaudaciones, valoraciones, fechas de estreno, nombres y ubicaciones de cines, así como la cartelera disponible, ideal para análisis o investigación.
Saber más ->
Raspador de olympustaff.com
El Raspador Web de olympustaff.com de Thunderbit te permite extraer datos de listas de cómics y comentarios en olympustaff.com. Aprovecha las sugerencias inteligentes impulsadas por IA para recopilar rápidamente títulos de cómics, autores, fechas de lanzamiento y opiniones de lectores, ya sea para análisis o investigación. Es la herramienta perfecta para marketers, investigadores y creadores de contenido que buscan datos estructurados de olympustaff.com.
Saber más ->
Raspador de Hatena
El Raspador Web de Hatena de Thunderbit te permite extraer datos de blogs y listas de temas de Hatena con sugerencias de campos impulsadas por IA. Recopila títulos de blogs, nombres de autores, fechas de publicación, resúmenes de contenido y temas en tendencia para investigación, marketing o análisis de contenido. Perfecto para profesionales de marketing, investigadores y creadores de contenido que buscan datos estructurados de Hatena.
Saber más ->
Raspador de namu.wiki
El Raspador Web de namu.wiki de Thunderbit te permite extraer información de namu.wiki, incluyendo páginas relevantes y debates recientes. Aprovecha las sugerencias inteligentes impulsadas por IA para recopilar rápidamente títulos de páginas, enlaces, fechas de última edición, temas de discusión y nombres de participantes, ideal para investigación, creación de contenido o análisis de comunidades.
Saber más ->
Raspador de Música de NetEase
El Raspador Web de NetEase Music de Thunderbit te permite extraer información de los resultados de búsqueda y páginas de artistas en NetEase Music. Aprovecha las sugerencias inteligentes impulsadas por IA para recopilar rápidamente títulos de canciones, nombres de artistas, detalles de álbumes, duraciones y enlaces de canciones para análisis o investigación. Perfecto para analistas musicales, profesionales del marketing y aficionados que buscan datos estructurados de NetEase Music.
Saber más ->
Raspador de QQ Music
El Raspador Web de QQ Music de Thunderbit te permite obtener datos de los resultados de búsqueda y listas de obras de artistas en QQ Music. Aprovecha las sugerencias inteligentes impulsadas por IA para recopilar rápidamente títulos de canciones, nombres de artistas, detalles de álbumes, fechas de lanzamiento y mucho más, ideal para análisis o investigación. Perfecto para analistas musicales, profesionales del marketing y aficionados que buscan datos estructurados de QQ Music.
Saber más ->¿Listo para potenciar tu extracción de datos?
Únete a más de 200,000 profesionales que ya usan Thunderbit para automatizar sus flujos de web scraping.
La prueba gratuita ofrece créditos ilimitados para 8 páginas web.



