Raspador de Artículos para Texto, Autores y Fechas













Recopila datos de artículos en diseños de página cambiantes
Lee los campos por su significado, programa ejecuciones repetidas y usa el mismo flujo de trabajo en sitios públicos.
Adáptate cuando cambie el diseño de los artículos
Thunderbit lee titulares visibles, firmantes, fechas, resúmenes y texto del artículo según su significado. El flujo de trabajo depende menos de posiciones fijas en la página cuando un sitio de noticias cambia su diseño.
Ejecuta el raspado de artículos en un horario
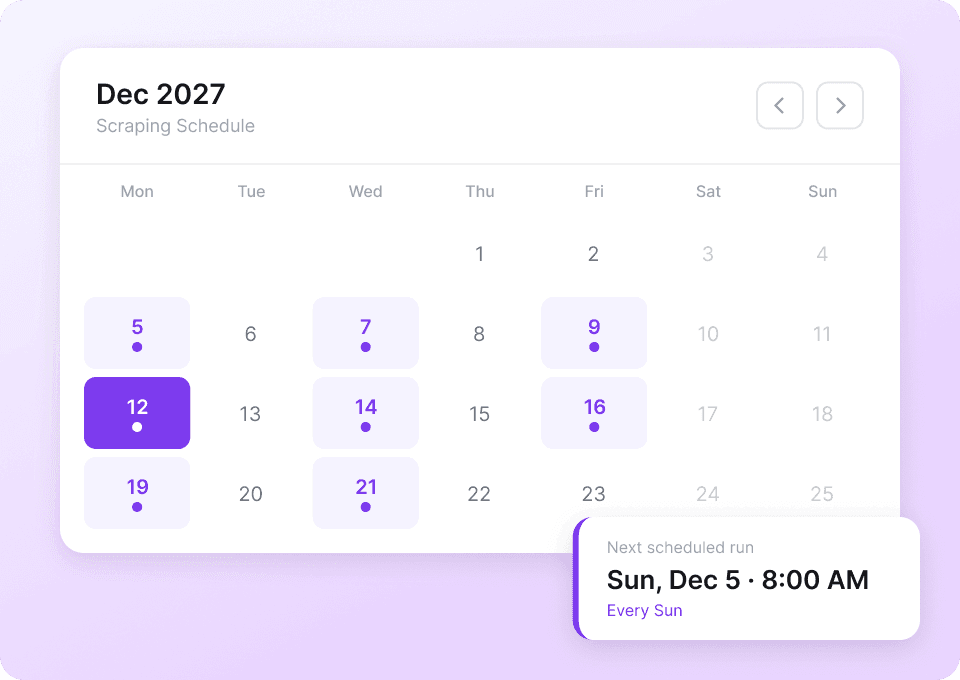
Configura una ejecución repetida para una página pública de noticias, blog o sección que visitas con frecuencia. Thunderbit puede recopilar los artículos visibles más recientes y enviar nuevas filas al archivo o app que elijas.
Usa un solo flujo de trabajo en cualquier sitio público
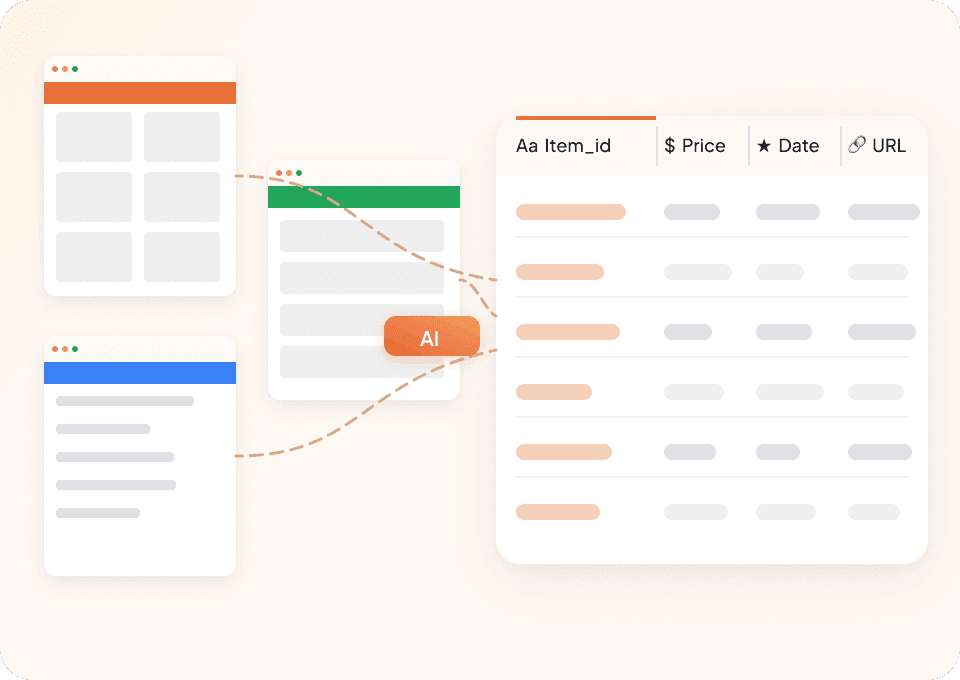
Usa el mismo flujo de trabajo en cualquier sitio público con artículos. Nombra los campos que necesitas y deja que Thunderbit coloque cada página en las mismas columnas.
Un solo flujo de trabajo para artículos en distintos diseños de página
Los selectores fijos siguen posiciones. La IA de Thunderbit busca los campos del artículo que indicaste.
Un mapa de selectores para cada editor
Cada diseño de página necesita mantenimiento por separadoCampos del artículo organizados por Thunderbit
El registro solicitado se mantiene consistente¿Qué datos puedes extraer de un artículo?
Elige entre 30 campos visibles de contenido, autor, editor, fecha, enlaces, temas, medios y metadatos de la página.
- Titular
- Titular alternativo
- Cuerpo del artículo
- Resumen del artículo
- Nombre del autor
- URL del autor
- Organización del autor
- Nombre del editor
- URL del editor
- Fecha de publicación
- Fecha de modificación
- Sección del artículo
- Palabras clave
- Conteo de palabras
- Idioma
- URL canónica
- URL de la entidad principal
- URL de la imagen
- Pie de foto de la imagen
- Crédito de la imagen
- URL del video
- URL del audio
- Dateline
- Temas relacionados
- Menciones
- Enlaces de cita
- URL de la licencia
- Enlaces a artículos relacionados
- Título de la página
- Meta descripción
Hear editors and research teams discuss article data
In these user videos, editors and researchers gather article text, bylines, dates, and source links for review.
Preguntas sobre el raspado de artículos públicos
Los sitios de noticias usan diseños y detalles de página distintos, así que los campos que obtienes dependen de la página del artículo que captures.
Continue from articles to the pages around them
Explore news, author, and publisher scrapers when your research also needs indexes, profiles, or related stories.

Raspador de 4PDA
El Raspador Web 4PDA de Thunderbit te permite extraer datos de artículos de noticias y publicaciones de foros en 4PDA utilizando IA. Recopila rápidamente títulos de artículos, fechas de publicación, autores y contenido de publicaciones para investigación, análisis o seguimiento de debates tecnológicos. Perfecto para entusiastas de la tecnología, investigadores y profesionales de marketing que buscan datos estructurados de 4PDA.
Saber más ->
Raspador de Ptt
El Raspador Web de Ptt de Thunderbit te permite extraer información de foros y publicaciones de Ptt con sugerencias inteligentes impulsadas por IA. Recopila nombres de foros, enlaces, popularidad, títulos de publicaciones, autores y comentarios para investigación, marketing o análisis de contenido. Perfecto para profesionales de marketing, investigadores y creadores de contenido que buscan datos estructurados de Ptt.
Saber más ->
Raspador de Mercado de Pizza
El Raspador Web de Pizza Marketplace de Thunderbit te permite extraer datos de los listados de noticias y directorios de proveedores de Pizza Marketplace. Aprovecha las sugerencias inteligentes impulsadas por IA para recopilar rápidamente títulos de noticias, fechas de publicación, autores, nombres de proveedores, ubicaciones y datos de contacto para investigación, marketing o análisis.
Saber más ->
Raspador de Failory
El Raspador Failory de Thunderbit te permite extraer datos estructurados del cementerio de startups y artículos de noticias de Failory. Aprovecha las sugerencias inteligentes impulsadas por IA para recopilar nombres de startups, años, causas de fracaso, títulos de artículos, autores y mucho más para tus investigaciones o análisis. Perfecto para emprendedores, inversores e investigadores que buscan información valiosa de Failory.
Saber más ->
Raspador de Investing.com
Extrae datos bursátiles — símbolos, precios, volumen y capitalización de mercado — de Investing.com en 2 clics y expórtalos directamente a Google Sheets, Notion o Excel. Abre cualquier página de Investing.com y deja que la IA identifique los campos por ti.
Saber más ->
Raspador de Substack
Extrae en 2 clics el número de suscriptores de Substack, títulos de artículos y descripciones de publicaciones — y luego expórtalos a Excel, Google Sheets o Notion. No necesitas programar; la IA de Thunderbit se encarga de estructurarlo todo por ti.
Saber más ->¿Listo para potenciar tu extracción de datos?
Únete a más de 200,000 profesionales que ya usan Thunderbit para automatizar sus flujos de web scraping.
La prueba gratuita ofrece créditos ilimitados para 8 páginas web.



