
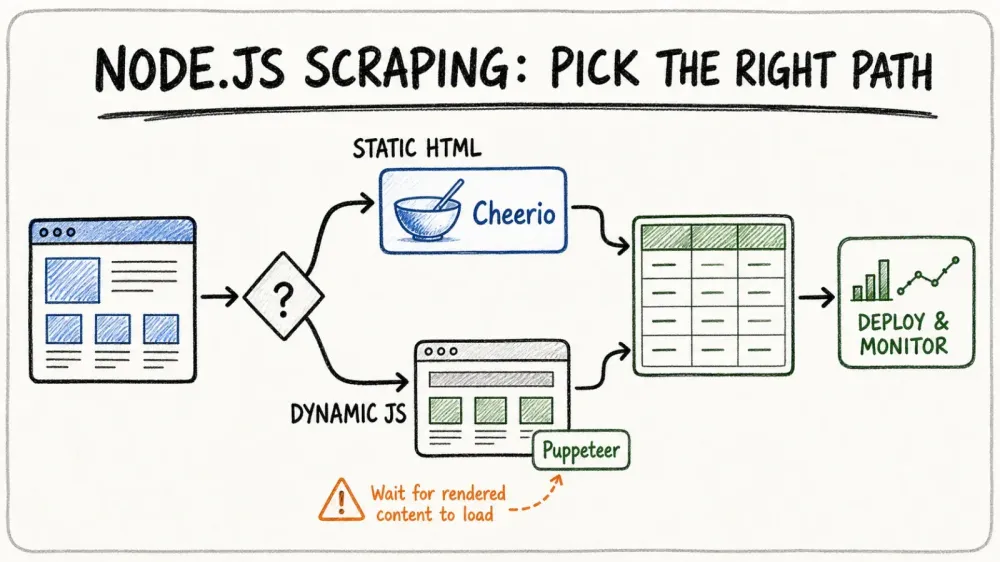
La web necesita más datos que nunca, y en 2026, Node.js se está consolidando como la opción favorita para los equipos que quieren extraer datos de forma más inteligente, no más pesada. Tanto si trabajas en ventas, ecommerce o simplemente eres un fanático de los datos como yo, seguro que ya notaste que el scraping ya no va solo de “llevarse la información”: ahora se trata de hacerlo rápido, a escala y sin acabar con tu IP en la cárcel digital. Y la demanda no afloja — los datos públicos de la web se han convertido, casi sin hacer ruido, en la base sobre la que se construyen muchos equipos modernos, desde inteligencia de precios hasta pipelines de entrenamiento de LLM, y la competencia nunca había estado tan fuerte.
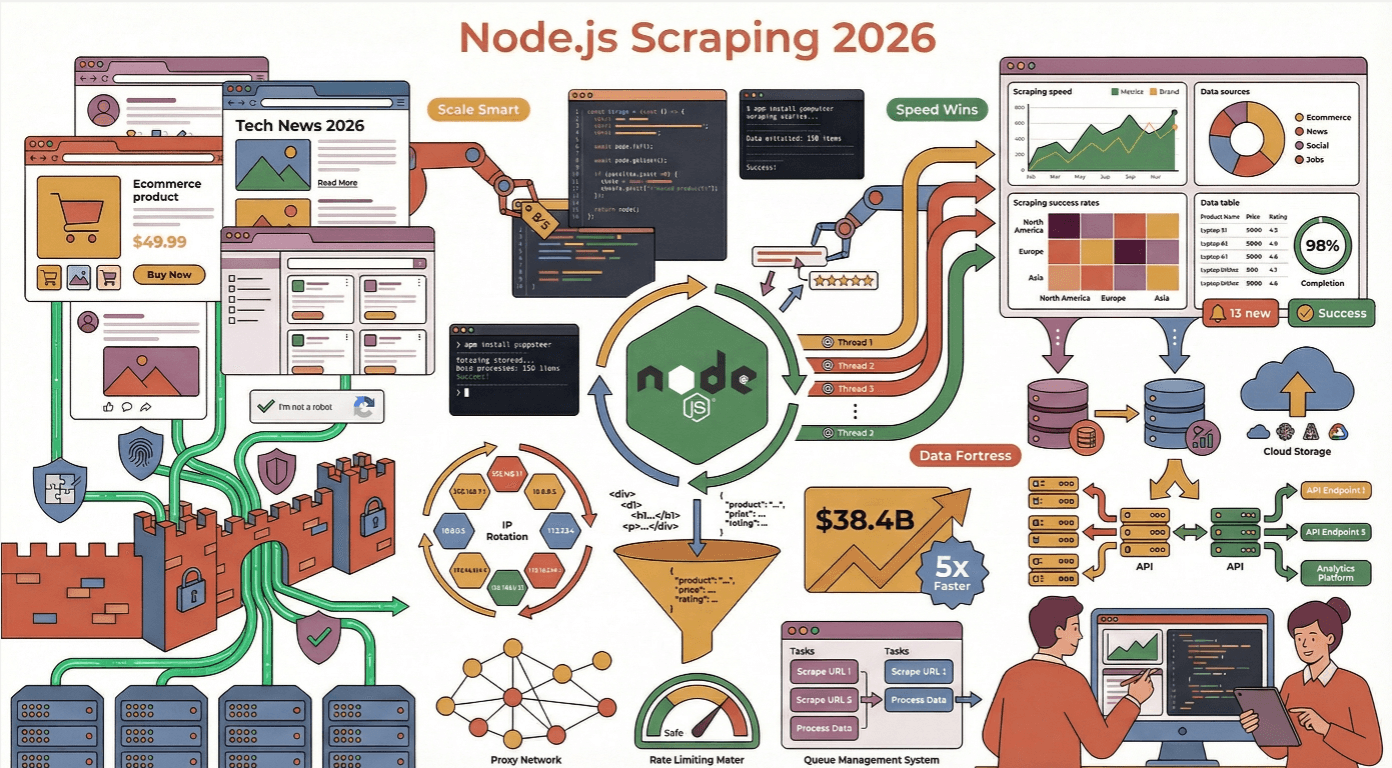
Pero aquí está el reto: la web moderna es una fortaleza de contenido dinámico, trampas anti-bot y diseños que cambian todo el tiempo. He visto caer más scrapers de los que me gustaría admitir — casi siempre porque ignoraron las buenas prácticas o subestimaron lo sofisticadas que se han vuelto las defensas anti-scraping. Así que vamos a repasar las mejores prácticas de verdad para hacer web scraping eficiente con Node.js, con algunas historias, un poco de humor y un montón de consejos prácticos.
¿Por qué elegir Node.js para un web scraping eficiente?
Si alguna vez intentaste extraer cientos (o miles) de páginas a la vez, sabes que la velocidad y la concurrencia lo son todo. Ahí es donde Node.js brilla. Su modelo de E/S asíncrono y no bloqueante está diseñado para manejar enormes volúmenes de solicitudes de red al mismo tiempo: piensa en él como el multitarea definitivo para la web (Node.js Docs). Mientras otros lenguajes se quedan esperando a que termine cada solicitud, Node.js sigue moviendo su event loop, haciendo pasar peticiones como un acróbata de circo con café de sobra.
He visto a Node.js superar a Python y Java en escenarios donde hacen falta actualizaciones en tiempo real y extracción a gran escala, sobre todo cuando los sitios de destino cargan contenido con JavaScript. De hecho, cerca del 40 % de los desarrolladores ya usan Node.js para tareas de backend y automatización, lo que lo convierte en una de las tecnologías web más populares del mundo.
Node.js frente a otros frameworks de web scraping
Vamos a ponernos un poco técnicos por un momento. Así queda Node.js frente a la competencia:
| Framework | Fortalezas | Debilidades | Casos de uso ideales |
|---|---|---|---|
| Node.js | Asíncrono, excelente para concurrencia, enorme ecosistema npm, JS nativo para sitios dinámicos | Puede consumir bastante memoria, callback hell (si no usas async/await) | Scraping en tiempo real, sitios con mucho JavaScript, microservicios escalables |
| Python | Montones de librerías de scraping (BeautifulSoup, Scrapy), sintaxis sencilla | Menos rápido para gran concurrencia, sufre con sitios renderizados con JS | HTML estático, investigación, prototipos |
| Java | Tipado fuerte, robusto para entornos empresariales | Verboso, menos flexible para scripts rápidos | Scraping a gran escala, nivel enterprise |
| Go | Rápido, concurrencia muy eficiente | Ecosistema más pequeño, curva de aprendizaje más alta | Scraping de alto rendimiento y baja latencia |
Para la mayoría de usuarios de negocio, Node.js logra el equilibrio justo: rápido, flexible y perfectamente adaptado a la web moderna basada en JavaScript (Thunderbit Blog).
Cómo preparar un entorno sólido de web scraping con Node.js
Un buen scraper empieza con una base sólida. Esta es mi configuración de referencia:
- Estructura del proyecto: Mantén todo modular. Usa carpetas como
/src,/libsy/config. Guarda la información sensible (claves API, proxies) en variables de entorno condotenv(Thunderbit Guide). - Cliente HTTP: Usa axios, got o node-fetch para hacer solicitudes.
- Análisis de HTML: Cheerio para HTML estático, Puppeteer o Playwright para contenido dinámico.
- Utilidades: Usa Lodash para transformar datos y validator.js o Joi para validar la información.
- Pruebas y linting: Mocha para tests y ESLint para mantener la calidad del código (LogRocket).
Librerías esenciales para web scraping con Node.js
- Clientes HTTP (axios / got /
fetchintegrado): Para hacer solicitudes. Conviene aclararlo desde el principio: desde Node.js v18 ya puedes usarfetchde forma nativa sin instalar nada, y Node.js v22 lo dejó estable. Para un proyecto nuevo en una versión reciente de Node, probablemente no necesites el paquetenode-fetchen absoluto: basta con llamar afetchdirectamente. Yo sigo usando axios cuando quiero interceptores, JSON automático y una API de promesas familiar tanto en Node como en el navegador, y got es la opción que elijo cuando necesito reintentos, streams o HTTP/2 listo para usar. Elige el que encaje con tu stack; para un script rápido,fetchnativo va perfecto. - Cheerio: Analizador HTML rápido, con estilo parecido a jQuery. Perfecto para páginas estáticas: analiza en unos ~0,5 s (Oxylabs).
- Playwright / Puppeteer: Automatización de navegador sin interfaz para sitios dinámicos con mucho JavaScript. Más lento (~4 s por página), pero imprescindible para sitios que cargan contenido después del render inicial (Bright Data). Si empiezas desde cero en 2026, Playwright es la opción por defecto: funciona con varios navegadores desde el inicio (Chromium / Firefox / WebKit), incluye visor de trazas y el equipo que creó originalmente Puppeteer ahora lo impulsa en Microsoft. Puppeteer sigue mantenido para trabajos solo con Chrome, pero sus notas de versión llevan tiempo centradas más en compatibilidad con Chrome que en capacidades nuevas.
- dotenv: Para gestionar variables de entorno.
- csv-writer/jsonfile: Para exportar datos.
Cómo evitar los errores más comunes en el web scraping con Node.js
He perdido la cuenta de cuántas veces he visto scrapers bloqueados, caídos o escupiendo datos desordenados. Esto es lo que debes vigilar:
- Ignorar robots.txt y los Términos de Servicio: Revísalos siempre antes de extraer datos. Incumplirlos puede hacer que bloqueen tu IP, o peor, meterte en problemas legales (ScraperAPI).
- Sobrecargar servidores: No bombardees con solicitudes. Limita el ritmo de tu scraper con retrasos aleatorios (1–3 segundos), usa controles de concurrencia y evita comportarte como un robot hiperactivo (ScrapeGraphAI).
- No manejar errores: Envuelve siempre las solicitudes en try/catch, gestiona los errores HTTP y registra los fallos. Reintenta los errores transitorios con backoff exponencial (ScrapeGraphAI).
- Olvidar los encabezados de solicitud: Usa cadenas de User-Agent realistas y róta las mismas. Añade Accept-Language, Referer y otros encabezados para imitar navegadores reales (ScrapeGraphAI).
Cómo sortear los mecanismos anti-scraping
Los sitios modernos vienen cargados hasta arriba con tecnología anti-bot. Así esquivo yo esas trampas digitales:
- Rotación de proxies/IPs: Usa un grupo de proxies y cambia las IP para evitar bloqueos (Medium).
- Aleatorizar encabezados: Rota User-Agent, Accept-Language y otros encabezados en cada solicitud.
- Sigilo en navegador sin interfaz: Usa plugins como
puppeteer-extra-plugin-stealthpara ocultar huellas de automatización. - Simular comportamiento humano: Añade retrasos aleatorios, movimientos del ratón, desplazamiento e incluso errores al escribir (ZenRows).
Cómo simular comportamiento humano en scrapers con Node.js
Aquí es donde la cosa se pone interesante, y un poco rara. En lugar de hacer clic y desplazarte al instante, programa tu scraper para que:
- Espere intervalos aleatorios entre acciones (
await page.waitForTimeout(randomDelay)) - Mueva el ratón en pequeños incrementos irregulares (
page.mouse.move(x, y)) - Escriba con pausas aleatorias y algún que otro error tipográfico (
page.type(selector, text, {delay: random(100,200)})) - Haga scroll de forma irregular, no solo hasta el final
Estos trucos pueden subir mucho tu tasa de éxito en sitios protegidos (ScraperAPI).
Cómo simplificar la extracción de datos complejos con Thunderbit
Extrae datos de cualquier sitio web usando IA Olvídate del código repetitivo: el scraper web agentic de Thunderbit lee cualquier página y extrae datos con un clic, sin tener que mantener código Node.js. Get Started Free
Ahora hablemos del elefante en la habitación: el scraping es difícil. Pero no tiene por qué serlo. Por eso creamos Thunderbit.
Thunderbit es una extensión de Chrome con un scraper web agentic que te permite extraer datos de cualquier sitio web usando lenguaje natural. Solo tienes que hacer clic en “One Click Extract”, dejar que la IA entienda la página y pulsar “Scrape”. Es como tener un desarrollador junior que nunca duerme y nunca pide aumento.
Y todavía mejor: Thunderbit ofrece una API, así que puedes integrarlo directamente en tus flujos de trabajo con Node.js. En vez de escribir miles de líneas de código de scraping, puedes dejar que Thunderbit se encargue de lo pesado — contenido dinámico, subpáginas, paginación y todo lo demás. Tú solo recuperas los datos estructurados (CSV, JSON o directo a Google Sheets, Airtable o Notion) y sigues con tu día (Thunderbit Blog).
Prueba gratis la extensión de Chrome de Thunderbit Instala la extensión gratuita de Chrome y extrae datos estructurados con un clic, o llama a la API de Thunderbit desde tu app en Node.js. Get Started Free
Thunderbit frente al scraping tradicional con Node.js
| Funcionalidad | Thunderbit | Scraper tradicional en Node.js |
|---|---|---|
| Tiempo de configuración | Minutos (sin código) | Horas o días (programación, pruebas) |
| Gestiona contenido dinámico | Sí (IA + navegador) | Sí (con Puppeteer/Playwright) |
| Subpáginas y paginación | Con 1 clic | Requiere código manual |
| Exportación de datos | Excel, Sheets, Notion, Airtable, CSV, JSON | CSV/JSON (código personalizado) |
| Curva de aprendizaje | Baja (usuarios de negocio) | Alta (desarrolladores) |
| Mantenimiento | Mínimo (la IA se adapta) | Alto (arreglos manuales ante cambios del sitio) |
Thunderbit es ideal para equipos no técnicos o para cualquiera que quiera ahorrarse el trabajo pesado y centrarse en los insights. Para usuarios avanzados, también puedes usar la API de Thunderbit para automatizar el scraping a gran escala (Thunderbit Docs).
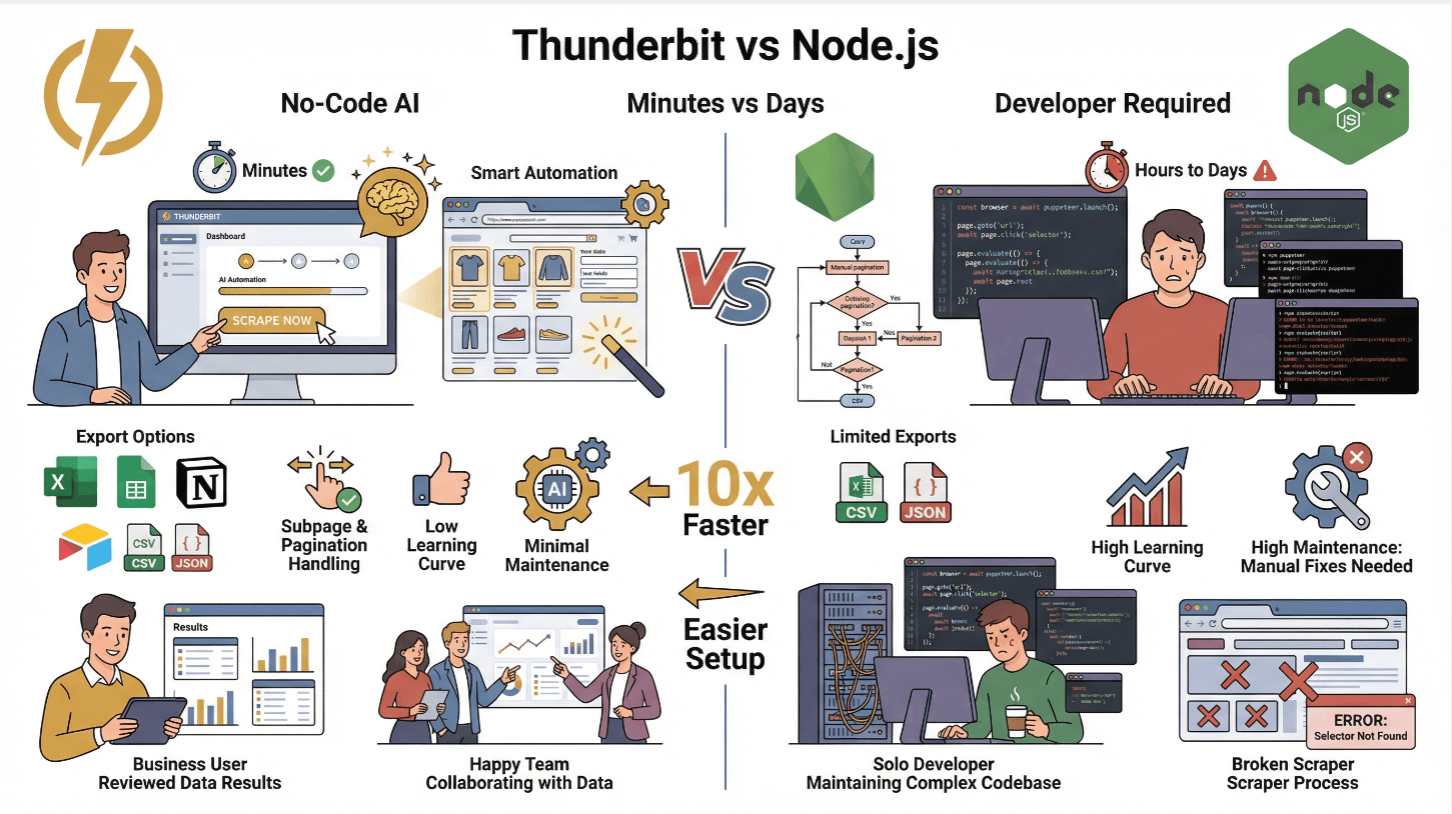
Combinar Cheerio y Puppeteer para contenido dinámico
Esta es mi combinación favorita de potencia en Node.js para scraping. Funciona así:
- Usa Puppeteer para cargar la página y ejecutar JavaScript (espera a
networkidlepara asegurarte de que todo el contenido haya cargado). - Captura el HTML con
await page.content(). - Analiza con Cheerio: pasa el HTML a Cheerio para un análisis y una extracción de datos rapidísimos, con estilo jQuery.
Este enfoque híbrido te da lo mejor de ambos mundos: la potencia de Puppeteer para contenido dinámico y la velocidad de Cheerio para el análisis (Browserless).
Consejo de rendimiento: selecciona solo los elementos que realmente necesitas. Cheerio carga todo el DOM en memoria, así que evita selectores demasiado amplios y guarda en caché los resultados si vas a raspar las mismas páginas una y otra vez (Oxylabs).
Cómo optimizar el análisis HTML y la extracción de datos
- Usa selectores específicos: Evita
$('body *'); apunta solo a lo que necesitas. - Haz streaming de páginas grandes: Para HTML masivo, considera usar streaming o dividir el trabajo.
- Guarda en caché el HTML renderizado: Si vuelves a visitar URLs, almacena el HTML para evitar solicitudes redundantes.
- Valida y limpia los datos: Usa librerías de validación para no llenar tu base de datos con basura (ScrapeGraphAI).
Despliegue escalable de scrapers Node.js en la nube
¿Vas a hacer scraping a gran escala? Es hora de apostar por la nube.
- Conteneriza tu scraper: Crea un
Dockerfile, copia tu código, instala dependencias y define el punto de entrada. - Despliega en la nube: Usa AWS EC2, Google Cloud Compute o Azure VMs para trabajos sencillos. Para una escala seria, usa Kubernetes o servicios gestionados como AWS ECS/EKS, Google Cloud Run o Azure Kubernetes Service (DigitalOcean).
- Orquesta con Kubernetes: Ejecuta múltiples pods, autoescálalos según la demanda y usa balanceadores de carga para repartir las URLs.
- Programa los trabajos: Usa programadores de la nube (CloudWatch Events, Cloud Scheduler) o cron jobs para lanzar extracciones a intervalos.
En un caso real, pasar de 5 a 10 pods de Kubernetes redujo un scraping de 400 páginas de varios minutos a menos de un minuto (DigitalOcean).
Cómo monitorizar y autoescalar tu infraestructura de scraping
- Registro de logs: Envía los logs a CloudWatch, Stackdriver o Datadog. Configura alertas para errores o ralentizaciones.
- Comprobaciones de estado: Usa Prometheus y Grafana para métricas como páginas extraídas por minuto, tasas de error y salud de los pods.
- Autoescalado: Configura Kubernetes HPA (Horizontal Pod Autoscaler) para escalar pods según CPU o número de solicitudes.
Implementa siempre reintentos con backoff exponencial para recuperarte de fallos de red o bloqueos temporales.
Mejores prácticas de almacenamiento y posprocesado de datos
Una vez que hayas extraído los datos, necesitas almacenarlos y limpiarlos:
- Trabajos pequeños: Exporta a CSV, JSON o envíalos a Google Sheets, Airtable o Notion (Thunderbit lo hace de forma nativa).
- Trabajos grandes: Usa SQL (MySQL/PostgreSQL) para datos estructurados, o NoSQL (MongoDB, DynamoDB) para datos semiestructurados o esquemas en evolución (ScrapeHero).
- Almacenamiento en la nube: S3 o Google Cloud Storage para archivos en bruto y copias de seguridad.
- Limpieza de datos: Valida siempre los campos, normaliza formatos (fechas, números) y elimina duplicados. Usa validadores de esquema para garantizar la calidad de los datos (ScrapeGraphAI).
Guarda tanto los datos brutos como los limpios — nunca sabes cuándo tendrás que reprocesar o depurar.
Conclusión: ideas clave para un web scraping eficiente con Node.js
Olvídate del código del scraper Descubre cómo el scraper web agentic de Thunderbit se compara con escribir y mantener tus propios scripts de scraping. Get Started Free
Cerremos con lo esencial:
- Aprovecha el poder asíncrono de Node.js para hacer scraping masivo y concurrente, especialmente en sitios con mucho JavaScript.
- Combina las herramientas adecuadas: Usa axios/got para solicitudes, Cheerio para HTML estático, Puppeteer para contenido dinámico y combínalos para lograr velocidad y flexibilidad.
- Evita las trampas anti-bot: Rota proxies y encabezados, simula comportamiento humano y respeta robots.txt.
- Simplifica con Thunderbit: Para usuarios de negocio o prototipos rápidos, Thunderbit te permite extraer datos complejos con IA e integrarlos en tu stack de Node.js mediante API.
- Despliega a escala: Conteneriza, orquesta con Kubernetes y monitoriza todo para asegurar fiabilidad.
- Almacena y limpia tus datos: Elige el almacenamiento adecuado para tus necesidades y valida siempre antes de usar.
La web no se está volviendo más simple, pero con estas buenas prácticas tus scrapers en Node.js pueden seguir siendo rápidos, fiables y estar siempre un paso por delante de la carrera armamentística anti-bot. Y si alguna vez te cansás de depurar selectores a las 2 de la mañana, recuerda: la IA de Thunderbit nunca duerme.
¿Quieres seguir aprendiendo? Visita el Thunderbit Blog para más análisis en profundidad, o prueba la extensión de Chrome de Thunderbit para ver lo fácil que puede ser el scraping.
Haz scraping con el scraper web agentic de Thunderbit La API de Web Scraper de Thunderbit te permite lanzar extracciones desde tu propio código Node.js, con un plan gratuito para empezar. Get Started Free
Preguntas frecuentes
1. ¿Por qué Node.js es especialmente bueno para el web scraping en 2025?
El modelo asíncrono y orientado a eventos de Node.js le permite manejar miles de solicitudes concurrentes, lo que lo hace ideal para extraer grandes volúmenes de datos o actualizaciones en tiempo real. Su enorme ecosistema npm y su soporte nativo de JavaScript encajan perfecto con sitios web modernos y cargados de JS (Node.js Docs).
2. ¿Cómo puedo evitar que me bloqueen al hacer scraping con Node.js?
Usa proxies rotativos, aleatoriza los encabezados de las solicitudes, limita el ritmo con retrasos aleatorios y simula comportamiento humano (movimiento del ratón, scroll, escritura) con herramientas como Puppeteer. Respeta siempre robots.txt y los términos del sitio (Medium).
3. ¿Cuándo debería usar Cheerio en lugar de Puppeteer en mi scraper de Node.js?
Usa Cheerio para analizar rápido HTML estático cuando los datos ya están en el HTML en bruto. Usa Puppeteer para sitios que cargan contenido dinámicamente con JavaScript. Para mejores resultados, usa Puppeteer para renderizar la página y luego Cheerio para analizar el HTML (Bright Data).
4. ¿Cómo simplifica Thunderbit el web scraping con Node.js?
Thunderbit te permite extraer datos estructurados de cualquier sitio web usando IA y prompts en lenguaje natural, sin necesidad de programar. Gestiona contenido dinámico, subpáginas y paginación, y ofrece una API para integrarlo con Node.js. Los datos se pueden exportar directamente a Excel, Google Sheets, Airtable o Notion (Thunderbit Blog).
5. ¿Cuál es la mejor forma de escalar y monitorizar scrapers de Node.js en la nube?
Conteneriza tu scraper, despliega en Kubernetes o en servicios cloud gestionados y usa autoescalado para absorber picos de demanda. Monitoriza logs y métricas con herramientas como CloudWatch o Prometheus, y configura alertas para errores o ralentizaciones (DigitalOcean).
¿Listo para llevar tu web scraping al siguiente nivel? Prueba Thunderbit y haz que tus scrapers sean rápidos, sigilosos y siempre vayan un paso por delante.
Prueba el scraper web agentic Get Started Free
Más información
- Cómo dominar el web scraping con Node para principiantes: guía paso a paso
- Cómo extraer datos de un sitio web de forma eficiente con las mejores herramientas
- Cómo rastrear un sitio web de forma eficiente: guía paso a paso
- Cómo dominar el rastreo con JavaScript: guía para principiantes
- Cómo dominar el web scraping para comparar precios en 2026




