
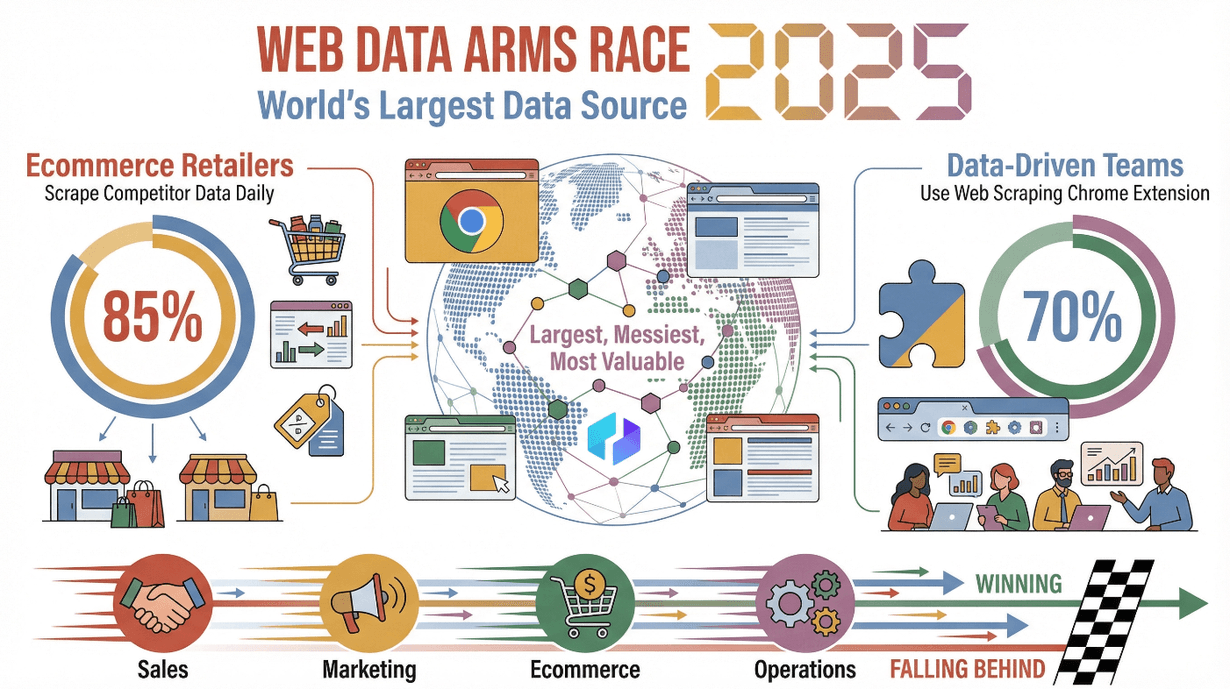
La web ya no es solo el rincón de los videos de gatos y los memes: hoy es la fuente de datos más grande, desordenada y valiosa del mundo. Las empresas están metidas de lleno en una auténtica carrera por los datos: los minoristas revisan cada día los precios de la competencia, y los equipos orientados a datos recurren cada vez más a una extensión del navegador en vez de abrir un ticket al equipo de ingeniería. Ya sea que trabajes en ventas, marketing, ecommerce u operaciones, conseguir los datos correctos rápido y en el formato adecuado puede marcar la diferencia entre ir a la cabeza o quedarse rezagado.
 Pero aquí está el problema: los sitios web no te ponen precisamente la alfombra roja para extraer datos con facilidad. Suelen ser caóticos, dinámicos y están pensados para personas, no para hojas de cálculo. Ahí es donde entran las herramientas de web scraping, que convierten ese desorden en tablas limpias y estructuradas, listas para usar. Llevo años trabajando en SaaS y automatización, y he visto de primera mano cómo elegir la herramienta adecuada puede ahorrarte horas, mejorar la precisión y desbloquear insights que estaban ahí, a simple vista.
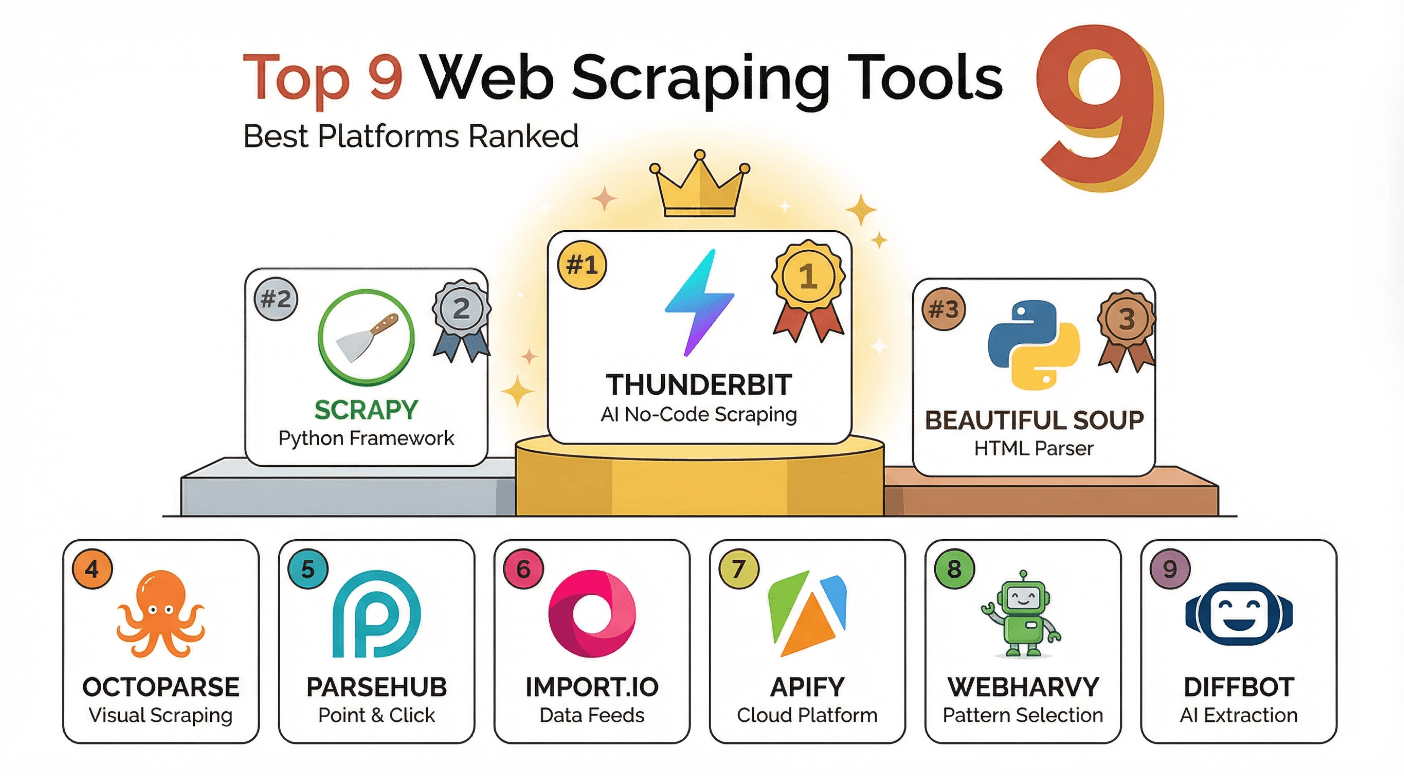
Entonces, ¿qué herramientas de web scraping de verdad valen la pena en 2025? He reunido las nueve mejores: desde extensiones de Chrome con IA para usuarios de negocio hasta frameworks de código abierto para desarrolladores. Vamos a ello.
Por qué las herramientas de web scraping son clave para las empresas modernas
Extrae datos de cualquier sitio web usando IA Get Started Free
Las herramientas de web scraping son el ingrediente secreto detrás de mejores ventas, un marketing más afinado y unas operaciones más ágiles. Estas son algunas razones por las que son tan importantes:
- Generación de leads: los equipos de ventas extraen datos de directorios, LinkedIn y sitios de reseñas para crear listas de prospectos bien segmentadas.
- Análisis de la competencia: marketing y ecommerce vigilan precios, lanzamientos de producto y espacios publicitarios de la competencia, muchas veces en tiempo real.
- Investigación de mercado: investigadores y analistas recopilan reseñas, noticias y opiniones de usuarios para detectar tendencias antes que la competencia.
- Seguimiento de precios: minoristas y marcas controlan precios y stock en cientos de sitios para mantenerse competitivos (Kanhasoft).
- Agregación de contenido: los equipos de operaciones extraen datos de portales de empleo, anuncios inmobiliarios o catálogos de proveedores para agilizar flujos de trabajo.
Aquí tienes una visión rápida de cómo las herramientas de web scraping impulsan resultados de negocio:
| Caso de uso empresarial | Dolor del trabajo manual | Solución con web scraping |
|---|---|---|
| Generación de leads | Copiar y pegar desde decenas de sitios | Extracción automatizada, exportación masiva |
| Seguimiento de precios | Revisiones manuales diarias | Scraping programado, alertas instantáneas |
| Investigación de mercado | Leer cientos de reseñas | Conjuntos de datos estructurados y consolidados |
| Agregación de contenido | Unir datos de múltiples sitios | Exportación unificada a Excel/Sheets |
| Análisis de la competencia | Datos lentos e incompletos | Insights completos y en tiempo real |
El retorno de la inversión es real: los equipos que adoptan herramientas modernas de scraping pasan la investigación y la recopilación de datos de días a horas, y los equipos comerciales suelen usar los datos extraídos para personalizar sus propuestas.
Cómo elegimos las mejores herramientas de web scraping
No todas las herramientas de web scraping son iguales. Algunas están pensadas para usuarios de negocio que quieren resultados sin escribir código; otras son un terreno de juego para desarrolladores que crean proyectos personalizados a gran escala. Esto es lo que busqué al seleccionar las mejores:
- Facilidad de uso: ¿los usuarios sin conocimientos técnicos pueden sacar valor rápido? ¿La interfaz es intuitiva?
- Escalabilidad: ¿puede manejar cientos o millones de páginas? ¿Permite automatizar y programar tareas?
- Opciones de exportación de datos: ¿exporta a Excel, Google Sheets, Airtable, Notion o mediante API?
- Soporte y comunidad: ¿hay buena documentación, tutoriales y soporte ágil?
- Precio y valor: ¿tiene plan gratuito? ¿Los planes de pago son transparentes y justos?
- Funciones únicas: extracción con IA, scraping de subpáginas, integración con API o flujos visuales.
También he asociado cada herramienta al caso de uso empresarial que mejor le encaja, para que encuentres la que de verdad se adapta a tus necesidades y a tu nivel técnico.
1. Thunderbit
Thunderbit es mi opción favorita para usuarios de negocio que quieren scraping con IA sin líos técnicos. Como extensión de Chrome, Thunderbit está pensada para equipos de ventas, marketing, ecommerce y operaciones que necesitan datos precisos y estructurados, y los necesitan rápido.
¿Qué hace diferente a Thunderbit? Todo gira en torno a la sencillez y la potencia:
- Sugerencia de campos impulsada por IA: haz clic en “AI Suggest Fields” y Thunderbit leerá la página, recomendará columnas como Nombre, Precio o Email, e incluso creará prompts de extracción para cada campo.
- Scraping de subpáginas: ¿necesitas más detalle? La IA de Thunderbit puede entrar en cada subpágina, como fichas de producto o perfiles, y enriquecer tu tabla sin configuración extra.
- Exportación instantánea: envía tus datos directamente a Excel, Google Sheets, Airtable o Notion. La exportación siempre es gratuita.
- Scraping programado: automatiza tareas recurrentes, como revisiones diarias de precios, con programación en lenguaje natural.
- Extractores gratuitos de email, teléfono e imágenes: extrae información de contacto o imágenes de cualquier sitio con un solo clic.
- AI Autofill: deja que la IA rellene formularios online por ti; ideal para flujos de trabajo y tareas repetitivas.
Thunderbit cuenta con la confianza de más de 200,000 usuarios en todo el mundo, y el plan gratuito permite extraer hasta 6 páginas al mes. Los planes de pago empiezan en solo 15 USD al mes por 500 créditos, ideal para equipos de cualquier tamaño.
Si quieres ver Thunderbit en acción, visita nuestro canal de YouTube o explora nuestro blog para tutoriales y consejos.
2. Scrapy
Scrapy es el framework de código abierto de referencia para desarrolladores que quieren control total sobre sus proyectos de web scraping. Escrito en Python, Scrapy permite crear spiders personalizados que rastrean, extraen y procesan datos a escala.
¿Por qué los desarrolladores adoran Scrapy?
- Framework potente: admite crawling complejo y multinivel, pipelines personalizados e integración con APIs.
- Escalable: maneja proyectos de gran tamaño, solicitudes concurrentes y puede extraer muchas páginas al mismo tiempo (ZenRows).
- Extensible: incorpora middleware para proxies, user agents o renderizado de JavaScript (con Splash).
- Comunidad activa: abundan los tutoriales, plugins y soporte para casos de uso avanzados.
Scrapy es ideal para equipos con conocimientos de Python que necesitan extraer datos a gran escala, integrarlos en pipelines o construir flujos de trabajo robustos y repetibles. Es gratuito y de código abierto, pero tendrás que montar y mantener tu propio entorno.
3. Beautiful Soup
Beautiful Soup es una biblioteca de Python muy valorada por quienes empiezan, por lo sencilla que es y por su potencia al analizar HTML y XML. Si necesitas extraer datos rápidamente de páginas web estáticas, Beautiful Soup es tu aliada.
¿Por qué elegir Beautiful Soup?
- Amigable para principiantes: fácil de aprender, con una curva de aprendizaje suave y muchos tutoriales (ScraperAPI).
- Análisis flexible: maneja HTML desordenado o roto con soltura.
- Ideal para proyectos pequeños: perfecta para scripts puntuales, extracciones rápidas o para aprender lo básico del web scraping.
¿Sus limitaciones? Beautiful Soup no está pensada para sitios dinámicos o de gran escala, y no maneja JavaScript. Para esos casos, conviene combinarla con requests o Selenium, o dar el salto a Scrapy.
4. Octoparse
Octoparse es una herramienta de web scraping sin código diseñada para todo el mundo, desde emprendedores independientes hasta equipos empresariales. Su interfaz de apuntar y hacer clic facilita extraer datos incluso de sitios complejos o dinámicos.
Por qué a los usuarios les gusta Octoparse:
- No requiere programar: constructor visual de flujos, selectores de arrastrar y soltar y plantillas preconfiguradas.
- Modo local y en la nube: ejecuta las extracciones en tu ordenador o en la nube para trabajos más rápidos y grandes.
- Gestiona paginación y contenido dinámico: extrae páginas con “cargar más”, scroll infinito y sitios AJAX.
- Opciones de exportación: descarga en CSV, Excel, JSON, HTML o exporta a bases de datos (Octoparse Pricing).
El plan gratuito de Octoparse cubre trabajos pequeños, mientras que los planes de pago empiezan alrededor de 69 USD al mes para usos más intensivos. Es una de las favoritas para investigación de mercado, análisis competitivo y cualquiera que quiera resultados sin código.
5. ParseHub
ParseHub es una herramienta visual de scraping que destaca en sitios con mucho JavaScript y contenido dinámico. Su constructor de flujos te permite hacer clic, iterar y extraer datos de forma condicional, incluso en sitios complicados.
Funciones destacadas de ParseHub:
- Selección visual de datos: haz clic en los elementos para seleccionarlos, recorre listas y gestiona páginas anidadas.
- Compatible con contenido dinámico: extrae datos cargados por JavaScript, maneja desplegables y automatiza clics.
- Exportación flexible: descarga en CSV, Excel, JSON o integra con Dropbox/Amazon S3 (Salesforge).
- Plan gratuito: hasta 5 proyectos y 200 páginas por ejecución; los planes de pago desbloquean más capacidad.
ParseHub es ideal para usuarios intermedios que quieren flexibilidad sin meterse de lleno en el código. Es especialmente popular para scraping de ecommerce, portales de empleo e inmobiliarias.
6. Import.io
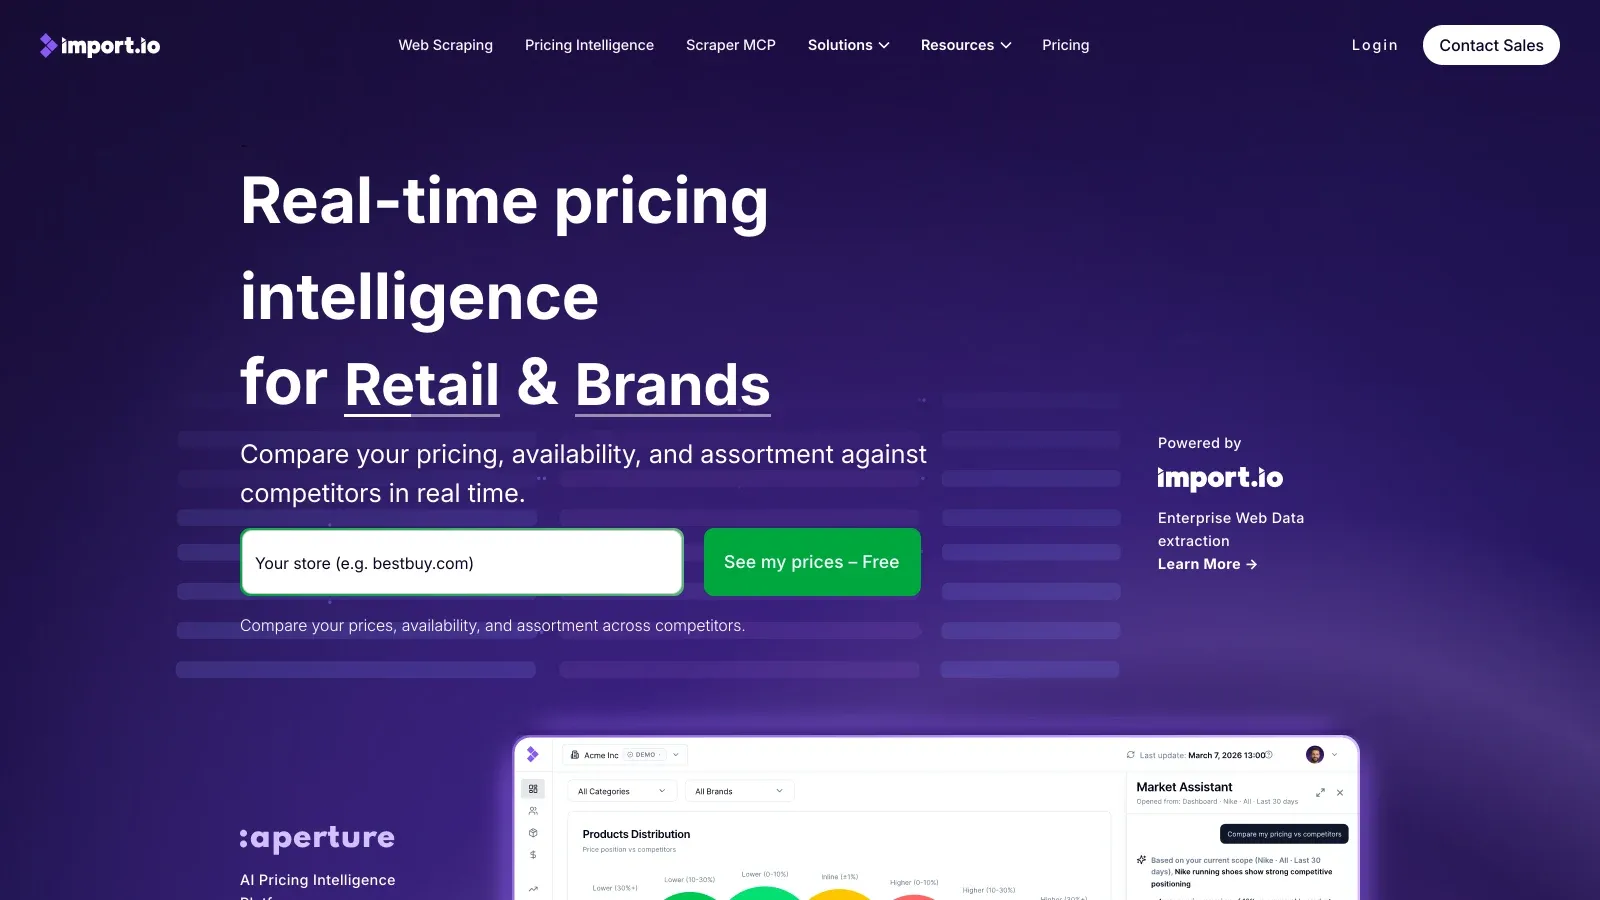
Import.io está diseñada para extracción y visualización de datos a nivel empresarial. Con foco en proyectos de gran escala, Import.io ofrece una interfaz intuitiva, soporte sólido y analítica avanzada.
¿Qué la hace destacar?
- Extracción con apuntar y hacer clic: no hace falta programar; solo selecciona los datos que quieres.
- Visualización de datos: herramientas integradas para analizar, crear gráficos y compartir resultados.
- Funciones empresariales: cumplimiento normativo, servicios gestionados y soporte para grandes volúmenes.
- Exportación e integración: descarga en CSV, Excel o intégrala con Google Sheets y herramientas de BI (Salesforge).
El precio está adaptado a equipos empresariales, así que encaja mejor con organizaciones que tienen grandes necesidades de datos y un presupuesto acorde.
7. Apify

Apify es una plataforma para automatización web escalable y extracción de datos personalizada. Es una de las favoritas de los desarrolladores para crear, ejecutar y compartir “actors” de scraping, ya sean predefinidos o propios.
Por qué Apify es una gran elección:
- Marketplace de actors: accede a más de 200 scrapers ya hechos para sitios comunes o crea los tuyos en JavaScript/Python.
- API-first: integra los datos extraídos directamente en tus flujos o aplicaciones.
- Despliegue en la nube: ejecuta tareas a escala, programa trabajos recurrentes y gestiona todo desde un panel (Apify Pricing).
- Precio flexible: plan gratuito para trabajos pequeños; pago por uso para proyectos mayores.
Apify es perfecta para equipos con perfil técnico que quieren automatizar, escalar e integrar datos web en sus procesos de negocio.
8. WebHarvy
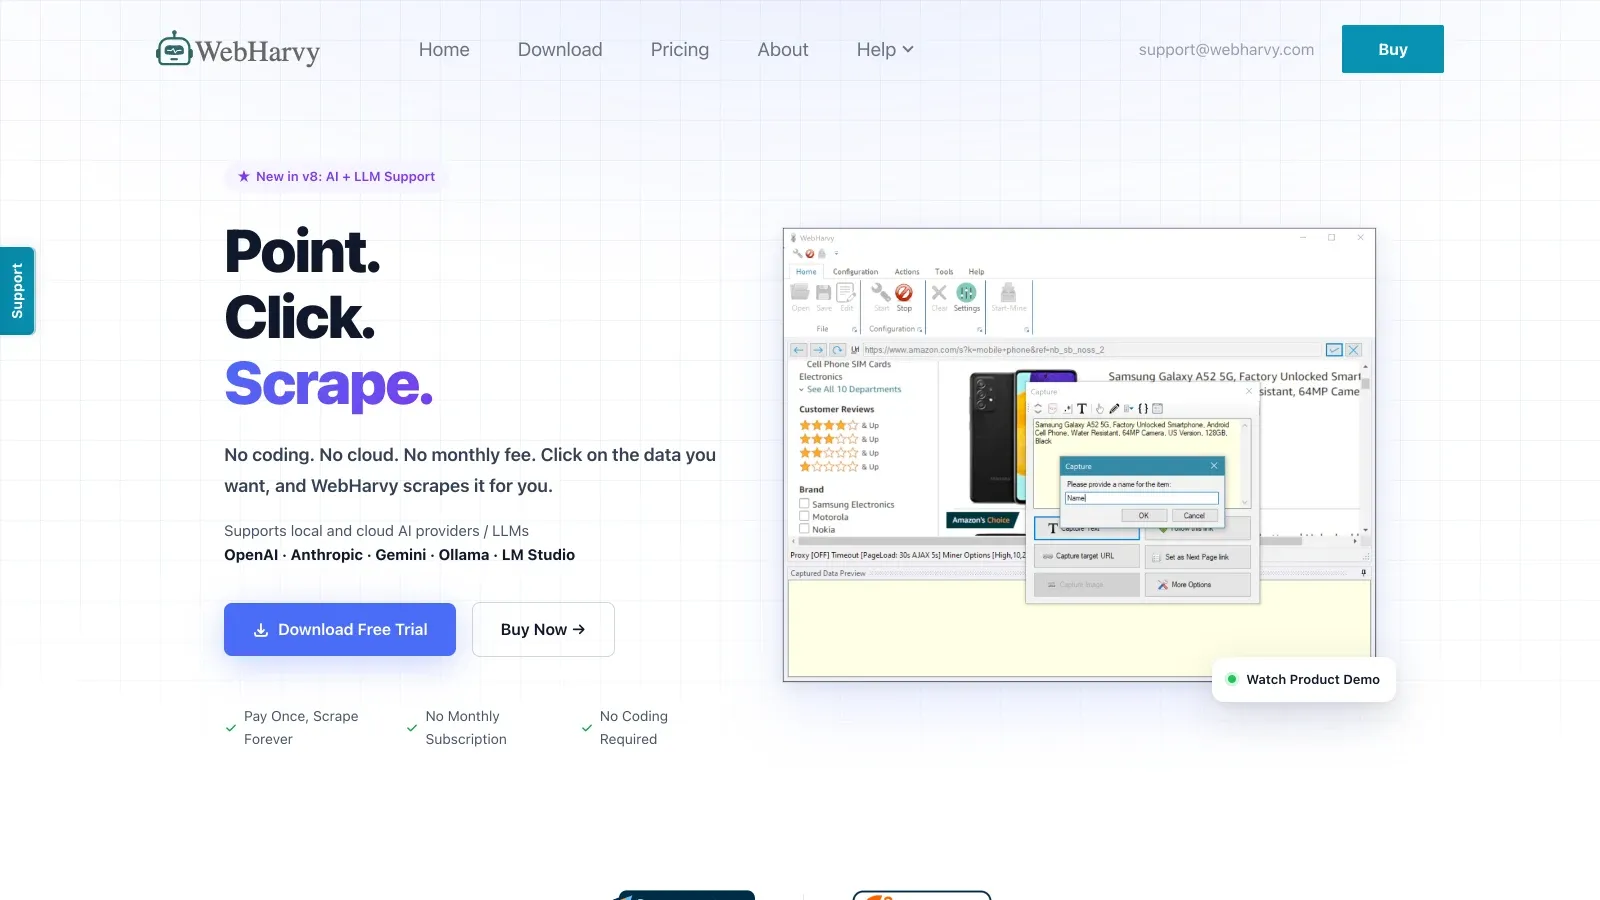
WebHarvy es una herramienta de web scraping de apuntar y hacer clic que detecta automáticamente patrones de datos en las páginas. Está pensada para personas sin conocimientos técnicos que quieren resultados sin aprender XPath ni selectores CSS.
Características clave de WebHarvy:
- Detección automática de patrones: haz clic en un campo de datos y WebHarvy encuentra elementos similares por ti (Thunderbit Blog).
- Compatible con AJAX/JavaScript: gestiona contenido dinámico, extracción de imágenes y extracción basada en palabras clave.
- Opciones de exportación: descarga en Excel, CSV, XML, JSON o SQL.
- Licencia única: pagas una vez y lo usas para siempre, con un año de actualizaciones y soporte.
WebHarvy es una opción popular entre pequeñas empresas, investigadores y emprendedores individuales que prefieren un enfoque visual y no necesitan automatización avanzada.
9. Diffbot
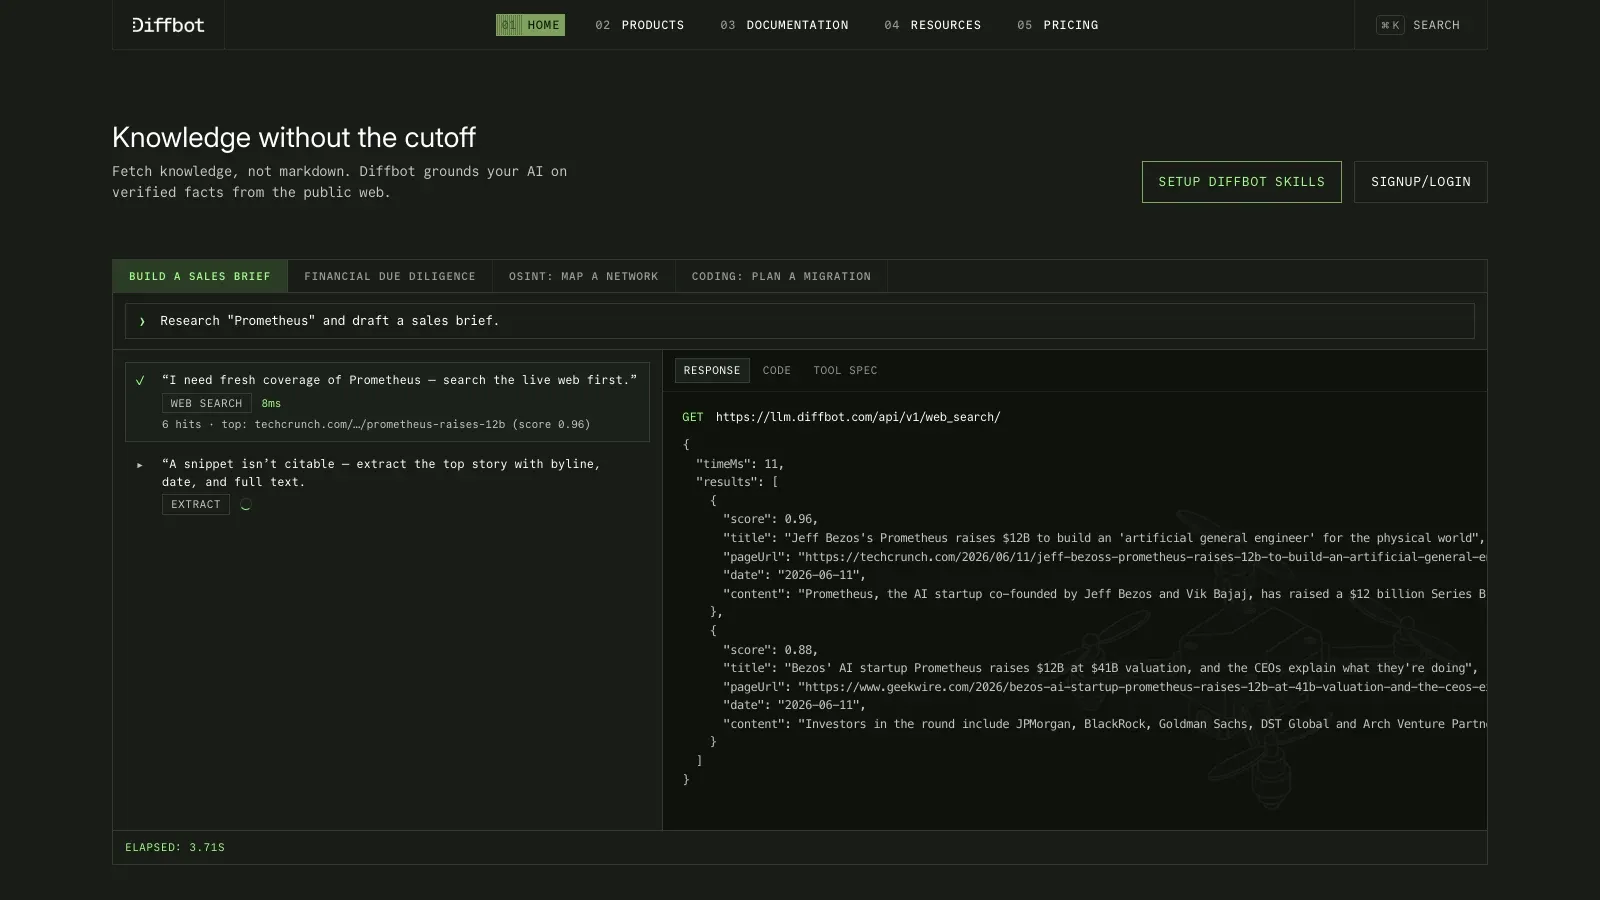
Diffbot es una potencia de IA para la extracción de datos web. Gracias al machine learning y la visión por computadora, Diffbot convierte cualquier página pública en datos estructurados sin necesidad de configuración manual.
¿Qué hace único a Diffbot?
- Extracción impulsada por IA: identifica y extrae automáticamente entidades, relaciones y hechos de las páginas web (VentureBeat).
- Knowledge Graph: acceso a una base de datos masiva y continuamente actualizada de personas, empresas, productos y más.
- Acceso por API: integra datos estructurados en tus apps, investigaciones o flujos de analítica (Diffbot Docs).
- Listo para empresas: lo usan Microsoft, Adobe, Hubspot y otros grandes actores.
Los precios comienzan en 299 USD al mes para startups, con opciones de pago por llamada para acceso a la API (Diffbot Pricing). Es ideal para investigación, data science empresarial y cualquiera que necesite precisión de nivel IA a gran escala.
Tabla comparativa de herramientas de web scraping
Aquí tienes una comparación lado a lado de las nueve herramientas:
| Herramienta | Ideal para | Sin código | Con IA | Compatible con API/Dev | Scraping de subpáginas | Opciones de exportación | Precio inicial |
|---|---|---|---|---|---|---|---|
| Thunderbit | Usuarios de negocio | Sí | Sí | No | Sí | Excel, CSV, Sheets, Notion, Airtable | Gratis (6 páginas), 15 USD/mes |
| Scrapy | Desarrolladores | No | No | Sí | Sí (personalizado) | CSV, JSON, XML, DB | Gratis, código abierto |
| Beautiful Soup | Principiantes, devs | No | No | Sí | No | Personalizado (vía Python) | Gratis, código abierto |
| Octoparse | No-coders, equipos | Sí | No | Algo | Sí | CSV, Excel, JSON, DB | Gratis, 69 USD/mes |
| ParseHub | Sitios visuales y dinámicos | Sí | No | Algo | Sí | CSV, Excel, JSON, S3, Dropbox | Gratis, 189 USD/mes |
| Import.io | Empresa, analítica | Sí | No | Sí | Sí | CSV, Excel, Sheets, BI tools | Personalizado, empresarial |
| Apify | Devs, automatización | No | No | Sí | Sí | CSV, JSON, Sheets, API | Gratis, pago por uso |
| WebHarvy | No-coders, pymes | Sí | No | No | Sí | Excel, CSV, XML, JSON, SQL | 129 USD (pago único) |
| Diffbot | IA, investigación, empresa | No | Sí | Sí | Sí (AI crawl) | JSON, Knowledge Graph API | 299 USD/mes |
Cómo elegir la herramienta de web scraping adecuada para ti
Las mejores herramientas y software de web scraping en 2025 Get Started Free
Entonces, ¿qué herramienta deberías elegir? Aquí va mi guía rápida:
- Para usuarios sin conocimientos técnicos o de negocio: Thunderbit, Octoparse, ParseHub, WebHarvy
- Para desarrolladores y automatización: Scrapy, Beautiful Soup, Apify
- Para necesidades empresariales o de IA: Import.io, Diffbot
- Para sitios dinámicos o con mucho JavaScript: ParseHub, Octoparse, Apify
- Para exportaciones instantáneas y estructuradas: Thunderbit, Import.io
Mi consejo: empieza por tu objetivo de negocio y tu nivel técnico. Si quieres scraping con IA, sin complicaciones y con exportación instantánea, Thunderbit es muy difícil de superar. Si necesitas control total o quieres construir crawlers personalizados, Scrapy o Apify son opciones fantásticas. Para datos a escala empresarial o impulsados por IA, Import.io y Diffbot son los pesos pesados.
La mayoría de las herramientas ofrecen pruebas o planes gratuitos, así que no tengas miedo de probar y ver cuál encaja mejor con tu flujo de trabajo.
Extrae datos con Thunderbit AI
Preguntas frecuentes
1. ¿Qué es una herramienta de web scraping y por qué la necesito?
Una herramienta de web scraping es un software que extrae datos de sitios web y los convierte en formatos estructurados como hojas de cálculo o bases de datos. Las empresas las usan para generar leads, hacer seguimiento de precios, investigación de mercado y mucho más, ahorrando tiempo y mejorando la precisión frente al copiar y pegar manual.
2. ¿Es legal hacer web scraping?
El web scraping es legal cuando extraes datos públicos y respetas los términos de servicio del sitio web. Evita siempre extraer información personal o sensible sin consentimiento y revisa la normativa local.
3. ¿Cuál es la mejor herramienta de web scraping para personas sin conocimientos técnicos?
Thunderbit, Octoparse, ParseHub y WebHarvy son excelentes para usuarios no técnicos. Thunderbit destaca por su sugerencia de campos con IA y su exportación instantánea a Excel, Google Sheets, Notion o Airtable.
4. ¿Puedo extraer datos de sitios dinámicos o con mucho JavaScript?
¡Sí! Herramientas como ParseHub, Octoparse y Apify están diseñadas para manejar contenido dinámico, AJAX y páginas con “cargar más”. La IA de Thunderbit también se adapta a muchos diseños web modernos.
5. ¿Cómo elijo la herramienta de web scraping adecuada para mi negocio?
Ten en cuenta tus habilidades técnicas, el volumen de datos, las necesidades de exportación y tu presupuesto. Quienes no programan pueden empezar con Thunderbit u Octoparse; los desarrolladores quizá prefieran Scrapy o Apify; y las empresas con grandes necesidades de datos pueden mirar Import.io o Diffbot. La mayoría ofrece pruebas gratuitas: prueba varias y descubre cuál funciona mejor.
¿Listo para convertir la web en tu próxima ventaja competitiva? Descarga Thunderbit o explora nuestro Thunderbit Blog para más guías y consejos. ¡Feliz scraping!
Prueba AI Web Scraper Get Started Free
Más información
- Las 10 mejores herramientas automatizadas de web scraping en 2025
- 15 mejores herramientas de extracción de datos en 2025
- Las 6 herramientas esenciales de web scraper para triunfar en 2025
- Cómo extraer datos de sitios web de forma eficiente con las mejores herramientas
- Las mejores herramientas y software de web scraping en 2025



