
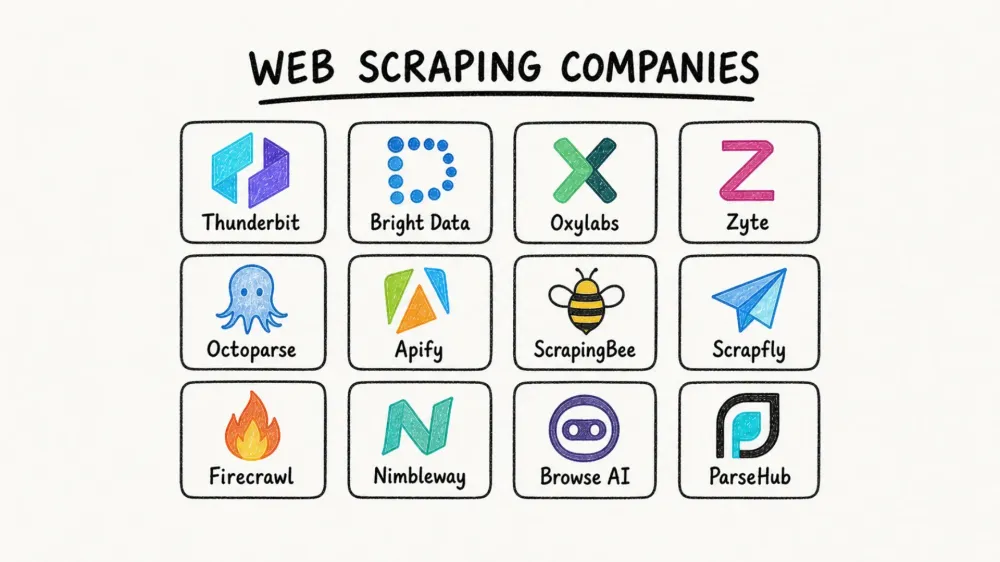
El mercado de web scraping alcanzó los 754 millones de dólares en 2024 y apunta a llegar a 2.87 mil millones en 2034. Aun así, la mayoría de los compradores sigue eligiendo al proveedor equivocado en el primer intento.
Ese desajuste no sorprende. "Empresa de web scraping" es un término paraguas que va desde una extensión de Chrome que instalas en diez segundos hasta una canalización de datos empresarial de varios millones de dólares. Si a eso le sumas páginas de precios poco claras, scrapers que se rompen sin parar —un usuario de Reddit reportó que entre el 10 y el 15% de los scrapers fallan cada semana— y cientos de proveedores que aseguran que "extraen datos de cualquier sitio", la confusión tiene sentido.
Trabajo en el equipo del sitio web oficial de Thunderbit, así que veo de primera mano las preguntas que hacen los compradores antes de decidirse —y la frustración que arrastran de herramientas anteriores que dejaron de funcionar en cuanto el sitio objetivo cambió su diseño. Esta guía es el recurso que me habría encantado tener cuando empecé a investigar este sector: 12 empresas, tres categorías bien diferenciadas, precios reales de 2026, una tabla comparativa unificada y un marco de decisión que de verdad ayuda a elegir.
Por qué importa elegir bien una empresa de web scraping en 2026
El web scraping ya no es un proyecto secundario para desarrolladores. Es una fuente de datos para inteligencia de precios, generación de leads, investigación de mercado, agregación de contenidos y, cada vez más, pipelines de IA y LLM. Market.us atribuye el 25.8% del mercado de web scraping solo al monitoreo de precios y la tarificación dinámica. Mordor Intelligence sitúa el mercado de 2026 en 1.17 mil millones de dólares, con un crecimiento del monitoreo de precios y de la competencia del 19.23% CAGR. Ambas firmas definen la categoría de forma distinta, por eso sus cifras no coinciden; tómelas como una referencia aproximada del tamaño del mercado, no como un dato exacto.
El retorno es medible. Los casos de estudio de proveedores lo dejan claro: Zyte reporta un ahorro del 25% en tiempo de desarrollo por spider para un minorista global. Un caso de generación de leads con Apify cita más de 40 horas de trabajo manual eliminadas por ciclo de campaña.
Pero los problemas también son constantes:
- Los scrapers se rompen todo el tiempo cuando los sitios cambian de diseño o añaden capas anti-bot.
- Los precios se vuelven impredecibles a escala, especialmente con modelos basados en uso.
- Muchas herramientas siguen asumiendo tiempo de desarrollo que la mayoría de los equipos de negocio simplemente no tiene.
Elegir la categoría equivocada —no solo el proveedor equivocado— es el error más caro. Un equipo comercial que se registra en una API pensada para desarrolladores puede perder semanas antes de darse cuenta de que necesitaba una herramienta sin código. Un equipo de ingeniería que elige un constructor visual puede chocar con límites de volumen en menos de un mes. Primero se decide la categoría. Después, el proveedor.
Tres tipos de empresas de web scraping (y por qué importa)
Antes de evaluar proveedores concretos, hay que entender los tres modelos operativos que se esconden detrás de la etiqueta única de "empresa de web scraping". Confundirlos es la principal causa de arrepentimiento entre compradores.
| Categoría | Qué obtienes | Ideal para | Ejemplos de esta lista |
|---|---|---|---|
| Servicio completo / scraping gestionado | Ellos construyen y mantienen los scrapers por ti; tú recibes datos limpios y estructurados | Equipos sin recursos técnicos o con objetivos complejos y de gran volumen | Bright Data (datasets), Zyte, Nimbleway |
| APIs e infraestructura de scraping | Tú llamas a una API; ellos gestionan proxies, renderizado y anti-bot | Desarrolladores que quieren control, pero no administrar infraestructura | ScrapingBee, Scrapfly, Oxylabs, Firecrawl, Apify |
| Herramientas sin código / basadas en navegador | Interfaz de apuntar y hacer clic; poca o ninguna programación | Usuarios de negocio en ventas, e-commerce, marketing, inmobiliaria | Thunderbit, Octoparse, Browse AI, ParseHub |
Empresas de web scraping de servicio completo / gestionado
Estos proveedores controlan todo el flujo. Tú defines qué datos necesitas; ellos se encargan de la extracción, anti-bot, renderizado, mantenimiento y entrega. La contrapartida es simple: menos trabajo de mantenimiento, pero más coste. Si tu equipo no tiene margen de desarrollo y necesita datos de objetivos muy protegidos a gran escala, esta es la categoría por la que conviene empezar.
Proveedores de APIs e infraestructura de scraping
Envías una URL o una tarea a un endpoint. Ellos devuelven HTML renderizado, datos estructurados o capturas de pantalla, mientras gestionan proxies, renderizado del navegador, reintentos y resolución de CAPTCHA por detrás. Tú sigues siendo dueño del código de integración, la lógica de parsing y los flujos posteriores. La contrapartida: coste medio, mantenimiento medio-alto y control total sobre la canalización.
Herramientas de web scraping sin código / basadas en navegador
Estas herramientas están pensadas para operadores, no para ingenieros. La mayoría usan una extensión de navegador, un constructor visual de flujos o una interfaz guiada por IA para producir datos estructurados rápidamente. La contrapartida: arrancas muy rápido, pero los límites de volumen suelen ser más bajos que en los proveedores centrados en API.
Thunderbit encaja de lleno en esta tercera categoría. Abres una página, haces un clic y la IA detecta qué extraer y completa la tabla sin más instrucciones. La idea es llevar a un comercial o a un analista de e-commerce de la página a la hoja de cálculo en un par de minutos, con exportación gratuita a Excel, Google Sheets, Airtable y Notion.
Prueba el Raspador Web con IA de Thunderbit
Cómo evaluamos las mejores empresas de web scraping
Aplicamos los mismos siete criterios a los 12 proveedores.
| Criterio | Por qué importa |
|---|---|
| Tipo de empresa (servicio completo / API / sin código / extensión) | Define quién hace realmente el trabajo |
| Gestión anti-bot y de proxies | El principal dolor técnico: que te bloqueen suele costar más tiempo que escribir el parser |
| Carga de mantenimiento | Los scrapers se rompen; la pregunta clave es quién los arregla |
| Precios transparentes (coste real del plan 2026, plan gratuito) | "Contacta con ventas" no es una respuesta |
| Facilidad para usuarios sin código | Una gran parte de los compradores no son técnicos |
| Formatos de exportación e integraciones | La compatibilidad de salida determina todo el flujo posterior |
| Etiqueta de mejor uso | Ayuda a encajar rápidamente el proveedor con el caso de uso |
Estos criterios se relacionan directamente con lo que la gente se queja en comunidades públicas. En Hacker News, una discusión de 2025 sostenía que las APIs son contratos, mientras que el scraping es inherentemente frágil. En GitHub, un issue de Firecrawl titulado "All scraping engines failed!" recordó que incluso las herramientas modernas pensadas para IA siguen encontrando casos límite.
1. Thunderbit
 Thunderbit es una extensión de Chrome con IA, creada para usuarios no técnicos que necesitan datos estructurados desde sitios web, PDFs e imágenes sin programar ni gestionar selectores.
Categoría: Herramienta sin código / basada en navegador con API opcional
Flujo principal: Abres cualquier página → haces un clic → la IA identifica qué campos extraer y genera la tabla final por su cuenta. Si quieres campos concretos, lo dices en lenguaje natural y usa esos. Para la mayoría de tareas, ese es todo el proceso.
Funciones clave:
- Detección automática de campos: identifica las columnas de datos en la página y las extrae sin que tengas que configurar nada.
- Extracción de subpáginas: visita cada página de detalle y enriquece la tabla principal, sin configuración manual.
- Extracción programada: describes el intervalo en lenguaje natural; el sistema se ejecuta en la nube según lo programado.
- Modo navegador vs. nube: usa el modo navegador para páginas con inicio de sesión; el modo nube para más velocidad (50 páginas a la vez).
- Extractores gratuitos de email, teléfono e imágenes: útiles para flujos de generación de leads sin herramientas adicionales.
- Exportación gratuita: Excel, Google Sheets, Airtable, Notion, CSV, JSON, sin recargo por exportación.
Anti-bot y mantenimiento: La IA relee cada página desde cero en cada extracción, adaptándose automáticamente a cambios de diseño. Esto elimina el vector de rotura más común para usuarios de negocio que extraen datos de sitios variados y de larga cola. No significa cero mantenimiento —nada lo es—, pero ataca el fallo que más frustra a los equipos no técnicos.
Precio: Plan gratuito (6 páginas al mes), más una prueba de 7 días de las funciones Pro. Starter a $15/mes, o $9/mes con facturación anual. Pro a $38/mes, o $24/mes con facturación anual. Business es personalizado. La API Web Scraper de Thunderbit se factura por separado, desde $29/mes ($16/mes con facturación anual), con 600 unidades gratuitas al inicio. Los créditos se calculan por fila de salida: 1 por fila, 2 cuando la fila proviene de una subpágina y 30 por cada consulta de enriquecimiento de datos personales. Consulta Precios de Thunderbit para ver la información actual.
Opción para desarrolladores: Thunderbit Open API incluye un endpoint Distill (página web → Markdown) y un endpoint Extract (página web → JSON estructurado mediante esquema).
Ideal para: Equipos de ventas (generación de leads desde directorios), operaciones de e-commerce (monitoreo de precios, scraping de SKUs de la competencia), agentes inmobiliarios (datos de anuncios) y marketers u operadores que necesitan datos web estructurados sin ayuda de ingeniería.
Limitaciones: No es la mejor opción para monitorización de SERP empresarial de más de 100K páginas, ni para sitios con protección anti-bot fuerte —para eso están los proveedores de proxies y API de esta lista. El límite de volumen es más bajo que el de los proveedores de infraestructura API dedicados.
2. Bright Data
 Bright Data es una de las plataformas de datos web más amplias del mundo, ya que combina una enorme red de proxies, APIs de scraping, un Web Scraper IDE y datasets preconstruidos.
Categoría: Híbrida: servicio gestionado + infraestructura API
Funciones clave:
- Red de proxies de más de 400M IP (residenciales, datacenter, móviles, ISP)
- Web Scraper API, Web Unlocker, IDE de scraping basado en navegador
- Más de 350 datasets y más de 437 scrapers preconstruidos
- Infraestructura empresarial de entrega y cumplimiento
Anti-bot y mantenimiento: Gestiona Cloudflare, CAPTCHAs y renderizado JS a gran escala. Los datasets gestionados absorben el mantenimiento por completo.
Precio: Web Scraper API desde $1.5 / 1K registros en pago por uso, plan Scale a $499/mes. Los costes de proxies pueden dispararse con el volumen, así que hay que vigilar el presupuesto con cuidado.
Ideal para: Grandes empresas con necesidades complejas de scraping de alto volumen y presupuesto acorde.
Limitaciones: Curva de aprendizaje pronunciada para usuarios no técnicos. Complejidad de precios y posibles picos de coste al escalar.
3. Oxylabs
 Oxylabs es un proveedor premium de proxies e infraestructura de scraping con una de las mayores reservas de IP del sector.
Categoría: API de scraping + infraestructura de proxies
Funciones clave:
- Proxies residenciales y de datacenter con geolocalización avanzada
- Web Scraper API, SERP Scraper API, E-commerce Scraper API
- AI Web Scraping API / OxyCopilot para mejorar el parsing
- Prueba gratuita de hasta 2,000 resultados
Anti-bot y mantenimiento: Desbloqueo robusto para scraping de gran volumen e intensivo en IP. Muy sólido para extracción recurrente a escala.
Precio: Web Scraper API desde $49/mes. Los paquetes de proxy y los complementos de pool de IP pueden aumentar el coste total.
Ideal para: Equipos de desarrollo que necesitan infraestructura de proxies fiable para extracción recurrente de datos a gran escala, especialmente SERP e inteligencia de productos.
Limitaciones: No existe una ruta real sin código para usuarios de negocio. El coste total sube cuando se acumulan proxies y casos de uso avanzados.
4. Zyte
 Zyte fue fundada por los creadores del framework open source Scrapy y combina APIs de scraping asistidas por IA con alojamiento en Scrapy Cloud y servicios de extracción gestionada.
Categoría: Híbrida: API + servicio gestionado
Funciones clave:
- Zyte API con extracción automática asistida por IA
- Scrapy Cloud para desplegar y administrar spiders
- Gestión inteligente de proxies y renderizado del navegador integrados
- Zyte Data, extracción gestionada para clientes empresariales
Anti-bot y mantenimiento: Rotación inteligente de proxies integrada y funciones de IA que ayudan a reducir el mantenimiento de selectores.
Precio: $5 de crédito gratuito para empezar. Precios de Zyte API basados en uso. Scrapy Cloud desde $9/unidad/mes.
Ideal para: Equipos Python/Scrapy que quieren un entorno cloud gestionado con extracción asistida por IA.
Limitaciones: Curva de aprendizaje más alta para quienes no desarrollan. La propuesta sin código es limitada frente a herramientas basadas en navegador.
5. Octoparse
 Octoparse es una de las marcas sin código más consolidadas del sector, construida alrededor de un generador visual de flujos de trabajo de apuntar y hacer clic.
Categoría: Herramienta sin código
Funciones clave:
- Constructor visual con lógica de arrastrar y soltar
- Aplicación de escritorio y ejecución programada en la nube
- Maneja paginación, scroll infinito y páginas con inicio de sesión
- Plantillas preconstruidas para sitios populares
- Exportación a CSV, Excel, JSON, HTML y XML
Anti-bot y mantenimiento: Manejo integrado de CAPTCHA y scraping en la nube con rotación de IP. Aun así, los usuarios deben actualizar los flujos cuando cambia el diseño del sitio.
Precio: Plan gratuito de por vida (10 tareas, 50,000 filas exportadas al mes). Standard a $83/mes, o $69/mes con facturación anual. Professional a $299/mes, o $249/mes con facturación anual. Enterprise es personalizado.
Ideal para: Marketers, investigadores y equipos de e-commerce que quieren una interfaz visual de scraping sin programar.
Limitaciones: El software de escritorio requiere instalación. El mantenimiento del flujo sigue recayendo en el usuario cuando cambian los sitios objetivo, porque el flujo depende de selectores guardados en lugar de releer la página cada vez.
6. Apify
 Apify no es solo un scraper: es una plataforma y un marketplace. Eso la hace especialmente fuerte cuando ya existe un scraper listo para el sitio que te interesa.
Categoría: Plataforma API / para desarrolladores con marketplace
Funciones clave:
- Marketplace de Actors con aproximadamente 59,000 scrapers y automatizaciones listas para usar (Apify Store, agosto de 2026)
- Apify SDK para crawlers personalizados
- Integraciones con Zapier, Google Sheets, webhooks y APIs
- Gestión de proxies incluida en los planes de la plataforma
Anti-bot y mantenimiento: Depende de la calidad de cada Actor. Los Actors oficiales están bien mantenidos; los de la comunidad pueden dejar de funcionar sin aviso.
Precio: Plan gratuito con $5 de crédito de uso. Starter desde $29/mes. Créditos de cómputo basados en uso aparte.
Ideal para: Equipos que quieren un scraper ya hecho para un sitio popular concreto (Google Maps, Amazon, Instagram) sin construir desde cero.
Limitaciones: La calidad varía entre Actors de la comunidad. Los sitios complejos o de nicho siguen necesitando desarrollo personalizado. No es realmente sin código para scrapers personalizados.
7. ScrapingBee
 ScrapingBee es una de las APIs más limpias para desarrolladores dentro de esta categoría, centrada en hacer que la obtención de páginas, el renderizado y la rotación de proxies sean tan simples como una sola llamada a la API. Ahora forma parte del grupo Oxylabs y sigue funcionando como producto independiente, algo útil si estás comparando ambas opciones.
Categoría: API de scraping
Funciones clave:
- API REST de una sola llamada (envías la URL y recibes HTML o JSON)
- Renderizado integrado con Chrome sin interfaz
- Rotación de proxies residenciales y de datacenter
- Google Search API y API de capturas de pantalla
- Opciones más recientes de Markdown y extracción con IA
Anti-bot y mantenimiento: Gestiona automáticamente el renderizado JS y la rotación de proxies. Tú te encargas de la lógica de parsing y del diseño del esquema.
Precio: 1,000 créditos gratuitos en la prueba. Planes desde $49/mes.
Ideal para: Desarrolladores que quieren una API limpia y sencilla para renderizar y obtener páginas, y luego procesar ellos mismos los datos.
Limitaciones: El producto principal sigue siendo la obtención de páginas. Tú gestionas la extracción, estructuración y fiabilidad posterior.
8. Scrapfly
 Scrapfly es la API más claramente enfocada en anti-bot de esta lista, creada para desarrolladores que apuntan a sitios web muy protegidos.
Categoría: API de scraping
Funciones clave:
- Bypass anti-bot para Cloudflare, DataDome, PerimeterX y defensas similares
- Renderizado con navegador sin interfaz
- Rotación de proxies residenciales
- Entrega por webhook, reintentos automáticos y capturas de pantalla
Anti-bot y mantenimiento: Especializada en objetivos difíciles de rastrear. Absorbe la mayor parte de la complejidad anti-bot. Tú sigues ocupándote del parsing.
Precio: Plan gratuito con 1,000 créditos. Planes de pago desde $30/mes.
Ideal para: Desarrolladores que extraen sitios con protección anti-bot agresiva y necesitan una alta tasa de éxito sin gestionar su propia pila de proxies y bypass.
Limitaciones: Se centra en obtención y renderizado; la extracción estructurada es tu responsabilidad. Ecosistema más pequeño que Bright Data u Oxylabs.
9. Firecrawl
 Firecrawl está diseñado para desarrolladores que quieren contenido web limpio para flujos de IA, no solo HTML en bruto.
Categoría: API de scraping para IA / pipelines LLM
Funciones clave:
- Endpoints de scrape y crawl
- Salida centrada en Markdown, pensada para RAG e ingestión por LLM
- Extracción de datos estructurados mediante LLM
- Renderizado JS y modos con proxy
- Flujo pensado para lotes y sistemas de agentes
Anti-bot y mantenimiento: Gestiona renderizado y anti-bot básico. Optimizado para calidad de contenido más que para volumen bruto.
Precio: 1,000 créditos gratuitos al mes. Hobby a $19/mes, o $16/mes con facturación anual. Standard a $99/mes, o $83/mes con facturación anual.
Ideal para: Equipos de IA/ML y desarrolladores que construyen pipelines RAG, bases de conocimiento o apps con LLM que necesitan contenido web limpio.
Limitaciones: Producto más nuevo, con menos funciones que los proveedores empresariales. No está pensado para monitorización de e-commerce a gran volumen. Solo para desarrolladores: no hay opción sin código.
10. Nimbleway
 Nimbleway se posiciona más como una plataforma de entrega de datos estructurados que como una herramienta de scraping autoservicio para pymes.
Categoría: Servicio completo / scraping gestionado con capa API
Funciones clave:
- Nimble Browser (navegador en la nube para scraping)
- APIs de datos estructurados en tiempo real para búsquedas, e-commerce y mapas
- Parsing basado en IA e infraestructura de desbloqueo
- Entrega de canalización gestionada
Anti-bot y mantenimiento: Totalmente gestionado. Nimbleway se encarga del mantenimiento de la canalización, del anti-bot y de la entrega de datos.
Precio: Pago por uso desde $1 por 1,000 solicitudes para extract, crawl y map, y $3 por 1,000 para las plantillas de extracción preconstruidas. Los Managed Data Services empiezan en $2,500/mes, con facturación anual.
Ideal para: Empresas medianas y grandes que quieren datos limpios y estructurados sin tener que gestionar scrapers internamente.
Limitaciones: El precio es demasiado alto para muchos flujos de trabajo de pymes. Excesivo para tareas de scraping simples o puntuales.
11. Browse AI
 Browse AI destaca cuando el flujo de trabajo está menos orientado a una extracción puntual y más al monitoreo recurrente con alertas.
Categoría: Herramienta sin código
Funciones clave:
- Entrenamiento de robots con apuntar y hacer clic
- Detección de cambios y monitoreo con alertas
- Integraciones con Google Sheets, Airtable, Zapier, webhooks y API
- Extracción masiva y ejecuciones programadas recurrentes
Anti-bot y mantenimiento: Gestiona anti-bot básico. Los robots pueden necesitar reentrenamiento cuando la estructura del sitio cambia de forma importante.
Precio: Plan gratuito de por vida (50 créditos al mes). Personal a $48/mes, o $19/mes con facturación anual. Professional a $87/mes, o $69/mes con facturación anual.
Ideal para: Usuarios de negocio que monitorean precios de la competencia, ofertas de empleo o disponibilidad de productos a lo largo del tiempo.
Limitaciones: Puede tener problemas con sitios muy dinámicos o intensivos en JS. Cuando cambia el diseño, hay que reentrenar el robot.
12. ParseHub
 ParseHub sigue teniendo sentido para proyectos pequeños, estudiantes y equipos que prueban el scraping por primera vez.
Categoría: Herramienta sin código
Funciones clave:
- Extracción visual de apuntar y hacer clic
- Manejo de páginas renderizadas con JS
- Salidas a CSV, JSON, Excel, API y webhook
- Plan gratuito reconocible (5 proyectos, 200 páginas por ejecución)
Anti-bot y mantenimiento: Manejo básico. Sin infraestructura avanzada de proxies. Los flujos pueden romperse si cambia el sitio.
Precio: Plan gratuito disponible. Planes de pago desde $189/mes.
Ideal para: Proyectos pequeños con presupuesto ajustado o usuarios que quieren explorar el scraping sin comprometerse con infraestructura.
Limitaciones: El precio de pago es alto para la profundidad de funciones que ofrece. Se siente como un producto más antiguo frente a competidores nativos de IA. Más lento y menos flexible que las opciones modernas centradas en la nube.
Mejores empresas de web scraping comparadas: tabla maestra
Todo lo anterior, en un solo lugar. Los precios de entrada son la tarifa mensual, con la tarifa anual entre paréntesis cuando el proveedor la ofrece. En "¿Plan gratuito?", "Sí" significa una cuota que se renueva o no expira; "Prueba" significa una asignación única.
| Empresa | Categoría | Ideal para | ¿Plan gratuito? | Precio de entrada | Modelo de precios | Anti-bot | Carga de mantenimiento | ¿Sin código? | Formatos clave de exportación |
|---|---|---|---|---|---|---|---|---|---|
| Thunderbit | Sin código + API | Equipos de negocio, sitios variados | Sí (6 páginas/mes) | $15/mes ($9/mes anual) | Créditos por fila; unidades API | Moderado | 🟡 | Sí | Excel, Sheets, Airtable, Notion, CSV, JSON |
| Bright Data | Híbrido gestionado + API | Extracción a escala empresarial | Sí (5K registros/mes) | $1.5/1K registros o $499/mes | Por resultado, por solicitud, dataset | Muy fuerte | 🟢 datasets / 🟠 API | Parcial | Salidas API, entrega de datasets |
| Oxylabs | API + infraestructura de proxies | Extracción recurrente con mucho uso de proxies | Prueba | $49/mes | Basado en resultados + paquetes de proxies | Muy fuerte | 🟠 | No | API / definido por el usuario |
| Zyte | Híbrido gestionado + API | Equipos Scrapy/Python | Sí ($5 de crédito) | Basado en uso; cloud $9/unidad/mes | API basada en uso + cloud | Fuerte | 🟢 Zyte Data / 🟠 Zyte API | Limitado | CSV, JSON, XML, almacenamiento |
| Octoparse | Sin código | Flujos visuales de scraping | Sí (10 tareas) | $83/mes ($69/mes anual) | Suscripción + complementos | Moderado | 🟡 | Sí | CSV, Excel, JSON, HTML, XML |
| Apify | Plataforma + marketplace | Scrapers preconstruidos para sitios concretos | Sí | $29/mes | Suscripción + uso + Actor | Bueno (varía) | 🟠 | Parcial | Datasets, API, integraciones |
| ScrapingBee | API | Renderizado y desbloqueo sencillos | Prueba | $49/mes | Créditos mensuales | Bueno | 🟠 | No | HTML, Markdown, JSON |
| Scrapfly | API | Objetivos con anti-bot duro | Sí (1,000 créditos) | $30/mes | Créditos mensuales de API | Muy fuerte | 🟠 | No | HTML, capturas de pantalla, JSON |
| Firecrawl | API de scraping para IA/LLM | Markdown y pipelines de datos para IA | Sí (1K créditos/mes) | $19/mes ($16/mes anual) | Basado en créditos | Moderado-fuerte | 🟠 | No | Markdown, HTML, JSON |
| Nimbleway | Gestionado + API | Datos estructurados empresariales | Sí (5K solicitudes/mes) | $1/1K solicitudes o $2,500/mes gestionado | PAYG API + planes anuales | Fuerte | 🟢 gestionado / 🟠 API | No | Feeds estructurados, APIs |
| Browse AI | Sin código | Monitoreo y alertas de cambios | Sí (50 créditos/mes) | $48/mes ($19/mes anual) | Créditos + límites por sitio | Básico-moderado | 🟡 | Sí | Sheets, Airtable, Zapier, API |
| ParseHub | Sin código | Proyectos pequeños gratuitos | Sí (200 páginas/ejecución) | $189/mes | Niveles de suscripción | Básico | 🟡 | Sí | CSV, JSON, Excel, API |
Escala de carga de mantenimiento:
- 🟢 La más baja: el proveedor asume casi todo el mantenimiento
- 🟡 Baja-media: el proveedor gestiona la obtención y el parsing, el usuario ejecuta el flujo y lo corrige cuando el sitio cambia
- 🟠 Media-alta: el proveedor gestiona obtención/desbloqueo, el usuario se encarga del parsing y la integración
- 🔴 La más alta: el usuario lo hace casi todo
Fiabilidad y mantenimiento: qué se rompe y quién lo arregla
Esta sección importa más que cualquier comparación de funciones.
La principal razón por la que los compradores se desilusionan con los proveedores de scraping no es que falle la primera ejecución. Es que falla la quinta, la quincuagésima o la quingentésima, y alguien del equipo tiene que hacerse cargo del problema.
| Nivel de mantenimiento | Tipo de proveedor | Qué haces tú | Qué hacen ellos |
|---|---|---|---|
| 🟢 Más bajo | Servicio completo (datasets de Bright Data, Zyte gestionado, Nimbleway) | Definir requisitos y validar la salida | Scraping, anti-bot, cambios de diseño, QA, entrega |
| 🟡 Bajo-medio | Herramientas sin código (Thunderbit, Octoparse, Browse AI, ParseHub) | Ejecutar el flujo, revisar la salida y reconstruirlo cuando la herramienta depende de selectores guardados | Obtención, parsing, alojamiento y programación |
| 🟠 Medio-alto | APIs de scraping (ScrapingBee, Scrapfly, Oxylabs, Apify, Firecrawl) | Código de integración, parsing, reintentos, validaciones de esquema | Proxies, renderizado, parte de la capa de desbloqueo |
| 🔴 Más alto | Frameworks DIY / open source | Todo | Nada |
Las herramientas sin código se sitúan en el centro. Ninguna elimina todos los fallos, y las que se basan en selectores guardados siguen rompiéndose cuando una página se reconstruye. Ese es justo el fallo que ataca el enfoque centrado en IA: Thunderbit relee cada página desde cero en lugar de depender de selectores fijos que el usuario debe mantener. Para usuarios de negocio que lidian con una larga cola de sitios inconsistentes, esto es mucho más llevadero que un constructor visual tradicional.
Los proveedores de servicio completo siguen absorbiendo más mantenimiento en conjunto. También son los que más cobran. No existe comida gratis: siempre estás decidiendo quién asume el dolor operativo.
Precios reales de 2026: comparación transparente de costes
La mayoría de los artículos recopilatorios esquivan esta sección. "Contacta con ventas" no es una página de precios. Aquí están las cifras reales. Las mismas convenciones que en la tabla maestra, más una columna con costes que no aparecen en el precio principal.
| Empresa | ¿Plan gratuito? | Precio de entrada | Modelo de precios | Riesgos de costes ocultos |
|---|---|---|---|---|
| Thunderbit | Sí (6 páginas/mes) | $15/mes ($9/mes anual) | Créditos por fila | Las filas de subpáginas cuestan 2 créditos, las consultas de enriquecimiento 30 |
| Bright Data | Sí (5K registros/mes) | $1.5/1K registros, o $499/mes en el plan Scale | Por resultado o por solicitud | Los costes de proxy se disparan con el volumen |
| Oxylabs | Prueba (2,000 resultados) | $49/mes | Por solicitud + paquetes de proxy | Complementos del pool de IP |
| Zyte | Sí ($5 de crédito) | Basado en uso | Uso de API + unidades cloud | Renderizado y niveles de complejidad |
| Octoparse | Sí (10 tareas) | $83/mes ($69/mes anual) | Suscripción + extras | Complementos de proxy, CAPTCHA y servicio |
| Apify | Sí ($5 de crédito) | $29/mes | Suscripción + cómputo + tarifas de Actor | Variación de Actor y uso |
| ScrapingBee | Prueba (1,000 créditos) | $49/mes | Basado en créditos | Las opciones de renderizado consumen más créditos |
| Scrapfly | Sí (1,000 créditos) | $30/mes | Basado en créditos | Los modos residencial y mejorado cuestan más |
| Firecrawl | Sí (1,000 créditos/mes) | $19/mes ($16/mes anual) | Basado en créditos | Proxy mejorado y modos de extracción más ricos |
| Nimbleway | Sí (5K solicitudes/mes) | $1/1K solicitudes o $2,500/mes gestionado | API + planes anuales | Los planes gestionados se facturan anualmente |
| Browse AI | Sí (50 créditos/mes) | $48/mes ($19/mes anual) | Créditos + límites | Sitios premium y topes por sitio web |
| ParseHub | Sí (200 páginas/ejecución) | $189/mes | Niveles de suscripción | Precios claros, pero valor más débil en planes de pago |
Entre las herramientas con precio mensual fijo, Thunderbit ($15) y Firecrawl ($19) son la puerta de entrada más barata, seguidas de Apify ($29) y Scrapfly ($30); Octoparse ($83) y ParseHub ($189) son la opción más cara dentro del no-code. Bright Data y Zyte facturan por uso, así que un piloto pequeño con cualquiera de los dos puede salir por debajo de todas las demás. Bright Data, Oxylabs y Nimbleway tienen más sentido cuando el volumen, la dificultad del objetivo y los requisitos empresariales pesan más que el presupuesto simple.
¿Qué empresa de web scraping es la adecuada para ti? Marco de decisión
Usa esta secuencia para acotar rápido.
1. ¿Qué volumen de datos tienes?
- Menos de 1,000 páginas/mes → herramientas sin código (Thunderbit, Browse AI, Octoparse, ParseHub)
- Más de 10K páginas/mes → APIs (Oxylabs, ScrapingBee, Apify, Scrapfly, Firecrawl)
- Más de 100K páginas/mes → gestión empresarial (Bright Data, Nimbleway, Zyte Data)
2. ¿Tienes desarrolladores en el equipo?
- Sí → las herramientas API te dan control (Oxylabs, ScrapingBee, Apify, Scrapfly, Firecrawl, Zyte API)
- No → no-code (Thunderbit, Browse AI, Octoparse) o servicio completo (datasets de Bright Data, Nimbleway)
3. ¿Cuántos sitios objetivo tienes?
- Pocos sitios conocidos y estables → las plantillas y los Actors preconstruidos funcionan bien
- Sitios variados, de larga cola y que cambian con frecuencia → importa la adaptabilidad de la IA (Thunderbit destaca aquí)
4. ¿Cuál es tu techo de presupuesto?
- Menos de $50/mes → planes gratuitos (Thunderbit, ParseHub, Apify, Scrapfly, Firecrawl)
- $50–$500/mes → APIs de gama media y planes de pago sin código
- Más de $500/mes → servicios gestionados empresariales
5. ¿Extracción puntual o monitoreo continuo?
- Continuo → importa la capacidad de scraping programado (Thunderbit, Browse AI, datasets de Bright Data)
- Puntual → casi cualquier herramienta sirve; prioriza la rapidez de configuración
Resumen rápido:
- Equipo no técnico, sitios diversos, sin recursos de desarrollo → Thunderbit
- Desarrollador construyendo un pipeline de datos a escala → Oxylabs, ScrapingBee o Apify
- Quieres que otra persona se encargue de todo → servicios gestionados de Bright Data o Zyte
- Construyendo pipelines de datos para IA/LLM → Firecrawl o Thunderbit API
Casos de uso reales: qué empresa de web scraping encaja con cada escenario
Monitoreo de precios en e-commerce
Para un equipo de operaciones que sigue los precios de la competencia en una tienda Shopify, Thunderbit es la ruta más rápida. Abres la página de colección y haces un clic. La IA detecta qué campos extraer —normalmente nombre del producto, precio, disponibilidad y URL— y rellena la tabla sola. Si quieres otro conjunto de campos, lo describes en una frase y usa eso en su lugar. Después lo programas en modo nube. Si además necesitas revisar cada página de detalle del producto, la extracción de subpáginas enriquece la tabla automáticamente. Exportas a Google Sheets y dejas que tu flujo de precios siga desde ahí.
Bright Data resuelve el mismo problema desde el otro lado. En lugar de operar el flujo, puedes comprar un dataset gestionado de e-commerce o usar su stack empresarial. Eso es más manos libres, pero la estructura de costes es completamente distinta.
Generación de leads B2B (emails y teléfonos)
Para proyectos pequeños y medianos de prospección, los extractores gratuitos de email y teléfono de Thunderbit son muy prácticos para directorios públicos, páginas de anuncios locales y sitios de negocios de nicho. El valor está en la velocidad: sacas una lista, la exportas y la llevas a tu CRM sin configuración técnica.
Apify es más potente cuando la fuente es una gran plataforma conocida con un ecosistema de Actors maduro. Si quieres listas de leads de Google Maps a gran volumen, un Actor preconstruido te pone en marcha más rápido que empezar desde cero.
Monitorización de SERP a gran escala
Aquí hace falta ser honestos. Thunderbit no es la mejor opción para más de 100K consultas SERP diarias. A ese nivel, deberías mirar las APIs SERP de Oxylabs, los productos SERP de Bright Data o infraestructuras empresariales similares, donde la tasa de éxito, la calidad de IP y la gestión de rate limits importan más que la facilidad de uso.
Llevar datos extraídos a pipelines de IA / LLM
Si tu objetivo es convertir páginas públicas en contenido limpio para RAG o flujos de agentes, Firecrawl es una candidata obvia por su diseño centrado en Markdown. Thunderbit también merece comparación porque su Distill API convierte páginas web a Markdown y su Extract API transforma páginas en JSON estructurado mediante esquema, lo que significa que una sola plataforma puede servir tanto para scraping de negocio (extensión de Chrome) como para pipelines de IA orientados a desarrolladores (capa API). Para saber más sobre cómo Thunderbit gestiona la extracción de datos con IA para empresas, tenemos una guía más detallada.
Consejos para sacar más partido a cualquier empresa de web scraping
- Empieza con el plan gratuito o la prueba antes de comprometer presupuesto. Todos los proveedores de esta lista ofrecen uno.
- Define tu esquema antes de scrapear. Decide primero qué campos, formatos y destinos necesitas. Este solo paso evita la mayoría de las frustraciones posteriores.
- Prueba con 50–100 páginas para evaluar la calidad de datos y la tasa de éxito antes de estimar el coste a escala.
- Confirma el formato de exportación por adelantado. No todas las herramientas admiten todos los destinos por igual. Si necesitas Airtable o Notion, verifícalo antes de empezar.
- Para trabajo recurrente, programa las ejecuciones en lugar de depender de scrapes manuales puntuales. Thunderbit, Browse AI, Octoparse y Bright Data lo permiten.
- Monitorea la deriva de calidad con el tiempo. Incluso los servicios gestionados pueden degradarse cuando cambian los objetivos.
- Entiende el consumo de créditos y los límites de tasa antes de escalar el flujo. Los precios basados en uso pueden dispararse si no los controlas.
El error de principiante normalmente no es técnico. Es operativo. Los equipos empiezan a scrapear antes de decidir qué forma debe tener la salida o cómo la consumirán después. Si quieres aprender más sobre qué es el data scraping y cómo hacerlo, tenemos una guía para principiantes que cubre los fundamentos.
Conclusión
La forma correcta de comprar en este mercado es elegir primero la categoría y luego el proveedor.
Si necesitas que otra empresa se encargue de toda la canalización, empieza con proveedores gestionados como Bright Data, Zyte Data o Nimbleway. Si tienes desarrolladores y quieres control directo de la infraestructura, APIs como Oxylabs, ScrapingBee, Scrapfly, Apify y Firecrawl encajan mejor. Si necesitas una vía rápida para operadores y usuarios de negocio que no pueden programar, la capa sin código es donde está el verdadero apalancamiento —y justo ahí es donde Thunderbit fue creado para estar.
Las mejores opciones por escenario:
- Inicio más rápido para equipos no técnicos: Thunderbit
- Infraestructura empresarial más potente: Bright Data u Oxylabs
- Mejor API para desarrolladores por simplicidad: ScrapingBee
- Mejor para pipelines de IA/LLM: Firecrawl o Thunderbit API
- Mejor opción gratuita para proyectos pequeños: ParseHub o el plan gratuito de Apify
Para la mayoría de los equipos no técnicos que scrapean una mezcla de sitios diversos, Thunderbit es el punto de partida más práctico. El plan gratuito reduce el riesgo, la configuración es mínima y el flujo centrado en IA encaja mejor con la realidad de mantenimiento de 2026 que los antiguos constructores visuales de scraping. Prueba la extensión de Chrome de Thunderbit y comprueba hasta dónde puede llegar un solo clic. Y si quieres ver la herramienta en acción antes de instalar nada, el canal de YouTube de Thunderbit tiene tutoriales para los casos de uso más comunes.
Prueba Thunderbit AI Web Scraper Get Started Free
FAQs
1. ¿Cuál es la diferencia entre una empresa de web scraping y una herramienta de web scraper?
Una empresa de web scraping puede ofrecer el servicio completo: infraestructura, mantenimiento, soporte y entrega de datos. Una herramienta de web scraper es software que tú operas por tu cuenta. Algunos proveedores (como Bright Data y Zyte) abarcan ambos modelos. Otros (como Thunderbit) son principalmente herramientas con una capa API opcional para desarrolladores.
2. ¿Es legal usar empresas de web scraping?
Extraer datos públicos es, en general, legal en muchas jurisdicciones, pero los detalles dependen del sitio web, del tipo de datos recopilados y de la normativa local. Respeta siempre los Términos de Servicio, robots.txt y las leyes de privacidad de datos como GDPR y CCPA. Los proveedores reputados incorporan consideraciones de cumplimiento en sus plataformas. Para más detalles, consulta nuestra guía sobre las implicaciones legales del web scraping.
3. ¿Cuánto cuestan las empresas de web scraping en 2026?
El mercado va desde planes gratuitos y opciones iniciales por menos de $50/mes hasta servicios gestionados empresariales que empiezan en unos $500/mes y pueden costar bastante más. Thunderbit, ParseHub y Apify ofrecen planes gratuitos. APIs de gama media como ScrapingBee y Scrapfly empiezan en $30–$49/mes. Los proveedores empresariales arrancan más alto: el plan Scale de Bright Data cuesta $499/mes y los planes gestionados de Nimbleway empiezan en $2,500/mes.
4. ¿Puedo usar una empresa de web scraping sin programar?
Sí. Herramientas sin código como Thunderbit, Octoparse, Browse AI y ParseHub están pensadas para usuarios no técnicos. Thunderbit no requiere programación: instala la extensión de Chrome, abre una página y haz un clic —la IA detecta qué campos extraer y termina el trabajo sola. También puedes describir en lenguaje natural los datos que quieres. Los datos van directamente a tu hoja de cálculo o base de datos.
5. ¿Qué empresa de web scraping es la mejor para pequeñas empresas?
Thunderbit es la recomendación por defecto más sólida para pequeñas empresas que necesitan datos estructurados de sitios variados sin configuración de desarrolladores. Su plan gratuito y su precio por créditos por fila hacen que sea fácil empezar y también sencillo prever la factura una vez que sabes cuántas filas necesitas. Apify también es interesante cuando existe un Actor listo para el sitio concreto que necesitas, y ParseHub funciona para proyectos pequeños en el plan gratuito cuando el volumen es bajo.
Más información



