
Craigslist parece que no ha cambiado desde 2003, pero los datos que esconden esos anuncios de texto simple son sorprendentemente valiosos. Con ~127 millones de visitas mensuales y decenas de millones de nuevas publicaciones cada mes, sigue siendo una de las plataformas de clasificados más grandes de Estados Unidos, y no ofrece ninguna API pública para aprovecharla.
Llevo años creando herramientas de automatización en Thunderbit, y una cosa que escucho constantemente de equipos de ventas, operaciones e inmobiliarios es esta: "Necesito los datos de Craigslist en una hoja de cálculo y no quiero pasar tres horas copiando y pegando". El problema es que la mayoría de las guías sobre el "mejor scraper de Craigslist" están desactualizadas, se saltan lo difícil (como las protecciones anti-bot) o solo enumeran herramientas sin compararlas de verdad.
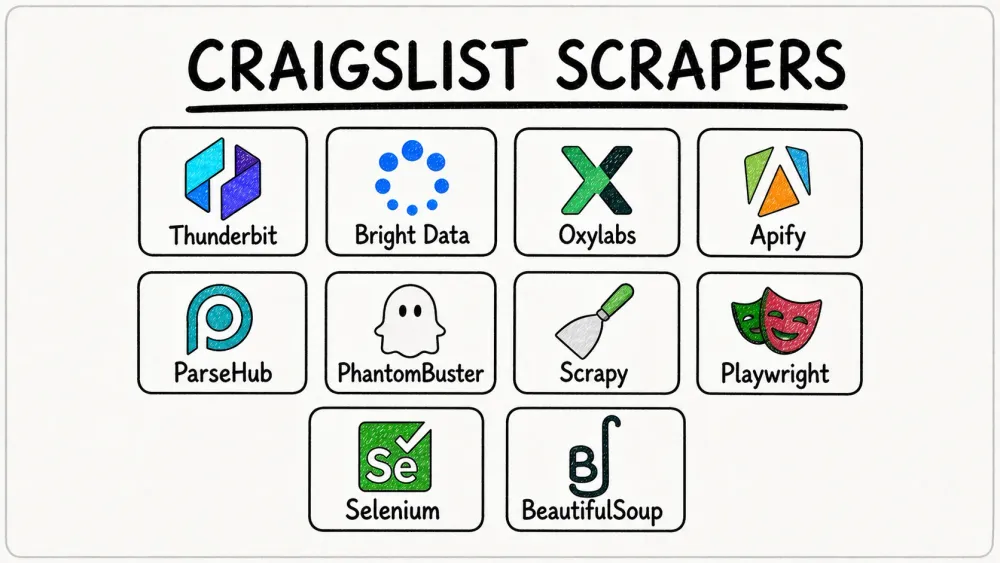
Por eso reuní esta guía con 10 herramientas que realmente siguen funcionando en 2026: desde extensiones de Chrome sin código hasta plataformas empresariales de proxies y bibliotecas Python de código abierto. Tanto si eres un usuario de negocio que nunca ha escrito una línea de código como si eres un desarrollador que piensa en Python, aquí hay algo para ti.
¿Por qué extraer datos de Craigslist en 2026? Casos de uso principales para equipos de negocio
Craigslist puede verse anticuado, pero esa es parte de su encanto y de su valor. Sigue ocupando el puesto #3 a nivel mundial entre los sitios de clasificados y opera en 416 entradas de EE. UU. y territorios en su directorio oficial. Eso significa muchísimo inventario hiperlocal que simplemente no existe reunido en ningún otro sitio.
Estos son los casos de uso que veo una y otra vez en los equipos:
- Generación de leads: Las publicaciones de servicios y trabajos puntuales suelen incluir descripción del negocio, ubicación geográfica y una ruta de contacto anónima de Craigslist; suficiente para que los equipos de ventas creen una lista de prospectos locales.
- Monitoreo inmobiliario: Las páginas de viviendas muestran alquiler, barrio, habitaciones/baños, metros cuadrados y fecha de publicación, ideal para comparar rentas y seguir disponibilidad.
- Precios competitivos: Los anuncios de venta muestran título, precio, estado y ubicación, información valiosa para reventa o arbitraje.
- Reclutamiento y seguimiento del mercado laboral: Las categorías de empleos y encargos muestran compensación, tipo de empleo y descripción del puesto para analizar el talento local.
- Análisis de mercado multirregional: Como Craigslist está segmentado por subdominio y ciudad, puedes consultar región por región para ver precios, volumen o mezcla de categorías.
- Automatización de flujos de trabajo: Muchos usuarios solo quieren que los datos de Craigslist lleguen a CSV, Google Sheets, Airtable o un CRM, sin navegar manualmente.
Un usuario reportó que una extracción diaria de Craigslist que antes tomaba 60–90 minutos se redujo a unos 5 minutos con automatización. Ese es el tipo de ahorro de tiempo que se nota rápido.
Extrae datos de Craigslist con IA El raspador web agentic de Thunderbit lee por sí mismo las páginas de anuncios de Craigslist y extrae precios, descripciones e información de contacto con un solo clic. Get Started Free
Cómo elegimos los mejores raspadores de Craigslist: nuestros criterios de evaluación
No todos los raspadores de Craigslist son iguales, y el "mejor" depende mucho de quién seas y qué necesites. Evalué cada herramienta en seis dimensiones:
- Facilidad de configuración — ¿Es apta para principiantes (sin código) o requiere desarrollador?
- Manejo anti-bot de Craigslist — ¿Incluye rotación de proxies, manejo de CAPTCHA o huellas del navegador?
- Nivel de precio — ¿Gratis, freemium, de pago o empresarial?
- Opciones de exportación de datos — ¿CSV, Excel, Google Sheets, Airtable, Notion, JSON, base de datos?
- Soporte multirregional — ¿Puede extraer en los 416 sitios de Craigslist en EE. UU. o está limitado a una ciudad a la vez?
- Esfuerzo de mantenimiento — ¿La herramienta se rompe cuando Craigslist cambia el diseño de sus páginas o se adapta automáticamente?
No encontré ningún artículo competidor que ofreciera una comparación lado a lado con criterios consistentes como estos; así que si te frustran las listas vagas de "top 10", esta guía es para ti.
Los 10 mejores raspadores de Craigslist de un vistazo
Antes de entrar en detalle con cada herramienta, aquí tienes la tabla comparativa principal. Las he agrupado en tres categorías: herramientas sin código para usuarios de negocio, plataformas empresariales para escalar y bibliotecas de código abierto para desarrolladores.
| Herramienta | Tipo | ¿Plan gratis? | Soporte de proxies / anti-bot | Manejo de CAPTCHA | Formatos de exportación | Ideal para |
|---|---|---|---|---|---|---|
| Thunderbit | Extensión de Chrome sin código | Sí (6 páginas/mes) | Modo navegador (no hace falta proxy para ejecuciones moderadas) | N/A (sesión del navegador) | Excel, Sheets, Airtable, Notion, CSV, JSON | Usuarios de negocio sin perfil técnico |
| Bright Data | Raspador empresarial + proxy + dataset | Prueba | Desbloqueo gestionado, proxies, reintentos, renderizado | Sí (resuelto automáticamente) | JSON, NDJSON, CSV, Parquet, XLSX, API | Recolección a escala empresarial |
| Oxylabs | API + stack de proxies | Prueba | Desbloqueo gestionado, proxies residenciales/ISP | Sí | HTML, captura de pantalla, salidas API | Desarrolladores que necesitan infraestructura empresarial |
| Apify | Mercado de actores en la nube | Sí ($5/mes en créditos) | Rotación de proxies (depende del actor) | Parcial / específico del actor | JSON, CSV, XML, Excel, JSONL | Automatización flexible low-code en la nube |
| ParseHub | Raspador visual sin código | Sí | Rotación de proxies de pago, ejecuciones en la nube | No es una función principal | CSV, JSON, API/S3/Dropbox (de pago) | Usuarios sin código con presupuesto limitado |
| Phantombuster | Plataforma de automatización en la nube | Sí (limitado) | Sí ofrece soporte de proxies | Créditos / basado en flujo de trabajo | CSV, JSON (de pago) | Automatización de ventas multicanal |
| Scrapy | Rastreador Python de código abierto | Gratis (OSS) | Proxies / middleware propios | No | JSON, JSONL, CSV, XML, BD | Rastreadoras en producción |
| Playwright | Automatización de navegador de código abierto | Gratis (OSS) | Navegador/proxy propios | No | Exportación personalizada | Control a nivel navegador |
| Selenium | Automatización de navegador de código abierto | Gratis (OSS) | Navegador/proxy propios | No | Exportación personalizada | Pilas heredadas multilenguaje |
| BeautifulSoup | Analizador HTML de código abierto | Gratis (OSS) | Ninguno por sí solo | No | Exportación personalizada | Análisis ligero |
Aquí se ven claramente tres grupos:
- Herramientas sin código (Thunderbit, ParseHub, Phantombuster) para usuarios de negocio que quieren datos sin carga de ingeniería.
- Plataformas empresariales (Bright Data, Oxylabs, Apify) para equipos que necesitan escala, infraestructura anti-bot y entrega gestionada.
- Herramientas de código abierto para desarrolladores (Scrapy, Playwright, Selenium, BeautifulSoup) para tener el máximo control, a costa de configuración, mantenimiento y gestión de proxies.
Ahora sí, vamos al detalle.
1. Thunderbit
 Thunderbit es una extensión de Chrome con IA creada para quienes quieren datos estructurados desde cualquier sitio web, incluido Craigslist, sin escribir código ni configurar proxies.
Voy a ser honesto: tengo un sesgo aquí (lo construimos nosotros), pero la razón por la que pongo a Thunderbit en primer lugar es que resuelve los problemas concretos que el scraping de Craigslist genera para usuarios no técnicos: diseños de página que varían según la categoría, enriquecimiento desde las subpáginas y la ruptura constante que ocurre cada vez que cambian los selectores CSS.
Cómo funciona en Craigslist:
- Instala la extensión de Chrome de Thunderbit y abre cualquier página de resultados de Craigslist, por ejemplo apartamentos en tu ciudad.
- Haz clic en "One Click Extract" — la IA de Thunderbit lee la página, entiende su estructura, decide qué columnas encajan y extrae los datos en una tabla en un solo paso. Para vivienda obtendrás Título, Precio, m², Habitaciones, Ubicación, Fecha de publicación y Enlace. Para empleos, Título, Compensación, Tipo de trabajo, etc. Sin configurar selectores manualmente.
- Gestiona la paginación: Thunderbit funciona con la paginación basada en clics de Craigslist.
- Usa "Scrape Subpages" para visitar cada anuncio individual y extraer campos que solo están en la página de detalle: descripción completa, todas las imágenes, información de contacto integrada y más.
- Exporta a Google Sheets, Excel, Airtable, Notion o CSV, gratis.
Funciones clave:
- Detección de campos impulsada por IA: Se adapta automáticamente a las distintas categorías de Craigslist: vivienda obtiene columnas de m²/habitaciones, empleo obtiene compensación/tipo de puesto, artículos en venta obtiene condición/precio. Sin trabajo manual con CSS.
- Extracción de subpáginas: Después de extraer una página de resultados, visita cada anuncio para traer campos de la página de detalle (descripción completa, imágenes, contacto).
- Modo de extracción basado en navegador: Funciona dentro de tu propia sesión de Chrome, así que para volúmenes moderados no necesitas proxy. Eso elimina una gran capa de coste y complejidad.
- Mantenimiento cero: La IA vuelve a leer la página cada vez. Cuando Craigslist cambia el diseño, tu raspador no se rompe.
- Exportación gratis: Excel, Google Sheets, Airtable, Notion, CSV, JSON; sin muro de pago para exportar.
Precio: plan gratis (6 páginas/mes), prueba gratis (10 páginas), planes de pago para mayor volumen.
Ideal para: equipos de ventas que extraen leads de servicios y trabajos puntuales en Craigslist, equipos inmobiliarios que siguen precios de alquiler, equipos de operaciones que necesitan datos estructurados sin apoyo de desarrolladores y cualquiera que quiera extraer, etiquetar y exportar datos en un solo paso.
Prueba Thunderbit para extraer Craigslist El plan gratis cubre 6 páginas al mes, suficiente para probar la extracción de Craigslist antes de pasar a un plan de pago. Get Started Free
2. Bright Data
 Bright Data es la opción empresarial de alto nivel. Es la única plataforma de esta lista que tiene tanto una página de producto dedicada a Craigslist Scraper como un mercado de Craigslist Dataset.
Si necesitas extraer miles de anuncios de Craigslist al día en todas las regiones de EE. UU., Bright Data está diseñada para eso. Su Web Unlocker gestiona IPs, reintentos, renderizado y bloqueos, incluida la resolución automática de CAPTCHAs por defecto. El Web Scraper IDE te permite construir flujos personalizados de recolección en Craigslist y puedes recorrer programáticamente las 416 URLs regionales.
Funciones clave:
- Enorme red de proxies residenciales (millones de IPs)
- Resolución de CAPTCHA integrada y evasión anti-bot
- Productos específicos para raspado y datasets de Craigslist
- Exportación: JSON, NDJSON, CSV, Parquet, XLSX, entrega por API y webhooks
Precio: el raspador de Craigslist cuesta desde $0.5 por cada 1K cargas de página en modalidad de pago por uso, con planes como 380K cargas por $499. Los proxies residenciales empiezan en $4/GB en pago por uso. Hay una prueba gratuita de 1K solicitudes durante una semana.
Ideal para: equipos empresariales que necesitan recolección de Craigslist de alto volumen y multirregional, con tiempo de actividad garantizado y soporte dedicado. Los equipos pequeños con presupuesto ajustado deberían mirar otras opciones.
3. Oxylabs
 Oxylabs es un proveedor premium de proxies e infraestructura de scraping con una Craigslist Scraper API dedicada y una página de proxies para Craigslist.
Oxylabs está más orientado a desarrolladores que el enfoque todo en uno de Bright Data. Su API de Web Scraper y Web Unblocker admiten renderizado JS, reintentos, gestión de sesiones, generación de huellas digitales y un manejo anti-bot más amplio. La prueba gratuita de la Craigslist Scraper API llega hasta 2,000 resultados.
Funciones clave:
- Pools de proxies residenciales e ISP (residenciales desde $6/GB, ISP desde $0.60/IP)
- Web Unblocker con generación automática de huellas digitales y gestión de sesiones
- Endpoint API específico para Craigslist
- Prueba gratuita de 7 días disponible
Precio: la API de scraping para "otros sitios" empieza alrededor de $0.15/1K resultados sin JS, $0.35/1K con JS. Web Unblocker en micro nivel desde unos $75/mes. Los proxies residenciales a gran escala pueden llegar a $0.50/GB a 1TB.
Ideal para: equipos de desarrollo que quieren infraestructura de proxies gestionada y flujos basados en API para scraping sostenido de Craigslist. Los equipos que ya usan proxies de Oxylabs en otros proyectos lo tendrán muy fácil para añadir Craigslist.
4. Apify
 Apify es una plataforma en la nube para scraping y automatización web con un mercado de "Actors" preconstruidos, es decir, plantillas de raspado que puedes ejecutar sin programar.
El panorama de Craigslist en Apify es interesante: hay varios actores de Craigslist mantenidos por la comunidad con niveles de calidad muy distintos. El actor ivanvs/craigslist-scraper tiene 829 usuarios totales y una valoración de 5.0, mientras que automation-lab/craigslist-scraper tiene 44 usuarios y una valoración de 1.0. La calidad es irregular, así que conviene probar antes de comprometerte.
Funciones clave:
- Varios actores de Craigslist disponibles (algunos extraen ~120 anuncios por página con pausas integradas)
- Ejecución en la nube, ejecuciones programadas, acceso API e integraciones con webhooks
- Rotación de proxies disponible
- Exportación: JSON, CSV, XML, Excel, JSONL
Precio: plan gratis con $5/mes en créditos, planes de pago desde unos ~$49/mes. El precio por cómputo puede dispararse con mucho uso, así que vigila el consumo de CU.
Ideal para: equipos que quieren una solución alojada en la nube sin administrar infraestructura, usuarios cómodos con configuración low-code y equipos que necesitan extracciones programadas y recurrentes de Craigslist.
5. ParseHub
 ParseHub es una herramienta visual de scraping basada en escritorio donde haces clic sobre elementos de la página para definir qué extraer.
Para configurar una extracción de Craigslist en ParseHub, haces clic en títulos, precios y enlaces para enseñarle a la herramienta qué capturar. Gestiona la paginación mediante bucles de clic AJAX y admite ejecuciones en la nube en los planes de pago. El plan gratis ofrece hasta 5 proyectos, suficiente para trabajos pequeños en Craigslist.
Funciones clave:
- Constructor visual de flujos point-and-click
- Paginación y manejo de contenido dinámico
- Ejecuciones en la nube y programación en planes de pago
- Exportación: CSV, Excel, JSON
Precio: plan gratis (5 proyectos), planes de pago desde unos ~$189/mes para más páginas y ejecuciones programadas.
Limitaciones: puede ir lento en extracciones grandes, el plan gratis tiene ejecuciones programadas limitadas y, lo más importante, depende de selectores CSS, por lo que requiere mantenimiento manual cuando Craigslist cambia el diseño.
Ideal para: usuarios individuales o equipos pequeños con necesidades moderadas que quieren una herramienta visual sin código, pero no necesitan detección de campos mediante IA.
6. Phantombuster
 Phantombuster es una plataforma de automatización en la nube que se popularizó primero para LinkedIn y redes sociales. No es una herramienta nativa de Craigslist, pero su Web Element Extractor puede extraer páginas públicas usando selectores CSS.
Configurar una extracción de Craigslist en Phantombuster exige más trabajo que usar una herramienta dedicada: tendrás que definir selectores, montar el flujo y configurar la programación. Pero si ya usas Phantombuster para LinkedIn o generación de leads en redes sociales, añadir Craigslist a tu proceso es bastante directo.
Funciones clave:
- Plantillas de automatización preconstruidas y ejecución en la nube
- Programación e integraciones con CRM
- Soporte de proxies y créditos para resolver CAPTCHA disponibles
- Exportación: CSV, JSON en planes de pago (el plan gratis limita a 10 filas)
Precio: plan gratis con 5 espacios, 2 horas al mes y límite de exportación de 10 filas. Los planes anuales de pago empiezan en ~$56/mes facturados anualmente.
Ideal para: equipos de ventas que ya usan Phantombuster para generación de leads multicanal y quieren añadir Craigslist a su flujo.
7. Scrapy
 Scrapy es el framework Python de scraping web de código abierto más popular, y es la opción obvia para equipos de desarrollo que quieren el máximo control sobre el rastreo de Craigslist.
La última versión estable es 2.15.0 (9 de abril de 2026). Scrapy permite rastreo multirregional (iterar por todas las URLs regionales), programación y limitación de peticiones integradas, middleware de descarga para rotación de proxies y exportaciones de feed a CSV, JSON, JSONL, XML y pipelines hacia bases de datos. El plugin scrapy-playwright añade renderizado a nivel navegador cuando lo necesitas.
Funciones clave:
- Rastreador altamente personalizable y apto para producción
- Middleware para proxies, reintentos, cookies y rotación de user-agent
- Exportaciones de feed: JSON, JSONL, CSV, XML, pipelines de base de datos
- Gratis y de código abierto
Coste oculto: Scrapy en sí es gratis, pero ejecutarlo a escala en Craigslist implica suscripciones a proxies ($50–500+/mes), costes de hosting/servidor y mantenimiento continuo cuando Craigslist cambia su estructura HTML.
Ideal para: equipos de desarrollo con experiencia en Python que necesitan máxima flexibilidad, infraestructura de proxies ya existente y rastreo de Craigslist multirregional y de alto volumen.
8. Playwright
 Playwright es una biblioteca moderna de automatización de navegadores de Microsoft que controla Chromium, Firefox y WebKit de forma programática. Su ritmo de lanzamiento sigue activo: v1.59.1 salió el 1 de abril de 2026.
Playwright se está convirtiendo cada vez más en la opción recomendada frente a Selenium para extraer Craigslist en comunidades de desarrollo. Es más rápido, más fiable y ofrece mejor sigilo anti-detección con plugins de la comunidad como playwright-extra. Soporta modos headless y con interfaz, espera automática de elementos, interceptación de red y captura de capturas de pantalla/PDF.
Funciones clave:
- Compatible con Python, JavaScript/TypeScript, Java y .NET
- Modos de navegador headless y con interfaz
- Espera automática de elementos, interceptación de red
- Gratis y de código abierto
Ventaja para Craigslist: Playwright puede imitar el comportamiento de un usuario real de forma más convincente que las peticiones HTTP en bruto, lo que reduce el riesgo de bloqueo. En Reddit, la opinión de la comunidad favorece de forma constante a Playwright frente a Selenium para proyectos nuevos.
Costes ocultos: los mismos que en Scrapy: proxies, hosting y mantenimiento cuando se rompen los selectores.
Ideal para: desarrolladores que necesitan control preciso del navegador, equipos que construyen raspadores para contenido renderizado con JavaScript y cualquiera que prefiera una alternativa moderna a Selenium.
9. Selenium
 Selenium es el framework de automatización de navegadores de larga trayectoria y uso extendido. Su versión más reciente es 4.43.0 (10 de abril de 2026), y sigue ampliando las capacidades de BiDi y control de red.
Selenium es compatible con varios lenguajes (Python, Java, C#, JavaScript) y con todos los navegadores principales. Puede simular sesiones completas de navegador, iniciar sesión si hace falta y desplazarse por las páginas. Pero comparado con Playwright, es más lento, más verboso y más fácil de detectar como bot sin bibliotecas extra de sigilo como undetected-chromedriver.
Funciones clave:
- Soporte multilenguaje (Python, Java, C#, JavaScript)
- Simulación completa de sesión de navegador
- Ecosistema maduro con documentación extensa
- Gratis y de código abierto
Limitaciones: en 2026, la comunidad tiende a preferir Playwright para proyectos nuevos. Un hilo de Reddit señalaba que Cloudflare seguía detectando Selenium "incluso usando proxies residenciales"; el sigilo es más difícil desde el principio.
Ideal para: equipos de desarrollo ya invertidos en Selenium que no quieren migrar, proyectos que necesitan soporte multilenguaje (Java, C#) y configuraciones heredadas de scraping.
10. BeautifulSoup
 BeautifulSoup es una biblioteca ligera de Python para analizar HTML y XML. La versión actual en PyPI es 4.14.3 (30 de noviembre de 2025).
Aclaración importante: BeautifulSoup es un parser, no un raspador completo. No descarga páginas web ni maneja automatización del navegador. Se combina con la biblioteca requests para hacer las peticiones HTTP, y luego analiza el HTML que le pases. Eso lo convierte en el punto de entrada más simple para desarrolladores, pero también en el más limitado.
Funciones clave:
- Muy fácil de aprender: requiere muy poco código
- Ideal para extracciones pequeñas o puntuales de Craigslist
- Gratis y de código abierto
Limitaciones: no incluye paginación, no renderiza JavaScript, no rota proxies; todo eso hay que añadirlo manualmente. Si Craigslist cambia la estructura HTML, los selectores se rompen y hay que corregirlos a mano.
Ideal para: principiantes en Python que quieren probar scraping de Craigslist con una configuración mínima, extracciones rápidas de una sola categoría o región y desarrolladores que solo necesitan un analizador ligero.
El plan anti-baneo de Craigslist: proxies, límites de velocidad y lo que hace que te bloqueen
Esta es la sección que la mayoría de las guías sobre scraping de Craigslist se saltan, y es la más importante. Las pruebas de Scraperly de abril de 2026 clasifican Craigslist como un objetivo de dificultad 3/5, citando CAPTCHA personalizado, limitación de tasa y bloqueo de IP. El tutorial de Bright Data recomienda optar por Web Unlocker o por un Scraping Browser basado en Playwright en lugar de HTTP puro. La página de proxies de Oxylabs indica que Craigslist puede detectar proxies y que los proxies residenciales son la mejor opción.
Esto es lo que sí funciona de verdad:
| Estrategia | Eficacia en Craigslist | Coste | Complejidad |
|---|---|---|---|
| Proxies residenciales | ✅ Alta | $$ ($4–6/GB) | Media |
| Proxies ISP | ✅ Alta | $ ($0.60–0.80/IP) | Media |
| Proxies de datacenter | ⚠️ Baja (a menudo bloqueados) | $ ($0.20–0.40/IP) | Baja |
| Scraping basado en navegador (tu propia sesión) | ✅ Media-Alta | Gratis | Baja |
| Limitación de tasa + retrasos randomizados | ✅ Básico esencial | Gratis | Baja |
Consejos accionables:
- Retrasos entre peticiones: mínimo 2–5 segundos entre solicitudes. Scraperly sugiere mantenerse en unas 5–10 solicitudes/minuto por IP y rotar tras 20–30 solicitudes.
- Rotación de sesión: rota user-agents y huellas del navegador. Los patrones de rastreo previsibles se detectan rápido.
- Evita proxies de datacenter: son baratos, pero Craigslist los bloquea enseguida.
- El scraping basado en navegador elimina por completo el problema de proxies para volúmenes moderados. El modo navegador de Thunderbit funciona dentro de tu propia sesión de Chrome: sin configuración de proxies, sin rotación de IP y sin coste. Para la mayoría de usuarios de negocio que extraen unos cientos de anuncios, es más que suficiente.
Y aquí está el ángulo de mantenimiento que mucha gente pasa por alto: cuando Craigslist cambia su CSS (y lo hace periódicamente), todos los raspadores basados en selectores CSS se rompen. Hay que inspeccionar la página, encontrar los nuevos selectores, actualizar el código y volver a probar. Las herramientas con IA como Thunderbit evitan todo eso: la IA lee la estructura de la página desde cero cada vez, así que los cambios de diseño no rompen tu flujo.
Código vs. sin código: dos tutoriales completos para extraer Craigslist
Sé que la audiencia de este artículo está dividida más o menos al 50/50: usuarios de negocio sin perfil técnico que solo quieren los datos, y desarrolladores principiantes o intermedios que buscan código funcional. Así que aquí van ambos caminos, lado a lado.
Sin código: cómo extraer Craigslist con Thunderbit (paso a paso)
- Instala la extensión de Chrome de Thunderbit desde la Chrome Web Store.
- Ve a una página de anuncios de Craigslist — por ejemplo, apartamentos en tu ciudad (
https://yourcity.craigslist.org/search/apa). - Haz clic en "One Click Extract" — la IA de Thunderbit lee la página, entiende su estructura, decide qué columnas encajan con la categoría y rellena una tabla estructurada en un solo paso. Para vivienda verás Título, Precio, m², Habitaciones, Ubicación, Fecha de publicación y Enlace. Después puedes ajustar cualquier columna si quieres algo distinto.
- Gestiona la paginación — avanza por las páginas o deja que Thunderbit lo haga.
- Usa "Scrape Subpages" para visitar cada anuncio individual y enriquecer con campos de la página de detalle: descripción completa, todas las imágenes e información de contacto integrada.
- Exporta a Google Sheets, Excel, Airtable, Notion o CSV, gratis.
Todo el proceso tarda unos 2 minutos por una página de resultados. Sin selectores CSS, sin proxies, sin código.
Ruta con código: cómo extraer Craigslist con Python + Playwright
Playwright es la biblioteca más recomendada para scraping de Craigslist en foros de desarrolladores en 2026. Aquí tienes un fragmento de Python que funciona para extraer una página de resultados de vivienda de Craigslist, sacar título/precio/enlace, manejar la paginación y devolver resultados.
El enfoque: probar primero los datos estructurados JSON-LD (Craigslist incrusta el esquema ItemList en algunas páginas) y luego caer a selectores DOM. La paginación se hace con s=120.
import asyncio, json
from urllib.parse import urlparse, parse_qs, urlencode, urlunparse
from playwright.async_api import async_playwright

def next_page_url(url, step=120):
    p = urlparse(url)
    qs = parse_qs(p.query)
    offset = int(qs.get("s", ["0"])[0]) + step
    qs["s"] = [str(offset)]
    return urlunparse((p.scheme, p.netloc, p.path, "", urlencode(qs, doseq=True), ""))

async def scrape_page(page, url):
    await page.goto(url, wait_until="domcontentloaded")
    await page.wait_for_timeout(1500)
    data = []
    # Try JSON-LD first
    for raw in await page.locator('script[type="application/ld+json"]').all_text_contents():
        try:
            obj = json.loads(raw)
        except Exception:
            continue
        if isinstance(obj, dict) and obj.get("@type") == "ItemList":
            for item in obj.get("itemListElement", []):
                thing = item.get("item", {})
                data.append({
                    "title": thing.get("name"),
                    "price": thing.get("offers", {}).get("price"),
                    "link": thing.get("url"),
                })
            if data:
                return data
    # Fallback: DOM selectors
    cards = page.locator("div.cl-search-result, li.cl-static-search-result")
    count = await cards.count()
    for i in range(count):
        card = cards.nth(i)
        title = await card.locator("a.posting-title, a.titlestring").first.text_content()
        link = await card.locator("a.posting-title, a.titlestring").first.get_attribute("href")
        price = (await card.locator(".price, .result-price").first.text_content()
                 if await card.locator(".price, .result-price").count() else None)
        data.append({"title": (title or "").strip(), "price": (price or "").strip(), "link": link})
    return data

async def main():
    start_url = "https://newyork.craigslist.org/search/apa?query=studio"
    async with async_playwright() as p:
        browser = await p.chromium.launch(headless=True)
        page = await browser.new_page()
        url = start_url
        all_rows = []
        for _ in range(3):  # scrape 3 pages
            rows = await scrape_page(page, url)
            if not rows:
                break
            all_rows.extend(rows)
            url = next_page_url(url)
        await browser.close()
        for row in all_rows[:10]:
            print(row)

asyncio.run(main())
Lo que necesitarás además de este script: Playwright instalado (pip install playwright && playwright install), configuración de proxy para ejecuciones de gran volumen y manejo manual de CAPTCHA si alcanzas los límites de tasa. Esa es la contrapartida: control total, pero responsabilidad total.
Gratis vs. de pago: desglose honesto de costes para cada raspador de Craigslist
Esta es la tabla que me habría gustado tener cuando empecé a investigar este tema. "Gratis" es una palabra cargada en web scraping.
| Herramienta | ¿Completamente gratis? | Límites del plan gratis | Precio inicial de pago | Costes ocultos |
|---|---|---|---|---|
| Thunderbit | Plan gratis (6 páginas) | 6 páginas/mes; prueba gratis = 10 páginas | Planes de pago para mayor volumen | Ninguno: la exportación es gratis |
| Scrapy | ✅ Código abierto | Ilimitado | $0 | Coste de proxies, hosting, mantenimiento |
| BeautifulSoup | ✅ Código abierto | Ilimitado | $0 | Coste de proxies, hosting, mantenimiento |
| Playwright | ✅ Código abierto | Ilimitado | $0 | Coste de proxies, hosting, mantenimiento |
| Selenium | ✅ Código abierto | Ilimitado | $0 | Coste de proxies, hosting, mantenimiento |
| ParseHub | Plan gratis | 5 proyectos | ~$189/mes | Ejecuciones programadas limitadas en gratis |
| Apify | Plan gratis | $5/mes en créditos gratis | ~$49/mes | El precio por cómputo puede dispararse |
| Phantombuster | Plan gratis | 5 espacios, 2h/mes, exportación de 10 filas | ~$56/mes (anual) | Precio por espacio |
| Bright Data | Solo prueba | 1K solicitudes/1 semana | ~$500+/mes | Proxies aparte |
| Oxylabs | Solo prueba | 2K resultados / 1GB | ~$75+/mes (Unblocker) | Precio empresarial |
La gran nota al pie sobre las herramientas de código abierto "gratis": Scrapy, Playwright, Selenium y BeautifulSoup cuestan $0 de instalar, pero ejecutarlos a escala en Craigslist implica horas de tiempo de desarrollador para la configuración, entre $50 y $500+/mes en proxies residenciales y mantenimiento continuo cada vez que Craigslist cambia su HTML. La IA de Thunderbit relee la página cada vez (mantenimiento cero), las exportaciones son gratis y el scraping basado en navegador elimina el coste de proxies para volúmenes moderados. Esa es una ventaja real para usuarios no técnicos.
Qué puedes extraer realmente: campos de datos de Craigslist por categoría
Las distintas categorías de Craigslist tienen estructuras de datos completamente diferentes. Un anuncio de vivienda no se parece en nada a una oferta de trabajo. Esto es lo que puedes extraer de forma realista de cada sección principal:
| Categoría de Craigslist | Campos extraíbles | ¿Hay información de contacto? |
|---|---|---|
| Vivienda / Apartamentos | Título, Precio, m², Habitaciones, Baños, Ubicación, Fecha, Imágenes, Descripción, Enlace al mapa, Disponibilidad, Política de mascotas, Lavandería/estacionamiento | ⚠️ A veces (relay de email anonimizado) |
| Venta | Título, Precio, Estado, Ubicación, Fecha, Imágenes, Descripción, Marca/Modelo/Año (varía) | ⚠️ A veces |
| Empleos | Título, Empresa, Compensación, Ubicación, Tipo de trabajo, Nivel de experiencia, Fecha, Descripción | Rara vez (solo enlace para postular) |
| Servicios | Título, Ubicación, Descripción, Imágenes | ⚠️ A veces |
| Trabajos puntuales | Título, Compensación, Ubicación, Fecha, Descripción | ⚠️ A veces |
Algunas notas importantes:
- Información de contacto: Craigslist usa relays de correo anónimos precisamente para evitar la extracción directa de emails. Las herramientas que dicen "extraer emails" a menudo capturan la dirección relay (
reply+randomstring@craigslist.org), no el correo real del anunciante. - Los campos de la página de detalle como la descripción completa, todas las imágenes y la información de contacto integrada solo aparecen cuando visitas cada anuncio individual, no en la página de resultados.
- "One Click Extract" de Thunderbit detecta automáticamente qué campos están disponibles en la página actual y propone la estructura de columnas correcta. Quien extrae viviendas obtiene columnas de m²/habitaciones; quien extrae empleos obtiene columnas de compensación/tipo de trabajo, sin configuración manual. Su extracción de subpáginas luego visita cada anuncio para capturar los campos exclusivos de la página de detalle.
Revisión legal: Términos de uso de Craigslist, el caso 3Taps y lo que debes saber
No soy abogado, y esto no es asesoramiento legal. Pero sé que a los usuarios les preocupa este tema y merece una respuesta directa.
El precedente clave: en Craigslist v. 3Taps (2013), Craigslist obtuvo una orden judicial contra 3Taps por extraer y volver a publicar anuncios después de enviar un cese y desistimiento. Según alegaciones, 3Taps eludió bloqueos de IP usando servidores proxy, y el tribunal trató el acceso posterior al bloqueo como potencialmente "sin autorización". La EFF señaló que el caso se resolvió en 2015.
Los Términos de uso de Craigslist prohíben explícitamente usar "robots, spiders, scripts, scrapers, crawlers o cualquier equivalente automatizado o manual" para interactuar con el sitio. Incluso establecen daños liquidados de $0.25 por página después de las primeras 1,000 vistas de página en un período de 24 horas por infracciones.
Guía práctica:
- ✅ Extrae datos públicos de anuncios para investigación de mercado o uso personal
- ✅ Respeta robots.txt y los límites de velocidad
- ⚠️ No vuelvas a publicar anuncios extraídos en masa
- ⚠️ No uses información de contacto extraída para marketing no solicitado
- ❌ No eludas restricciones técnicas de acceso después de haber sido bloqueado
La diferencia importa: extraer datos públicos visibles para tu propio análisis no es lo mismo que republicarlos en masa o recolectar emails para spam. Aun así, ten en cuenta que Craigslist históricamente ha pasado de hacer cumplir sus términos a bloquear IPs y, en algunos casos, a acciones legales.
¿Qué raspador de Craigslist es mejor para ti?
Después de probar y evaluar los 10, esta es mi recomendación según el escenario:
- Usuario de negocio sin perfil técnico que necesita datos de Craigslist rápido → Thunderbit. Sin código, detección de campos impulsada por IA, mantenimiento cero y exportación gratis. La ruta más rápida de "necesito estos datos" a "ya están en mi hoja de cálculo".
- Equipo empresarial que extrae miles de anuncios al día en todas las regiones → Bright Data. Raspador específico para Craigslist, enorme infraestructura de proxies, resolución automática de CAPTCHA y soporte dedicado.
- Equipo de desarrollo que necesita infraestructura gestionada de API/proxy → Oxylabs para flujos centrados en proxies, Apify para flexibilidad con marketplace de actores.
- Desarrollador que quiere control total y personalización → Scrapy + Playwright. Código abierto, máxima flexibilidad, pero con proxies y mantenimiento propios.
- Usuario con presupuesto ajustado y necesidades moderadas → plan gratis de Apify ($5/mes en créditos) o plan gratis de ParseHub (5 proyectos).
- Equipo de ventas que ya usa herramientas multicanal de generación de leads → Phantombuster. Añade Craigslist a tu pipeline actual.
- Principiante en Python que hace una extracción puntual → BeautifulSoup + requests. Mínimo código, mínima configuración, capacidad mínima.
Para la mayoría de usuarios de negocio sin perfil técnico, Thunderbit ofrece el mejor equilibrio entre facilidad, precisión y coste. Para desarrolladores, Scrapy + Playwright es la combinación más potente. Y para escala empresarial, Bright Data es difícil de superar.
Si quieres ver cómo se ve realmente el scraping de Craigslist con IA, prueba Thunderbit — el plan gratis basta para testearlo en tu caso de uso. Y si quieres profundizar en técnicas de scraping web, consulta nuestras guías sobre cómo extraer datos a Google Sheets, las mejores herramientas automáticas de web scraping y cómo hacer web scraping sin ser bloqueado. También puedes visitar nuestro canal de YouTube para tutoriales paso a paso en vídeo.
Feliz scraping, y que tus datos siempre estén limpios, estructurados y listos para la acción.
Preguntas frecuentes
¿Es legal extraer anuncios de Craigslist?
Los Términos de uso de Craigslist prohíben explícitamente el scraping automatizado, y el caso Craigslist v. 3Taps es el precedente legal principal. Extraer datos públicos de anuncios para uso personal o analítico suele tratarse de forma distinta a la republicación masiva o el spam, pero siempre debes respetar los límites de velocidad y las reglas del sitio, y esto no es asesoramiento legal.
¿Puedo extraer datos de Craigslist sin programar?
Sí. Herramientas como Thunderbit, ParseHub y Apify ofrecen opciones sin código o con muy poco código para extraer datos de Craigslist. La detección de campos con IA de Thunderbit lo hace especialmente fácil: solo haz clic en "One Click Extract" y luego en "Scrape".
¿Cuál es el mejor raspador gratis para Craigslist?
Para desarrolladores, Scrapy o BeautifulSoup son completamente gratis y de código abierto, aunque los costes de proxy y mantenimiento se acumulan. Para quienes no programan, el plan gratis de Thunderbit (6 páginas/mes) es el mejor punto de partida, con el plan gratis de ParseHub (5 proyectos) como otra opción.
¿Cómo evito que me bloqueen al extraer datos de Craigslist?
Usa limitación de tasa (retrasos mínimos de 2–5 segundos), rota user-agents, evita proxies de datacenter (los residenciales o ISP funcionan mucho mejor en Craigslist) y no sigas patrones de rastreo predecibles. Para volúmenes moderados, herramientas de scraping basadas en navegador como Thunderbit esquivan por completo el problema de proxies al ejecutarse dentro de tu propia sesión de Chrome.
¿Puedo extraer todas las regiones de Craigslist a la vez?
Con herramientas para desarrolladores como Scrapy o Playwright, puedes recorrer programáticamente todas las 416 URLs regionales de EE. UU./territorios. Herramientas empresariales como Bright Data y Oxylabs ya traen incorporado el scraping multirregional. Con Thunderbit, puedes abrir cada sitio regional y extraer con el mismo flujo: la IA se adapta automáticamente a cada página.
Prueba Thunderbit para extraer Craigslist Get Started Free
Más información



