
El mes pasado, la integración de Stripe de un amigo empezó a devolver 503 en silencio un viernes a las 11 de la noche. Nadie se dio cuenta hasta el sábado por la mañana, cuando el buzón de soporte ya tenía más de 200 correos furiosos de clientes cuyo pago no se había completado.
Esa historia no tiene nada de rara. Un referente muy citado sitúa el coste medio del tiempo de inactividad en $5.600 por minuto, y las caídas de alto impacto pueden llegar a millones por hora. La cifra exacta depende del tráfico, la conversión, el valor del pedido, la exposición a los SLA y el coste de recuperación, pero la conclusión es clara: las APIs sin supervisión son un riesgo de negocio, no solo una molestia técnica. Con organizaciones que ya operan una media de 131 APIs de terceros y solo un 16% con alta capacidad para mitigar ese riesgo, la monitorización ya no es opcional. Con esta guía quise hacer algo que no había visto en otros sitios: organizar las herramientas según tu caso de uso, evaluar la calidad de las alertas (no solo si existen), mostrar precios reales de 2026 y medir qué tan rápido puedes empezar a usarlas. No otra lista de logos.
Una cosa más: si tu trabajo con APIs implica recopilar datos web, alimentar LLMs, construir sistemas RAG, vigilar páginas de la competencia o extraer precios y productos de sitios web, la conversación sobre "herramientas de API" no debería quedarse en el uptime. También necesitas una forma fiable de convertir páginas desordenadas en datos estructurados. Ahí encaja Thunderbit Open API en esta guía: no es un monitor de disponibilidad, pero sí una de las formas más rápidas de convertir sitios web en Markdown limpio o JSON basado en esquema vía API.
Qué es la monitorización de API y por qué debería importarle a tu equipo
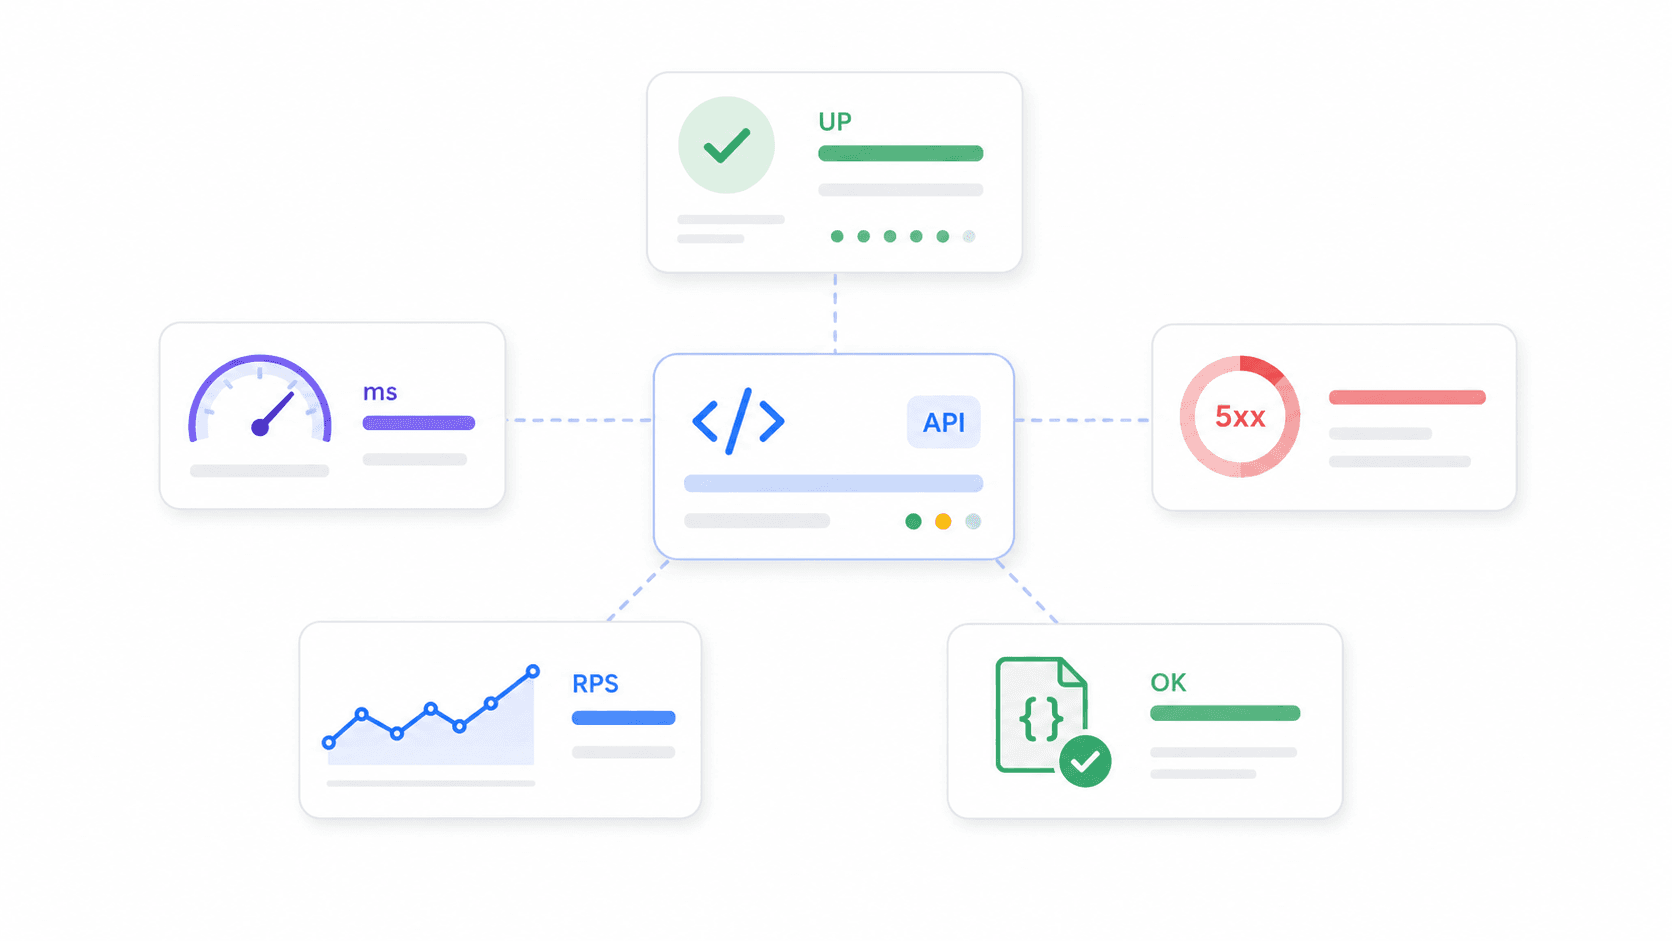
Monitorizar una API significa comprobar de forma continua que tus endpoints estén disponibles, respondan rápido y devuelvan los datos correctos. No es solo "¿está levantado el servidor?": un buen monitor valida códigos HTTP, contenido de respuesta, latencia, certificados SSL, flujos de varios pasos (como iniciar sesión → buscar → pagar) e incluso la corrección del esquema.
Es distinto de la monitorización general de sitios web (que comprueba si una página carga) y del APM (Application Performance Monitoring), que profundiza en trazas a nivel de código, consultas a bases de datos e internals. La monitorización de API se sitúa en el punto medio: prueba lo que experimentan tus usuarios, partners e integraciones al llamar a tus endpoints.
También hay una categoría relacionada que vale la pena mencionar: las APIs de datos web. No supervisan si tu propia API funciona bien; ayudan a tu producto a recopilar datos externos de forma fiable. Por ejemplo, Thunderbit Open API puede convertir una página web en Markdown limpio, extraer campos estructurados como JSON y ejecutar trabajos por lotes sobre muchas URLs. Si tu proyecto "API" depende de datos recientes de proveedores, páginas de producto, listados públicos, documentación o fuentes de investigación, ese tipo de API de extracción puede ser tan importante como las comprobaciones de uptime.
¿Por qué debería importarle a gente no técnica? Porque las APIs representan el 71% del tráfico web dinámico y el 62% de los profesionales de API dicen que generan ingresos directamente. Cuando falla una pasarela de pagos, un servicio de autenticación o una API de envíos, no es un problema abstracto de infraestructura: es pérdida de ingresos, contratos rotos con partners, picos de soporte y confianza erosionada. Producto, ventas, operaciones y customer success también se juegan algo aquí.
Métricas clave que debes vigilar:
- Porcentaje de disponibilidad: proporción del tiempo en que un endpoint está accesible
- Tiempo de respuesta / latencia: cuánto tarda el endpoint en responder (media, p95, p99)
- Tasa de error: porcentaje de solicitudes que devuelven 5xx, timeouts o fallos de validación
- Throughput: solicitudes por segundo/minuto
- Corrección: si la API devuelve los datos esperados, no solo un 200 OK
Cómo evaluamos las mejores herramientas de monitorización de API para 2026
La mayoría de los artículos de "mejores herramientas de monitorización de API" se limitan a acumular nombres de proveedores y listas de funciones. Yo quise ser más riguroso con los criterios de selección: en parte porque pasé bastante tiempo leyendo foros de desarrolladores, y en parte porque el equipo de Thunderbit me ayudó a extraer en bloque datos de precios y funciones de las webs de los proveedores para construir una comparación real (más sobre ese flujo más adelante).
Esto es lo que ponderamos:
| Criterio | Por qué importa |
|---|---|
| Facilidad de configuración / tiempo hasta la primera alerta | Los equipos pequeños necesitan cobertura hoy, no después de un proyecto de plataforma |
| Inteligencia de alertas y reducción de ruido | Si las alertas hacen ruido, el equipo las ignora y se pierde incidentes reales |
| Generosidad del plan gratis | Los proyectos paralelos y las startups tempranas suelen empezar gratis |
| Transparencia de precios | Las facturas de observabilidad pueden dispararse por hosts, usuarios, logs, ejecuciones sintéticas e ingesta de datos |
| Amplitud de integraciones | Las alertas deben llegar donde el equipo ya trabaja (Slack, PagerDuty, etc.) |
| Escalabilidad y profundidad de datos | Los equipos maduros necesitan trazas, logs, APM, RBAC, SSO y retención |
| Calidad de la comunidad y del soporte | Los equipos open source necesitan ritmo de lanzamientos; los enterprise necesitan SLA |
| Capacidad de extracción de datos web | Las apps de IA, los flujos RAG y las herramientas de análisis de mercado suelen necesitar datos externos limpios, no solo uptime del endpoint |
También segmentamos las recomendaciones por caso de uso —desarrollador individual, startup, e-commerce/SaaS, enterprise, purista open source, equipo de producto API y equipo de datos web/IA— para que vayas directo a tu contexto en vez de leer 14 resúmenes adivinando cuál aplica. La encuesta de Grafana de 2025 encontró que el 46% de los encuestados citó la interoperabilidad y el 35% la facilidad para cambiar en el futuro como criterios de selección: no son solo extras bonitos.
Mejores herramientas de monitorización de API por caso de uso: tabla rápida
Este es el atajo. Encuentra tu fila y luego ve a las secciones de herramientas más abajo para el desglose completo.
| Caso de uso | Herramientas recomendadas | Diferenciador clave |
|---|---|---|
| Equipos de datos web / apps de IA | Thunderbit Open API, Moesif, Apitally | Convierte sitios web en Markdown limpio o JSON estructurado para flujos LLM, RAG, precios e investigación |
| Desarrollador individual / proyecto paralelo | UptimeRobot, Uptime Kuma, Gatus | Gratis o autoalojado, configuración mínima, arranque rápido |
| Startup (equipo de 5 a 15 personas) | Checkly, Better Stack, Postman | Alertas inteligentes, puesta en marcha rápida, precio razonable, páginas de estado |
| E-commerce / SaaS | Datadog, New Relic, Moesif, Checkly | Métricas de negocio, APM/tracing, profundidad de SDK, sintéticos de varios pasos |
| Enterprise / multicloud | Datadog, New Relic, Splunk, Grafana Cloud | Trazas distribuidas, cumplimiento, híbrido, RBAC/SSO |
| Puristas open source | Prometheus + Grafana, Uptime Kuma, Gatus, Uptrace | Control total, nativo de OTel, sin vendor lock-in |
| Equipos de producto API | Moesif, Apitally, New Relic | Uso por cliente, tendencias de endpoints, alertas de anomalías |
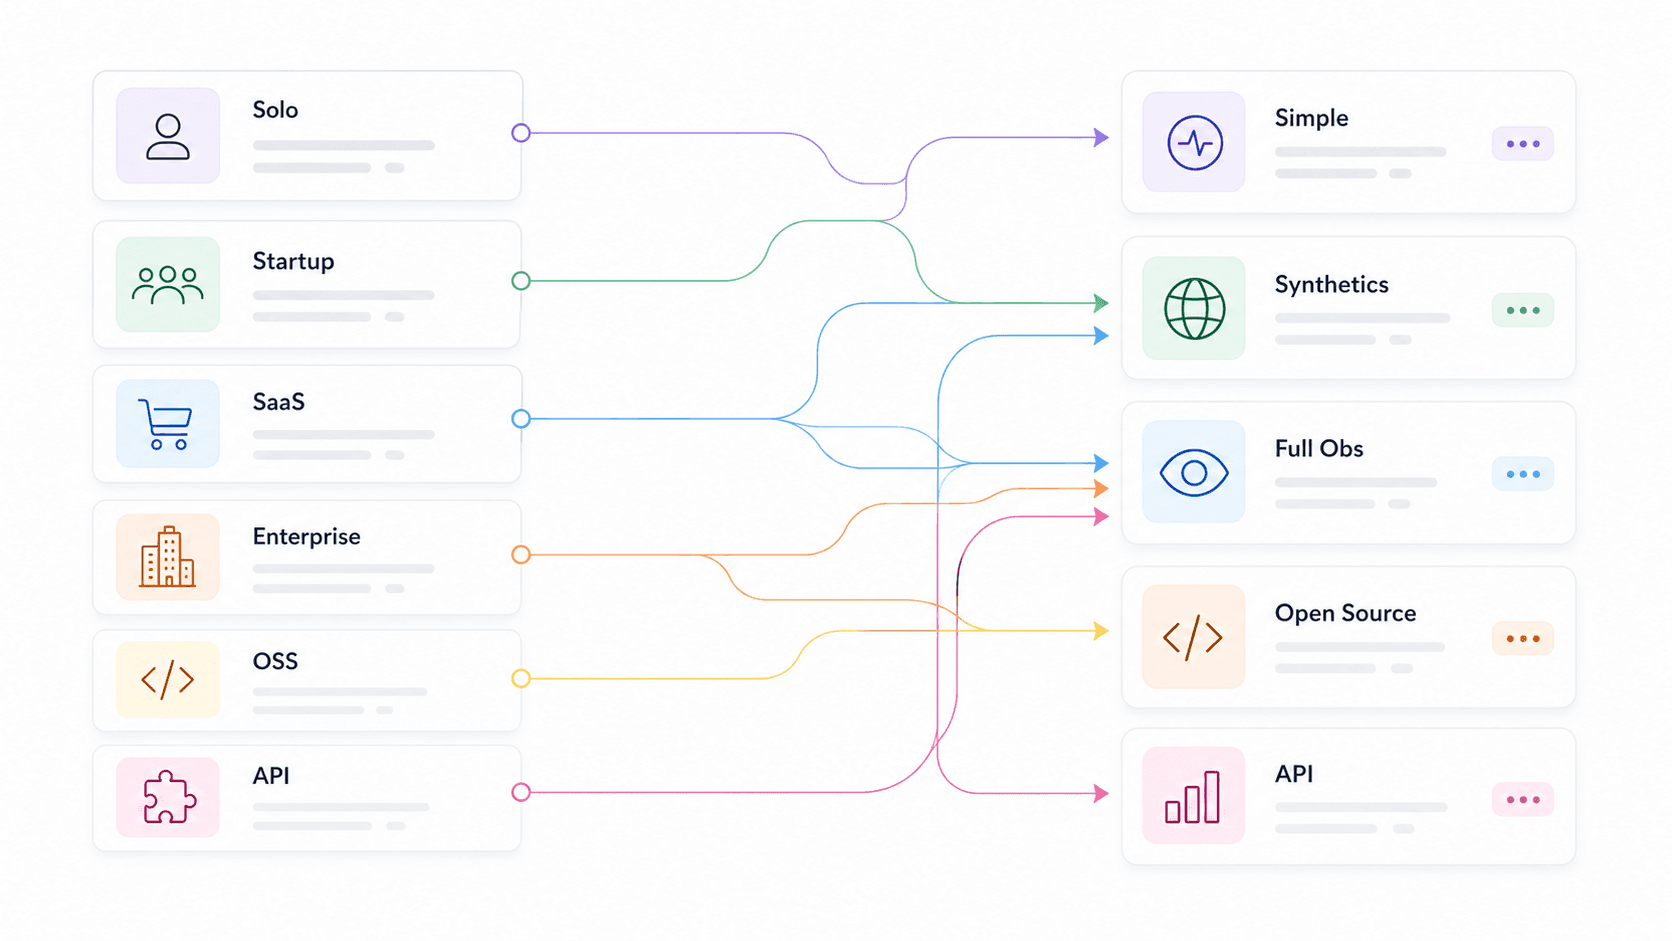
El patrón más claro: las herramientas más rápidas de configurar suelen ofrecer menos analítica, mientras que las plataformas más profundas exigen más configuración y disciplina de costes. No es un defecto, es un intercambio a entender. Thunderbit juega en una liga distinta: destaca cuando la tarea es convertir páginas web en datos listos para API, no avisar a ingeniería de una caída.
Thunderbit Open API: la mejor opción para convertir sitios web en datos estructurados para API
Empieza a construir con Thunderbit Open API Convierte páginas en Markdown, extrae JSON estructurado y procesa URLs por lotes sin mantener infraestructura de scraping. Get Started Free
Thunderbit Open API es la API que yo pondría primero para equipos cuyo flujo de "monitorización" o investigación depende de datos web externos. No es una herramienta tradicional de monitorización de uptime como Checkly o UptimeRobot. Thunderbit convierte cualquier página web en datos limpios y estructurados que tus apps, agentes, dashboards y pipelines de LLM sí pueden usar.
La API tiene tres flujos principales. Distill convierte una página en Markdown limpio y listo para LLM. Extract toma un esquema y devuelve campos JSON estructurados como nombre del producto, precio, disponibilidad, tamaño de la empresa, etapa de financiación o valoración de reseñas. Batch permite procesar hasta 100 URLs de forma asíncrona con webhooks, útil cuando supervisas páginas de precios, catálogos de competidores, documentación de proveedores, fuentes de noticias o grandes listas de investigación.
Merece estar en una guía de herramientas de API porque muchos equipos subestiman cuánta infraestructura exige "solo extrae esta página". Los sitios pesados en JavaScript necesitan renderizado. Algunas páginas requieren georouting. El HTML debe limpiarse de menús, anuncios, modales y texto repetitivo antes de ser útil para un LLM. Los selectores se rompen cuando cambia el diseño. La rotación de proxies, el manejo anti-bot, los reintentos, las colas y la consulta de resultados pueden convertir un pequeño flujo de datos en un proyecto de mantenimiento. Thunderbit absorbe gran parte de ese trabajo detrás de una sola API.
Ideal para: creadores de apps de IA, equipos RAG, operaciones de e-commerce, sales ops, growth, analistas de mercado y desarrolladores que necesitan datos web vía API sin construir ni mantener una pila de scraping.
Precio: Gratis: 600 unidades API de un solo uso, incluyendo hasta 600 páginas Distill o 30 páginas Extract, con 2 solicitudes concurrentes. El plan Starter figura en $16/mes con facturación anual para 60.000 unidades API/año y 30 solicitudes concurrentes. El plan Pro figura en $40/mes con facturación anual para 600.000 unidades API/año y 50 solicitudes concurrentes.
Velocidad de puesta en marcha: ~5–15 minutos para obtener una clave API y ejecutar la primera solicitud Distill o Extract con cURL, SDKs o la CLI de Thunderbit.
Inconvenientes: Thunderbit no sustituye a Datadog, New Relic, Better Stack o Checkly para comprobaciones de uptime, escalado de incidentes, trazas, logs o enrutamiento de guardias. Piensa en él como la API para recopilar y estructurar datos web —precios de proveedores, documentación, páginas de competidores, listados de productos o datasets públicos— no como el sistema que despierta a tu ingeniero de guardia.
Datadog: la mejor opción para visibilidad de extremo a extremo
Datadog es la herramienta que más veo en stacks enterprise y SaaS de mercado medio, y por buena razón. No es solo monitorización de API: es una plataforma completa de observabilidad que conecta pruebas sintéticas de API con trazas distribuidas, logs, métricas de infraestructura y monitorización de usuario real en una sola vista.
Datadog admite HTTP, SSL, DNS, WebSocket, TCP, UDP, ICMP, gRPC y pruebas de API de varios pasos. Sus monitores de detección de anomalías aprenden patrones esperados y alertan sobre desviaciones en vez de umbrales estáticos, una mejora real frente a "alerta si la latencia supera 500 ms". También ofrece monitores de previsión que predicen cuándo una métrica superará un umbral, y monitores compuestos que combinan varias condiciones.
Ideal para: equipos de e-commerce, SaaS y enterprise que necesitan una sola consola para APIs, infraestructura, logs y trazas.
Precio: los detalles del plan gratis varían según el producto. Infrastructure Pro empieza en $15 por host/mes; las pruebas sintéticas de API cuestan $5 por cada 10.000 ejecuciones. Más de 800 integraciones.
Velocidad de puesta en marcha: ~15–30 minutos para instalar el agente y crear una prueba sintética básica.
Inconvenientes: puede encarecerse a escala: el "susto en la factura" es un tema recurrente en Hacker News y Reddit. La cantidad de SKU (hosts, logs, métricas personalizadas, sintéticos, usuarios) obliga a que alguien vigile la factura, no solo los paneles. La curva de aprendizaje es real en la plataforma completa.
Checkly: la mejor opción para comprobaciones sintéticas orientadas a desarrolladores
Checkly es la herramienta que daría a un equipo de ingeniería de una startup que quiere tener las comprobaciones de API cerca del código. Su idea central es "monitorización como código": definir checks de API y de navegador programáticamente, ejecutarlos desde ubicaciones globales, integrarlos con pipelines CI/CD y gestionar todo desde Git.
La calidad de las alertas es un punto fuerte aquí. La lógica de reintentos de Checkly se presenta como la "primera línea de defensa" contra falsos positivos: puedes configurar reintentos fijos, lineales o exponenciales, desde la misma ubicación o desde otra, y duraciones máximas antes de que salte una alerta. También distingue entre degradado, fallido y recuperado, lo que reduce alertas ruidosas.
Ideal para: startups y equipos de desarrollo que quieren checks programables de API, checks de navegador basados en Playwright, integración CI/CD y arranque rápido.
Precio: datos públicos recientes muestran un plan gratis con 10 monitores de uptime, 1.000 checks de navegador y 10.000 checks de API. Starter ronda los $24/mes con facturación anual; comprueba la página oficial de precios antes de comprar.
Velocidad de puesta en marcha: ~10–20 minutos para una primera comprobación de API y un canal de alerta.
Inconvenientes: centrado en checks sintéticos. No sustituye a un APM profundo, analítica de logs ni trazas distribuidas. Si necesitas correlacionar un fallo de API con un cuello de botella en la base de datos, te hará falta otra herramienta.
UptimeRobot: la mejor opción para un seguimiento de uptime simple y asequible
UptimeRobot es el Honda Civic de la monitorización de API. Hace una cosa muy bien: creas un monitor HTTP, por palabra clave, ping, puerto, SSL o heartbeat, eliges el intervalo y recibes una alerta cuando falla. Eso es todo.
Ideal para: desarrolladores individuales, equipos pequeños, agencias o cualquiera que necesite seguimiento básico de uptime y latencia sin complejidad.
Precio: Gratis: 50 monitores, intervalos de 5 minutos. Plan Solo de pago alrededor de $7/mes con facturación anual. No hace falta tarjeta de crédito para el plan gratis. Velocidad de puesta en marcha: ~2–5 minutos, la más rápida de esta lista.
Inconvenientes: inteligencia de alertas limitada. Alertas básicas por umbral, sin detección de anomalías, sin trazas distribuidas, sin analítica profunda. Si necesitas saber por qué un endpoint va lento, y no solo que va lento, UptimeRobot no te llevará ahí.
Uptime Kuma: la mejor herramienta gratis y autoalojada para monitorización de API
Uptime Kuma es el favorito de la comunidad self-hosting, y sus cifras en GitHub lo respaldan: 86.637 estrellas, 7.831 forks, 1.060 colaboradores, y versión 2.3.2 a mayo de 2026. Tiene licencia MIT y soporta HTTP(s), palabras clave, consultas JSON, WebSocket, TCP, ping, DNS, push, Docker, múltiples páginas de estado y más de 90 servicios de notificación.
Ideal para: desarrolladores individuales y equipos que quieren control total, privacidad y coste SaaS recurrente cero, si tienen un servidor.
Precio: gratis. El coste real es tu VM/contenedor, las copias de seguridad, las actualizaciones y asegurarte de que el propio monitor siga funcionando. Velocidad de puesta en marcha: ~5–15 minutos con Docker para una comprobación básica; 15–30 minutos si quieres pulir notificaciones y la página de estado.
Inconvenientes: tú te encargas del mantenimiento. Y aquí está la trampa crítica: si alojas Uptime Kuma en la misma infraestructura que está monitorizando, una caída de nube o DNS tumba tanto tu app como tu monitor. Aloja el monitor fuera o combínalo con un check SaaS.
Better Stack: la mejor opción para responder rápido a incidentes
Better Stack (que muchos usuarios siguen llamando Better Uptime) combina monitorización de uptime con gestión de incidentes, turnos de guardia, políticas de escalado y páginas de estado en una sola plataforma. Su punto fuerte no es tanto la analítica como el flujo de trabajo de incidentes alrededor de la monitorización.
Las políticas de escalado definen quién recibe la alerta, en qué orden y con qué retrasos, hasta que alguien confirma el incidente. El enrutamiento basado en metadatos envía incidentes según severidad o propiedad. Se integra con Slack, Teams, webhooks y Zapier.
Ideal para: startups y equipos medianos que quieren monitorización + respuesta a incidentes + páginas de estado sin unir tres herramientas distintas.
Precio: plan gratis: 10 monitores/heartbeats, 1 página de estado. Team ronda los $29/mes con facturación anual. Velocidad de puesta en marcha: ~5–10 minutos con asistente GUI.
Inconvenientes: menos profundidad en analítica de payloads de API, trazas distribuidas o KPIs de negocio que Datadog, New Relic o Moesif.
Prometheus + Grafana: la mejor pila open source para monitorización de API
Es la combinación open source estándar del sector. Prometheus recopila y almacena métricas de series temporales. Grafana (73.705 estrellas en GitHub, 3.010 colaboradores) aporta paneles y alertas. Alertmanager gestiona enrutamiento, agrupación, deduplicación, silenciamiento e inhibición. Para endpoints API, los equipos añaden Blackbox Exporter, que sondea HTTP, HTTPS, DNS, TCP, ICMP y gRPC.
Ideal para: puristas open source, equipos Kubernetes/SRE y organizaciones ya estandarizadas en métricas Prometheus.
Precio: gratis si lo autoalojas. Grafana Cloud tiene un plan gratis (100.000 ejecuciones de pruebas API/mes) y planes de pago por uso.
Velocidad de puesta en marcha: 1–4 horas para un setup básico con Blackbox + Prometheus + Grafana + Alertmanager. Días para alta disponibilidad en producción y ajuste de alertas.
Inconvenientes: PromQL, YAML, relabeling, diseño de dashboards, retención, almacenamiento, HA y ajuste fino de alertas son trabajo operativo real. El intercambio habitual es "menos interfaz, más YAML". Es la pila para equipos que ya piensan en métricas y quieren un plano de control único, no para quienes quieren monitorización lista antes de comer.
New Relic: la mejor opción para rendimiento de aplicaciones SaaS
New Relic combina APM, monitorización de infraestructura, logs, trazas distribuidas, monitorización sintética, alertas, dashboards y análisis de incidentes asistido por IA. Su plan gratis —100 GB/mes de ingesta de datos y 1 usuario full platform— es realmente generoso para equipos pequeños.
Aquí es donde brilla en el debate sobre fatiga de alertas. Sus funciones de incident intelligence incluyen correlación de eventos, detección de anomalías, alertas predictivas, análisis de causa raíz y supresión de flapping. New Relic publicó un ejemplo en el que una eficacia de flapping del 97,2% deja solo 28 incidencias visibles por cada 1.000 incidentes con flapping: un número concreto de reducción de ruido.
Ideal para: equipos SaaS y plataformas de e-commerce que quieren una monitorización de API estrechamente integrada con trazas, errores, throughput e impacto en el usuario.
Precio: gratis: 100 GB/mes, 1 usuario completo. Los planes de pago usan precios por usuario y por volumen de datos.
Velocidad de puesta en marcha: ~15–30 minutos para instalar el agente y seguir una configuración guiada.
Inconvenientes: el precio puede complicarse a escala. La configuración de alertas tiene curva de aprendizaje: la plataforma es potente, pero no es obvia de inmediato.
Moesif: la mejor opción para analítica de API y métricas de negocio
Moesif no es un monitor de disponibilidad tradicional. Es analítica de API e inteligencia de producto: entender el uso de la API por cliente, endpoint, cohorte, empresa, geografía, SDK, plan y comportamiento. Si tu pregunta es "¿qué cliente se ve afectado?" en lugar de "¿está arriba el endpoint?", Moesif está pensado para eso.
Admite alertas estáticas por umbral y alertas dinámicas por anomalías para métricas de API como picos o caídas de tráfico, latencia y cambios de comportamiento. Las alertas dinámicas necesitan unos días de comportamiento de la API para construir un modelo, pero una vez entrenadas detectan cambios que las reglas estáticas pasan por alto.
Ideal para: equipos de producto API, empresas SaaS y plataformas de e-commerce que necesitan conectar rendimiento de API con ingresos, engagement y retención.
Precio: hay plan gratis o de prueba; los planes de pago escalan con el volumen de eventos API. Mi investigación no pudo rastrear del todo los importes self-service; conviene comprobar la página actual.
Velocidad de puesta en marcha: ~20–45 minutos (la integración por SDK/proxy/gateway es más profunda que un ping externo).
Inconvenientes: más orientado a analítica que a monitorización tradicional de uptime. Probablemente querrás combinar Moesif con Checkly, UptimeRobot o sintéticos de Datadog para comprobaciones externas de disponibilidad.
Splunk: la mejor opción para análisis de logs y cumplimiento en enterprise
Splunk es la herramienta a la que recurres cuando agregación de logs, búsqueda, correlación, trazabilidad para compliance y soporte híbrido/multicloud son innegociables. Splunk Observability Cloud cubre infraestructura, APM, sintéticos, monitorización de usuario real, logs y respuesta a incidentes. ITSI/Event Analytics agrupa eventos relevantes en episodios y reduce el ruido entre silos de monitorización.
La propia investigación de observabilidad de 2025 de Splunk es reveladora: 73% de ITOps/ingeniería reportó caídas por alertas ignoradas o suprimidas, 59% luchaba con demasiadas herramientas distintas y 52% tenía problemas con falsos positivos.
Ideal para: equipos enterprise y multicloud con requisitos estrictos de cumplimiento, seguridad, auditoría y búsqueda de logs.
Precio: basado en uso y con proceso comercial. Sin un plan gratis sencillo para producción.
Velocidad de puesta en marcha: el onboarding en la nube puede ser más rápido, pero el despliegue enterprise suele llevar de días a semanas.
Inconvenientes: caro a escala. Configuración compleja. Excesivo para desarrolladores individuales y startups pequeñas.
Postman: la mejor opción para equipos que ya prueban APIs
Postman es principalmente una plataforma de desarrollo y testing de APIs, pero su producto de monitorización permite programar colecciones de Postman y ejecutarlas desde ubicaciones en la nube. El argumento más fuerte es el reaprovechamiento: si tu equipo de QA o desarrollo ya tiene colecciones con aserciones, convertirlas en monitores es un paso natural.
Ideal para: equipos de desarrollo y QA que ya usan colecciones de Postman y quieren comprobaciones programadas sin comprar una herramienta sintética aparte.
Precio: existe plan gratis. El exceso de monitorización cuesta $0,75 por cada 1.000 llamadas; además hay un bloque adicional de 50.000 llamadas por $20/mes. Conviene verificar la página actual de planes porque el empaquetado cambia.
Velocidad de puesta en marcha: ~10 minutos si ya existen colecciones.
Inconvenientes: las capacidades de monitorización son más ligeras que las de herramientas dedicadas como Checkly, Datadog o New Relic. Las opciones de alerta son básicas.
Otras herramientas de monitorización de API que merece la pena mirar
Gatus: panel de salud ligero, autoalojado y basado en configuración. 10.906 estrellas en GitHub, compatible con HTTP, ICMP, TCP, DNS, métricas compatibles con Prometheus y distintivos de uptime. Bueno para desarrolladores individuales que quieren algo más simple que Prometheus pero prefieren YAML/config-as-code frente a la interfaz de Uptime Kuma.
Apitally: herramienta más reciente centrada en analítica de tráfico API y seguimiento de calidad para startups. Afirma configurarse en menos de 5 minutos con alertas personalizadas sobre 14 métricas. Buena para analítica ligera de API sin adoptar una plataforma completa de observabilidad.
Sematext: monitorización full-stack con logs, sintéticos y visibilidad de infraestructura. Sintéticos alrededor de $2 por monitor HTTP, $7 por monitor de navegador, mínimo $5/mes. Una alternativa a Datadog de menor coste para equipos de mercado medio.
Uptrace: backend nativo de OpenTelemetry para APM, trazas, métricas y logs. 4.198 estrellas en GitHub. No es un comprobador puro de uptime, pero es ideal para equipos estandarizados en OTel que quieren un backend de trazas de código abierto.
Construir o comprar: ¿deberías montar tu propia monitorización de API?
"¿No sería mejor escribir un script que haga ping a mis endpoints, en vez de usar una herramienta específica?"
Esta pregunta aparece constantemente en foros de desarrolladores. He leído suficientes hilos de Reddit como para ver el patrón con claridad: los equipos empiezan con curl + cron, funciona bastante bien durante un tiempo y luego cambian cuando necesitan dashboards, histórico, comprobaciones multirregión, enrutamiento fiable de alertas o visibilidad entre equipos.
Una matriz de decisión honesta:
| Factor | Script personalizado | Herramienta especializada |
|---|---|---|
| Tiempo de configuración | 1–4 horas (básico); días (robusto) | 5–30 minutos |
| Mantenimiento | Te lo quedas para siempre | El proveedor gestiona las actualizaciones |
| Calidad de alertas | Básica (up/down) | Inteligente (tendencias de latencia, anomalías, reintentos) |
| Coste | Gratis (tu tiempo) | $0–500+/mes |
| Dashboard | Construir desde cero | Prehecho y personalizable |
| Mejor cuando… | ≤3 endpoints, equipo muy técnico, proyecto hobby | 5+ endpoints, equipo de operaciones/producto, ingresos en juego |
La idea clave de los foros: quienes construyen su propia solución suelen arrepentirse cuando necesitan dashboards, histórico o visibilidad transversal entre equipos. Y está el problema meta: "necesitas monitorización para tu monitorización". Un monitor autoalojado, su base de datos, copias de seguridad, ruta de red y proveedor de alertas también deben ser fiables.
Construye si tienes 2 endpoints y te gusta trastear. Compra si tienes un producto que lanzar.
La misma lógica aplica a la extracción de datos web. Puedes escribir un scraper, ejecutar navegadores headless, rotar proxies, mantener selectores, limpiar HTML y montar una cola. Pero si el objetivo es alimentar de forma fiable un producto API, un agente de IA o un flujo de investigación con datos web, usar Thunderbit Open API suele ser más rápido que montar tu propia infraestructura de scraping.
Fatiga de alertas: por qué la calidad gana a la cantidad
Este quizá sea el criterio más infravalorado al elegir una herramienta de monitorización de API. La fatiga de alertas aparece cuando los equipos reciben tantas alertas ruidosas, duplicadas o poco accionables que empiezan a ignorarlas todas y, entonces, se les escapan los incidentes reales.
Las cifras son llamativas. El informe 2025 de BigPanda encontró que la organización mediana generaba 2.350 alertas al día y 803.406 al año. La accionabilidad mediana era solo del 18%: menos de una de cada cinco incidencias derivadas de alertas era realmente accionable. La encuesta 2026 de NeuBird encontró que el 77% de los equipos de guardia recibe al menos 10 alertas al día y el 80% dice que la mitad o menos son accionables.
La mejor herramienta de monitorización es la que genera alertas en las que de verdad confías. Así manejan la inteligencia de alertas las distintas herramientas:
| Herramienta | Tipo de alerta | Método de reducción de ruido | Canales de alerta |
|---|---|---|---|
| Datadog | Anomalía ML, previsión, compuesta | Bandas históricas de anomalías, líneas base dinámicas, Watchdog AI | Slack, PagerDuty, Opsgenie, Teams, más de 20 |
| Checkly | Umbral + degradación | Reintentos antes de disparar, reintentos misma/diferente ubicación | Slack, PagerDuty, Opsgenie, Teams, incident.io |
| New Relic | Agrupación de problemas con IA, anomalía, predictiva | Correlación de eventos, supresión de flapping, contexto de causa raíz | Slack, PagerDuty, Teams, webhooks |
| Moesif | Anomalía de comportamiento | Modelos dinámicos tras varios días de comportamiento | Slack, PagerDuty, email, SMS |
| Better Stack | Uptime/incidentes/guardia | Políticas de escalado, enrutamiento por propiedad, retrasos | Slack, Teams, webhooks, Zapier |
| Prometheus + Alertmanager | Alertas por reglas PromQL | Agrupación, deduplicación, silenciamiento, inhibición | Email, PagerDuty, Opsgenie, webhooks |
| Splunk | Eventos, episodios, estado del servicio | ITSI Event Analytics, agrupación de episodios, ticketing | Splunk On-Call, ServiceNow, webhooks |
| Thunderbit Open API | No es una plataforma de alertas | Úsalo con tu propio scheduler, herramienta de flujo o stack de monitorización | Webhooks para trabajos por lotes; las alertas se gestionan fuera |
Consejo práctico: empieza con menos alertas y de mayor confianza. Usa reintentos antes de disparar, confirmación multirregión, alertas por burn rate de SLO, deduplicación y enrutamiento por propiedad. Alerta sobre impacto al usuario y flujos críticos de negocio (fallo en checkout, fallo de autenticación, 5xx en pagos), no sobre cada síntoma interno.
Planes gratis y precios de 2026: lo que realmente pagas
Las páginas de precios cambian. Los planes gratis se mueven. Los costes ocultos (hosts, usuarios, logs, ejecuciones sintéticas, ingesta de datos) pueden sorprenderte. Esta es la sección que me gustaría que existiera en todos los artículos de "mejores herramientas". La foto de 2026:
| Herramienta | Plan gratis | El plan de pago empieza en | ¿Requiere tarjeta? | Mejor caso de uso gratis |
|---|---|---|---|---|
| Thunderbit Open API | 600 unidades API de un solo uso | ~$16/mes anual | No | Extracción de datos web para LLM, RAG, precios e investigación |
| Uptime Kuma | Ilimitado (autoalojado) | — | No | Monitorización completa, tu propio servidor |
| UptimeRobot | 50 monitores, intervalos de 5 min | ~$7/mes | No | Comprobaciones básicas de uptime |
| Better Stack | 10 monitores, 1 página de estado | ~$29/mes | No | Uptime + página de estado para startups |
| Checkly | 10 uptime, 10.000 checks API | ~$24/mes | Sí | Checks sintéticos de API |
| Postman | Cuenta gratis + cuota de monitorización | ~$14/usuario/mes | No | Reutilizar colecciones existentes |
| Prometheus + Grafana | Ilimitado (autoalojado) | — | No | Métricas + visualización |
| Grafana Cloud | 100.000 ejecuciones de pruebas API/mes | $29/mes de plataforma + uso | Verificar | Prueba de sintéticos gestionados |
| New Relic | 100 GB/mes, 1 usuario full | Por usuario + datos | Algunos planes | APM + observabilidad básica |
| Datadog | Prueba/varía según producto | $15/host/mes (Infra Pro) | A menudo sí | Evaluación full-stack |
| Moesif | Plan gratis/prueba disponible | Basado en volumen | Verificar | Evaluación de analítica API |
| Splunk | Pruebas disponibles | Basado en presupuesto | Flujo comercial | Prueba de concepto enterprise |
| Gatus | Ilimitado (autoalojado) | — | No | Panel de estado basado en YAML |
| Apitally | Plan gratis/prueba disponible | Verificar | Verificar | Analítica ligera de API |
| Sematext | La prueba/el plan gratis varía | ~$2 por monitor HTTP | Verificar | Sintéticos y logs de menor coste |
| Uptrace | Gratis autoalojado | Los tiers cloud varían | Verificar | Evaluación de APM con OTel |
Nota sobre costes ocultos: las herramientas autoalojadas (Uptime Kuma, Prometheus, Gatus) son "gratis" en términos de licencia, pero una pequeña VM, las copias de seguridad, el tiempo de mantenimiento y el failover externo pueden convertirse fácilmente en el coste real. En las APIs de datos web, el coste oculto suele ser distinto: mantener navegadores headless, selectores rotos, pools de proxies, trucos anti-bot y limpieza de HTML.
Estimación para equipos pequeños: para 10 endpoints de API y 3 miembros de equipo, la ruta SaaS más barata suele ser UptimeRobot gratis o de bajo coste, Better Stack gratis/Team, o Checkly si el volumen de ejecuciones encaja. Datadog y New Relic pueden ser asequibles para evaluar, pero la factura real depende de hosts, usuarios, logs, trazas y volumen sintético. Si tu proyecto necesita datos web como API, las unidades gratis de Thunderbit bastan para probar el flujo antes de pasar a un plan de pago.
Panel de complejidad de configuración: cuánto tardas en llegar a la primera alerta
Ningún artículo de la competencia evalúa el tiempo hasta el valor: cuánto pasa desde el registro hasta recibir tu primera alerta realmente útil. Para equipos pequeños, esto importa más que la profundidad funcional.
| Herramienta | Tiempo hasta la primera alerta | Nivel técnico necesario | Forma de configuración |
|---|---|---|---|
| Thunderbit Open API | ~5–15 min | Bajo–medio | Clave API, cURL/SDK/CLI |
| UptimeRobot | ~2–5 min | Bajo | GUI, añadir con clic |
| Better Stack | ~5–10 min | Bajo | Asistente GUI |
| Checkly | ~10–20 min | Bajo–medio | Código o GUI |
| Postman | ~10 min (con colecciones) | Bajo–medio | Programador de colecciones |
| Uptime Kuma | ~5–30 min | Medio | Docker + GUI |
| Gatus | ~15–45 min | Medio | YAML + Docker |
| Datadog | ~15–30 min | Medio | Instalación de agente + GUI |
| New Relic | ~15–30 min | Medio | Agente + configuración guiada |
| Moesif | ~20–45 min | Medio | Integración SDK/proxy |
| Grafana Cloud Synthetics | ~15–45 min | Medio | GUI, Terraform opcional |
| Prometheus + Grafana | 1–4 horas | Medio–alto | YAML, PromQL |
| Uptrace | 30–90 min | Medio–alto | Integración OTel SDK |
| Splunk | Horas a semanas | Alto | Onboarding enterprise |
Si la monitorización tiene que estar activa hoy, empieza en la mitad superior de la tabla. Si el objetivo es una observabilidad de plataforma duradera, plantea un proyecto aparte para la mitad inferior. Y si tu primer hito es "meter datos limpios de estas 100 páginas web en una app", empieza con Thunderbit antes de construir infraestructura de scraping a medida.
Comparativa completa de las mejores herramientas de monitorización de API
Una tabla para revisar antes de decidir:
| Herramienta | Mejor caso de uso | Plan gratis | Inteligencia de alertas | Tiempo de configuración | Alojamiento | Función destacada |
|---|---|---|---|---|---|---|
| Thunderbit Open API | Extracción de datos web/pipelines de datos API | 600 unidades API | No es herramienta de alertas | 5–15 min | Cloud | Convierte páginas en Markdown o extrae JSON basado en esquema |
| Datadog | Enterprise/SaaS full-stack | Prueba/varía | Anomalías, previsión, IA | 15–30 min | Cloud | Correlaciona sintéticos con logs/trazas/infra |
| Checkly | Sintéticos para desarrolladores | Generoso basado en checks | Reintentos, degradación | 10–20 min | Cloud | Monitoring as code + Playwright |
| UptimeRobot | Uptime simple | 50 monitores | Umbrales básicos | 2–5 min | Cloud | El monitor básico de bajo coste más rápido |
| Uptime Kuma | Autoalojado gratis | Ilimitado | Estado/umbral básico | 5–30 min | Autoalojado | UI limpia, sin cuota SaaS |
| Better Stack | Respuesta a incidentes/páginas de estado | 10 monitores | Escalados, enrutamiento | 5–10 min | Cloud | Monitorización + guardia + página de estado |
| Prometheus + Grafana | Stack open source de métricas | Ilimitado (autoalojado) | Agrupación de Alertmanager | 1–4 h | Autoalojado/cloud | Profundidad del ecosistema PromQL |
| New Relic | APM SaaS + checks de API | 100 GB/mes, 1 usuario | Agrupación con IA, supresión de flapping | 15–30 min | Cloud | Gran APM + sintéticos juntos |
| Moesif | Analítica de API/métricas de negocio | Gratis/prueba | Anomalías de comportamiento | 20–45 min | Cloud | Analítica del comportamiento por cliente |
| Splunk | Logs enterprise/cumplimiento | Prueba | Episodios ITSI, AIOps | Días+ | Cloud/gestionado por ti | Búsqueda de logs y gobernanza empresarial |
| Postman | Equipos que ya prueban APIs | Cuenta gratis | Alertas básicas de monitorización | 10 min | Cloud | Reutiliza colecciones de pruebas API |
Cómo puede Thunderbit acelerar la evaluación de tu herramienta de API
Aviso de transparencia: Thunderbit no es una herramienta de monitorización de API; es un scraper web agéntico y una Open API para convertir páginas en Markdown limpio o JSON estructurado. Eso la hace útil en otra parte del proceso de decisión: recopilar precios de proveedores, límites de planes, funciones, documentación e integraciones antes de elegir plataforma.
En lugar de abrir manualmente más de 10 páginas de precios y copiar nombres de planes, límites de monitores, intervalos de comprobación, integraciones y requisitos de tarjeta en una hoja de cálculo, usamos la extensión de Chrome de Thunderbit para extraer datos estructurados de las páginas de precios y funciones de cada herramienta. La IA de Thunderbit lee cada página y sugiere campos —nombre del plan, detalles del plan gratis, precio de pago, integraciones compatibles— y estructura la salida en una hoja exportable.
Para flujos de trabajo de desarrollador, Thunderbit Open API da la misma idea de forma programática. Usa Distill cuando quieras Markdown limpio para LLMs o RAG. Usa Extract cuando necesites campos concretos devueltos como JSON. Usa Batch cuando tengas que procesar una lista de páginas de precios, URLs de documentación, páginas de producto o páginas de competidores y recibir resultados de forma asíncrona.
El flujo es este:
- Abre la página de precios de un proveedor (Datadog, Checkly, UptimeRobot, etc.)
- Haz clic en "One Click Extract": la IA de Thunderbit lee la página, entiende su estructura y rellena una tabla en una sola pasada
- Usa el scraping de subpáginas para visitar las páginas de precios, funciones y documentación de cada proveedor
- Exporta a Google Sheets, Excel, Airtable, Notion o CSV
Para equipos que trabajan primero con API, el flujo con la API es igual de directo:
- Obtén una clave API gratuita de Thunderbit
- Llama al endpoint Distill para obtener Markdown limpio de cualquier página pública
- Llama al endpoint Extract con descripciones de esquema para obtener JSON estructurado
- Usa los endpoints Batch y los webhooks para listas de URLs más grandes
- Envía la salida a tu app, hoja de cálculo, warehouse, base vectorial o flujo de monitorización
Para comparar más de 10 proveedores, el copiar y pegar manual puede llevar fácilmente 2–3 horas si sumas subpáginas de precios, documentación e integraciones. Thunderbit redujo nuestra extracción inicial a unos 15–30 minutos, con el tiempo restante en verificación y decisiones. Si tu equipo de operaciones, compras, investigación o producto de IA evalúa herramientas con presión de tiempo, es un atajo práctico. Más sobre este flujo en nuestra guía de web scraping sin programar, en los precios de Thunderbit API o en nuestro canal de YouTube.
Cómo elegir la mejor herramienta de monitorización de API para tu equipo
La mejor herramienta de monitorización de API depende del tamaño de tu equipo, su profundidad técnica, el presupuesto y qué significa un fallo para tu producto.
Un desarrollador individual no necesita Splunk. Una empresa regulada no debería depender de un cron job. Un equipo de producto API puede necesitar más analítica de cliente al estilo Moesif que pings de uptime. Un equipo de e-commerce debería priorizar checks críticos de login, búsqueda, carrito, checkout y autorización de pago. Un equipo de IA o de datos quizá necesite primero extracción de datos web al estilo Thunderbit, antes que observabilidad completa.
Tres principios que se mantuvieron en toda mi investigación:
- Adapta la herramienta al caso de uso. La tabla rápida existe por una razón: empieza por ahí.
- Prioriza la calidad de las alertas por encima de la cantidad. Si tu equipo ignora las alertas, no tienes monitorización. Tienes ruido.
- No subestimes la velocidad de puesta en marcha. Un monitor que entra en producción hoy y envía alertas fiables es mejor que un plan de plataforma perfecto que deja el checkout sin supervisar otro mes.
Si estás comparando varias herramientas a la vez y quieres acelerar la investigación, prueba Thunderbit para extraer en bloque los datos de los proveedores en una sola hoja de cálculo. Si estás construyendo un producto API, un pipeline RAG, un agente de IA o un flujo de inteligencia de mercado que necesita datos web limpios, empieza con Thunderbit Open API. No elegirá por ti la herramienta de monitorización, pero te llevará antes a la decisión y puede darle a tu propio producto una capa fiable de datos web.
Preguntas frecuentes sobre las mejores herramientas de monitorización de API
¿Cuál es la mejor herramienta gratuita de monitorización de API en 2026?
Para simplicidad SaaS, UptimeRobot ofrece 50 monitores gratis con intervalos de 5 minutos y sin tarjeta de crédito. Para control autoalojado, Uptime Kuma es open source, ilimitado y tiene una interfaz limpia con más de 90 servicios de notificación. Para equipos con capacidad técnica que quieren profundidad de métricas, Prometheus + Grafana + Alertmanager es la mejor pila open source, aunque la configuración lleva horas, no minutos.
Si tu objetivo no es monitorizar uptime sino extraer datos web a través de una API, Thunderbit Open API tiene un plan gratis con 600 unidades API de un solo uso, suficiente para probar la conversión de página a Markdown o la extracción JSON basada en esquema antes de escalar.
¿Cuál es la diferencia entre monitorización de API y APM?
La monitorización de API comprueba desde fuera la disponibilidad del endpoint, el tiempo de respuesta, los errores y la corrección; simula lo que experimenta un usuario o una integración. APM (Application Performance Monitoring) va más adentro: trazas a nivel de código, consultas a bases de datos, errores de ejecución, latencia de colas y dependencias de servicio. Datadog y New Relic ofrecen ambas; UptimeRobot y Uptime Kuma se centran en checks externos de uptime.
Thunderbit Open API es distinto de ambos: es una API de extracción de datos web. Te ayuda a convertir sitios web externos en Markdown o JSON estructurado, útil para apps LLM, flujos de investigación, inteligencia de precios y pipelines de datos.
¿Con qué frecuencia debería monitorizar mis APIs?
Las APIs de producción críticas para ingresos (checkout, auth, pagos) normalmente deberían comprobarse cada 1 minuto. Las APIs internas o con poco tráfico pueden comprobarse cada 5 minutos. Pero la frecuencia sola no lo es todo: usa reintentos, varias regiones y aserciones útiles para que cada comprobación sea rápida y fiable. Un check cada minuto con falsos positivos es peor que uno cada 5 minutos en el que puedes confiar.
En flujos de extracción de datos web, la frecuencia depende de la rapidez con que cambie la fuente. Las páginas de precios quizá requieran extracción diaria o semanal. Inventario, viajes o marketplaces, que cambian rápido, pueden necesitar actualización cada hora o más frecuente. La API por lotes y los webhooks de Thunderbit son útiles para procesar muchas URLs según un calendario.
¿Puedo monitorizar APIs sin escribir código?
Sí. UptimeRobot, Better Stack y Uptime Kuma pueden usarse por completo desde interfaces gráficas. Checkly admite configuración por GUI o por código. Postman usa una interfaz basada en colecciones. Prometheus/Grafana suele requerir YAML y PromQL. Datadog y New Relic pueden empezar con configuración guiada, pero se vuelven más potentes con instrumentación profunda.
Si quieres extraer datos web sin escribir código, la extensión de Chrome de Thunderbit es la vía no-code. Si quieres automatizar ese mismo flujo desde una aplicación, Thunderbit Open API ofrece a los desarrolladores endpoints Distill, Extract y Batch.
¿Cómo reduzco la fatiga de alertas en la monitorización de API?
Elige herramientas con alertas inteligentes: detección de anomalías (Datadog, New Relic), reintentos antes de disparar (Checkly), anomalías de comportamiento (Moesif) o agrupación/silenciamiento (Prometheus Alertmanager). Empieza con menos alertas y de mayor confianza, centradas en el impacto visible para el usuario. Usa alertas por burn rate de SLO en vez de umbrales estáticos, deduplica entre servicios, enruta por propiedad y mide la accionabilidad: si menos del 20% de tus alertas llevan a una acción real, reduce el ruido primero.
Prueba Thunderbit Open API para extracción de datos web Get Started Free
Más información



