Wikipedia Scraper pro infoboxy, citace a sekce













Uspořádejte články z Wikipedie pro výzkum
Mějte fakta o článku, hodnoty z infoboxu, citace i kontext sekcí v oddělených polích.
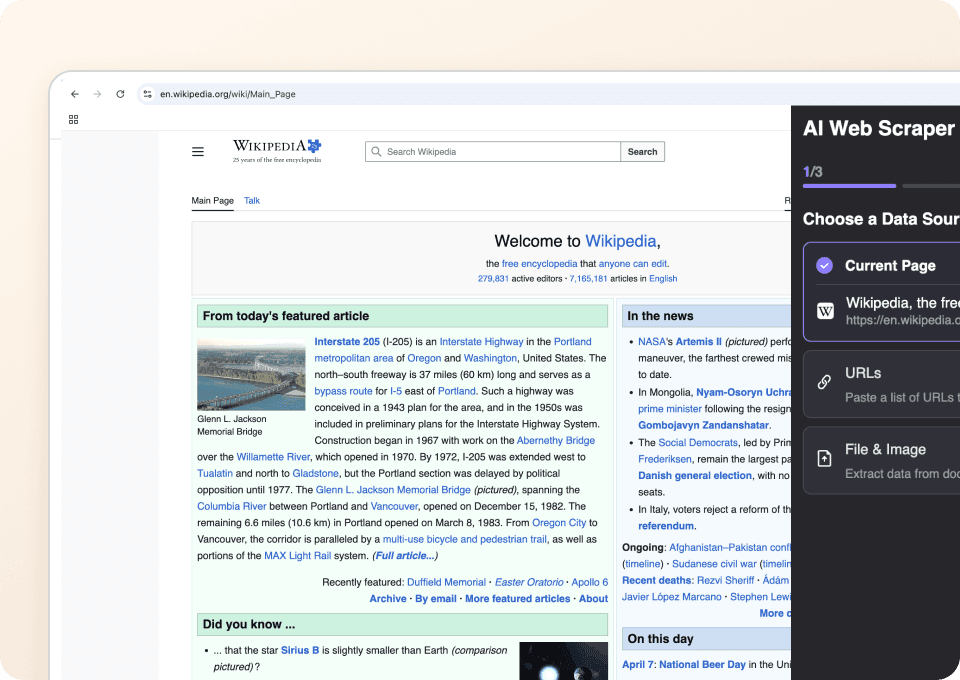
Získejte data z Wikipedie jedním kliknutím
Pro stránku, kterou otevřete, navrhne sloupce a vše dokončí v jednom běhu. Pole můžete upravit nebo přejmenovat přirozeným jazykem a případně spustit znovu.
Pracujte napříč různými typy stránek Wikipedie
Agent čte viditelné popisky, záhlaví a názvy sekcí a podle nich mapuje hodnoty na stránce, ke které máte přístup. Pokud pole na stránce není, sloupec zůstane prázdný.
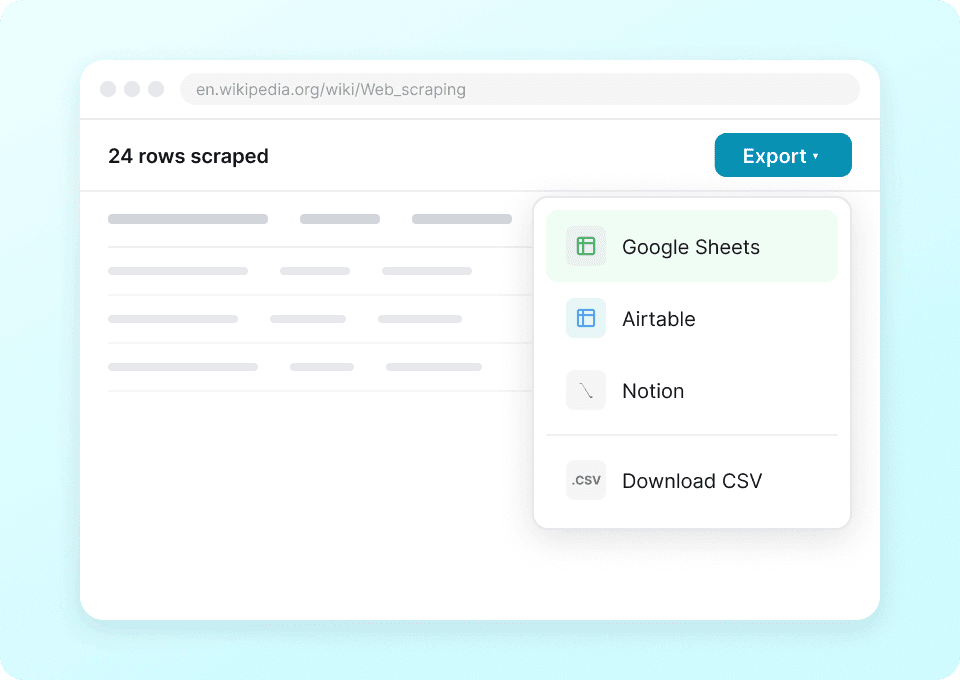
Exportujte data z Wikipedie přímo
Pokračujte v analýze v Google Sheets, Excelu, Airtable, Notion nebo staženém CSV.
Sbírejte výzkumná data z Wikipedie bez stavby vlastního scraperu
Omezte údržbu selektorů při výzkumu na Wikipedii.
Ruční nebo selektorové nastavení
Čas strávený údržbou pravidelAI Agent Thunderbit
Návrhy polí a jeden jediný běhSloupce pro fakta z článku, infobox, citace a sekce
Sloupce se zobrazí pouze tehdy, když jsou viditelné na stránce, ke které máte přístup.
- page_title
- page_url
- lead_paragraph
- first_sentence
- infobox_image_url
- infobox_image_caption
- birth_name
- birth_date
- death_date
- birth_place
- death_place
- nationality
- occupation
- years_active
- employer
- alma_mater
- spouse
- children
- website
- notable_works
- latitude
- longitude
- categories
- reference_titles
- reference_links
- external_links
- article_sections
- table_of_contents
- hatnotes
- page_last_edited_date
See researchers capture structured facts from open pages
In user-recorded videos, researchers pick page facts, check the rows, and move the result into their own tools.



Dotazy k výzkumným běhům na Wikipedii
Krátké odpovědi k Agent Mode na Wikipedii.
When your research spans Wikimedia projects
Pair Wikipedia articles with Wikidata items, Commons groups, or media pages.
Framer Scraper
Framer Scraper od Thunderbitu vám s pomocí AI umožní vytěžit přehledy šablon a ukázky z Frameru. Můžete sbírat kategorie jako šablony Portfolia a následně projít každou šablonu nebo podstránku Showcase, abyste získali detaily jako název, štítky, odkazy na náhled a metadata. Výsledky vyexportujete do Excelu, Google Sheets, Airtable nebo Notion během pár kliknutí.
Zjistit více ->
WordPress.org Scraper
WordPress.org Scraper od Thunderbitu vám s pomocí AI umožní získat přehledná, strukturovaná data z adresáře pluginů na WordPress.org i z knihovny blokových vzorů. Umí stáhnout data ze seznamů a doplnit je o detaily z podstránek (statistiky pluginu, verze, hodnocení, metadata vzorů) a následně je exportovat do Excelu, Google Sheets, Airtable nebo Notion.
Zjistit více ->
CoinMarketCap scraper
Získejte kryptoměnová data — cenu, tržní kapitalizaci a 24hodinový objem — z CoinMarketCap na 2 kliknutí. Otevřete libovolnou stránku, nechte AI automaticky rozpoznat pole a exportujte data přímo do Excelu, Google Sheets nebo Notion.
Zjistit více ->
GoDaddy Scraper
Namiřte na libovolnou doménu GoDaddy, její dostupnost nebo cenu — AI od Thunderbit vytáhne data na 2 kliknutí a okamžitě je exportuje do Excelu, Google Sheets nebo Notion.
Zjistit více ->
IMDb爬虫
Získejte názvy filmů, hodnocení, informace o obsazení i režisérovi z IMDb ve 2 kliknutích — a poté je automaticky exportujte do Excelu, Google Sheets nebo Notion. Bez nutnosti programování.
Zjistit více ->
Steam Scraper
Získejte názvy her ze Steamu, ceny a skóre uživatelských recenzí během 2 kliknutí — bez programování. Přehledná data exportujte rovnou do Excelu, Google Sheets nebo Notion a hned začněte s analýzou.
Zjistit více ->Připraven zrychlit extrakci dat?
Přidej se k více než 200 000 profesionálům, kteří už Thunderbit používají k automatizaci svých web scraping workflow.
Zkušební verze zdarma nabízí neomezené kredity pro 8 webových stránek.


