
Zadejte do Googlu „Thunderbit vs Oxylabs“ a nejspíš čekáte přehlednou srovnávací tabulku, něco jako Coke proti Pepsi. Jenže tady je to složitější. Jeden z těchto nástrojů je browserový pomocník, který za vás během pár vteřin prokliká stránku. Ten druhý je proxy síť s takovou IP stopou, jakou by záviděl nejeden telekom. A přesto se lidé na toto spojení pořád ptají, protože oba produkty se snaží vyřešit stejnou zásadní otázku: jak dostat data z webu, aniž by vám to vzalo celý týden života?
Velkou část kariéry jsem strávil pohybem mezi světem „postavme infrastrukturu“ a světem „prostě mi dodejte data“ — nejdřív v Automation Anywhere, pak v Jet.com a dnes v Thunderbit. Takže chápu, proč ta volba lidi mate. Je to trochu jako porovnávat stěhovací firmu se sadou krabic na stěhování — obojí dostane vaše věci z bodu A do bodu B, ale jedno je služba a druhé je nástroj, na kterém si postavíte vlastní proces. Pojďme si tedy ujasnit, co vlastně potřebujete, protože slibuji, že to není tak mlhavé, jak to působí na marketingových stránkách.
Rychlá odpověď
Než se ponoříme do detailů, stručně: Thunderbit je agentické, no-code web scrapování — otevřete stránku, kliknete na One Click Extract a nástroj si sám odvodí pole a stáhne strukturovaná data. K dispozici je také Web App, Open API, MCP Server a CLI pro každého, kdo chce jít více do hloubky. Oxylabs je enterprise scrapingová infrastruktura — proxy sítě, Web Scraper API a produkt Web Unblocker určený pro engineering týmy, které si staví vlastní datové pipeline ve velkém měřítku.
Ani jeden z těchto nástrojů není „lepší“ obecně. Záleží čistě na tom, čí práci potřebujete udělat — jestli potřebujete tabulku do pátku, nebo jestli jste datový inženýr zodpovědný za to, aby scraping pipeline fungovala při milionu požadavků měsíčně.
Na první pohled
Takhle bych ty dva produkty porovnal ještě předtím, než se pustíme do jednotlivých funkcí:
| Oblast | Thunderbit | Oxylabs |
|---|---|---|
| Hlavní uživatel | Obchod, ops, research, netechnické týmy, plus vývojáři přes API/MCP | Datoví inženýři, backend týmy, enterprise |
| Nastavení | Instalace browserového rozšíření, otevření stránky | Registrace, vytvoření API přístupů, napsání request logiky |
| Vrstva extrakce | Agentická — AI přečte stránku a odhadne pole | Definovaná vývojářem — response parsujete a strukturalizujete sami |
| Anti-bot/rendering | Automaticky řešeno na podporovaných, autorizovaných stránkách | Řešeno přes Web Unblocker nebo konfiguraci proxy vrstvy |
| Výstup | Tabulka/řádky, export do Sheets, Airtable, Notion | Surové HTML nebo strukturované JSON pro podporované cíle |
| Model škálování | Na kredity, podle úloh | Podle šířky pásma (GB) a objemu požadavků |
| Údržba | Nízká — logika extrakce se přizpůsobuje stránce | Průběžná — retry, rotace, údržba parserů je na vás |
| Governance | Autorizované, kompatibilní stránky; odpovědnost za soulad je na uživateli | Totéž — zákonné a autorizované použití je odpovědností zákazníka |
Co je Thunderbit?
Thunderbit bych nazval agentickým web scraperem — důraz je na „agentické“, protože pointa je v tom, že nemusíte ručně psát selektory ani vytvářet schéma od nuly. Otevřete stránku, ke které máte oprávněný přístup, kliknete na One Click Extract a agent stránku sám detekuje, přečte a zanalyzuje. Navrhne pole, která dávají pro danou stránku smysl, a pak se objeví Run Now — ale tady je část, kterou lidé často přehlédnou: nemusíte na to kliknout vůbec. Když nic neuděláte, extrakce se spustí sama.
To je podstatně jiný pracovní postup než vícekrokové nastavení, které používaly některé rané scrapingové nástroje a které starší recenze možná pořád popisují. My jsme ho postavili kolem jednoho záměrného kroku, protože upřímně — nikdo nechce pětikrokový rituál jen kvůli tomu, aby si stáhl tabulku cen z webu.

Kromě jedním kliknutím spuštěné extrakce můžete výsledky upravovat v běžné angličtině („show only listings from the last 30 days“), obohacovat podstránky tam, kde to struktura webu umožňuje, a exportovat přímo do Google Sheets, Airtable nebo Notion. A pokud jste vývojář, který chce přeskočit browser úplně, je tu Thunderbit Open API pro programový přístup, Thunderbit MCP Server pro napojení extrakce do Claude, Cursoru nebo jiných AI agent prostředí, a balíček Thunderbit CLI and Skills pro workflow v terminálu nebo v coding agentech. Je to stejná extrakční inteligence, jen zpřístupněná různými cestami podle toho, co zrovna potřebujete.
Pokud vás zajímá širší kontext toho, jak tahle kategorie funguje, doporučil bych náš vlastní rozbor AI web scrapování a web scrapování bez kódování — obojí jde více do technických detailů, než se sem vejde.
Co je Oxylabs?
Oxylabs je úplně jiná liga — a abych jim nekřivdil, ani se nesnaží být přímým konkurentem Thunderbit ve smyslu „klikni a vytáhni data“. Jejich aktuální ceník uvádí několik samostatných produktů: Web Scraper API, Web Unblocker a rodinu proxy sítí (residential, mobile, datacenter, ISP).
Web Scraper API je nejblíž klasickému „scraping produktu“ — začíná na 49 USD/měsíc, zvládá JavaScript rendering a vrací parsovaný nebo strukturovaný JSON pro podporované typy cílů, jako jsou vyhledávače, e-commerce a cestovní platformy. Web Unblocker je spíš přístupová vrstva: automaticky spravuje browser fingerprinty, cookies, výběr proxy i retry logiku a je stavěný na to, aby procházel přes náročnou anti-bot ochranu na chráněných webech — ale zpátky vám vrací page response, ne hotovou tabulku. Parser si pořád píšete sami.
Pak jsou tu ještě čisté proxy produkty, což je přesně to, co zní v názvu: balíky residential, mobile nebo datacenter IP adres, které si pronajímáte podle gigabytů, a které předpokládají, že už máte vlastní browser automation, parsování i storage pipeline. To je infrastruktura v pravém slova smyslu — nekupujete hotový výsledek, kupujete potrubí.
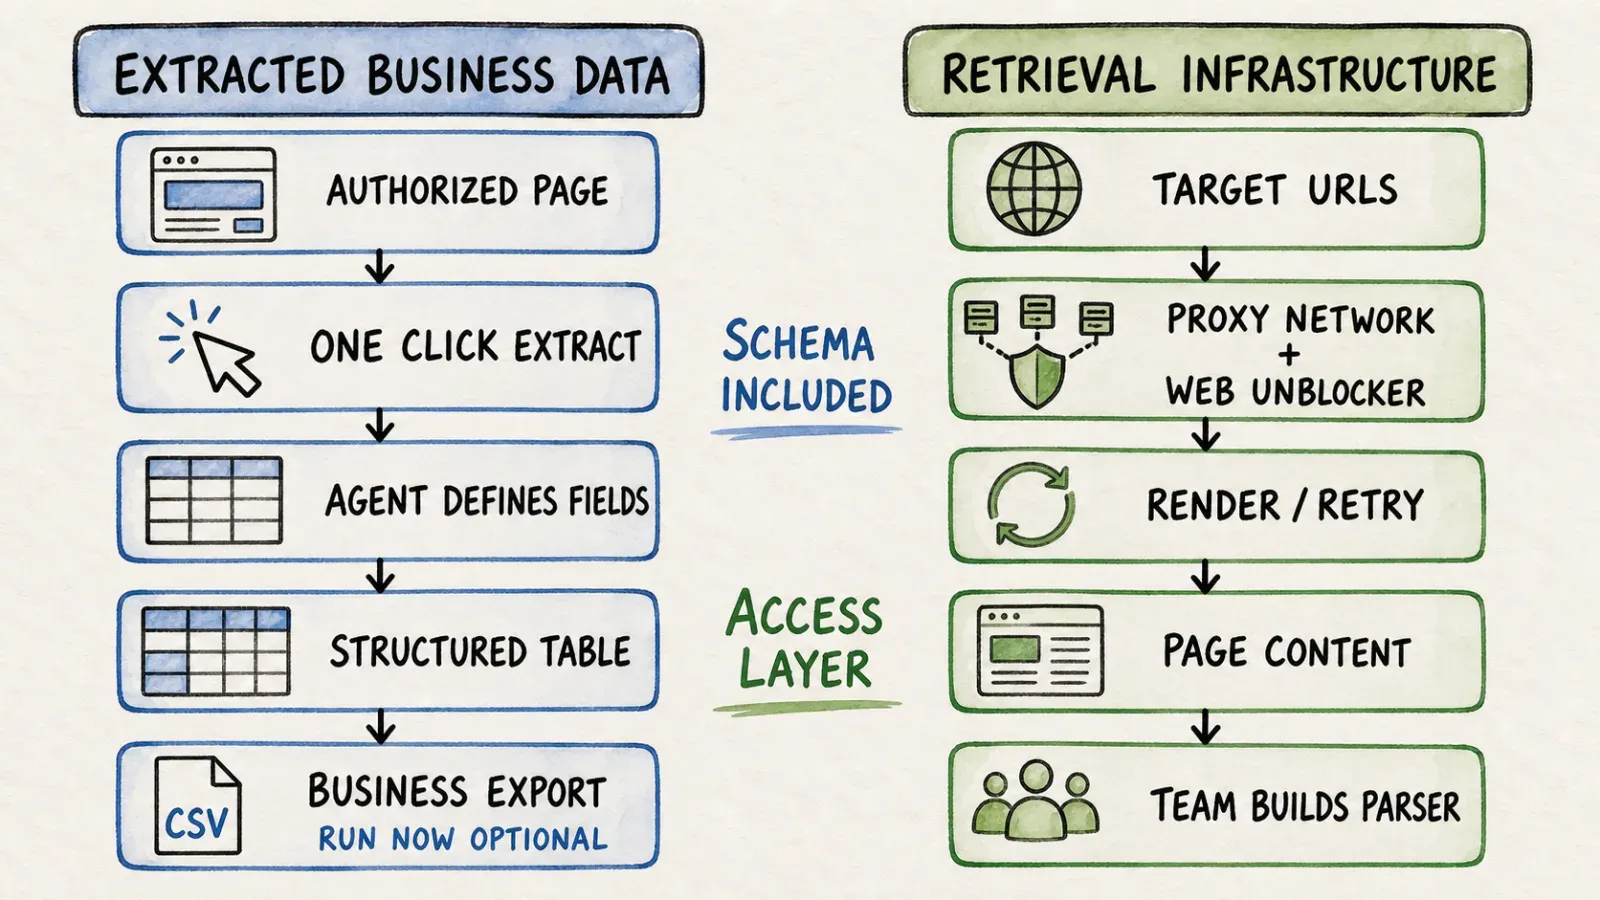
Zásadní rozdíl: hotová obchodní data vs. infrastruktura pro získávání dat
Kdo určuje schéma a pole?
U Thunderbit se na stránku podívá agent a navrhne pole — názvy produktů, ceny, hodnocení, prostě cokoli, co na stránce skutečně je — a vy je pak podle potřeby upravíte v přirozeném jazyce. U Oxylabs, pokud nepoužíváte parser určený pro konkrétní cíl v rámci Web Scraper API, definujete schéma sami. To není výtka vůči Oxylabs; je to prostě úplně jiný model rozdělení práce. Jeden nástroj předpokládá, že se nad schématem nechcete vůbec zamýšlet. Ten druhý předpokládá, že na něj máte názor a čas od vývojářů ho prosadit.
Kdo řeší blokování, rendering a rotaci proxy?
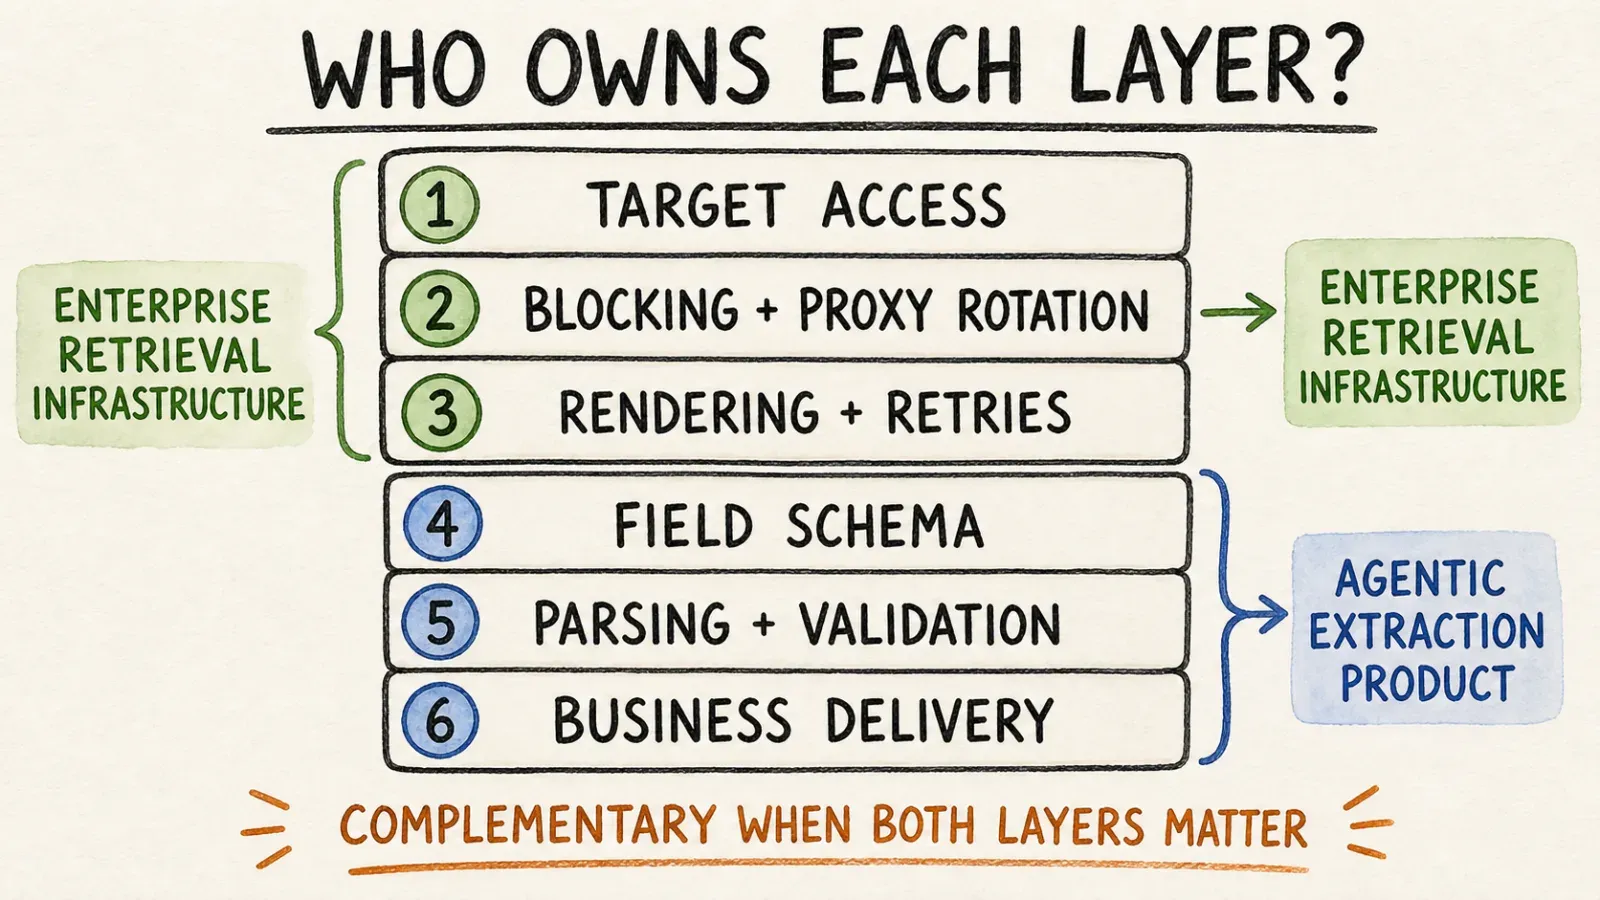
Thunderbit na podporovaných, autorizovaných stránkách zvládá rendering i přístup automaticky jako součást extrakčního flow — není potřeba konfigurovat samostatný proxy produkt. Oxylabs rozděluje tuto část do samostatné vrstvy: Web Unblocker existuje právě proto, že dostat se přes sofistikované anti-bot systémy je dost těžké na to, aby to byl samostatný produkt se samostatným ceníkem i dokumentací. Pokud jsou vaše cílové weby obzvlášť agresivní v blokování, tahle specializovaná odblokovací vrstva je skutečně jednou ze silných stránek Oxylabs — dělají ji lidé, kteří celý den přemýšlejí nad fingerprintingem a session managementem.
Kdo nese monitoring a navazující parsování?
Tady je rozdíl mezi „infrastrukturou“ a „hotovým výstupem“ nejviditelnější. U Oxylabs, jakmile dostanete response — ať už surové HTML z Web Unblocker, nebo strukturovaný JSON z podporovaného cíle ve Web Scraper API — downstream část je na vás nebo na vašem týmu: validace, ukládání, plánování, error handling, alerty, když se ve dvě ráno něco rozbije. U Thunderbit je tahle zátěž mnohem menší, protože extrakce a strukturování probíhají společně a export jde rovnou do nástrojů, které tým už používá.
Srovnání workflow krok za krokem
Čísla nelžou, takže si opravdu spočítejme kroky místo toho, abychom jen tvrdili, že něco je „jednodušší“.
Jednorázový úkol převodu stránky do tabulky:
| Krok | Thunderbit | Oxylabs |
|---|---|---|
| 1 | Nainstalujte Thunderbit Chrome Extension, otevřete cílovou stránku | Zaregistrujte se, vytvořte API přístupy |
| 2 | Klikněte na One Click Extract | Nakonfigurujte request payload (cíl, render, geolokační parametry) |
| 3 | Agent analyzuje stránku a navrhne pole | Odešlete request, nastavte parametry proxy/renderingu |
| 4 | Zobrazí se Run Now — volitelné, extrakce se spustí i sama | Parsujte response a vytvořte retry a rotation logiku |
| 5 | Exportujte do Sheets/Airtable/Notion | Výstup si sami uložte, validujte a strukturalizujte |
Pro byznys uživatele, který prostě potřebuje tabulku cen konkurence nebo seznam leadů, je to s Thunderbit zhruba jednokliková práce, zatímco s Oxylabs už jde o menší vývojový úkol. To není kritika Oxylabs — nikdy to nebylo navrženo tak, aby vynechalo inženýrský krok. Je postavené tak, aby inženýrům dalo spolehlivý základ, na kterém mohou stavět.
Velký opakovaný systém pro crawling / sběr dat: tady se rovnice obrací. Pokud taháte miliony stránek měsíčně napříč desítkami geografických oblastí a máte přísné SLA, začne být důležitější hloubka proxy sítě Oxylabs a enterprise support než pohodlí jednoho kliknutí. Tohle je opravdu jejich domácí hřiště.
Integrace s AI agentem přes API nebo MCP: pokud zapojujete extrakci do workflow v Claude nebo Cursoru, sáhnete buď po Thunderbit MCP Server pro strukturovanou extrakci vyvolanou agentem, nebo po Scraper API od Oxylabs, pokud agent ve skutečnosti potřebuje surový přístup/odblokování spíš než hotový strukturovaný výstup. Obojí dává smysl podle toho, co má agent s daty následně dělat.
Kdo vlastně potřebuje co
Mám radši persony než vágní texty typu „pro koho to je“, protože právě ve vágním textu se marketingové stránky schovávají.
| Persona | Lepší volba | Proč |
|---|---|---|
| Sales/marketing ops, byznys uživatel bez kódu | Thunderbit | Extrakce kliknutím, přímý export do Sheets/Airtable/Notion, nic se nemusí udržovat |
| Datový inženýr stavící scraping pipeline ve velkém | Oxylabs | Hluboké proxy pooly, vyhrazená infrastruktura, škálování podle objemu |
| Vývojář budující workflow s AI agenty | Obojí, podle úkolu | Thunderbit Open API/MCP pro strukturovanou extrakci; Oxylabs Scraper API pro surový přístup/odblokování |
| Enterprise, které potřebuje obrovskou IP diverzitu | Oxylabs | Residential proxy footprint je jejich klíčová síla |
Kdybych to měl shrnout do jedné věty: Thunderbit odpovídá na otázku „jak dostanu použitelné data hned teď“, zatímco Oxylabs odpovídá na otázku „jak postavím systém, který bude data získávat pořád“.
Přesnost, anti-bot ochrana a údržba
Ani jeden nástroj není magie, a bylo by nepoctivé tvrdit opak. Agentická extrakce v Thunderbit funguje dobře na kompatibilních, autorizovaných stránkách, pro které byla navržena — ale to je důležitá podmínka, ne marketingová poznámka pod čarou. Není to záruka proti každému CAPTCHA, přihlašovací bariéře nebo anti-automation ochraně na internetu. Web Unblocker od Oxylabs je naopak přímo navržený tak, aby si s některými z těchto náročnějších cílů poradil přes automatickou správu fingerprintů a session, a to je legitimní specializace, které stojí za respekt.
Rozdíl je ale hlavně v údržbě. Thunderbit se při změnách stránky dokáže přizpůsobit výkladu polí, což výrazně snižuje množství babysittingu, které vyžadují klasické scrapery. Oxylabs přesouvá tuto odpovědnost na vás — retry logika, rotace, aktualizace parserů, když cílový web změní HTML. To je daň za to, že si infrastrukturu vlastníte sami: víc kontroly, víc odpovědnosti.
Na jedné věci by se obě firmy shodly — a správně: sbírejte jen to, k čemu máte oprávnění, a respektujte podmínky cílového webu i platné zákony. Ani AI agent, ani proxy síť nezmění neautorizované scrapování na autorizované.
Cena a celkové náklady
Tady si myslím, že spousta srovnávacích článků lenivě opakuje čísla z ceníku a hotovo. Pojďme si to raději zasadit do konkrétní situace.
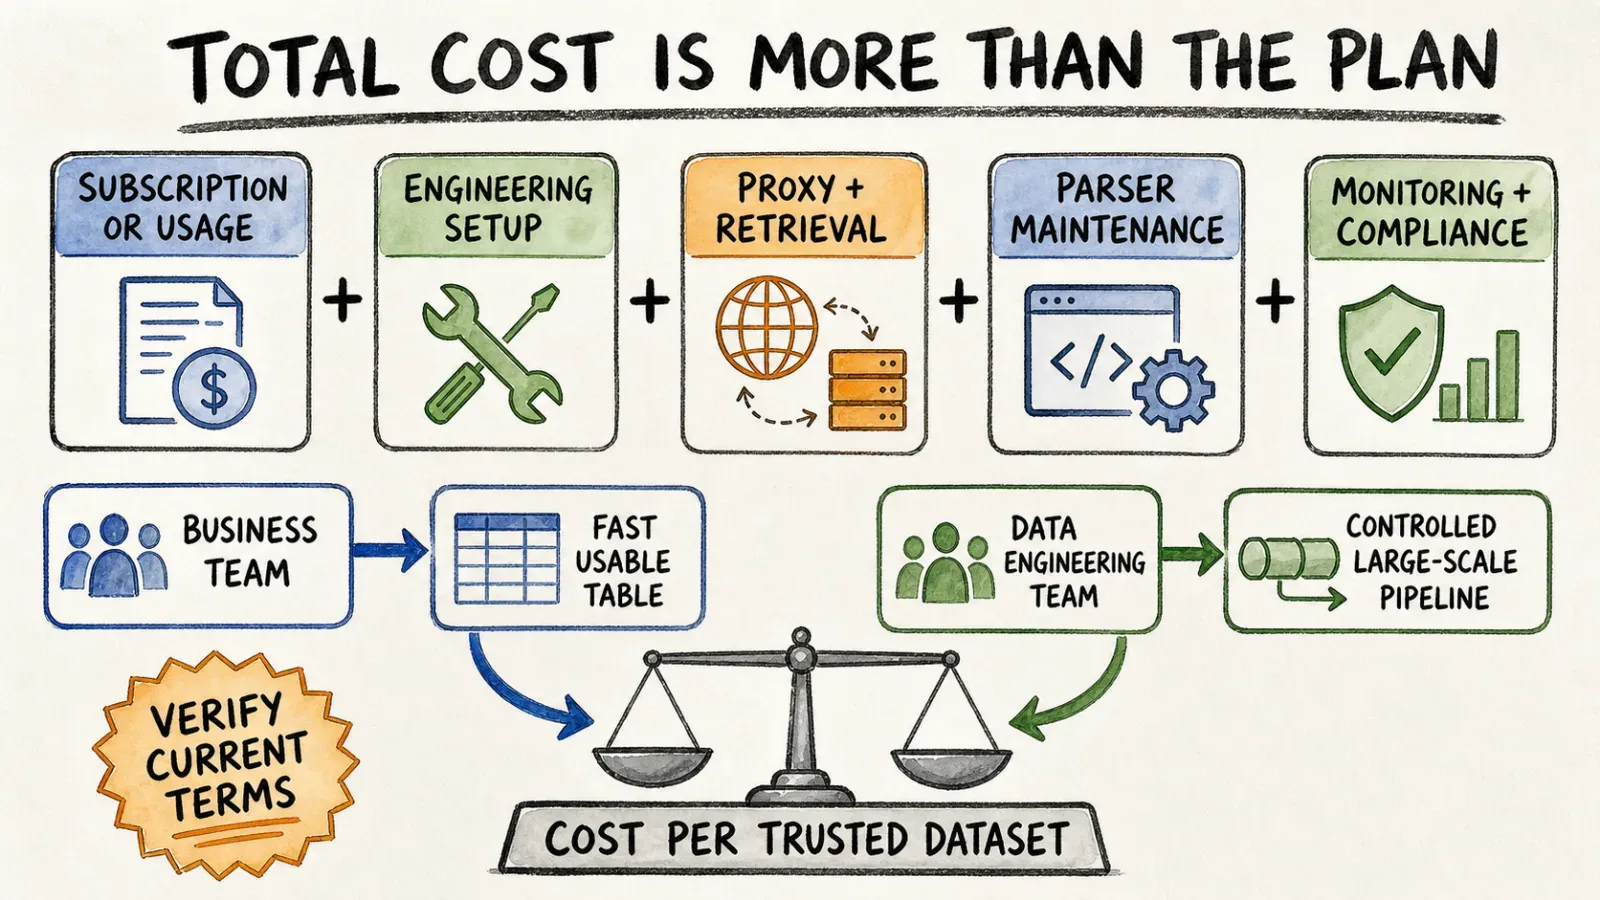
Řekněme, že potřebujete každý měsíc nasbírat 5 000 produktových záznamů z kategorie e-shopu a aktualizovat je týdně. U Web Scraper API od Oxylabs, které začíná někde kolem 49 USD/měsíc, platíte podle výsledků a požadavků. A pokud potřebujete i tvrdší přístupovou vrstvu, úrovně Web Unblocker sahají od plánu Micro za 75 USD/měsíc pro 8 GB až po Advanced za 660 USD/měsíc pro 88 GB (běžná cena, bez případných časově omezených slevových kuponů). Háček je v tom, že spotřeba GB neroste předvídatelně — stránka s těžkým JavaScript renderingem může spálit bandwidth mnohem rychleji než lehká statická stránka, a vlastní billing dokumentace Oxylabs uvádí, že se do účtování počítá provoz pro request i response, a dokonce i některé 4xx odpovědi mohou být zpoplatněné.
Thunderbit naproti tomu funguje na modelu kreditů navázaných na extrakční úlohy, nikoli na hrubý objem dat — takže úloha na 5 000 řádků stojí zhruba tolik, kolik stojí úloha na 5 000 řádků, bez ohledu na to, jak moc je stránka pod kapotou postavená na JavaScriptu. To je opravdu odlišný mentální model: jedno je účtované jako za utilitu, druhé jako předplatné služby.
Řeknu i samozřejmost, kterou by měl říct každý poctivý srovnávací článek: ceny se neustále mění, kupony přicházejí a mizí a názvy plánů se občas přeskládávají. Než si cokoli rozpočtujete, podívejte se přímo na aktuální ceny Thunderbit a na ceník Oxylabs a započítejte i vlastní engineering time — „levná“ cena za GB ve skutečnosti není levná, pokud musí vývojář dva dny měsíčně držet pipeline při životě.
Co říkají recenze doopravdy
Snažím se tu jen nemávnout vlajkou vlastního týmu, protože to nikomu při skutečném výzkumu nepomůže. Recenzní weby jako G2 dlouhodobě ukazují, že Oxylabs získává silná hodnocení za dedikovanou zákaznickou podporu a enterprise spolehlivost — což sedí, protože přesně to od firmy prodávající infrastrukturu engineering týmům se SLA čekáte. Pokud vaše firma závisí na tom, že scraping pipeline nikdy nespadne, má support, který odpovídá rychle, skutečnou hodnotu.
Na druhé straně signály kolem snadnosti použití a rychlosti dosažení hodnoty obvykle favorizují nástroje postavené na šablonách a task-based extrakci, ne na surové API konfiguraci — a to je přesně prostor, ve kterém žije Thunderbit. Jiný produkt, jiná kritéria recenze, a upřímně — obojí může být pravda zároveň, aniž by si to odporovalo.
Kdo by měl zvolit Thunderbit?
Zvolte Thunderbit, pokud pracujete v sales, ops, research nebo marketingu a potřebujete strukturovaná data z webové stránky bez čekání na vývojářský sprint. Je to také dobrá volba pro vývojáře, kteří chtějí extrakci vyvolanou AI agentem, aniž by si sami stavěli proxy a parsovací stack od nuly — k dispozici máte Open API, MCP Server i CLI, a přitom nepřijdete o možnost jedním klikem spustit browserovou úlohu ručně. Pokud vás zajímá, jak si vede proti dalším nástrojům v této kategorii, náš přehled nejlepších AI web scraperů je dobrý další krok.
Kdo by měl zvolit Oxylabs?
Zvolte Oxylabs, pokud jste engineering nebo data tým a běžíte rozsáhlé, chráněné, produkční data retrieval workloady — tedy případy, kdy potřebujete geotargeting, session control a tak hluboký proxy pool, aby přežil agresivní rate limiting. Pokud vaše organizace už vlastní orchestrace, parsování i storage vrstvu a jen potřebuje spolehlivý přístup ve velkém objemu, infrastruktura Oxylabs je postavená přesně na to.
Mohou fungovat společně?
Teoreticky ano — enterprise by mohlo používat Oxylabs pro surový přístup a odblokování na infrastrukturní vrstvě, zatímco jednotlivé týmy by si nad autorizovanými zdroji dat mohly nasazovat nástroj jako Thunderbit pro rychlou, strukturovanou extrakci. Chci ale být opatrný: nejsem si vědom žádné oficiální integrace mezi těmito dvěma produkty a nerad bych přeháněl partnerství, které neexistuje. Vnímejte to spíš ne jako „tyto dva produkty se propojují“, ale jako „tyto dva produkty mohou koexistovat v různých vrstvách datového stacku firmy“ — a to je mnohem upřímnější formulace.
Verdikt
Pokud je vaším cílem nejkratší cesta z „webové stránky“ k „použitelné tabulce“, Thunderbit je postavený kolem jednoho záměrného kliknutí na One Click Extract; agent stránku analyzuje a úloha se spustí automaticky, zatímco Run Now zůstává volitelné. Tento přístup Web Scraping Without Coding ho zpřístupňuje i netechnickým týmům. Pokud je vaším cílem provozovat odolnou, vysokobjemovou scrapingovou operaci, kterou si váš engineering tým plně vlastní a kontroluje, Oxylabs vám dává suroviny k vybudování přesně takového řešení — hloubku proxy, odblokování a enterprise support, který to podpoří.
Nemyslím si, že existuje univerzální vítěz, a každý článek, který vám tvrdí opak, se vás nejspíš jen snaží přesvědčit ke koupi něčeho konkrétního. Vyberte podle toho, kdo bude nástroj denně provozovat — byznys uživatel, který chce výsledky, nebo inženýr, který chce infrastrukturu.
FAQ
Je Oxylabs bez kódu jako Thunderbit? Ne tak docela. Web Scraper API a Web Unblocker od Oxylabs jsou produkty pro vývojáře — posíláte API requesty a response si obsluhujete sami. Neexistuje zde browserový zážitek typu klikni a vytáhni, který by odpovídal workflow Thunderbit s jedním kliknutím.
Má Thunderbit pro vývojáře API a MCP? Ano. Kromě browserového rozšíření nabízí Thunderbit Open API pro programový přístup, MCP Server pro AI agenty jako Claude a Cursor a CLI pro workflow v terminálu.
Který nástroj lépe zvládá cíle s těžkou anti-bot ochranou? Web Unblocker od Oxylabs je stavěný přímo na náročné, chráněné cíle s automatickou správou fingerprintů a session. Thunderbit řeší rendering a přístup na kompatibilních, autorizovaných stránkách jako součást extrakčního flow, ale není prezentovaný jako specializovaný nástroj na obcházení anti-bot ochrany.
Co je jednodušší pro netechnické business uživatele? Thunderbit, a to výrazně. Není potřeba nastavovat API, navrhovat schéma ani psát parser — kliknete, agent navrhne pole a výsledky se exportují do Sheets, Airtable nebo Notion.
Jak mám porovnat ceny Thunderbit a Oxylabs? Ne porovnáváním samotných částek — modely jsou jiné. Oxylabs účtuje hlavně podle bandwidth (GB) a objemu requestů, což se mění podle složitosti stránky a JavaScript renderingu. Thunderbit používá kredity navázané na extrakční úlohy, takže je cena za úlohu předvídatelnější. Před plánováním rozpočtu si vždy zkontrolujte aktuální čísla na cenové stránce Thunderbit i na ceníku Oxylabs.




