
Před pár týdny někdo z našeho týmu hodil do Slacku zprávu, která zněla jen: „máme se bát Crawl4AI?“ Zasmál jsem se, protože srovnávat Thunderbit s Crawl4AI je trochu jako srovnávat aplikaci na rozvoz jídla s plně vybavenou komerční kuchyní. Obě vám sice zajistí večeři. U jedné z nich ale musíte vědět, jak vařit.
Většinu kariéry jsem strávil v automatizaci — nejdřív v Automation Anywhere, kde jsem sledoval, jak se firmy snaží napojovat boty na staré systémy, a pak v Jet.com, kde každá hodina navíc strávená na datovém lepení chyběla na skutečný produkt. Když se mě proto lidé ptají, jak bych porovnal Thunderbit s open-source Python crawlerem, neberu to stylem „náš nástroj je lepší“. Beru to z pohledu: kdo to vlastně bude používat a kolik na to má času. Pojďme se podívat na to, k čemu je který nástroj skutečně určený, protože upřímná odpověď zní: záleží na tom, jestli raději kliknete na tlačítko, nebo píšete skript.
Rychlá odpověď
Když to vezmu stručně, než se do toho ponořím víc do hloubky: Thunderbit je spravovaný agentní webový scraper pro byznys uživatele — otevřete stránku, kliknete na One Click Extract a nástroj vám vrátí strukturovanou tabulku. Zároveň má i Open API, MCP Server a CLI pro vývojáře, kteří ho chtějí zapojit do pipeline bez psaní vlastní scraping logiky od nuly.
Crawl4AI je open-source Python framework pro vývojáře, kteří staví AI a RAG datové pipeline. Je opravdu silný — hluboké crawlování, adaptivní crawlování, generování Markdownu, strategie extrakce přes LLM — ale píšete kód, spravujete vlastní browser infrastrukturu a platíte za výpočetní výkon i za tokeny LLM, které po cestě spotřebujete.
Skutečný kompromis tedy není „dobré vs. špatné“. Je to rychlost výsledku proti kontrole na úrovni kódu. Ani jedno není špatně. Jen jsou ty nástroje dělané pro jiné lidi na jiných místech stacku.
Přehledně
Než půjdu bod po bodu, tady je tabulka, kterou bych si sám přál mít, když jsem ty dva nástroje porovnával poprvé. Většina článků typu „X vs Crawl4AI“, které teď kolují po internetu, je ve skutečnosti o Firecrawl, ne o Thunderbit, tak jsem tuhle udělal úplně od nuly.
| Oblast | Thunderbit | Crawl4AI |
|---|---|---|
| Způsob nasazení | Rozšíření do prohlížeče / webová aplikace, One Click Extract | Python knihovna (pip install), vlastní skripty |
| Nutnost kódování | Bez kódu (agentní rozpoznání polí) | Ano (Python + volitelně LLM klíče pro strukturovanou extrakci) |
| JS / dynamické renderování | Zpracováno na podporovaných, autorizovaných stránkách | Chromium přes Playwright, ruční konfigurace |
| Výstupní formát | Strukturované tabulky, export do Excelu / Sheets / Airtable / Notion | Markdown, JSON (přes vlastní schéma nebo LLM extrakci) |
| PDF / obrázky / dokumenty | Podporované typy vstupu (aktuální seznam ověřte v oficiální dokumentaci) | Není hlavní fokus — primárně HTML / Markdown |
| Model hostování | Cloud (webová aplikace) / browser session | Self-hosted (Docker, vlastní infrastruktura) |
| Ideální uživatel | Netekničtí lidé z ops, obchodu a výzkumu | Vývojáři stavějící RAG / LLM pipeline |
| Licence | Komerční, předplatné / kredity (aktuální ceny) | Apache 2.0 s doložkou o uvedení autorství |
Ještě jedna rychlá poznámka, protože by ode mě nebylo fér to nezmínit: cenové tarify, limity kreditů i podporované typy vstupů se na obou stranách docela často mění. Berte tedy tuhle tabulku spíš jako mapu než jako smlouvu — před nákupem si vždycky zkontrolujte aktuální dokumentaci.
Co je Thunderbit?
Thunderbit je nástroj, který jsme postavili poté, co jsme se unavili z toho, jak netechnickým lidem — obchodníkům, manažerům operací, výzkumníkům — pokaždé ztuhne úsměv ve chvíli, kdy potřebují dostat data z webu a odpověď zní „zeptejte se vývojáře“. Současný postup je schválně jednoduchý a v tom nejlepším smyslu trochu nudný: otevřete stránku, ze které chcete data získat, kliknete na One Click Extract a agent si stránku přečte, odhadne vhodná pole a začne data vytahovat. Uvidíte tlačítko Run Now, ale je volitelné — když neuděláte nic, extrakce se spustí sama.

A právě o to jde. Žádné selektory, žádné schema soubory, žádný krok „nejdřív si definujte pravidla extrakce“, ještě než vůbec uvidíte náhled. Výstup si pak můžete upravit obyčejnou češtinou — přejmenovat sloupec, požádat o překlad pole, říct mu, ať přeskočí řádky bez ceny — a na podporovaných stránkách projde i stránkování nebo otevře podstránky, aby dataset dál obohatil.
Thunderbit navíc není jen rozšíření do prohlížeče. Má i Web App pro cloudové úlohy, Open API pro vývojáře, kteří chtějí programový přístup bez vlastního scraperu, MCP Server pro napojení na Claude, Cursor nebo jiné AI-agentní prostředí a také CLI pro terminál a workflow řízená kódem. Export jde přímo do Excelu, Google Sheets, Airtable nebo Notion. Je to typ nástroje, který jsem si přál mít už v Jet.com, když jsem viděl analytiky každý týden ručně kopírovat ceny konkurence do tabulek.
Co je Crawl4AI?
Crawl4AI je úplně jiná kategorie nástroje, a tady mu chci dát poctivě kredit, protože je to skutečně dobře navržený open-source software — ne jen scraper, který přelije HTML do Markdownu. Jde o async Python crawler postavený ve výchozím stavu na Chromiu a od vydání v0.9.0 ze dne 18. června 2026 projekt dodal zásadní bezpečnostní změny do svého self-hosted Docker API, včetně zapnutého ověřování ve výchozím nastavení a bindování na loopback, pokud si to nenastavíte jinak.
Quickstart dokumentace ukazuje základní postup: spustíte AsyncWebCrawler, pustíte ho na URL a dostanete čistý Markdown, nebo definujete CSS/XPath schéma, případně to předáte LLMExtractionStrategy, pokud chcete, aby AI určilo strukturu pomocí modelu, který sami nakonfigurujete a zaplatíte.
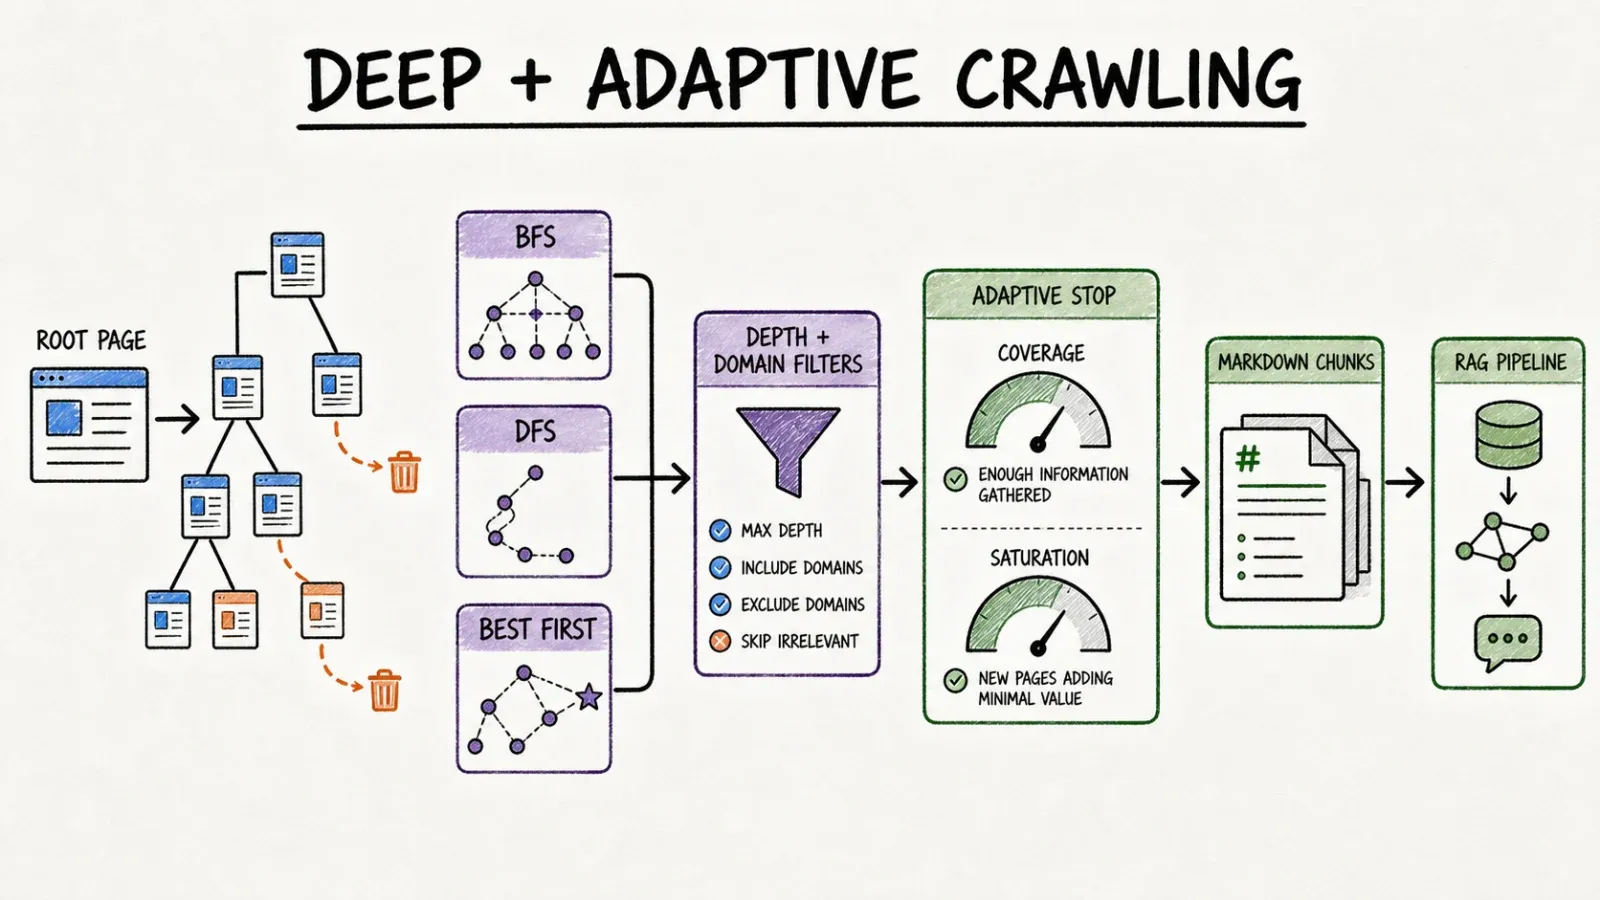
Co mě na tom při procházení kódu i dokumentace skutečně zaujalo, byla crawling logika. K dispozici je deep crawling s metodami BFS, DFS a BestFirst, včetně limitů hloubky, filtrování domén a skórování — hodně užitečné, pokud potřebujete zmapovat dokumentační web nebo rozsáhlý archiv obsahu. Je tu také adaptive crawling, což je chytrá myšlenka: systém průběžně vybírá, na které odkazy má jít dál, a skončí ve chvíli, kdy usoudí, že nasbíral „dost“ informací, místo aby crawloval donekonečna. A na úrovni ovládání prohlížeče zvládá cookies, headery, geolokaci, virtuální scrollování, storage state a dokonce i zachytávání PDF a screenshotů.
Licence je Apache 2.0, ale — a tohle stojí za přečtení, pokud jste komerční uživatel — v licenčním souboru je uvedena projektová doložka o uvedení autorství. „Zdarma a open source“ totiž neznamená vždycky „bez podmínek“, a radši na to upozorním teď, než aby vás to překvapilo později.
Hlavní rozdíl: hotový agentní produkt vs vývojářský framework
Čas do první tabulky
Nebudu předstírat, že jsem tady dělal přesný stopwatch benchmark, protože vymýšlet konkrétní číslo by bylo nepoctivé a navíc dost zbytečné — rychlost sítě, složitost stránky i vaše vlastní psaní do výsledku stejně mluví. Ten rozdíl v počtu kroků ale reálný je a stojí za to ho poctivě projít.
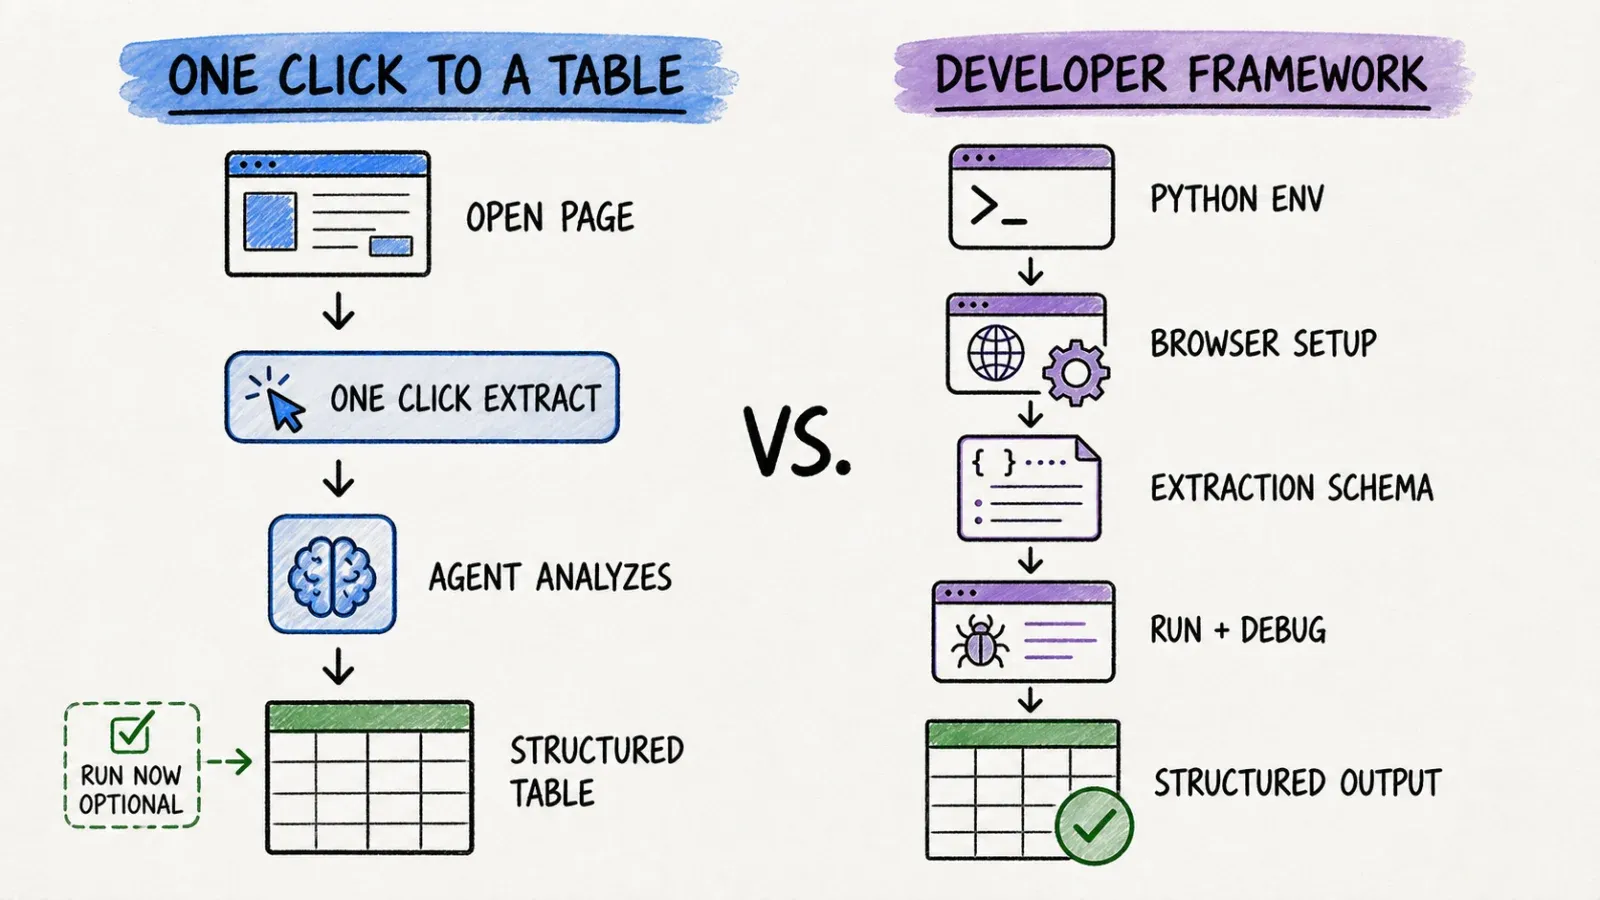
S Crawl4AI váš postup vypadá zhruba takto: nastavíte Python prostředí, dáte pip install crawl4ai, spustíte setup/doctor kontrolu, nakonfigurujete browser a Playwright závislosti, napíšete extrakční schéma nebo připojíte LLM klíč, spustíte skript a pak ladíte výstup, když něco neparsuje správně (a něco se první pokus skoro vždycky nepovede — to je prostě software).
S Thunderbit je postup tento: nainstalujete rozšíření do prohlížeče, otevřete stránku, kliknete na One Click Extract a buď kliknete na Run Now, nebo jen počkáte, protože se to spustí automaticky. To je vše. Jedno záměrné kliknutí, žádný kód.
Jestli jste vývojář, který už žije v terminálu, Crawl4AI vás nevyděsí — to je prostě úterý. Jestli jste obchodní manažer, který do oběda potřebuje seznam leadů, je to spíš zeď.
Kontrola nad crawlingem a logikou extrakce
Tady Crawl4AI opravdu předbíhá pro specifickou skupinu uživatelů. Dostanete plnou kontrolu nad hloubkou crawlů, paralelismem, retry logikou, cacheováním i nad tím, jak přesně se obsah rozseká, než se dostane do LLM nebo vektorové databáze. Pokud stavíte RAG pipeline a potřebujete přesně řídit, jak se dokumenty segmentují pro embedding, taková granularita je důležitá a Thunderbit se o stejnou úroveň kontroly nesnaží.
Řídicí vrstva Thunderbitu je jiná — jde o to, co se vytáhne ven (která pole, v jakém formátu, v jakém jazyce), ne o to, jak crawler na úrovni kódu prochází web. Pro strukturovaná byznys data to většinou hraje ve váš prospěch. Pro vlastní RAG architekturu ale budete chtít právě kontrolu na úrovni kódu.
Hostování, dohled a odpovědnost za údržbu
U Crawl4AI nesete infrastrukturu sami. To znamená, že zodpovídáte za Docker nasazení, browser závislosti, rotaci proxy, pokud se weby brání, monitoring, když crawl v 2 ráno tiše selže, i aktualizace skriptů ve chvíli, kdy cílový web změní HTML strukturu. U Thunderbit zůstává tahle provozní zátěž na nás — browser i cloud execution, logika čtení stránek i údržba extrakčního enginu.
Ani jeden přístup není bez kompromisů. Self-hosting znamená, že můžete všechno auditovat, upravit a mít pod kontrolou, ale zároveň to znamená, že každé selhání ve dvě ráno je váš problém.
Praktické scénáře
Abstraktní srovnání jsou fajn, ale mně se na tyhle věci přemýšlí lépe přes konkrétní situace.
Byznys uživatel, který potřebuje aktuální stránku. Představte si, že jste market researcher a do konce dne potřebujete cenová data ze 40 produktových stránek konkurence. Python neumíte a dnes se to ani učit nechcete. Thunderbit vám přes rozšíření vrátí strukturovanou tabulku přímo v prohlížeči, kde už stejně jste.
Vývojář stavějící RAG ingestion pipeline. Indexujete technickou dokumentaci pro interního chatbota a potřebujete čisté Markdown chunky s konzistentním formátováním pro embedding. Tohle je přesně doména Crawl4AI — generování Markdownu a řízení chunkingu bylo navržené právě pro tento účel.
Hluboké crawlování dokumentačního webu. Chcete zmapovat celý knowledge base, stovky stránek hluboko, s omezením domény a skórováním, aby se neplýtvalo výkonem na nesouvisející stránky. Deep crawling strategie v Crawl4AI jsou přesně na tohle dělané; Thunderbit na tento use case není primárně stavěný.
Volání scrappingu z AI agenta. Máte Claude nebo Cursor nastavený jako agenta, který potřebuje uprostřed workflow stáhnout strukturovaná data bez toho, aby člověk cokoli kliknul. MCP Server od Thunderbitu se do takového prostředí napojuje přímo a Open API funguje i pro backend automatizaci.
Přesnost, dynamické stránky a údržba
Je dobré oddělit dvě věci, které lidé často házejí do jednoho pytle: inferenci polí (tedy zjištění, která data na stránce dávají smysl) a kontrolu prohlížeče / crawl procesu (tedy skutečné renderování a procházení stránky).
Thunderbit obojí automatizuje na podporovaných, autorizovaných stránkách — agent si stránku přečte, odhadne strukturu a renderování vyřeší v pozadí. Crawl4AI automatizuje renderování (přes Chromium/Playwright), ale rozhodnutí o inferenci struktury nechává na vás — ať už jde o ručně napsaný CSS selektor, nebo o LLM extrakční volání, které si nastavíte a zaplatíte.
Ani jeden nástroj negarantuje univerzální přístup. Přihlášené stránky, agresivní anti-bot systémy a neustále se měnící markup jsou těžké problémy pro jakýkoli scraper, ať už je spravovaný nebo self-hosted. Kdybych tvrdil, že Thunderbit funguje na doslova každém webu, lhal bych — funguje dobře na podporovaných, autorizovaných stránkách, a to je férové tvrzení, ne marketing. Crawl4AI má stejný limit; jen přesouvá břemeno řešení na váš inženýrský čas místo na dodavatele.
Cena, licence a celkové náklady
Tohle je sekce, kterou většina srovnávacích článků přeskočí, a mě to pokaždé štve, protože „zdarma“ a „bez nákladů“ nejsou totéž.
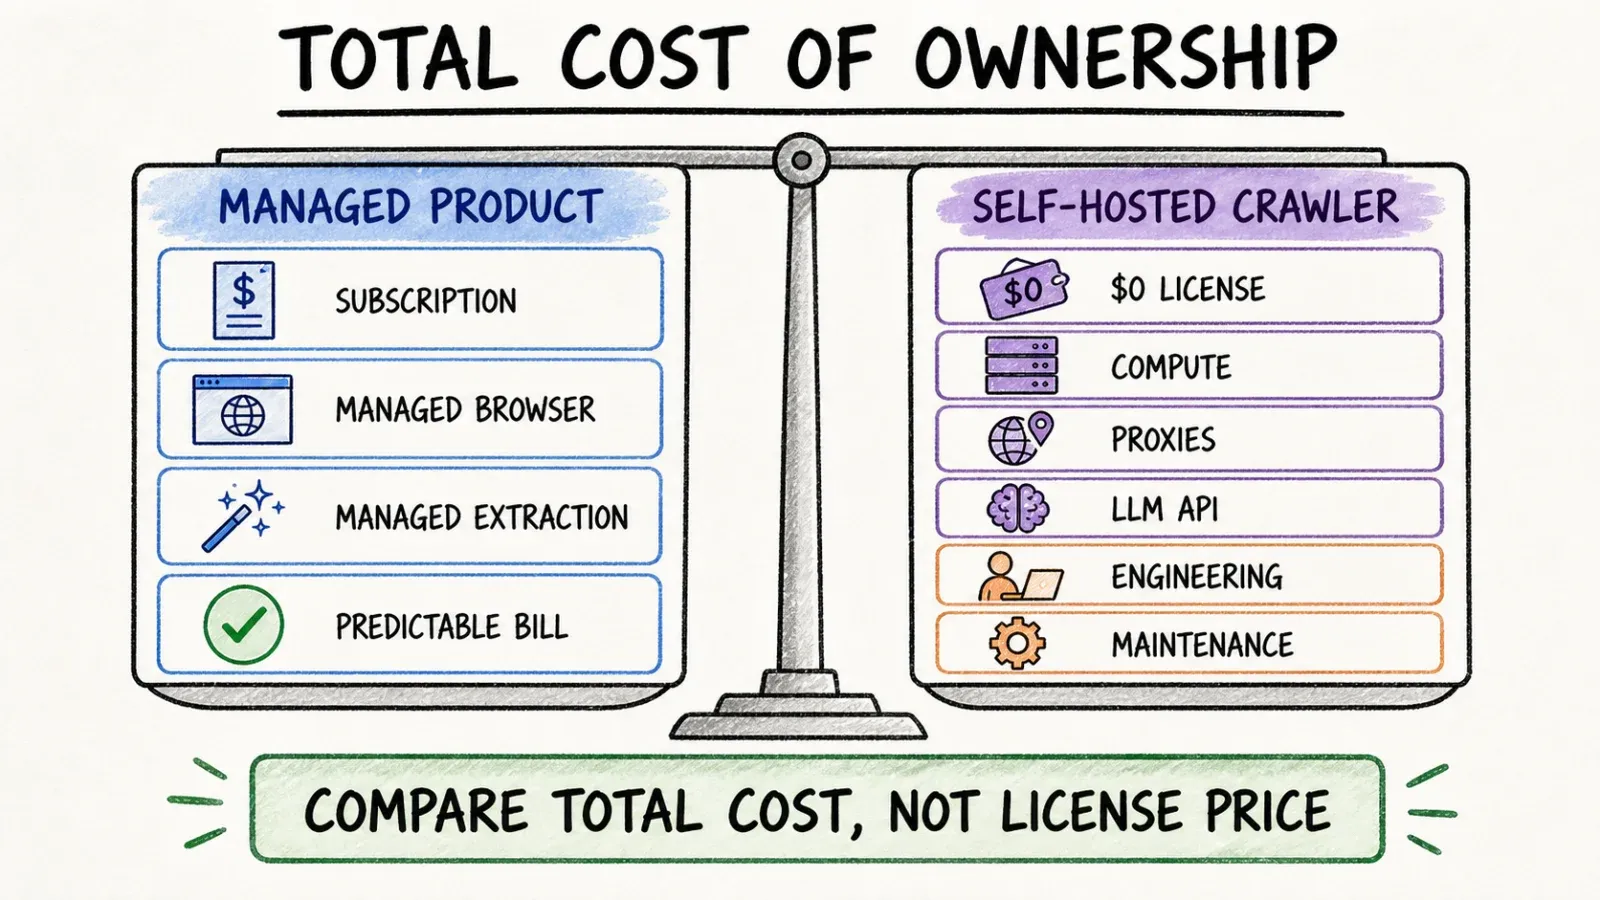
Dejme si reálný scénář: měsíčně potřebujete vytáhnout zhruba 3 000 řádků — leady, nabídky, cokoli podobného — a dělat to průběžně.
S Crawl4AI samotná licence nic nestojí. Ale pořád platíte za:
- výpočetní výkon a hostování browseru (server nebo kontejner s Chromiumem)
- proxy služby, pokud cílové weby vyžadují rotaci IP adres
- tokeny LLM API, pokud používáte
LLMExtractionStrategys modelem úrovně GPT-4o pro strukturovanou extrakci - čas vývojářů na psaní, testování, nasazení a údržbu skriptů — a na jejich opravy ve chvíli, kdy web změní layout
Tohle všechno se na cenovce „0 Kč“ neukáže, ale v reálných měsíčních nákladech ano — obvykle rozptýlené mezi cloudový účet, fakturu za API a něčí kalendář.
S Thunderbit platíte fixní a předvídatelné předplatné nebo kreditový tarif — vždy je dobré si zkontrolovat aktuální stránku s cenami, protože tarify se v čase mění — a nemusíte zvlášť spravovat LLM klíč, proxy smlouvu ani Docker deployment.
Upřímné srovnání tedy není „zdarma vs placené“. Je to „skryté inženýrské náklady vs předvídatelné předplatné“. Viděl jsem dost engineering týmů, které si infrastrukturu nenápadně rozpustily do rozpočtu na headcount, abych věděl, že „bezplatný software“ a „bezplatný provoz“ jsou dvě úplně jiné věty.
Kdo by měl zvolit Thunderbit?
Pokud jste netechnický nebo časově omezený uživatel, který potřebuje rychle strukturovaná data — tabulky, leady, nabídky — a chcete je rovnou exportovat do Excelu, Sheets, Airtable nebo Notion bez sahání na infrastrukturu, proxy nebo LLM klíče, Thunderbit je přímější cesta. Platí to i pro týmy, které chtějí workflow pro AI lead generation nebo ad hoc research bez toho, aby musely pokaždé zapojovat vývojáře.
Kdo by měl zvolit Crawl4AI?
Pokud jste vývojář, který staví RAG nebo LLM datovou pipeline, potřebujete plnou kontrolu nad crawl logikou — paralelní crawling, vlastní chunking, specifická extrakční schémata — a jste v pohodě se self-hostingem i údržbou Python kódu, Crawl4AI vám dává takovou kontrolu, jakou spravovaný produkt z principu není stavěný poskytovat.
Mohou týmy používat oba nástroje?
Upřímně ano, a neříkám to jen proto, abych se vyhnul jasné volbě. Tenhle model jsem viděl fungovat ve větších firmách: engineering tým postaví specializovaný crawler na bázi Crawl4AI pro svou RAG pipeline, protože potřebuje přesnou kontrolu nad chunkingem a přípravou embeddingů, zatímco obchod, marketing a research používají Thunderbit pro každodenní požadavky typu „potřebuju do tří odpoledne seznam firem“, kvůli kterým se nevyplatí psát skript. Mezi těmito dvěma produkty neexistuje žádná oficiální integrace a nebudu předstírat opak — ale rozdělení podle rolí dává v praxi smysl samo o sobě.
Verdikt
Moje upřímné hodnocení po letech strávených na obou stranách — u „stavění automatizace“ i u sledování toho, jak s automatizací lidé zápasí — je jednoduché: vybírejte podle toho, kdo práci dělá a jak hluboký ten workload je. Pokud máte vývojáře, kteří mají čas udržovat infrastrukturu, a potřebujete hluboké adaptivní crawlávání pro AI pipeline, Crawl4AI je opravdu silná a dobře udržovaná open-source volba. Pokud potřebujete dostat strukturovaná data z webů bez rozjíždění Python prostředí — a většina lidí, kteří se ptají „mám použít scraper?“, spadá právě sem — Thunderbit vás k výsledku dostane rychleji a s menší údržbou do budoucna. Univerzální vítěz neexistuje; je jen lepší fit podle toho, na které straně klávesnice sedíte.
Jestli chcete vidět, jak přesně funguje no-code přístup, stojí za to mrknout na web scraping bez kódování nebo si projít náš přehled nejlepších AI web scraperů, abyste měli lepší kontext, kde tyhle nástroje leží vůči sobě.
FAQ
Je Crawl4AI opravdu zdarma a open source? Jádro knihovny je pod licencí Apache 2.0 s projektovou doložkou o uvedení autorství a neplatíte žádné předplatné dodavateli. „Zdarma“ ale pokrývá jen licenci — pořád zaplatíte hosting, proxy a případná volání LLM API, která si nastavíte pro extrakci, plus čas vývojářů na stavbu a údržbu.
Vyžaduje Thunderbit kódování? Ne. Základní workflow — nainstalovat Chrome extension, kliknout na One Click Extract, zkontrolovat výsledky — žádný kód nevyžaduje. Vývojáři, kteří chtějí programový přístup, mohou použít Open API, MCP Server nebo CLI, ale jde jen o volitelné vrstvy, ne o nutnost.
Co je lepší pro RAG / LLM pipeline? Crawl4AI je pro tohle přímo navržené — generování Markdownu, hluboké a adaptivní crawlování i řízení chunkingu byly vytvořené s přípravou pro RAG na mysli. Thunderbit je stavěný na strukturovaná, exportovatelná byznys data (tabulky, leady, nabídky), ne na pipeline orientované na Markdown, takže pro vyhraněnou RAG architekturu je Crawl4AI přirozenější volba.
Co je rychlejší pro jednorázovou extrakci? Pro jednu stránku nebo pár stránek má Thunderbit díky one-click flow méně kroků mezi „potřebuju tahle data“ a „mám tahle data“ — žádné nastavování prostředí, žádné psaní skriptu. U Crawl4AI se vyšší režie při rozjezdu vyplácí hlavně u opakovaných, velkých nebo silně přizpůsobených crawl úloh, ne u rychlých jednorázovek.
Má Thunderbit MCP a API přístup? Ano. Thunderbit nabízí MCP Server pro AI-agentní prostředí jako Claude a Cursor a také Open API pro backend a programové workflow, vedle no-code rozšíření do prohlížeče a webové aplikace. Pokud porovnáváte i alternativy mimo tyto dva nástroje, často se v té samé debatě objevují Firecrawl, Apify a Bright Data, a stojí za to se podívat i na náš širší přehled AI web scrapingu, kde je celý trh rozebraný.




