
Google ukončil své Flights API už v roce 2018, ale ceny letenek se dál mění — u jedné domácí trasy až 17krát za 48 hodin. Pokud k těmto datům chcete přistupovat programově, scraping je v podstatě jediná reálná cesta.
Strávil jsem hodně času testováním různých přístupů k získávání letových dat z Googlu a situace se zásadně změnila — zejména poté, co Google v lednu 2025 nasadil SearchGuard. V tomto návodu vám ukážu, jak postavit funkční Python scraper pro Google Flights pomocí Playwrightu, jak zvládnout anti-bot opatření, na kterých většina lidí ztroskotá, a pak z toho vytvořit automatický sledovač cen s upozorněními. Pokud se chcete obejít bez kódu, ukážu také no-code zkratku přes Thunderbit, se kterou se dostanete ke stejnému výsledku přibližně za dvě minuty.
Proč scrapovat Google Flights v Pythonu?
Google Flights dominuje vyhledávání letenek. Jeho viditelnost na mobilech v USA vyskočila na 47,6 %, čímž předstihl všechny hlavní OTA platformy. Trh cestovních metavyhledávačů má hodnotu $8,33 miliardy v roce 2024 a roste tempem 30,2 % CAGR. Jenže od chvíle, kdy bylo QPX Express API trvale vypnuto 10. dubna 2018, neexistuje oficiální způsob, jak se k těmto datům dostat programově.
Mezitím se ceny letenek u stejné itineráře mohou měnit až o 50 %, přičemž rozdíl mezi nejnižší a nejvyšší cenou bývá v průměru kolem 20 dolarů. Letecké společnosti jako Delta používají pro dynamické naceňování 77 cenových kategorií. Průměrná zpáteční letenka v USA na začátku roku 2026 stojí 408 dolarů a letenky jsou meziročně o 14,9 % dražší.
Dominantní platforma, žádné API, proměnlivé ceny. Proto se scraping Google Flights v Pythonu stal jedním z nejčastějších projektů na GitHubu i v cestovatelských fórech.
Tohle z něj mohou těžit a jak:
| Typ uživatele | Případ použití | Hlavní přínos |
|---|---|---|
| Jednotliví cestující | Sledování cen konkrétních tras v čase | Úspora v průměru $50 na let |
| Cestovní agentury | Cenová inteligence vůči konkurenci | Monitoring parity cen v reálném čase |
| Firemní travel týmy | Optimalizace nákladů napříč trasami | Úspora 10–30 % na služebních cestách |
| Vývojáři | Tvorba aplikací pro porovnání tarifů | Programový přístup k cenovým datům |
| Výzkumníci | Analýza cenové volatility aerolinek | Akademický a tržní výzkum |
Uživatelé ve fórech to říkají naplno: „Google Flights API bylo zrušeno a měl bych místo toho použít web scraping“ je názor, který se objevuje znovu a znovu. A návratnost je reálná — Hopper tvrdí 95% přesnost predikcí při analýze více než 5 miliard cenových nabídek denně, zatímco data Expedia z roku 2026 ukazují, že rezervace 8–15 dní před odletem ušetří asi 25 dolarů na domácích letech.
Jaká data lze z Google Flights scrapovat?
Výsledková stránka Google Flights obsahuje překvapivě bohatou sadu dat. Typicky lze získat:
- Název aerolinky (a logo)
- Čas odletu a kód letiště
- Čas příletu a kód letiště
- Celkovou dobu letu
- Počet přestupů a detaily přestupů (letiště, délka, zda jde o noční přestup)
- Cenu letenky (podle měny)
- Emise CO2 (kg CO2e, včetně procentního rozdílu oproti běžným letům)
- Cestovní třídu, číslo letu, model letadla
- Prostor pro nohy
- Doplňky (Wi‑Fi, zásuvky, streamování médií)
- Ukazatel cenové úrovně (nízká / běžná / vysoká)
- Varování před zpožděním („Často zpožděno o více než 30 min“)
Dostupnost dat se liší podle trasy, data a typu letenky (jednosměrná vs. zpáteční). Takhle vypadá jeden scrapovaný záznam letu ve formátu JSON:
{
  "search_date": "2026-04-16",
  "route": "SFO-JFK",
  "departure_date": "2026-05-15",
  "flights": [
    {
      "airline": "United Airlines",
      "flight_number": "UA123",
      "departure_time": "08:00",
      "departure_airport": "SFO",
      "arrival_time": "16:35",
      "arrival_airport": "JFK",
      "duration_minutes": 335,
      "stops": 0,
      "price_usd": 287,
      "price_level": "low",
      "co2_kg": 156,
      "co2_vs_typical": "-12%",
      "travel_class": "Economy"
    }
  ]
}
Nastavení Python prostředí
Než napíšeme první scrapingový kód, je potřeba mít připraveno několik věcí.
Požadavky:
- Obtížnost: Střední
- Časová náročnost: cca 1–2 hodiny pro celý tutoriál
- Co budete potřebovat: Python 3.7+, základní znalost Pythonu, prohlížeč založený na Chromiu
Instalace potřebných knihoven
Použijeme Playwright pro automatizaci prohlížeče (Google Flights je z 100 % renderovaný JavaScriptem — běžné HTTP požadavky vrací jen nepoužitelný obsah), plus několik pomocníků:
pip install playwright playwright-stealth pandas
playwright install chromium
- Playwright — automatizace headless prohlížeče, zvládá renderování JavaScriptu, vestavěné čekací mechanismy
- playwright-stealth — maskuje běžné signály detekce botů
- pandas — pro analýzu dat a pozdější export do CSV
Proč Playwright místo Selenium nebo requests
Google Flights nebude fungovat jen s requests + BeautifulSoup — obsah stránky se vykresluje výhradně pomocí JavaScriptu. Potřebujete skutečný prohlížeč.
| Vlastnost | Playwright | Selenium | requests + BS4 |
|---|---|---|---|
| Renderování JS | Plná podpora | Plná podpora | Žádné |
| Rychlost | O 42 % rychlejší celkově | Základ | V tomto případě N/A |
| Podpora async | Nativní | Jen sekvenčně | N/A |
| Využití paměti | O 30 % méně | Vyšší | Minimální |
| Obejití detekce botů | Dobré (se stealth režimem) | Snáz detekovatelné | N/A |
Playwright je rychlejší, modernější a lépe zvládá async. Pro Google Flights je to jasná volba.
Krok za krokem: Jak scrapovat Google Flights v Pythonu
Tohle je jádro celého návodu. Scraper postavíme postupně.
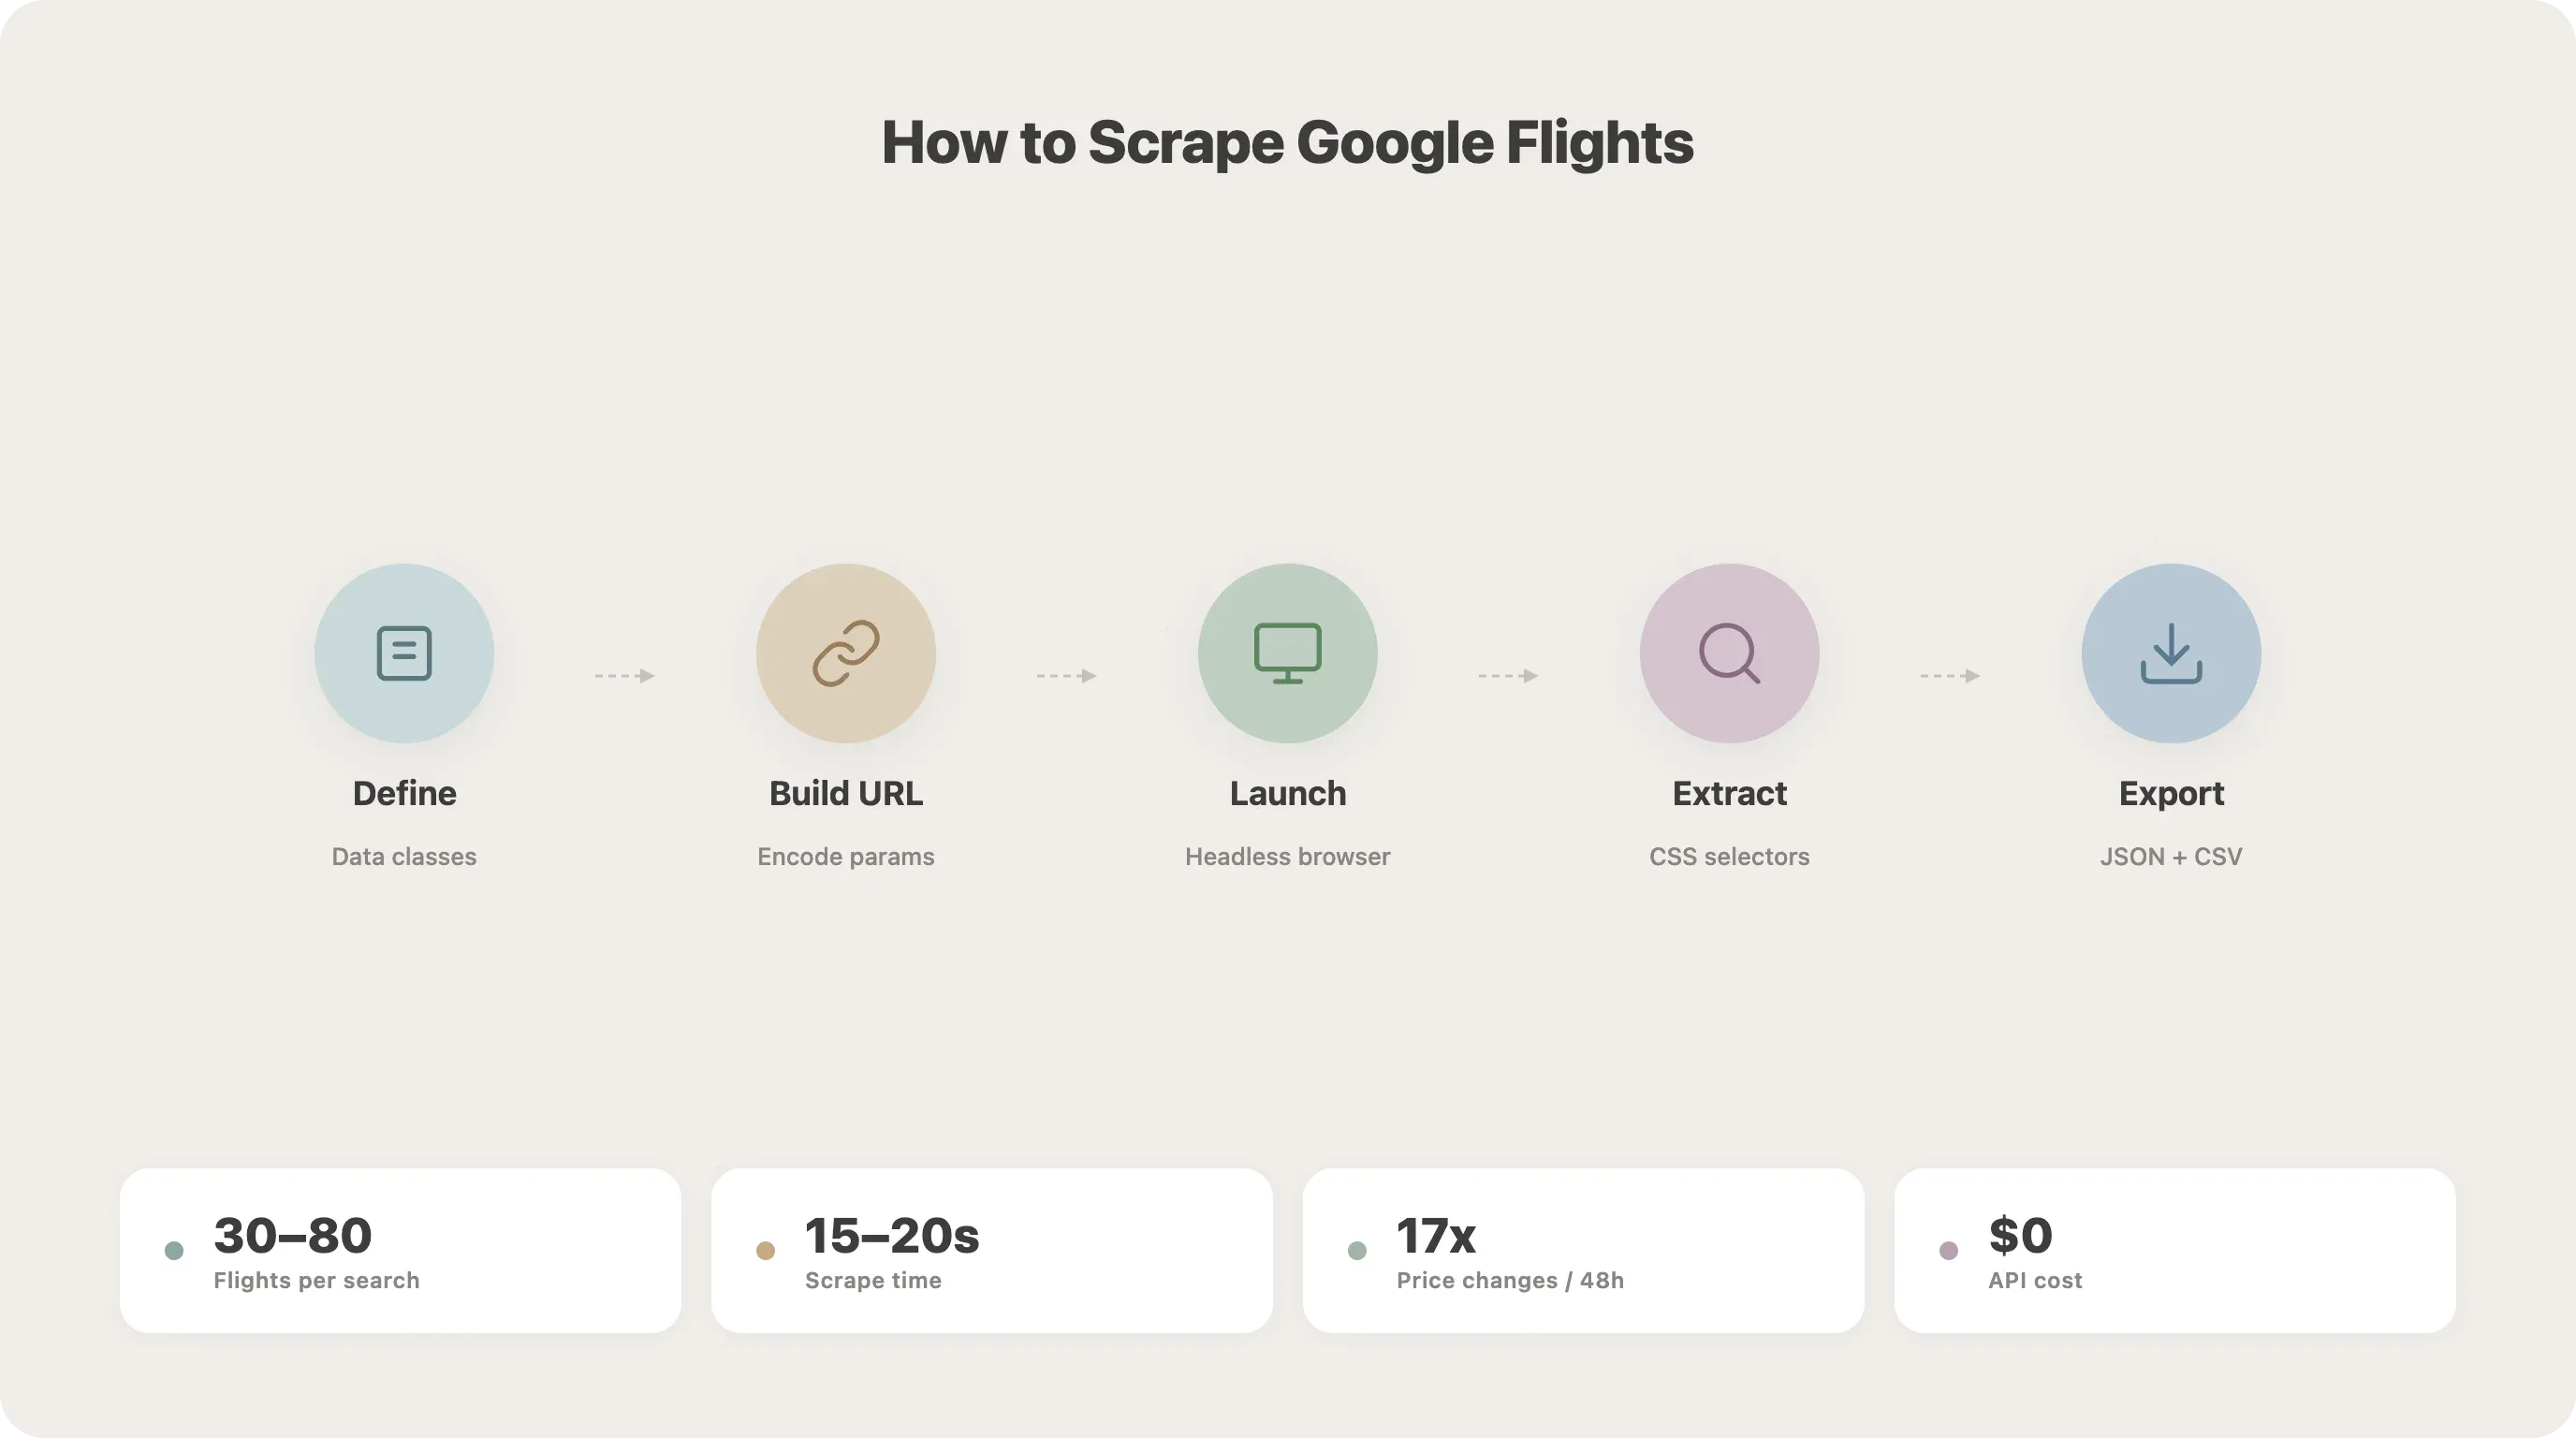
Krok 1: Definujte datové třídy
Začněte tím, že si v Pythonu pomocí dataclassů strukturovaně popíšete parametry vyhledávání a data o letech. Kód bude čistší a později se bude lépe rozšiřovat.
from dataclasses import dataclass, field
from typing import Optional, List

@dataclass
class SearchParams:
    origin: str          # např. "SFO"
    destination: str     # např. "JFK"
    departure_date: str   # např. "2026-05-15"
    return_date: Optional[str] = None
    trip_type: str = "one-way"  # "one-way" nebo "round-trip"
    travel_class: str = "economy"

@dataclass
class FlightData:
    airline: str = ""
    departure_time: str = ""
    arrival_time: str = ""
    duration: str = ""
    stops: str = ""
    price: str = ""
    co2_emissions: str = ""
Každé pole přímo odpovídá tomu, co budeme ze stránky extrahovat. Díky této struktuře nebudete později předávat nepořádné slovníky.
Krok 2: Pochopení struktury URL Google Flights
Google Flights kódování parametrů vyhledávání provádí pomocí Base64-enkódovaného Protobufu v URL parametru tfs. Můžete buď reverzně analyzovat toto kódování, nebo zvolit jednodušší cestu: sestavit URL v přirozeném jazyce.
Nejjednodušší varianta používá formát vyhledávacího dotazu:
https://www.google.com/travel/flights?q=flights+from+SFO+to+JFK+on+2026-05-15&curr=USD
Pro větší kontrolu můžete URL generovat programově:
def build_flights_url(origin: str, destination: str, date: str) -> str:
    base = "https://www.google.com/travel/flights"
    query = f"flights from {origin} to {destination} on {date}"
    return f"{base}?q={query.replace(' ', '+')}&curr=USD"
Alternativa — reverzní inženýrství Protobuf kódování — dává přesnější kontrolu, ale přestává fungovat, jakmile Google změní interní formát. Knihovny jako fast-flights na GitHubu používají dekódování Protobufu, aby se vyhnuly parsování HTML úplně, ale jde o pokročilejší přístup.
Krok 3: Spuštění prohlížeče a otevření Google Flights
Tady je nastavení pro Playwright. Používáme playwright-stealth, abychom hned od začátku snížili riziko detekce.
import asyncio
from playwright.async_api import async_playwright
from playwright_stealth import Stealth

async def scrape_flights(params: SearchParams) -> List[FlightData]:
    async with Stealth().use_async(async_playwright()) as pw:
        browser = await pw.chromium.launch(
            headless=True,
            args=[
                "--disable-blink-features=AutomationControlled",
                "--disable-dev-shm-usage",
                "--no-first-run",
            ]
        )
        context = await browser.new_context(
            viewport={"width": 1920, "height": 1080},
            user_agent=(
                "Mozilla/5.0 (Windows NT 10.0; Win64; x64) "
                "AppleWebKit/537.36 (KHTML, like Gecko) "
                "Chrome/125.0.0.0 Safari/537.36"
            ),
            locale="en-US",
            timezone_id="America/New_York",
        )
        # Přednastavíme cookie souhlasu, aby se přeskočilo okno s consentem
        await context.add_cookies([{
            "name": "SOCS",
            "value": "CAESHwgBEhJnd3NfMjAyNTAyMjctMF9SQzIaBXpoLUNOIAEaBgiAy6O-Bg",
            "domain": ".google.com",
            "path": "/"
        }])
        page = await context.new_page()
Pro produkční použití běžíme v headless režimu (pro ladění přepněte na headless=False), nastavujeme realistický viewport i user-agent a předem ukládáme cookie SOCS, aby se přeskočilo consent okno — o tom víc v části o anti-bot ochraně.
Krok 4: Přejděte na výsledky vyhledávání
Načtěte sestavenou URL a počkejte, až se objeví výsledky letů:
        url = build_flights_url(
            params.origin, params.destination, params.departure_date
        )
        await page.goto(url, wait_until="networkidle")

        # Počkáme na načtení výsledků letů
        await page.wait_for_selector(
            "li.pIav2d", timeout=15000
        )
Pokud zde dostáváte timeout, obvykle to znamená buď to, že stránku zablokovalo consent okno (viz oprava pomocí cookie ve 3. kroku), nebo Google servíruje CAPTCHA. Obojí řešíme v části o anti-bot ochraně.
Krok 5: Načtěte všechny výsledky letů
Google Flights skrývá další výsledky za tlačítkem „Show more flights“. Musíte na něj klikat opakovaně, dokud nejsou vidět všechny lety:
        # Klikáme na "Show more flights", dokud se nenačtou všechny výsledky
        while True:
            try:
                more_button = page.locator(
                    'button:has-text("Show more flights")'
                )
                if await more_button.is_visible(timeout=3000):
                    await more_button.click()
                    await page.wait_for_timeout(2000)
                else:
                    break
            except Exception:
                break
Tento cyklus tlačítko klikne, počká 2 sekundy na vykreslení nových výsledků a skončí, jakmile tlačítko zmizí. Podle mých testů má většina tras 1–3 stránky výsledků.
Krok 6: Extrahujte data o letu pomocí CSS selektorů
Teď z načtené stránky vyparsujeme samotná data o letu. Tady jsou selektory (ověřené k dubnu 2026 — viz sekce o údržbě níže, proč na tom datum záleží):
        flights = []
        cards = await page.query_selector_all("li.pIav2d")

        for card in cards:
            flight = FlightData()

            # Název aerolinky
            airline_el = await card.query_selector(
                "div.sSHqwe span:not([class])"
            )
            if airline_el:
                flight.airline = (await airline_el.inner_text()).strip()

            # Čas odletu
            dep_el = await card.query_selector(
                'span[aria-label*="Departure time"]'
            )
            if dep_el:
                flight.departure_time = (await dep_el.inner_text()).strip()

            # Čas příletu
            arr_el = await card.query_selector(
                'span[aria-label*="Arrival time"]'
            )
            if arr_el:
                flight.arrival_time = (await arr_el.inner_text()).strip()

            # Doba letu
            dur_el = await card.query_selector("div.gvkrdb")
            if dur_el:
                flight.duration = (await dur_el.inner_text()).strip()

            # Přestupy
            stops_el = await card.query_selector("div.EfT7Ae span")
            if stops_el:
                flight.stops = (await stops_el.inner_text()).strip()

            # Cena
            price_el = await card.query_selector(
                "div.FpEdX span"
            )
            if price_el:
                flight.price = (await price_el.inner_text()).strip()

            # Emise CO2
            co2_el = await card.query_selector("div.O7CXue")
            if co2_el:
                flight.co2_emissions = (
                    await co2_el.get_attribute("aria-label") or ""
                ).strip()

            flights.append(flight)

        await browser.close()
        return flights
Pozor: názvy tříd jako pIav2d, sSHqwe a FpEdX generuje Google Closure Compiler a mohou se změnit při libovolném buildu. Selektory přes aria-label jsou stabilnější. Níže ukážu strategii údržby.
Krok 7: Uložení výsledků do JSON nebo CSV
Nakonec si scrapovaná data uložte s časovým razítkem (to je klíčové pro pozdější sledování cen):
import json
from datetime import datetime
from dataclasses import asdict

async def main():
    params = SearchParams(
        origin="SFO",
        destination="JFK",
        departure_date="2026-05-15"
    )
    flights = await scrape_flights(params)

    output = {
        "search_date": datetime.now().isoformat(),
        "params": asdict(params),
        "flights": [asdict(f) for f in flights],
    }

    with open("flights.json", "w") as f:
        json.dump(output, f, indent=2)

    # Uložíme i CSV
    import pandas as pd
    df = pd.DataFrame([asdict(f) for f in flights])
    df["search_date"] = datetime.now().isoformat()
    df["route"] = f"{params.origin}-{params.destination}"
    df.to_csv("flights.csv", index=False)

    print(f"Scrapováno {len(flights)} letů")

asyncio.run(main())
Spusťte to a měli byste dostat flights.json i flights.csv s výsledky. V mých testech vrací vyhledání SFO-JFK obvykle 30–80 možností letu a dokončí se za zhruba 15–20 sekund.
Průvodce přežitím anti-bot ochrany při scrapování Google Flights
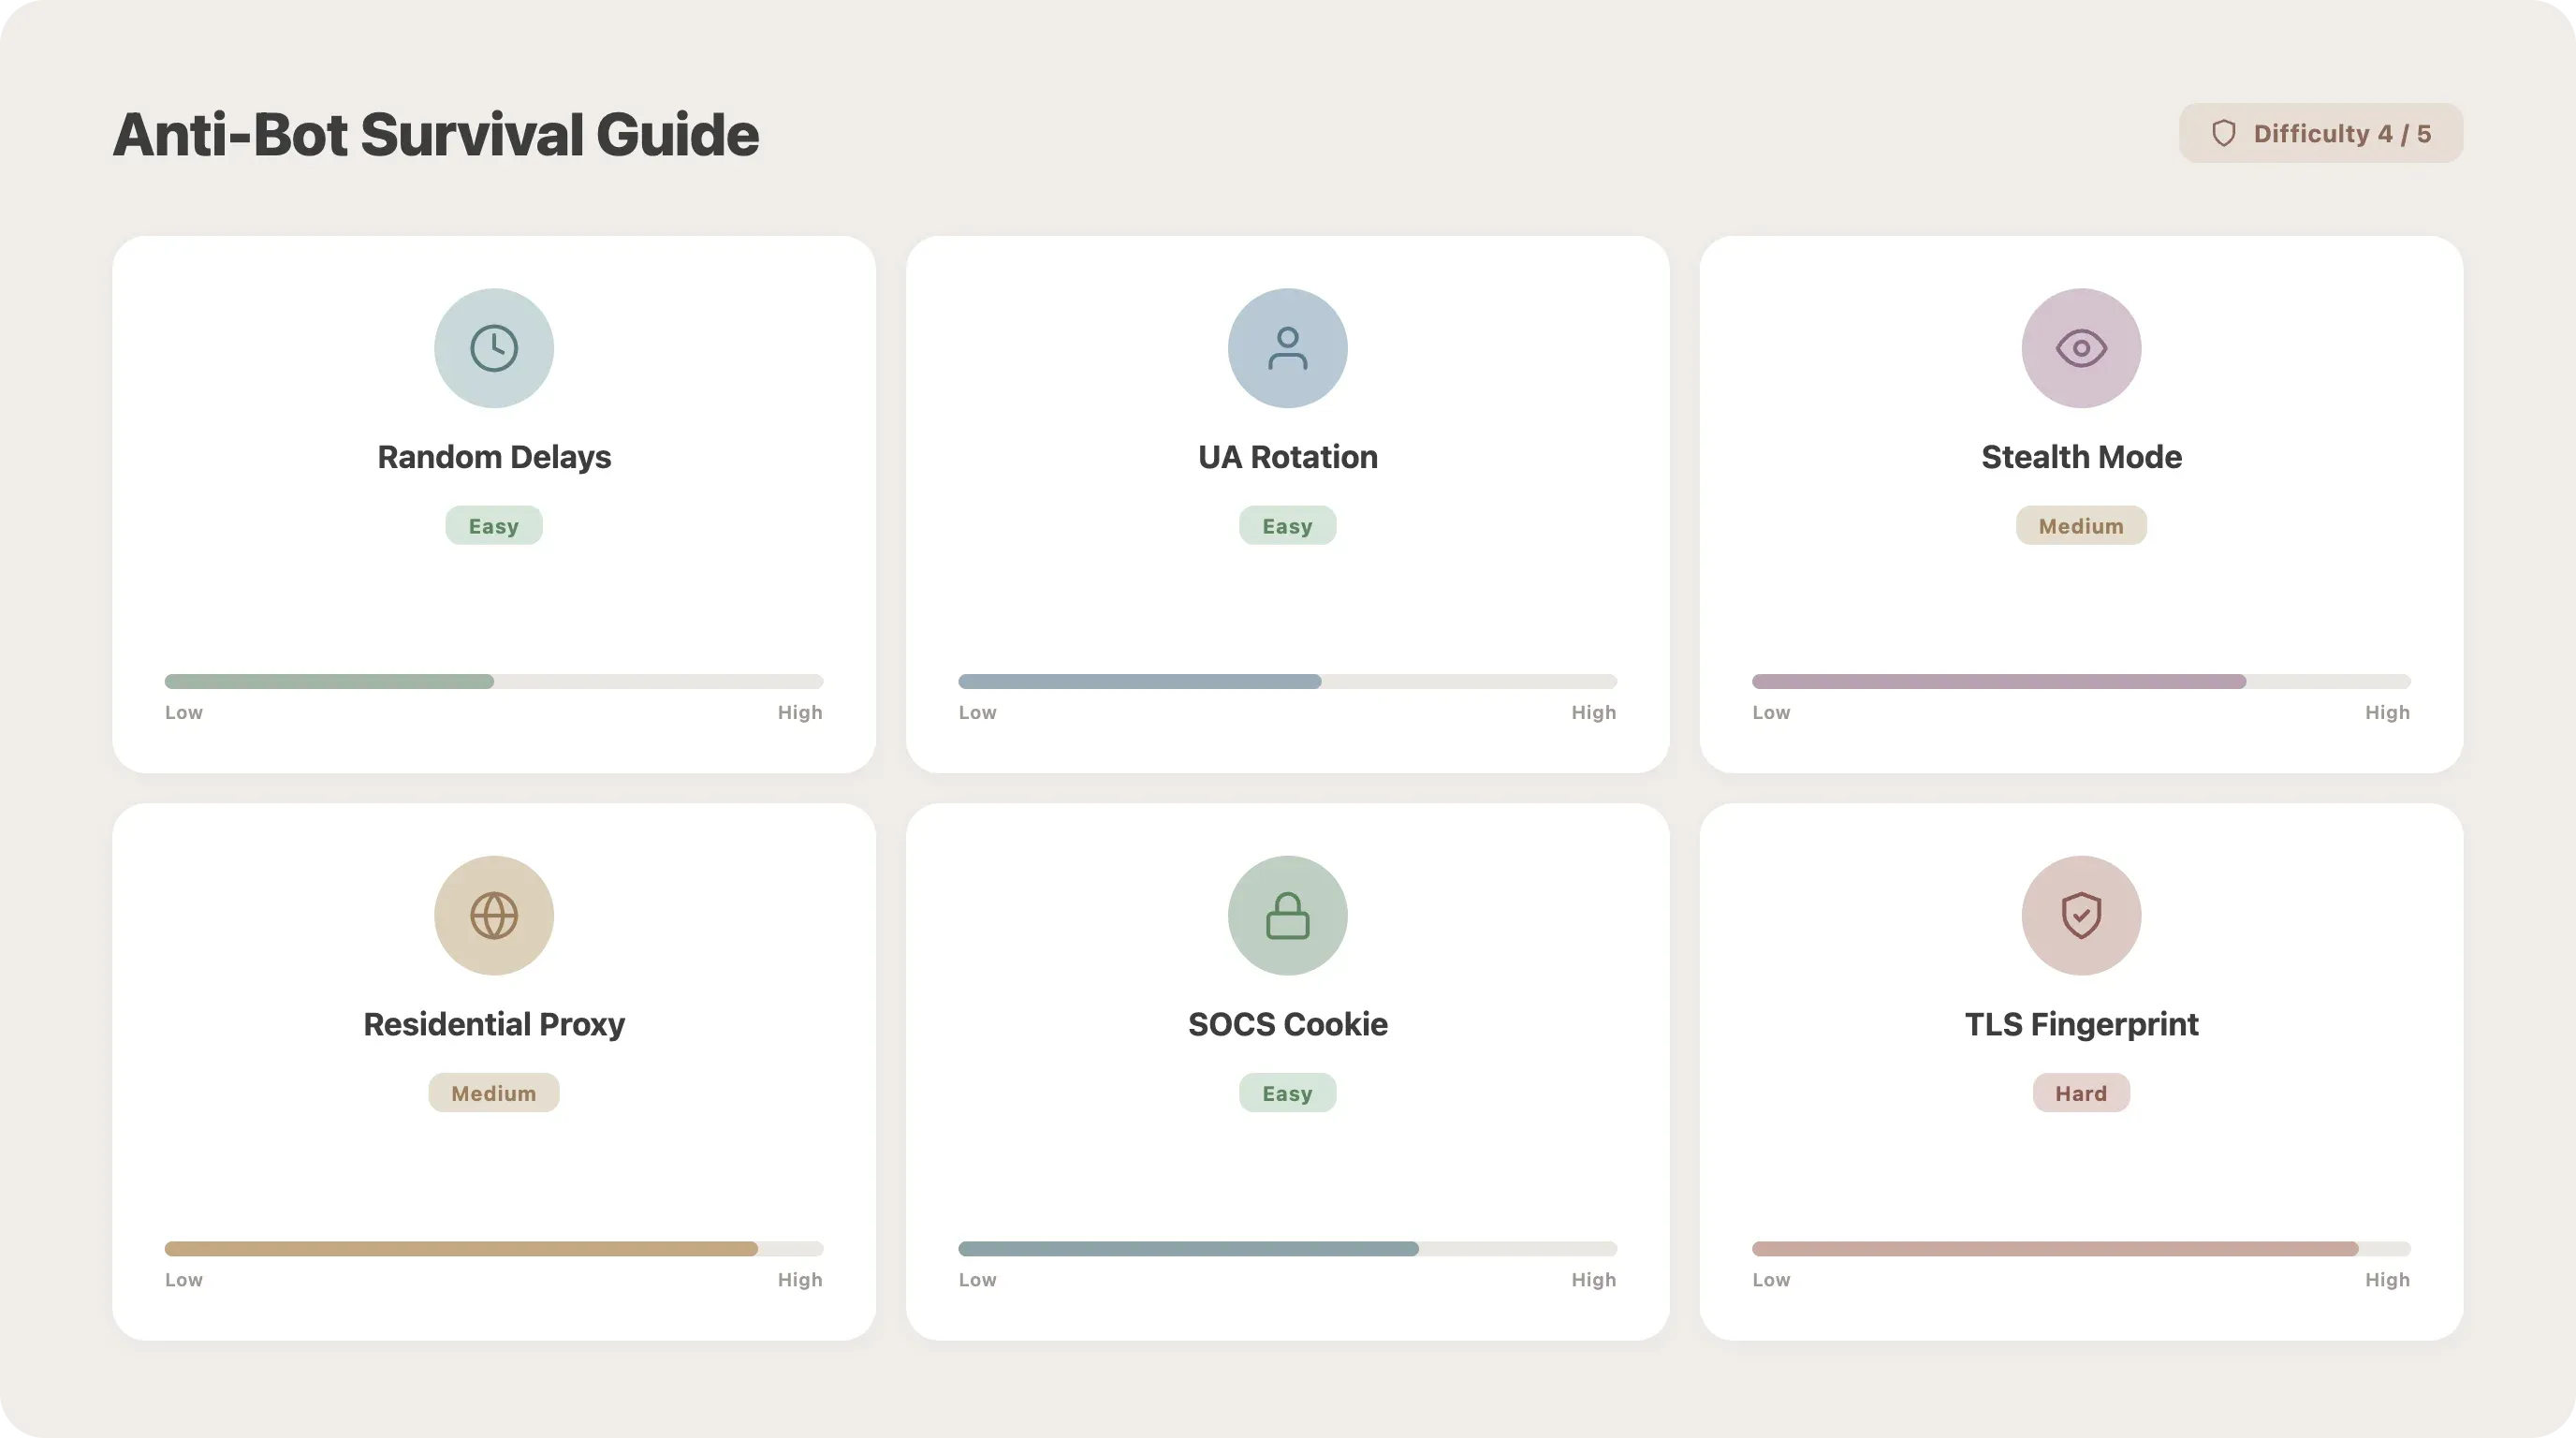
Většina návodů tady končí. Většina scraperů tady selže. Google v lednu 2025 nasadil SearchGuard, který přes noc rozbil téměř všechny SERP scrapery. Google to popisuje jako „výsledek desítek tisíc člověkohodin a milionů dolarů investic“. Google Flights je hodnocen jako 4/5 z hlediska obtížnosti scrapování.
Žádný konkurenční článek tohle nerozebírá do hloubky, a přitom je to hlavní důvod, proč scraperům lidem přestávají fungovat. Tady je, co proti vám stojí a jak na to.
Náhodné prodlevy mezi požadavky
Nejjednodušší obrana proti rate limitu. Dva řádky kódu, střední účinnost:
import time
import random

time.sleep(random.uniform(3, 7))
Vložte to mezi přechody mezi stránkami. Pevné intervaly (například přesně 5 sekund pokaždé) jsou podezřelé — je potřeba je náhodně obměňovat.
Rotace User-Agentu
Posílat při každém požadavku stejný user-agent je snadno rozpoznatelný vzorec. Střídejte je ze seznamu:
import random

USER_AGENTS = [
    "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 Chrome/125.0.0.0 Safari/537.36",
    "Mozilla/5.0 (Macintosh; Intel Mac OS X 14_5) AppleWebKit/605.1.15 Safari/605.1.15",
    "Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 Chrome/124.0.0.0 Safari/537.36",
    "Mozilla/5.0 (Windows NT 10.0; Win64; x64; rv:126.0) Gecko/20100101 Firefox/126.0",
]

user_agent = random.choice(USER_AGENTS)
Obejítí detekce headless režimu
Google kontroluje příznak navigator.webdriver i další automatizační signály. Knihovna playwright-stealth pokryje většinu z nich, ale měli byste zároveň použít i spouštěcí parametry z kroku 3. Klíčové přepínače:
args=[
    "--disable-blink-features=AutomationControlled",
    "--disable-dev-shm-usage",
    "--no-first-run",
]
To vás dostane přes základní detekci. SearchGuard jde hlouběji — sleduje rychlost pohybu myši, načasování kláves a vzory scrollování — ale pro scraping v nižším až středním objemu obvykle stačí stealth režim a realistické prodlevy.
Rotace proxy: datacentrové vs. rezidenční
Pro cokoliv nad pár vyhledání budete potřebovat proxy. Rozdíl je zásadní:
| Vlastnost | Datacentrové proxy | Rezidenční proxy |
|---|---|---|
| Rychlost | 100–1 000 Mbps | 10–100 Mbps |
| Úspěšnost (Google) | 20–40 % | 85–95 % |
| Cena | $0,10–$0,50/IP/měsíc | $5–$15/GB |
| Riziko detekce | Vysoké | Velmi nízké |
Rezidenční proxy jsou při scrapování chráněných webů asi 180× levnější na úspěšný požadavek. Ceníky poskytovatelů v roce 2026: Smartproxy od $7/GB, Bright Data $8,40/GB, Oxylabs $8/GB.
Proxy přidáte do Playwrightu takto:
browser = await pw.chromium.launch(
    proxy={"server": "http://proxy-host:port",
           "username": "user", "password": "pass"}
)
Řešení vyskakovacího okna se souhlasem cookies
Uživatelé opakovaně uvádějí okno „Souhlasím s podmínkami“ jako blokující překážku: „nejdřív Google zobrazí vyskakovací okno 'souhlasím s podmínkami a pravidly'.“ Nejčistší řešení je přednastavit cookie SOCS (viz krok 3). Pokud to nestačí, klikněte přes něj:
try:
    accept_btn = page.locator('button:has-text("Accept all")')
    if await accept_btn.is_visible(timeout=3000):
        await accept_btn.click()
        await page.wait_for_timeout(1000)
except Exception:
    pass  # Žádné okno se nezobrazilo
Poznámka: text tlačítka se liší podle jazyka — v němčině „Alle akzeptieren“, ve francouzštině „Tout accepter“.
Rychlá přehledová tabulka anti-bot technik
| Technika | Obtížnost | Účinnost | Je potřeba kód? |
|---|---|---|---|
| Náhodné prodlevy (2–7 s) | Nízká | Střední | 2 řádky |
| Rotace user-agentu | Nízká | Střední | 5 řádků |
| Obejítí detekce headless | Střední | Vysoká | Launch args Playwrightu |
| Doplněk playwright-stealth | Střední | 60–80 % u základních webů | pip install |
| Rotace proxy (datacentrové) | Střední | Střední | Konfigurace |
| Rotace proxy (rezidenční) | Střední | 85–95 % úspěšnost | Konfigurace |
| Přednastavení consent cookie (SOCS) | Nízká | Nutné | 1 řádek |
Doporučené bezpečné tempo: mezi požadavky držte prodlevy 10–20 sekund a rotujte IP adresy. Prahové hodnoty Googlu jsou zhruba 100 požadavků za minutu na jednu IP, než dostanete 429, a dlouhodobý objem nad 1 000 požadavků denně na IP může vyvolat dočasný ban.
Proč se vám stále rozbíjejí selektory pro Google Flights (a jak to opravit)
Tohle je zdaleka největší bolest. Fóra jsou plná variant typu „všechno, co mi vrací, jsou 14 prázdných seznamů.“ Každý návod vám dá selektory. Nikdo nevysvětlí, proč se rozbíjejí.
Proč se selektory Google Flights mění
Důvodů jsou tři:
-
Obfuskace přes Closure Compiler. Google používá Closure Stylesheets k generování názvů tříd jako
BVAVmfaYMlIzpřesgoog.setCssNameMapping(). Tyto názvy se mění s každým buildem — někdy i týdně. -
A/B testování. Různí uživatelé současně vidí různé HTML struktury. Váš scraper může fungovat u vás, ale selhat u někoho v jiném regionu.
-
Rozdíly v lokalizaci. Uživatelé v EU vidí jiné termíny, rozložení i datová pole než uživatelé v USA.
Pište odolné selektory
Dávejte přednost selektorům založeným na významu, ne na vzhledu:
# Křehké — rozbije se při každém buildu
price_el = await card.query_selector("div.BVAVmf > div.YMlIz")

# Odolnější — navázané na accessibility label
sp_el = await card.query_selector('span[aria-label*="Departure time"]')

# Taky odolné — textová shoda
more_btn = page.locator('button:has-text("Show more flights")')
Hierarchie stability selektorů (od nejstabilnějšího po nejméně stabilní):
aria-labelatributy — souvisí s přístupností, mění se zřídkadata-*atributy — přidávají se záměrně pro funkčnostroleatributy — ARIA role jsou sémantické- Selektory podle textu — shoda s viditelným obsahem
- Částečná shoda názvu třídy — např.
[class*="price"] - Plné obfuskované názvy tříd — pokud možno se jim vyhněte
Přidejte validační funkci
Nedovolte, aby rozbité selektory tiše vytvářely prázdná data. Zachyťte to hned:
import logging

logger = logging.getLogger(__name__)

def validate_flight(data: FlightData) -> bool:
    required = ["airline", "price", "departure_time",
                "arrival_time", "duration"]
    valid = True
    for field_name in required:
        if not getattr(data, field_name, ""):
            logger.warning(
                f"Chybí '{field_name}' — selektory bude možná potřeba aktualizovat"
            )
            valid = False
    return valid
Spouštějte ji na každý scrapovaný let. Jakmile se začnou objevovat varování, je čas stránku zkontrolovat a selektory upravit.
Strategie údržby selektorů
- Kontrolujte selektory měsíčně, nebo ihned, jakmile klesne kvalita výstupu
- Uchovávejte selektory v samostatném konfiguračním slovníku, aby šly snadno upravit
- Selektory v tomto článku byly naposledy ověřeny: duben 2026
- Zvažte knihovnu fast-flights jako alternativu — používá dekódování Protobufu místo CSS selektorů, takže tenhle problém obchází úplně (i když má vlastní zranitelnost, pokud Google změní interní datový formát)
Od jednorázového scrapu k automatickému sledování cen Google Flights
Většina návodů končí u „uložte do JSON“. Název tohoto článku ale slibuje „Price Alerts“. Tak pojďme doručit i to.
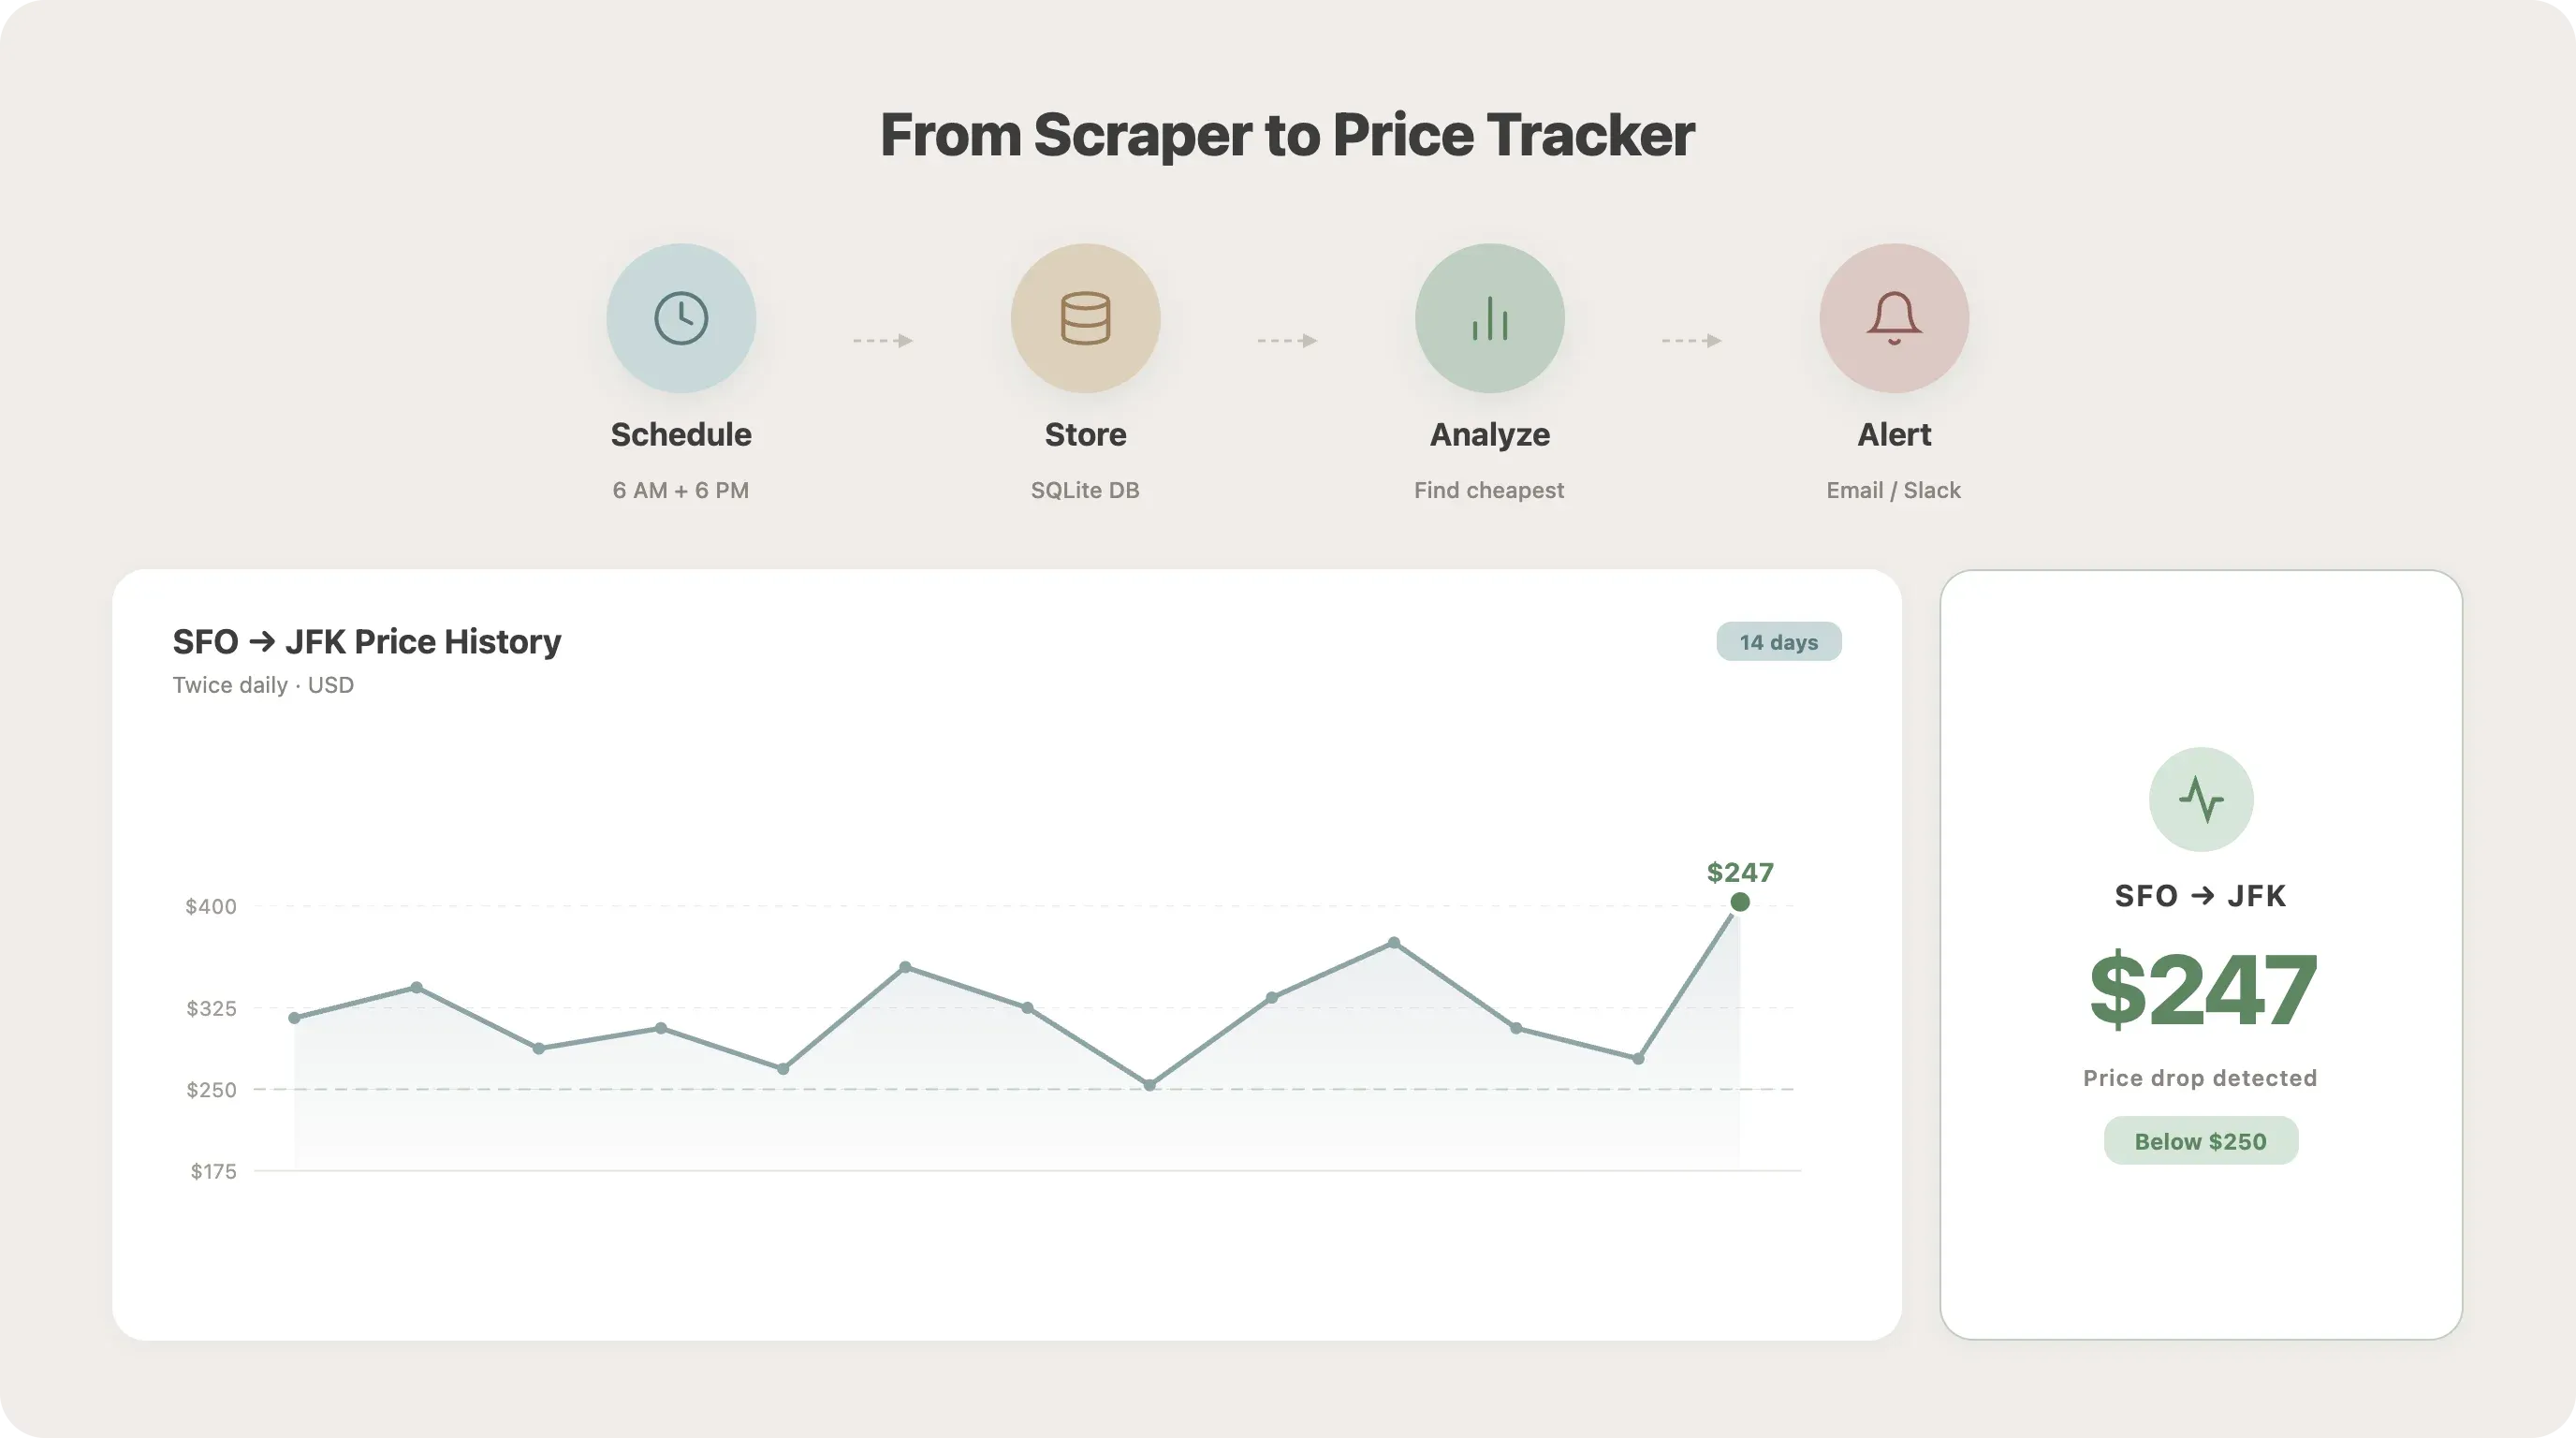
Naplánujte automatické spuštění scraperu
Možnost 1: knihovna schedule v Pythonu (nejjednodušší, multiplatformní):
import schedule
import time

def run_scraper():
    asyncio.run(main())

schedule.every().day.at("06:00").do(run_scraper)
schedule.every().day.at("18:00").do(run_scraper)

while True:
    schedule.run_pending()
    time.sleep(60)
Možnost 2: cron úloha (Linux/Mac):
# Spustit každý den v 6:00 a 18:00
0 6,18 * * * cd /path/to/scraper && python scraper.py
Možnost 3: Windows Task Scheduler — vytvořte základní úlohu, která spouští python scraper.py podle zvoleného rozvrhu.
Nevýhoda: všechna tato řešení vyžadují stroj, který běží neustále. Pokud to poběží na notebooku, který uspáváte, o scrape přijdete.
Ukládání historických cenových dat
Místo přepisování JSON souboru je lepší data připojovat do SQLite databáze:
import sqlite3
from datetime import datetime

def init_db():
    conn = sqlite3.connect("flights.db")
    conn.execute("""
        CREATE TABLE IF NOT EXISTS flights (
            id INTEGER PRIMARY KEY AUTOINCREMENT,
            scrape_date TEXT NOT NULL,
            route TEXT NOT NULL,
            airline TEXT,
            departure_time TEXT,
            arrival_time TEXT,
            duration TEXT,
            stops TEXT,
            price_usd REAL,
            co2_emissions TEXT
        )
    """)
    conn.execute(
        "CREATE INDEX IF NOT EXISTS idx_route_date "
        "ON flights(route, scrape_date)"
    )
    conn.commit()
    return conn

def save_flight(conn, route: str, flight: FlightData):
    price_num = float(
        flight.price.replace("$", "").replace(",", "")
    ) if flight.price else None
    conn.execute(
        "INSERT INTO flights "
        "(scrape_date, route, airline, departure_time, "
        "arrival_time, duration, stops, price_usd, co2_emissions) "
        "VALUES (?, ?, ?, ?, ?, ?, ?, ?, ?)",
        (datetime.now().isoformat(), route, flight.airline,
         flight.departure_time, flight.arrival_time,
         flight.duration, flight.stops, price_num,
         flight.co2_emissions)
    )
    conn.commit()
Po týdnu scrapování dvakrát denně budete mít dost dat na první trendovou analýzu.
Analýza cenových trendů a nastavení upozornění
Najděte nejlevnější variantu v historických datech:
import pandas as pd
import sqlite3

conn = sqlite3.connect("flights.db")
df = pd.read_sql_query(
    "SELECT * FROM flights WHERE route = 'SFO-JFK'", conn
)
summary = df.groupby("scrape_date")["price_usd"].agg(
    ["min", "max", "mean"]
)
cheapest = df.loc[df["price_usd"].idxmin()]
print(
    f"Nejlevnější: ${cheapest['price_usd']:.0f} dne "
    f"{cheapest['scrape_date']} ({cheapest['airline']})"
)
Pošlete e-mailové upozornění, když cena klesne pod váš limit:
import smtplib
from email.mime.text import MIMEText

def send_price_alert(route, price, threshold, recipient):
    msg = MIMEText(
        f"Upozornění na pokles ceny! {route}: ${price:.0f} "
        f"(pod vaším limitem ${threshold:.0f})"
    )
    msg["Subject"] = f"Výhodná letenka: {route} za ${price:.0f}"
    msg["From"] = "alerts@example.com"
    msg["To"] = recipient

    with smtplib.SMTP_SSL("smtp.gmail.com", 465) as server:
        server.login("alerts@example.com", "your_app_password")
        server.send_message(msg)

# Po každém scrapu zkontrolujte výhodné nabídky
min_price = df["price_usd"].min()
threshold = 250
if min_price < threshold:
    send_price_alert("SFO-JFK", min_price, threshold,
                     "you@email.com")
Doporučená frekvence scrapování: pro osobní sledování cen stačí dvakrát denně (náhodné časy snižují riziko detekce). Pro business monitoring každé 4–6 hodin. Hodinové scrapování jen během krátkodobých slev, a to pouze dočasně.
Snazší cesta: Thunderbit Scheduled Scraper
Pokud se vám konfigurace cron úloh, běžící server a proxy zdají jako příliš velká infrastruktura, Thunderbit's Scheduled Scraper zvládne stejný use case bez všech těchto starostí. Stačí popsat interval scrapování přirozeným jazykem, vložit URL vašich výsledků Google Flights a scraper běží automaticky na cloudové infrastruktuře Thunderbitu — s vestavěným řešením anti-bot ochrany a přímým exportem do Google Sheets, Excelu nebo Airtable. Není to náhrada za plně vlastní Python řešení (ztrácíte možnost hluboké customizace), ale pro konkrétní případ „chci tabulku se sledováním cen“ jde o nejrychlejší cestu. Vyzkoušet to můžete na bezplatném tarifu.
Když je Python zbytečně moc: no-code způsoby, jak scrapovat Google Flights
Po vybudování všeho výše řečeného musím být upřímný: je to spousta pohyblivých částí. Ne každý potřebuje takovou úroveň kontroly. Selektory se rozbíjejí, proxy se musí rotovat, cron úlohy je potřeba hlídat. Pokud je váš cíl „pravidelně dostávat ceny letenek do tabulky“, existují rychlejší možnosti.
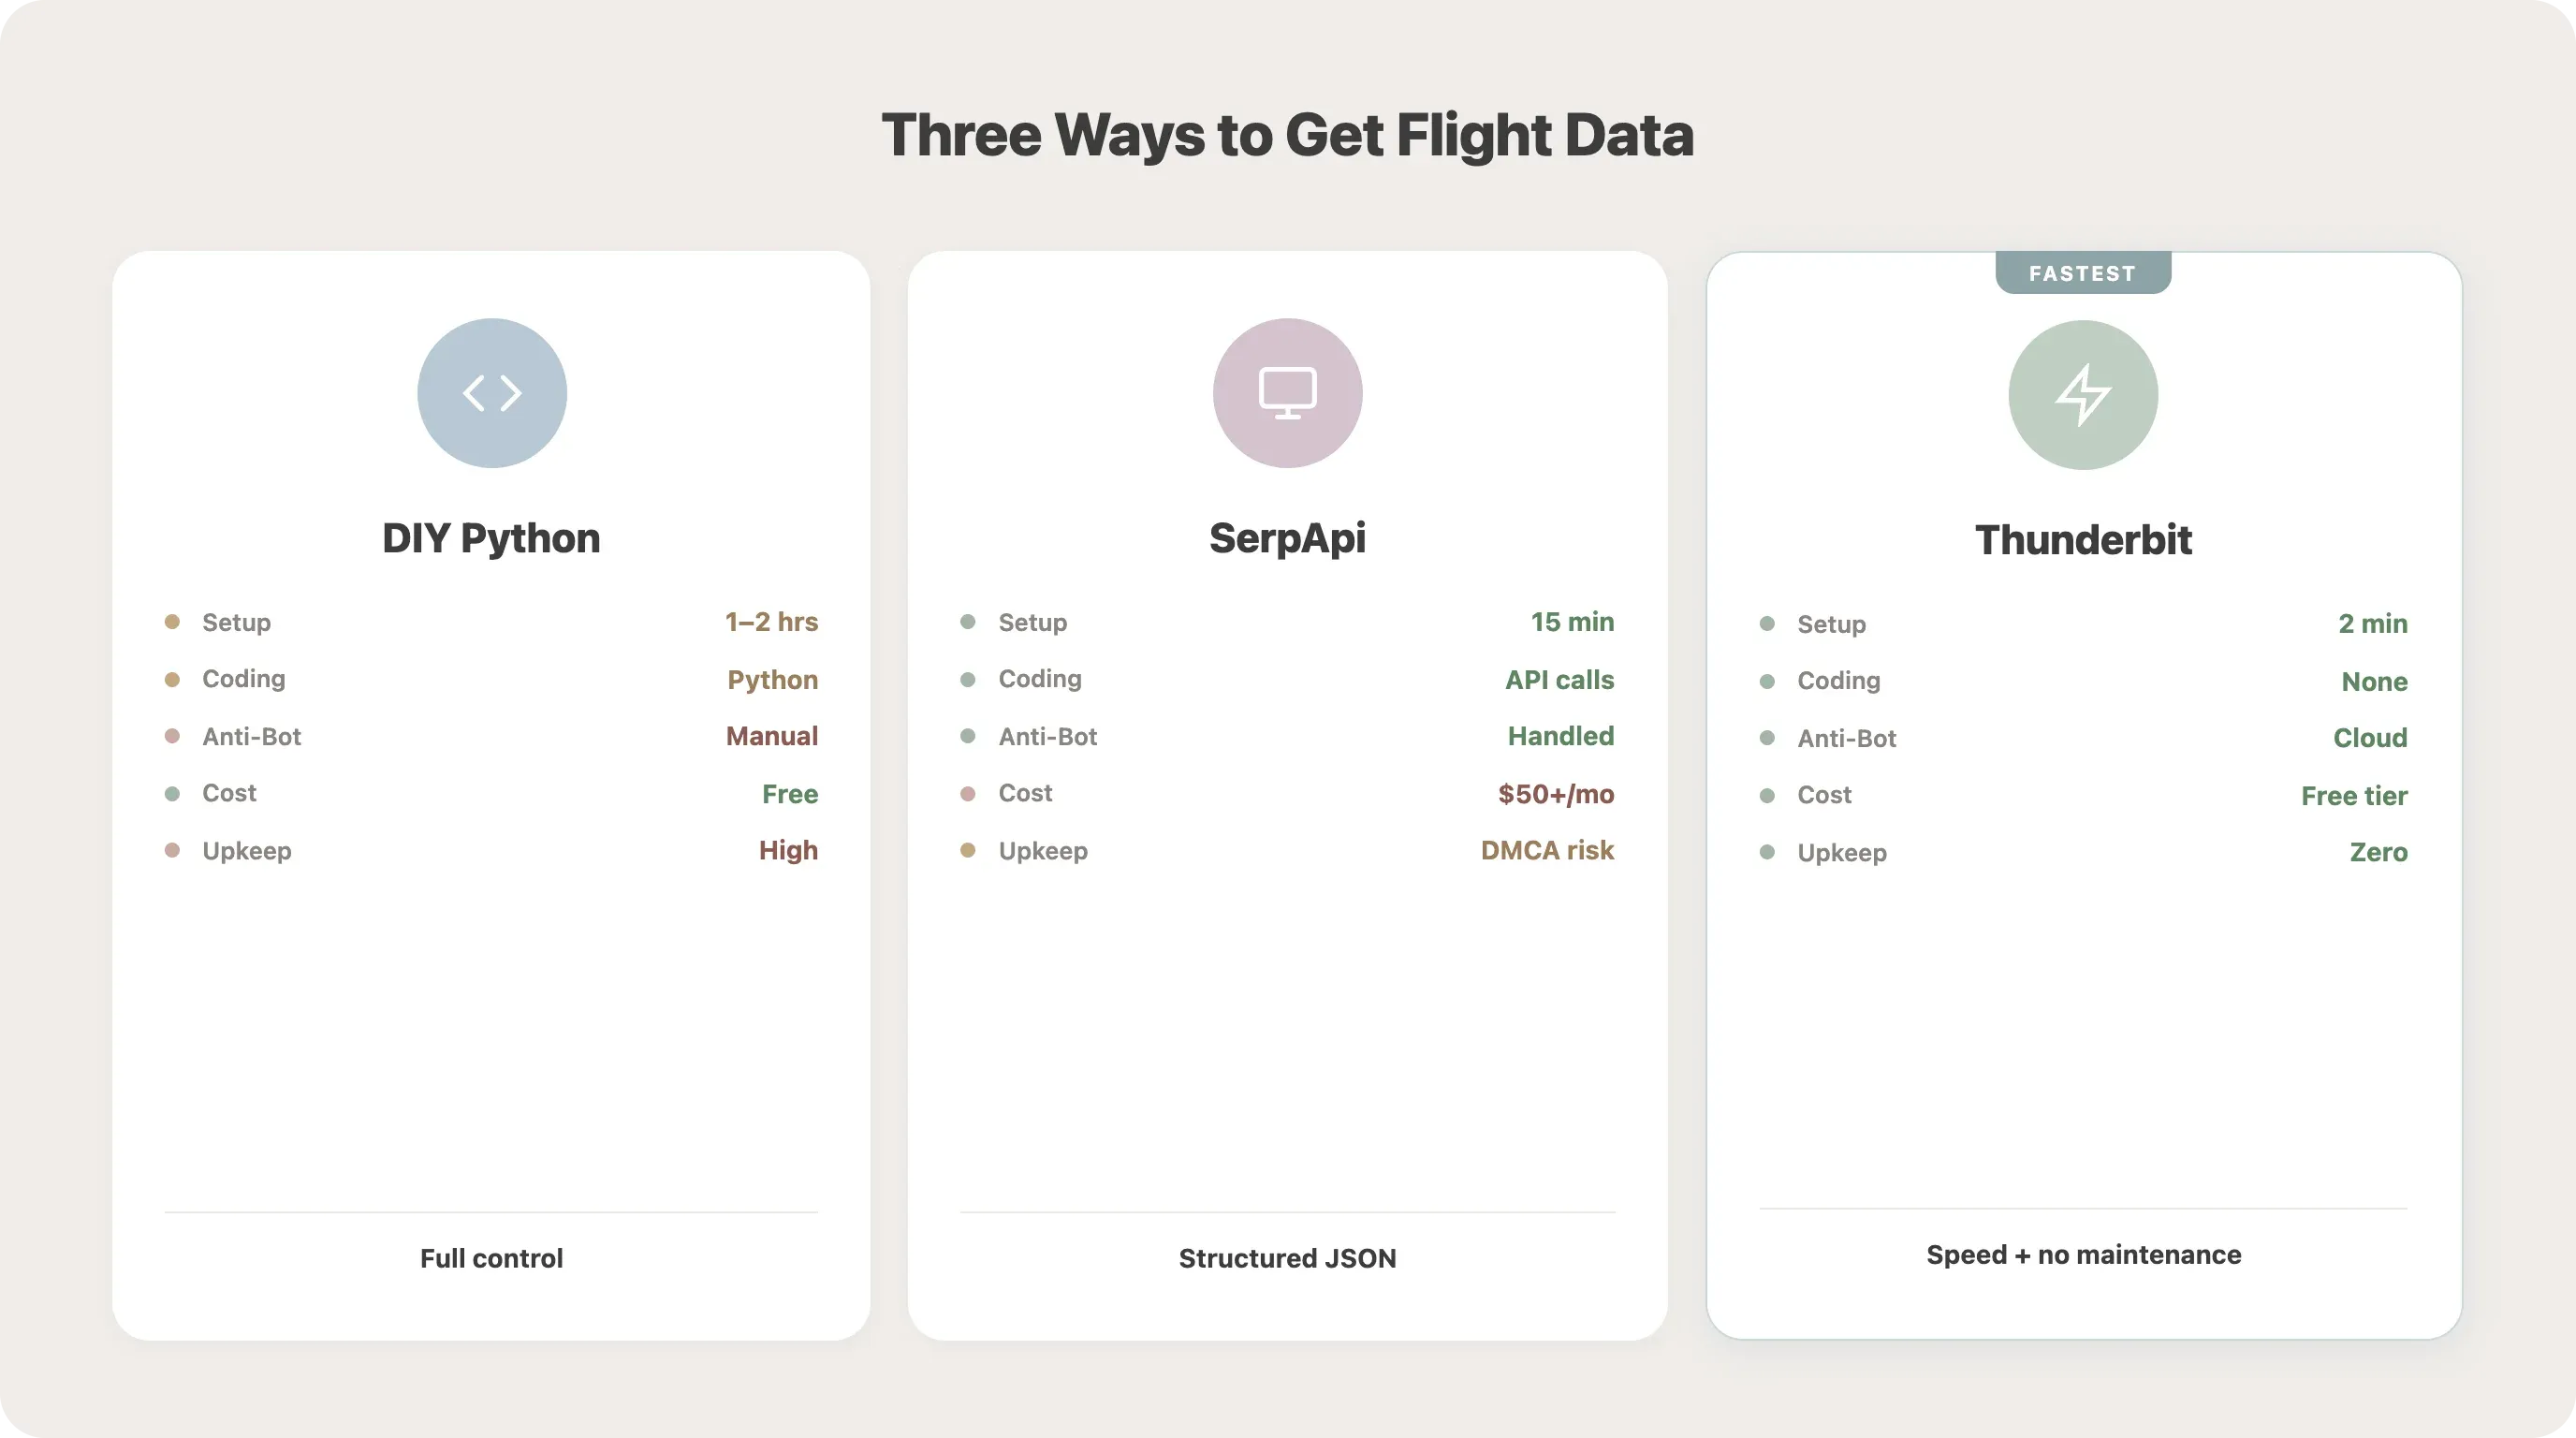
Srovnání: vlastní Python vs. API služby vs. Thunderbit
| Přístup | Čas na nastavení | Nutnost kódování | Řeší anti-bot | Plánování | Cena |
|---|---|---|---|---|---|
| DIY Playwright (tento návod) | 1–2 hodiny | Python (středně pokročilý) | Ruční konfigurace | Ručně (cron) | Zdarma + náklady na proxy |
| SerpApi Google Flights endpoint | 15 min | Jen API volání | Zajištěno | Přes API | cca $50+/měsíc |
| Thunderbit Chrome Extension | 2 min | Žádné | Cloud scraping | Vestavěný plánovač | K dispozici zdarma |
Poznámka k SerpApi: Google v prosinci 2025 podal žalobu podle DMCA na SerpApi, protože jejich požadavky měly během dvou let narůst o 25 000 %. Pokud zvažujete API poskytovatele, tahle právní nejistota stojí za zvážení.
Jak Thunderbit scrapuje Google Flights
Otevřete výsledky vyhledávání Google Flights v Chromu, klikněte v Thunderbitu na tlačítko „AI Suggest Fields“ — AI si přečte stránku a navrhne sloupce jako aerolinka, cena, čas odletu, přestupy — zkontrolujte navržená pole a klikněte na „Scrape“. Výsledky se objeví v tabulce, kterou lze exportovat do Excelu, Google Sheets, Airtable nebo Notion — vše na bezplatném tarifu.
Pro use case sledování cen konkrétně Thunderbit Scheduled Scraper a Cloud Scraping (který zvládne 50 stránek paralelně) nahradí celou infrastrukturu cron + proxy + server.
Python vám dá plnou kontrolu a neomezené možnosti přizpůsobení. Thunderbit přinese rychlost a nulovou údržbu. Záleží na vašem skutečném cíli. Pokud se chcete dozvědět víc o no-code přístupech, podívejte se na náš průvodce nejlepšími no-code web scrapery.
Je scrapování Google Flights legální? Co byste měli vědět
Uživatelé na fórech to řeší často: „přímé scrapování Google Flights porušuje podmínky používání Googlu.“ Je to oprávněná obava — zvlášť když bylo API zrušeno a neexistuje žádná oficiálně schválená alternativa.
Porušení podmínek vs. právní odpovědnost
Podmínky služby Googlu (aktualizované 22. května 2024) uvádějí, že uživatelé nesmějí „přistupovat ke službám nebo obsahu ani je používat prostřednictvím automatizovaných prostředků (například robotů, crawlerů nebo scraperů).“ Porušení ToS je porušení smlouvy (občanskoprávní věc) — není to totéž co porušení zákona.
Klíčový právní precedent: hiQ v. LinkedIn (9. obvod, 2022) stanovil, že scrapování veřejně dostupných dat neporušuje zákon CFAA (Computer Fraud and Abuse Act). Případ ale skončil smírem a prosincová žaloba Googlu na SerpApi v roce 2025 používá jinou právní teorii — DMCA § 1201 (obcházení technologických ochranných opatření) — která může být závažnější.
Nejlepší postupy pro odpovědné scrapování
- Omezujte rychlost požadavků — prodlevy 10–20 sekund s rotací IP
- Nescrapujte osobní údaje — ceny letenek jsou veřejně zobrazená agregovaná data
- Neobcházejte CAPTCHA programově (to je právně citlivá oblast DMCA)
- Používejte data pro osobní výzkum, ne pro vytváření konkurenčního komerčního produktu bez řádné licence
- Zvažte oficiální API, pokud jsou k dispozici
Alternativní zdroje dat
Pokud vám scrapování pro váš use case přijde příliš riskantní, existují legitimní API možnosti:
| Poskytovatel | Cena | Free tier | Poznámky |
|---|---|---|---|
| SerpApi | $75–$3 750+/měsíc | 250 vyhledávání/měsíc | Přímé Google Flights JSON (pod právním dohledem) |
| Kiwi Tequila | Zdarma (affiliate model) | Neomezeně | Nejlepší pro startupy a testování |
| Amadeus | Pay-as-you-go | 2 000 pož./měsíc | 400+ aerolinek, možnost rezervace |
| Skyscanner | Individuální | Vyžaduje schválení | 52 trhů, 30 jazyků |
Podrobnější rozbor právních dopadů web scrapingu najdete v našem dalším článku.
Závěr a klíčová zjištění
Bylo toho hodně. Tohle je to podstatné:
- Python + Playwright je nejflexibilnější cesta pro scraping Google Flights, ale vyžaduje průběžnou údržbu
- Anti-bot opatření (prodlevy, rotace user-agentu, rezidenční proxy) nejsou volitelná — jsou nezbytná pro spolehlivost, zejména po SearchGuardu
- Selektory se často rozbíjejí — používejte pokud možno
aria-labela textové selektory, validujte výstup a mějte plán údržby - Automatizujte pomocí
schedulenebo cronu, aby se jednorázový scrape změnil v reálný tracker cen s historickými daty a e-mailovými upozorněními - Thunderbit nabízí no-code alternativu s vestavěným plánováním, cloud scrapingem a anti-bot řešením — ideální, pokud chcete spíš tabulku se sledováním cen než programátorský projekt
- Respektujte právní hranice — omezujte rychlost, scrapujte jen veřejná data a pro komerční použití zvažte API alternativy
Vezměte si kód z tohoto návodu, nebo si nainstalujte Thunderbit Chrome extension a jděte rychlejší cestou. V obou případech budete sledovat ceny letenek místo neustálého ručního obnovování Google Flights.
Další techniky Python scrapingu najdete v našich průvodcích jak scrapovat web v Pythonu a nejlepších Python nástrojích pro web scraping.
Často kladené dotazy
1. Můžu scrapovat Google Flights bez Pythonu?
Ano. API služby jako SerpApi a Kiwi Tequila poskytují strukturovaná letová data přes API volání (bez nutnosti automatizace prohlížeče). Pro plně no-code přístup umí Thunderbit Chrome extension scrapovat výsledky Google Flights přímo z vašeho prohlížeče s AI navrhovanými poli a exportem jedním kliknutím.
2. Blokuje Google scrapování letů?
Google používá detekci botů (SearchGuard), CAPTCHA a omezení rychlosti. S vhodnými anti-bot opatřeními — náhodné prodlevy, rotace user-agentu, rezidenční proxy a stealth nastavení prohlížeče — můžete při středním objemu udržet spolehlivé scrapování. Konkrétní techniky a prahy najdete v sekci o anti-bot ochraně výše.
3. Jak často bych měl scrapovat Google Flights pro sledování cen?
Dvakrát denně (v náhodných časech) stačí pro osobní sledování cen a zároveň drží riziko detekce nízko. Pro firemní monitoring každé 4–6 hodin s rotací proxy. Hodinové scrapování se vyplatí jen při krátkodobých slevách letenek — výrazně totiž zvyšuje šanci na blokaci.
4. Existuje zdarma Google Flights API?
Oficiální Google QPX Express API bylo ukončeno v dubnu 2018. Neexistuje žádná bezplatná oficiální náhrada. Nejbližší bezplatná možnost je Kiwi Tequila API (affiliate model, neomezené vyhledávání). SerpApi nabízí 250 bezplatných vyhledávání měsíčně. Pro většinu uživatelů je nejpraktičtější cesta scraping nebo no-code nástroj jako Thunderbit.
5. Proč mi CSS selektory pro Google Flights pořád vracejí prázdná data?
Google používá Closure Compiler k generování obfuskovaných názvů tříd, které se mění s každým buildem. HTML strukturu navíc mění i A/B testování a rozdíly v lokalizaci. Řešení: používejte aria-label atributy a textové selektory místo názvů tříd, přidejte validační funkci pro včasné zachycení rozbití a kontrolujte selektory každý měsíc. Podrobnosti najdete v části o údržbě selektorů.
Zjistěte více




