
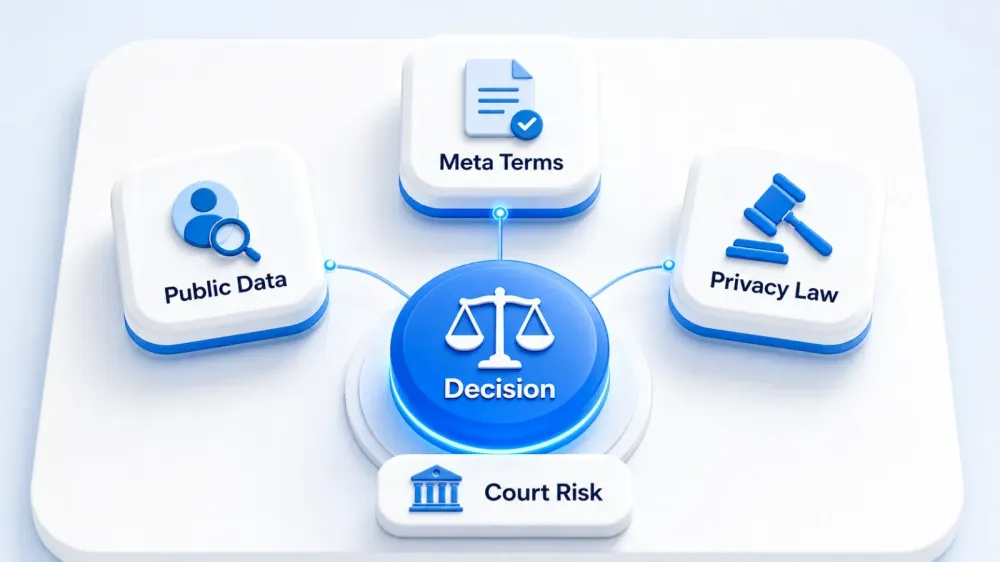
Kdykoli se mě někdo zeptá „je scrapování Instagramu legální?“, odpovědi se obvykle rozdělí do tří táborů: „je to úplně v pohodě“, „je to stoprocentně nelegální“ a „záleží na tom“. Jen ten třetí tábor je opravdu užitečný.
Ta nejasnost je reálná, protože odpověď závisí na tom, jaká data sbíráte, kde se nacházíte vy i lidé, kterých se data týkají, jakým způsobem k nim přistupujete a proč je vlastně chcete. Tenhle článek to celé rozplete. Projdu hlavní soudní rozhodnutí, rozdíl mezi porušením pravidel platformy a porušením zákona, porovnání podle jurisdikcí i praktický rozhodovací strom, abyste si mohli vyhodnotit vlastní situaci. Není to právní rada — jsem technický redaktor, ne právník — ale mělo by vám to dát mnohem jasnější mapu terénu.
Co vlastně znamená „scrapování Instagramu“?
Nejdřív definice.
Scrapování Instagramu znamená použití softwaru k automatickému sběru veřejně viditelných informací z webu nebo aplikace Instagramu — například bio profilu, popisků příspěvků, komentářů, používání hashtagů, počtu followerů nebo engagement metrik.
Není to totéž jako použití oficiálního Graph API od Instagramu, které má vlastní omezení, pravidla schvalování a omezení podle typu použití. Scrapování nepoužívá oficiální API cestu; data sbírá přímo z webových stránek nebo z rozhraní aplikace.
Typické případy použití:
- Generování leadů: hledání potenciálních zákazníků nebo influencerů podle veřejných profilů a vzorců engagementu.
- Sledování konkurence: monitorování frekvence příspěvků, míry zapojení a obsahové strategie konkurentů.
- Průzkum trhu: analýza trendů hashtagů, sentimentu nebo geografických vzorců ve veřejných příspěvcích.
- Akademický výzkum: studium veřejného diskurzu, vizuální kultury nebo dynamiky sociálních sítí pro diplomku či článek.
Tenhle článek se zaměřuje na právní otázku — ne na technický postup. Pokud se snažíte zjistit, jestli vám konkrétní použití může přinést žalobu, zákaz účtu nebo pokutu, čtěte dál.
Je scrapování Instagramu legální? Krátká odpověď
Scrapování veřejně dostupných dat z Instagramu obecně není podle současné americké judikatury federálním trestným činem — ale „není to trestné“ a „je to úplně v pohodě“ jsou dvě dost odlišné věci.
Uplatňují se tři samostatné právní vrstvy a většina zmatku vzniká tím, že se do jedné hromady zamíchají:
- Zákony o přístupu k počítačovým systémům (např. americký Computer Fraud and Abuse Act, tedy CFAA): Je přístup k datům „neoprávněný“?
- Pravidla ochrany soukromí (např. GDPR, CCPA): Obsahují data osobní údaje a máte k jejich zpracování právní základ?
- Smluvní podmínky / Terms of Service: Zakazují podmínky Instagramu to, co děláte, a co se stane, když je porušíte?
Každá vrstva má jiné důsledky, jiné mechanismy vymáhání a jinou míru rizika. Scrapování může být zcela v pořádku podle jedné vrstvy a zároveň velmi problematické podle jiné.
„Je můj scraping legální?“ — rozhodovací strom, který můžete opravdu použít
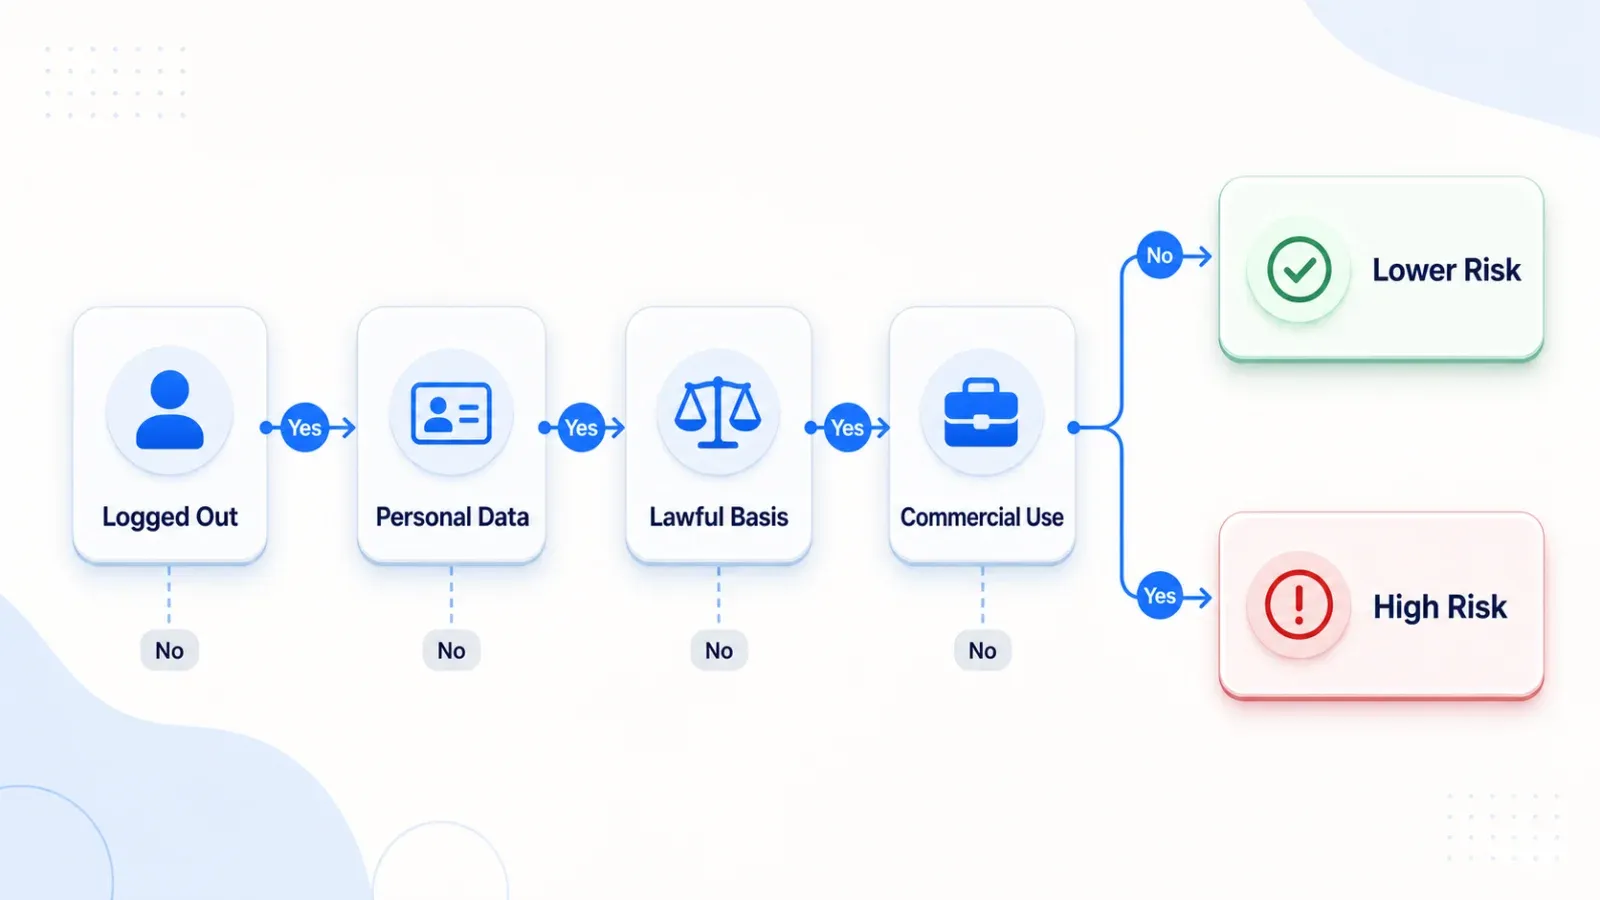
O tomhle tématu jsem četl desítky článků. Všechny vyjmenovávají tytéž právní faktory v dlouhých odstavcích — a žádný vám nedá způsob, jak si vlastní situaci vyhodnotit za minutu. Tady je rozhodovací strom:
| Krok | Otázka | Když ANO → | Když NE → |
|---|---|---|---|
| 1 | Je data vidět veřejně i bez přihlášení? | Přejděte na krok 2 | ⚠️ Vysoké riziko — pravděpodobně se dotýká CFAA / ochrany přístupu |
| 2 | Obsahují data osobní údaje (jména, fotky, bio, e-mailové adresy)? | Přejděte na krok 3 (platí GDPR/CCPA) | Nižší riziko — přejděte na krok 4 |
| 3 | Máte podle GDPR/CCPA právní základ (oprávněný zájem, souhlas atd.)? | Přejděte na krok 4 | ⛔ Nepokračujte bez právníka |
| 4 | Jde o komerční využití (prodej dat, lead gen, SaaS produkt)? | Vyšší riziko vymáhání — prověřte TOS a předchozí výzvy k ukončení | Nižší riziko — hlavně pro osobní nebo akademické použití |
| 5 | Vyhýbáte se technickým obcházením a nadměrnému automatizovanému přístupu? | Nižší praktické riziko | Zvyšuje právní, platformní i účetní riziko |
Tohle není bianko šek — je to rámec pro odhad rizika. Pokud jste na kroky 1, 3 a 5 odpověděli „ano“ a na krok 4 „ne“, nacházíte se v nižší rizikové zóně. Pokud jste přihlášení, sbíráte osobní data bez právního základu, komerčně je přeprodáváte a ignorujete omezení platformy, skládáte riziko na riziko.
U firemních workflow bývá často nižší riziko Instagram vůbec nesbírat a místo toho použít povolené veřejné zdroje, jako jsou firemní weby, landing pages tvůrců, e‑commerce stránky, adresáře nebo licencované datasety. Tenhle rozhodovací strom platí bez ohledu na to, jaký nástroj používáte.
Krok 1: Jsou data veřejně viditelná?
Test v anonymním okně: otevřete privátní okno (bez přihlášení do Instagramu), přejděte na stránku a podívejte se. Pokud data vidíte, jsou v praktickém smyslu veřejná. Americké případy jako hiQ v. LinkedIn zacházejí s veřejně dostupnými, odhlášeným uživatelem viditelnými daty jinak než s daty za přístupovou bariérou, pokud jde o CFAA — ale to není univerzální povolení.
Instagram navíc průběžně mění, co je bez přihlášení vidět. Než budete předpokládat, že jsou vaše cílová data přístupná bez účtu, ověřte si, co je veřejné dnes.
Krok 2: Obsahuje to osobní údaje?
Osobní údaje jsou podle GDPR a CCPA definované velmi široce: uživatelská jména, profilové fotky, bio, e‑mailové adresy, lokalizační štítky a dokonce i odvozené atributy z fotek nebo popisků. Pokud scrapujete profily Instagramu, téměř jistě sbíráte osobní údaje.
Veřejná viditelnost vás nevyvazuje z pravidel ochrany soukromí — to je jeden z nejvytrvalejších omylů v tomhle prostoru.
Krok 3: Máte právní základ?
Podle článku 6 GDPR potřebujete před zpracováním osobních údajů doložit právní základ. Nejčastěji se u scrapování uvádí „oprávněný zájem“, ten ale vyžaduje formální test vyvážení — váš zájem versus práva subjektu údajů. Další možností je souhlas, ten je ale při sběru ve velkém nepraktický.
Podle CCPA mají obyvatelé Kalifornie práva týkající se jejich osobních údajů, včetně práva vědět, smazat a odmítnout prodej nebo sdílení. Pokud jste firma, která spadá do působnosti zákona a sbíráte data o Kaliforňanech, tyto povinnosti se vás týkají.
Žádný právní základ + osobní údaje = zastavit a vyhledat právní radu.
Krok 4: Jde o komerční použití?
Komerční využití — přeprodej datasetů, budování lead-gen produktu, napájení SaaS nástroje — přitahuje od společnosti Meta největší pozornost v oblasti vymáhání. Osobní projekty a akademický výzkum nesou nižší praktické riziko, i když nejsou bez rizika.
Krok 5: Respektujete rate limity a ochranné mechanismy platformy?
Neobcházejte CAPTCHA, přihlašovací stěny, anti-bot ochranu ani omezení účtu. I když data vypadají veřejně, agresivní automatizovaný přístup zvyšuje platformní, smluvní, privacy i provozní riziko.
Veřejná vs. soukromá data: hranice, na které nejvíc záleží
Všechno stojí na jednom rozdílu: veřejná versus soukromá data.
| Obvykle nižší riziko při scrapování | Nescrapujte |
|---|---|
| Veřejná bio profilu, zobrazovaná jména | Příspěvky a stories soukromých účtů |
| Veřejné popisky příspěvků a komentáře | Přímé zprávy (DM) |
| Veřejné používání hashtagů | Obsah za přihlašovací stěnou |
| Veřejné počty reakcí (lajky, komentáře) | Data z falešných / koupených účtů |
| Veřejné profilové fotky (s výhradami podle práva na soukromí) | Seznamy followerů ve velkém měřítku (šedá zóna) |
Šedých zón je spousta. Seznamy followerů a following, data o označených lokacích i účty dětí se pohybují v právně nejasném prostoru. I když jsou technicky vidět, scrapování ve velkém může vyvolat obavy o soukromí nebo zásah platformy. Když si nejste jistí, raději to nesbírejte.
Odůvodnění v americkém právu přístupu k počítačovým systémům vychází z případů jako hiQ v. LinkedIn, ale držte se úzkého výkladu: jde o oprávnění k přístupu podle CFAA, ne o závěr, že každý veřejný profil na sociální síti lze volně sbírat a znovu používat. Předpisy o ochraně soukromí jako GDPR fungují na jiném principu.
Porušení TOS vs. trestní odpovědnost: největší omyl kolem scrapování Instagramu
Řeknu to na rovinu:
Porušení podmínek Instagramu není trestný čin.
Podmínky používání Instagramu uvádějí, že uživatelé nesmí vytvářet účty nebo přistupovat ke službě či sbírat informace neoprávněnými způsoby, včetně automatizovaného sběru bez výslovného souhlasu Instagramu. Podmínky pro automatizovaný sběr dat od Meta zase vyžadují výslovný písemný souhlas.
To jsou smluvní pravidla — dohody mezi vámi a Instagramem. Když je porušíte, může to vést k zablokování účtu a ve výjimečných případech i k občanskoprávní žalobě. Nejde o trestní zákony.
Tady je zjednodušená právní hierarchie:
| Právní vrstva | Co to je | Důsledek porušení |
|---|---|---|
| Smluvní právo (TOS) | Dohoda mezi vámi a Instagramem | Zákaz účtu, občanskoprávní žaloba za porušení smlouvy |
| Zákonné právo (CFAA) | Federální zákon o přístupu k počítačům | Možná trestní odpovědnost — ale po Van Buren v. US (2021) výrazně užší |
| Regulatorní právo (GDPR/CCPA) | Předpisy o ochraně soukromí | Pokuty až do 4 % celosvětových příjmů (GDPR); různé sankce podle CCPA |
To je klíčový rozdíl: pravidlo platformy může znamenat riziko pro účet a občanskoprávní odpovědnost, aniž by se automaticky proměnilo v trestný čin v oblasti počítačové kriminality.
Důležitý je i detail, protože případ Meta v. Bright Data z ledna 2024 dopadl ve prospěch Bright Data u teorie porušení smlouvy v souvislosti s odhlášeným scrapováním veřejných dat z Facebooku a Instagramu. Rozhodnutí ale bylo úzké: odhlášený přístup, veřejná data, konkrétní skutkový stav a jeden okresní soud v USA. Neposkytlo svolení k scrapování za přihlašovací stěnou, sběru přes falešné účty, sběru soukromých dat, porušování privacy práva ani k libovolnému komerčnímu znovupoužití dat z Instagramu.
Co se skutečně může stát, když scrapujete Instagram: matice rizik
Lidé se pořád ptají „Může mě Instagram žalovat?“ a „Dostanu ban na účet?“. Tady je upřímný přehled:
| Důsledek | Co se stane | Závažnost | Pravděpodobnost |
|---|---|---|---|
| Zákaz / pozastavení účtu | Okamžitě, obvykle bez odvolání | Nízký až střední dopad | VYSOKÁ u agresivního scrapování |
| Výzva k ukončení | Právní upozornění od právníků Meta | Střední dopad (náklady na reakci) | STŘEDNÍ u komerčního využití |
| Občanskoprávní žaloba (porušení TOS) | Nárok na náhradu škody, soudní zákaz | Vysoký dopad | NÍZKÁ (spíše u vysokých objemů / komerčních operací) |
| Trestní stíhání podle CFAA | Trestní obvinění | Velmi vysoký dopad | VELMI NÍZKÁ (po Van Buren výrazně omezeno) |
| Pokuta podle GDPR | Až 4 % celosvětových příjmů | Velmi vysoký dopad | NÍZKÁ až STŘEDNÍ při sběru osobních dat z EU |
Nejpravděpodobnější dva důsledky jsou omezení účtu a výzvy k ukončení. Nejlepší kontrola není technický workaround; je to disciplína v rozsahu: vyhnout se sběru po přihlášení nebo za bránou přístupu, minimalizovat osobní údaje, dokumentovat účel a právní základ a pokud možno použít oficiální nebo odsouhlasené cesty.
Meta na své stránce o pokroku v oblasti soukromí uvádí, že denně blokuje miliardy podezřelých neoprávněných pokusů o scrapování napříč Facebookem, Instagramem a WhatsAppem. Je to tvrzení samotné Mety a nemohu si jeho přesnost nezávisle ověřit, ale ukazuje to, jak vážně vymáhání bere.
Po zemích: kde je scrapování Instagramu legální?
Legálnost závisí na jurisdikci a žádné dvě země k tomu nepřistupují identicky. Tady je srovnávací tabulka, kterou podle všeho nikdo jiný nezveřejnil v tak přehledné podobě:
| Jurisdikce | Klíčový zákon / zákony | Scrapování veřejných dat | Scrapování osobních údajů | Riziko jen kvůli TOS | Významný případ / rozhodnutí |
|---|---|---|---|---|---|
| USA | CFAA, státní varianty CFAA | Nižší CFAA riziko u odhlášených veřejných dat v některých případech, ale závisí na faktech | Na kvalifikované firmy a obyvatele Kalifornie se může vztahovat CCPA/CPRA | Smluvní / účetní / občanskoprávní riziko může stále trvat | hiQ v. LinkedIn (2022), Van Buren v. US (2021), Meta v. Bright Data (2024) |
| EU | GDPR, směrnice o databázích | Nižší privacy riziko, pokud neobsahuje osobní údaje; mohou být relevantní i další práva | Vyžaduje právní základ podle čl. 6 | Smluvní a platformní vymáhání může stále hrát roli | Vymáhání GDPR; riziko zvláštních kategorií údajů v obrázcích / bio |
| UK | UK GDPR, DPA 2018 | Podobné jako v EU | Vyžaduje právní základ; pokyny ICO aktualizované v dubnu 2026 | Smluvní a platformní vymáhání může stále hrát roli | Pokyny ICO |
| Kanada | PIPEDA, provinční zákony | Nižší riziko, pokud nejde o osobní údaje | Může se uplatnit souhlas a další privacy povinnosti | Smluvní a platformní vymáhání může stále hrát roli | Omezená judikatura přímo ke scrapování |
| Brazílie | LGPD | Nižší riziko, pokud nejde o osobní údaje | Vyžaduje právní základ | Smluvní a platformní vymáhání může stále hrát roli | Rozvíjející se vymáhání; zatím žádný velký precedent ke scrapování |
| Austrálie | Privacy Act 1988 | Nižší riziko, pokud nejde o osobní údaje | Mohou se uplatnit Australian Privacy Principles (APPs) | Smluvní a platformní vymáhání může stále hrát roli | Omezená judikatura přímo ke scrapování |
Napříč všemi šesti jurisdikcemi se ukazuje stejný vzorec. Ve všech je scrapování nepersonálních veřejných dat nejméně rizikové. Jakmile se objeví osobní údaje, nastupují pravidla ochrany soukromí — a „data byla veřejně viditelná“ není podle GDPR, UK GDPR ani LGPD obrana sama o sobě. Je to faktor, ale ne právní základ.
Pro čtenáře, kteří řeší rezidenci dat a přeshraniční sběr: záležet může na tom, kde jsou data sbírána, zpracovávána a ukládána. Pokud pro povolené veřejné zdroje používáte jakýkoli třetí nástroj nebo dodavatele, zkontrolujte před sběrem osobních údajů jeho region, retention a privacy kontrolu.
Klíčové právní milníky u rizika scrapování Instagramu
Několik právních a platformních milníků vysvětluje, proč je odpověď pořád tak nuancovaná:
- 2017: hiQ v. LinkedIn — okresní soud vydává předběžné opatření, které LinkedIn brání blokovat scrapování veřejných profilů hiQ. První velké americké rozhodnutí ve prospěch scrapování veřejných dat.
- 2018: GDPR nabývá účinnosti v EU a vytváří nejkomplexnější rámec ochrany osobních údajů na světě.
- 2020: V Kalifornii vstupuje v platnost CCPA. Meta podává Meta v. BrandTotal, zaměřený na scrapování dat z Facebooku.
- 2021: Van Buren v. United States — Nejvyšší soud USA zužuje výklad ustanovení CFAA o „překročení oprávněného přístupu“. Zlomový okamžik pro právo scrapování.
- 2022: hiQ v. LinkedIn — 9. obvod vydává konečné rozhodnutí potvrzující, že scrapování veřejných dat neporušuje CFAA.
- 2024: Meta v. Bright Data — Soud pro severní okres Kalifornie rozhoduje, že podmínky Facebooku/Instagramu nebránily odhlášenému scrapování veřejných dat ze strany Bright Data. Úzké, ale významné.
- 2024 a dál: Meta pokračuje ve veřejném prosazování proti scrapování. Na její stránce o pokroku v oblasti soukromí stojí, že denně blokuje miliardy podezřelých neoprávněných pokusů o scrapování napříč Facebookem, Instagramem a WhatsAppem. Berte to jako vlastní tvrzení Mety, ne jako nezávisle ověřený benchmark.
Jak Van Buren v. US změnil pohled na scrapování veřejných dat
Před Van Buren existoval reálný argument, že scrapování jakéhokoli webu proti vůli provozovatele by mohlo být podle CFAA federálním trestným činem. Znění zákona o „překročení oprávněného přístupu“ bylo dost široké na to, aby se ho někteří žalobci a prokurátoři pokoušeli natáhnout i na porušení TOS.
Nejvyšší soud to zastavil. V případu Van Buren soud přijal rámec „brány otevřené vs. brány zavřené“: CFAA se uplatní, když někdo obejde technologickou bariéru přístupu (například přihlašovací stěnu nebo heslo), ne když se jen dostane k informacím, které jsou volně dostupné, ale jejichž vlastník webu by raději nechtěl, aby byly čteny.
Pro scraping to má zásadní praktický dopad. Pokud jsou data za loginem nebo jinou přístupovou kontrolou, riziko podle CFAA prudce roste. Pokud jsou data na veřejné stránce, kterou si každý může otevřít v anonymním okně, argument podle CFAA je obvykle slabší — i když rizika spojená s ochranou soukromí, smlouvami, IP a vymáháním platformy mohou přetrvávat.
Většina konkurenčních článků cituje hiQ, ale málo vysvětluje Van Buren. Jsou to doplňující se rozhodnutí a Van Buren je možná důležitější, protože jde o rozhodnutí Nejvyššího soudu s celostátní působností, ne o rozhodnutí odvolacího obvodu.
Jak Meta vymáhá pravidla
Meta rozhodně nezahálí. Podle vlastních veřejných vyjádření zahrnuje její nástrojový arzenál:
- Rate limity a limity dat pro omezení automatizovaného sběru.
- Detekci vzorců pro rozpoznání neobvyklého chování při sběru.
- Omezení nebo deaktivaci účtu, když Meta usoudí, že automatizace porušuje její podmínky.
- Výzvy k ukončení, žaloby a požadavky na stažení obsahu u objemového nebo komerčního scrapování.
I když vás zajímá jen právní riziko, vymáhání platformy je podstatné. Veřejný postoj Mety je jasný: automatizovaný sběr z jejích platforem bez povolení porušuje její pravidla a společnost do jeho zastavení výrazně investuje.
Scrapování Instagramu pro akademický výzkum: co by měli vědět studenti a výzkumníci
Doktorandi a akademičtí výzkumníci se pohybují v jiné rizikové kategorii — často nižší než komerční prodej dat, ale ne nulové.
Nižší riziko než komerční scraping, ano. Automatická výjimka, ne.
Analýza fair use pro data z Instagramu
V USA doktrína fair use (17 U.S.C. § 107) posuzuje čtyři faktory:
- Účel a povaha použití: Nepodnikatelské, vzdělávací a transformativní použití fair use podporuje. Akademický výzkum si zde obvykle vede dobře.
- Povaha chráněného díla: Faktická data (počty followerů, data příspěvků) jsou méně chráněná než tvůrčí obsah (fotky, popisky). Scrapování kreativního obsahu je rizikovější.
- Množství použitého materiálu: Scraping celého veřejného profilu je něco jiného než sběr několika údajů. Sbírejte co nejméně.
- Dopad na trh: Pokud váš výzkum nekonkuruje komerčním službám Instagramu, tento faktor vyznívá ve váš prospěch.
Akademický výzkum obvykle vychází v tomto testu příznivě, ale není to záruka — zvlášť pokud scrapujete velké objemy tvůrčího obsahu (obrázky, videa, celé popisky).
IRB aspekty
Pokud váš výzkum pracuje s identifikovatelnými údaji o lidských subjektech — a profily Instagramu jsou identifikovatelné už ze své podstaty — může váš univerzitní Institutional Review Board (IRB) potřebovat váš plán sběru dat zkontrolovat a schválit. Platí to i tehdy, když jsou data veřejně viditelná. Než začnete scrapovat, ověřte si to u svého IRB.
Platformní programy pro výzkum
Meta nabízí Content Library a API pro schválené výzkumníky, které poskytují přístup k veřejně dostupnému obsahu z Facebooku, Instagramu a Threads. Žádosti procházejí nezávislým posouzením. Pokud splňujete podmínky, jde o nižší rizikovou oficiální cestu pro akademický výzkum Instagramu.
(Poznámka: Nástroj CrowdTangle od Mety, který byl mezi výzkumníky populární, byl z velké části ukončen. Content Library/API je jeho nástupce.)
Minimalizace dat pro výzkumníky
Praktická doporučení:
- Sbírejte jen ta data, která opravdu potřebujete pro svou výzkumnou otázku. Nescrapujte celé profily „pro jistotu“.
- Dataset anonymizujte co nejdřív — odstraňte uživatelská jména, rozmažte profilové fotky, raději agregujte než reportujte údaje na úrovni jednotlivců.
- Nastavte pravidla pro uchovávání dat: jak dlouho je budete držet a kdy je smažete?
- Zdokumentujte metodiku i právní základ (pro soulad s GDPR, pokud se uplatní).
Pro výzkum mimo Instagram aplikujte princip minimalizace dat: sbírejte jen pole nutná pro uvedený účel, neukládejte zbytečný surový text a dokumentujte retention i řízení přístupu.
Checklist s nižším rizikem před sběrem dat z Instagramu
Teď, když už máte přehled o právním prostředí, tady je praktický checklist pro snížení rizika:
- Scrapujte jen veřejně viditelná data. Použijte test v anonymním okně. Když data nevidíte bez přihlášení, nescrapujte je.
- Nikdy neobcházejte přihlašovací stěny ani nepoužívejte falešné účty. Tady prudce roste riziko podle CFAA, smluv i vymáhání platformy.
- Technická a účetní omezení berte jako stopku. CAPTCHA, login wall, omezení účtu a anti-bot systémy jsou jasné varovné signály.
- Minimalizujte sběr osobních údajů. Sbírejte jen to, co skutečně potřebujete. Pokud nepotřebujete uživatelská jména, nesbírejte je.
- Mějte pravidla pro uchovávání a mazání dat. Vědět, jak dlouho data držíte a kdy je smažete, je zásadní.
- Zdokumentujte právní základ, pokud sbíráte osobní údaje (zejména podle GDPR). „Oprávněný zájem“ vyžaduje písemný balancing test, ne jen vágní záměr.
- Používejte oficiální, licencované, odsouhlasené nebo neinstagramské zdroje, kde dávají smysl. Nejnižší riziko bývá často v tom, co na Instagramu vůbec nemusíte sbírat.
Poznámka k nástrojům a alternativám
Thunderbit je navržený pro povolené workflow nad veřejným webem mimo produkty Meta. Neposkytuje sběr dat z Facebooku, Instagramu, Threads, Messengeru, WhatsAppu ani Meta Ad Library, připojení účtů ani funkce obcházení ochrany.
Pro mnoho firemních otázek poskytují veřejné firemní weby, adresáře, e‑commerce stránky, licencované datasety a další ne-Meta zdroje informace, které potřebujete, s jasnějšími podmínkami a povinnostmi v oblasti soukromí. Vyberte si zdroj, který použití výslovně dovoluje, a pak minimalizujte informace, které si ponecháte.
Hlavní závěry
- Scrapování veřejně dostupných dat z Instagramu není podle současné americké judikatury automaticky nelegální, ale „není to nelegální“ a „je to bez rizika“ jsou úplně různé věci.
- Záleží na třech právních vrstvách: zákony o přístupu k počítačům (CFAA), privacy regulace (GDPR/CCPA) a smluvní podmínky / Terms of Service. Nemíchejte je dohromady.
- Porušení TOS není trestný čin. Může vést k zákazu účtu a občanskoprávním žalobám, ale ne k trestnímu stíhání (po Van Buren).
- Privacy právo platí i pro veřejná data. Pokud sbíráte osobní údaje, potřebujete právní základ — zejména podle GDPR a CCPA.
- Záleží na jurisdikci. Právní prostředí se výrazně liší mezi USA, EU, UK, Kanadou, Brazílií a Austrálií.
- Rozhodovací strom je váš přítel. U každého projektu sběru dat projděte kroky: veřejný přístup → osobní údaje → právní základ → use case → platformní kontrola.
- Akademičtí výzkumníci mají nižší, ale ne nulové riziko. Pokud splňujete podmínky, použijte Meta Content Library/API, minimalizujte sběr dat, anonymizujte co nejdřív a zkontrolujte IRB.
- Zvažte alternativní zdroje dat. U mnoha byznysových use casů poskytne potřebná data veřejný web, adresáře nebo stránky tvůrců bez rizik specifických pro Instagram. Vyberte zdroj, který dané použití výslovně povoluje.
- U vysokorizikového komerčního použití se poraďte s právníkem. Tenhle článek je mapa, ne právní stanovisko.
FAQ o legálnosti scrapování Instagramu
Může mě Instagram žalovat za scrapování veřejných dat?
Meta může poslat výzvu k ukončení nebo podat občanskoprávní žalobu za porušení svých Terms of Service. Americké soudy — včetně rozhodnutí v Meta v. Bright Data (2024) — ale v konkrétních situacích rozhodly, že podmínky Instagramu nebránily odhlášenému scrapování veřejných dat, a Van Buren v. US (2021) výrazně zúžil odpovědnost podle CFAA za přístup k veřejným informacím. Pravděpodobnost žaloby je u malého, nekomerčního použití nízká, ale není nulová — zvlášť u komerčních operací.
Je scrapování Instagramu v Evropě legální?
Scrapování veřejně dostupných neosobních dat bývá obvykle scénář s nižším privacy rizikem, ale data z Instagramu často obsahují osobní údaje. Pokud jsou osobní údaje ve hře, potřebujete podle článku 6 GDPR právní základ — například oprávněný zájem podložený dokumentovaným balancing testem. Pokuty za nesoulad mohou dosáhnout až 4 % celosvětového ročního obratu. Pokyny ICO (aktualizované v dubnu 2026) vyžadují, aby organizace před zpracováním určila a zdokumentovala právní základ.
Dostanu ban na Instagram účtu kvůli scrapování?
Omezení účtu patří mezi nejpravděpodobnější důsledky agresivního scrapování. Pravidla pro omezení účtu popisují neoprávněné scrapování jako automatizaci používanou ke sběru informací v rozporu s podmínkami. Vyhýbání se scrapování z osobního účtu snižuje riziko banu, ale neznamená to, že sběr dat z Instagramu je právně nebo smluvně bez rizika.
Je scrapování Instagramu legální pro akademický výzkum?
Obecně bývá riziko nižší než u komerčního přeprodeje, zejména u nekomerčního výzkumu veřejných dat, ale nejde o automatickou výjimku. Může se uplatnit fair use nebo fair dealing, ale výzkumníci by si měli ověřit požadavky IRB při práci s identifikovatelnými údaji o lidech, praktikovat minimalizaci dat a zvážit použití Meta Content Library a API, pokud splňují podmínky.
Jaký je rozdíl mezi scrapováním Instagramu a použitím Instagram API?
Oficiální Instagram Graph API poskytuje strukturovaný přístup pro schválené případy použití firemních a tvůrčích účtů, ale má limity, schvalovací proces a pravidla. Scrapování sbírá data viditelná na webu mimo oficiální API cestu. Oba přístupy mají právní dopady: použití API se řídí vývojářskými podmínkami Meta, zatímco odhlášené scrapování veřejných dat bylo v některých úzkých případech v USA posuzováno příznivě, ale stále může narazit na smluvní, privacy, IP a platformní otázky. Pro většinu firemních use casů jsou nižší riziko oficiální API, odsouhlasená data, licencovaná data nebo veřejné zdroje mimo Instagram.
Další informace




