Upřímně: když jsem se poprvé pokusil stáhnout všechny URL z velkého webu, říkal jsem si: „Jak těžké to může být?“ O pár hodin později jsem pořád proklikával nekonečné stránky, kopíroval odkazy do tabulky a přemýšlel nad svými životními rozhodnutími. Pokud jste se někdy snažili najít všechny stránky na webu — ať už kvůli obsahovému auditu, seznamu leadů nebo konkurenční analýze — víte, jaká je to dřina. Je to otravné, náchylné k chybám a upřímně řečeno i ztráta vašeho času a talentu.
Dobrá zpráva ale je, že už to nemusíte dělat po staru. Nástroje s AI, jako je Thunderbit, mění pravidla hry pro firemní uživatele a umožňují najít všechny URL na doméně za minuty, ne za dny. Firmy, které používají AI nástroje pro web scraping, uvádějí 30–40% úsporu času při sběru dat a některé hlásí až o 80 % méně stráveného času oproti ručním metodám. To není jen číslo — to jsou hodiny, nebo dokonce dny, které dostanete zpátky.
Pojďme se tedy podívat, proč je hledání všech stránek na webu tak složité, proč si s tím obecné AI modely jako GPT nebo Claude moc neporadí a jak specializovaní AI agenti — třeba Thunderbit — celý proces výrazně zjednoduší. A ano, ukážu vám přesné kroky, jak vytáhnout každou URL, kterou potřebujete, i když nejste programátor.
Proč je hledání všech URL na doméně tak náročné
Přiznejme si to: weby nejsou stavěné tak, aby vám samy předaly přehledný seznam všech stránek, které obsahují. Jsou dělané pro návštěvníky, ne pro lidi, kteří chtějí najít všechny stránky na webu najednou. Tady je důvod, proč je to taková otrava:
- Ruční kopírování a vkládání je peklo: Proklikávat se každým menu, seznamem a adresářem, kopírovat URL jednu po druhé — to je recept na syndrom karpálního tunelu (a na to, že polovinu stránek minete).
- Stránkování a nekonečný scroll: Mnoho webů rozděluje obsah do více stran nebo načítá další výsledky při scrollování. Stačí přehlédnout tlačítko „Další“ nebo nescrolovat dost daleko a přijdete o celé sekce.
- Nekonzistentní struktura stránek: Některé stránky mají odkazy v jednom formátu, jiné používají jiné rozložení. Udržet si v tom přehled je noční můra.
- Skryté nebo osiřelé stránky: Ne každá stránka je odkazovaná z hlavní navigace. Některé jsou hluboko schované a dostanete se k nim jen přes sitemapu nebo interní vyhledávání.
- Lidská chyba: Čím víc stránek musíte kopírovat, tím je pravděpodobnější, že uděláte chybu — duplicitní URL, překlepy, nebo prostě něco přeskočíte.
A pokud pracujete na webu se stovkami nebo tisíci stránek? Na to rovnou zapomeňte. Ruční extrakce prostě nemá škálování. Jak řekl jeden datový tým: cokoli nad triviální případy, „budete muset automatizovat“.
Co vlastně znamená „najít všechny stránky na webu“?
Než se pustíme do řešení, pojďme si ujasnit, co přesně hledáme.
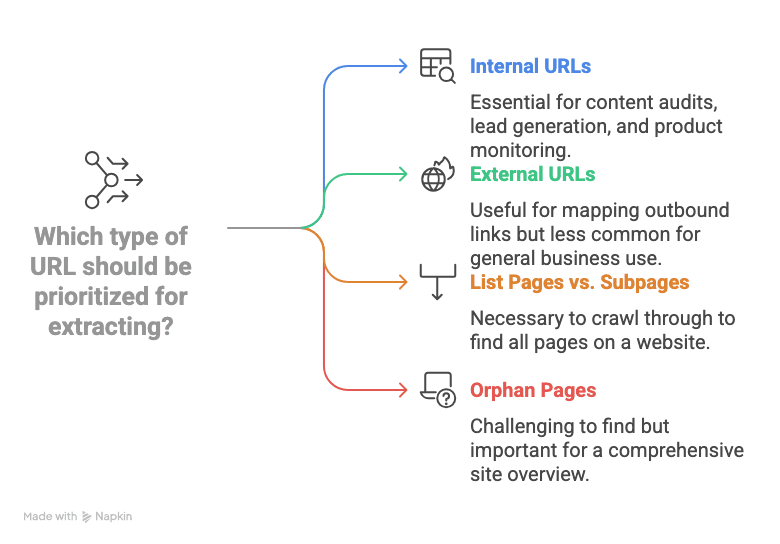
- Interní URL: To jsou odkazy na stránky ve stejné doméně (například /about-us nebo /products/widget-123). Pro většinu firemních use caseů — obsahové audity, generování leadů, sledování produktů — jsou interní URL hlavní cíl.
- Externí URL: Odkazy vedoucí na jiné weby. Ty obvykle nepotřebujete, pokud nemapujete odchozí odkazy.
- Seznamové stránky vs. podstránky: Mnoho webů má „hub“ nebo seznamové stránky (například kategorie, archiv blogu, adresáře), které odkazují na detailní stránky (například produktové nebo profilové stránky). Abyste opravdu našli všechny stránky na webu, musíte projít tyto seznamy a vytáhnout každou podstránku, na kterou odkazují.
- Osamocené stránky: Jsou to stránky, na které nevede žádný zjevný odkaz. Někdy je zachytíte přes sitemapu nebo interní vyhledávání, ale snadno se přehlédnou.
Když tedy mluvíme o hledání všech URL na doméně, myslíme tím: získat každou interní URL stránky, od domovské stránky až po nejhlubší produkt nebo článek, ideálně ve formátu, který můžete rovnou použít — třeba v tabulce.
Tradiční způsoby, jak najít všechny URL na doméně
Existuje několik starých postupů, jak to řešit, ale každý má své vlastní problémy:
Ruční kopírování a nástroje v prohlížeči
To je přístup „silou a vůlí“: kliknout na každý odkaz, zkopírovat každou URL, vložit ji do tabulky a doufat, že nic nevynecháte. Někteří lidé používají rozšíření do prohlížeče, která vytáhnou všechny odkazy z aktuální stránky, ale pořád to musíte opakovat pro každou stránku a o stránkování nebo skryté sekce se musíte postarat sami. Na web o pěti stránkách to ještě jde — na cokoli většího už ne.
Použití vyhledávání webu a sitemapy
- Vyhledávání Google pomocí site: Zadejte do Googlu site:vasadomena.cz a uvidíte spoustu indexovaných stránek. Google ale ukazuje jen to, co zaindexoval (často maximálně kolem 1 000 výsledků), takže vám uniknou nové, skryté nebo málo kvalitní stránky. Dokumentace Googlu sama přiznává, že to není úplné řešení.
- XML sitemap: Mnoho webů má /sitemap.xml, kde jsou uvedené důležité URL. Skvělé — pokud je sitemap aktuální a obsahuje opravdu všechny stránky. Ne každý web ji ale má a některé používají více souborů. Osamocené stránky se do ní často vůbec nedostanou.
Technické crawlery a skripty
- SEO nástroje (například Screaming Frog): Tyto nástroje procházejí web podobně jako vyhledávač a vyplivnou seznam URL. Jsou silné, ale vyžadují nastavení, konfiguraci a někdy i placenou licenci pro větší weby.
- Python skripty (například Scrapy): Vývojáři mohou napsat skripty, které web procházejí a URL extrahují. Ale buďme realisti: pokud se necítíte pohodlně s kódem, tohle pro vás není reálná cesta. Navíc skripty se rozbíjejí, když se změní layout webu, takže pořád jen doháníte změny.
Shrnutí: Tradiční metody jsou buď moc ruční, moc neúplné, nebo moc technické pro většinu firemních uživatelů. Není divu, že tolik lidí to v půlce vzdá.
Proč obecné AI modely nedokážou plně automatizovat extrakci URL
Možná si říkáte: „Nemůžu prostě požádat ChatGPT nebo Claude, aby mi našly všechny stránky na webu?“ Kéž by to bylo tak snadné. Realita je ale jiná:
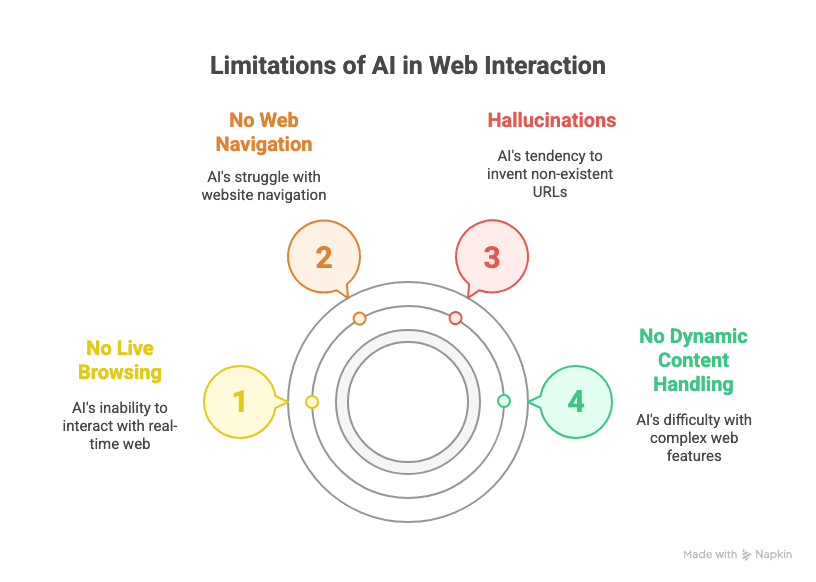
- Žádné živé prohlížení: Obecné AI modely jako GPT nebo Claude neumějí ve skutečnosti procházet web v reálném čase. Nevidí aktuální stav webu — pracují jen s tréninkovými daty nebo s tím, co jim vložíte.
- Žádná navigace po webu: I s pluginy nebo zapnutým prohlížením LLM neumí kliknout na „Další“, řešit nekonečný scroll ani systematicky následovat každý odkaz na webu.
- Halucinace: Zeptejte se obecné AI na všechny URL na doméně a často si vymyslí odkazy, které znějí věrohodně, ale ve skutečnosti neexistují. (Viděl jsem, jak si vymyslela /about-us stránky pro weby, které je nikdy neměly.)
- Nezvládá dynamický obsah: Weby, které načítají obsah přes JavaScript, vyžadují přihlášení nebo používají složitou navigaci, jsou pro obecné LLM mimo dosah.
Jak uvádí průvodce Rayobyte: „Pokud chcete scrapovat stovky nebo tisíce stránek… samotný ChatGPT nestačí.“ Potřebujete nástroj, který je pro ten úkol vytvořený přímo.
Vertikální AI agenti jsou budoucnost (a proč na tom záleží)
Tady přichází moje zkušenost ze SaaS a automatizace: vertikální AI agenti — tedy AI nástroje vytvořené pro konkrétní oblast, jako je extrakce webových dat — jsou jediný způsob, jak získat spolehlivé a škálovatelné výsledky pro firemní úkoly. Proč?
- Obecné LLM jsou skvělé na psaní nebo vyhledávání, ale trpí halucinacemi a nezvládnou vícekrokové, opakovatelné workflow se stabilitou, kterou firmy potřebují.
- Enterprise SaaS nástroje musejí automatizovat spoustu opakujících se, strukturovaných úloh. A právě v tom vertikální AI agenti vynikají — jsou stavěné na jednu věc a dělají ji dobře, s minimem chyb.
- Příklady najdeme napříč obory: Thunderbit pro extrakci webových dat, Devin AI pro vývoj softwaru, Alta pro automatizaci prodeje, IL VISTA od Infinity Learn pro vzdělávání, Rippling pro HR, Harvey pro právo… a seznam pokračuje.
Stručně řečeno: pokud chcete najít všechny stránky na webu spolehlivě, potřebujete vertikální AI agenta určeného přesně pro tenhle úkol — ne univerzální chatbot.
Seznamte se s Thunderbit: extrakce URL s AI pro každého
Scrape data from any website using AI Get Started Free
A právě tady přichází Thunderbit. Jako AI web scraper rozšíření do Chromu je Thunderbit navržený pro firemní uživatele — bez kódu, bez technického nastavování, prostě výsledky. Tohle ho odlišuje:
- Rozhraní v přirozeném jazyce: Stačí popsat, co chcete („Vylistuj všechny URL stránek na tomto webu“), a AI v Thunderbitu sama vymyslí, jak to vytáhnout.
- AI navrhne pole: Thunderbit prohlédne stránku a automaticky navrhne názvy sloupců (například „URL stránky“) — nemusíte se vrtat v CSS selektorech ani XPath.
- Zvládá stránkování i nekonečný scroll: Thunderbit umí automaticky klikat na „Další“ nebo scrollovat dolů, takže nepřijdete o žádné stránky.
- Navigace na podstránky: Potřebujete jít hlouběji? Thunderbit umí následovat odkazy na podstránky a vytáhnout data i odtud.
- Strukturovaný export: Výsledky můžete jedním kliknutím exportovat přímo do Google Sheets, Excelu, Notionu, Airtable nebo CSV — zdarma.
- Bez nutnosti kódu: Pokud umíte používat webový prohlížeč, zvládnete i Thunderbit. Je to tak jednoduché.
A protože Thunderbit je vertikální AI agent, je postavený na stabilitu a opakovatelnost — ideální pro firemní uživatele, kteří potřebují automatizovat stále stejné úkoly dokola.
Krok za krokem: Jak najít všechny URL na doméně s Thunderbit
Chcete vidět, jak to funguje? Tady je praktický postup bez technických znalostí, jak vytáhnout každou URL, kterou potřebujete.
1. Nainstalujte si rozšíření Thunderbit pro Chrome
Nejdřív: stáhněte si Thunderbit z Chrome Web Store. Funguje v Chrome, Edge, Bravenu a dalších prohlížečích na bázi Chromium. Připněte si ho na panel nástrojů, ať ho máte po ruce.
2. Otevřete seznamovou nebo adresářovou stránku, kterou chcete projít
Přejděte na web, ze kterého chcete URL vytáhnout. Může to být domovská stránka, sitemapa, adresář nebo jakákoli seznamová stránka, která odkazuje na stránky, které vás zajímají.
3. Spusťte Thunderbit a nastavte pole
Klikněte na ikonu Thunderbitu a otevřete rozšíření. Začněte nový scraper template. Tady přichází ta magie:
- Klikněte na „AI Suggest Fields“. AI v Thunderbitu prohledá stránku a navrhne sloupce — hledejte ten, který se jmenuje „Page URL“, „Link“ nebo podobně.
- Pokud nevidíte přesně to pole, které chcete, jednoduše přidejte sloupec s názvem „Page URL“ (nebo jiným rozumným názvem). AI v Thunderbitu je trénovaná na rozpoznávání těchto pojmů a namapuje je na správná data.
4. Zapněte stránkování nebo scrollování, pokud je potřeba
Pokud má cílová stránka více stránek (například „Strana 1, 2, 3…“ nebo tlačítko „Načíst další“), zapněte v Thunderbitu stránkování:
- Přepněte do režimu „Click Pagination“ pro weby s tlačítkem „Další“, nebo „Infinite Scroll“ pro weby, které načítají další obsah při scrollování.
- Thunderbit vás vyzve, abyste vybrali tlačítko „Další“ nebo oblast pro scrollování — prostě na ni klikněte a AI se postará o zbytek.
5. Spusťte scraping a zkontrolujte výsledky
Klikněte na tlačítko „Scrape“. Thunderbit projde všechny stránky a sesbírá každou URL, kterou najde. Výsledky se zobrazí přímo v tabulce v rozšíření. U velkých webů to může trvat pár minut, ale pořád je to výrazně rychlejší než ruční práce.
6. Exportujte seznam URL
Jakmile je scraping hotový, klikněte na Export. Data můžete poslat přímo do:
- Google Sheets
- Excel/CSV
- Notionu
- Airtable
Export je zdarma a zachová veškeré formátování. Konec kopírování a vkládání.
Srovnání Thunderbitu s dalšími řešeními pro extrakci URL
| Metoda | Snadnost použití | Přesnost a pokrytí | Škálovatelnost | Možnosti exportu |
|---|---|---|---|---|
| Ruční kopírování a vkládání | Bolestivé | Nízká (lehké něco minout) | Žádná | Ručně (Excel apod.) |
| Link extraktory v prohlížeči | OK pro 1 stránku | Střední | Slabá | Ručně |
Vyhledávání Google pomocí site: | Snadné | Střední (neúplné) | Omezené na cca 1 000 | Ručně |
| XML sitemap | Snadné (pokud existuje) | Dobrá (pokud je aktuální) | Dobrá | Ručně/Skript |
| SEO nástroje (Screaming Frog) | Technické | Vysoká | Vysoká (placené) | CSV, Excel |
| Python skripty (Scrapy apod.) | Velmi technické | Vysoká | Vysoká | Na míru |
| Thunderbit | Velmi snadné | Velmi vysoká | Vysoká | Google Sheets, CSV apod. |
Thunderbit vám dává přesnost a škálování profesionálního crawleru a zároveň jednoduchost rozšíření do prohlížeče. Žádný kód, žádné nastavování, jen výsledky.
Bonus: S Thunderbitem vytáhnete víc než jen URL
Seznamte se se scrapingem podstránek Get Started Free
A tady to začíná být opravdu zajímavé. Thunderbit není jen na URL — můžete s ním vytáhnout i:
- Nadpisy
- E-maily
- Telefonní čísla
- Obrázky
- Jakákoli strukturovaná data na stránce
Když třeba vytváříte seznam leadů, může Thunderbit z každé položky v adresáři vytáhnout URL profilu, jméno, e-mail i telefonní číslo — všechno najednou. Když kontrolujete produkty, můžete získat URL produktu, název, cenu i stav skladu. Thunderbit podporuje i scraping podstránek, takže umí kliknout do každého odkazu a vytáhnout detaily i odtud.
A ano, extraktory e-mailů a telefonních čísel v Thunderbitu jsou úplně zdarma. To je pro obchodní a marketingové týmy velká výhoda.
Hlavní poznatky: Jak najít všechny stránky na webu pomocí AI
Pojďme si to shrnout:
- Extrahovat všechny URL z domény je s ručními nebo obecnými nástroji těžké.
- Obecné AI modely jako GPT nezvládnou navigaci po webu, stránkování ani dynamický obsah.
- Vertikální AI agenti jako Thunderbit jsou vytvořeni přímo pro extrakci webových dat — stabilní, opakovatelní a jednoduchí pro firemní uživatele.
- Thunderbit to dělá jednoduše: nainstalujte rozšíření, nechte AI navrhnout pole, zapněte stránkování, spusťte scraping a exportujte. Žádný kód, žádné starosti.
- Můžete vytáhnout víc než jen URL: nadpisy, e-maily, telefonní čísla a další — ideální pro lead gen, audity nebo research.
Jestli už vás nebaví ručně kopírovat odkazy nebo zápasit s technickými crawlery, vyzkoušejte Thunderbit. Má bezplatnou verzi, takže si sami ověříte, kolik času — a nervů — ušetříte.
A pokud vás zajímá, jak vám Thunderbit může pomoct i jinak — třeba se scrappingem produktů na Amazonu, extrakcí dat do Excelu nebo scrapingem výsledků vyhledávání Google — podívejte se na Thunderbit Blog pro další návody a tipy.
Připraveni získat zpět čas, který jinak trávíte ručním sběrem dat? Budoucnost extrakce webových dat patří vertikálním AI agentům — a Thunderbit je tahounem v tomto směru. Vyzkoušejte ho a udělejte z dalšího auditu, seznamu leadů nebo výzkumného projektu ten nejsnazší vůbec.
Extrahujte URL z libovolného webu s Thunderbitem
Čtěte dál
- Skutečné náklady na ruční sběr dat – Oxylabs
- Jak najít každou URL na webu – Ahrefs
- Jak používat vyhledávací operátory Google pro analýzu webu – Moz
P. S. Pokud někdy budete mít chuť ručně kopírovat 1 000 URL, vzpomeňte si: teď už na to existuje AI. Vaše zápěstí (a váš šéf) vám poděkují.
Vyzkoušejte AI Web Scraper Get Started Free



