
Každý seznam typu „nejlepší proxy API“ naráží na stejnou chybu v kategoriích: hází do jednoho pytle Bright Data, Thunderbit a Apify, jako by soutěžily o úplně stejnou práci. Nesoutěží. Jeden produkt může poskytovat směrované IP připojení, jiný vrací strukturované JSON a další spouští naplánovaný scrapingový workflow. Srovnávat je podle jediné vstupní ceny je jako porovnávat zahradní hadici a úpravnu vody.
Tento průvodce mapuje deset proxy, managed scraping, extrakčních a platformních produktů na základě oficiální dokumentace získané 10. srpna 2026. Nevyhlašuje univerzálního vítěze ani neopakuje přenositelné claims o úspěšnosti. Místo toho vám ukáže, jak definovat platný výsledek, zúžit výběr podle kategorie a spustit autorizovaný pilot na vašich vlastních cílech.
Proč „Proxy API“ neznamená jednu jedinou věc
Tady je ten zmatek, který stojí za každým vláknem typu „jaké proxy API mám použít“: ten pojem pokrývá nejméně čtyři skutečně odlišné produkty.
Surová proxy síť vám dá IP adresu a možnosti routování — logiku požadavků, retry, renderování JavaScriptu a parsování odpovědí si pořád řešíte sami. Je to nejbližší věc ke školní definici proxy: RFC 9110 ji popisuje jako zprostředkovatele předávajícího zprávy, kterého si klient zvolí. Nic víc.
Managed unblocking nebo browser API přebírá větší část životního cyklu požadavku. Vy pošlete URL, služba vybere IP, stránku případně vyrenderuje, zkusí to znovu při chybě a vrátí HTML, screenshot nebo občas Markdown.
Extrakční API jde ještě o úroveň výš — místo surového HTML, které si musíte sami parsovat, dostanete strukturované JSON nebo čistý text.
Scrapingová platforma pak balí všechno výše zmíněné dohromady se schedulerem, úložištěm a často i tržištěm předpřipravených scraperů.
Proč je to důležité u článku o „výběru proxy API“? Protože cena a „success rate“ nejsou mezi těmito kategoriemi srovnatelné. Rezidenční síť účtovaná podle objemu dat a managed API účtované podle počtu requestů řeší jiné problémy. Liší se jmenovatelé, zahrnutá práce i význam výstupu, takže žebříček podle headline ceny by byl zavádějící. Každý profil níže proto začíná kategorií produktu.
Ještě jedna věc na úvod: samotný přístup k proxy vám nedává automaticky právo scrapovat cokoliv chcete. Oprávnění, podmínky cílového webu a povinnosti v oblasti ochrany dat jsou samostatné téma — a žádné proxy API, jakkoli dobré, je nevyřeší za vás.
Jak hodnotit těchto deset možností
Neexistuje poctivé pevné váhování, které by fungovalo pro každý tým. Archivace raw HTML, monitor cen citlivý na lokaci a workflow pro obohacování strukturovaných dat mají odlišné nároky. Začněte těmito kritérii, přidělte jim váhy, které dohromady dají 100, a skórujte jen na základě vlastního pilotu nebo zdokumentovaného požadavku:
| Kritérium | Co měřit |
|---|---|
| Míra platných výsledků | Podíl pokusů, které projdou vaší sémantickou validací, ne jen HTTP 200 |
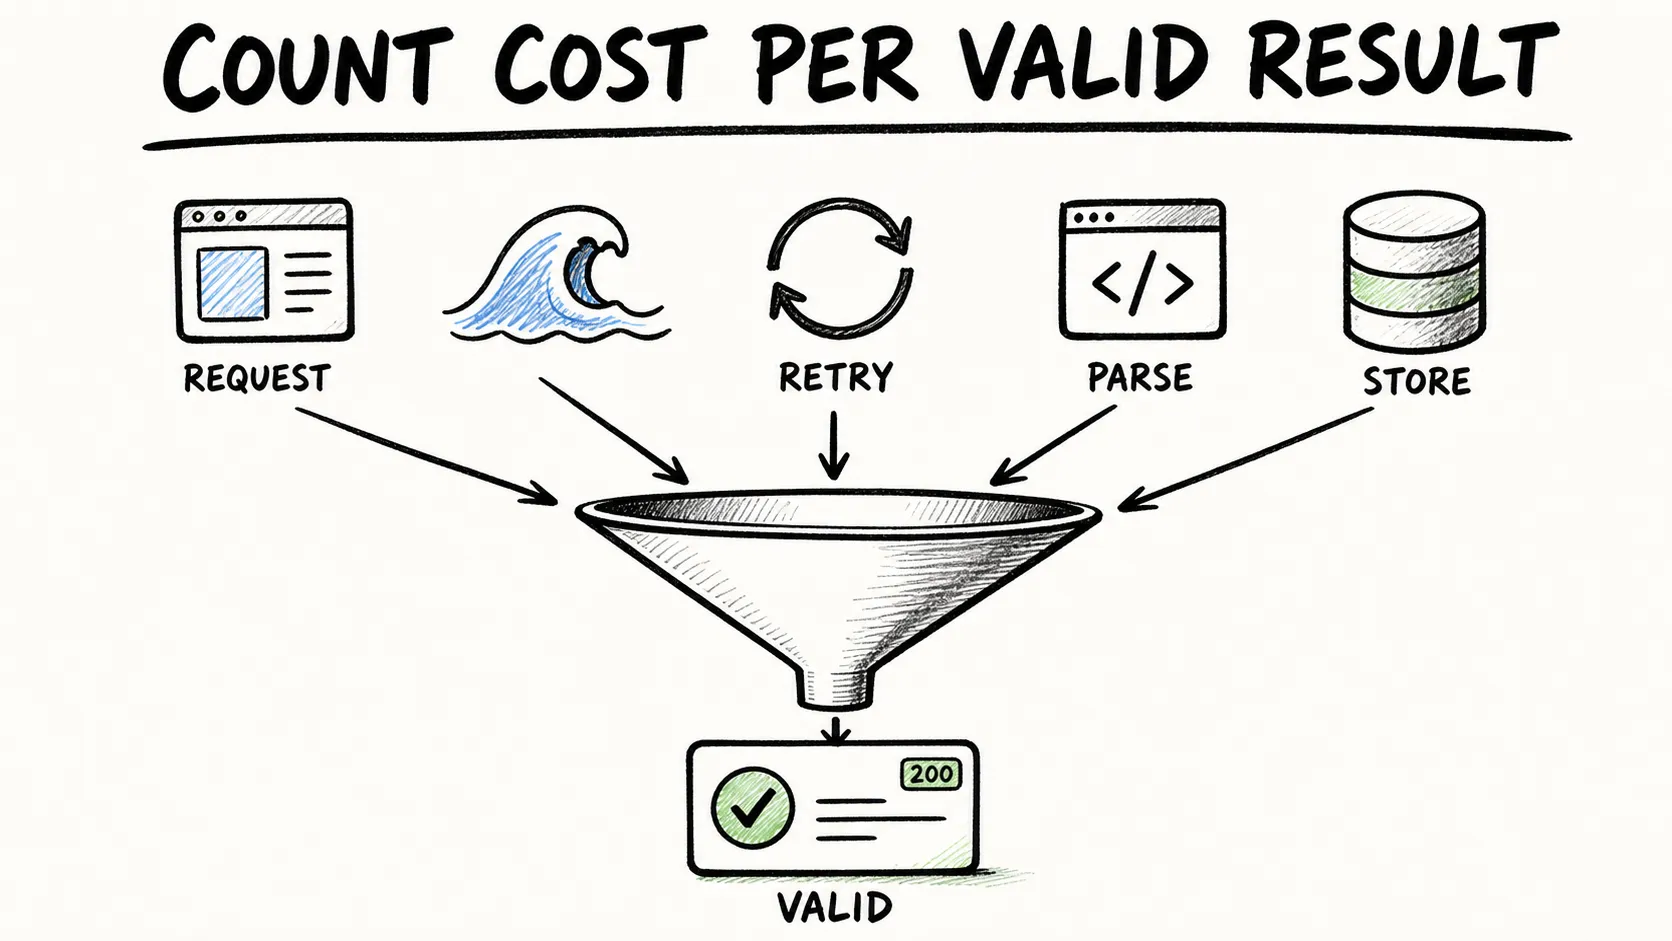
| Cena za platný výsledek | Všechny náklady na requesty, traffic, renderování, retry, parsování, úložiště a práci operátora dělené počtem platných výstupů |
| Shoda výstupu | Surová odpověď, vyrenderované HTML, screenshot, Markdown nebo data ve tvaru schématu |
| Kontrola připojení a geografie | Region, město, ASN, session, rotace, hlavičky, cookies a protokol, které skutečně potřebujete |
| Observabilita a limity | Request ID, hlavičky s účtovanou jednotkou, logy, replay, řízení konkurence a budget stopky |
| Důkazy o compliance | Prohlášení o zdrojování, smlouvy, oprávnění k cílovému použití, auditovatelnost a podpora |
| Inženýrská náročnost | Integrace, údržba parserů, monitoring a čas na ruční opravy |
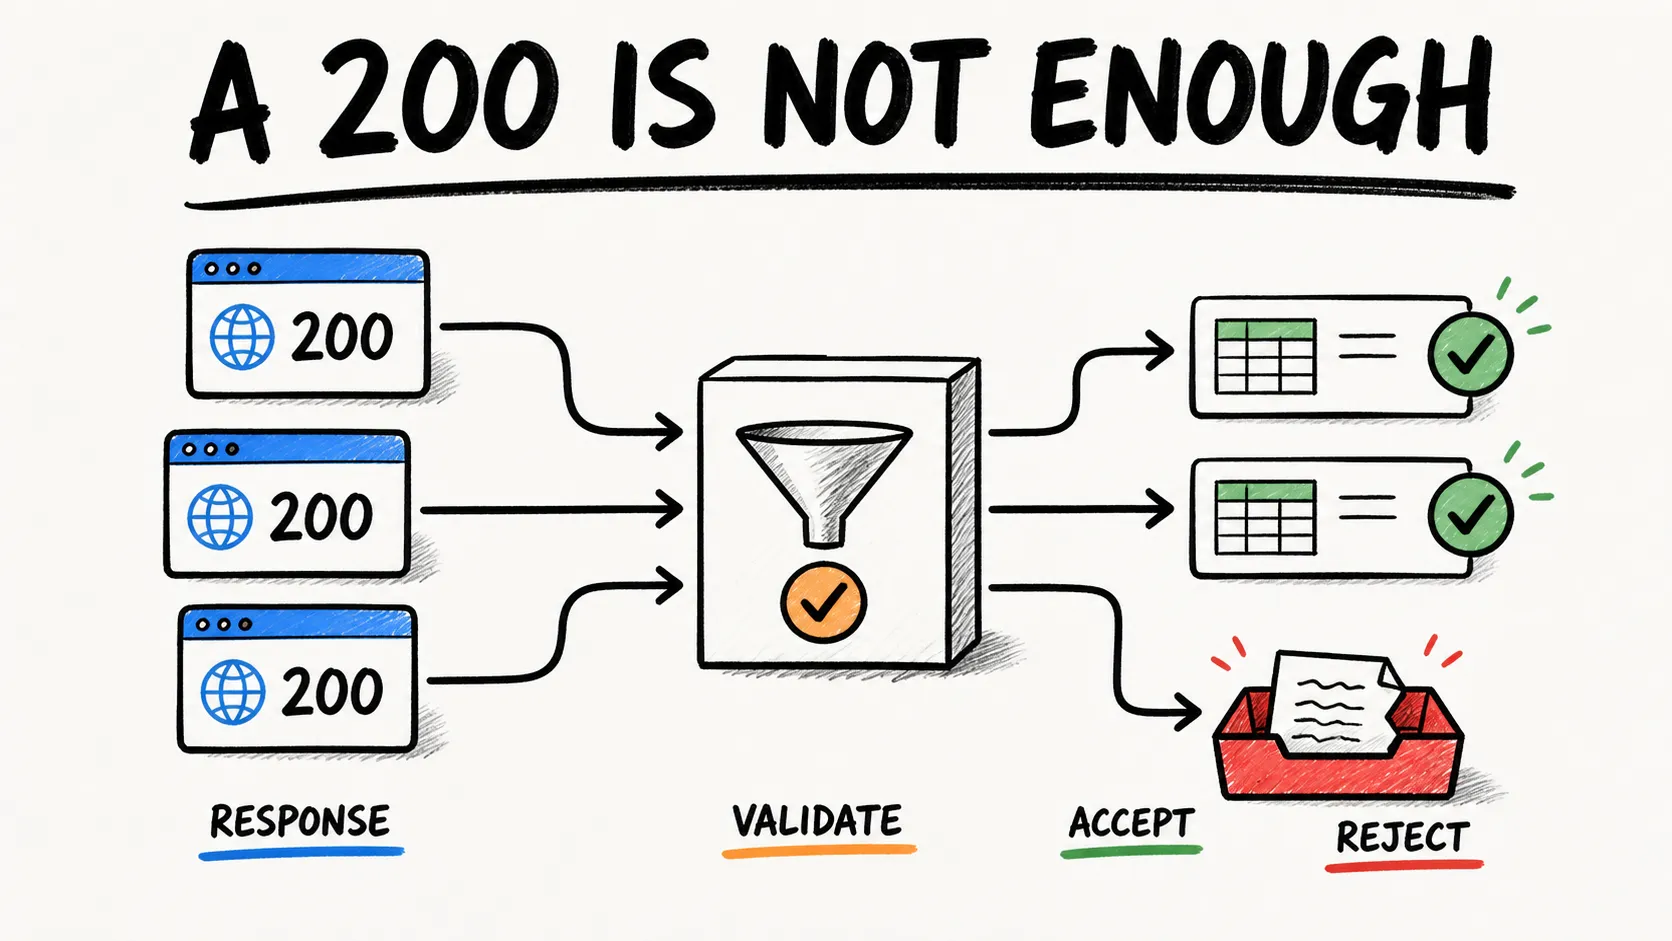
Nepodporovaná pole nechte prázdná nebo je označte jako „nerelevantní“. Cílem je rozhodnutí pro konkrétní workload, ne skóre, které vytváří falešnou přesnost.
1. Thunderbit
Thunderbit je v tomto seznamu trochu mimo hlavní kategorii, protože jde o sousední extrakční API, ne o surovou proxy síť, kterou připojíte k HTTP klientovi. Ve veřejné API dokumentaci popisuje Distill pro Markdown, Extract pro JSON ve tvaru schématu a Batch pro asynchronní sady URL. Tahle hranice může odstranit několik downstream kroků, pokud je požadovaným výstupem obsah nebo záznamy, ne proxy spojení.
Praktický rozdíl je vidět hned, jak odešlete request. U tradičního proxy API úspěšné volání znamená, že dostanete surové HTML — práce je hotová napůl. U endpointu POST /extract v Thunderbit pošlete cílovou URL a JSON Schema popisující pole, která chcete, a zpět dostanete už strukturované JSON odpovídající tomuto schématu. Žádné CSS selektory, žádná údržba parseru ve chvíli, kdy web v Q3 přepracuje produktovou stránku.
Právě tahle hranice produktu je jeho praktická výhoda: volající může popsat výstupní schéma, místo aby udržoval oddělený stack pro proxy, renderer a parser. I tak je potřeba skutečný pilot. Před nasazením ověřte úplnost polí, podporu cílových webů, latenci, spotřebu jednotek, konkurenci a chování při chybách na autorizovaných URL.
Klíčové funkce:
- Strukturovaný výstup jako výchozí stav — JSON odpovídající vámi definovanému schématu, ne surové HTML
- Zdokumentované ovládání renderování a routování — hodnocené jako součást extrakčního endpointu, ne jako samostatný proxy produkt
- HTTP API hranice — Distill, Extract a Batch pokrývají Markdown, strukturované JSON a asynchronní sady URL
- Batch režim pro asynchronní úlohy s více URL, užitečný pro cokoli nad rámec několika stránek
- Extrakce podle schématu, která snižuje, ale neeliminuje potřebu validace a údržby na úrovni polí
Účtovací jednotka: Distill a Extract používají zdokumentované jednotky na stránku, nikoli proxy bandwidth. Před plánováním rozpočtu si zkontrolujte aktuální Thunderbit pricing a API dokumentaci, protože jednotky i plány se mohou měnit.
Vhodné pro: vývojáře, kteří chtějí hned od začátku validovaná, strukturovaná data a nechtějí sami stavět a udržovat pipeline pro rotaci proxy a parsování.
Kde pořád vyhrává tradiční proxy API: pokud potřebujete raw HTML pro vlastní pipeline, hromadnou archivaci nebo ne-HTTP protokol, model strukturovaného výstupu od Thunderbit není ta správná volba — ve skutečnosti chcete některou z dalších devíti možností.
Přeskočte proxy a sáhněte po AI extrakci Agentic web scraper od Thunderbit zvládá renderování i anti-bot bariéry sám, takže spousta úloh žádné samostatné proxy API nepotřebuje. Get Started Free
2. Bright Data
Bright Data je pro toto odvětví nejblíž zavedenému lídrovi: nabízí rezidenční, datacentrové, ISP i mobilní proxy sítě a k tomu samostatný managed produkt Web Unlocker. To slovo „samostatný“ je důležité — Bright Data není jeden produkt, ale rodina produktů, a ceny i chování se výrazně liší podle toho, co přesně kupujete.
Dokumentace k Residential síti uvádí cílení na stát, region, město, ZIP a ASN. Web Unlocker je samostatná managed vrstva s billingem „pay per success“ a měsíčním spend capem. To jsou užitečné ovládací prvky, ale jejich přesnost a vhodnost je nutné ověřit v pilotu kupujícího; tento průvodce neprováděl benchmark geografie napříč více poskytovateli.
Klíčové funkce:
- Rezidenční, datacentrové, ISP a mobilní proxy typy s detailním geotargetingem
- Managed API Web Unlocker s účtováním podle úspěšnosti a limity výdajů
- Zdokumentované opt-in sourcing pro rezidenční IP adresy
- Debug pole (request ID, billed state, peer country) pro troubleshooting
Účtovací jednotka: surové proxy produkty a Web Unlocker používají různé jednotky. Před plánováním rozpočtu si na oficiálních cenových stránkách ověřte přesný produkt, závazek, oprávnění cílového použití i aktuální sazbu.
Vhodné pro: enterprise týmy, které potřebují všechny typy proxy a jsou ochotné spravovat o něco složitější produktové portfolio výměnou za škálování.
3. Oxylabs
Oxylabs hraje ve stejné váhové kategorii jako Bright Data — rezidenční, datacentrové, ISP a mobilní proxy sítě plus samostatný produkt Web Unblocker pro managed přístup. Jeho session handling používá dedikovanou hlavičku X-Oxylabs-Session-Id, takže získáte kontinuitu IP v omezeném časovém okně, což je opravdu užitečné pro vícekrokové flow, třeba stránkované výsledky vyhledávání.
Klíčové funkce:
- Více proxy typů s geokontrolami popsanými výrobcem
- Web Unblocker pro JS renderování a managed unblocking, účtovaný aktuálně podle GB
- Udržení session pomocí header-based session ID
- Hlavičky úloh/session v ukázkových odpovědích pro debugging
Účtovací jednotka: stránka Web Unblocker získaná pro tento výzkum používala tarify založené na GB s limity specifickými pro plán; ostatní produkty Oxylabs používají jiné jednotky. Znovu ověřte aktuální stránku vybraného produktu.
Vhodné pro: provozy s velkým objemem dat, které potřebují geografickou rozmanitost a nevadí jim billing založený na GB napříč produkty.
4. ScrapingBee
ScrapingBee je managed HTML API: pošlete URL, dostanete obsah stránky a downstream validace a parsování zůstávají většinou na vás. Dokumentace zpřístupňuje systém kreditů závislý na funkcích, Auto-Mode, cost headers a parametr max_cost, který může omezit jednotlivý Auto-Mode request.
Klíčové funkce:
- Auto-Mode, který automaticky navyšuje konfiguraci (úroveň proxy, renderování), dokud neuspěje
- Parametr
max_costpro omezení výdajů na jeden request - Neúspěšné pokusy Auto-Mode přes jakoukoli konfiguraci stojí nula kreditů
- Hlavičky s použitím a cenou na každé odpovědi pro sledování v reálném čase
Účtovací jednotka: kredity se liší podle renderování, proxy tieru a dalších zapnutých funkcí. Místo toho, abyste základní plán brali jako cenu za request, podívejte se na aktuální kreditovou stupnici a limity konkurence.
Vhodné pro: menší až střední projekty, kde je důležitější rychlé nasazení než hluboká customizace — kreditový model je po pochopení opravdu dobře předvídatelný.
5. ZenRows
ZenRows balí do jednoho produktu Universal Scraper API, Scraping Browser a rezidenční proxy, s multiplikátory requestů pro JavaScript renderování a použití premium proxy. Jeden detail stojí za jasné upozornění: ZenRows počítá HTTP 404 a 410 jako „úspěšné“ pro účely billingů, což je dobrá připomínka, že „úspěch“ na faktuře dodavatele a „úspěch“ ve vaší validaci nejsou totéž.
Klíčové funkce:
- Kombinovaná sada nástrojů: scraper API, browser automation a rezidenční proxy
- Uváděné více výstupních formátů (JSON, Markdown, screenshoty, plaintext)
- Managed rendering a komponenty pro přístup, jejichž aktuální chování je nutné ověřit na autorizovaných cílech
- URL-based usage limity, které pozastaví requesty, dokud nepřikoupíte kapacitu
Účtovací jednotka: request kredity se zdokumentovanými multiplikátory pro funkce jako JavaScript renderování a premium proxy. Ověřte si aktuální plán a pravidla multiplikátorů.
Vhodné pro: týmy, které chtějí od jednoho dodavatele vyhodnotit scraper API, browser i proxy produkty, a přitom testovat každý vybraný produkt na autorizovaných cílech.
Jaké vzorce se už teď ukazují
Po pěti nástrojích je vzorec jasný: téměř nikdo nemá produktovou hranici přesně shodnou s marketingovým popisem. Bright Data i Oxylabs oddělují „raw proxy“ od „managed unblocking“ do samostatných produktů se samostatnými cenovými modely, takže homepage dodavatele sama o sobě neodpoví na otázku „kolik mě to bude stát“ — nejdřív musíte vybrat konkrétní produkt. ScrapingBee a ZenRows používají billing založený na kreditech s rostoucími multiplikátory, což je transparentnější než GB pricing, ale pořád je potřeba číst drobný text k tomu, co multiplikátor spouští.
Další opakující se téma: „úspěšný request“ definuje dodavatel, ne vy. To, že ZenRows počítá 404 jako billable success, není zlomyslnost — je to jen nesoulad definic, který vás doběhne, pokud předpokládáte, že „účtováno jako úspěch“ znamená „data, která jsem potřeboval, tam opravdu byla“.
6. Scrape.do
Scrape.do provozuje managed Web Scraping API s modelem „Successful API Credits“ — platíte jen za aktuální core endpoint, protože v samotné navigaci cen je uvedeno, že samostatné proxy a scraping-browser produkty jsou „coming soon“ (což se vyplatí ověřit, než budete předpokládat, že Scrape.do dnes prodává raw proxy). Rozhraní API pokrývá geo-targeting, sessions, hlavičky, cookies a přepínání mezi browser/proxy režimem.
Klíčové funkce:
- Účtování na kredity za úspěšné výsledky, které zastaví requesty po dosažení měsíčního limitu (bez neočekávaného přečerpání v základním nastavení)
- Premium-network přepínač pro způsobilé cíle
- Session a geo kontrola, kterou je potřeba testovat proti přesnému workloadu
- Režim browser renderování pro stránky náročné na JS
Účtovací jednotka: balíčky successful API credits s měsíčními limity; ověřte aktuální limity plánu, konkurenci a pravidla pro dodatečnou kapacitu.
Vhodné pro: týmy citlivé na rozpočet, které chtějí managed API bez závazku k pricingu založenému na GB.
7. Smartproxy / Decodo
Smartproxy se přejmenoval na Decodo a jeho aktuální stránka cen pro rezidenční proxy popisuje plány per GB i pay-as-you-go, s cílením na úrovni ASN a podporou rotujících i sticky session přes HTTP(S)/SOCKS5. Získaná stránka cituje výzkum Proxyway u zveřejněných výkonových tvrzení. To je užitečný kontext, ale není to důkaz, že stejný výsledek se přenese na jiný cíl, region, časové okno nebo konfiguraci účtu.
Klíčové funkce:
- Rezidenční, datacentrové, ISP a mobilní proxy typy
- Cílení na ASN i lokalitu
- Podpora rotujících a sticky session přes HTTP(S) a SOCKS5
- Výkonové claims převzaté z externího výzkumu, ne vlastní reportování
Účtovací jednotka: stránka rezidenčního produktu získaná pro tento výzkum popisuje varianty per-GB i pay-as-you-go. Aktuální sazby a zahrnuté ovládací prvky si ověřte na stránce vybraného produktu.
Vhodné pro: e-commerce monitoring a provoz ve středním měřítku, který chce variabilitu proxy bez enterprise cen.
8. Scrapfly
Scrapfly je managed scraping API s volitelnou funkcí Anti Scraping Protection (ASP). Jeho dokumentace výslovně říká, že obrana cíle se vyvíjí, obnova po bloku může trvat nejistou dobu a náklady spojené se zdroji se mohou měnit. Tenhle dodatek je důležitý: managed access není záruka trvalého přístupu.
Klíčové funkce:
- ASP s dynamickým navyšováním nákladů podle obtížnosti cíle
- Parametr
cost_budgeta ochrana proti neférovému započítání neúspěšných scrape pokusů (vyloučené status code se proti vám nepočítají) - Hlavičky s cenou na úrovni odpovědi a dashboard pro replay/debug requestů
- Volitelné browser renderování a rezidenční proxy pooly
Účtovací jednotka: kredity, jejichž cena se může měnit podle proxy poolu, renderování a konfigurace ASP. Hlavičky odpovědí, cost_budget a limity projektu pomáhají tuto cenu měřit a držet pod kontrolou.
Vhodné pro: týmy, které zvlášť prioritizují anti-detection nástroje a chtějí vidět, kolik každá request skutečně stála v kreditech.
9. Zyte
Zyte (dříve Scrapinghub, pro ty, kdo jsou v oboru dost dlouho na to, aby si to pamatovali) nabízí API, které může vracet surové HTTP odpovědi, browser-renderované HTML, screenshoty nebo automaticky extrahované strukturované objekty podle typu requestu. Ceny jsou přiřazeny podle cílového/request tier, ne podle jedné pevné sazby, a — podobně jako u několika dalších nástrojů zde — neúspěšné odpovědi a rate-limited requesty se neúčtují.
Klíčové funkce:
- Více výstupních režimů: HTTP, browser, screenshot nebo auto-extraction
- Nativní integrace se Scrapy pro Python vývojáře, kteří už v tomto ekosystému pracují
- Spend limity a blocking thresholds, které můžete nastavit dopředu
- Ceny podle target/request tier, které se přizpůsobují obtížnosti webu
Cenový model: pay-as-you-go dostupný; přesná sazba závisí na tieru cíle.
Vhodné pro: týmy, které potřebují managed HTTP/browser/extraction API, obzvlášť ty, které už používají Scrapy. Shoda cíle a stabilita tieru se musí potvrdit pilotem.
10. Apify
Apify je méně proxy API a spíš plnohodnotná scrapingová platforma — výpočetní výkon, předpřipravení „Actors“ (jejich označení pro zabalené scrapery), scheduling, dataset storage i proxy služby jsou balené dohromady s odděleným účtováním každé položky. To je plus, pokud chcete tržiště hotových scraperů pro běžné weby; je to komplikace, pokud jste chtěli jen proxy a dostali platformu.
Klíčové funkce:
- Tržiště předpřipravených Actors pro běžné cíle scrapingu
- Rezidenční, datacentrové a SERP proxy služby jako jedna z komponent
- Scheduling, dataset storage a webhooky pro automatizaci workflow
- Detailní diagnostické proxy status kódy pro debug neúspěšných requestů
Účtovací jednotka: předplacené platformní využití může zahrnovat oddělené náklady na compute, Actors, proxy, dataset a storage. Modelujte celý workload, ne jen proxy položku.
Vhodné pro: týmy, které chtějí spíš hotové scrapery a automatizaci workflow než surovou kontrolu nad proxy.
Skryté náklady: používejte cenu za platný výsledek
Listová cena je jen jeden čitatel. Užitečný jmenovatel nejsou odeslané requesty, přenesené bajty ani HTTP 200 odpovědi. Je jím počet výstupů, které splňují vaši vlastní sémantickou validaci.
Metriku definujte před pilotem:
cost_per_1,000_valid = total_pilot_cost / valid_results * 1,000
total_pilot_cost by měl zahrnovat náklady, které se mezi kandidáty skutečně liší: request nebo síťové jednotky, multiplikátory za renderování a premium routování, retry, parsování, výpočetní výkon, úložiště, monitoring a čas operátora. valid_results by měly počítat jen odpovědi s požadovanými poli, správnou lokalitou, přijatelnou čerstvostí a bez challenge nebo consent stránky maskované jako obsah.
Zvažte záměrně hypotetický příklad. Provider A stojí 3,00 $ za testovací batch a vygeneruje 600 platných záznamů; Provider B stojí 3,50 $ a vygeneruje 950. Jejich normalizované náklady jsou 5,00 $ a asi 3,68 $ za 1 000 platných záznamů. Tato čísla ukazují jen aritmetiku. Nejsou to tvrzení o žádném konkrétním poskytovateli, typu cíle ani ochranném systému.
U extrakčního API, jako je Thunderbit, započítejte hodnotu a náklady získání dat ve tvaru schématu místo raw HTML. U surového proxy řešení započítejte downstream parser a údržbu. Ani jedna hranice není univerzálně levnější; odpověď závisí na tom, jaký výstup workload skutečně potřebuje.
Pokud chcete hlubší rozbor toho, jak AI-based extrakce funguje jinak než scraping založený na selektorech, naše vysvětlení AI web scraping popisuje základní přístup.
Proxy API vs. AI scraping API: Potřebujete vůbec proxy?
Každý článek na špičce vyhledávání na toto téma předpokládá, že čtenář proxy potřebuje. Nikdo tenhle předpoklad nezpochybní — což je zvláštní, když tolik lidí dnes klade mnohem základnější otázku: potřebuji vůbec raw HTML, nebo jen data?
| Oblast | Tradiční proxy API | AI scraping API (např. Thunderbit) |
|---|---|---|
| Co dostanete zpět | Surové HTML, které parsujete sami | Strukturované JSON odpovídající vašemu schématu |
| Chování managed access | Řídí ho váš proxy/client stack nebo samostatný managed produkt | Je součástí extrakční služby a podléhá jejím zdokumentovaným limitům |
| Parsování/extrakce | Parsery stavíte a udržujete vy | AI extrahuje pole podle schématu |
| Údržba při změně layoutu | Změny selektorů a parserů řeší váš tým | Služba přebírá větší část extrakční logiky, ale váš tým stále validuje výstup |
| Vhodné pro | Archivaci velkých objemů HTML, custom pipeline, specifické protokoly | Strukturovaná data, RAG ingest, lead listy |
| Hranice integrace | Proxy endpoint nebo API dodavatele | HTTP extrakční endpointy jako Distill, Extract a Batch |
Upřímný závěr: pokud vaše pipeline skutečně potřebuje raw HTML, kontrolu session na úrovni proxy nebo vlastní request stack, tradiční proxy API může být správná hranice. Pokud je požadovaným výstupem strukturovaná produktová data, lead záznamy nebo výsledky vyhledávání připravené do tabulky či retrieval pipeline, extrakční API může přesunout routování, renderování i extrakci za jednu hranici služby. Tím se rozhodnutí přeformuluje, aniž by se dokazovalo, že je jeden model univerzálně lepší.
Pro týmy, které hledají hlavně leady nebo strukturované záznamy a ne raw stránky, ukazují průvodce AI lead generation a AI for sales, jaké workflow mají přirozeně jako výstup strukturované řádky.
Zjistěte, jestli vůbec potřebujete proxy Bezplatný plán pokrývá 6 stránek měsíčně — otestujte, jestli vestavěné renderování Thunderbit zvládne váš cílový web, než koupíte proxy kapacitu. Get Started Free
Otázky compliance a zdrojování patří do hodnocení
Technický přístup a oprávnění jsou dvě odlišné věci. Před pilotem si zdokumentujte, které URL smí organizace sbírat, jaká pole dat potřebuje, pravidla retence, povinnosti v oblasti ochrany soukromí, relevantní podmínky cílových webů a komu patří eskalační rozhodnutí. Samotné předplatné na proxy tato oprávnění nerozšiřuje.
U rezidenčních sítí si od poskytovatele vyžádejte aktuální dokumentaci ke sourcingu a souhlasu, pravidla způsobilosti cílů, požadavky na identitu nebo KYC, auditní důkazy a postup reakce v okamžiku, kdy IP rozsah nebo cíl přestanou být dostupné. Oficiální prohlášení dodavatele jsou užitečné důkazy, ale nejsou nezávislým auditem dodavatelského řetězce.
Během pilotu zaznamenávejte region a ASN, pokud je to relevantní, ale nevyvozujte z jednoho lookupu závěr o sourcingu celé sítě. Nesrovnalosti berte jako otázky pro dodavatele a nákupní tým. Pokud se změní oprávnění, selže kontrola policy, dosáhne se retry limitu nebo se spustí budget cap, test zastavte.
U extrakčních a platformních služeb nezmizí odpovědnost za sourcing a přístup; přesune se za jinou služební hranici. Kupující by měl stále prověřit smlouvy, zásady povoleného použití, chování při chybách a nakládání s daty. Tento průvodce je technická metodika hodnocení, ne právní rada.
Srovnání na první pohled
| Nástroj | Hranice produktu | Typický výstup | Účtovací jednotka k ověření | Užitečná otázka pro pilot |
|---|---|---|---|---|
| Thunderbit | Extrakční API | Markdown nebo JSON ve tvaru schématu | Jednotky na stránku | Zůstávají požadovaná pole validní napříč šablonami cíle? |
| Bright Data | Rodiny raw proxy plus managed Unlocker | Připojení, raw obsah nebo managed výstup | Traffic nebo úspěšné requesty podle produktu | Jaký přesný produkt a geo kontrolu workload vyžaduje? |
| Oxylabs | Proxy rodiny plus Web Unblocker a scraper API | Připojení nebo managed obsah | Specifické pro produkt; získaná stránka Unlocker byla GB-based | Jak ovlivňuje velikost odpovědi a kontinuita session cenu? |
| ScrapingBee | Managed HTML API | HTML | Kredity závislé na funkcích | Která konfigurace uspěje a kolik stojí jedna platná stránka? |
| ZenRows | Scraper API, browser a rezidenční proxy | Více formátů popsaných dodavatelem | Requesty s multiplikátory funkcí | Jak billing 404/410 interaguje s vaší validací? |
| Scrape.do | Managed Web Scraping API | Obsah stránky | Successful API credits | Sedí premium, geo, session a browser kontroly na workload? |
| Decodo | Rodina proxy a scraping produktů | Připojení nebo výstup podle produktu | GB nebo PAYG na získané rezidenční stránce | Jsou ovládací prvky lokace, ASN, protokolu a sticky session dostatečně přesné? |
| Scrapfly | Managed scraping API | Obsah stránky, browser výstup, volitelná extrakce | Kredity závislé na funkcích | Fungují budget limity, logy a ochrana proti selhání podle očekávání? |
| Zyte | Managed HTTP, browser, extraction a Scrapy rozhraní | HTTP, vyrenderované HTML, screenshoty nebo objekty | Tier cíle/requestu plus volby | Je tier stabilní a odpovídají limity režimu requestů implementaci? |
| Apify | Scrapingová platforma a tržiště plus proxy | Dataset z Actoru nebo crawleru | Poplatky za compute, Actor, proxy, storage a dataset | Vyváží přínos workflow celkové náklady na platformu? |
Kategorie a účtovací jednotky výše vycházejí z oficiálních stránek získaných 10. srpna 2026. Plány, limity, názvy i multiplikátory funkcí se mohou měnit, proto si před plánováním rozpočtu znovu ověřte přesný produkt.
Rozhodovací flowchart: Co vlastně scrapujete?
Nejčastější otázka ve fórech kolem proxy je variace na „nevím, co je nejlepší, má někdo doporučení?“ — a po ní následuje obecný seznam, který ve skutečnosti neodpovídá. Tady je pokus o něco blíž skutečné rozhodovací cestě.
Jaký výstup potřebujete?
- Potřebujete kontrolu proxy protokolu, raw odpovědi, vlastní hlavičky nebo vlastní parser? Vyberte si raw proxy produkty.
- Potřebujete vyrenderované HTML bez toho, abyste spravovali browser a retry vrstvu? Vyberte managed scraping nebo browser API.
- Potřebujete validovaná pole, záznamy nebo Markdown? Zvažte extrakční API, včetně zdokumentovaných endpointů Distill a Extract od Thunderbit.
- Potřebujete scheduling, storage, marketplace joby a týmové operace? Zvažte scrapingové platformy.
Které kontroly jsou nepřekročitelné? Sepište požadované regiony, délku session, chování rotace, request metody, cookies, hlavičky, renderování, screenshoty, datový tvar, konkurenci, logy a budget stopky. Kandidáty, kteří nesplní tvrdý požadavek, vyřaďte ještě před testováním měkkých preferencí.
O jakém objemu mluvíme? Nepoužívejte obecný práh počtu stránek pro výběr poskytovatele. Objem interaguje s velikostí odpovědi, konkurencí, multiplikátory funkcí, mírou platných výsledků, vyjednanými závazky a inženýrskou náročností. Modelujte očekávaný mix šablon cílů a spusťte pilot v reprezentativní konkurenci.
Raw HTML nebo strukturovaná data? Tady pořád leží hlavní rozcestí. Pokud potřebujete raw HTML pro vlastní pipeline, testujte proxy nebo managed-HTML produkty. Pokud je dodávkou validovaný řádek, JSON nebo Markdown, testujte extrakční hranici jako samostatnou kategorii místo toho, abyste násilně porovnávali neporovnatelné.
Vytvořte si vlastní váženou scorecard
Seznam funkcí sám o sobě nerozhodne, protože výkon i cena závisí na cílové sadě a konfiguraci. Scorecard postavte z vlastních požadavků a výsledků pilotu. Níže uvedené váhy jsou záměrně prázdné.
| Kritérium | Vaše váha | Skóre poskytovatele A (1–5) | Důkaz | Skóre poskytovatele B (1–5) | Důkaz |
|---|---|---|---|---|---|
| Míra platných výsledků | |||||
| Cena za platný výsledek | |||||
| Shoda výstupu | |||||
| Geo/session/request kontroly | |||||
| Observabilita a budget kontroly | |||||
| Compliance a důkazy o sourcingu | |||||
| Podpora a provozní vhodnost | |||||
| Inženýrská a údržbová náročnost | |||||
| Celkem | 100 |
Používejte skóre 1–5 jen tehdy, když existují důkazy. „Nerelevantní“ držte odděleně od nuly. Váhy publikujte spolu s výsledkem, aby kolegové viděli, které předpoklady rozhodly.
Následující krátký příklad v Pythonu selhává uzavřeně při chybějících nebo neplatných vstupech. Minimum 30 pokusů je v tomto tutoriálu jen ochranná hranice, ne univerzální tvrzení o velikosti statistického vzorku:
from dataclasses import dataclass

@dataclass(frozen=True)
class PilotResult:
    attempts: int
    valid_results: int
    request_cost: float
    engineering_cost: float = 0.0

    def cost_per_1000_valid(self) -> float:
        if self.attempts < 30:
            raise ValueError("pilot needs at least 30 attempts for this tutorial")
        if not 0 < self.valid_results <= self.attempts:
            raise ValueError("valid_results must be between 1 and attempts")
        if self.request_cost < 0 or self.engineering_cost < 0:
            raise ValueError("costs cannot be negative")
        total = self.request_cost + self.engineering_cost
        return total / self.valid_results * 1000

def weighted_score(weights: dict[str, float], scores: dict[str, float]) -> float:
    if set(weights) != set(scores):
        raise ValueError("every weighted criterion needs a score")
    if abs(sum(weights.values()) - 100.0) > 1e-9:
        raise ValueError("weights must sum to 100")
    if any(not 1 <= score <= 5 for score in scores.values()):
        raise ValueError("scores must be in the 1–5 range")
    return sum(weights[name] * scores[name] for name in weights) / 100
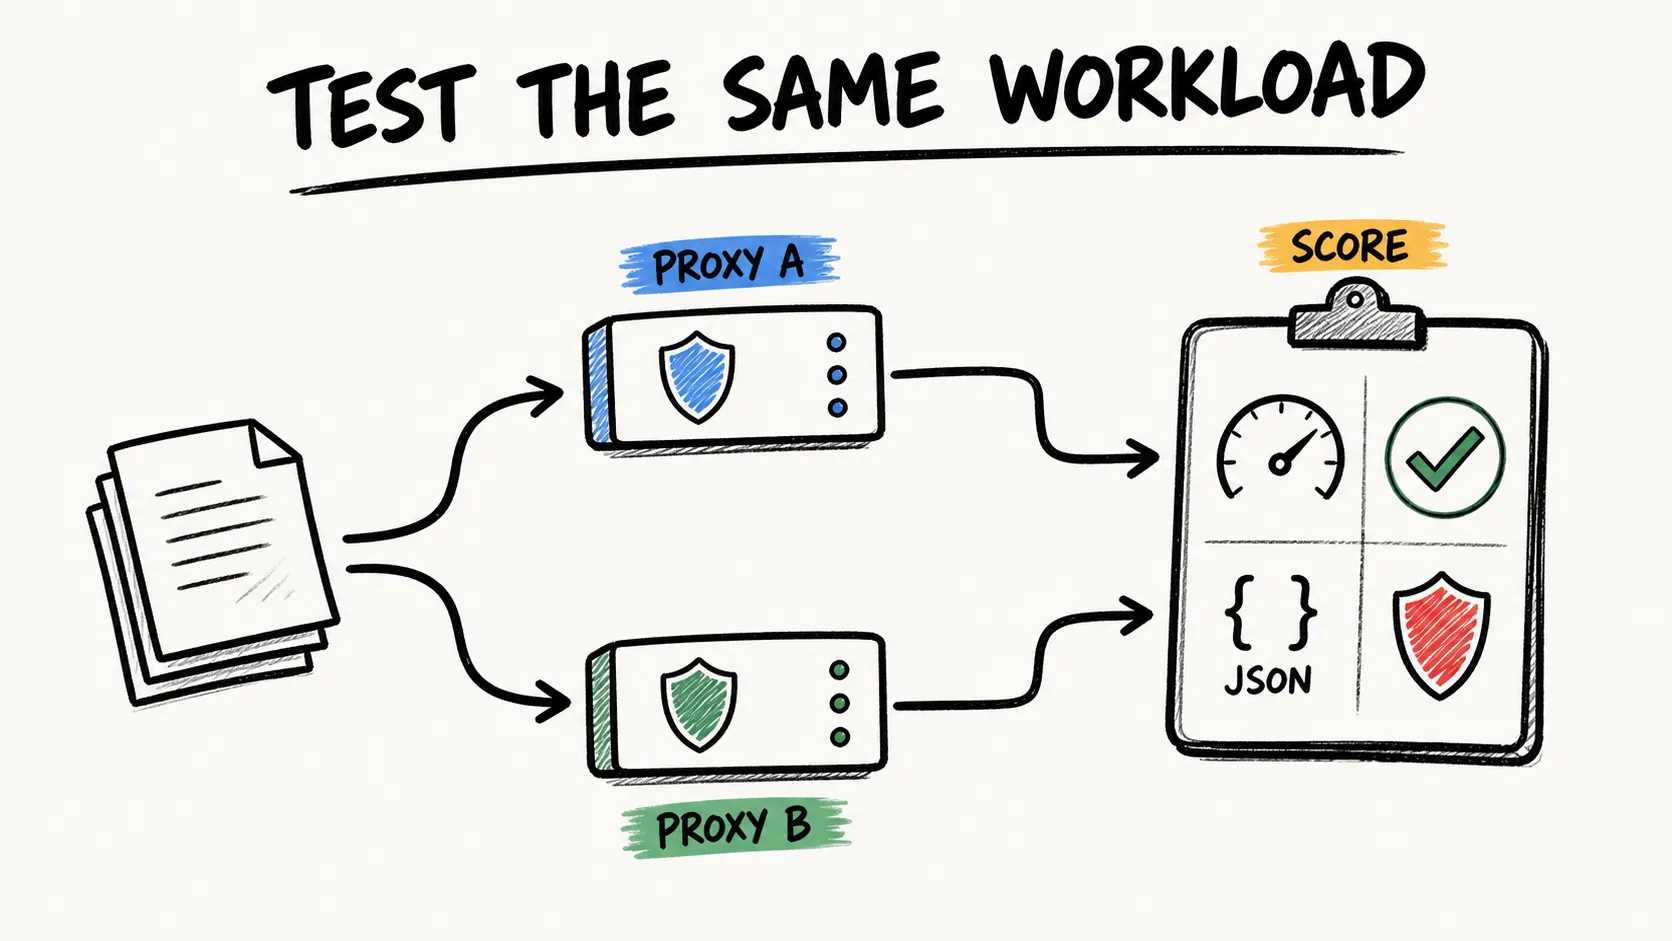
Spusťte alespoň dvě kola v různých časech za stejných podmínek. U každého pokusu zaznamenejte cílovou skupinu, region, konfiguraci, status, výsledek sémantické validace, latenci, retry, účtované jednotky, bajty, request nebo job ID a důvod neplatnosti. Větší nákupy potřebují vzorek odpovídající riziku týmu a rozmanitosti cílů; tutoriálový minimální práh to nenahradí.
Pokud jste se scrapingem teprve na začátku a chcete si před porovnáváním dodavatelů ujasnit základy, náš úvod do what web scraping actually is a průvodce web scraping without coding jsou dobrý start.
Výběr proxy API není ve skutečnosti otázka „který vendor je nejlepší“, ale „která hranice produktu odpovídá požadovanému výstupu“, a pak pilot, který potvrdí, že marketingová tvrzení obstojí proti vašim skutečným cílům. Deset poskytovatelů, čtyři produktové kategorie a jeden vzorec (cena za platný výsledek) vás dostanou většinu cesty. Zbytek je už jen samotné otestování místo spoléhání na cizí benchmark.
Jestli je vaším skutečným cílem strukturovaná data a ne hromada HTML k parsování, můžete do shortlistu přidat rozšíření Thunderbit pro Chrome nebo API a před pilotem si ověřit aktuální limity trialu či plánu. YouTube kanál Thunderbit navíc nabízí ukázky produktu; berte je jako demonstrace, ne jako nezávislý benchmark.
Vyzkoušejte agentic web scraper od Thunderbit Get Started Free
Další informace
- Co je web scraping
- AI web scraping
- Web scraping bez programování
- Alternativy k Instant Data Scraper
- Scraping LinkedIn
Časté dotazy
1. Jaký je skutečný rozdíl mezi proxy sítí a scraping API?
Surová proxy síť vám dá IP adresu a kontrolu routování — renderování, retry i parsování si pořád řešíte sami. Scraping API (managed nebo AI-based) přebírá větší část tohoto životního cyklu a vrací HTML, JSON nebo Markdown podle produktu. Nejsou zaměnitelné a přímé srovnání cen obvykle vede k zavádějícímu závěru.
2. Jak mám měřit „success rate“, aby to mělo skutečný smysl?
Neberte HTTP 200 jako úspěch. Definujte úspěch jako „obsah nebo pole, která jsem skutečně potřeboval, byla přítomná a správná“ a testujte reprezentativní vzorek reálných cílů — ne demo web dodavatele.
3. Jak spočítám cenu za úspěšný request?
Vydělte uvedenou cenu (za request nebo GB) vaší naměřenou úspěšností na konkrétních cílech. Levnější poskytovatel s nižší úspěšností může po započtení retry vyjít dráž — než se zavážete k plánu, udělejte si propočet.
4. Potřebuji proxy API, když chci jen strukturovaná data, ne raw HTML?
Ne nutně. Extrakční API jako Thunderbit může vracet strukturované JSON a přesunout renderování i routování za hranici služby, takže pro tento workflow možná nebudete muset kupovat samostatnou raw proxy. Ověřte podporu cílových webů a validitu polí. Tradiční proxy produkt zůstává relevantní kategorií ve chvíli, kdy potřebujete raw odpovědi nebo proxy-level kontrolu.
5. Co bych se měl dodavatele zeptat ohledně sourcingu IP před registrací?
Požádejte o aktuální dokumentaci k souhlasu a zdrojování rezidenčních IP, pravidla povoleného použití, důkazy o compliance, auditovatelnost a postup reakce ve chvíli, kdy subnet nebo cíl přestanou být dostupné. Prvostupňová prohlášení by měla být podle rizika zkontrolována nákupem nebo právníkem; nejsou nezávislým auditem dodavatelského řetězce.




