
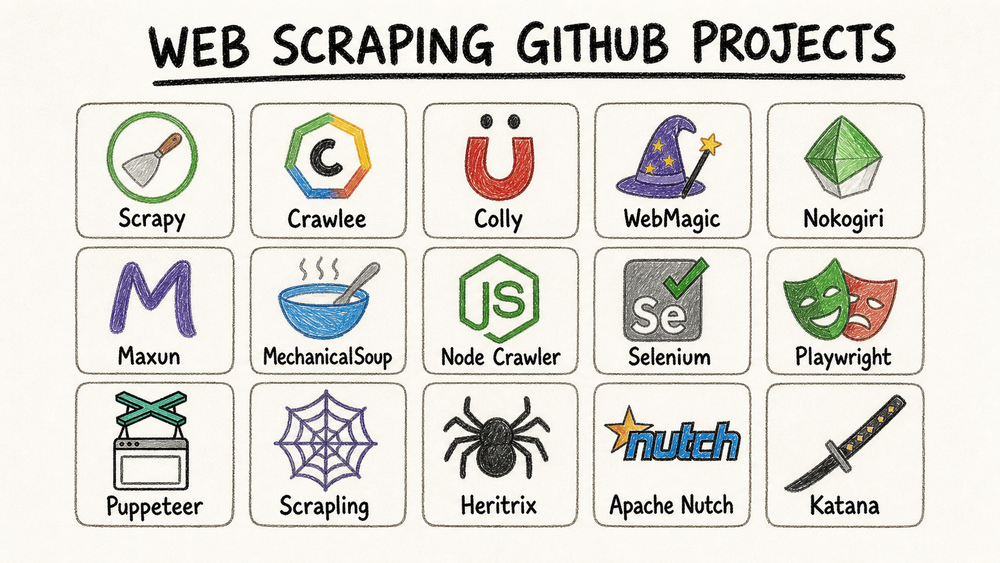
Web je i v roce 2026 pořád plný cenných dat, ale většina týmů ve skutečnosti nepotřebuje „nějaký scraper“ obecně. Potřebují praktickou odpověď na jednu ze tří otázek: který open-source projekt má smysl dál rozvíjet, která sada nástrojů zvládne moderní weby s náročným JavaScriptem a jestli by se měl někdo bez vývojářských dovedností GitHubu raději úplně vyhnout a místo toho použít no-code workflow.
Tenhle aktualizovaný přehled je postavený právě kolem tohoto rozhodovacího procesu. 6. srpna 2026 jsem znovu zkontroloval veřejné GitHub repozitáře, počet hvězdiček i aktivitu commit feedu a pak jsem níže uvedené projekty porovnal podle složitosti nastavení, podpory JavaScriptu, známek údržby, způsobu exportu a toho, pro koho jsou nejvhodnější.
Rychlá odpověď
- Zvolte Scrapy, pokud chcete nejzralejší Python framework pro strukturovaný scraping ve velkém.
- Zvolte Crawlee, pokud váš tým pracuje v JavaScriptu nebo TypeScriptu a chce jednu sadu nástrojů pro HTTP i browser-based scraping.
- Zvolte Playwright nebo Puppeteer, pokud je web silně postavený na JavaScriptu a skutečná potřeba je automatizace prohlížeče.
- Zvolte Maxun, pokud chcete open-source, vizuální, self-hostovatelnou no-code vrstvu místo psaní scraperu od nuly.
- Zvolte Heritrix, Apache Nutch nebo Katana jen tehdy, pokud je váš úkol specializovaný: archivní crawling, distribuované procházení nebo bezpečnostní průzkum.
- Zvolte Thunderbit, pokud se vůbec nechcete pouštět do GitHubu a chcete data rychle do Sheets, Airtable, Notion, CSV nebo JSON.
Vyzkoušejte no-code scraper, než se zavážete ke kódové sadě nástrojů
Srovnání na první pohled
Počet hvězdiček na GitHubu a signály posledních commitů níže byly zkontrolovány na veřejných stránkách repozitářů a v commit feedech 6. srpna 2026.
| Projekt | Jazyk / model | Nastavení | Podpora JS | Nejlépe pro | GitHub hvězdičky | Signál posledního commitu |
|---|---|---|---|---|---|---|
| Scrapy | Python framework | Střední | Nativně ne | Velké crawlery, ecommerce, zpravodajství | 63,7k | 6. srpna 2026 |
| Crawlee | Node.js / TypeScript framework | Střední | Ano | Jedna sada nástrojů pro statické i dynamické scrapingy | 25,2k | 6. srpna 2026 |
| Maxun | Open-source no-code platforma | Střední nasazení, snadné pro uživatele | Ano | Business uživatelé, kteří chtějí open-source kontrolu | 17,1k | 5. srpna 2026 |
| MechanicalSoup | Python knihovna | Snadné | Ne | Formuláře, session a jednoduché statické weby | 4,9k | 4. srpna 2026 |
| Node Crawler | Node.js crawler | Střední | Ne | Rychlé statické crawlingy a agregace feedů | 6,8k | 18. června 2026 |
| Heritrix | Java archivní crawler | Pokročilé | Ne | Archivace webu a záchyt ve velkém měřítku | 3,3k | 5. srpna 2026 |
| Apache Nutch | Java distribuovaný crawler | Pokročilé | Ne | Crawling ve stylu vyhledávače a big data sběr | 3,3k | 5. srpna 2026 |
| Selenium | Automatizace prohlížeče ve více jazycích | Střední | Ano | Toky s mnoha interakcemi a věrnost chování prohlížeče | 34,3k | 6. srpna 2026 |
| Playwright | Automatizace prohlížeče ve více jazycích | Střední | Ano | Moderní dynamické weby a robustní skripty | 94,1k | 6. srpna 2026 |
| Puppeteer | Automatizace prohlížeče v Node.js | Střední | Ano | Automatizace a scraping primárně pro Chrome | 95,4k | 6. srpna 2026 |
| Scrapling | Python stealth scraping toolkit | Střední | Ano | Scraping s důrazem na ochranu proti botům | 72,8k | 30. července 2026 |
| Katana | Go crawler / CLI | Střední | Volitelně headless | Bezpečnostní crawling a objevování URL | 17,3k | 5. srpna 2026 |
| Colly | Go framework | Střední | Ne | Vysoce výkonný statický scraping | 25,4k | 18. června 2026 |
| WebMagic | Java framework | Střední | Bez nativního JS | Obecné Java scraping pipeline | 11,7k | 20. prosince 2025 |
| Nokogiri | Ruby parser | Snadné | Ne | Ruby aplikace a vlastní parsovací workflow | 6,3k | 3. srpna 2026 |
| Thunderbit | AI no-code Chrome extension | Plug and play | Ano | Netekničtí uživatelé, kteří chtějí rychle použitelná data | N/A | Spravovaný produkt, průběžně aktualizován |
Než si vybereš GitHub projekt, zvaž, jestli vůbec chceš kódový workflow
Thunderbit není GitHub projekt, a přesně proto do tohoto průvodce patří. Spousta lidí, kteří hledají „best web scraping GitHub projects“, ve skutečnosti nechce udržovat crawler stack. Chtějí dnes získat strukturovaná data z živého webu.
Thunderbit je nejjednodušší cesta od průzkumu scrapingových řešení zaměřených na kód k provozu připravenému pro byznys:
- Nejlepší pro: sales prospecting, sledování ecommerce, sběr dat o realitách, recruiting research a browser-first provozní práci.
- Čím vyniká: AI návrhy polí, obohacování podstránek, práce s dynamickými stránkami a export do Sheets, Airtable, Notion, CSV a JSON bez psaní scraping logiky.
- Na co si dát pozor: pokud buduješ dlouhodobou interní crawl platformu s vlastní infrastrukturou, open-source framework ti stále dá větší kontrolu.
Pokud chceš vidět no-code cestu dřív, než se rozhodneš fungovat čistě v GitHubu, je tenhle aktuální průvodce Thunderbit nejrychlejší test reality:
Vyzkoušejte Thunderbit AI Web Scraper zdarma
Jak jsem tyto GitHub scraping projekty hodnotil
Ne všechny GitHub scraping projekty jsou mezi sebou přímo srovnatelné. Některé jsou plnohodnotné frameworky. Některé jsou knihovny pro automatizaci prohlížeče. Některé jsou parsovací nástroje. A některé jsou úzce specializované crawlery pro archivy nebo bezpečnostní týmy.
Aby byl seznam užitečný, upřednostnil jsem projekty, které pořád splňují čtyři praktická kritéria:
- Stále za nimi stojí reálný trh.
Samotný vysoký počet hvězdiček nestačí, ale nízká adopce plus zastaralá údržba je obvykle špatné znamení. - Je vidět, že se na projektu pořád něco děje.
Pro tenhle refresh jsem 6. srpna 2026 znovu zkontroloval veřejnou aktivitu commit feedu místo toho, abych slepě věřil starým souhrnným číslům. - Řeší skutečný scraping úkol.
Vyřadil jsem sice chytré, ale okrajové repozitáře, které příliš neodpovídají reálným business nebo research workflow. - Jsou natolik odlišné, že stojí za shortlist.
Cílem není naházet sem 50 repozitářů. Cílem je pomoct ti vybrat mezi frameworky, browser stacky, open-source no-code nástroji a specializovanými crawlery.
Porovnávací kritéria jsou stejná, která v praxi obvykle rozhodují o úspěchu nebo neúspěchu:
- Složitost nastavení: jak rychle se nový uživatel dostane k funkčnímu scrapu.
- Podpora JavaScriptu: jestli projekt zvládne moderní weby renderované na klientovi.
- Zdraví projektu: jestli repozitář pořád působí důvěryhodně a živě.
- Práce s daty: jestli projekt dává strukturovaný výstup, nebo nechává víc práce na tobě.
- Vhodnost pro publikum: jestli je projekt opravdu pro začátečníky, datové inženýry, bezpečnostní týmy nebo netechnické uživatele.
Složitost nastavení: jak rychle můžete začít?
Tahle kategorizace nastavení pořád dává smysl, ale v roce 2026 je praktičtější jednoduché členění:
- Plug and play: Thunderbit pro business uživatele; MechanicalSoup nebo Nokogiri pro lehké skripty psané od kódu.
- Střední: Scrapy, Crawlee, Maxun, Selenium, Playwright, Puppeteer, Colly, Katana, Scrapling, WebMagic a Node Crawler vyžadují určitou míru programování, práci v CLI nebo nasazení.
- Pokročilé: Heritrix a Apache Nutch dávají smysl jen tehdy, když skutečně potřebuješ archivní nebo distribuované crawling řešený v Javě.
Maxun si tady zaslouží zvláštní zmínku, protože stojí někde mezi. Samotná platforma vyžaduje nasazení, ale uživatelský workflow je výrazně jednodušší než přímá práce se Scrapy nebo Playwrightem.
Podpora dynamického obsahu: které projekty zvládnou moderní web?
Moderní weby jsou plné Reactu, Vue, infinite scrollu, API volání na pozadí a flow s nutností přihlášení. Právě tady se láme rozdíl mezi „dostal jsem HTML“ a „dostal jsem skutečně ta data, která jsem potřeboval“.
Projekty v tomhle seznamu spadají do tří skupin:
- Plná automatizace prohlížeče: Selenium, Playwright a Puppeteer plně spouštějí JavaScript a pořád patří mezi nejspolehlivější volby pro weby s mnoha interakcemi.
- Hybridní nebo wrapper podpora: Crawlee umí přepínat mezi lehkým HTTP crawlingem a scrapingem přes prohlížeč. Scrapling přidává stealth nástroje pro náročnější cíle. Maxun používá browser-backed přístup za vizuálním rozhraním.
- Ve výchozím stavu jen statické HTML: Scrapy, MechanicalSoup, Node Crawler, Colly, WebMagic, Nokogiri, Heritrix a Apache Nutch samy o sobě neřeší moderní renderování.
Pokud je tvoje největší otázka „zvládne tenhle stack stránky s JavaScriptem, aniž bych musel ručně skládat každý krok v prohlížeči?“, je tenhle aktuální návod na scraping v Playwrightu nejlepší průběžný test reality:
Zdraví projektu: které repozitáře vypadají v roce 2026 stále důvěryhodně?
Verze tohohle článku z roku 2025 se opírala hlavně o počet hvězdiček a několik starších poznámek k aktualizacím. To už dnes nestačí. Zkontroloval jsem jak aktuální počet hvězdiček, tak nedávné signály commitů k 6. srpnu 2026.
Zdravé rozdělení vypadá takto:
- Jasně aktivní právě teď: Scrapy, Crawlee, Maxun, MechanicalSoup, Heritrix, Apache Nutch, Selenium, Playwright, Puppeteer, Scrapling, Katana a Nokogiri všechny zveřejnily commity v posledních dvou týdnech před kontrolou.
- Živé, ale pomaleji se vyvíjejí: Colly a Node Crawler oba naposledy commitovaly 18. června 2026. Pořád vypadají použitelné, ale aktualizují se spíš v občasných vlnách než v týdenním tempu Playwrightu nebo Crawlee.
- Vyžadují větší opatrnost: WebMagic je na tomhle seznamu největší slabší místo. Poslední veřejný commit signál, který jsem našel, byl 20. prosince 2025, takže bych ho bral spíš jako stabilní než aktivně se vyvíjející.
To je důležité, protože styl údržby by měl ovlivnit tvůj shortlist:
- Pokud chceš bezpečný výchozí bod pro nový engineering projekt, upřednostni zjevně aktivnější repozitáře.
- Pokud je nástroj jednoduchý a use case úzký, pomalejší vývoj nevadí.
- Pokud je projekt specializovaný, posuzuj nejdřív jeho vhodnost, ne to, jestli vydává nové verze každý týden.
15 nejlepších GitHub projektů pro web scraping v roce 2026
Frameworky pro velké nebo obecné scraping úlohy
1. Scrapy
Scrapy je pořád výchozí Python odpověď, když je úkol větší než jen krátký skript. Pokud chceš spiders, pipelines, middleware, throttling, retry a zralý ekosystém, zůstává na tomhle seznamu nejbezpečnější open-source sázkou.
- Nastavení: Střední
- Nejlepší pro: ecommerce katalogy, scraping adresářů, crawling zpráv a dlouhodobě žijící interní scraping systémy
- Podpora JS: Bez nativního renderování; v případě potřeby kombinujte s Playwrightem nebo Selenium
- Proč zvolit: zralá architektura, silná dokumentace a jeden z nejlepších poměrů výkonu ke komunitě v open-source scrappingu
- Na co si dát pozor: pokud jsi nikdy nepracoval v crawler frameworku, křivka učení je reálná
Pokud chceš před závazkem zjistit, jestli ti cesta přes Scrapy sedí, je tenhle aktuální průvodce pro začátečníky pořád užitečný:
2. Crawlee
Crawlee se stal nejatraktivnější volbou frameworku pro JavaScript nebo TypeScript týmy, které chtějí jeden projekt schopný pokrýt lehký crawling i scraping přes prohlížeč. Skutečnou výhodou je možnost přepínat mezi HTTP-first a Playwright/Puppeteer workflow.
- Nastavení: Střední
- Nejlepší pro: JS a TS týmy, hybridní statické a dynamické cíle a interní nástroje s velkým podílem automatizace
- Podpora JS: Ano
- Proč zvolit: flexibilní runtime model, anti-blocking helpery a lepší ergonomie browser story než u starších crawler-only stacků
- Na co si dát pozor: největší smysl dává, pokud je váš tým už pohodlný v Node.js
3. Colly
Colly je pořád jedna z nejčistších a nejvýkonnějších možností pro Go týmy, které nepotřebují nativní renderování v prohlížeči. Je rychlý, elegantní a praktický tam, kde je úzkým místem objem, ne složitost rozhraní.
- Nastavení: Střední
- Nejlepší pro: Go vývojáře budující rychlé statické crawlery
- Podpora JS: Bez nativního renderování
- Proč zvolit: souběžnost, rate limiting a příjemné API pro vysoce průchodné úlohy
- Na co si dát pozor: není to správná volba, pokud je skutečnou potřebou automatizace prohlížeče
4. WebMagic
WebMagic zůstává Java obdobou pro týmy, které mají rády model Scrapy, ale chtějí zůstat v JVM ekosystému. I dnes dává smysl pro Java prostředí, i když kolem něj není taková pozornost jako u Python nebo Node variant.
- Nastavení: Střední
- Nejlepší pro: Java scraping pipeline
- Podpora JS: Bez nativního renderování
- Proč zvolit: schedulery, pipeline a přehledná struktura frameworku
- Na co si dát pozor: ekosystém je tišší než u větších Python a Node možností a poslední veřejný commit signál, který jsem našel, je z 20. prosince 2025, takže jej ber spíš jako stabilní než aktivně se vyvíjející
5. Nokogiri
Nokogiri není crawler framework. Je to parser, po kterém Ruby vývojáři sahají, když potřebují čisté zpracování HTML nebo XML v rámci vlastního skriptu nebo aplikačního workflow.
- Nastavení: Snadné
- Nejlepší pro: Ruby a Rails aplikace, které potřebují parsování, ne kompletní crawler framework
- Podpora JS: Ne
- Proč zvolit: rychlé, stabilní a bezpečné parsování
- Na co si dát pozor: HTTP, session nebo browser vrstvu si musíš zajistit sám
Lehké statické projekty a projekty přátelské pro začátečníky
6. Maxun
Maxun je open-source odpověď pro lidi, kterým se líbí no-code scraping, ale zároveň chtějí self-hosting a kontrolu na úrovni GitHubu. Pro netechnické uživatele je mnohem přístupnější než čistý framework, ale pořád jde o skutečný open-source projekt, ne uzavřený SaaS.
- Nastavení: Střední při nasazení, po nastavení jednodušší pro koncové uživatele
- Nejlepší pro: týmy, které chtějí vizuální UI s open-source kontrolou
- Podpora JS: Ano
- Proč zvolit: point-and-click extrakce, vícekrokové workflow a lepší přístupnost než psaní kódu od nuly
- Na co si dát pozor: krok nasazení je pořád těžší než u plně spravovaného rozšíření do prohlížeče
7. MechanicalSoup
MechanicalSoup si své místo zaslouží, protože ne každý scraping potřebuje headless browser. Pokud je skutečným problémem práce se session, odesílání formulářů nebo procházení statického flow za přihlášením, zůstává příjemně malý a srozumitelný.
- Nastavení: Snadné
- Nejlepší pro: jednoduché formuláře, statické stránky chráněné přihlášením a rychlé Python automatizační skripty
- Podpora JS: Ne
- Proč zvolit: nízká míra tření, čitelný kód a šetrný vstup pro Python uživatele
- Na co si dát pozor: na webech s náročným JavaScriptem přestává rychle stačit
8. Node Crawler
Node Crawler má pořád své místo, pokud je cílem statické HTML a hlavní důraz kladeš na souběžnost, queueing a parsování ve stylu Cheerio. Pro nový browser-heavy projekt bych si ho nevybral, ale pro feed-style sběr a statické weby může pořád fungovat dobře.
- Nastavení: Střední
- Nejlepší pro: vysokorychlostní statické crawlingy a agregaci
- Podpora JS: Ne
- Proč zvolit: řízení souběžnosti a známý jQuery-like parsovací workflow
- Na co si dát pozor: poslední veřejný commit signál, který jsem našel, je z 18. června 2026 a mezi aktualizacemi jsou dlouhé mezery, takže bych na něm nezačínal nový dlouhodobý stack pro dynamické weby
Projekty pro dynamické weby a automatizaci prohlížeče
9. Selenium
Selenium je starší než Playwright, ale pořád má význam tam, kde přesnost chování prohlížeče a věrnost interakcí převáží nad elegancí. Je pořád důležité hlavně tam, kde se scraping překrývá s QA, regresní automatizací nebo weby vyžadujícími hodně doslovné chování prohlížeče.
- Nastavení: Střední
- Nejlepší pro: toky s mnoha interakcemi, legacy automatizace prohlížeče a týmy, které Selenium už používají na testování
- Podpora JS: Ano
- Proč zvolit: široká podpora prohlížečů, obrovský ekosystém a dlouhodobá zralost
- Na co si dát pozor: novější automatizační stacky často působí čistěji a rychleji pro nové scraping projekty
10. Playwright
Playwright je moje výchozí moderní doporučení pro developerské týmy, které potřebují scraping dynamických stránek. Kombinace podpory více prohlížečů, silného čekání na prvky a čistého API z něj dělá nejjednodušší browser-automation projekt na tomhle seznamu pro obecné doporučení.
- Nastavení: Střední
- Nejlepší pro: moderní webové aplikace, přihlášené flow a JavaScriptově náročné cíle
- Podpora JS: Ano
- Proč zvolit: ovládání napříč prohlížeči, robustní automatizační primitiva a aktivní údržba
- Na co si dát pozor: selektory, browser infrastrukturu, retry logiku i kvalitu výstupu si pořád spravujete sami
11. Puppeteer
Puppeteer je pořád klasika zaměřená hlavně na Chrome. Pokud je váš tým už v Node.js a míří převážně na workflow kompatibilní s Chromium, zůstává to praktická a dobře pochopitelná volba.
- Nastavení: Střední
- Nejlepší pro: automatizaci orientovanou na Chrome, screenshoty, PDF a extrakci dynamického obsahu
- Podpora JS: Ano
- Proč zvolit: bohaté ovládání prohlížeče a obrovské množství komunitních příkladů
- Na co si dát pozor: Playwright je dnes silnější výchozí volba, pokud chceš širší podporu prohlížečů nebo modernější cross-browser přístup
12. Scrapling
Scrapling je v téhle skupině nejvíc specializovaný moderní nováček. Je pro lidi, kteří už vědí, že renderování v prohlížeči není jediný problém. Potřebují také stealth, práci s proxy a silnější anti-bot přístup.
- Nastavení: Střední
- Nejlepší pro: stealth scraping, cíle citlivé na boty a Python-first práci s dynamickými weby
- Podpora JS: Ano
- Proč zvolit: aktivní vývoj a ostřejší zaměření na třecí plochy scrapingu, které jednodušší frameworky přehlížejí
- Na co si dát pozor: pro obyčejné statické weby je to zbytečně silné řešení a pro začátečníky méně přívětivé než MechanicalSoup nebo Scrapy
Specializované crawlery pro výzkum, bezpečnost a infrastrukturu
13. Heritrix
Heritrix není scraper na porovnávání produktů. Je to archivní crawler vytvořený pro instituce, které řeší dlouhodobé uchování webu a standardizovaný záchyt obsahu.
- Nastavení: Pokročilé
- Nejlepší pro: archivy, knihovny a velké workflow pro zachování obsahu
- Podpora JS: Ne
- Proč zvolit: původ v Internet Archive a archivní workflow orientované na WARC
- Na co si dát pozor: špatná volba pro cílený scraping seznamů nebo cen
14. Apache Nutch
Apache Nutch pořád dává smysl pro týmy, které uvažují v pojmech distribuovaného crawlingu, indexování nebo sběru dat ve stylu vyhledávače, spíš než jednorázového business scrapingu.
- Nastavení: Pokročilé
- Nejlepší pro: distribuovaný crawling, výzkumné datasety a sběr ve stylu vyhledávače
- Podpora JS: Ne
- Proč zvolit: plugin model a enterprise pocit typický pro Apache ekosystém
- Na co si dát pozor: pro většinu úloh orientovaných na tabulky nebo browser-first workflow je příliš těžký
15. Katana
Katana sem patří proto, že bezpečnostní crawling je vlastní use case. Pokud je úkolem průzkum, objevování endpointů nebo rychlé zmapování struktury cíle, je Katana mnohem lepší volba než obecný scraping framework.
- Nastavení: Střední
- Nejlepší pro: bezpečnostní průzkum, objevování odkazů a generování inventáře URL
- Podpora JS: Volitelný headless režim
- Proč zvolit: rychlost, souběžnost a crawler model zaměřený na bezpečnost
- Na co si dát pozor: není navržený jako uhlazený stack pro extrakci byznysových dat
Můj shortlist podle typu týmu
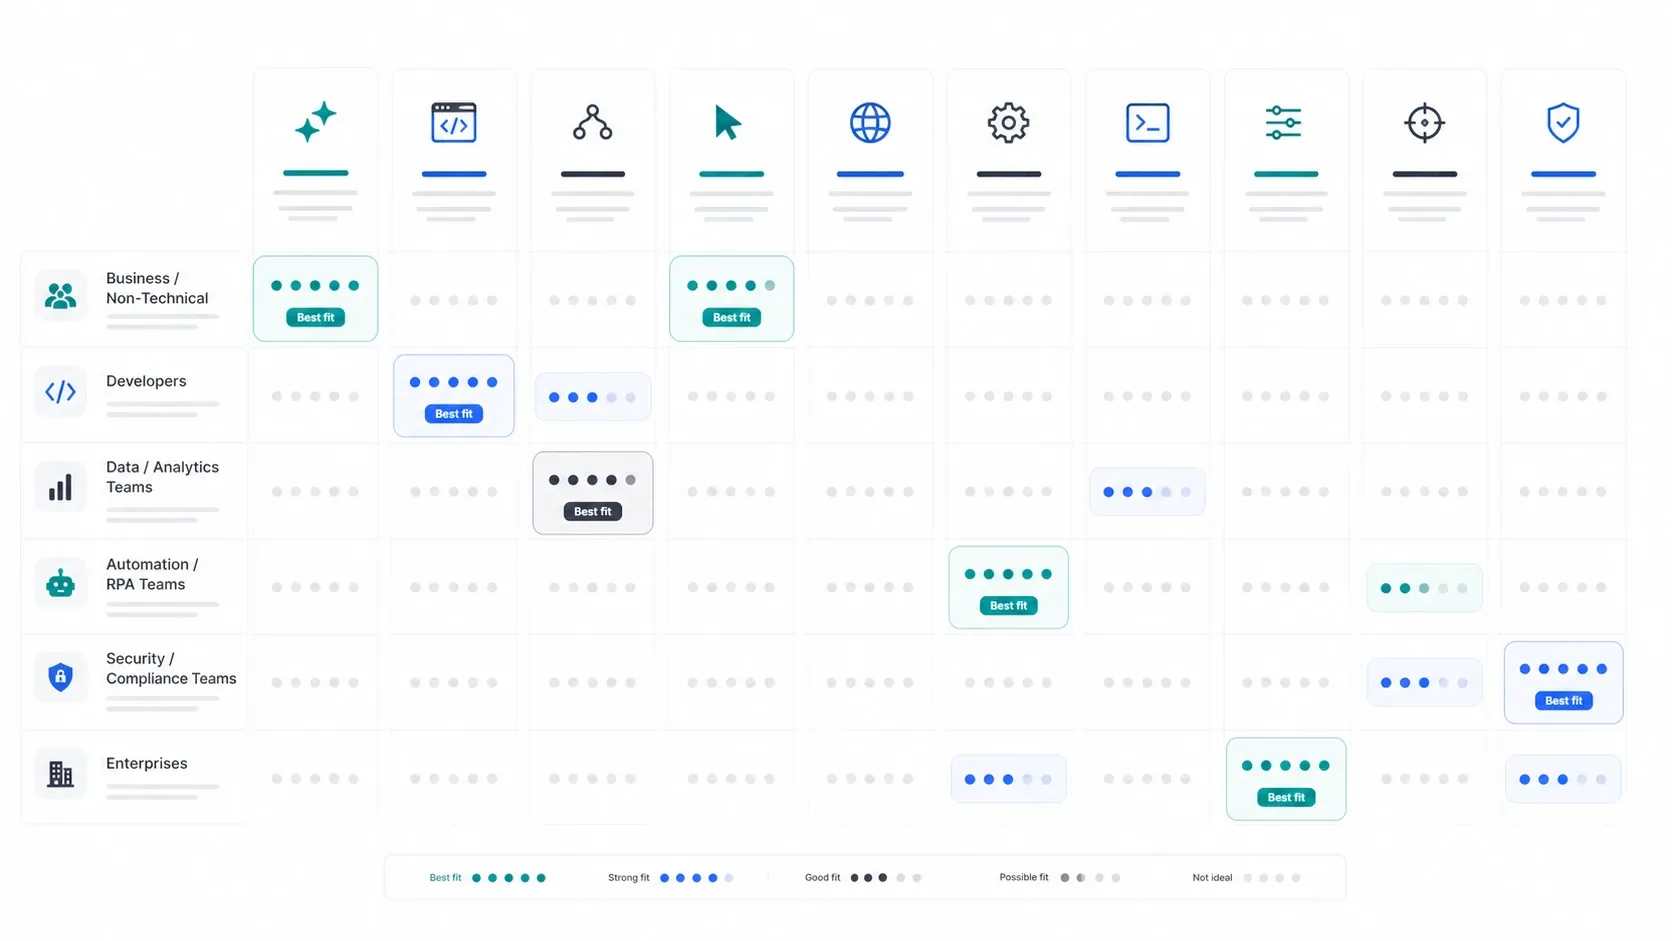
- Python vývojáři: začněte se Scrapy pro frameworky, s MechanicalSoup pro menší statické flow a s Scraplingem, pokud je součástí problému už od začátku stealth nebo anti-bot tření.
- JavaScript nebo TypeScript týmy: začněte s Crawlee jako frameworkem, s Playwrightem pro automatizaci prohlížeče a s Puppeteerem, pokud vám stačí Chrome-first workflow.
- Go týmy: Colly pro scraping, Katana pro bezpečnostní crawling zaměřený na objevování.
- Java týmy: WebMagic pro obecné crawlingy, Heritrix pro archivní záchyt, Apache Nutch pro distribuované crawlingy ve stylu vyhledávače.
- Netechnické týmy: Maxun, pokud chcete open-source self-hosting, nebo Thunderbit, pokud chcete spravovaný no-code workflow, který se rychleji dostane k použitelnému výstupu.
Který projekt by si měla většina lidí vybrat jako první?
Praktická odpověď zní:
- Pokud chcete postavit a vlastnit scraper, začněte se Scrapy nebo Crawlee.
- Pokud potřebujete ovládat skutečný browser, začněte s Playwrightem.
- Pokud chcete vizuální open-source vrstvu, začněte s Maxun.
- Pokud potřebujete specializované archivní nebo bezpečnostní crawling, zvolte Heritrix, Nutch nebo Katana jen tehdy, když to váš use case jasně vyžaduje.
- Pokud chcete vynechat kód a získat data hned, netlačte se nejdřív do GitHubu. Použijte Thunderbit.
Závěrečné shrnutí
Nejlepší GitHub projekt pro web scraping v roce 2026 nezávisí ani tak na surovém počtu hvězdiček, jako spíš na tom, jakou zátěž jste ochotni si vzít na sebe. Scrapy zůstává nejbezpečnější výchozí volbou mezi Python frameworky. Crawlee je nejlepší moderní volba pro JavaScript. Playwright je nejsilnější výchozí volba pro automatizaci prohlížeče. Maxun je nejzajímavější open-source no-code cesta. Heritrix, Apache Nutch a Katana jsou specialisté, kteří jsou skvělí jen tehdy, když je úloha skutečně specializovaná.
Důležité je neplést si „nejvýkonnější“ s „nejvhodnější“. Pokud váš tým potřebuje jen čistá data v tabulce, GitHub možná vůbec není správný začátek.
Vyhněte se údržbové režii a začněte scrapovat rychleji Get Started Free



