
Google denně zpracuje víc než 8,5 miliardy vyhledávání — některé odhady mluví dokonce o 14 miliardách — a tohle číslo pořád roste. Všechna tahle search data jsou doslova zlatý důl pro SEO týmy, sales ops, e-commerce analytiky a čím dál častěji i pro AI agenty, kteří potřebují ověřitelné důkazy z webu v reálném čase. Háček? Vybrat v roce 2026 SERP API je míň o tom najít „nejlepší nástroj“ a víc o tom rozmotat změť ceníků, kreditních systémů a mlhavých slibů o „strukturovaném JSONu“.
Posledních několik týdnů jsem strávil podrobným testováním osmi poskytovatelů SERP API — měřil jsem rychlost odpovědí, přepočítával ceny napříč záludnými modely účtování a kontroloval, které SERP prvky každý z nich opravdu převádí do strukturovaných polí. Cíl byl jednoduchý: dát dohromady poctivé srovnání typu jablka s jablky, které jinde nenajdete. Podíváme se na rychlost, skutečné náklady při škálování, rozsah parsování, připravenost pro AI agenty i produkční spolehlivost. Pokud už vás unavuje přístup „porovnáváte ceníky, ne skutečné výdaje“ (to je doslovný citát z Reddit vlákna, které jsem našel), jste tady správně.
Proč v roce 2026 potřebujete SERP API (a proč je tak těžké vybrat to správné)
SERP API je hostovaná služba, která pošle dotaz do vyhledávače a vrátí stránku s výsledky ve strojově čitelné podobě — obvykle jako JSON. Místo toho, abyste si sami řešili rotaci proxy, CAPTCHA, renderování v prohlížeči a parsování, zavoláte endpoint a dostanete zpět strukturovaná data. Jednoduchý koncept, ale dost složitý trh.
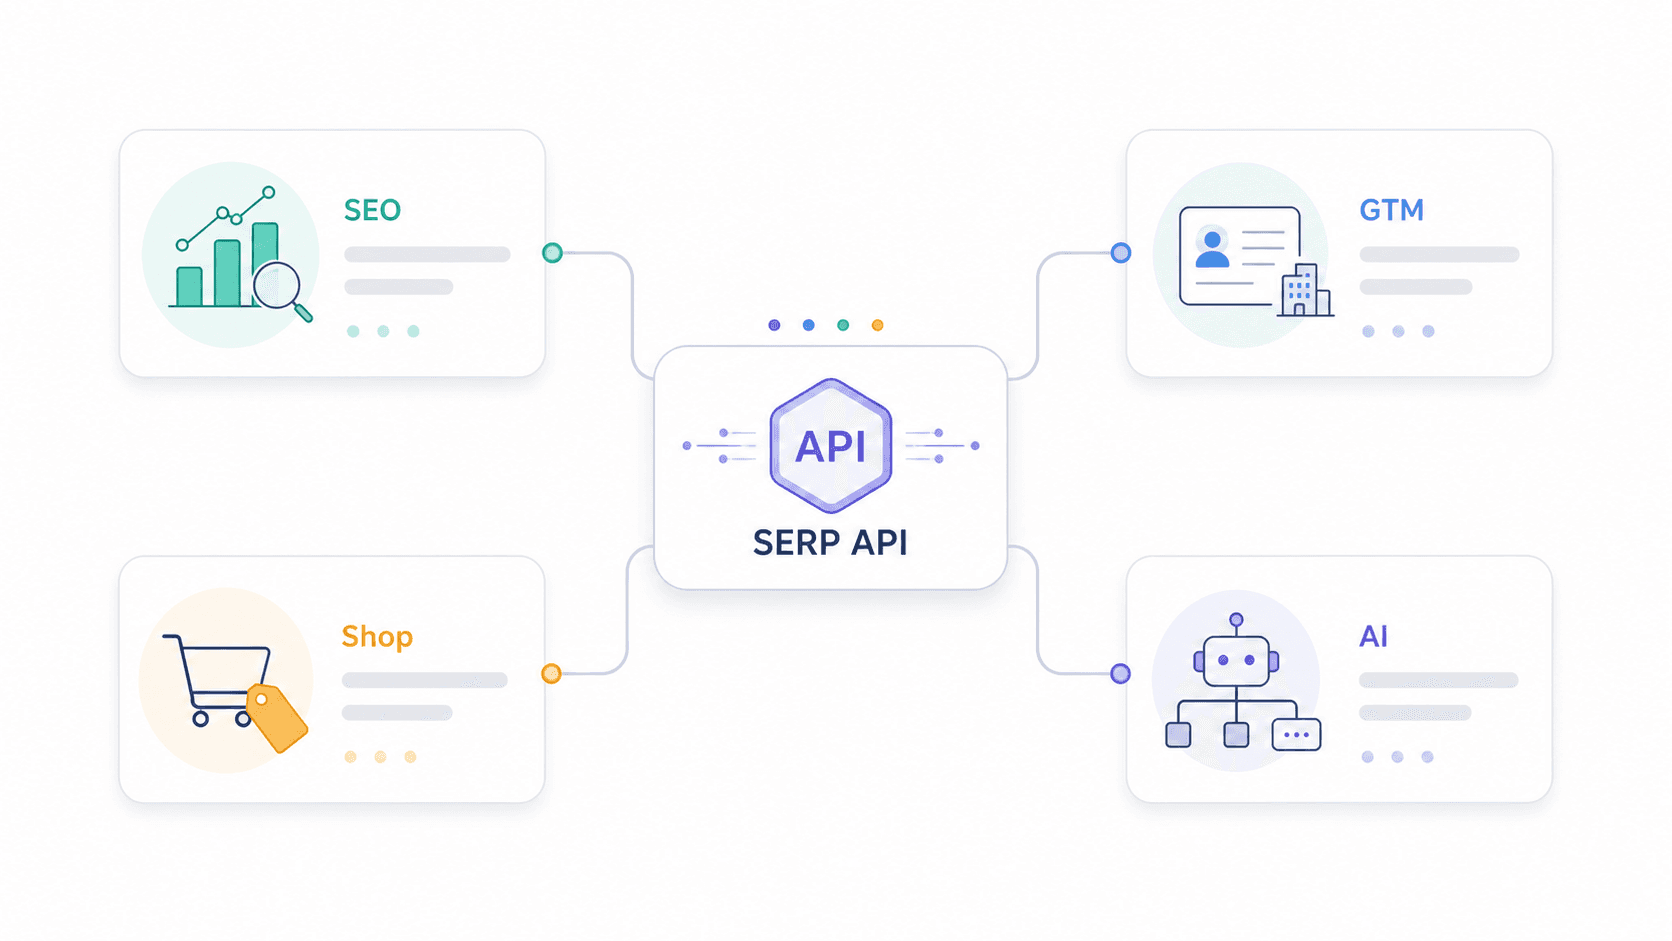
Použití už dávno přesahuje klasické sledování pozic:
- SEO týmy potřebují pozice, vlastnictví snippetů, otázky v People Also Ask a viditelnost konkurence.
- Sales a GTM týmy používají SERP k objevování firem, recenzních webů, katalogů a nákupních signálů.
- E-commerce týmy sledují Google Shopping, placené reklamy a ceny konkurence.
- AI vývojáři posílají SERP data do LLM agentů, RAG pipeline a workflow nástrojů jako n8n a LangChain.
Podle odhadů trhu s web scrapingem má tenhle segment do roku 2031 dosáhnout 2,23 miliardy USD při růstu zhruba 13,78 % CAGR. SERP API z toho koláče berou významný díl.
A tady je jádro frustrace: každý provider tvrdí, že nabízí „strukturovaný JSON“, ale ve skutečnosti se dramaticky liší v tom, které SERP elementy umí parsovat — PAA, knowledge panely, local pack, shopping reklamy, featured snippets a podobně. Stejně chaotické je i nacenění. Někdo účtuje za vyhledávání, někdo za kredit, někdo za výsledek a někdo má různé sazby podle rychlosti nebo geolokace. Jeden uživatel na Redditu to vystihl přesně: „SerpApi účtuje za úspěšné hledání, ScraperAPI to balí do kreditů a Serperdev vypadá levně, dokud nepřepočítáte kredity na skutečnou zátěž.“
Tenhle článek vyplňuje mezery, které jsem jinde nenašel: tabulku parsování ukazující, co každé API opravdu vrací, normalizované ceny pro 1K/10K/100K dotazů, vhodnost pro AI agenty i data o připravenosti do produkce.
Jak jsme testovali: kritéria pro výběr nejlepšího SERP API
Každého providera jsem hodnotil napříč osmi dimenzemi, které přímo odpovídají tomu, co je pro produkční provoz skutečně důležité. Většina srovnávacích článků pokrývá dvě nebo tři z nich jen hodně povrchně. Chtěl jsem všech osm — a ideálně i s důkazy.
Rychlost a doba odezvy. Vycházel jsem z externích benchmarků — hlavně z porovnání od HasData — a z dokumentace jednotlivých providerů. Rychlost je zásadní, když stavíte dashboardy v reálném čase nebo AI agenty, kteří si nemůžou dovolit čekat 30 sekund na odpověď.
Cena při škálování (1K, 10K, 100K dotazů). Přepočítal jsem cenu každého providera na náklad za 1 000 úspěšných dotazů. To je jediný férový způsob, jak porovnat kreditní modely, předplatné i pay-as-you-go.
Parsované SERP prvky (nejen organické výsledky). Kontroloval jsem dokumentaci i ukázkové odpovědi, abych ověřil, které SERP elementy API vrací jako strukturovaná pole — ne jen jako surové HTML.
Volný tarif a dostupnost pay-as-you-go. Nízká bariéra pro vyzkoušení je důležitá. Pokud si provider nemůžete otestovat na reálné zátěži, než do něj pošlete stovky dolarů, je to varovný signál.
Integrace pro AI a automatizaci. V roce 2026 potřebuje víc týmů posílat SERP data do AI agentů než do klasických dashboardů. Důležitá je stabilita schématu, čistý výstup a převod do Markdownu pro downstream LLM.
Podpora více vyhledávačů. Většina článků se soustředí jen na Google. Já jsem ověřil, kteří provideri podporují Bing, Yandex, DuckDuckGo, Baidu a další.
Rate limity a připravenost do produkce. Žádný konkurenční článek systematicky neporovnává rate limity, retry politiku ani SLA. Přitom pro týmy, které škálují na tisíce dotazů denně, je to zásadní.
Přátelskost pro vývojáře. Kvalita dokumentace, dostupnost SDK a čas do prvního výsledku.
1. Thunderbit
Thunderbit přistupuje k SERP API úplně jinak než tradiční hráči. Místo pevných endpointů s předem danými poli nabízí Extract API, kde si sami definujete JSON Schema — a AI vytáhne přesně ta data, která určíte, z jakékoli stránky s výsledky vyhledávání. Distill API zase převádí libovolnou URL do čistého Markdownu připraveného pro LLM.
To znamená, že Thunderbit funguje na Googlu, Bingu, Yandexu, DuckDuckGo nebo jakémkoli jiném vyhledávači — AI si stránku pokaždé načte znovu, místo aby se spoléhala na natvrdo napsané selektory. Layouty SERP se navíc mění pořád. Nemusíte čekat, až provider aktualizuje parser.
Klíčové funkce
- Extract API: Definujete vlastní JSON Schema (organické výsledky, otázky z PAA, firmy v local packu, produkty v shoppingu — cokoli potřebujete) a dostanete přesně tahle pole jako strukturovaná data.
- Distill API: Převádí libovolnou SERP stránku do čistého Markdownu — ideální pro RAG pipeline a sumarizaci pomocí LLM.
- Více vyhledávačů nativně: Funguje na jakékoli přístupné vyhledávací stránce, ne jen na Googlu.
- Dávkové zpracování: Paralelní zpracování více URL.
- Vestavěná anti-bot ochrana: CAPTCHA, JS renderování i rotace proxy jsou součástí.
- Rate limity podle tarifu: Free (600 jednotek jednorázově, 2 souběžné), Starter (60 000 jednotek/měsíc, 30 souběžných), Pro (600 000 jednotek/měsíc, 50 souběžných).
Cena
Kreditní model. Distill stojí 1 kredit za stránku; Extract 20 kreditů za stránku. K dispozici jsou i free kredity na testování. Při přepočtu na roční plán může být mezní cena Distillu jen kolem ~0,80 USD za 1K stránek, zatímco Extract vychází asi na ~16 USD za 1K stránek při plném využití. Hodnota Extractu je v tom, že dostanete přesně takové schema, jaké potřebuje váš downstream systém — bez dalšího postprocessingu.
Aktuální balíčky najdete na Thunderbit Pricing.
Vyzkoušet Thunderbit pro AI extrakci SERP
Nejlepší pro
Workflow pro AI agenty, RAG pipeline, scraping napříč více vyhledávači, týmy, které potřebují flexibilní schema místo pevného výstupu, a každého, koho už nebaví čekat, až provider přidá podporu pro nový SERP prvek.
2. SerpApi
SerpApi je v tomhle prostoru veterán — funguje od roku 2016 a nabízí nejširší sadu endpointů specifických pro Google. Pokrývá Google Search, Maps, Shopping, Scholar, News, Jobs, Trends, Images, Videos a další.
Klíčové funkce
- Dedikované endpointy pro různé Google produkty s vyzrálým geo-targetingem až na úroveň města.
- Parsuje PAA, knowledge panely, local pack, reklamy, shopping výsledky, featured snippets, answer boxy i související vyhledávání jako strukturovaná pole.
- Dobře udržovaná dokumentace a klientské knihovny v několika jazycích.
Cena
250 bezplatných vyhledávání měsíčně. Starter plán: 25 USD/měsíc za 1 000 vyhledávání (efektivně 25 USD za 1K). Developer plán (označený jako „Most popular“): 75 USD/měsíc za 5 000 vyhledávání (~15 USD za 1K). Big Data: 275 USD/měsíc za 30 000 vyhledávání (~9,17 USD za 1K). Žádná jednoduchá pay-as-you-go varianta — jde o předplatné po balíčcích.
Rychlost a spolehlivost
Benchmark od HasData uvádí průměrně ~5,49 sekundy — ne nejrychlejší, ale stabilní. SerpApi na placených plánech uvádí SLA 99,95 % uptime a limity souběžných požadavků se liší podle tarifu.
Nejlepší pro
Týmy, které potřebují nejširší pokrytí Google produktů (Maps, Scholar, Shopping, Jobs) s vysokou přesností a stabilním schématem. Enterprise projekty s rozpočtem na prémiové ceny.
3. Serper
Serper je sázka na rychlost a cenu. Jde o novější službu zaměřenou na rychlé scrapování Google SERP za velmi konkurenceschopnou cenu a mezi komunitami n8n a LangChain si získala popularitu díky integracím pro AI agenty.
Klíčové funkce
- Čistý JSON výstup pro Google Search, News, Scholar, Images, Shopping, Videos, Places, Patents a Autocomplete.
- Minimální nastavení — výsledky můžete tahat během minuty.
- Dostatečně jednoduché na to, aby jej AI agent frameworky podporovaly nativně.
Cena
Při registraci 2 500 bezplatných dotazů. Vstupní cena kolem 0,001 USD za vyhledávání, při vyšším objemu klesá zhruba na ~0,00075 USD. Vhodné pro pay-as-you-go. Jedna poznámka: pokud požadujete víc než 10 výsledků na dotaz, může to stát 2 kredity (aktuální chování si ověřte v dashboardu).
Rychlost a spolehlivost
Patří mezi nejrychlejší v benchmarcích — HasData uvádí průměrně kolem 2,87 sekundy. Podpora je pouze přes e-mail a tým má poměrně nízký veřejný profil, což některé uživatele zneklidňuje. Při velmi vysoké konkurenci několik recenzí zmiňuje výhrady ke spolehlivosti. Pro většinu workloadů je ale v pohodě.
Nejlepší pro
Projekty citlivé na rozpočet, startupy a AI agent integrace, které potřebují rychlá a levná Google SERP data. Vysoce objemové rank trackery, kde je hlavní limit cena za dotaz.
4. Scrapingdog
Scrapingdog je na trhu už víc než 5 let a v nezávislých benchmarcích se opakovaně objevuje jako nejrychlejší. HasData naměřila ~1,25 sekundy průměrné odezvy se 100% úspěšností.
Klíčové funkce
- Google SERP API vrací organické výsledky, PAA, featured snippets, reklamy i lokální výsledky jako strukturovaný JSON.
- K dispozici je jak surové HTML, tak parsovaný JSON.
- Dokumentace ve více jazycích s ukázkami kódu pro většinu programovacích jazyků — začít trvá minuty, ne hodiny.
- 24/7 podpora.
Cena
200 bezplatných kreditů měsíčně. Placené tarify začínají kolem 40 USD měsíčně. Cena za jeden call začíná přibližně na 0,001 USD a při vysokém objemu dramaticky klesá — některá srovnání uvádějí sazby až na 0,000058 USD v nejvyšších tarifech.
Rychlost a spolehlivost
Ta čísla jsou fakt působivá. Pokud je váš workflow citlivý na latenci a děláte vysokobjemovou extrakci Google SERP se stabilním schématem, Scrapingdog je hodně těžké překonat.
Nejlepší pro
Vysoce objemové SEO nástroje a rank trackery, které potřebují nízkou latenci a nízkou cenu. Týmy budující produkční systémy, kde záleží na každé milisekundě odezvy API.
5. DataForSEO
DataForSEO není jen SERP API — je to celá sada API navržená pro firmy, které staví SEO produkty. Pokrývá SERP, klíčová slova, zpětné odkazy, business data, Google Ads, Trends a další.
Klíčové funkce
- Mimořádně komplexní parsování SERP prvků — organické výsledky, placené výsledky, local pack, knowledge graph, PAA, featured snippets, shopping, obrázky, videa, top stories a další.
- Dva režimy: Live (synchronní) pro dashboardy v reálném čase a Standard (asynchronní) pro dávkové workflow, kde úlohy zařazujete do fronty a výsledky stahujete později.
- Více vyhledávačů: Google, Bing, Yahoo, Baidu, Naver, Seznam a další.
Cena
Pay-as-you-go model, ale cena se liší podle endpointu, vyhledávače, zařízení, priority a režimu. SERP ceny se obvykle pohybují zhruba od 0,0006 do 0,002 USD za úlohu pro Google organic podle standard vs. live a nastavení priority. Dokumentace je hustá — počítejte s časem stráveným v cenové kalkulačce. DataForSEO Pricing.
Rychlost a spolehlivost
Standardní async režim může být pomalejší (~10 sekund), protože úlohy jdou do fronty. Live/high-speed režimy stojí víc, ale jsou vhodné pro dashboardy v reálném čase. Dlouhá historie, ověřená stabilita a enterprise podpora.
Nejlepší pro
SaaS firmy stavějící SEO platformy, rank tracking dashboardy a nástroje pro keyword research. Týmy, které si poradí s komplexní dokumentací a enterprise infrastrukturou.
6. Bright Data
Bright Data je enterprise těžká váha. Její SERP API je jen jeden z mnoha produktů — vedle proxy, datasetů, Web Unlockeru a scraping nástrojů. Hlavní přidaná hodnota je škála, spolehlivost a infrastruktura.
Klíčové funkce
- Samostatné endpointy pro Google Maps, Shopping a obecné vyhledávání — plus podpora více vyhledávačů přes proxy infrastrukturu pro Bing, Yahoo, Yandex a DuckDuckGo.
- Tvrdí 100% success rate díky vestavěné technologii pro obejití blokací.
- Silná stránka Bright Data: geo-targeting, souběžnost a unblocking v enterprise měřítku.
Cena
Orientace na enterprise. Veřejné ceny ukazují pay-as-you-go i předplatné; v mnoha srovnáních se uvádí vstupní závazek okolo 499 USD měsíčně. Cena za jeden call začíná přibližně na 0,005 USD, ale s objemem klesá. Bright Data Pricing. K dispozici je free tier (5 000 kreditů/měsíc, bez kreditní karty).
Rychlost a spolehlivost
Benchmarky často ukazují 2 až 5,58 sekundy. Důvod, proč Bright Data kupujete, není jen medián latence — ale enterprise SLA, dedikovaná podpora a infrastruktura, která zvládá miliony souběžných požadavků bez degradace. Dokumentace k rate limitům doporučuje postupné navyšování zátěže.
Nejlepší pro
Enterprise týmy sbírající miliony SERP měsíčně. Organizace, které potřebují Google Maps a lokální business data ve velkém. Týmy už využívající proxy produkty Bright Data.
7. ScraperAPI
ScraperAPI je obecné web scraping API, které zároveň nabízí strukturované endpointy pro Google SERP. Je to varianta „jeden nástroj na všechno“ — snadná integrace a proxy pool s více než 40 miliony IP adres.
Klíčové funkce
- Strukturované datové endpointy pro Google Search, Shopping, News a Jobs.
- Ochrana proti blokacím a CAPTCHA řešená pomocí strojového učení, včetně JavaScript renderování bez příplatku.
- Podpora geo-targetingu pro lokalizované výsledky.
Cena
7denní free trial s 5 000 kredity. Placené tarify začínají přibližně na 49 USD měsíčně. Háček: SERP call může spotřebovat jiné množství kreditů než běžný scraping, takže je vždy potřeba přepočítat cenu podle skutečně úspěšně doručených SERP dotazů. ScraperAPI Pricing.
Rychlost a spolehlivost
Tady je ta upřímná část: benchmark od HasData uvádí průměrně ~33,66 sekundy pro SERP dotazy. To je výrazně pomalejší než u specializovaných SERP API. Úspěšnost je vysoká (99,9 %), ale latence z toho dělá méně vhodnou volbu pro real-time aplikace. Lepší pro dávkové zpracování.
Nejlepší pro
Týmy, které potřebují obecné scraping řešení, kde je SERP jen doplněk. Projekty, kde je důležitější spolehlivost a jednoduché nasazení než rychlost. Vývojáři, kteří už ScraperAPI používají na jiné scraping úlohy a chtějí zjednodušit počet dodavatelů.
8. Apify
Apify není čisté SERP API. Je to platforma pro scraping a automatizaci postavená na „Actors“ — znovupoužitelných skriptech pro úlohy jako scrapování Google Search, extrakce z Maps nebo automatizace workflow. Je to něco jako marketplace, kde si vybereš (nebo vytvoříš) scraper přesně pro svou potřebu.
Klíčové funkce
- Marketplace předpřipravených Google SERP actorů s různou úrovní pokrytí funkcí.
- Vysoká míra přizpůsobení — můžeš stavět vlastní scraping workflow, řetězit actory a plánovat běhy.
- Výstup do JSON; možnost přes konfiguraci actoru parsovat konkrétní SERP prvky.
- Silné pro kombinaci SERP extrakce s dalšími scraping/automatizačními úlohami.
Cena
Free tier s měsíčními platformními kredity (cca 5 USD, zhruba 1 400 výsledků). Placené plány začínají přibližně na 29 USD měsíčně. Cena na úrovni actoru se liší — některé účtují za výsledek, jiné za compute unit. Třetí strany často uvádějí cenu kolem 0,003 USD za vyhledávání v malém objemu. Apify Pricing.
Rychlost a spolehlivost
HasData uvádí průměrně ~8,2 sekundy. Architektura založená na actorech přidává režii oproti dedikovaným SERP endpointům. Vhodnější pro plánované a dávkové workflow než pro dotazy v reálném čase.
Nejlepší pro
Týmy, které potřebují vlastní scraping a automatizaci nad rámec samotných SERP dat. Projekty kombinující SERP extrakci s dalšími web scraping úlohami. Vývojáře, kteří chtějí maximální flexibilitu místo předpřipravených endpointů.
Tabulka parsování SERP prvků: co jednotlivá API skutečně vracejí
Tohle je srovnání, které jsem jinde nenašel. Každý provider tvrdí, že nabízí „strukturovaný JSON“, ale reálně se dramaticky liší v tom, které SERP elementy parsuje jako prvotřídní pole. U každého jsem prošel dokumentaci i ukázkové odpovědi.
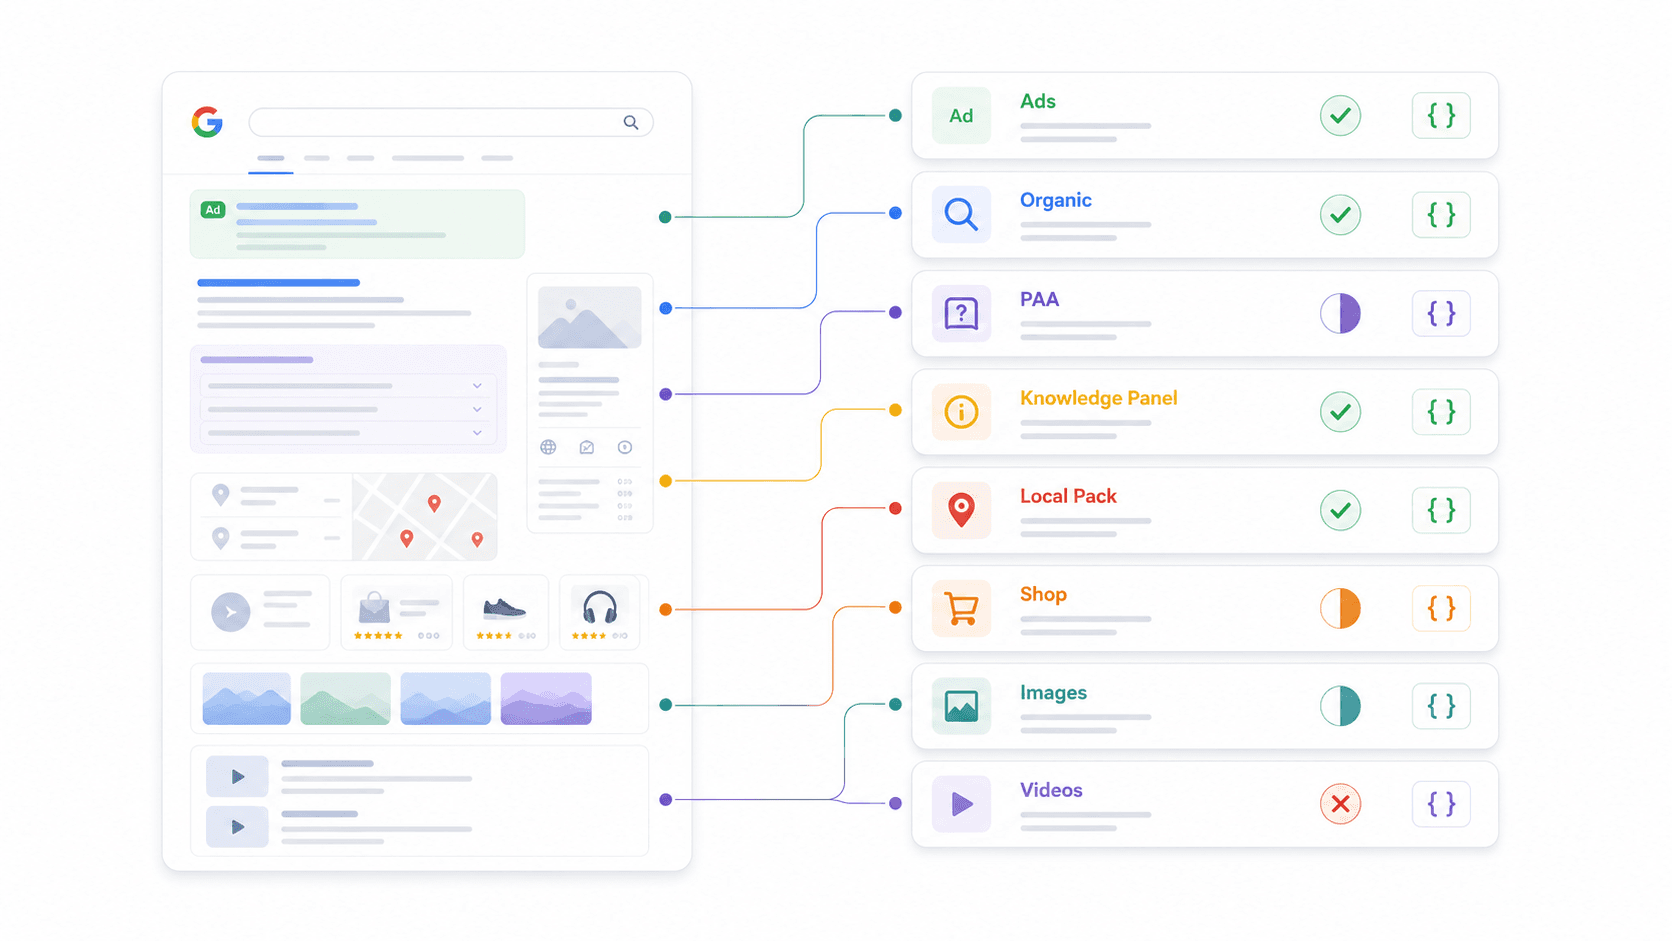
| SERP prvek | Thunderbit | SerpApi | Serper | Scrapingdog | DataForSEO | Bright Data | ScraperAPI | Apify |
|---|---|---|---|---|---|---|---|---|
| Organické výsledky | Vlastní schema | ✅ | ✅ | ✅ | ✅ | ✅ | ✅ | Závisí na actoru |
| People Also Ask | Vlastní schema | ✅ | ✅ | ✅ | ✅ | Částečně | Částečně | Závisí na actoru |
| Knowledge Panel | Vlastní schema | ✅ | Částečně | Částečně | ✅ | Částečně | Částečně | Závisí na actoru |
| Local Pack / Maps | Vlastní schema | ✅ | ✅ | Částečně | ✅ | ✅ | Částečně | Závisí na actoru |
| Shopping výsledky | Vlastní schema | ✅ | ✅ | Částečně | ✅ | ✅ | ✅ | Závisí na actoru |
| Featured Snippets | Vlastní schema | ✅ | Částečně | ✅ | ✅ | Částečně | Částečně | Závisí na actoru |
| Reklamy (nahoře/dole) | Vlastní schema | ✅ | Částečně | ✅ | ✅ | Částečně | Částečně | Závisí na actoru |
| Image Pack | Vlastní schema | ✅ | ✅ | ✅ | ✅ | Částečně | Částečně | Závisí na actoru |
| Video výsledky | Vlastní schema | ✅ | ✅ | Částečně | ✅ | Částečně | Částečně | Závisí na actoru |
Co u Thunderbit znamená „vlastní schema“: Místo toho, abyste měli předem dané, které SERP prvky se parsují, sami definujete JSON Schema a AI z extrahuje přesně ta pole, která potřebujete. Chcete otázky z PAA, k nim stručné odpovědi a signály komerčního záměru? Definujete schema a AI vám to vrátí. Právě tahle flexibilita je důvod, proč Thunderbit funguje napříč jakýmkoli vyhledávačem — ne jen na Googlu.
Proč je to důležité pro váš workflow: Pokud potřebujete data z PAA pro content strategii, ověřte si, že je váš provider opravdu parsuje. Pokud sledujete shopping reklamy pro e-commerce, potvrďte, že existují strukturovaná pole pro shopping. Nespoléhejte na to, že „strukturovaný JSON“ automaticky znamená kompletní pokrytí.
Reálné náklady ve velkém: srovnání ceny za dotaz
Ceny uvedené na webech neříkají celý příběh. Přepočítal jsem všechno na cenu za 1 000 úspěšných dotazů ve třech objemových úrovních.
| Provider | Cena za 1K dotazů | Cena za 10K dotazů | Cena za 100K dotazů | Pay-as-you-go? | Free tier |
|---|---|---|---|---|---|
| Thunderbit (Distill) | ~0,80–3,20 USD | ~8–32 USD | ~80–320 USD | Kreditní balíčky | Free kredity |
| Thunderbit (Extract) | ~16–64 USD | ~160–640 USD | ~1 600–6 400 USD | Kreditní balíčky | Free kredity |
| SerpApi | 25 USD (Starter) | ~150 USD (Developer) | ~917 USD (Big Data) | Ne (předplatné) | 250/měsíc |
| Serper | ~1 USD | ~10 USD | ~75–100 USD | Ano | 2 500 dotazů |
| Scrapingdog | ~1 USD | ~10 USD nebo méně | Může klesnout hluboko pod 10 USD | Plán/kredity | 200 kreditů/měsíc |
| DataForSEO | ~0,60–2 USD | ~6–20 USD | ~60–200 USD | Ano | Trial kredity |
| Bright Data | ~0,50–5+ USD | Podle nabídky | Nejlepší ve velkém enterprise objemu | Ano/plán | Free tier (5 000 kreditů/měsíc) |
| ScraperAPI | Závisí na kreditech | Závisí na kreditech | Závisí na kreditech | Plán/kredity | 5 000 trial kreditů |
| Apify | ~3 USD (malý objem) | Závisí na actoru | Závisí na actoru | Platformní kredity | Měsíční free kredity |
Skryté náklady, na které si dát pozor:
- Možný poplatek 2 kredity u Serperu při více než 10 výsledcích na dotaz.
- Cenové rozdíly DataForSEO mezi standardním a live/high-priority režimem.
- Kreditní multiplikátory u ScraperAPI pro SERP oproti běžnému scrapingu.
- Enterprise minimální závazky u Bright Data.
Hodnota v jednotlivých úrovních:
- Vedlejší projekty (50 USD/měsíc): Serper nebo Scrapingdog pro pevné Google SERP JSON.
- Rostoucí týmy (10K–50K dotazů/měsíc): Serper, Scrapingdog nebo DataForSEO podle hloubky parsování.
- Enterprise (100K+ dotazů/měsíc): DataForSEO, Bright Data nebo SerpApi Big Data.
- Extrakce zaměřená na AI: Thunderbit, protože schema odpovídá očekávání downstream agenta bez postprocessingu.
Nejlepší SERP API pro AI agenty a LLM workflow v roce 2026
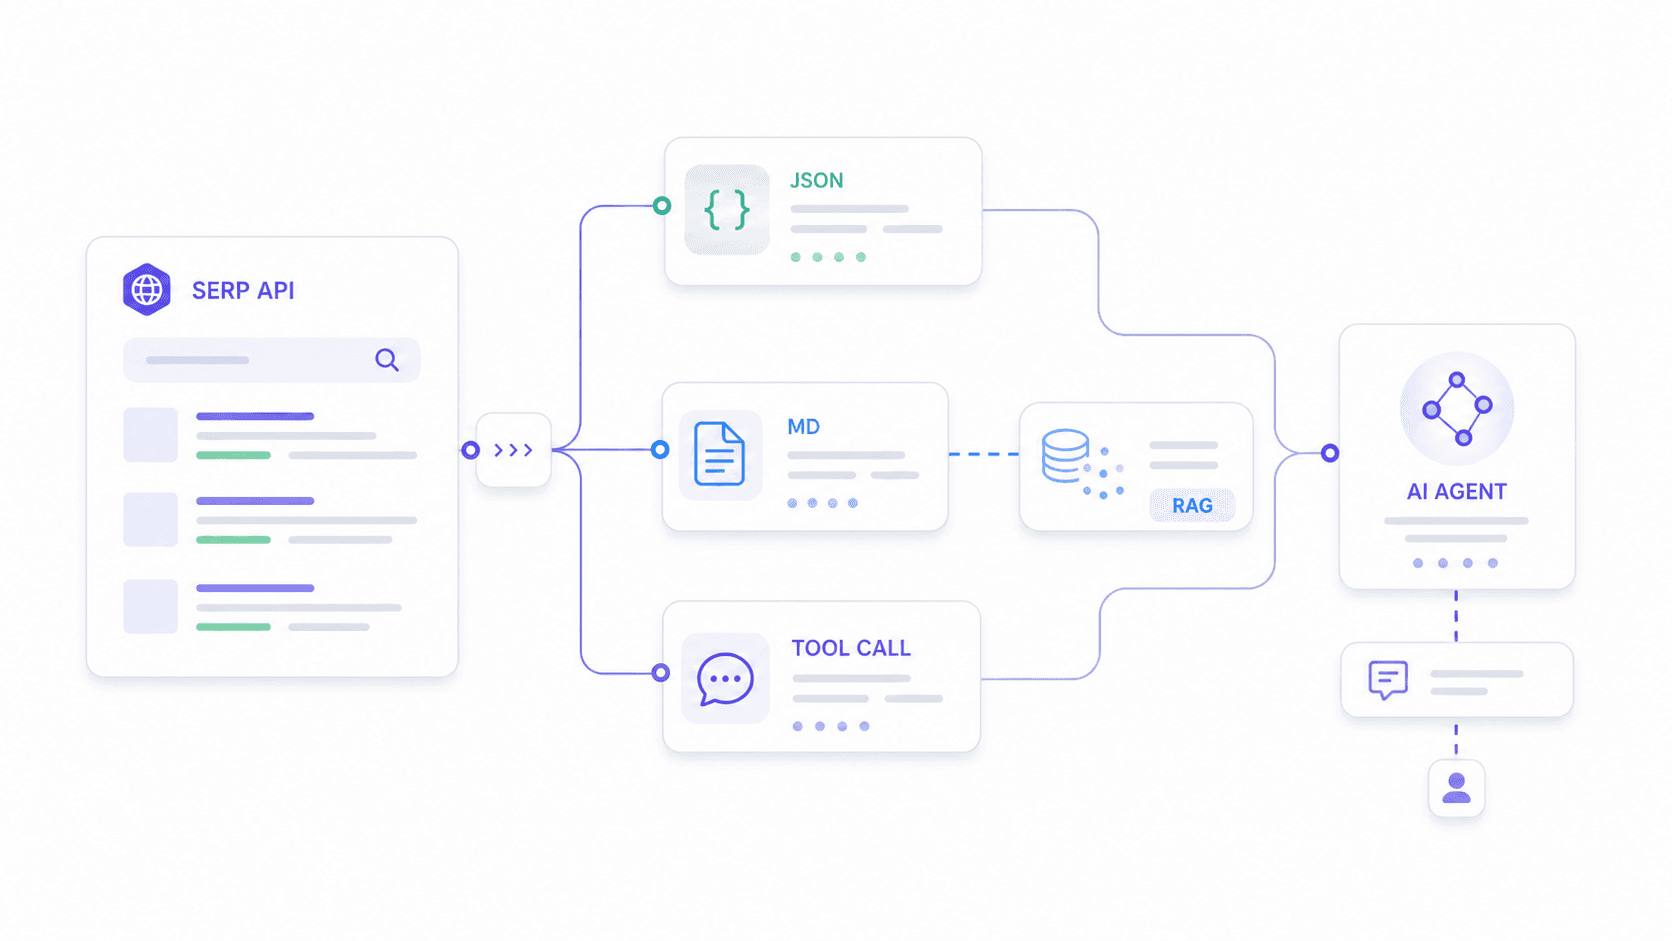
Tohle je use case, který ostatní popisují jen hodně slabě. Našel jsem nejméně tři Reddit vlákna, kde uživatelé řešili snahu propojit SERP API s workflow v n8n a AI agenty; v jednom z nich zaznělo přímo, že „se jim nepodařilo přijít na to, jak to správně rozchodit s AI agentem“.
AI agenti potřebují něco jiného než dashboardy na sledování pozic. Potřebují:
- Stabilní JSON schéma, které nerozbije parser, když provider změní formát výstupu.
- Vlastní výstupní pole odpovídající tomu, co downstream model očekává — ne generický dump všeho.
- Čistý Markdown nebo text pro embedding pipeline v RAG.
- Dostatečně nízkou latenci pro tool-calling v reálném čase.
Jak si jednotliví provideri stojí v AI agent stacku
| Provider | Vhodnost pro AI agenty | Proč |
|---|---|---|
| Thunderbit | Výborná | Vlastní JSON Schema (Extract API) + Markdown pro RAG (Distill API). Nejflexibilnější pro extrakci specifickou pro agenta. |
| Serper | Velmi dobrá | Rychlý, čistý JSON, populární v komunitách n8n/LangChain. Jednoduchý a levný pro základní volání vyhledávacího nástroje. |
| SerpApi | Dobrá | Stabilní schema, skvělá dokumentace. Hodí se, když agent potřebuje Google vertikály (Maps, Scholar, Shopping). |
| DataForSEO | Dobrá | Nejlepší volba, když je agent součástí širší SEO datové pipeline. |
| Scrapingdog | Dobrá | Rychlý a levný; schema je pro Google SERP stabilní. |
| Bright Data | Dobrá | Enterprise sběr čerstvých dat napříč vyhledávači a regiony. |
| ScraperAPI | Střední | Lepší, když agent zároveň potřebuje obecný web crawling. |
| Apify | Střední až dobrá | Flexibilní, ale pomalejší; lepší pro plánované dávkové workflow. |
Praktický příklad s Thunderbit: Představ si, že tvůj AI agent potřebuje analyzovat search intent pro dotaz „best CRM for real estate“. Definuješ schema, které chce organické výsledky (title, URL, snippet, position), otázky z People Also Ask včetně shrnutí odpovědí a klasifikaci komerčního záměru. Thunderbit Extract API vrátí přesně takovou strukturu — nic navíc, nic míň. Agent neztrácí tokeny parsováním zbytečných polí ani čištěním HTML artefaktů.
Pro RAG pipeline zase Distill API Thunderbit převede SERP stránku do čistého Markdownu, který je připravený k embeddingu. Většina specializovaných SERP API vrací pevně dané JSON schema; přístup Thunderbitu dovoluje vývojářům přizpůsobit výstup tomu, co jejich downstream model skutečně potřebuje.
Matice pro rozhodování podle use case: když potřebujete X, použijte Y
Uživatelé na fórech se pořád ptají na konkrétní doporučení navázaná na jejich reálný workflow — ne na obecné „záleží na tom“ rady. Tak jsem to dal dohromady.
| Váš use case | Nejlepší volba | Druhá volba | Proč |
|---|---|---|---|
| SEO rank tracking (vysoký objem) | DataForSEO | Scrapingdog | SEO-native endpointy, hromadné ceny, komplexní parsování |
| Google Maps / lokální business data | SerpApi | Bright Data | Zralý Maps endpoint; Bright Data sedí pro enterprise-scale lokal scraping |
| AI agent / automatizace n8n | Thunderbit | Serper | Vlastní schema + Markdown pro RAG; Serper je rychlý a levný pro jednoduchá volání |
| Budget MVP / side project (<50 USD/měs.) | Serper | Scrapingdog | Štědré free tarify, pay-as-you-go, minimální nastavení |
| Více vyhledávačů (Bing, Yandex, DuckDuckGo) | Thunderbit | DataForSEO | Thunderbit funguje na jakémkoli vyhledávači díky AI extrakci; DataForSEO má multi-engine endpointy |
| Agregace Google recenzí | SerpApi | DataForSEO | Dedikované endpointy pro recenze |
| E-commerce / sledování shoppingu | SerpApi | DataForSEO | Silné pokrytí Google Shopping a strukturovaná pole |
| Vlastní scraping workflow | Apify | ScraperAPI | Flexibilita actorů; ScraperAPI je jednoduché pro obecný scraping + SERP |
Rychlý průvodce podle persony:
- SEO tým: Začni s DataForSEO, pokud stavíš dashboardy; použij SerpApi, pokud je pro tebe důležitější pokrytí Google vertikál a dokumentace než cena.
- Sales tým: Použij Thunderbit, když workflow zahrnuje SERP, katalogové stránky a enrichment; Serper je vhodný pro jednoduché lead discovery dotazy.
- Vývojář AI nástrojů: Thunderbit pro vlastní schémata/RAG, Serper pro levné a rychlé vyhledávání, SerpApi pro robustní Google vertikály.
- Solo podnikatel: Začni na free tarifech Serperu, Scrapingdogu, SerpApi a Thunderbitu. Otestuj stejných 20 produkčních dotazů, než se zavážeš.
Srovnání rate limitů, spolehlivosti a připravenosti do produkce
Přál bych si, aby tahle sekce existovala už tehdy, když jsem providery vybíral pro první produkční workflow. Týmy škálující na tisíce dotazů denně potřebují předvídatelné rate limity, automatické retry a garantované uptime — a žádný jiný srovnávací článek je systematicky neřeší.
| Provider | Rate limit | Souběžné požadavky | Retry při chybě | SLA / uptime |
|---|---|---|---|---|
| Thunderbit Free | 600 jednotek, jednorázově | 2 | Vestavěné (anti-bot, CAPTCHA) | — |
| Thunderbit Starter | 60 000 jednotek/měsíc | 30 | Vestavěné | — |
| Thunderbit Pro | 600 000 jednotek/měsíc | 50 | Vestavěné | — |
| SerpApi | Podle plánu (vyhledávání/hodina) | Podle plánu | Provider řeší proxy/CAPTCHA | SLA 99,95 % |
| Serper | Podle účtu/plánu | Není široce zveřejněno | Doporučený ruční retry na klientovi | Žádné veřejné SLA |
| Scrapingdog | Podle plánu | Ověřte podmínky plánu | Anti-blocking řešeno | Ne vždy veřejně uvedeno |
| DataForSEO | Zdokumentováno podle endpointu/režimu | Liší se podle režimu | Async podporuje polling/retry | Enterprise podpora |
| Bright Data | Zdokumentováno, navyšujte postupně | Enterprise měřítko | Vestavěné unblocking | Enterprise SLA |
| ScraperAPI | Concurrency podle plánu | Závisí na kreditech | Řeší retry/proxy | Placené support možnosti |
| Apify | Závislé na actoru/paměti/compute | Limity platformy | Konfigurace na úrovni actoru | Spolehlivost platformy |
Checklist před nasazením do produkce:
- Zeptej se, jestli provider účtuje i za neúspěšné nebo zablokované požadavky.
- Ověř přesně concurrency, requests za minutu a chování při špičkách.
- Zjisti, jestli geotargeting, mobile vs. desktop a JS renderování mění spotřebu kreditů.
- Ulož si ukázkové JSON odpovědi z 20–50 reálných dotazů a porovnávej názvy polí v čase, abys ověřil stabilitu schématu.
- Přidej retry na klientské straně a rozumné timeouty, pokud jsou SERP data kritická pro byznys.
Přehledové shrnutí: srovnání všech 8 SERP API
| Provider | Prům. rychlost | Cena za 1K | Free tier | Rozsah parsování | Vhodnost pro AI | Více vyhledávačů | Verdikt |
|---|---|---|---|---|---|---|---|
| Thunderbit | Střední (AI extrakce) | Nízká (Distill) až prémiová (Extract) | Ano | Vlastní (jakýkoli prvek) | Výborná | Výborná | Nejlepší pro AI-nativní vlastní SERP extrakci a RAG |
| SerpApi | ~5,5 s | Prémiová | 250/měsíc | Výborný (fixní) | Dobrá | Široké Google vertikály | Nejlepší vyzrálé pokrytí Googlu |
| Serper | ~2–3 s | Velmi nízká | 2 500 dotazů | Dobré | Velmi dobrá | Hlavně Google | Nejlepší levné a rychlé API pro AI/MVP |
| Scrapingdog | ~1,25 s | Velmi nízká ve velkém | 200 kreditů/měsíc | Dobré | Dobrá | Ověřte enginy | Nejlepší kombinace rychlosti a ceny |
| DataForSEO | Střední až pomalejší (standard) | Nízká až střední | Trial kredity | Výborný | Dobrá | Výborná | Nejlepší infrastruktura pro SEO platformy |
| Bright Data | ~2–5,5 s | Enterprise | Free tier (5 000/měsíc) | Dobré (podle produktu) | Dobrá | Výborná | Nejlepší sběr v enterprise měřítku |
| ScraperAPI | ~33 s | Závislá na kreditech | 5 000 trial | Střední | Střední | Google endpointy | Nejlepší, pokud je SERP jen část širšího scrapingu |
| Apify | ~8 s | Závislá na actoru | Měsíční kredity | Závislá na actoru | Střední až dobrá | Závislá na actoru | Nejlepší pro vlastní automatizační workflow |
Jak Thunderbit zapadá do vašeho SERP workflow
Trochu víc kontextu k tomu, proč jsme API Thunderbit navrhli právě takhle. Tradiční model SERP API — pevné endpointy, předem daná výstupní pole, jen Google — funguje dobře pro jednoduché sledování pozic. Ale jakmile potřebujete něco trochu jiného (odpovědi z PAA se sentimentem, výsledky z local packu s počtem recenzí nebo shopping data ve specifickém databázovém schématu), končíte u postprocessingu nebo přechodu k jinému providerovi.
Thunderbit Extract API tenhle model obrací. Řeknete mu, co chcete, pomocí JSON Schema, a AI zjistí, jak to vytáhnout z libovolné vyhledávací stránky, kterou jí pošlete. Dnes Google, zítra Bing, příští týden specializovaný vertikální vyhledávač — stejné API, stejný přístup.
Distill API řeší jiný problém: převede chaotické SERP stránky do čistého Markdownu, který LLM dokáže skutečně zpracovat, aniž by se dusil HTML artefakty, navigací a tracking skripty. Pokud stavíte RAG pipeline a potřebujete čerstvé search evidence, je to nejrychlejší cesta od „live SERP“ k „embedding-ready obsahu“.
Oba endpointy mají v sobě anti-bot ochranu, CAPTCHA solving i JS renderování. Za to nic navíc neplatíte — je to už zahrnuté v ceně kreditů.
Vyzkoušet rozšíření Thunderbit pro Chrome
Vyzkoušejte to sami: Thunderbit Chrome Extension pro extrakci v prohlížeči, nebo použijte přímo API pro programové workflow. Náš YouTube kanál obsahuje návody, pokud chcete vidět, jak to funguje, ještě před psaním kódu.
Poznámka k legalitě
Tohle se objevuje v každém FAQ, takže stručně: legalita scrapování SERP závisí na konkrétním případu i jurisdikci. Případ hiQ v. LinkedIn potvrdil, že scrapování veřejně přístupných dat není nutně počítačový zločin, ale nedává to automaticky všeobecné povolení. Google zažaloval SerpApi kvůli SERP scrapingu, což ukazuje, že kolem přístupu k těmto datům probíhá i komerční tlak.
Praktická rada: používej vendor API v souladu s jejich podmínkami, nesbírej osobní údaje, pokud to není nutné, a ptej se providerů, jak řeší compliance. Nepředpokládej, že SERP scraping je bezrizikový.
Závěr
Neexistuje jeden provider, který by vyhrál ve všech kategoriích — správná volba závisí na use case, rozpočtu a technickém stacku. Po normalizaci cen, otestování rychlosti, zmapování parsování a vyhodnocení připravenosti pro AI agenty je můj rozhodovací rámec tenhle:
- Potřebuješ flexibilitu + připravenost pro AI agenty? → Thunderbit
- Potřebuješ široké pokrytí Google produktů? → SerpApi
- Potřebuješ rychlost + co nejnižší cenu? → Serper nebo Scrapingdog
- Stavíš SEO platformu? → DataForSEO
- Enterprise škála se SLA? → Bright Data nebo DataForSEO
- Obecný scraping + občasné SERP? → ScraperAPI nebo Apify
Začni na free tarifech. Otestuj 20–50 reálných dotazů odpovídajících tvé produkční zátěži. Porovnej JSON odpovědi. Zjisti skutečné náklady po započtení kreditů a multiplikátorů. Až potom se rozhodni.
Ceny se v tomhle trhu mění často — tohle srovnání bylo normalizováno z veřejně dostupných stránek v květnu 2026. Pokud to čteš až po několika měsících, před nákupem si údaje znovu ověř.
Více o přístupech k AI web scrapingu a jejich srovnání s tradičními metodami najdeš v našich podrobných článcích. A pokud zvažuješ web scraping bez kódování, i s tím ti rozšíření Thunderbit pro Chrome pomůže.
Časté dotazy
1. Co je SERP API a kdo ho potřebuje?
SERP API je služba, která posílá vyhledávací dotazy do vyhledávačů jako Google, Bing nebo Yandex a vrací výsledky jako strukturovaná data (obvykle JSON). SEO specialisté je používají pro sledování pozic, sales týmy pro objevování leadů, e-commerce týmy pro monitoring cen a AI vývojáři pro napojení živých dat z vyhledávání do agentů a RAG pipeline.
2. Kolik stojí scrapování 1 000 výsledků Google vyhledávání přes API?
Rozdíly jsou velké — od zhruba 0,60 USD za 1K (DataForSEO ve standardním tarifu) až po cca 25 USD za 1K (SerpApi Starter). Slevy při vysokém objemu se mezi providery výrazně liší. Vždy porovnávej cenu za 1 000 úspěšných dotazů, ne jen headline cenu.
3. Můžu použít SERP API s AI agenty jako LangChain nebo n8n?
Ano. Serper je populární v komunitě n8n pro jednoduchá search volání. Thunderbit je nejsilnější tam, kde agent potřebuje vlastní JSON schéma nebo Markdown pro RAG. SerpApi funguje dobře pro agenty, kteří potřebují stabilní Google vertikální data (Maps, Scholar, Shopping).
4. Které SERP API má nejlepší free tier na testování?
Serper nabízí při registraci 2 500 bezplatných dotazů — nejštědřejší varianta z hlediska objemu. SerpApi dává 250/měsíc, Scrapingdog nabízí 200 kreditů/měsíc, ScraperAPI poskytuje 5 000 trial kreditů na 7 dní a Thunderbit obsahuje free kredity pro prototypování. Apify má měsíční platformní kredity v hodnotě zhruba 5 USD.
5. Jaké SERP prvky bych si měl před koupí ověřit, že provider parsuje?
Nepředpokládej, že „strukturovaný JSON“ znamená kompletní pokrytí. Ověř si, zda API vrací strukturovaná pole pro: People Also Ask, Knowledge Panel, Local Pack/Maps, Shopping výsledky, Featured Snippets, reklamy nahoře i dole, Image Pack a Video Results. Použij parsovací tabulku v tomhle článku jako počáteční checklist a před závazkem otestuj reálné dotazy.
Vyzkoušet Thunderbit pro AI web scraping Get Started Free
Zjistit více



