
قبل بضعة أسابيع، ألقى أحد زملائنا في الفريق رسالة على Slack تقول فقط: "هل يجب أن نقلق من Crawl4AI؟" ضحكت، لأن مقارنة Thunderbit بـ Crawl4AI تشبه إلى حدٍّ ما مقارنة تطبيق توصيل طعام بمطبخ تجاري مجهز بالكامل. كلاهما يوصلك إلى العشاء. لكن أحدهما يفترض أنك تعرف كيف تطبخ.
لقد قضيت معظم مسيرتي المهنية في عالم الأتمتة — بدأت في Automation Anywhere أراقب الشركات وهي تحاول تركيب الروبوتات فوق الأنظمة القديمة، ثم في Jet.com حيث كانت كل ساعة هندسية إضافية تُصرف على ربط البيانات تعني ساعة أقل تُصرف على المنتج نفسه. لذلك عندما يطلب مني الناس مقارنة Thunderbit بزاحف Python مفتوح المصدر، فأنا لا أنطلق من زاوية "أداتنا أفضل". بل أنطلق من زاوية: "من الذي سيستخدم هذا فعلًا، وما الوقت المتاح لديه؟". دعونا نلقي نظرة فعلية على ما صُممت له كل أداة، لأن الإجابة الصادقة هي: يعتمد ذلك على ما إذا كنت تفضّل الضغط على زر أم كتابة سكربت.
الإجابة المختصرة
إذا أردت الخلاصة قبل الدخول في التفاصيل: Thunderbit هو أداة استخراج ويب وكيلية مُدارة ومصممة لمستخدمي الأعمال — تفتح الصفحة، تضغط One Click Extract، ثم تحصل على جدول منظم مباشرة. كما يوفّر Open API، ومخدم MCP، وCLI للمطورين الذين يريدون دمجه في خطوط العمل دون كتابة منطق الاستخراج من الصفر.
أما Crawl4AI فهو إطار عمل Python مفتوح المصدر للمطورين الذين يبنون خطوط بيانات للذكاء الاصطناعي وRAG. وهو قوي فعلًا — زحف عميق، زحف تكيفي، توليد Markdown، واستراتيجيات استخراج بالـ LLM — لكنك هنا تكتب الكود، وتدير بنية المتصفح بنفسك، وتدفع تكلفة الحوسبة ورموز LLM التي تستهلكها في الطريق.
المفاضلة الحقيقية ليست "جيد مقابل سيئ". إنها سرعة الوصول إلى النتيجة مقابل مستوى التحكم على مستوى الكود. ولا واحد منهما خطأ. إنهما ببساطة مبنيان لأشخاص مختلفين يقفون في طبقات مختلفة من المنظومة.
نظرة سريعة
قبل أن أفصل النقاش قسمًا قسمًا، إليك الجدول الذي تمنيت لو كان موجودًا أول مرة قارنت فيها بين الأداتين. معظم المقالات المنتشرة حاليًا من نوع "X مقابل Crawl4AI" تتحدث في الواقع عن Firecrawl وليس Thunderbit، لذلك بنيت هذا الجدول من الصفر.
| البُعد | Thunderbit | Crawl4AI |
|---|---|---|
| نموذج الإعداد | إضافة متصفح / تطبيق ويب، استخراج بنقرة واحدة | مكتبة Python (pip install)، سكربتات تُكتب يدويًا |
| الحاجة إلى البرمجة | بدون كود (اكتشاف حقول وكيل) | نعم (Python + مفاتيح LLM اختيارية لاستخراج منظم) |
| صفحات JavaScript / العرض الديناميكي | يتم التعامل معها في الصفحات المدعومة والمصرح بها | Chromium عبر Playwright مع إعداد يدوي |
| صيغة المخرجات | جداول منظمة، وتصدير إلى Excel/Sheets/Airtable/Notion | Markdown وJSON (عبر مخططك الخاص أو استخراج LLM) |
| ملفات PDF / الصور / المستندات | أنواع إدخال مدعومة (تحقق من القائمة الحالية في الوثائق الرسمية) | ليست محورًا أساسيًا — يركّز أساسًا على HTML/Markdown |
| نموذج الاستضافة | سحابي (تطبيق ويب) / جلسة متصفح | مستضاف ذاتيًا (Docker، وبنيتك التحتية) |
| المستخدم المثالي | فرق العمليات والمبيعات والبحث غير التقنية | مطورون يبنون خطوط RAG/LLM |
| الترخيص | تجاري، اشتراك/نظام أرصدة (الأسعار الحالية) | Apache 2.0 مع بند نسبٍ للمشروع |
ملاحظة مهمة هنا، لأن عدم ذكرها سيكون ظلمًا لك: شرائح الأسعار وحدود الأرصدة وأنواع الإدخال المدعومة تتغير كثيرًا على الجانبين. اعتبر هذا الجدول خريطة لا عقدًا — راجع الوثائق الحية قبل اتخاذ قرار الشراء.
ما هو Thunderbit؟
Thunderbit هو ما بنته فريقي بعد أن سئمنا من رؤية غير التقنيين — مندوبي المبيعات، ومديري العمليات، والباحثين — يتعطلون كلما احتاجوا إلى بيانات من موقع ويب وكانت الإجابة: "اسأل مهندسًا". المسار الحالي متعمد أن يكون بسيطًا لأفضل درجة: تفتح الصفحة التي تريد البيانات منها، تضغط One Click Extract، فيقرأ الوكيل الصفحة، ويستنتج الحقول المنطقية، ويبدأ بجلب البيانات. سترى زر Run Now، لكنه اختياري — إذا لم تلمسه، يبدأ الاستخراج تلقائيًا.

وهذه هي الفكرة بالكامل. لا محددات CSS، لا ملفات مخطط، ولا خطوة "عرّف قواعد الاستخراج" قبل أن ترى معاينة أصلًا. يمكنك تحسين الناتج لاحقًا بلغة بسيطة — غيّر اسم عمود، اطلب ترجمة حقل، أو أخبره بتجاوز الصفوف التي لا تحتوي على سعر — وعلى الصفحات المدعومة سيتابع الصفحات اللاحقة أو يفتح الصفحات الفرعية لإثراء مجموعة البيانات أكثر.
Thunderbit ليس مجرد إضافة متصفح أيضًا. هناك تطبيق ويب للمهام السحابية، وOpen API للمطورين الذين يريدون وصولًا برمجيًا دون بناء زاحفهم الخاص، ومخدم MCP لربطه مع Claude أو Cursor أو بيئات الوكلاء الأخرى، وCLI لسير العمل الطرفي وسير العمل المعتمد على أدوات البرمجة. التصدير يتم مباشرة إلى Excel أو Google Sheets أو Airtable أو Notion. إنه النوع من الأدوات الذي كنت أتمنى وجوده في Jet.com، عندما كنت أرى المحللين ينسخون ويلصقون أسعار المنافسين يدويًا في جداول بيانات كل أسبوع.
ما هو Crawl4AI؟
Crawl4AI كائن مختلف تمامًا، وأريد أن أعطيه حقه هنا لأنه بالفعل قطعة برمجية مفتوحة المصدر مصممة بإتقان — وليس مجرد زاحف يرمي HTML في Markdown. إنه زاحف Python غير متزامن، مبني افتراضيًا حول Chromium، واعتبارًا من الإصدار v0.9.0 في 18 يونيو 2026، أطلق المشروع تغييرات كبيرة لتأمينه افتراضيًا في واجهة Docker المستضافة ذاتيًا، بما في ذلك تفعيل المصادقة افتراضيًا والارتباط بـ loopback ما لم تُعدّ غير ذلك.
توضح لك وثائق البدء السريع الحلقة الأساسية: تنشئ AsyncWebCrawler، وتشغّله على رابط، وتحصل على Markdown نظيف، أو تعرّف مخطط CSS/XPath، أو تمرره إلى LLMExtractionStrategy إذا أردت للذكاء الاصطناعي أن يستنتج البنية باستخدام نموذج أنت تضبطه وتدفع تكلفته بنفسك.
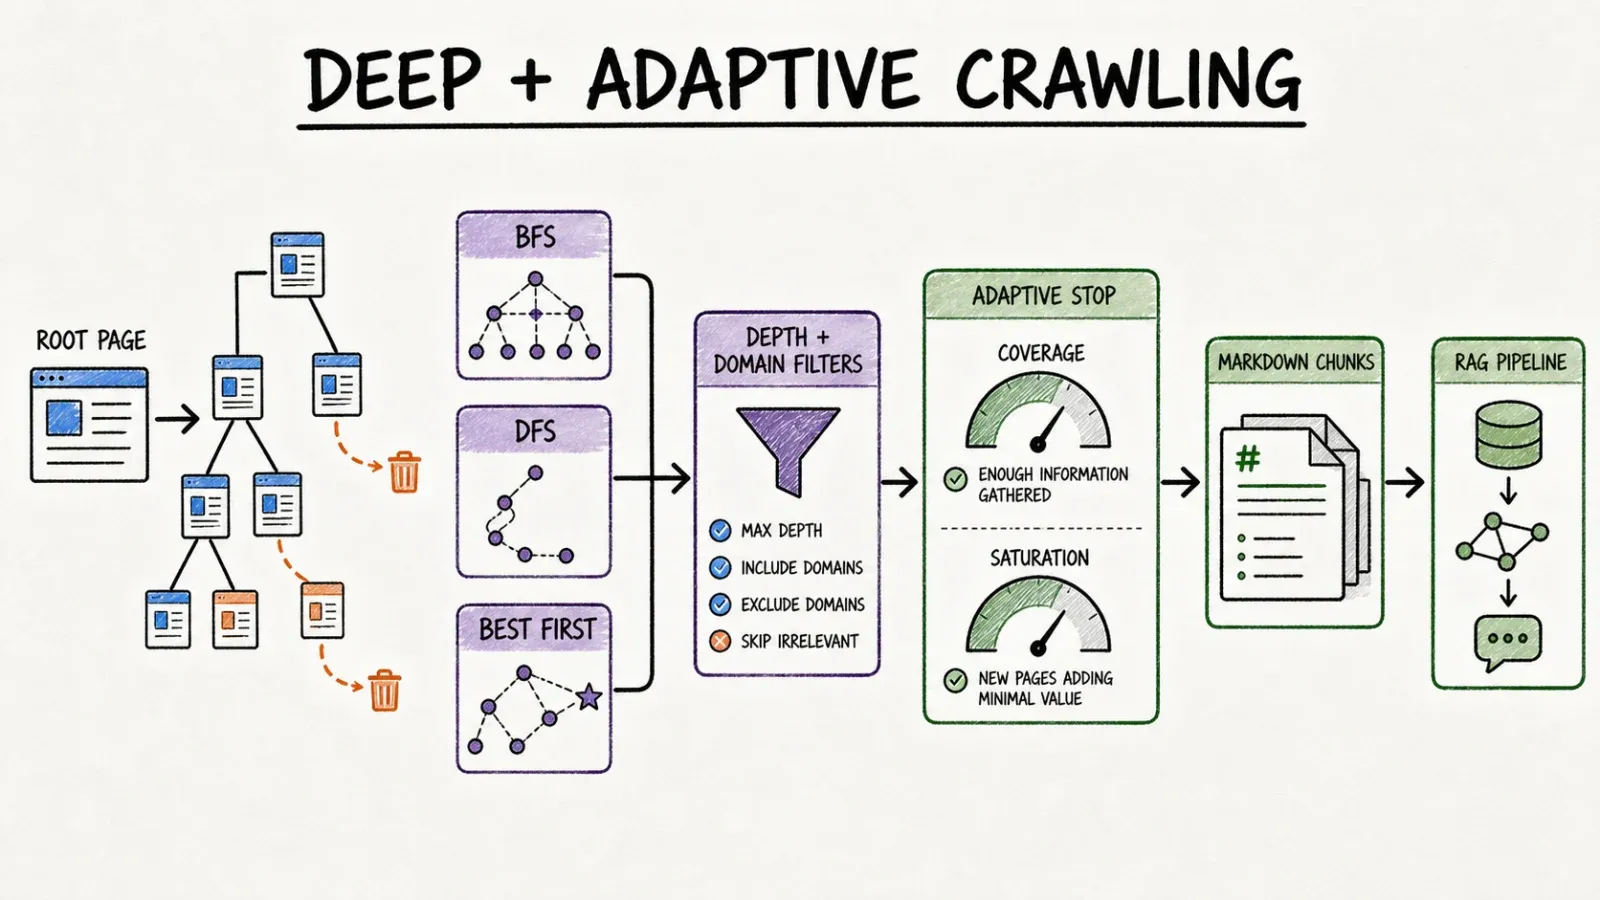
ما أثار إعجابي فعلًا عند التعمق فيه هو منطق الزحف. يوجد زحف عميق باستراتيجيات BFS وDFS وBestFirst، مع حدود للعمق، وتصفية للنطاق، ونظام تقييم — وهو مفيد فعلًا إذا كنت تحاول رسم خريطة لموقع توثيق أو أرشيف محتوى كبير. وهناك أيضًا الزحف التكيفي، وهي فكرة ذكية: يقرر أي الروابط يتابعها بعد ذلك ويتوقف عندما يعتقد أنه جمع "ما يكفي" من المعلومات، بالاعتماد على مقاييس التغطية والتشبّع بدلًا من الزحف إلى ما لا نهاية. وعلى مستوى التحكم في المتصفح، يدعم ملفات الارتباط، والرؤوس، والموقع الجغرافي، والتمرير الافتراضي، وحالة التخزين، وحتى التقاط ملفات PDF / لقطات الشاشة.
الترخيص Apache 2.0، لكن — وهذه نقطة تستحق القراءة إذا كنت مستخدمًا تجاريًا — توجد إشارة نسب خاصة بالمشروع مذكورة في ملف الترخيص. "مجاني ومفتوح المصدر" لا يعني دائمًا "دون أي شروط"، وأفضّل أن أوضح ذلك الآن بدل أن تكتشفه لاحقًا.
الفرق الجوهري: منتج وكيل مكتمل مقابل إطار عمل للمطورين
الوقت حتى أول جدول
لن أدّعي أنني أجريت اختبارًا بزمن محدد هنا، لأن اختلاق عدد دقائق بعينه سيكون غير صادق، وأيضًا غير مفيد إلى حدٍّ كبير — سرعة الشبكة، وتعقيد الصفحة، وحتى سرعة كتابتك أنت كلها تغيّر الرقم. لكن الفارق في عدد الخطوات حقيقي ويستحق أن نمر عليه بصراحة.
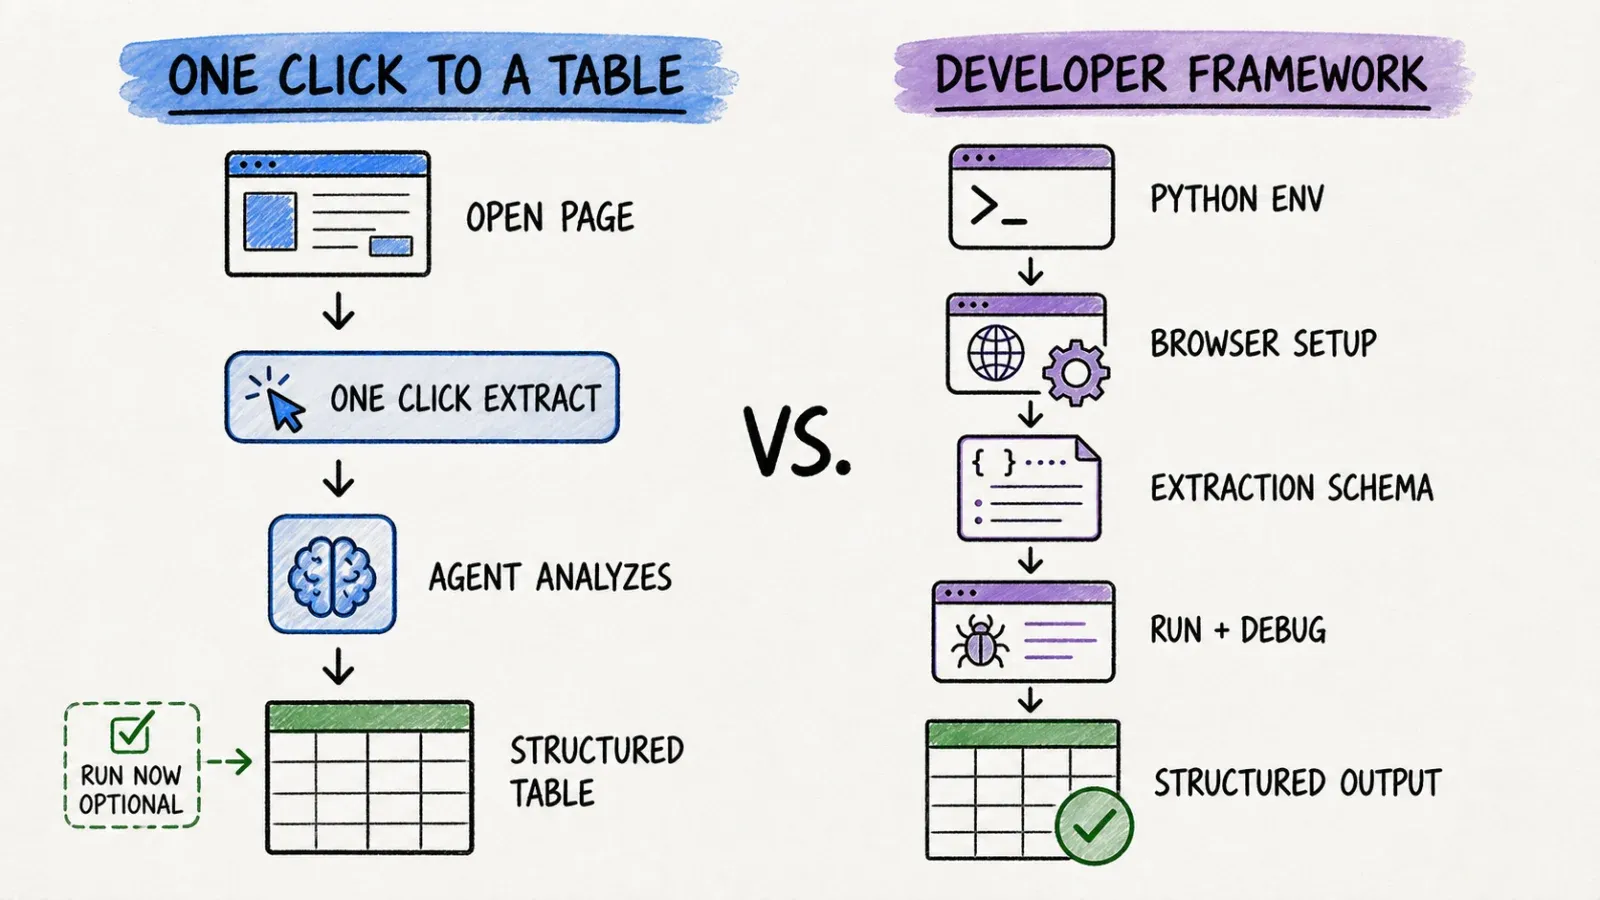
مع Crawl4AI، تكون رحلتك تقريبًا كالتالي: إعداد بيئة Python، تنفيذ pip install crawl4ai، تشغيل فحص الإعداد/doctor، ضبط المتصفح واعتماديات Playwright، كتابة مخطط استخراج أو ربط مفتاح LLM، تشغيل السكربت، ثم تصحيح المخرجات عندما لا تُحلَّل بعض البيانات بشكل صحيح — وهذا يحدث دائمًا في المحاولة الأولى، هكذا تعمل البرمجيات.
أما مع Thunderbit، فالمسار هو: تثبيت إضافة المتصفح، فتح الصفحة، الضغط على One Click Extract، ثم إمّا النقر على Run Now أو الانتظار لأن العملية تبدأ تلقائيًا. هذا كل شيء. نقرة مقصودة واحدة، بلا كود.
إذا كنت مطورًا وتعيش أصلًا داخل الطرفية، فلن يبدو مسار Crawl4AI مخيفًا — إنه يوم الثلاثاء بالنسبة لك. أما إذا كنت مدير مبيعات يريد فقط قائمة عملاء محتملين قبل الغداء، فذلك جدار كامل.
مستوى التحكم في منطق الزحف والاستخراج
هنا يتفوق Crawl4AI فعلًا لفئة معينة من المستخدمين. تحصل على تحكم كامل في عمق الزحف، والتوازي، ومنطق إعادة المحاولة، والتخزين المؤقت، وكيفية تقسيم المحتوى بدقة قبل أن يصل إلى LLM أو قاعدة متجهات. إذا كنت تبني خط RAG وتحتاج تحكمًا دقيقًا في كيفية تقسيم المستندات قبل التضمين، فهذه الدقة مهمة، وThunderbit ليس يحاول المنافسة في هذا الجانب.
سطح التحكم في Thunderbit مختلف — هو يركز على تحسين ما يتم استخراجه (أي الحقول، وأي صيغة، وأي لغة) بدلًا من كيفية تنقل الزاحف عبر الويب على مستوى الكود. بالنسبة للبيانات التجارية المنظمة، غالبًا ما يكون هذا القرار في صالحك. أما لبنية RAG مخصصة، فستحتاج إلى التحكم على مستوى الكود.
الاستضافة، والمراقبة، وملكية الصيانة
مع Crawl4AI، أنت من يملك البنية التحتية. وهذا يعني أنك مسؤول عن نشر Docker، واعتماديات المتصفح، وتدوير البروكسيات إذا قاومتك المواقع، ومراقبة فشل الزحف بصمت عند الثانية صباحًا، وتحديث السكربتات عندما يغيّر الموقع المستهدف بنيته. مع Thunderbit، يقع هذا العبء التشغيلي علينا — تشغيل المتصفح والسحابة، ومنطق قراءة الصفحات، وصيانة محرك الاستخراج.
ولا نهج منهما يخلو من المفاضلات. الاستضافة الذاتية تعني أنك تستطيع التدقيق والتعديل والتحكم في كل شيء، لكنها تعني أيضًا أن أي فشل في الثانية صباحًا هو مشكلتك.
سيناريوهات عملية
المقارنات المجردة مفيدة، لكنني أجد من الأسهل التفكير في هذه الأمور عبر سيناريوهات حقيقية.
مستخدم أعمال يستخرج الصفحة الحالية. لنفترض أنك باحث سوق يحتاج إلى بيانات الأسعار من 40 صفحة منتج منافس قبل نهاية اليوم. لا تعرف Python ولا ترغب في تعلمها اليوم. إضافة Thunderbit تمنحك جدولًا منظمًا دون مغادرة تبويب المتصفح الذي أنت فيه أصلًا.
مطور يبني خط إدخال بيانات لـ RAG. أنت تفهرس موقع توثيق تقنيًا لمساعد داخلي، وتحتاج إلى مقاطع Markdown نظيفة وبتنسيق ثابت لتضمينها. هذا هو المجال الطبيعي لـ Crawl4AI — توليد Markdown والتحكم في التقسيم بُنيا لهذا الغرض تحديدًا.
زحف عميق لموقع توثيق. تريد رسم خريطة كاملة لقاعدة معرفة تمتد مئات الصفحات، مع قيود على النطاق وتقييم حتى لا تهدر الحوسبة على صفحات غير مهمة. استراتيجيات الزحف العميق في Crawl4AI مصممة لهذا؛ وليس هذا بالضبط استخدام Thunderbit.
استدعاء الاستخراج من وكيل ذكاء اصطناعي. لديك Claude أو Cursor مُعدًّا كوكيل يحتاج إلى سحب بيانات منظمة أثناء سير العمل دون أن يضغط إنسان أي زر. مخدم MCP في Thunderbit يتصل مباشرة بهذا النوع من بيئات الوكلاء، كما أن Open API يعمل أيضًا لسير العمل الخلفي.
الدقة، والصفحات الديناميكية، والصيانة
من المهم التمييز بين أمرين غالبًا ما يخلط الناس بينهما: استنتاج الحقول (معرفة أي البيانات مهمة في الصفحة) والتحكم في المتصفح/الزحف (عرض الصفحة والتنقل فيها فعليًا).
Thunderbit يؤتمت الأمرين معًا على الصفحات المدعومة والمصرح بها — الوكيل يقرأ الصفحة ويستنتج البنية، ويتعامل مع العرض في الخلفية. أما Crawl4AI فيؤتمت العرض (عبر Chromium/Playwright) لكنه يترك قرار استنتاج البنية لك، سواء كان ذلك محدد CSS مكتوبًا يدويًا أو استدعاء استخراج عبر LLM تضبطه وتدفع مقابله.
ولا أداة منهما تضمن وصولًا عالميًا. الصفحات المحمية بتسجيل دخول، وأنظمة مكافحة الروبوتات العدوانية، والبنية التي تتغير باستمرار هي مشكلات صعبة لأي زاحف، سواء كان مُدارًا أو مستضافًا ذاتيًا. سيكون من الكذب أن أقول إن Thunderbit يعمل على كل موقع حرفيًا — هو يعمل جيدًا على الصفحات المدعومة والمصرح بها، وهذه عبارة صادقة لا تسويقية. Crawl4AI لديه القيود نفسها؛ لكنه يضع عبء التعامل معها على وقتك الهندسي بدلًا من وقت المورّد.
السعر، والترخيص، والتكلفة الإجمالية
هذا هو القسم الذي تتجاهله معظم مقالات المقارنة، وهذا يزعجني في كل مرة لأن "مجاني" و"صفر تكلفة" ليسا الشيء نفسه.
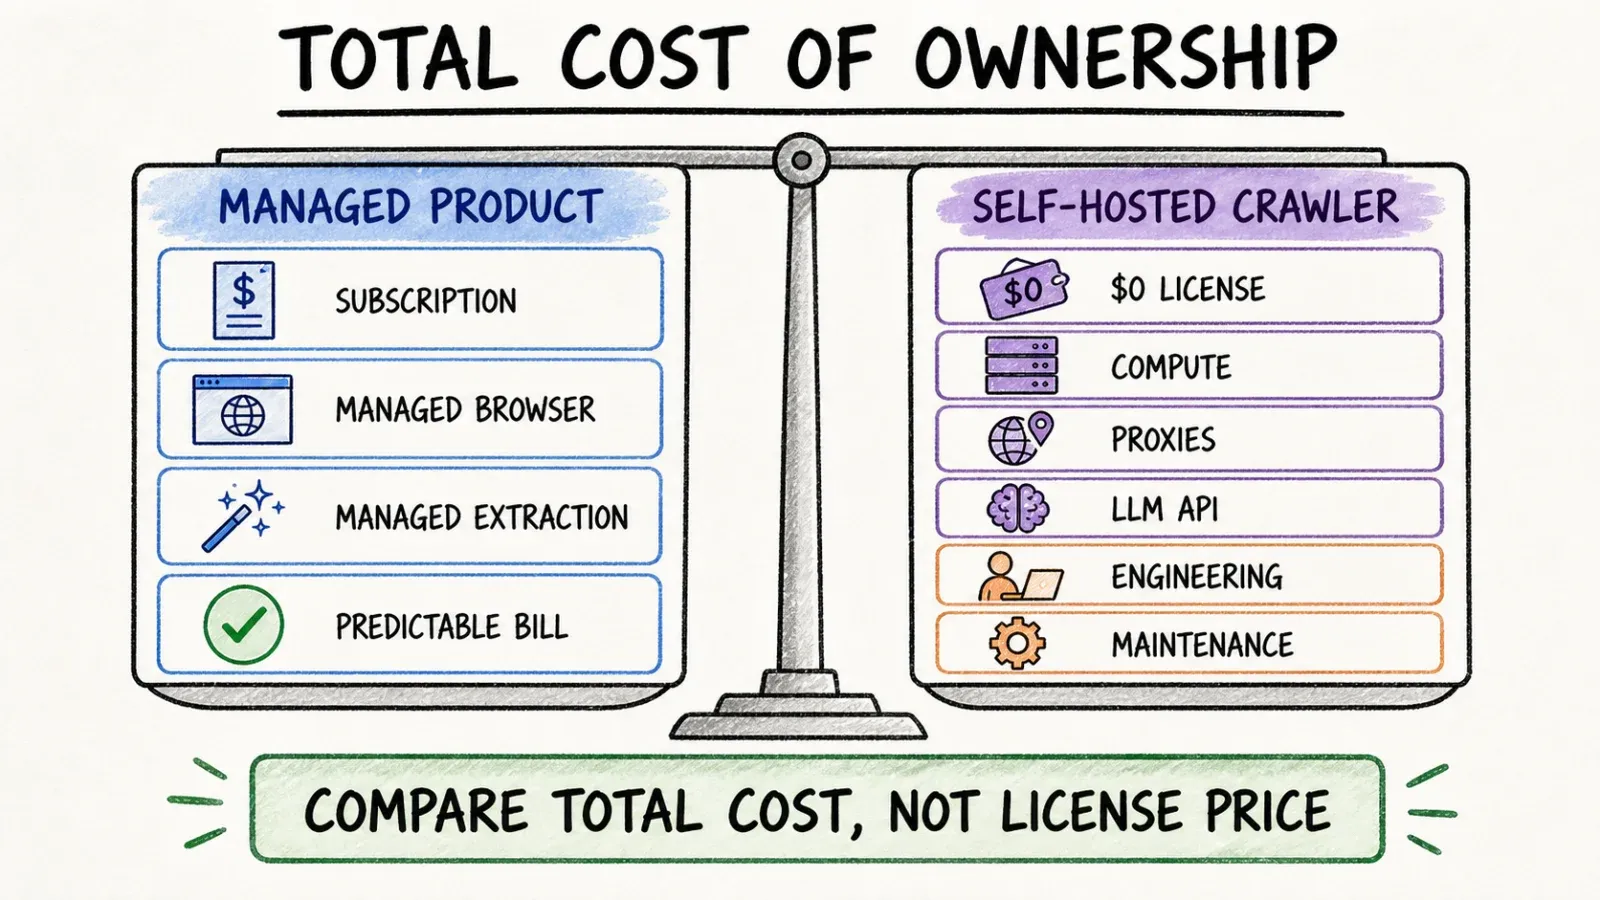
لنأخذ سيناريو واقعيًا: تحتاج إلى استخراج حوالي 3,000 صف شهريًا — عملاء محتملون، قوائم، أيًا كان — بشكل مستمر.
مع Crawl4AI، لا تكلفك الرخصة شيئًا. لكنك لا تزال تدفع مقابل:
- الحوسبة واستضافة المتصفح (خادم أو حاوية تشغّل Chromium)
- رسوم خدمة البروكسي إذا كانت المواقع المستهدفة تتطلب تدوير عناوين IP
- تكاليف رموز واجهة برمجة التطبيقات الخاصة بـ LLM إذا كنت تستخدم
LLMExtractionStrategyمع نموذج من فئة GPT-4o لاستخراج منظم - الوقت الهندسي لكتابة السكربتات واختبارها ونشرها وصيانتها — وإصلاحها عندما يعيد الموقع تصميم واجهته
لا يظهر أي من ذلك على بطاقة السعر "$0"، لكنه يظهر في إنفاقك الشهري الفعلي، وغالبًا يكون موزعًا بين فاتورة سحابية، وفاتورة API، وتقويم شخص ما.
مع Thunderbit، أنت تدفع اشتراكًا ثابتًا ومتوقعًا أو مستوى أرصدة — راجع صفحة الأسعار الحالية لأن الشرائح قد تتغير مع الوقت — ولا تحتاج بشكل منفصل إلى إدارة مفتاح LLM أو عقد بروكسي أو نشر Docker.
الصياغة الصادقة ليست "مجاني مقابل مدفوع". بل "تكلفة هندسية مخفية مقابل اشتراك متوقع". لقد رأيت ما يكفي من فرق الهندسة وهي تبتلع تكاليف البنية التحتية بصمت داخل ميزانية الرواتب لكي أعرف أن "برمجيات مجانية" و"تشغيل مجاني" جملتان مختلفتان تمامًا.
من ينبغي أن يختار Thunderbit؟
إذا كنت مستخدمًا غير تقني أو محدود الوقت وتحتاج إلى بيانات منظمة — جداول، عملاء محتملين، قوائم — بسرعة، وتريد تصديرها مباشرة إلى Excel أو Sheets أو Airtable أو Notion دون لمس البنية التحتية أو البروكسيات أو مفاتيح LLM، فإن Thunderbit هو الطريق الأكثر مباشرة. وينطبق هذا أيضًا على الفرق التي تريد سير عمل توليد العملاء المحتملين بالذكاء الاصطناعي أو الأبحاث السريعة دون إدخال الهندسة في كل مرة.
من ينبغي أن يختار Crawl4AI؟
إذا كنت مطورًا تبني خط بيانات لـ RAG أو LLM، وتحتاج إلى تحكم كامل في منطق الزحف — الزحف المتوازي، والتقسيم المخصص، ومخططات استخراج خاصة — وتشعر بالراحة في الاستضافة الذاتية وصيانة كود Python، فإن Crawl4AI يمنحك ذلك التحكم بطريقة لم يُصمم المنتج المُدار ليقدمه.
هل يمكن للفرق استخدام الاثنين معًا؟
نعم فعلًا، وهذا ليس تهرّبًا مني من اختيار طرف. لقد رأيت هذا النمط يتكرر في الشركات الأكبر: يبني فريق الهندسة زاحفًا متخصصًا قائمًا على Crawl4AI لخط RAG لأنهم يحتاجون ذلك المستوى من التحكم في التقسيم والتحضير للتضمين، بينما تستخدم فرق المبيعات والتسويق والبحث Thunderbit للطلبات اليومية من نوع "أحتاج هذه القائمة من الشركات قبل الثالثة عصرًا" التي لا تبرر كتابة سكربت. لا يوجد تكامل رسمي بين المنتجين، ولن أزعم وجوده — لكن تقسيم الأدوار منطقي عمليًا بذاته.
الحكم النهائي
تقييمي الصادق، بعد سنوات قضيتها على جانبي "بناء الأتمتة" و"مشاهدة الناس يتعثرون بدون أتمتة" هو: اختر بناءً على من سيقوم بالعمل وكم عمق العبء المطلوب. إذا كان لديك مهندسون لديهم الوقت لصيانة البنية التحتية، وتحتاج إلى زحف عميق وتكيفي لخط أنابيب ذكاء اصطناعي، فإن Crawl4AI خيار مفتوح المصدر قوي جدًا ومصان جيدًا. أما إذا كنت تحتاج إلى بيانات منظمة من المواقع دون تشغيل بيئة Python — ومعظم من يسأل "هل أحتاج إلى أداة استخراج؟" يقع في هذه الفئة — فإن Thunderbit يوصلك إلى الهدف أسرع، مع صيانة أقل لاحقًا. لا يوجد فائز عالمي هنا، فقط ملاءمة أفضل بحسب الجهة التي تجلس خلف لوحة المفاتيح.
إذا أردت أن ترى كيف يعمل جانب "بدون كود" من هذا فعليًا، فاطّلع على استخراج الويب بدون برمجة أو تصفح تقريرنا حول أفضل أدوات استخراج الويب بالذكاء الاصطناعي لمزيد من السياق حول موقع هذه الأدوات مقارنة ببعضها.
الأسئلة الشائعة
هل Crawl4AI مجاني ومفتوح المصدر فعلًا؟ المكتبة الأساسية مرخّصة تحت Apache 2.0 مع بند نسب خاص بالمشروع، ولا توجد رسوم اشتراك من المورّد. لكن "مجاني" يغطي الرخصة فقط — ستدفع أيضًا مقابل الاستضافة، والبروكسيات، وأي استدعاءات API للـ LLM تضبطها للاستخراج، إضافة إلى الوقت الهندسي اللازم لبنائه وصيانته.
هل يتطلب Thunderbit كتابة كود؟ لا. سير العمل الأساسي — تثبيت إضافة Chrome، الضغط على One Click Extract، ثم مراجعة النتائج — لا يحتاج إلى أي برمجة. يمكن للمطورين الذين يريدون وصولًا برمجيًا استخدام Open API، أو مخدم MCP، أو CLI، لكن هذه طبقات اختيارية وليست متطلبات.
أيّهما أفضل لخطوط RAG/LLM؟ Crawl4AI مصمم لهذا الغرض تحديدًا — توليد Markdown، والزحف العميق والتكيفي، والتحكم في التقسيم كلها أُعدت مع تجهيز RAG في الاعتبار. أما Thunderbit فمبني للبيانات التجارية المنظمة القابلة للتصدير (جداول، عملاء محتملين، قوائم) وليس لخطوط تعتمد Markdown أولًا، لذلك بالنسبة لبنية RAG مخصصة، يكون Crawl4AI هو الاختيار الطبيعي أكثر.
أيّهما أسرع لاستخراج لمرة واحدة؟ لصفحة واحدة أو بضع صفحات، مسار Thunderbit بنقرة واحدة يقلل عدد الخطوات بين "أحتاج هذه البيانات" و"أصبحت لدي البيانات" — لا إعداد بيئة، ولا سكربت للكتابة. أما عبء الإعداد في Crawl4AI فيؤتي ثماره أكثر في المهام المتكررة أو واسعة النطاق أو شديدة التخصيص بدلًا من عمليات السحب السريعة لمرة واحدة.
هل يدعم Thunderbit MCP والوصول عبر API؟ نعم. يوفّر Thunderbit مخدم MCP لبيئات وكلاء الذكاء الاصطناعي مثل Claude وCursor، بالإضافة إلى Open API لسير العمل الخلفي والبرمجي، إلى جانب إضافة المتصفح بدون كود وتطبيق الويب. وإذا كنت تقارن بدائل أخرى خارج هذين الخيارين، فغالبًا ستظهر أدوات مثل Firecrawl وApify وBright Data في نفس النقاش، ومن المفيد الاطلاع على قراءتنا الأوسع حول استخراج الويب بالذكاء الاصطناعي لفهم المشهد الأوسع.




