
الملخص التنفيذي
التقرير السابق طرح سؤالًا سياساتيًا: كم عدد المواقع الأكثر زيارة في العالم التي تخبر زواحف الذكاء الاصطناعي بما يمكنها فعله وما لا يمكنها فعله؟
هذا التقرير اللاحق يطرح السؤال التشغيلي الكامن وراءه: ما مدى موثوقية robots.txt بوصفه البنية التحتية التي يُطلب منها الآن حمل هذه السياسة؟
الإجابة غير مريحة. ما يزال robots.txt يعمل لأنه علني، منخفض التكلفة، قابل للقراءة آليًا، ومألوف أصلًا لدى الزواحف. لكنه أيضًا يُطلب منه أن يفعل أكثر بكثير مما صُمم له. في 2026، قد يحتوي الملف النصي نفسه على عناصر تحكم في الزحف لأغراض SEO، وفهارس خرائط الموقع، وامتدادات قديمة لمحركات البحث، وإشارات انسحاب من تدريب الذكاء الاصطناعي، ومفردات سياسة تضعها Cloudflare، وتحفظات حقوق نشر، ولغة قانونية موجّهة لنزاعات مستقبلية.
هذا دينٌ تقني في الإعدادات.
البيانات التي يستند إليها هذا التقرير هي نفسها زحف Tranco Top 10,000 المستخدم في دراسة زواحف الذكاء الاصطناعي الأصلية. من بين 10,000 نطاق، أعاد 6,638 ملف robots.txt قابلًا للقراءة؛ وأعاد 610 آخرون حالة 404، وهي تُعامل في البروتوكول على أنها سماح ضمني. هذا يمنحنا 7,248 موقعًا قابلًا للتحليل لاتخاذ قرارات الوصول من قبل الروبوتات، و6,638 ملفًا فعليًا لتحليل تعقيد الإعداد.
تبرز ست نتائج:
-
معظم ملفات
robots.txtصغيرة، لكن الذيل الأيمن شديد التعقيد. الملف الوسيط لا يتجاوز 834 بايت و31 سطرًا. لكن 1,005 ملفات يبلغ حجمها 5 كيلوبايت على الأقل، و273 تبلغ 20 كيلوبايت على الأقل، و28 تبلغ 100 كيلوبايت على الأقل. أكبر ملف في العينة يبلغ 248 كيلوبايت. -
مئات المواقع الكبرى تشغّل ملفات أقرب إلى إعدادات إنتاجية منها إلى ملاحظات سياسات. الملف الوسيط يحتوي على 9 توجيهات
Disallow. لكن 707 مواقع لديها 100 قاعدةDisallowأو أكثر، و13 لديها 1,000 أو أكثر، و240 تسمي 50 وكيل مستخدم على الأقل، و110 تسمي 100 وكيل مستخدم أو أكثر. -
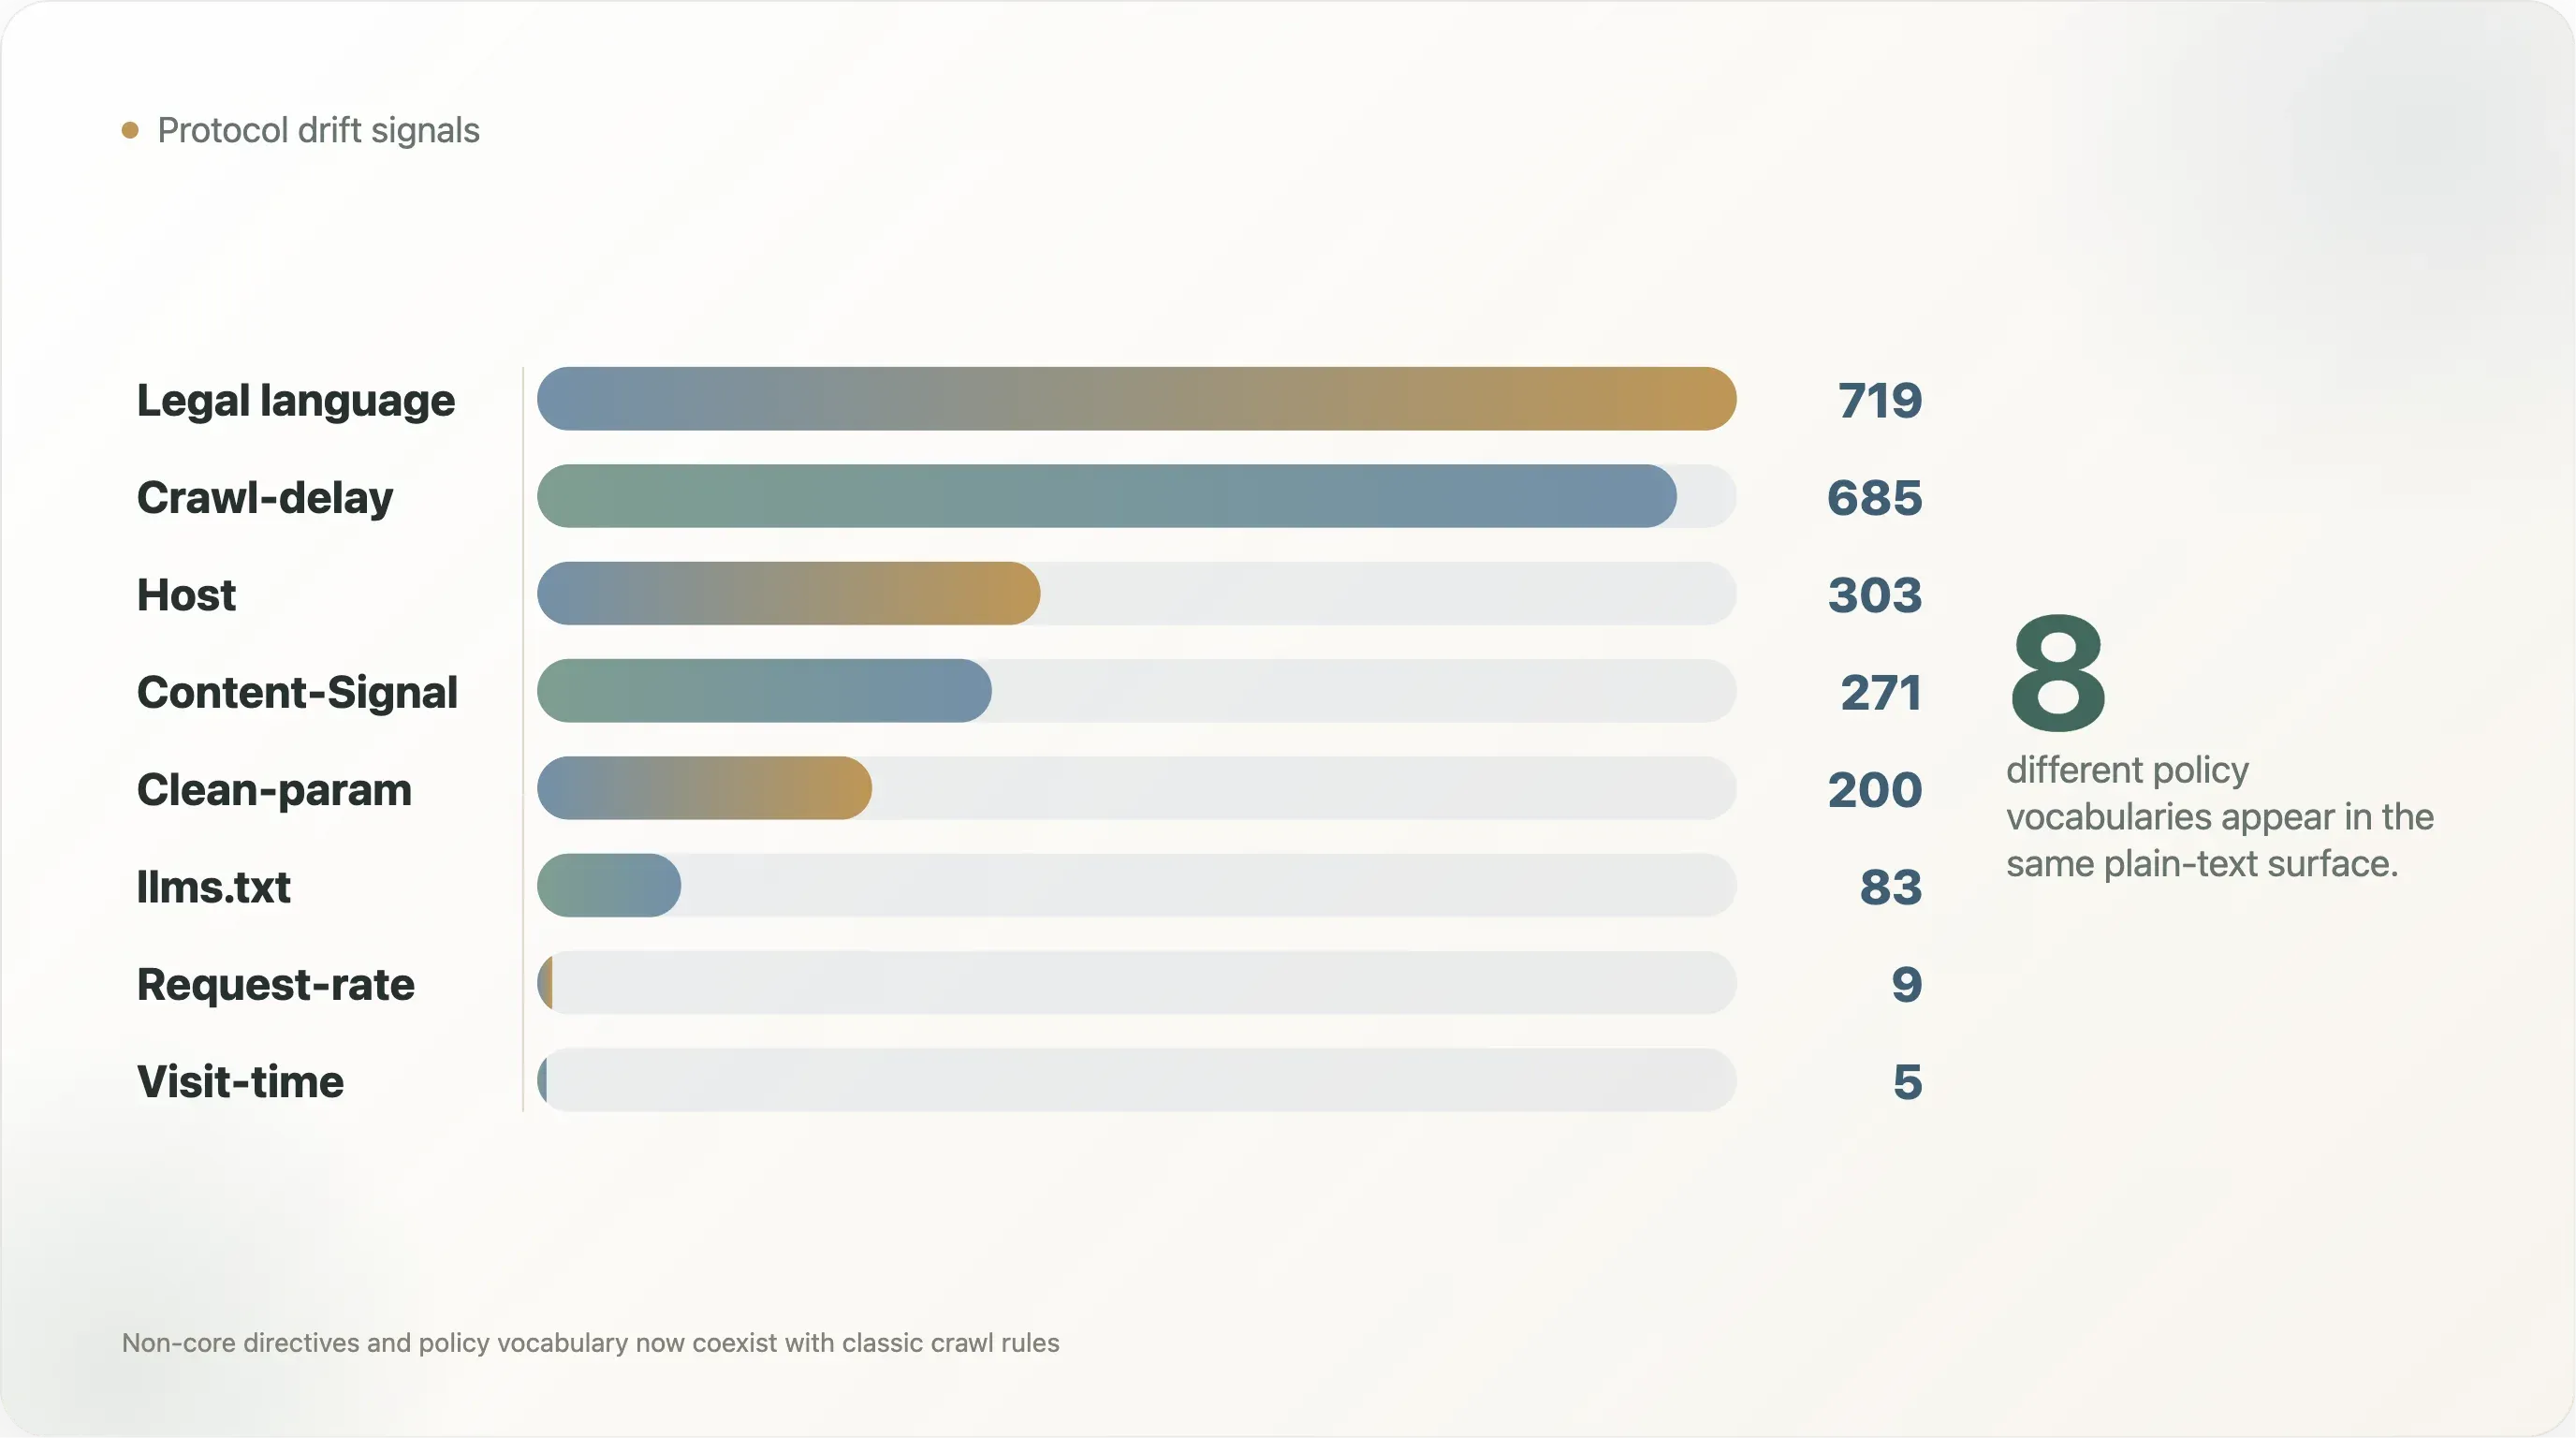
انحراف البروتوكول ليس نظريًا. من بين 6,638 ملفًا قابلًا للقراءة، يحتوي 685 على
Crawl-delay، و303 علىHost، و200 علىClean-param، و9 علىRequest-rate، و5 علىVisit-time، و271 على لغة على نمطContent-Signalالخاصة بـ Cloudflare. هذه ليست كلها جزءًا من معيار نقي واحد. إنها فولكلور زاحف متراكم. -
Googlebot يُعامل كمواطن خاص. 562 نطاقًا قابلًا للتحليل تحجب زاحف بحث تقليديًا واحدًا على الأقل. وفي 404 من تلك الحالات، يُسمح لـ Googlebot بينما يُحجب زاحف بحث واحد على الأقل. لم يظهر التمييز ضد زواحف الذكاء الاصطناعي في نظام بيئي محايد؛ بل إن
robots.txtكان قد رسّخ أصلًا تراتبية لمحركات البحث. -
سياسة الذكاء الاصطناعي تجعل هذا الدين أكثر وضوحًا. 1,377 ملفًا قابلًا للقراءة تحتوي على لغة متعلقة بسياسة الذكاء الاصطناعي؛ و719 تحتوي على لغة حقوق نشر أو شروط أو ترخيص أو إذن؛ و501 تجمع بين الاثنين. لقد أصبح الملف واجهة آلية ومادة قانونية في آن واحد. وهذا مفيد، لكنه هش.
-
الملفات الأكثر خطورة ليست دائمًا الأكثر عداءً للذكاء الاصطناعي. التجارة الإلكترونية، والسفر، والشبكات الاجتماعية، والمال، والأكاديميا، والأخبار كلها تنتج ملفات معقدة لأسباب مختلفة: التحكم في ميزانية الزحف، والمسارات القديمة، والمحتوى الذي ينشئه المستخدمون، وتحفظات الحقوق، والاستثناءات الخاصة بالروبوتات. تُضاف قواعد الذكاء الاصطناعي فوق قاعدة أساس فوضوية أصلًا.
الخلاصة الرئيسية: يبقى robots.txt أهم سطح عام لسياسة الزحف على الويب، لكنه أساس ضعيف لحوكمة الذكاء الاصطناعي عالية المخاطر ما لم يوحّد النظام البيئي هوية الزاحف، ومفردات استخدام الذكاء الاصطناعي، وقابلية تدقيق السياسة.
المنهجية
يعيد هذا التقرير استخدام مجموعة البيانات من تحليل Thunderbit الأصلي لسياسة زواحف الذكاء الاصطناعي على نطاقات Tranco Top 10,000.
كانت المواد المدخلة هي:
tranco_top10k.csv— قائمة Tranco الأصلية لأفضل 10 آلاف نطاق.out/fetch_meta.csv— حالة الجلب، وعدد البايتات، والمخطط، ونتيجة إعادة التوجيه، وبيانات الأخطاء الوصفية.out/sites.csv— النطاق، والترتيب، والفئة، واللغة، وحالةrobots.txt.out/site_meta.csv— صف تحليلي واحد لكل موقع، يتضمن فئة القالب، وأعلام حظر الذكاء الاصطناعي، وحجم الملف، وحقول ملخص سياسة الروبوتات.out/bot_status.csv— صف واحد لكل نطاق ولكل زاحف، يتضمن ما إذا كان ذلك الروبوت محظورًا وما إذا كانت هناك قاعدة محددة.raw_robots/— نصوصrobots.txtالمخزنة مؤقتًا للمواقع 6,638 التي أعادت الحالة200.
ولأجل هذا التقرير اللاحق، جرى فحص كل ملف robots.txt قابل للقراءة بحثًا عن:
- حجم الملف وعدد الأسطر؛
- الأسطر النشطة غير المعلّقة؛
- أعداد توجيهات
User-agentوDisallowوAllowوSitemap؛ - التوجيهات القديمة أو غير الأساسية مثل
Crawl-delayوHostوClean-paramوRequest-rateوVisit-time؛ - مفردات عصر الذكاء الاصطناعي بما في ذلك
Content-Signalوllms.txtوAI وLLM وmachine learning وTDM و2019/790؛ - مفردات قانونية مثل حقوق النشر وشروط الخدمة والترخيص والإذن ولغة التحفّظ على الحقوق؛
- معاملة زواحف البحث Googlebot وBingbot وDuckDuckBot وSlurp وBaiduspider وYandexBot.
كما يعرّف التقرير مؤشرًا بسيطًا لدَين الإعدادات لفرز الأولويات. وهو يجمع بين حجم الملف، وعدد وكلاء المستخدم، وعدد Disallow، وعدد Allow، وعدد التوجيهات غير القياسية، ومزيج لغة سياسة الذكاء الاصطناعي واللغة القانونية. هذا المؤشر ليس مقياسًا عالميًا للصحة أو الصحة الفنية. إنه وسيلة لتحديد الملفات التي يُرجّح أن تكون صعبة الصيانة أو المراجعة أو الاستدلال.
جميع الجداول والرسوم المشتقة مضمنة في مجلد التسليم.
النتيجة 1: الملف الوسيط بسيط، لكن الذيل ليس كذلك
ملف robots.txt النموذجي على الويب الكبير ما يزال صغيرًا.
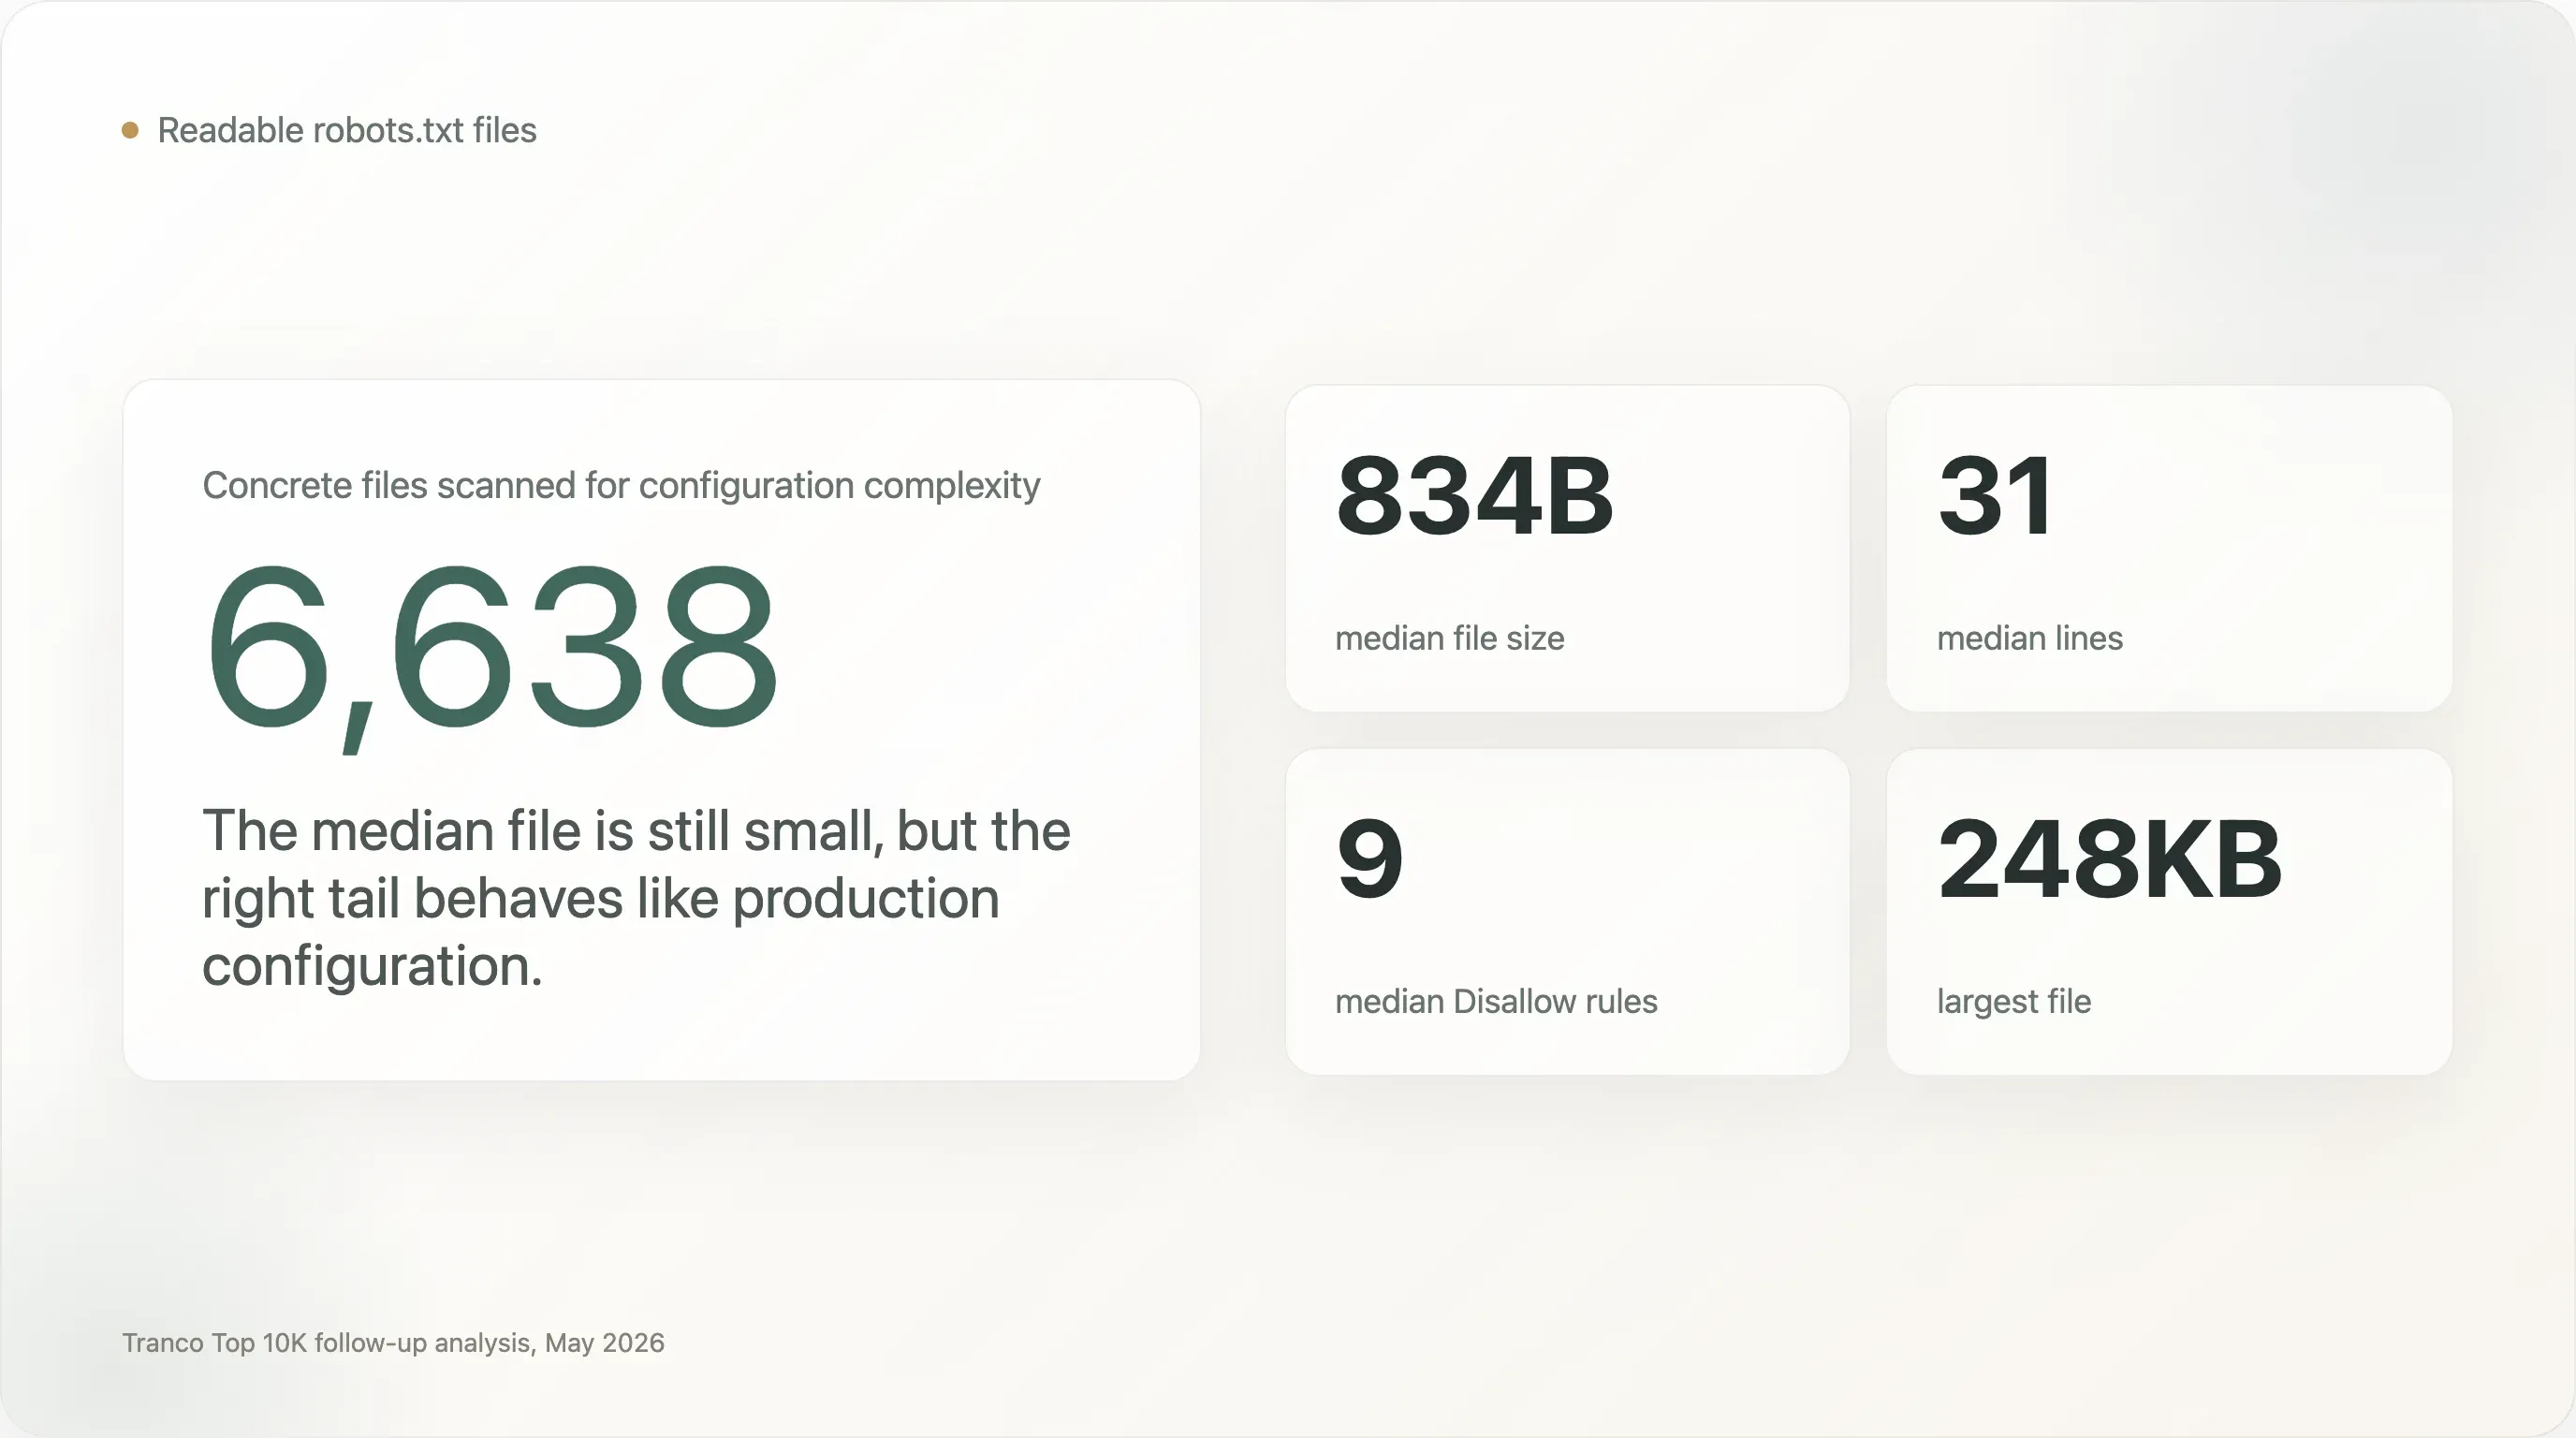
عبر الملفات الـ 6,638 القابلة للقراءة:
| المقياس | الوسيط | P90 | P95 | P99 | الحد الأقصى |
|---|---|---|---|---|---|
| حجم الملف | 834 بايت | 6.7 كيلوبايت | 15.8 كيلوبايت | 76.0 كيلوبايت | 248.3 كيلوبايت |
| الأسطر | 31 | 238 | 332 | 1,008 | 4,998 |
| الأسطر النشطة | 23 | 198 | 282 | 837 | 4,998 |
توجيهات User-agent | 1 | 21 | 39 | 137 | 823 |
توجيهات Disallow | 9 | 103 | 176 | 422 | 4,997 |
توجيهات Allow | 1 | 17 | 33 | 69 | 890 |
هذا التوزيع مهم لأن robots.txt يُناقش كثيرًا وكأنه تصريح صغير:
User-agent: *
Disallow: /private/
هذه الصورة الذهنية غير صحيحة بالنسبة لجزء مهم من الويب عالي الزيارات.
في هذه البيانات:
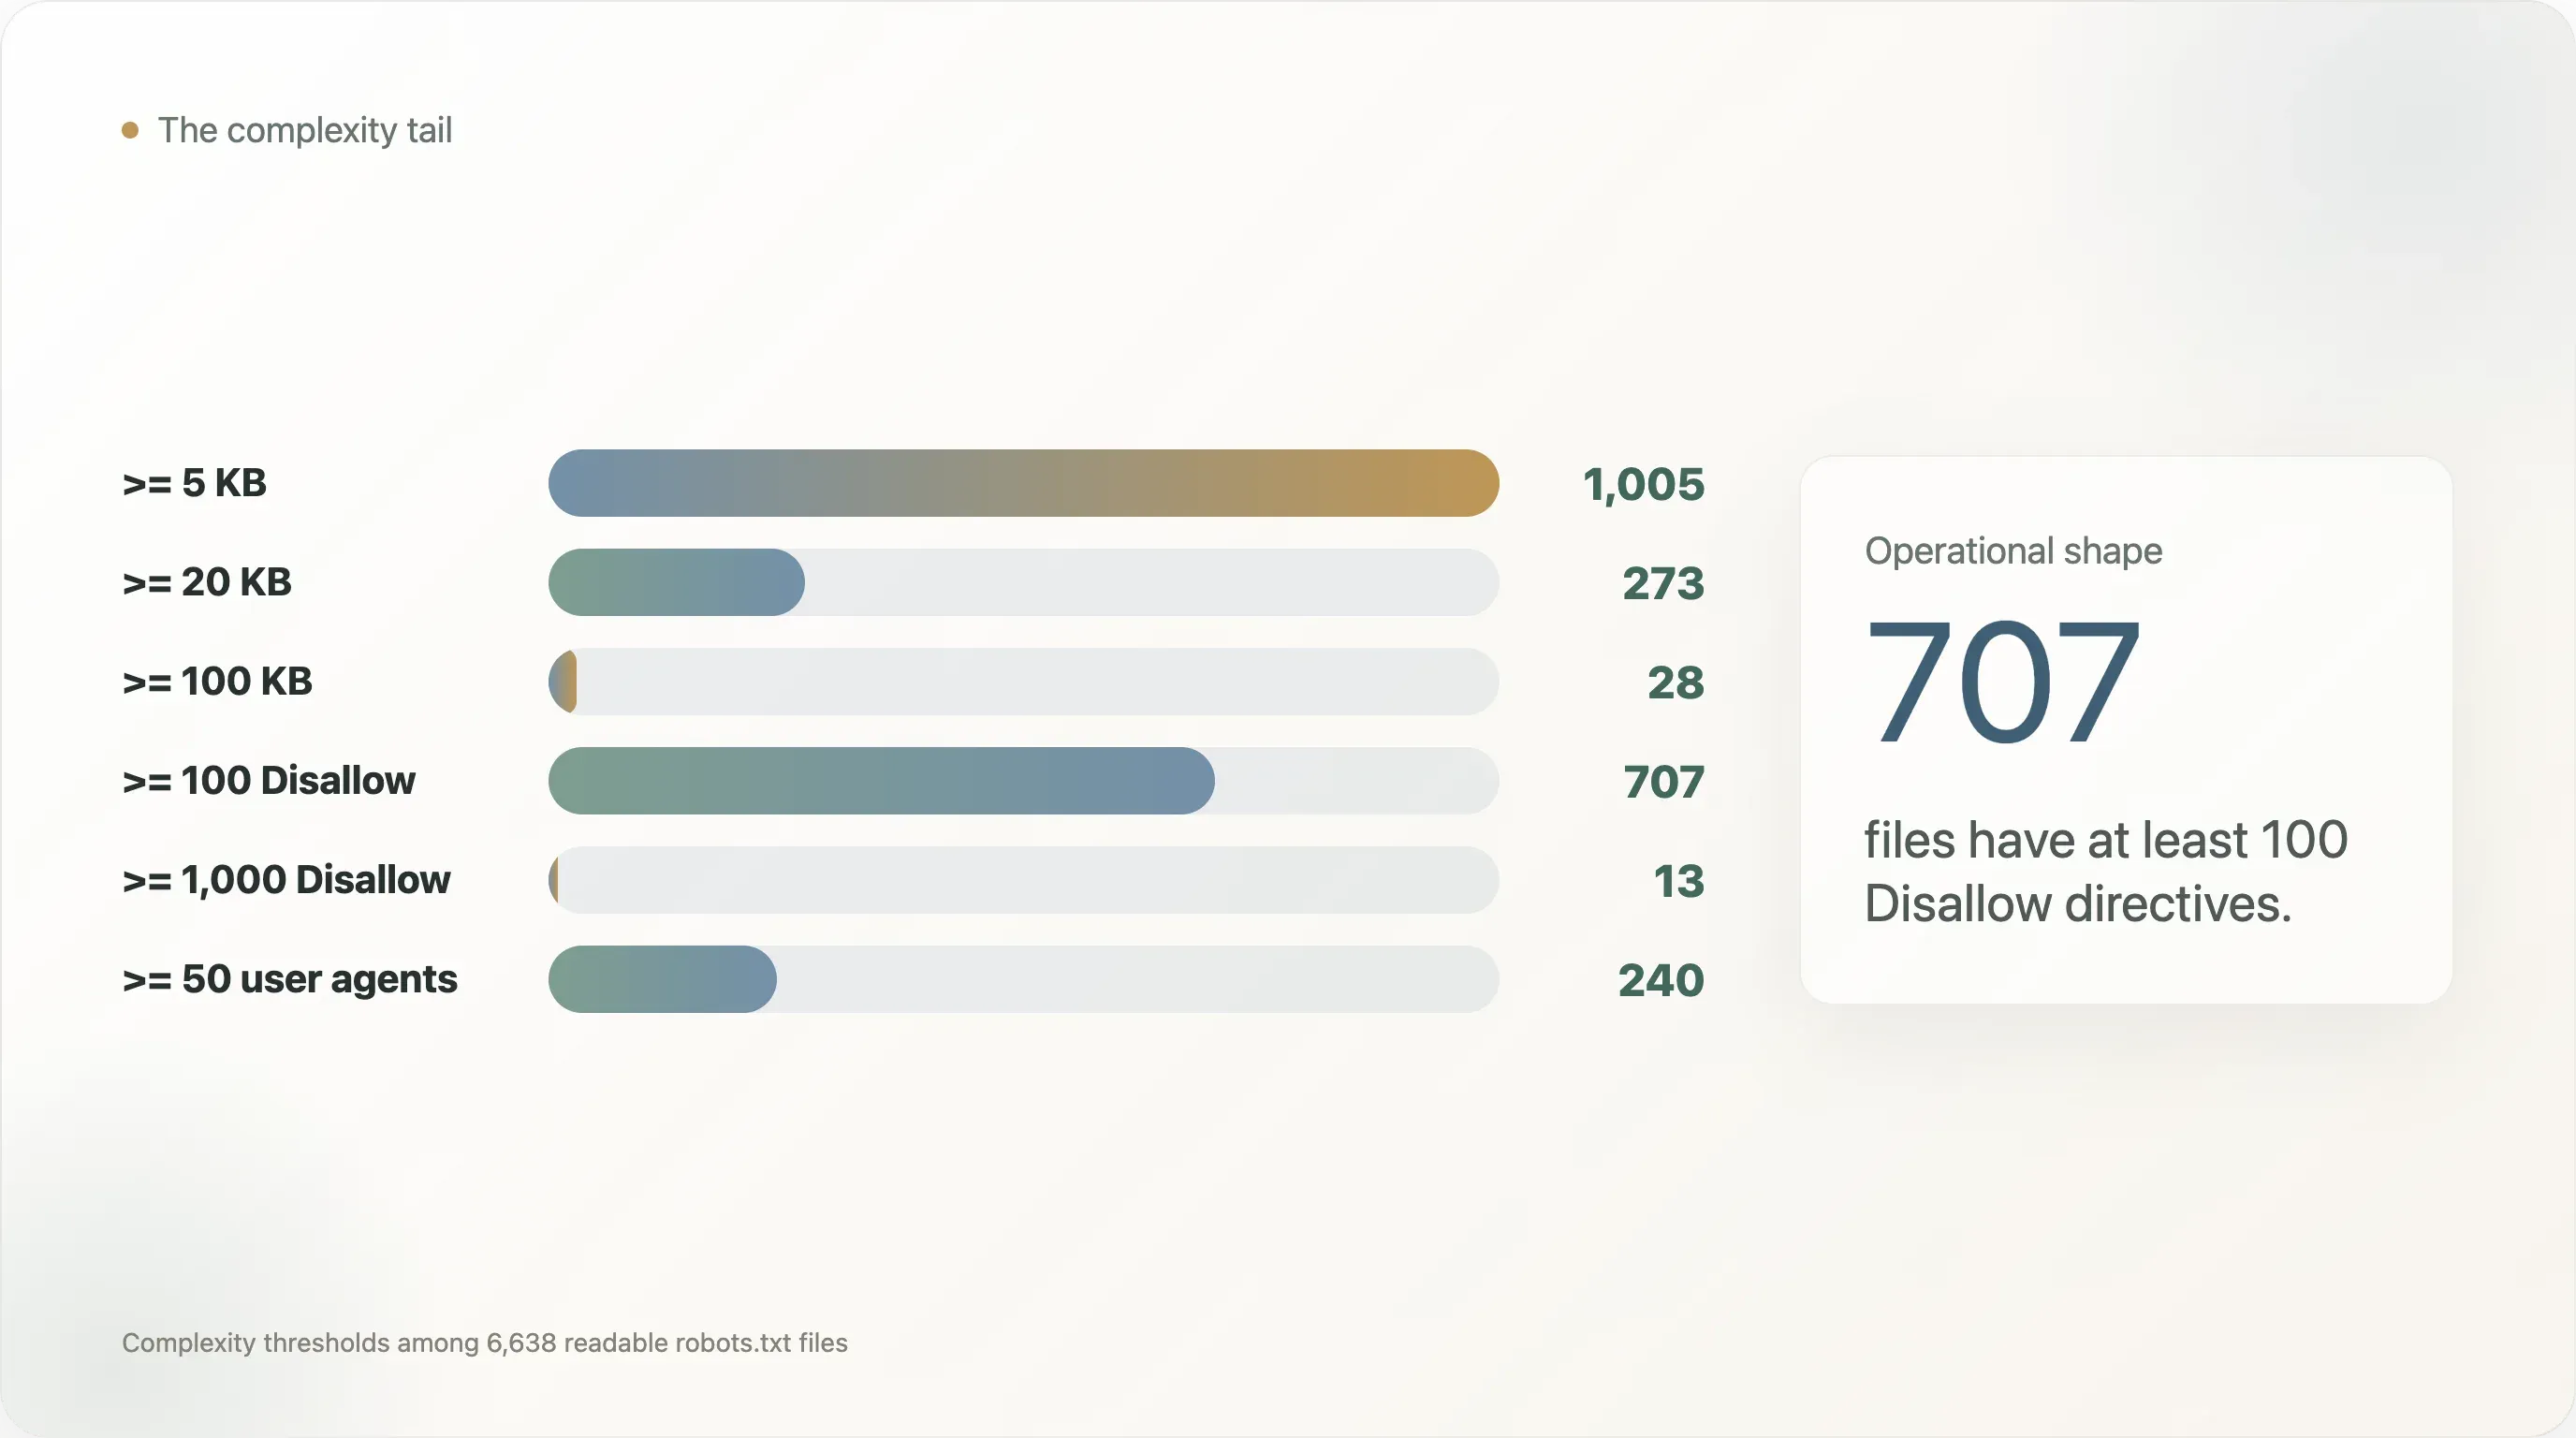
| عتبة التعقيد | المواقع |
|---|---|
robots.txt بحجم 5 كيلوبايت أو أكثر | 1,005 |
| 20 كيلوبايت أو أكثر | 273 |
| 100 كيلوبايت أو أكثر | 28 |
50 توجيه User-agent على الأقل | 240 |
100 توجيه User-agent على الأقل | 110 |
100 توجيه Disallow على الأقل | 707 |
1,000 توجيه Disallow على الأقل | 13 |
100 توجيه Allow على الأقل | 40 |
أكبر الملفات وأكثرها تعقيدًا ليست فضولًا أكاديميًا. إنها تخص مواقع حقيقية عالية الزيارات:
| النطاق | الترتيب | الفئة | البايتات | User-agent | Disallow | Allow |
|---|---|---|---|---|---|---|
linkedin.com | 17 | اجتماعي | 114,341 | 76 | 4,184 | 281 |
runescape.com | 5,226 | غير معروف | 113,393 | 1 | 4,997 | 0 |
academia.edu | 832 | أكاديمية | 57,384 | 63 | 2,044 | 227 |
etsy.com | 286 | تجارة إلكترونية | 51,320 | 3 | 1,621 | 120 |
thepaper.cn | 9,395 | أخبار | 56,867 | 1 | 1,496 | 0 |
opentable.com | 4,137 | غير معروف | 70,494 | 32 | 1,683 | 176 |
alfabank.ru | 2,625 | مالي | 73,158 | 2 | 1,566 | 133 |
هذه الملفات أقرب إلى جداول التوجيه الإنتاجية منها إلى الشعارات السياسية. إنها ترمز إلى سنوات من إطلاق المنتجات، والمسارات القديمة، وأنماط المعلمات المحظورة، والاستثناءات الخاصة بالزواحف، وتجارب SEO، وقرارات CDN، والآن قواعد زواحف الذكاء الاصطناعي.
الذيل ليس قصة ذكاء اصطناعي فقط. من بين 273 ملفًا بحجم 20 كيلوبايت أو أكثر، يحتوي 131 على لغة سياسة الذكاء الاصطناعي و142 لا تحتوي. ومن بين 707 ملفات فيها 100 توجيه Disallow على الأقل، 207 فقط تحتوي على لغة سياسة الذكاء الاصطناعي. بعبارة أخرى، الذكاء الاصطناعي لم يخلق مشكلة الملف الكبير. لقد جاء بعد سنوات من تشغيل الويب العادي التي ملأت الملف أصلًا بقواعد المسارات، وإشارات خرائط الموقع، واستثناءات الزواحف.
وهذا مهم لأن قابلية الصيانة تعتمد على الشكل، لا على النية فقط. ملف صغير يحظر الذكاء الاصطناعي مباشرة قد يكون سهل التدقيق. أما ملف تجارة إلكترونية أو سفر بحجم 70 كيلوبايت فقد يكون صعب التدقيق حتى لو لم يذكر الذكاء الاصطناعي إطلاقًا. الخطر ليس أن كل ملف كبير خاطئ. الخطر أن السياسة الفعلية قد تصبح معقدة لدرجة تعجز معها الجهة المسؤولة عن التحقق منها.
الخطر التشغيلي واضح: كلما نما robots.txt، أصبح من الأصعب على الناشر أو مهندس المنصة أو المحامي أو قائد SEO أن يجيب عن السؤال الأساسي: ماذا يسمح هذا الملف فعلًا؟
لم يعد هذا السؤال بسيطًا. فوفق قواعد تحليل على طراز RFC، قد يطابق الزاحف مجموعة وكيل مستخدم أكثر تحديدًا بدل User-agent: *؛ وقد تتجاوز مطابقة المسار الأطول الأقصر؛ وتتفاعل توجيهات Allow وDisallow حسب الأولوية؛ وقد تلتقط قواعد المنع العامة زواحف جديدة لم تكن موجودة عند كتابة الملف.
في ملف من 30 سطرًا، يمكن للإنسان أن يستنتج ذلك. أما في ملف من 4,000 سطر مع عشرات الروبوتات المسماة، فلا ينبغي لأحد أن يحاول ذلك يدويًا.
النتيجة 2: robots.txt يحمل أكثر من مجرد قواعد الزحف
جعل جدل زواحف الذكاء الاصطناعي robots.txt ظاهرًا سياسيًا، لكن الملف نفسه كان قد بدأ أصلًا بتراكم مسؤوليات لا علاقة لها بالزحف وحده.
يمكن أن يحتوي ملف robots.txt الحديث لموقع كبير على:
- عناصر تحكم في مسارات الزحف؛
- اكتشاف خرائط الموقع؛
- امتدادات خاصة بمحركات البحث؛
- تلميحات لمعدل الزحف؛
- تلميحات لتوحيد المضيف؛
- تلميحات لتنظيف معلمات URL؛
- مفردات سياسة تضعها CDN؛
- نصوص تحفظ حقوق النشر؛
- حالات انسحاب من تدريب الذكاء الاصطناعي؛
- تعليقات قانونية مقروءة للبشر.
تُظهر البيانات هذا التراكب بوضوح.
| الإشارة | الملفات | النسبة من الملفات القابلة للقراءة |
|---|---|---|
Crawl-delay | 685 | 10.3% |
Host | 303 | 4.6% |
Clean-param | 200 | 3.0% |
Content-Signal | 271 | 4.1% |
Request-rate | 9 | 0.1% |
Visit-time | 5 | 0.1% |
ذكر llms.txt | 83 | 1.3% |
| لغة حقوق النشر أو الشروط أو الترخيص أو الإذن | 719 | 10.8% |
| لغة سياسة الذكاء الاصطناعي | 1,377 | 20.7% |
بعض هذه التوجيهات معروفة جيدًا لدى زواحف محددة. وبعضها اتفاقيات قديمة. وبعضها خاص بالمورّد. وبعضها ليس توجيهات زواحف أصلًا، بل لغة قانونية أو منتجية داخل التعليقات.
هذه هي صورة انحراف البروتوكول.
يُعد Crawl-delay مثالًا مفيدًا. فهو مألوف لكثير من مشغلي المواقع، لكن دعمه غير متسق عبر الزواحف الكبرى. تاريخيًا ارتبط Host وClean-param بسلوك Yandex. أما Content-Signal فهو جزء من مفردات سياسة Cloudflare في عصر الذكاء الاصطناعي. وllms.txt تنسيق مجاور مقترح للاكتشاف، وليس معيارًا يُحترم عالميًا. ومع ذلك تظهر كلها في النوع نفسه من الملفات، وغالبًا بجوار قواعد User-agent وDisallow الكلاسيكية.
وتُظهر الأرقام أيضًا كيف تتعايش الاتفاقيات القديمة والجديدة الآن. يظهر Crawl-delay في 685 ملفًا، أي أكثر من ضعفي 271 ملفًا التي تحتوي على Content-Signal. ويظهر Host في 303 ملفات وClean-param في 200، وهو ما يعكس أساسًا اتفاقيات حقبة محركات البحث. أما llms.txt، رغم النقاش الكبير حوله في أوساط البحث بالذكاء الاصطناعي، فلا يُذكر إلا في 83 ملفًا قابلًا للقراءة. الويب الحي لا يتقارب على مفردات واحدة. بل يكدّس المفردات فوق بعضها.
المشكلة ليست أن أي امتداد منفرد خاطئ. المشكلة أن الملف أصبح حاوية غير مؤرخة لعدة أنظمة حوكمة متداخلة.
وهذا يخلق ثلاثة أنواع من الدين:
- دين دلالي. قد تفسر زواحف مختلفة الملف نفسه بطرق مختلفة.
- دين ملكية. قد تكون لدى فرق SEO والقانون والبنية التحتية والأمن والمنتج أسباب لتعديل الملف، لكن قد لا تكون هناك جهة واحدة تملك السياسة كاملة.
- دين تدقيقي. قد ينشر الموقع سياسة تبدو مقصودة بينما لا يحدد السلوك الفعلي إلا المفسّر الآلي.
يزداد هذا أهمية مع الذكاء الاصطناعي لأن الرهانات تغيرت. عندما يُتجاهل تلميح قديم لمعدل الزحف، قد تكون النتيجة مجرد حركة مرور إضافية. أما عندما يكون انسحاب تدريب الذكاء الاصطناعي غامضًا، فقد يصبح دليلًا في نزاع حقوق نشر أو ترخيص.
النتيجة 3: أصبح الملف واجهة آلية ومادة قانونية في آن واحد
أظهر تقرير زواحف الذكاء الاصطناعي الأصلي أن 17.0% من المواقع القابلة للتحليل كانت قد كتبت قواعد صريحة خاصة بالذكاء الاصطناعي. ينظر هذا التقرير اللاحق في العبء النصي الذي تضيفه تلك السياسات.
من بين ملفات robots.txt الـ 6,638 القابلة للقراءة:
- 1,377 تحتوي على لغة سياسة الذكاء الاصطناعي؛
- 719 تحتوي على لغة حقوق النشر أو الشروط أو الترخيص أو الحقوق أو الإذن؛
- 271 تحتوي على
Content-Signal؛ - 83 تذكر
llms.txt.
أما التداخل فهو ما يجعل القصة أكثر إثارة للاهتمام:
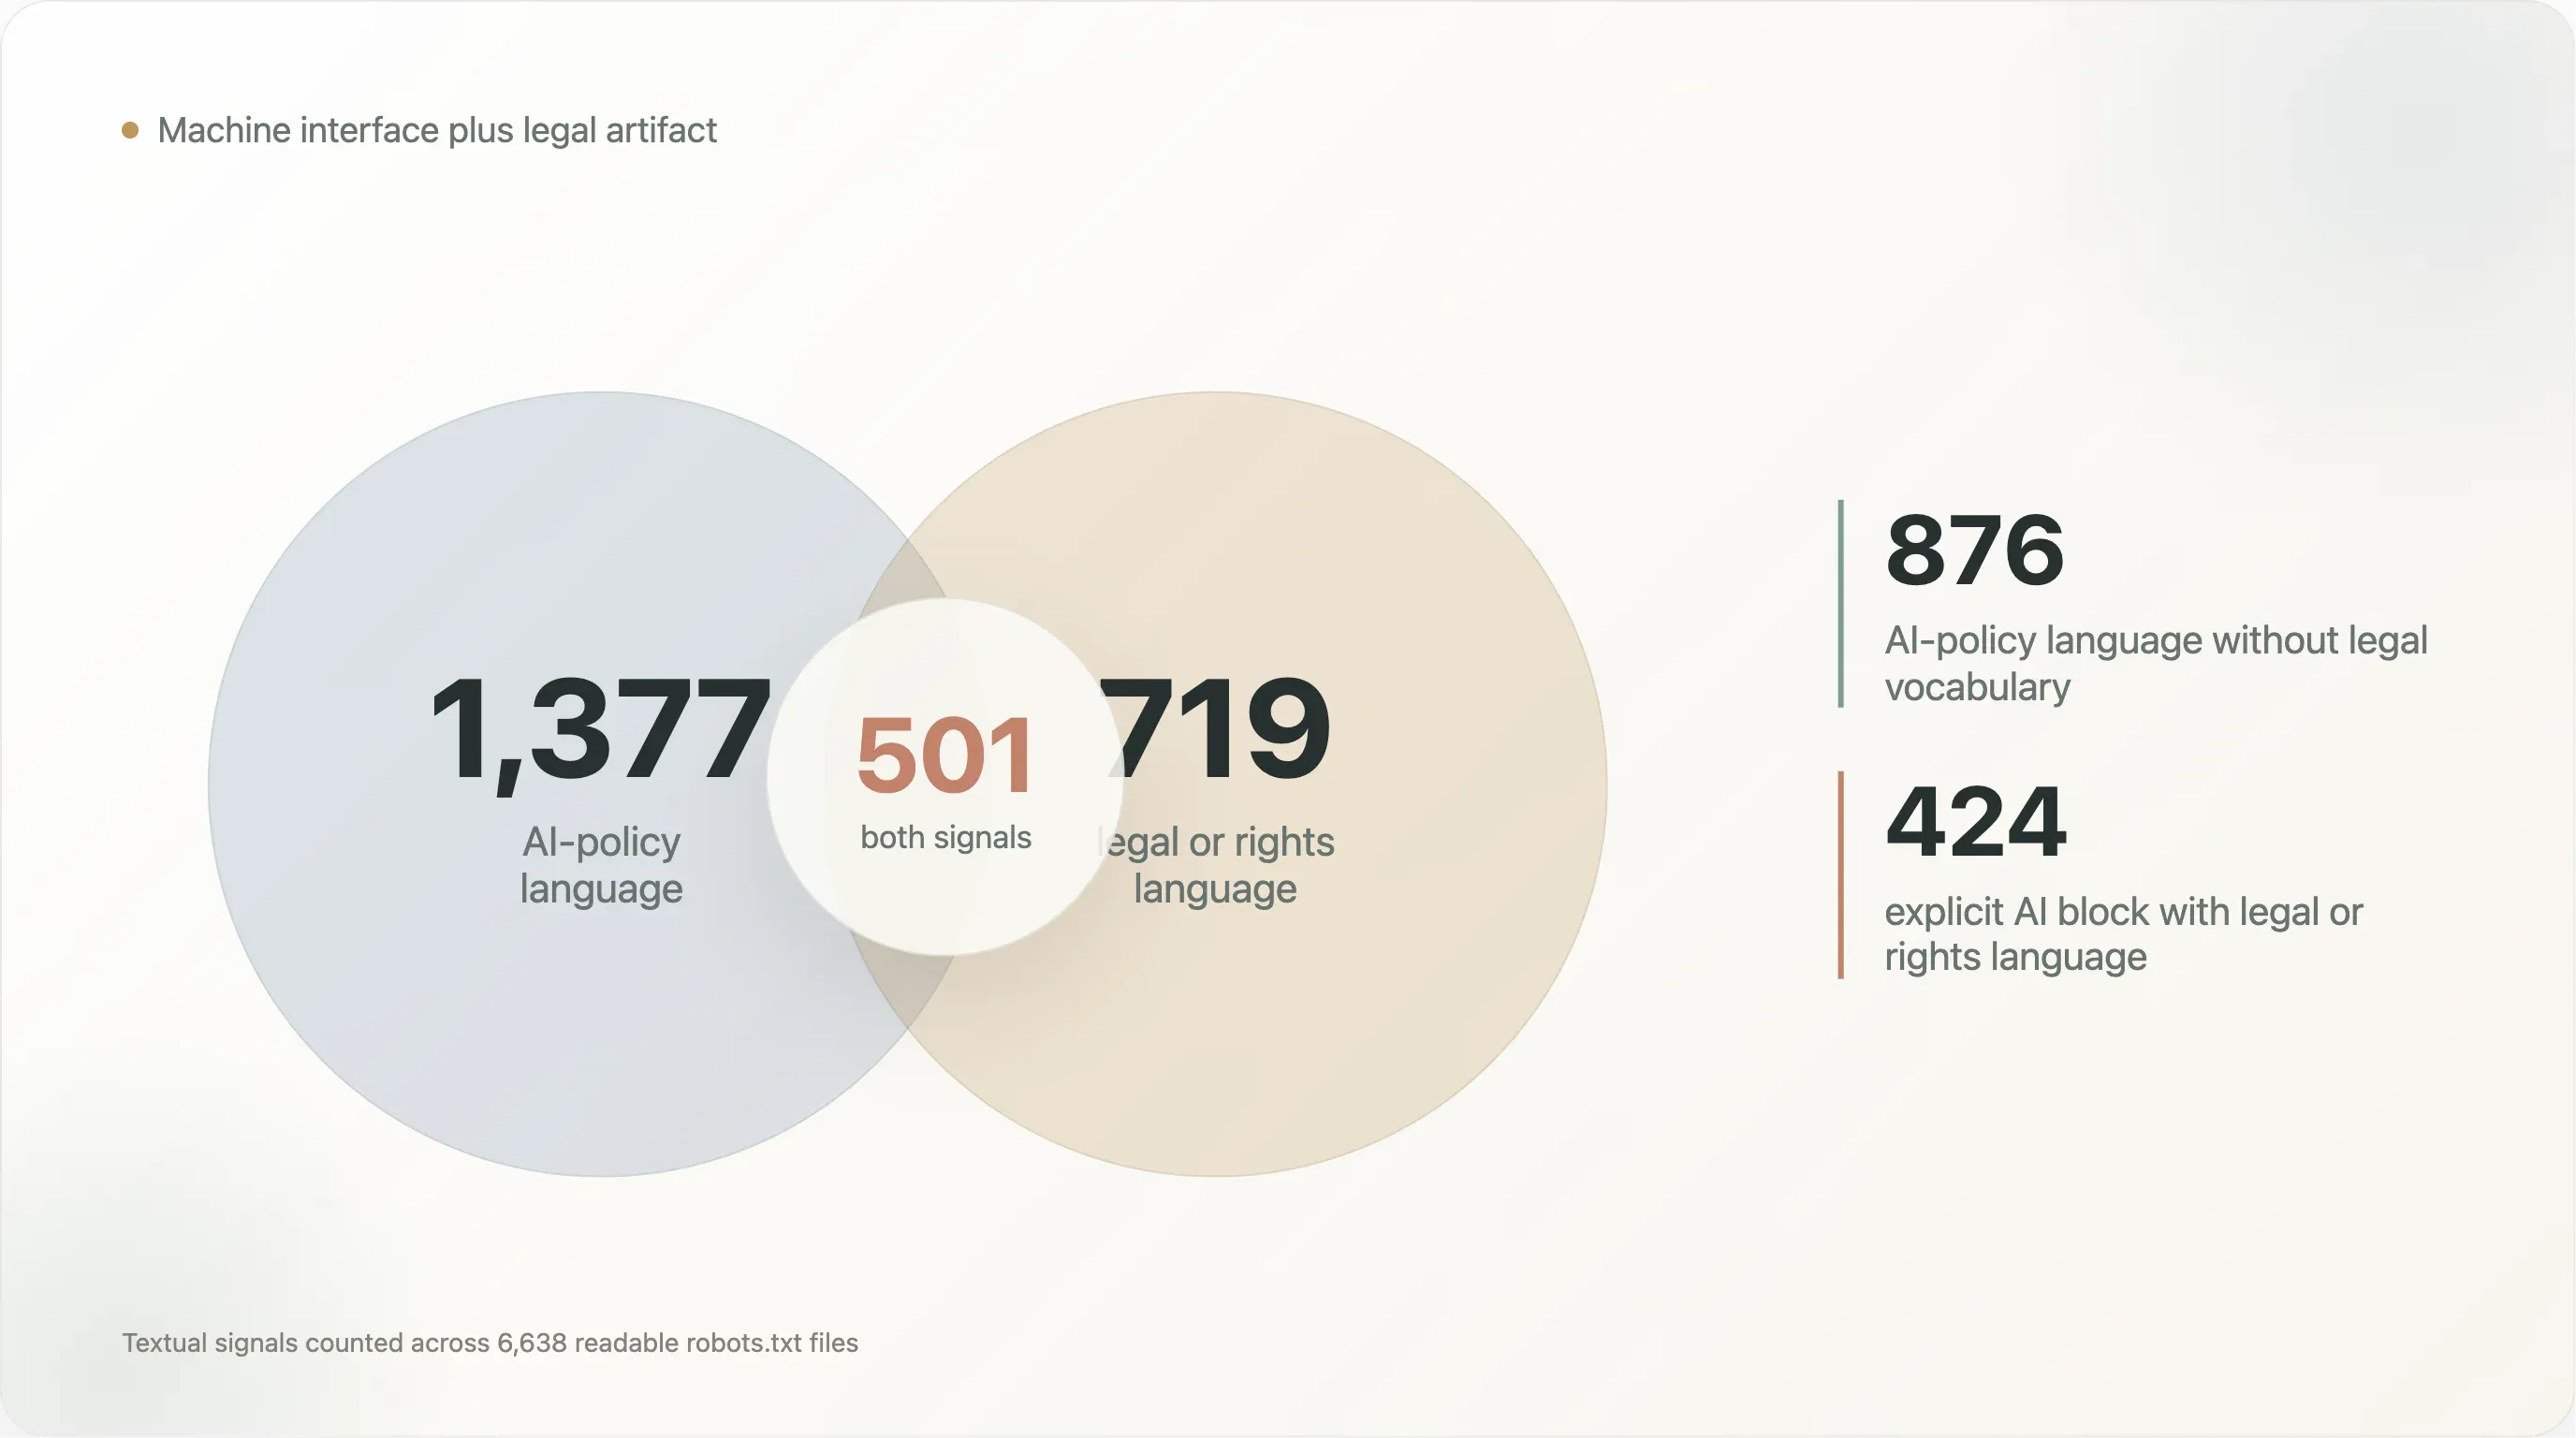
| النمط النصي | الملفات |
|---|---|
| لغة سياسة الذكاء الاصطناعي ولغة قانونية/حقوقية | 501 |
| لغة سياسة الذكاء الاصطناعي من دون لغة قانونية/حقوقية | 876 |
| لغة قانونية/حقوقية من دون لغة سياسة ذكاء اصطناعي | 218 |
Content-Signal مع لغة قانونية/حقوقية | 242 |
| حظر صريح للذكاء الاصطناعي مع لغة قانونية/حقوقية | 424 |
هذا نوع جديد من الملفات.
ملف robots.txt التقليدي موجّه إلى الزواحف. أما ملف robots.txt ذي المقدمة القانونية فهو موجّه إلى ما لا يقل عن أربعة جماهير في وقت واحد:
- مشغلي الزواحف، الذين يحتاجون إلى توجيهات قابلة للقراءة الآلية؛
- بائعي البحث والذكاء الاصطناعي، الذين يحتاجون إلى إشارات سياسة؛
- المحامين، الذين يريدون تحفظًا صريحًا على الحقوق؛
- المدققين أو القضاة أو الصحفيين المستقبليين، الذين قد يقرأون التعليقات بوصفها دليلًا على النية.
هذا التصميم متعدد الجمهور يفسر لماذا تبدو بعض الملفات الآن كوثائق سياسة. لكنه أيضًا يضعف الفصل النظيف بين ما يمكن للزاحف تحليله وما يريد المحامي البشري التصريح به.
الملفات الـ 876 التي تحتوي على لغة سياسة الذكاء الاصطناعي من دون مفردات قانونية هي في معظمها ملفات سياسة آلية: أسماء روبوتات، وكتل Disallow، ولغة قوالب. أما الملفات الـ 501 التي تجمع الذكاء الاصطناعي واللغة القانونية فهي مختلفة. إنها تحاول أن تكون تعليمات زحف وتحفظات حقوق في الوقت نفسه. والملفات الـ 218 التي تحتوي على لغة قانونية من دون مفردات ذكاء اصطناعي تُظهر أن هذا النمط لم يبدأ مع LLMs؛ فقد استُخدم robots.txt بالفعل كمكان لذكر الشروط، وحدود الإذن، وادعاءات الحقوق.
على سبيل المثال، قد تقول ملاحظة تعليق إن التعلم الآلي محظور، بينما لا تحظر الكتلة الفعلية إلا مجموعة فرعية من وكلاء المستخدم المعروفين. وقد يعلن موقع ما حقوقه بشكل شامل لكنه يذكر قلة من الزواحف فقط. وقد تُدرج قالب CDN مفردات مرتبطة بالذكاء الاصطناعي في ملف لم يكتب مشغّله لغته القانونية يدويًا. وقد يكتب موقع ما قاعدة عامة User-agent: * تحظر زواحف مستقبلية على غير قصد.
من منظور الحوكمة، أصبح robots.txt جذابًا تحديدًا لأنه علني وقابل للقراءة آليًا. لكن كلما زادت السياسة التي يحملها، زادت أهمية حدوده:
- لا توجد طبقة مصادقة تثبت أن سياسة معينة راجعها صاحب الحقوق بدلًا من أن تكون موروثة من البنية التحتية.
- لا يوجد سجل إصدارات أصلي.
- لا يوجد حقل منظم يعبّر عن الاستخدام المقصود، مثل التدريب أو الاسترجاع أو الفهرسة أو التلخيص أو التخزين المؤقت أو تقييم النموذج.
- لا يوجد سجل عالمي لهويات زواحف الذكاء الاصطناعي.
- لا توجد آلية إنفاذ.
هذا لا يجعل الملف عديم الفائدة. بل يجعله هشًا.
والتفسير الأفضل هو أن robots.txt يتحول إلى طبقة إشعار: إعلان عام قابل للفحص عن التفضيل والنية. لكنه ليس، بحد ذاته، نظامًا كاملًا لإدارة الحقوق.
النتيجة 4: كان البحث غير متساوٍ بالفعل قبل وصول الذكاء الاصطناعي
إحدى أقوى نتائج التقرير الأصلي كانت أن كثيرًا من الناشرين يميزون بين زواحف تدريب الذكاء الاصطناعي وزواحف البحث. فهم يحجبون CCBot أو GPTBot أو Google-Extended مع الحفاظ على ظهورهم في بحث Google.
هذا التقرير يضيف نقطة مختلفة: زواحف البحث التقليدية نفسها لا تُعامل على قدم المساواة.
فحصنا ستة زواحف بحث:
- Googlebot؛
- Bingbot؛
- DuckDuckBot؛
- Slurp؛
- Baiduspider؛
- YandexBot.
عبر المواقع الـ 7,248 القابلة للتحليل:
| معاملة زاحف البحث | المواقع |
|---|---|
| يحجب زاحف بحث واحدًا على الأقل | 562 |
| يسمح لـ Googlebot لكنه يحجب زاحف بحث آخر واحدًا على الأقل | 404 |
| يحجب زواحف البحث الستة كلها قيد الفحص | 152 |
ليست أعداد الزواحف المحجوبة موزعة بالتساوي:
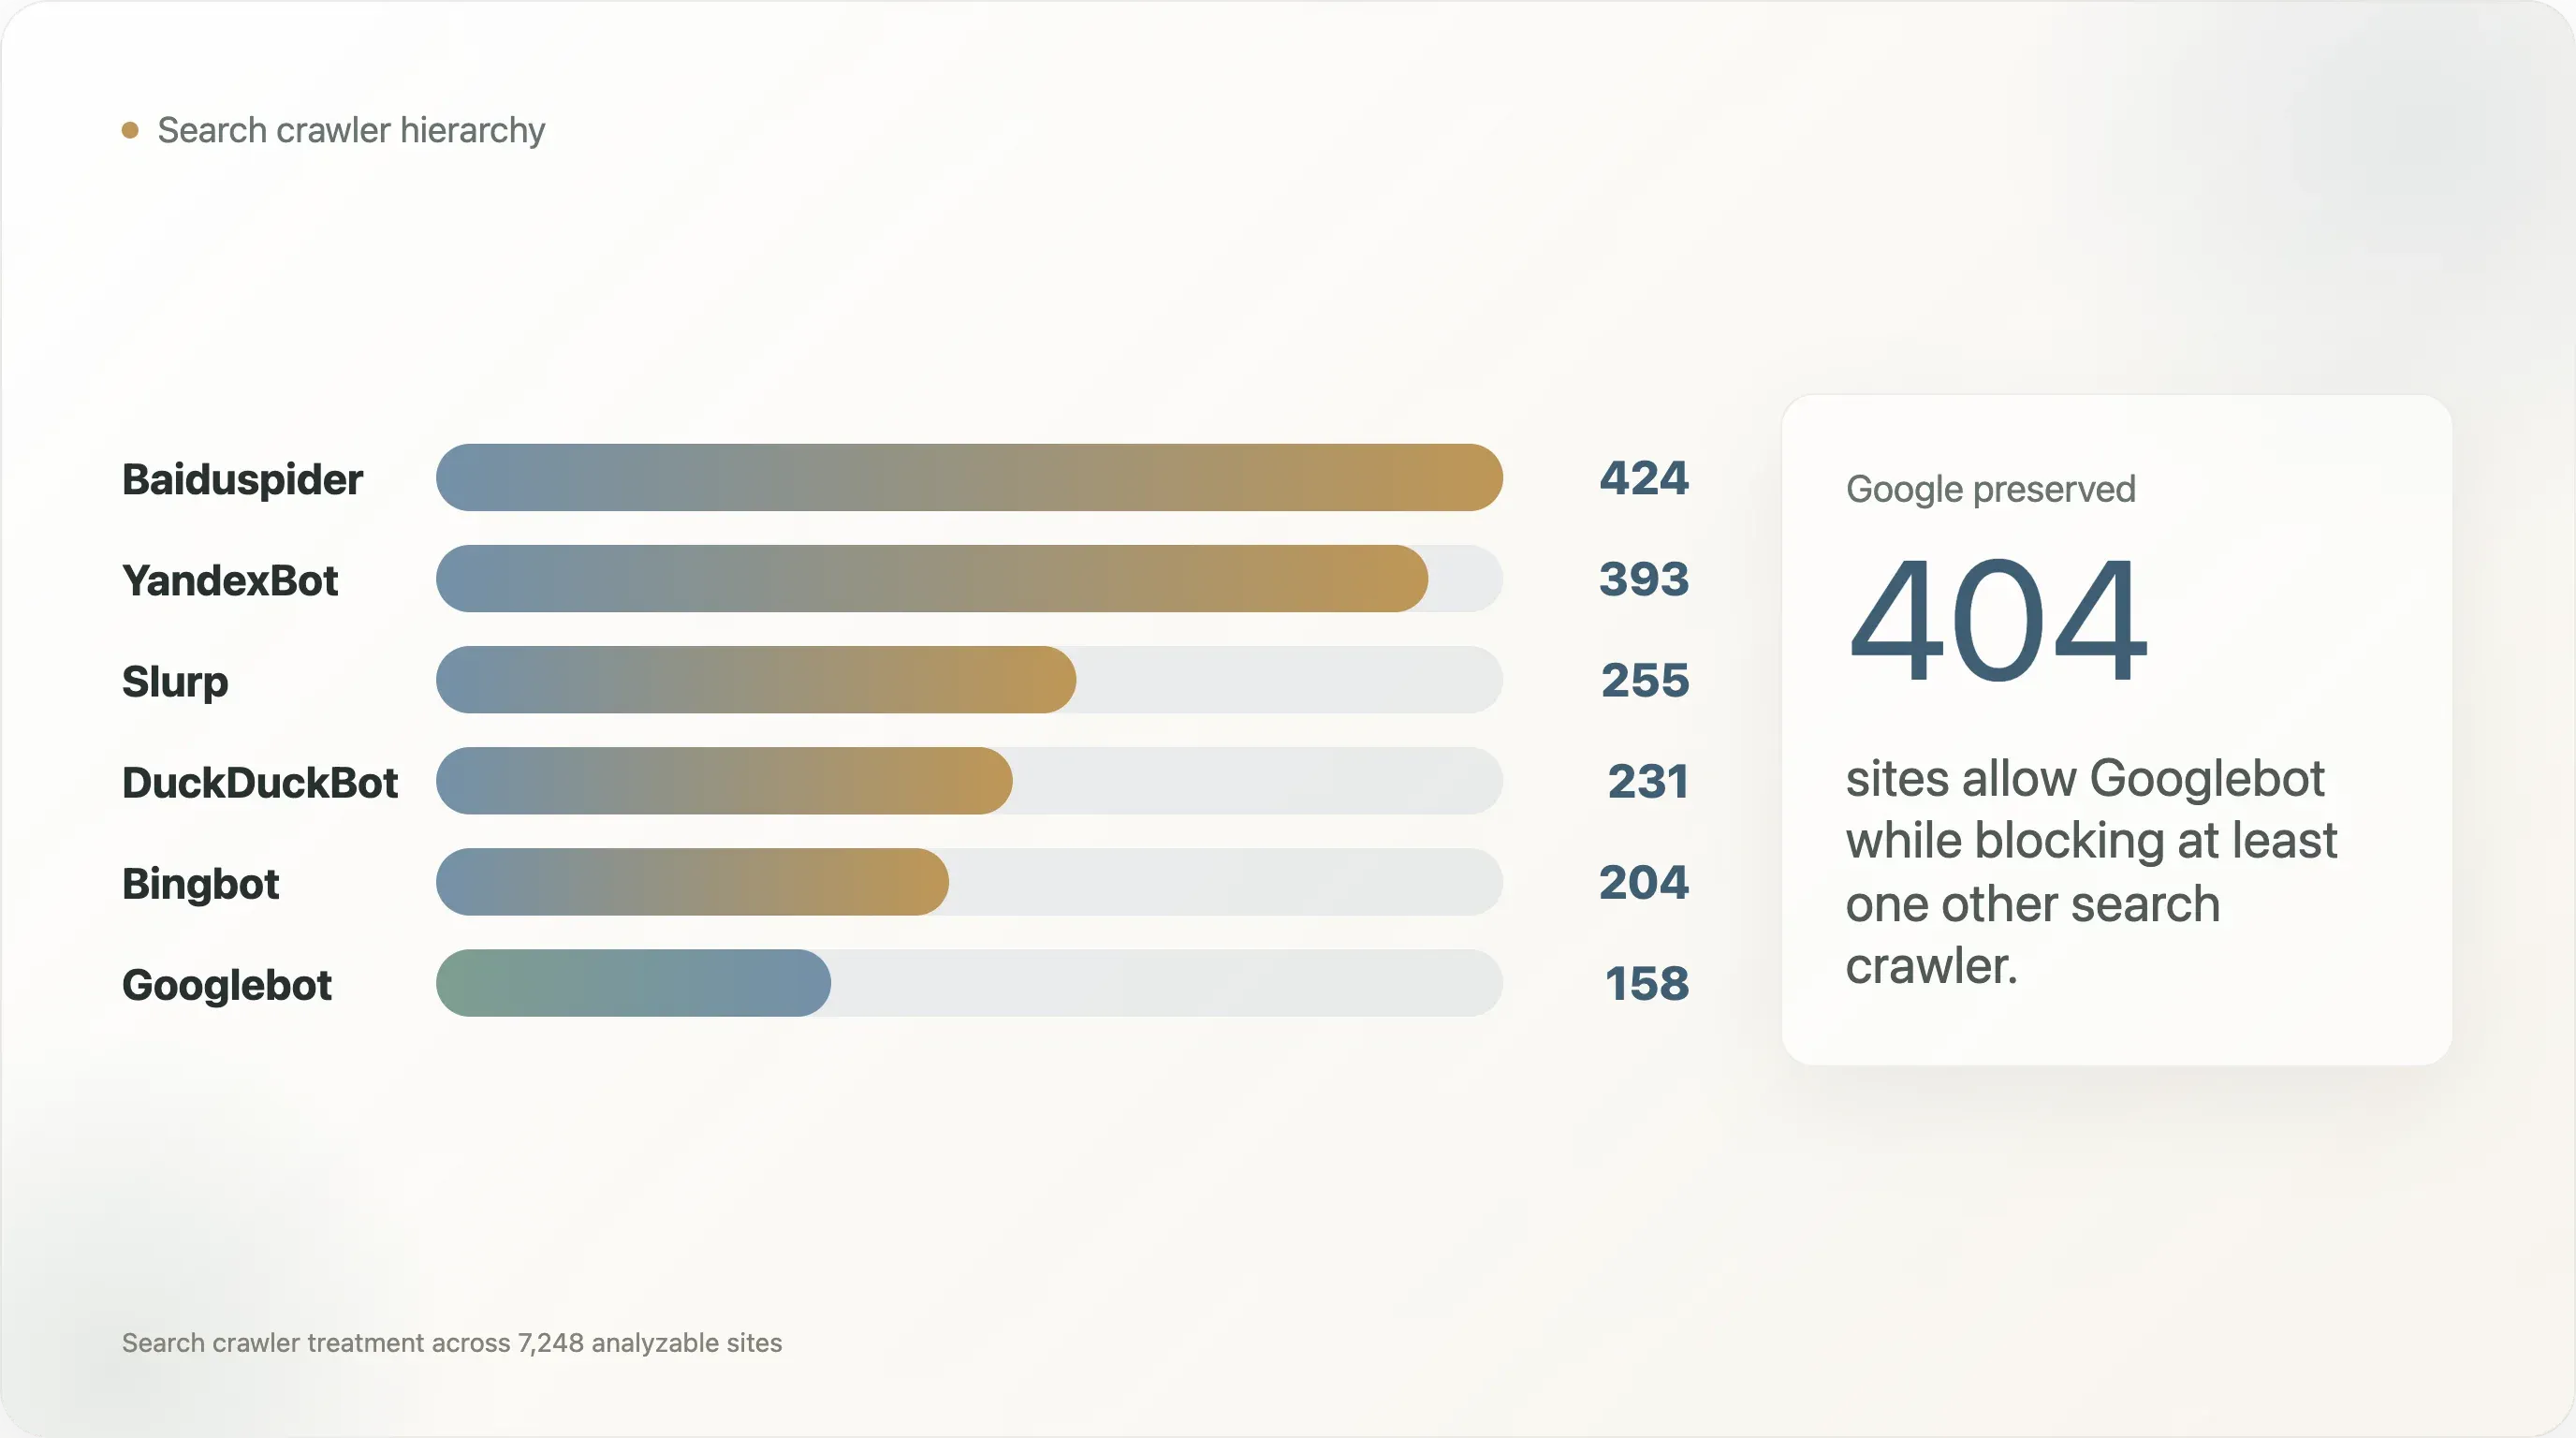
| زاحف البحث | المواقع التي تحجبه |
|---|---|
| Baiduspider | 424 |
| YandexBot | 393 |
| Slurp | 255 |
| DuckDuckBot | 231 |
| Bingbot | 204 |
| Googlebot | 158 |
Googlebot هو الزاحف الأقل حجبًا في هذه المجموعة. بينما يُحجب Baiduspider وYandexBot كثيرًا، وفي معظم تلك الحالات يبقى Googlebot مسموحًا. ومن بين 404 موقعًا تسمح لـ Googlebot بينما تحجب زاحف بحث آخر، يحجب 269 منها Baiduspider و240 تحجب YandexBot.
الأمثلة رفيعة المستوى:
| النطاق | زواحف البحث المحجوبة مع السماح لـ Googlebot |
|---|---|
facebook.com | Baiduspider, YandexBot |
apple.com | Baiduspider |
twitter.com | DuckDuckBot, Slurp, Baiduspider, YandexBot |
netflix.com | DuckDuckBot, Slurp |
x.com | DuckDuckBot, Slurp, Baiduspider, YandexBot |
tiktok.com | Baiduspider |
baidu.com | Bingbot, DuckDuckBot, Slurp, YandexBot |
washingtonpost.com | YandexBot |
wsj.com | YandexBot |
bilibili.com | DuckDuckBot, Slurp, YandexBot |
temu.com | Slurp |
t-mobile.com | Baiduspider, YandexBot |
وهذا مهم في جدل الذكاء الاصطناعي لأنه يبيّن أن robots.txt لم يكن بروتوكول وصول عام محايدًا حتى قبل وصول زواحف نماذج اللغة الكبيرة. كان للويب العام بالفعل تسلسل هرمي:
- غالبًا ما يُحافَظ على Googlebot لأن حركة بحث Google ذات قيمة كبيرة يصعب المخاطرة بها.
- يسهل حجب الزواحف الإقليمية أو التنافسية.
- بعض المواقع تتعامل مع الوصول من الزواحف باعتباره قرارًا حسب السوق أو المورّد.
دخلت زواحف الذكاء الاصطناعي إلى نظام بيئي كان فيه الوصول التفاضلي أمرًا طبيعيًا بالفعل.
وهذا يجعل انتقال السياسة أسهل فهمًا. فالناشر الذي يكتب "احجب Google-Extended، واسمح لـ Googlebot" لا يخترع شكلًا جديدًا من التمييز. إنه يطبّق نمطًا قديمًا على فئة جديدة من الزواحف: حافظ على التوزيع، وقيّد الاستخراج.
السؤال غير المحسوم هو ما إذا كان هذا النمط القديم قابلًا للتوسع. مع البحث، لم يكن هناك سوى عدد محدود من الزواحف المهمة اقتصاديًا. أما مع الذكاء الاصطناعي، فتتجزأ هوية الزاحف عبر موردي النماذج، وروبوتات الاسترجاع، وسماسرة البيانات، والزواحف الأكاديمية، ووكلاء المتصفح الاصطناعي، وجالبي البيانات على مستوى البنية التحتية. سيواصل عدد وكلاء المستخدم المسماة النمو ما لم يتوحد النظام البيئي حول مجموعة أصغر من الإشارات المبنية على الغرض.
هكذا يتفاقم دين الإعدادات.
النتيجة 5: يختلف التعقيد باختلاف القطاع، لكن ليس بالطريقة نفسها التي تختلف بها معدلات حظر الذكاء الاصطناعي
أظهر التقرير الأصلي تباينًا كبيرًا بين القطاعات في حظر الذكاء الاصطناعي: الأخبار تحجب بمعدلات مرتفعة؛ بينما الاتصالات والحكومة وSaaS تحجب بمعدلات منخفضة.
أما تعقيد الإعداد فيقطع الويب بطريقة مختلفة.
من بين الفئات المختارة التي لديها ما يكفي من ملفات robots.txt القابلة للقراءة للمقارنة المفيدة:
| الفئة | n | الوسيط بالبايت | P90 بالبايت | وسيط Disallow | P90 Disallow | وسيط User-agent | P90 User-agent |
|---|---|---|---|---|---|---|---|
| تجارة إلكترونية | 215 | 1,738 | 10,388 | 37 | 164 | 3 | 49 |
| سفر | 63 | 2,074 | 27,368 | 41 | 779 | 5 | 34 |
| أخبار | 647 | 1,534 | 7,039 | 19 | 114 | 6 | 68 |
| مالي | 121 | 1,002 | 8,337 | 17 | 132 | 2 | 23 |
| أكاديمية | 253 | 839 | 3,959 | 14 | 75 | 1 | 11 |
| حكومة | 151 | 1,227 | 3,263 | 13 | 46 | 1 | 4 |
| SaaS | 368 | 485 | 12,606 | 4 | 56 | 1 | 10 |
| أدوات التطوير | 119 | 273 | 9,255 | 3 | 58 | 1 | 10 |
P90 Disallow by category chart here<<<<<<<<<<<<<<<<<<<<<<<<<
الأخبار معقدة سياسيًا لأنها تكتب قواعد صريحة للذكاء الاصطناعي ونصوصًا قانونية. لكن التجارة الإلكترونية والسفر معقدتان تشغيليًا لأن لديهما كتالوجات كبيرة، وتنقلًا مجزأً، وصفحات نتائج البحث، وفلاتر، ومسارات حسابات المستخدم، وعناوين URL مع معلمات.
هذا التمييز مهم.
السفر هو أوضح مثال. لديه فقط 63 ملفًا قابلًا للقراءة في هذه الشريحة من الفئة، لكن P90 لـ robots.txt فيه يبلغ 27.4 كيلوبايت وP90 لعدد Disallow فيه يبلغ 779، وهو أعلى بكثير من الأخبار. هذا لا يعني أن مواقع السفر لديها سياسة ذكاء اصطناعي أكثر تطورًا. بل يعني أن لديها أسطحًا أكثر يمكن لمشغلي الزحف أن يهدروا ميزانيتهم عليها: عمليات البحث حسب التاريخ، وصفحات الإتاحة، وتكرار صفحات المراجعات، ومسارات الحجز، وتوليفات الفلاتر، ومسارات المخزون المحلية.
أما SaaS فهو المفاجأة من النوع الآخر. فالملف الوسيط لديه 485 بايت فقط، لكن ملف P90 يقفز إلى 12.6 كيلوبايت. معظم مواقع SaaS مفتوحة وخفيفة؛ بينما يحمل عدد أصغر ملفات تحكم طويلة بالمسارات، غالبًا لأن التوثيق، ومسارات تسجيل الدخول، ومسارات التطبيق، وصفحات التسويق تعيش تحت النطاق نفسه.
الأخبار تقع في الوسط تشغيليًا لكنها في القمة سياسيًا. عدد وكلاء المستخدم P90 فيها هو 68، وهو أعلى من التجارة الإلكترونية والسفر والمال والأكاديميا والحكومة وSaaS وأدوات التطوير في هذا الجدول. وهذه علامة على سياسة خاصة بالروبوتات، لا مجرد نظافة في المسارات.
قد يكون robots.txt لدار نشر معقدًا بسبب سياسة الحقوق. وقد يكون ملف السوق معقدًا بسبب إدارة ميزانية الزحف. وقد يكون ملف الجامعة معقدًا لأن آلاف المسارات القديمة تراكمت تحت نطاق واحد. وقد يكون ملف المنصة الاجتماعية معقدًا لأنها تحتاج إلى إظهار بعض الأسطح وإخفاء أخرى على نطاق هائل.
تأتي سياسة الذكاء الاصطناعي فوق كل ذلك. إنها لا تستبدل الأسباب القائمة لتعقيد الملف.
وهذا يساعد على تفسير لماذا لا يمكن حل حوكمة robots.txt في عصر الذكاء الاصطناعي بقائمة حظر عامة واحدة. فالملفات الأساسية لها وظائف مختلفة:
- مواقع التجارة الإلكترونية تدير المسارات المكررة وأسطح المخزون؛
- مواقع السفر تدير القوائم والتقويمات والمراجعات وصفحات البحث الديناميكية؛
- مواقع الأخبار تدير حقوق النشر والأرشيفات ووضع الترخيص؛
- مواقع SaaS وأدوات التطوير غالبًا ما تريد ظهورًا في الذكاء الاصطناعي؛
- الحكومات غالبًا ما تحتاج إلى وصول عام لكنها قد تظل تملك أنظمة حساسة ينبغي استبعادها؛
- المنصات الاجتماعية تدير المحتوى الذي ينشئه المستخدمون، وأسطح الملفات الشخصية، ومخاوف مكافحة الإساءة.
قاعدة زاحف ذكاء اصطناعي واحدة تعني أشياء مختلفة في كل بيئة.
النتيجة 6: مؤشر دين الإعدادات يحدد خطر المراجعة، لا الفشل الأخلاقي
أجرى هذا التحليل مؤشرًا بسيطًا لدَين الإعدادات لتحديد ملفات robots.txt التي يُرجح أن تكون صعبة المراجعة.
ويعطي المؤشر وزنًا لـ:
- حجم الملف؛
- عدد توجيهات
User-agent؛ - عدد توجيهات
Disallow؛ - عدد توجيهات
Allow؛ - عدد التوجيهات غير الأساسية؛
- وجود لغة سياسة الذكاء الاصطناعي؛
- مزيج الحظر الصريح للذكاء الاصطناعي واللغة القانونية أو حقوق النشر.
هذا ليس مؤشر صحة أو صواب. قد يكون الملف شديد التعقيد مقصودًا تمامًا. وقد يكون الملف البسيط خاطئًا أيضًا. الهدف هو الفرز: إذا كان الملف كبيرًا، ومثقلًا بالسياسات، ومحددًا للروبوتات، ومليئًا بالاستثناءات، فهو يستحق انضباطًا أقوى في المراجعة.
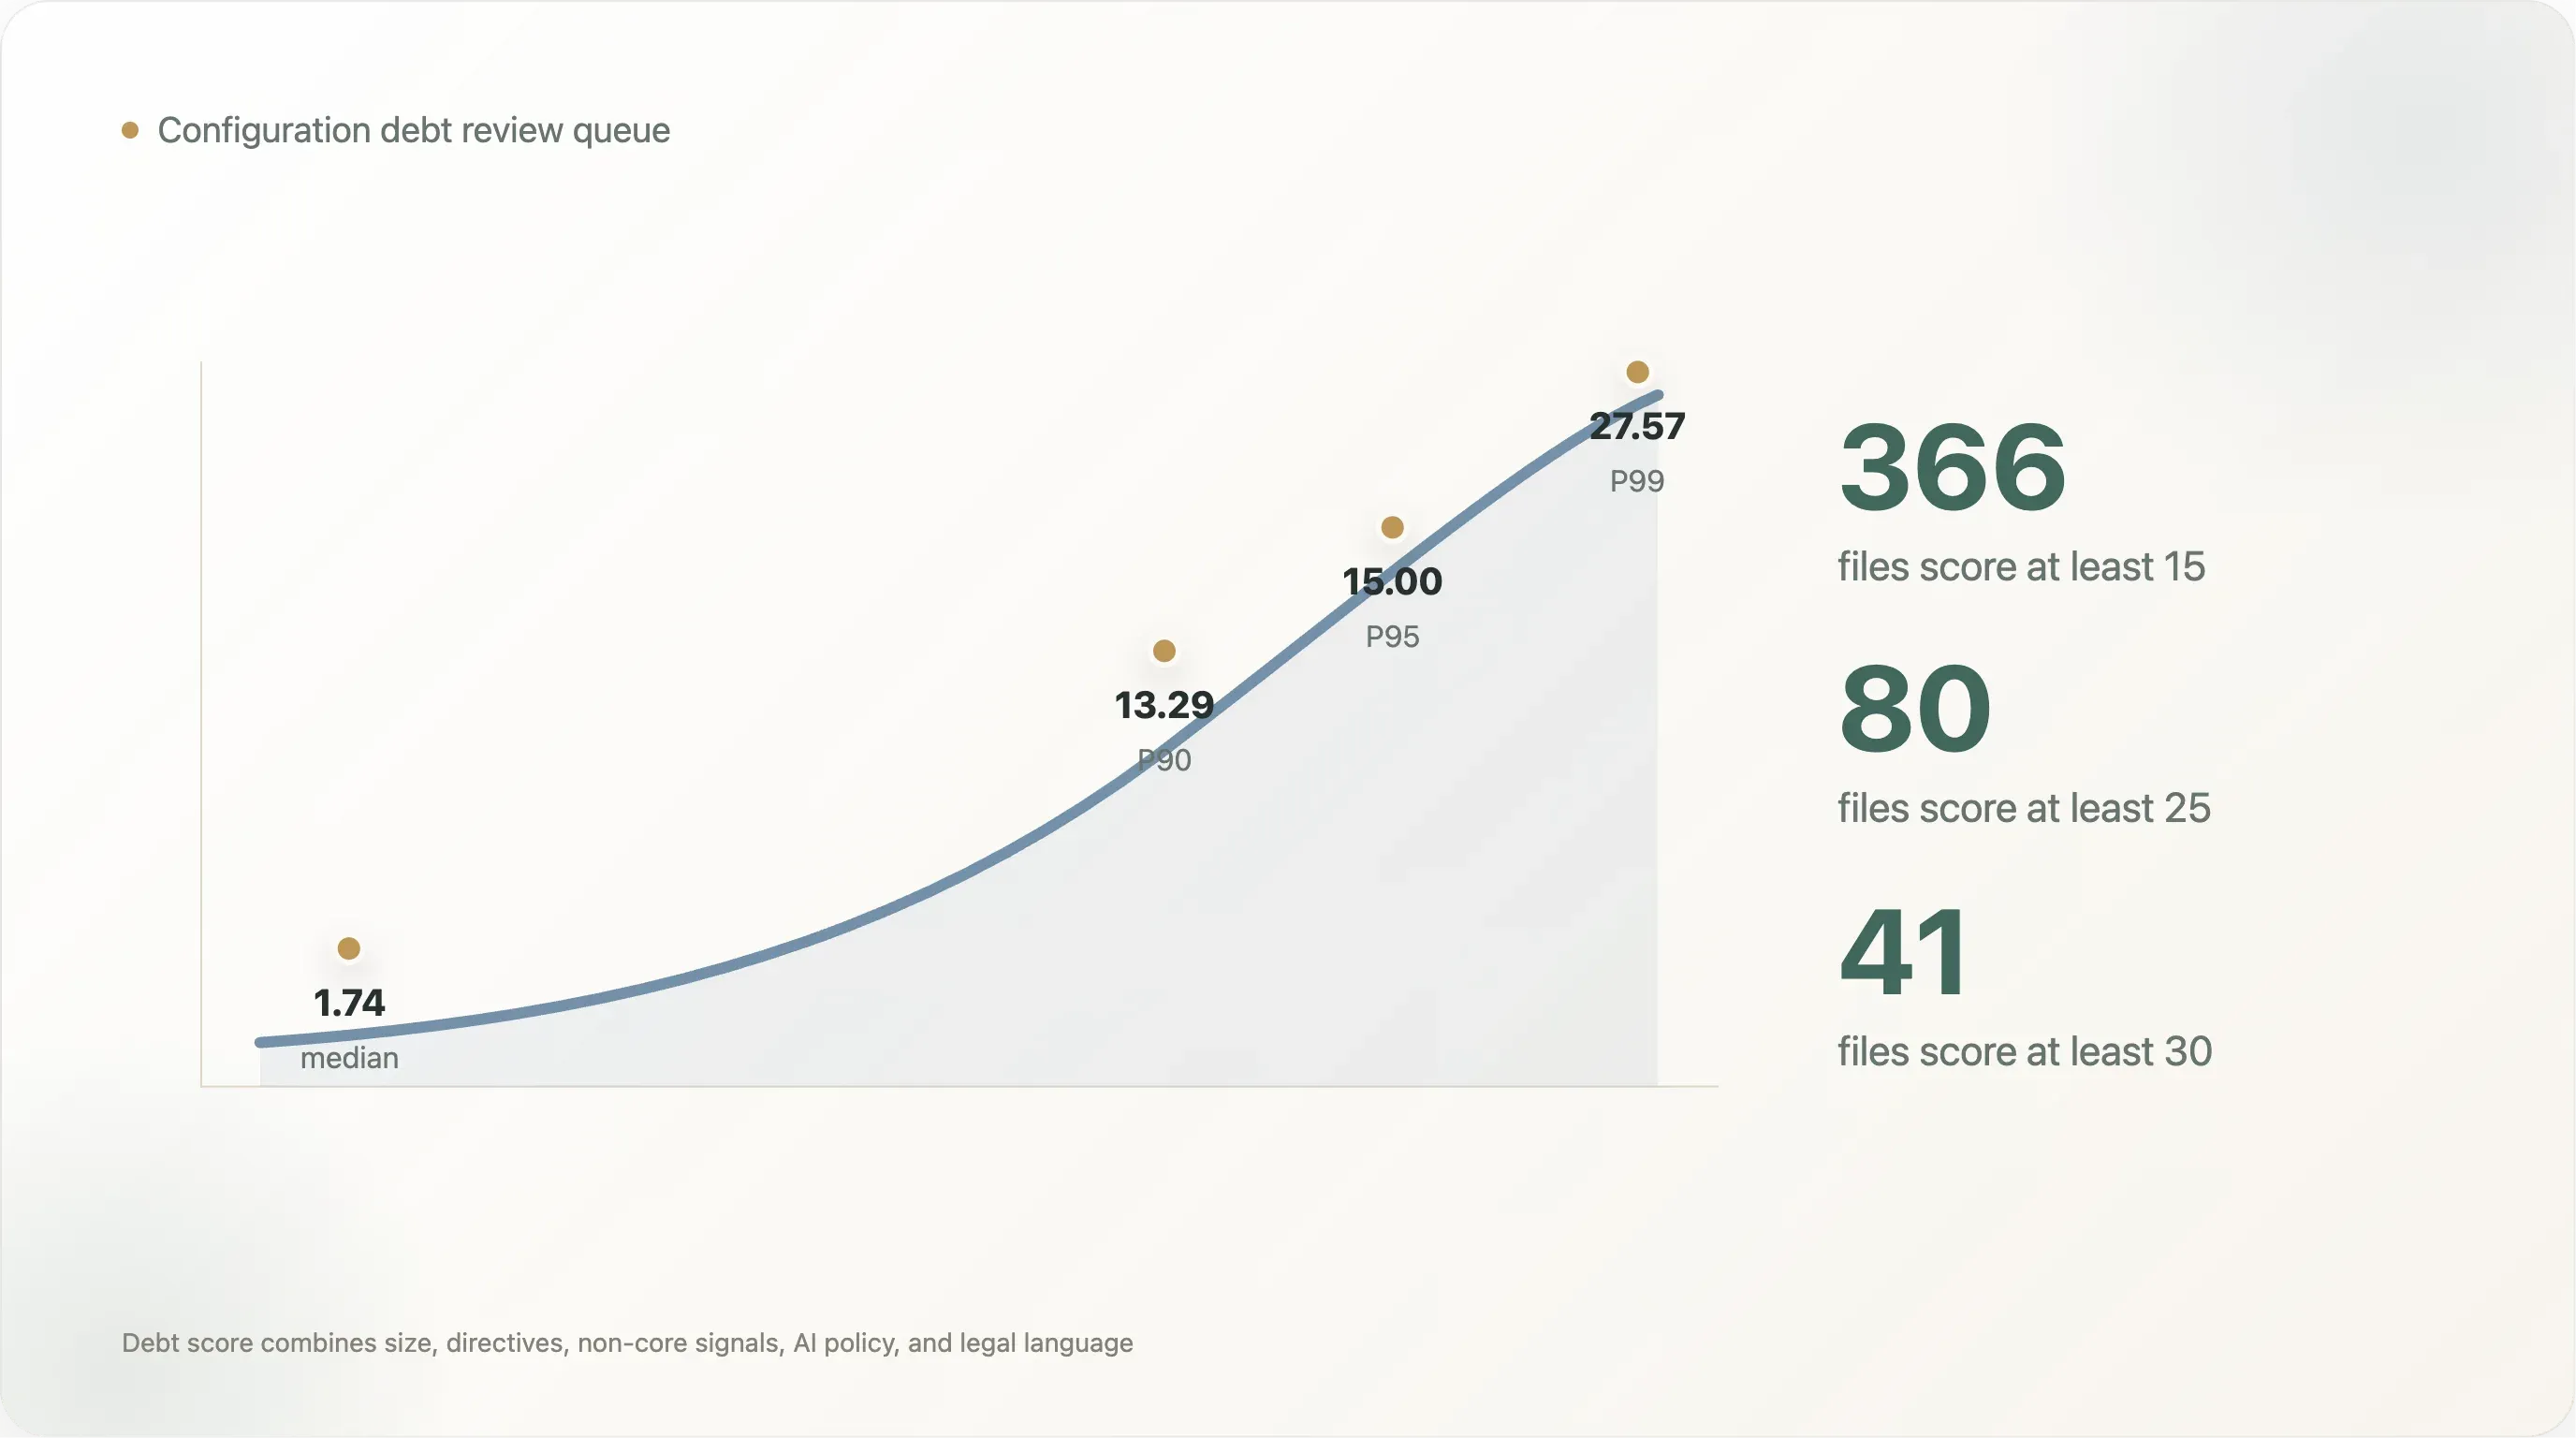
توزيع الدرجات حاد. فملف القراءة الوسيط يسجل 1.74. وP90 هو 13.29، وP95 هو 15.00، وP99 هو 27.57. فقط 366 ملفًا تسجل 15 أو أكثر، و80 ملفًا تسجل 25 أو أكثر، و41 ملفًا تسجل 30 أو أكثر. هذه هي قائمة المراجعة العملية: ليس كل موقع يحتاج إلى مشروع حوكمة، لكن الذيل العلوي يحتاج.
كما أن الرؤية حسب الفئة تُظهر لماذا تكون تسمية واحدة مثل "حاجب ذكاء اصطناعي" مسطحة أكثر من اللازم:
| الفئة | الدرجة الوسيطة | درجة P90 |
|---|---|---|
| سفر | 4.92 | 28.94 |
| بحث | 2.97 | 24.23 |
| اجتماعي | 2.25 | 15.00 |
| أخبار | 4.91 | 14.92 |
| مالي | 1.67 | 12.61 |
| SaaS | 0.98 | 11.85 |
| تجارة إلكترونية | 3.88 | 10.87 |
| حكومة | 1.57 | 6.38 |
يحمل السفر والبحث أعلى درجات P90 لأن أقلية من الملفات تصبح كبيرة جدًا ومثقلة بالقواعد. الأخبار لديها واحدة من أعلى الدرجات الوسيطة لأن لغة السياسة والمعاملة الخاصة بالروبوتات أكثر شيوعًا عبر الفئة كلها. أما التجارة الإلكترونية فلديها متوسط Disallow مرتفع، لكن درجة الدين في P90 فيها أقل من السفر لأن التعقيد يتركز أكثر في قواعد المسارات منه في إشارات السياسة/القانون المختلطة.
تشمل أعلى الملفات تصنيفًا في هذه البيانات ما يلي:
| النطاق | سبب ارتفاع درجته |
|---|---|
linkedin.com | ملف ضخم جدًا، آلاف قواعد المسارات، عدد كبير من وكلاء المستخدم المسماة، ولغة سياسة ذكاء اصطناعي صريحة |
lnkd.in | سطح سياسة مشابه لبنية الروابط القصيرة الخاصة بـ LinkedIn |
fragrantica.com | مئات كتل وكلاء مستخدم مسماة مع لغة سياسة ذكاء اصطناعي |
sovcombank.ru | مئات كتل وكلاء المستخدم ولغة قانونية/سياساتية |
academia.edu | مصفوفة كبيرة من السماح/المنع وسياسة صريحة لحظر الذكاء الاصطناعي |
opentable.com | مجموعة كبيرة من قواعد المسارات، وتوجيهات sitemap كثيرة، وسطح سياسة مرتبط بالذكاء الاصطناعي |
etsy.com | ملف ضخم للتحكم في المسارات للتجارة الإلكترونية مع أكثر من 1,600 قاعدة Disallow |
runescape.com | ما يقرب من 5,000 توجيه Disallow تحت مجموعة واحدة من وكلاء المستخدم |
لا ينبغي السخرية من هذه الملفات لكونها معقدة. فغالبًا ما تعكس التعقيدات احتياجات عمل حقيقية. لكنها تُظهر لماذا تستحق سياسة robots.txt نفس الانضباط الهندسي الذي تستحقه إعدادات الإنتاج الأخرى:
- يجب أن تكون الملكية واضحة؛
- يجب مراجعة التغييرات؛
- يجب وسم الأقسام المولدة آليًا؛
- ينبغي فصل التعليقات القانونية عن التوجيهات الآلية كلما أمكن؛
- ينبغي أن تؤكد حالات الاختبار سلوك الوصول المتوقع للزواحف الحرجة؛
- يجب حفظ سجل الإصدارات؛
- ينبغي تقاعد أسماء الروبوتات القديمة أو توثيقها؛
- يجب التعامل مع تدريب الذكاء الاصطناعي، والاسترجاع بالذكاء الاصطناعي، وفهرسة البحث، والأرشفة كأغراض منفصلة.
النقطة الأخيرة هي الأهم. فالقواعد الحالية تعتمد على وكيل المستخدم أولًا: إنها تطلب من مشغلي المواقع تسمية الروبوتات. أما الحاجة في عصر الذكاء الاصطناعي فهي مبدئيّة على أساس الغرض: إنها تطلب من مشغلي المواقع تحديد الاستخدامات المسموح بها.
وهذان ليسا الشيء نفسه.
وهذا التباين هو السبب في أن قوائم الحظر الأطول لن تصمد جيدًا مع الوقت. قد يضيف الناشر اليوم GPTBot وClaudeBot وCCBot وGoogle-Extended وBytespider وApplebot-Extended وPerplexityBot، لكن اسم الزاحف التالي أو وكيل الاسترجاع أو وسيط البيانات قد يظهر غدًا. أما السياسة المبنية على الغرض فستسمح للموقع أن يقول: "الفهرسة البحثية نعم، تدريب الذكاء الاصطناعي لا، والاسترجاع الذي يبدأه المستخدم ربما" من دون تحويل robots.txt إلى دفتر عناوين للروبوتات.
ماذا يعني هذا لحوكمة الذكاء الاصطناعي
غالبًا ما يصوغ النقاش العام robots.txt على أنه إما ذو معنى أو متجاوز. لكن البيانات تقترح إجابة أكثر عملية:
robots.txt ذو معنى، لكنه مثقل بالأعباء.
إنه ذو معنى لأن المواقع الكبرى تستخدمه، والزواحف تستطيع تحليله، والقرارات السياسية تصبح مرئية للباحثين والصحفيين والمورّدين والمحاكم. وقد وجد التقرير الأصلي أن 17.0% من المواقع الكبرى القابلة للتحليل كانت لديها قواعد صريحة خاصة بالذكاء الاصطناعي. هذا ليس ضجيجًا رمزيًا.
وهو مثقل بالأعباء لأن الملف مطالب الآن بالتعبير عن أكثر من مجرد الوصول من قبل الروبوتات:
- "لا تدرب على هذا المحتوى."
- "يمكنك استخدام هذا المحتوى لفهرسة البحث."
- "يمكنك استخدام هذا المحتوى للاسترجاع المباشر."
- "لا يجوز لك إنشاء مجموعات بيانات مخزنة مؤقتًا."
- "ينطبق هذا التحفظ القانوني بموجب قانون الاتحاد الأوروبي الخاص بالتنقيب النصي والبياني."
- "هذا الموقع المُدار عبر CDN يرسل
Content-Signal: ai-train=no." - "هذا الموقع يريد Googlebot لكن لا يريد YandexBot."
- "هذا الموقع لديه 1,000 مسار URL قديمًا لا ينبغي الزحف إليها."
النحو لم يُصمم لكل هذه الوظائف.
وهناك ثلاثة تغييرات من شأنها تقليل هذا الدين:
-
تحتاج هوية الزاحف إلى سجل موحد. لا ينبغي لمشغلي المواقع أن يضطروا إلى الحفاظ على قائمة متنامية بلا نهاية من
GPTBotوClaudeBotوanthropic-aiوCCBotوGoogle-ExtendedوApplebot-ExtendedوBytespiderوOAI-SearchBotوChatGPT-Userوعشرات غيرها. من دون سجل، ستتأخر السياسة دائمًا عن سلوك الزاحف. -
تحتاج استخدامات الذكاء الاصطناعي إلى مفردات منظمة. التدريب، والاسترجاع، والفهرسة، والتلخيص، وإعادة بيع مجموعات البيانات، وتقييم النماذج، والتصفح الذي يبدأه المستخدم هي استخدامات مختلفة. التعبير عنها عبر أسماء وكلاء المستخدم الخاصة بالمورّد هشّ.
-
تحتاج السياسة إلى قابلية تدقيق. يحتاج الويب إلى طريقة تميّز بين تحفظات الحقوق التي صاغها البشر وبين الإعدادات الافتراضية الموروثة من CDN، وقوالب CMS المولدة، والقواعد القديمة المهملة، وكتل الحظر الشاملة غير المقصودة. هذا التمييز مهم للثقة وللتقاضي.
ولا يعني أي من ذلك استبدال robots.txt بين ليلة وضحاها. المسار الأفضل هو التكديس الطبقي: إبقاء robots.txt كواجهة اكتشاف وتوافق، لكن توحيد سياسة مجاورة قابلة للقراءة آليًا لاستخدامات الذكاء الاصطناعي.
llms.txt أحد المحاولات، لكن اعتماده في هذه البيانات ما يزال ضئيلًا: 83 ملفًا قابلًا للقراءة فقط تذكره. أما Content-Signal فهو أوضح حضورًا لأن Cloudflare يمكنها توزيعه عبر البنية التحتية، وجميع ملفات Content-Signal الـ 271 في هذا الفحص تطابقت أيضًا مع لغة سياسة الذكاء الاصطناعي. ومع ذلك، فالتوزيع ليس إجماعًا. والحل الدائم يحتاج على الأرجح إلى آلية التوحيد المملة: حقول واضحة، ودلالات واضحة، والتزامات من الزواحف، ومجموعات اختبار عامة.
الخلاصة
حوّل صراع زواحف الذكاء الاصطناعي robots.txt إلى وثيقة حوكمة. وهذا مفيد وخطِر في آنٍ واحد.
مفيد، لأن الملف علني. يمكن للباحثين مراجعته. ويمكن للناشرين تغييره. ويمكن للزواحف احترامه. ويمكن للمحاكم قراءته. ويمكن لمزودي البنية التحتية نشره على نطاق واسع.
وخطِر، لأنه يحمل أكثر مما ينبغي.
ما يزال ملف robots.txt الوسيط في Tranco Top 10K صغيرًا بما يكفي لفهمه. لكن الذيل الطويل للويب عالي الزيارات مليء بملفات كبيرة، وقديمة، ومتعددة الطبقات، وخاصة بالمورّدين، ومشحونة قانونيًا. الآن تدير مئات المواقع إعدادات robots.txt يمكن فهمها بشكل أفضل على أنها أنظمة سياسة إنتاجية لا مجرد تلميحات بسيطة للزواحف.
الدرس المركزي ليس أن robots.txt فشل. بل إن الويب رقّاه من دون إعادة هيكلته.
إذا كانت سياسة الوصول للذكاء الاصطناعي ستعتمد على تصريحات عامة قابلة للقراءة آليًا، فالخطوة التالية ليست قائمة حظر أطول أخرى. إنها بنية أفضل للسياسة: أذونات قائمة على الغرض، وهوية ثابتة للزاحف، وقوالب قابلة للمراجعة، وسجلات تدقيق.
وإلى أن يحدث ذلك، ستظل طبقة حوكمة الذكاء الاصطناعي على الويب العام متكئة على ملف نصي لم يُصمم قط لحمل كل هذا العبء.
ملاحظات قابلية إعادة الإنتاج
يتضمن مجلد التسليم:
source_data/analysis.json— المقاييس الإجمالية الأصلية.source_data/site_meta.csv— الجدول التحليلي الأصلي على مستوى الموقع.source_data/bot_status.csv— جدول السياسة الأصلي حسب النطاق والزاحف.source_data/fetch_meta.csv— بيانات الجلب الوصفية الأصلية.source_data/sites.csv— جدول النطاق/الفئة/الحالة الأصلي.derived_data/robots_complexity_by_site.csv— مقاييس التعقيد على مستوى الموقع التي وُلدت لهذا التقرير.derived_data/search_bot_treatment.csv— مصفوفة معاملة زواحف البحث.derived_data/category_complexity_summary.csv— ملخص تعقيد على مستوى الفئة.derived_data/top_config_debt_sites.csv— أفضل المواقع حسب درجة الفرز الموضحة أعلاه.derived_data/summary_metrics.json— جميع المقاييس الرئيسية المقتبسة في هذا التقرير.
تنزيل جميع البرامج النصية ومجموعات البيانات
نرحّب بتصحيحات المنهجية، ومشكلات البيانات، والتحليلات اللاحقة عبر support@thunderbit.com. يُنشر هذا التقرير بصورة مستقلة عن أي موقف تجاري تحتفظ به Thunderbit؛ فنحن نبني أداة استخراج ويب بالذكاء الاصطناعي، ولدينا مصلحة بنيوية في أن يظل robots.txt عقدًا ذا معنى وقابلًا للقراءة آليًا على الويب العام. إن البيانات الواردة في هذا التقرير قائمة بذاتها. — فريق أبحاث Thunderbit، مايو 2026.
جرّب Thunderbit لاستخراج الويب بالذكاء الاصطناعي Get Started Free



