
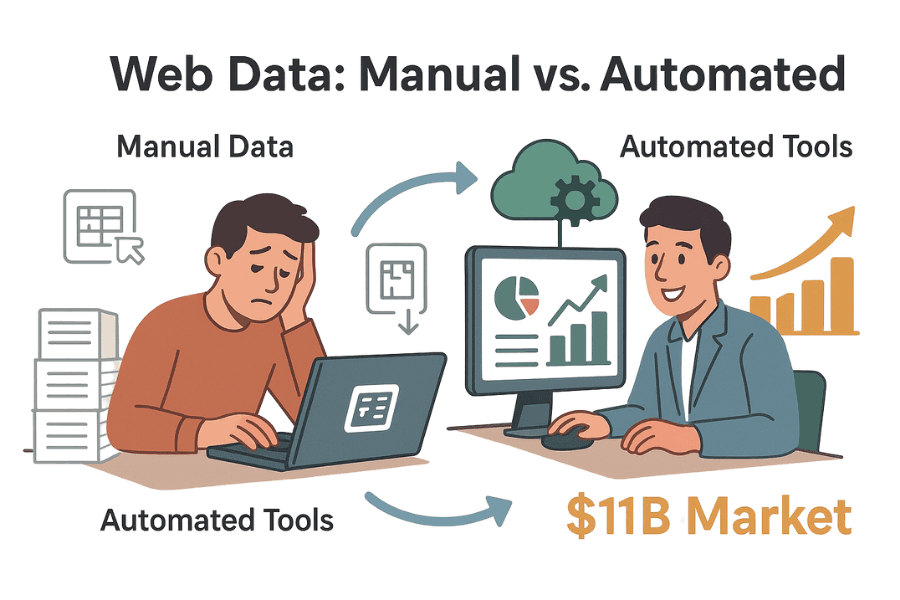
لنكن صريحين: لا أحد يستيقظ صباحًا متحمسًا لنسخ ولصق 500 صف من أسعار المنتجات في جدول بيانات. (وإن كنت تفعل ذلك، فأحييك على قدرتك على التحمّل، وأنصحك برباط جيد للمعصم.) سواء كنت تعمل في المبيعات أو العمليات، أو تحاول فقط أن تبقى عملك خطوة أمام المنافسين، فغالبًا ما واجهت ألم جمع البيانات من المواقع الإلكترونية. العالم اليوم يعتمد على بيانات الويب، والطلب على الاستخراج الآلي يتصاعد بسرعة — ومن المتوقع أن يصل سوق برمجيات استخراج الويب إلى أكثر من 11 مليار دولار بحلول 2032.
لقد أمضيت سنوات في خنادق SaaS والأتمتة، ورأيت كل شيء: من وحدات ماكرو Excel البطولية إلى سكربتات Python المرقّعة معًا في الثانية صباحًا. في هذا الدليل، سأرشدك إلى كيفية استخدام محلل HTML في Python لاستخراج بيانات حقيقية من العالم الواقعي (نعم، سنسحب معًا تقييمات أفلام IMDb)، وسأوضح أيضًا لماذا توجد طريقة أفضل في 2026 — أدوات مدعومة بالذكاء الاصطناعي مثل Thunderbit تتيح لك تجاوز البرمجة والوصول مباشرة إلى الرؤى.
ما هو محلل HTML ولماذا تستخدمه في Python؟
لنبدأ من الأساس: ماذا يفعل محلل HTML فعلًا؟ تخيّله كأمين مكتبة شخصي للويب. يقرأ كود HTML الفوضوي خلف صفحة الويب وينظّمه في بنية شجرية مرتّبة. بهذه الطريقة، يمكنك انتزاع البيانات التي تحتاجها فقط — العناوين، الأسعار، الروابط — من دون أن تضيع في بحر من الأقواس المعقوفة و
تُعد Python اللغة المفضلة لهذه المهمة، ولسبب وجيه. فهي سهلة القراءة، مناسبة للمبتدئين، وتضم منظومة ضخمة من المكتبات الخاصة باستخراج الويب وتحليل HTML. بل إن Python هي إلى حد بعيد اللغة الأكثر استخدامًا في استخراج الويب، بفضل منحنى التعلّم السلس والدعم القوي من المجتمع.
أبرز أدوات محلل HTML في Python
إليك الأسماء الرئيسية التي ستصادفها عند تحليل HTML في Python:
- BeautifulSoup: الخيار الكلاسيكي المناسب للمبتدئين. وما يزال يُصان بنشاط — فقد صدر
beautifulsoup4الإصدار 4.14.3 على PyPI في أواخر 2025 — لذا فالمعلومات هنا لا تحيلك إلى مكتبة قديمة. - lxml: سريع وقوي، مع إمكانات متقدمة للاستعلام.
- html5lib: متسامح جدًا مع HTML الفوضوي، تمامًا مثل متصفحك.
- PyQuery: يتيح لك استخدام محددات بأسلوب jQuery داخل Python.
- HTMLParser: المحلل المدمج في Python — متاح دائمًا، لكنه بسيط إلى حد ما.
لكل واحد منها خصائصه، لكنها جميعًا تساعدك على تحويل HTML الخام إلى بيانات منظّمة.
أهم حالات الاستخدام: كيف تستفيد الشركات من محللات HTML في Python
استخراج بيانات الويب ليس حكرًا على التقنيين أو علماء البيانات. لقد أصبح نشاطًا أساسيًا في الأعمال، خصوصًا في المبيعات والعمليات. وإليك السبب:
| حالة الاستخدام (الصناعة) | البيانات المستخرجة عادةً | النتيجة التجارية |
|---|---|---|
| مراقبة الأسعار (التجزئة) | أسعار المنافسين، مستويات المخزون | تسعير ديناميكي، هوامش أفضل (المصدر) |
| معلومات منتجات المنافسين | القوائم، المراجعات، التوفر | تحديد الفجوات، توليد العملاء المحتملين (المصدر) |
| توليد العملاء المحتملين (مبيعات B2B) | أسماء الشركات، البريد الإلكتروني، جهات الاتصال | تنقيب آلي عن العملاء، نمو خط المبيعات (المصدر) |
| مشاعر السوق (التسويق) | منشورات اجتماعية، مراجعات، تقييمات | تغذية راجعة لحظية، رصد الاتجاهات (المصدر) |
| تجميع بيانات العقارات | القوائم، الأسعار، معلومات الوسطاء | تحليل السوق، استراتيجية التسعير (المصدر) |
| استخبارات التوظيف | ملفات المرشحين، الرواتب | استقطاب المواهب، مقارنة الرواتب (المصدر) |
باختصار: إذا كنت لا تزال تنسخ البيانات يدويًا، فأنت تترك الوقت والمال على الطاولة.
تعرّف على مجموعة أدوات محلل HTML في Python: مقارنة المكتبات الشائعة
لنبدأ بالتطبيق العملي. إليك مقارنة سريعة لأشهر مكتبات تحليل HTML في Python، حتى تختار الأداة المناسبة لمهمتك:
BeautifulSoup: الخيار المناسب للمبتدئين
BeautifulSoup هو “Hello World” الخاص بتحليل HTML. صيغته سهلة الفهم، وتوثيقه ممتاز، ويتسامح مع HTML القبيح أو غير المنظّم (اعرف المزيد). العيب؟ ليس الأسرع، خصوصًا في الصفحات الكبيرة أو المعقدة، ولا يدعم محددات متقدمة مثل XPath بشكل مباشر.
lxml: سريع وقوي
إذا كنت تحتاج السرعة أو تريد استخدام استعلامات XPath، فـ lxml هو صديقك (التفاصيل). فهو مبني على مكتبات C، لذلك يتمتع بسرعة فائقة، لكنه قد يكون أصعب في التثبيت وله منحنى تعلّم أكثر حدة.
خيارات أخرى: html5lib وPyQuery وHTMLParser
- html5lib: يحلل HTML تمامًا كما يفعل متصفحك — رائع للترميز المكسور أو الغريب، لكنه بطيء (مقارنة).
- PyQuery: يتيح لك استخدام محددات بأسلوب jQuery داخل Python، وهو مفيد إذا كنت قادمًا من خلفية الواجهة الأمامية (راجع التوثيق).
- HTMLParser: الخيار المدمج في Python — سريع ومتاح دائمًا، لكنه أقل ثراءً في الميزات.
الخطوة 1: إعداد بيئة محلل HTML في Python
قبل أن تحلل أي شيء، تحتاج إلى إعداد بيئة Python الخاصة بك. إليك الطريقة:
-
ثبّت Python: حمّله من python.org إذا لم يكن مثبتًا لديك.
-
ثبّت pip: يأتي عادةً مع Python 3.4+، ويمكنك التحقق عبر تنفيذ
pip --versionفي الطرفية. -
ثبّت المكتبات (سنستخدم BeautifulSoup وrequests في هذا الشرح):
pip install beautifulsoup4 requests lxmlbeautifulsoup4هو المحلل.requestsيتيح لك جلب صفحات الويب.lxmlمحلل سريع يمكن لـ BeautifulSoup استخدامه من الخلفية.
-
تحقق من التثبيت:
python -c "import bs4, requests, lxml; print('All good!')"
نصائح لاستكشاف الأخطاء:
- إذا ظهرت لك أخطاء صلاحيات، جرّب
pip install --user ... - على Mac/Linux، قد تحتاج إلى استخدام
python3وpip3بدلًا من ذلك. - إذا ظهر لك “ModuleNotFoundError”، فتأكد من الإملاء ومن بيئة Python الصحيحة.
الخطوة 2: تحليل أول صفحة ويب باستخدام Python
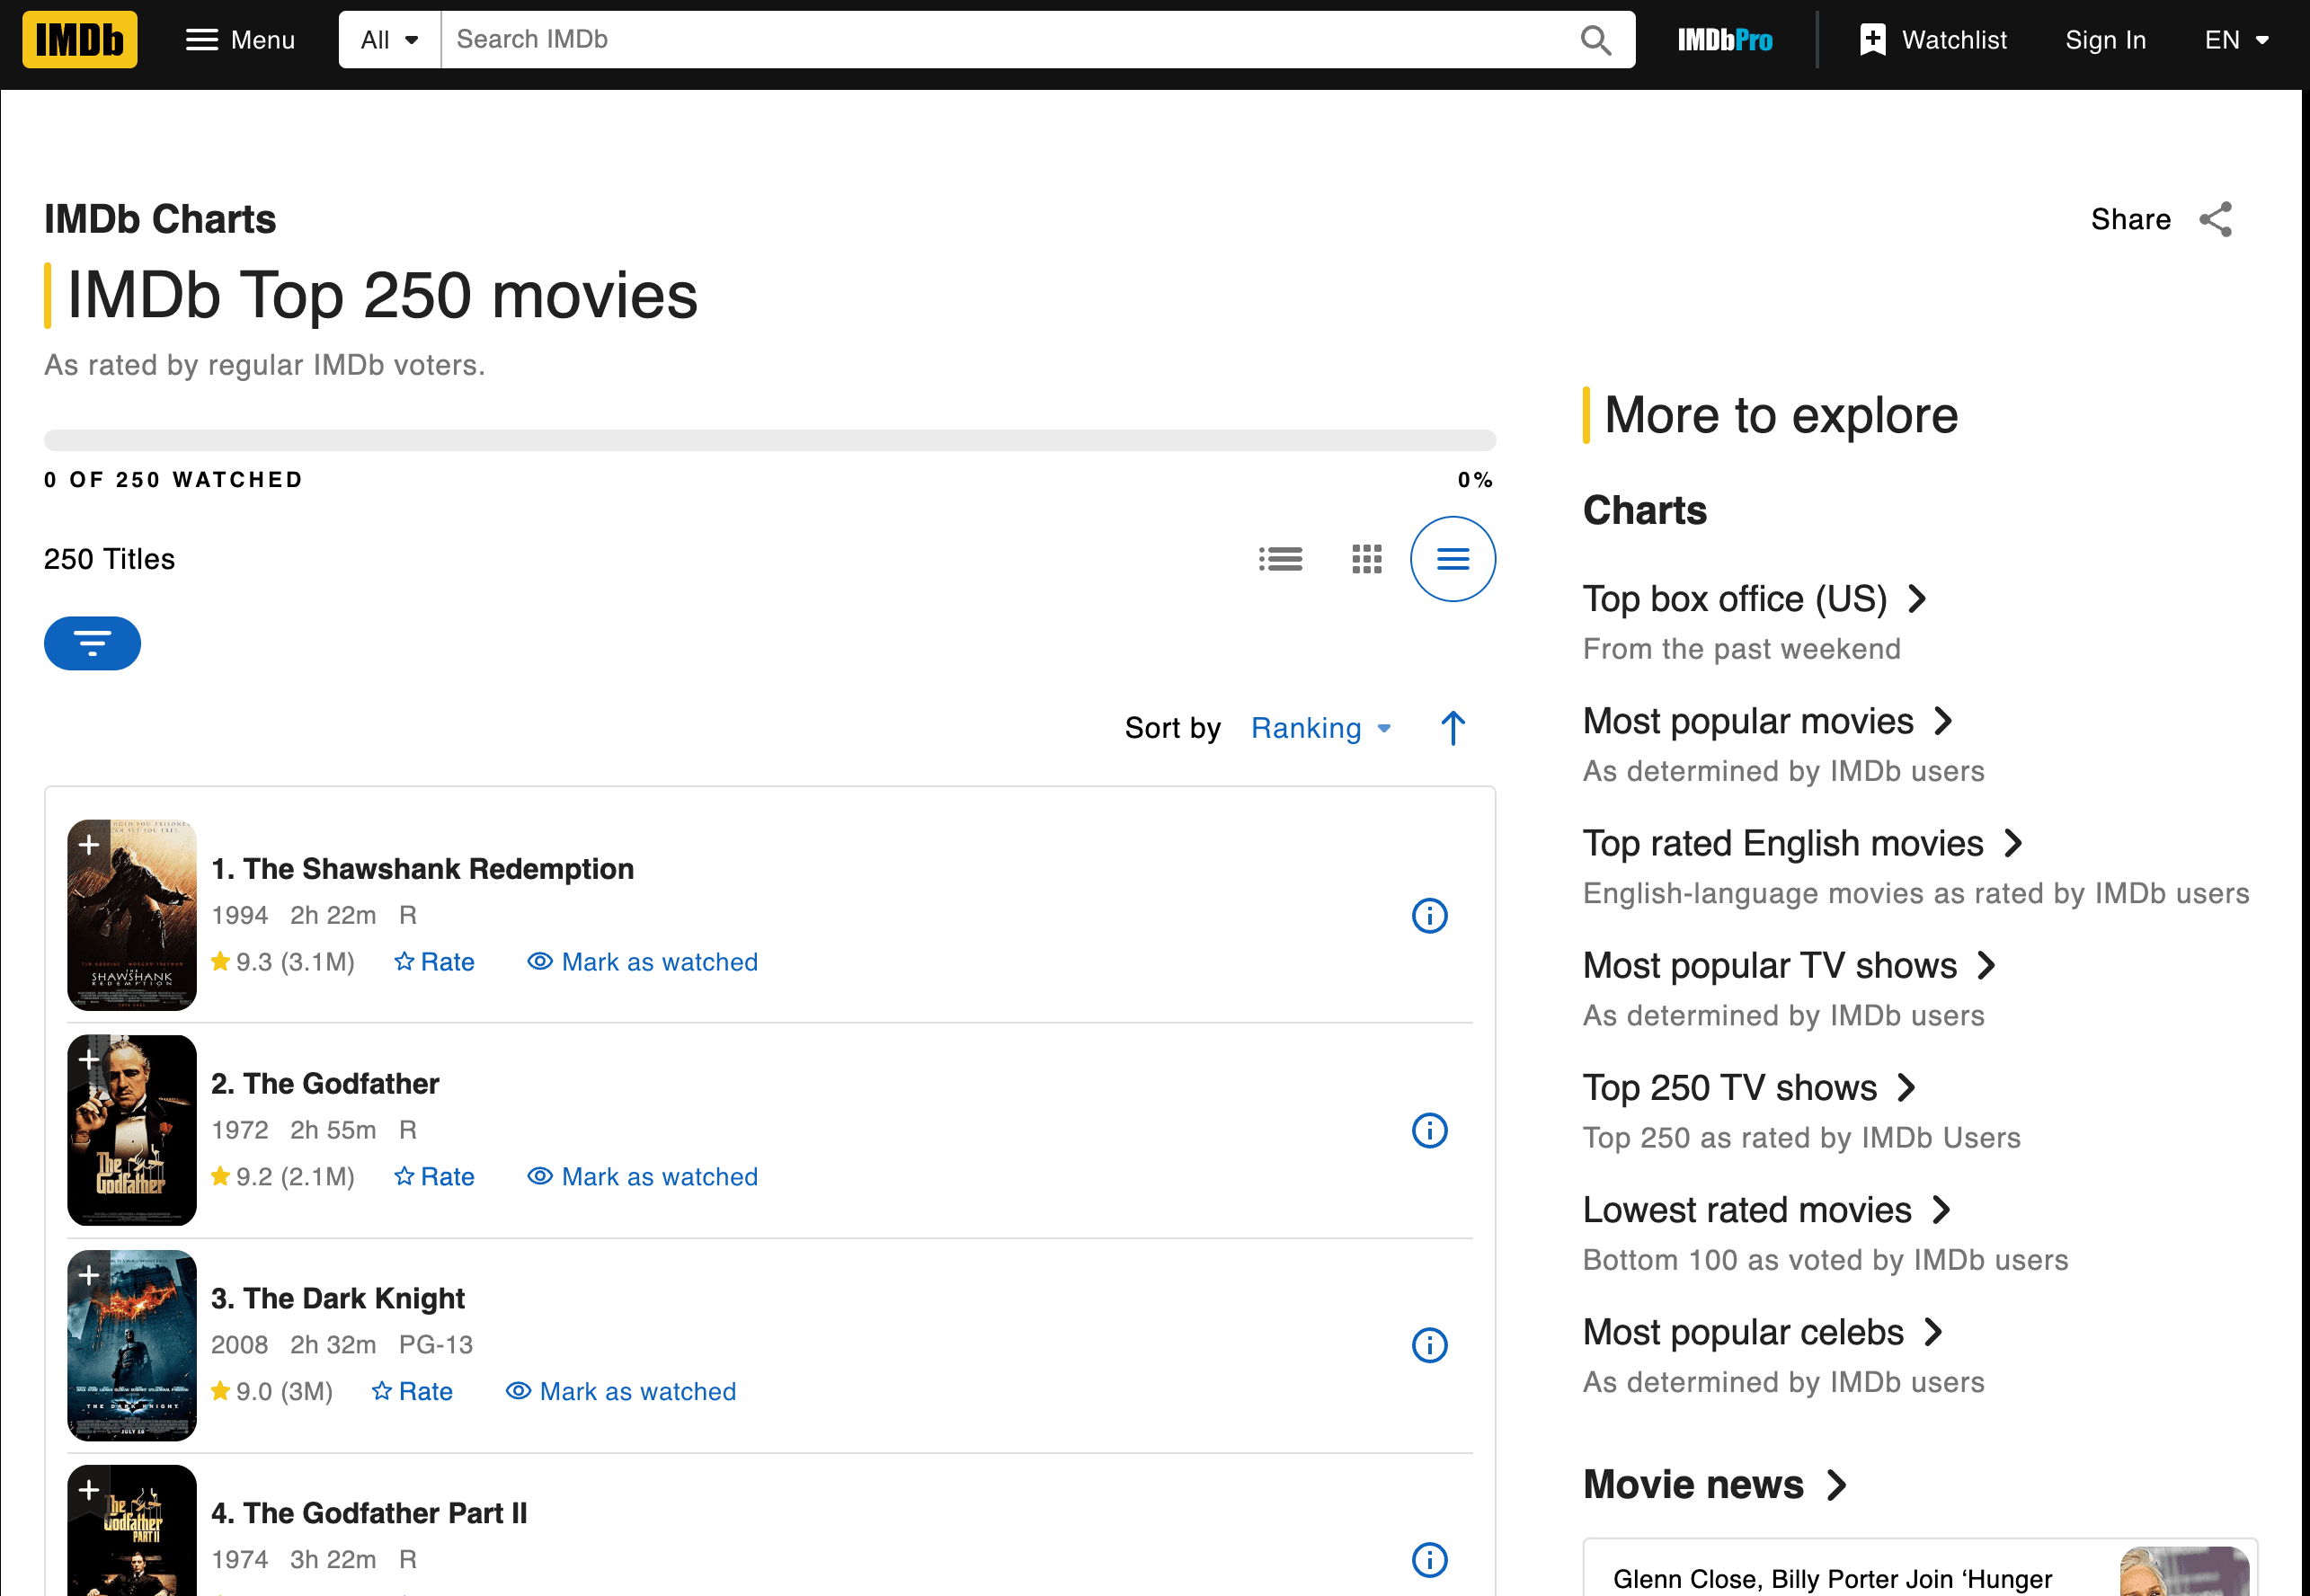
لنبدأ العمل الفعلي ونستخرج أفضل 250 فيلمًا على IMDb. سنجلب العناوين، والسنوات، والتقييمات.
جلب الصفحة وتحليلها
إليك سكربت خطوة بخطوة. تنبيه سريع قبل أن تنسخه: أعادت IMDb تصميم صفحة أفضل 250 فيلمًا في يونيو 2023، لذا فإن المحددات القديمة td.titleColumn وtd.ratingColumn التي لا تزال تراها في الشروحات الأقدم لم تعد تطابق شيئًا. الترميز الحالي يستخدم فئات تبدأ بـ ipc- تم توليدها بواسطة نظام المكوّنات لديهم، كما أعادت IMDb هيكلة الصفحة عدة مرات منذ ذلك الحين (بما في ذلك منتصف 2025)، لذا خطط لإعادة الفحص عبر DevTools كلما عدت إلى هذا المثال.
import requests
from bs4 import BeautifulSoup

url = "https://www.imdb.com/chart/top/"
headers = {"User-Agent": "Mozilla/5.0"}  # IMDb returns sparse markup without a real UA
resp = requests.get(url, headers=headers)
soup = BeautifulSoup(resp.text, "html.parser")

# Each row is a list item under the chart container
rows = soup.select("li.ipc-metadata-list-summary-item")

for i, row in enumerate(rows[:3], start=1):
    title_el  = row.select_one("h3.ipc-title__text")
    year_el   = row.select_one("span.cli-title-metadata-item")
    rating_el = row.select_one("span.ipc-rating-star--rating")

    title  = title_el.get_text(strip=True) if title_el else None
    # h3 text comes back as "1. The Shawshank Redemption" — strip the rank prefix
    if title and ". " in title:
        title = title.split(". ", 1)[1]
    year   = year_el.get_text(strip=True) if year_el else None
    rating = rating_el.get_text(strip=True) if rating_el else None

    print(f"{i}. {title} ({year}) -- Rating: {rating}")
ماذا يحدث هنا؟
- نستخدم
requests.get()لجلب الصفحة (معUser-Agentيبدو حقيقيًا — أحيانًا تعرض IMDb هيكلًا مختصرًا لعملاءpython-requestsالخام). - يقوم
BeautifulSoupبتحليل HTML. - نلتقط كل صف فيلم عبر
li.ipc-metadata-list-summary-item، ثم نسحب العنوان (h3.ipc-title__text) والسنة (span.cli-title-metadata-item) والتقييم (span.ipc-rating-star--rating) من داخله باستخدامselect_one(). - نستخرج النص الخاص بالعنوان والسنة والتقييم، مع حذف رقم الترتيب في البداية (
"1. ") الذي تدمجه IMDb داخل نص العنوان.
إذا كنت تريد طريقة أكثر ثباتًا من مطاردة تغيّر أسماء الفئات كل بضعة أشهر، فإن IMDb يضع أيضًا كتلة <script type="application/ld+json"> في الصفحة نفسها وتتضمن البيانات ذاتها بصيغة منظّمة — يمكنك تحليلها باستخدام json.loads(soup.find("script", type="application/ld+json").string) ثم التصفح عبر مصفوفة itemListElement. هذه هي الطريقة التي أميل لاستخدامها في بيئات الإنتاج؛ أما نسخة محددات CSS أعلاه فهي أسهل للتعليم لكنها أكثر هشاشة.
المخرجات:
1. The Shawshank Redemption (1994) -- Rating: 9.3
2. The Godfather (1972) -- Rating: 9.2
3. The Dark Knight (2008) -- Rating: 9.0
استخراج البيانات: العثور على العناوين والتقييمات وأكثر
كيف عرفتُ أي الوسوم والفئات أستخدم؟ لقد فحصت HTML الخاص بصفحة IMDb (زر الفأرة الأيمن > Inspect Element في المتصفح). ابحث عن الأنماط — هنا، كل صف فيلم موجود داخل <li class="ipc-metadata-list-summary-item">، مع العنوان تحت <h3 class="ipc-title__text"> والتقييم تحت <span class="ipc-rating-star--rating">. وملاحظة مهمة تستحق الحفظ: لقد غيّرت IMDb هذا الترميز أكثر من مرة (تنسيق td.titleColumn الذي ستجده في الشروحات القديمة لم يعد يعمل منذ إعادة التصميم في يونيو 2023)، لذا تعامل دائمًا مع سلاسل الفئات الدقيقة على أنها أمثلة فقط وأعد الفحص قبل تشغيل السكربت.
نصيحة احترافية: إذا كنت تستخرج البيانات من موقع آخر، فابدأ دائمًا بفحص بنية HTML وتحديد أسماء الفئات أو الوسوم الفريدة.
حفظ النتائج وتصديرها
لنحفظ بياناتنا في ملف CSV:
import csv

movies = []
for i in range(len(title_cells)):
    title_cell = title_cells[i]
    rating_cell = rating_cells[i]
    title = title_cell.a.text
    year = title_cell.span.text.strip("()")
    rating = rating_cell.strong.text if rating_cell.strong else rating_cell.text
    movies.append([title, year, rating])

with open('imdb_top250.csv', 'w', newline='', encoding='utf-8') as f:
    writer = csv.writer(f)
    writer.writerow(['Title', 'Year', 'Rating'])
    writer.writerows(movies)
نصائح التنظيف:
- استخدم
.strip()لإزالة المسافات البيضاء. - تعامل مع البيانات الناقصة عبر شروط
if. - لتصديرها إلى Excel، يمكنك فتح ملف CSV في Excel أو استخدام
pandasلكتابة ملفات.xlsx.
الخطوة 3: التعامل مع تغييرات HTML وتحديات الصيانة
هنا تبدأ الأمور الحقيقية. المواقع الإلكترونية تحب تغيير تخطيطها — أحيانًا فقط لإبقاء أدوات الاستخراج في حالة ترقب (أو هكذا يبدو الأمر). إذا غيّرت IMDb class="titleColumn" إلى class="movieTitle"، فقد يعود سكربتك فجأة بنتائج فارغة. لقد مررت بذلك، ونقحت الأخطاء الناتجة أيضًا.
عندما تتعطل السكربتات: مشاكل واقعية
المشكلات الشائعة:
- عدم العثور على المحددات: لا يستطيع الكود العثور على الوسم/الفئة التي حددتها.
- نتائج فارغة: تغيّرت بنية الصفحة، أو أصبح المحتوى يُحمّل عبر JavaScript.
- أخطاء HTTP: أضاف الموقع إجراءات مضادة للروبوتات.
خطوات استكشاف الأخطاء:
- تحقّق مما إذا كان HTML الذي تحلله يطابق ما تراه في المتصفح.
- حدّث المحددات لتطابق البنية الجديدة.
- إذا كان المحتوى يُحمّل ديناميكيًا، فقد تحتاج إلى التبديل إلى أداة أتمتة متصفح مثل Selenium أو العثور على نقطة API.
أين الصداع الحقيقي؟ إذا كنت تستخرج من 10 أو 50 أو 500 موقع مختلف، فقد تقضي وقتًا في إصلاح السكربتات أكثر مما تقضيه فعلًا في تحليل البيانات (راجع قصص المطورين).
الخطوة 4: التوسع — التكاليف الخفية للتحليل اليدوي في Python
لنفترض أنك تريد استخراج بيانات ليس فقط من IMDb، بل أيضًا من Amazon وZillow وLinkedIn ومواقع أخرى كثيرة. كل موقع سيحتاج إلى سكربت خاص به. وفي كل مرة يتغير فيها موقع، تعود إلى محرر الكود من جديد.
التكاليف الخفية:
- جهد الصيانة: تُقدَّر الصيانة أحيانًا بأنها 10 أضعاف تكلفة البناء الأولية.
- البنية التحتية: ستحتاج إلى بروكسيات، ومعالجة للأخطاء، ومراقبة.
- الأداء: التوسع يعني التعامل مع التزامن، وحدود المعدل، وأكثر.
- ضمان الجودة: كلما زادت السكربتات، زادت نقاط الكسر المحتملة.
بالنسبة للفرق غير التقنية، يصبح هذا غير قابل للاستمرار بسرعة. إنه أشبه بتوظيف فريق من المتدربين لنسخ ولصق البيانات طوال اليوم — باستثناء أن المتدربين هنا هم سكربتات Python، وهم يتصلون مرضى كلما غيّر موقع ويب تصميمه.
ملاحظة سريعة حول وكلاء البرمجة بالذكاء الاصطناعي
قبل أن نصل إلى أدوات بدون كود، يجدر الإشارة إلى مسار وسط لم يكن موجودًا تقريبًا عندما كُتبت معظم شروحات “تعلّم BeautifulSoup”: وكلاء البرمجة بالذكاء الاصطناعي. أدوات مثل Claude Code أو Cursor ستأخذ وصفًا بالإنجليزية بكل سرور (“اجلب أفضل 250 فيلمًا في IMDb، واستخرج العنوان / السنة / التقييم إلى CSV”) وتنتج لك سكربتًا عاملًا باستخدام requests وBeautifulSoup دفعة واحدة، بما في ذلك نوع تنظيف المحددات الذي قمنا به يدويًا للتو. ولتدفقات المتصفح باللغة الطبيعية — تسجيل الدخول، التنقل بين الصفحات، التعامل مع لافتات الكوكيز — يمكن لأداة مثل Browser Use تشغيل متصفح بدون واجهة مباشرة من خلال prompt.
لكنها لا تلغي الأجزاء الصعبة. حدود المعدل، وrobots.txt، ونوافذ تسجيل الدخول، والدفاعات المضادة للروبوتات تبقى مسؤوليتك، وعندما يتعطل محدد بصمت (كما حدث مع IMDb) لا يزال عليك أن تميّز ما الذي أنشأه الوكيل وتصلحه. لذلك، حتى مع وجود وكيل في الحلقة، فإن فهم سير عمل محلل HTML في هذا الدليل هو ما يتيح لك تصحيح المخرجات بدلًا من التحديق في قوائم فارغة.
ما بعد محللات HTML في Python: تعرّف على Thunderbit، البديل المدعوم بالذكاء الاصطناعي
والآن نصل إلى الجزء المثير. ماذا لو استطعت تجاوز البرمجة، وتجاوز الصيانة، والحصول فقط على البيانات التي تحتاجها — مهما تغيّر الموقع؟
هذا بالضبط ما بنيناه مع Thunderbit. إنها إضافة Chrome لاستخراج الويب بالذكاء الاصطناعي تتيح لك استخراج بيانات منظمة من أي موقع في نقرتين فقط. لا Python، لا سكربتات، لا صداع.
محللات HTML في Python مقابل Thunderbit: مقارنة مباشرة
| الجانب | محللات HTML في Python | Thunderbit (اطلع على الأسعار) |
|---|---|---|
| وقت الإعداد | مرتفع (تثبيت، برمجة، تصحيح) | منخفض (ثبّت الإضافة، انقر) |
| سهولة الاستخدام | يتطلب برمجة | بدون برمجة — أشر وانقر |
| الصيانة | مرتفعة (تتعطل السكربتات كثيرًا) | منخفضة (الذكاء الاصطناعي يتكيّف تلقائيًا) |
| قابلية التوسع | معقدة (سكربتات، بروكسيات، بنية تحتية) | مدمجة (استخراج سحابي، مهام دفعات) |
| إثراء البيانات | يدوي (اكتب المزيد من الكود) | مدمج (وسم، تنظيف، ترجمة، صفحات فرعية) |
لماذا تبرمج عندما يمكنك حل المشكلة بالذكاء الاصطناعي؟
لماذا تختار الذكاء الاصطناعي لاستخراج بيانات الويب؟
يقرأ وكيل Thunderbit صفحة الويب، ويفهم بنيتها، ويتكيّف عندما تتغير الأمور. إنه أشبه بمتدرب خارق لا ينام ولا يشتكي أبدًا من تغيّر أسماء الفئات.
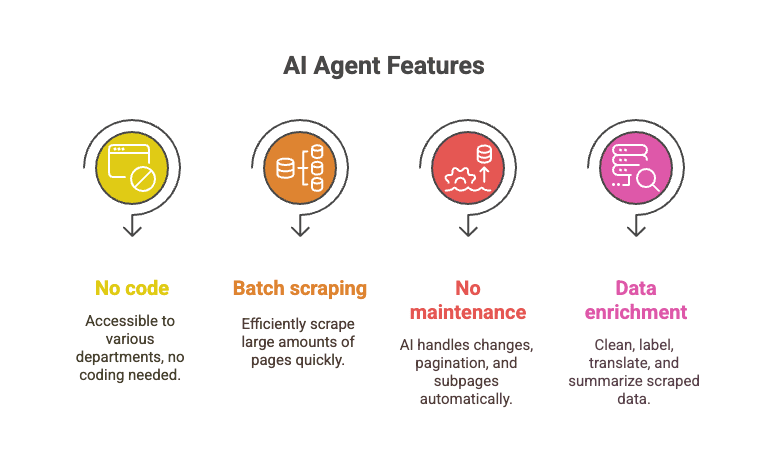
- لا حاجة إلى البرمجة: يمكن لأي شخص استخدامه — المبيعات، العمليات، التسويق، وغيرهم.
- استخراج دفعات: استخرج أكثر من 10,000 صفحة في الوقت الذي يستغرقه تصحيح سكربت Python واحد.
- لا صيانة: يتعامل الذكاء الاصطناعي مع تغييرات التخطيط، وترقيم الصفحات، والصفحات الفرعية، وأكثر.
- إثراء البيانات: نظّف البيانات، ووسمها، وترجمها، ولخّصها أثناء الاستخراج.
والجانب الآخر من سير عمل BeautifulSoup الذي شرحناه للتو هو بالضبط ذلك النوع من الهشاشة الذي واجهناه مع محددات IMDb أعلاه — عندما تعيد الصفحة ترتيب نفسها، يعود السكربت بنتائج فارغة بصمت، وتقضي فترة بعد الظهر في DevTools بدلًا من النظر إلى البيانات. أداة استخراج AI بدون كود تخفي هذه الخطوة خلف طبقة استدلال خاصة بها؛ وهذه مقايضة حقيقية (أنت تثق بأن استخراج طرف آخر صحيح)، وليست عصا سحرية.
خطوة بخطوة: استخراج تقييمات أفلام IMDb باستخدام Thunderbit
لنرَ كيف يتعامل Thunderbit مع مهمة IMDb نفسها:
- ثبّت Thunderbit Chrome Extension.
- انتقل إلى صفحة أفضل 250 فيلمًا في IMDb.
- انقر على أيقونة Thunderbit.
- انقر على “اقتراح الحقول بالذكاء الاصطناعي”. سيقرأ Thunderbit الصفحة ويقترح الأعمدة (العنوان، السنة، التقييم).
- راجع الأعمدة أو عدّلها إذا لزم الأمر.
- انقر على “استخراج”. سيستخرج Thunderbit الصفوف الـ250 كلها فورًا.
- صدّر إلى Excel أو Google Sheets أو Notion أو CSV — حسب اختيارك.
هذا كل شيء. لا برمجة، لا تصحيح أخطاء، ولا لحظة من نوع “لماذا هذه القائمة فارغة؟”.
هل تريد رؤيته عمليًا؟ تفقّد قناة Thunderbit على YouTube لمشاهدات توضيحية، أو اقرأ دليلنا خطوة بخطوة لاستخراج بيانات Amazon لمثال آخر من الواقع.
الخلاصة: اختيار الأداة المناسبة لاحتياجاتك من بيانات الويب
محللات HTML في Python مثل BeautifulSoup وlxml قوية ومرنة ومجانية. وهي ممتازة للمطورين الذين يريدون تحكمًا كاملًا ولا يمانعون في العمل بجهد. لكنها تأتي مع منحنى تعلّم حاد، وصيانة مستمرة، وتكاليف خفية — خصوصًا مع نمو احتياجاتك من الاستخراج.
أما لمستخدمي الأعمال وفرق المبيعات وكل من يريد البيانات فقط لا الكود، فإن الأدوات المدعومة بالذكاء الاصطناعي مثل Thunderbit هي بمثابة نفسٍ من الهواء النقي. فهي تتيح لك استخراج بيانات الويب وتنظيفها وإثراءها على نطاق واسع، من دون أي برمجة أو صيانة.
نصيحتي؟ استخدم Python إذا كنت تحب كتابة السكربتات وتحتاج إلى تخصيص كامل. أما إذا كنت تقدّر وقتك (وسلامتك النفسية)، فجرّب Thunderbit. لماذا تبني السكربتات وتعتني بها يدويًا بينما يمكن للذكاء الاصطناعي أن يتولى العمل الشاق؟
هل تريد معرفة المزيد عن استخراج الويب، واستخراج البيانات، وأتمتة الذكاء الاصطناعي؟ تصفّح المزيد من الشروحات على مدونة Thunderbit، مثل كيفية استخراج بيانات المواقع إلى Excel باستخدام الذكاء الاصطناعي أو أفضل أدوات وبرمجيات استخراج الويب في 2025.




