
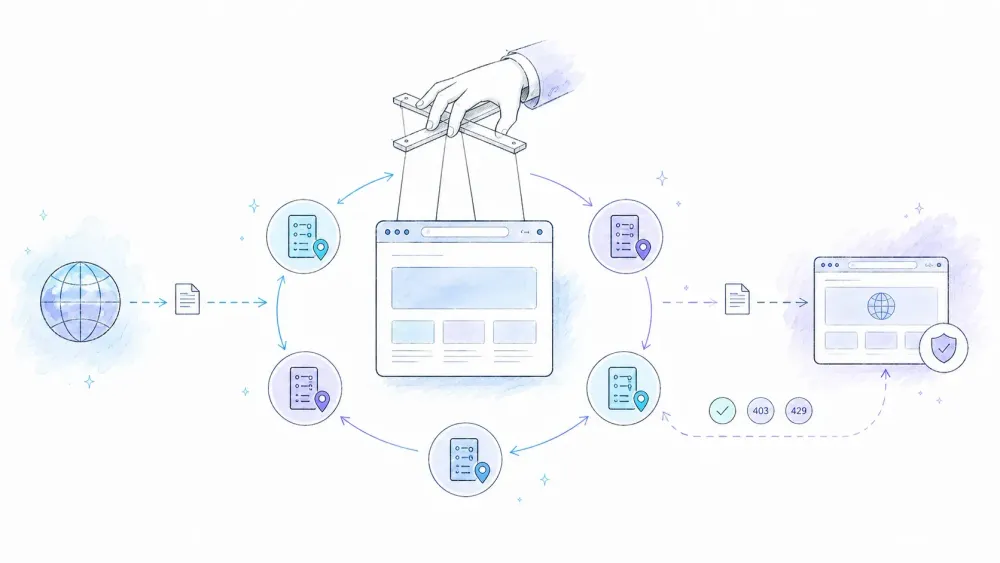
النمط الشائع الذي تواجهه في Puppeteer هو أن الطلبات الأولى تنجح، ثم تبدأ تظهر أخطاء 403 أو 429، أو مهلات زمنية، أو تحويل مباشر إلى صفحة تحقق. ومع ذلك، كثير من الأدلة تتعامل مع البروكسي الدوّار وكأنه مجرد تعديل سطرين في الإعدادات.
الواقع مختلف تمامًا. هناك فجوة كبيرة بين مثال بسيط بإضافة سطر واحد فقط --proxy-server، وبين نظام يمكن الوثوق به في الإنتاج الفعلي. هذا الدليل يناقش بصراحة تدوير البروكسي على مستوى المتصفح، بوابات المصادقة، تقسيم المتصفحات أو المرحّلات الخارجية، تثبيت ملف تعريف المتصفح، معالجة الأخطاء على مستوى الإنتاج، وحتى الحالات التي يجب فيها عدم إدارة البروكسي بنفسك من الأساس.
ما هو البروكسي الدوّار ولماذا يحتاجه Puppeteer؟
البروكسي يقف بين نسخة Puppeteer التي تستخدمها والموقع الذي تتصل به. الموقع لا يرى عنوان IP الخاص بجهازك، بل يرى عنوان IP الخارجي القادم من البروكسي. والبروكسي الدوّار يبدّل هذا العنوان الخارجي مع كل طلب أو كل جلسة، بحيث لا يبدو الأمر وكأن عميلًا واحدًا يقرع باب نفس الخادم مرارًا.
سبب أهمية هذا في Puppeteer تحديدًا هو أن إرسال مئات الطلبات المتتالية من نفس عنوان IP عبر Chrome في وضع headless هو بالضبط النمط الذي صُممت أنظمة الحماية من البوتات لاكتشافه. توثيق Cloudflare يوضح أيضًا أن عدة طبقات تعمل في وقت واحد: قواعد استدلالية، وفحص بصمة JavaScript، وتعلم آلي، وتحليل السلوك الشاذ. تغيير عنوان IP يعالج طبقة واحدة فقط من هذه الطبقات. طبقة واحدة لا أكثر.
هناك أيضًا ثلاثة أنواع من البروكسي يجب معرفتها. هي ليست بدائل متكافئة.
- بروكسيات مراكز البيانات — رخيصة وسريعة، وتأتي من مزودي استضافة. بما أن ASN الخاص بالشبكة يكشف بسهولة أنه مركز بيانات، يسهل على المواقع حظرها.
- البروكسيات السكنية — تمر عبر مزود خدمة إنترنت (ISP) لمستخدم عادي، فتبدو كأنها اتصال إنترنت منزلي حقيقي. أبطأ وأغلى، لكنها أكثر مصداقية.
- بروكسيات الموبايل — عناوين IP من شبكات المشغّلين، وعادة الأغلى ثمنًا. مفيدة عندما تحتاج فعلًا هوية شبكة موبايل.
من منظور التصنيف حسب ASN وحده، قد يكون من الأسهل إخفاء بروكسي سكني مقارنة ببروكسي مركز بيانات، لكن هذا لا يعني أن أيًا منهما محصّن من الحظر. لا توجد نسبة اكتشاف ثابتة واحدة. النتيجة تعتمد على الموقع المستهدف، وسمعة عنوان الخروج، والموقع الجغرافي، وسجل الجلسة، وملف تعريف المتصفح، ونمط الطلبات.
هناك فرق آخر يسبب التباسًا. قائمة تدوير ثابتة تديرها بنفسك تعني أنك تدير مجمّع البروكسيات بنفسك، وتختار العنوان التالي، وتتعامل مع الأعطال. أما بروكسيات backconnect / gateway فتعني أنك تتصل بنقطة نهاية واحدة فقط، والمزوّد يبدّل عنوان الخروج خلف الكواليس. كلا الأسلوبين صحيح، لكن مكان التعقيد يختلف بينهما.
لماذا نستخدم البروكسيات الدوّارة في Puppeteer؟ حالات الاستخدام الشائعة
بصراحة، التدوير ليس ضروريًا دائمًا حتى تحتاجه فعلًا. لكن عندما تحتاجه، تحتاجه بشدة.
| حالة الاستخدام | لماذا التدوير مهم |
|---|---|
| مراقبة أسعار كتالوج المنتجات | الاستعلام المتكرر عن الكتالوج من IP واحد يراكم إشارات تحديد المعدل والسمعة |
| إثراء بيانات العملاء المحتملين / استخراج جهات الاتصال | تصفح الملفات الشخصية بشكل متكرر من IP واحد يبدو وكأنه جمع بيانات لا مجرد تصفح |
| استخراج نتائج البحث | محركات البحث من أكثر الجهات صرامة في تقييد IP وفرض CAPTCHA |
| تحليل المنافسين | جمع بيانات من نفس النطاق لعدة أيام يترك أثرًا يربط بين IP وسجل الكوكيز |
| تجميع المحتوى | النمط الذي يجمع بين قيمة منخفضة لكل صفحة وعدد كبير من الصفحات هو أول ما تشتبه فيه أنظمة اكتشاف البوتات |
لا توجد قاعدة ثابتة مثل "أمازون يحظر بعد كذا طلب". المواقع لا تعلن عن حدودها العامة، والقيود تختلف حسب نقطة النهاية وحالة الحساب وسمعة ASN وشكل حركة المرور. ابدأ بأقل معدل طلبات ممكن، ولا تكتفِ بفحص رمز الحالة بل تحقق من المحتوى الفعلي. واعتمد على سياسة الموقع المستهدف والملاحظات الفعلية لتقرر متى تحتاج التدوير حقًا.
ثلاث استراتيجيات لتدوير البروكسي في Puppeteer: أيها تحتاج؟
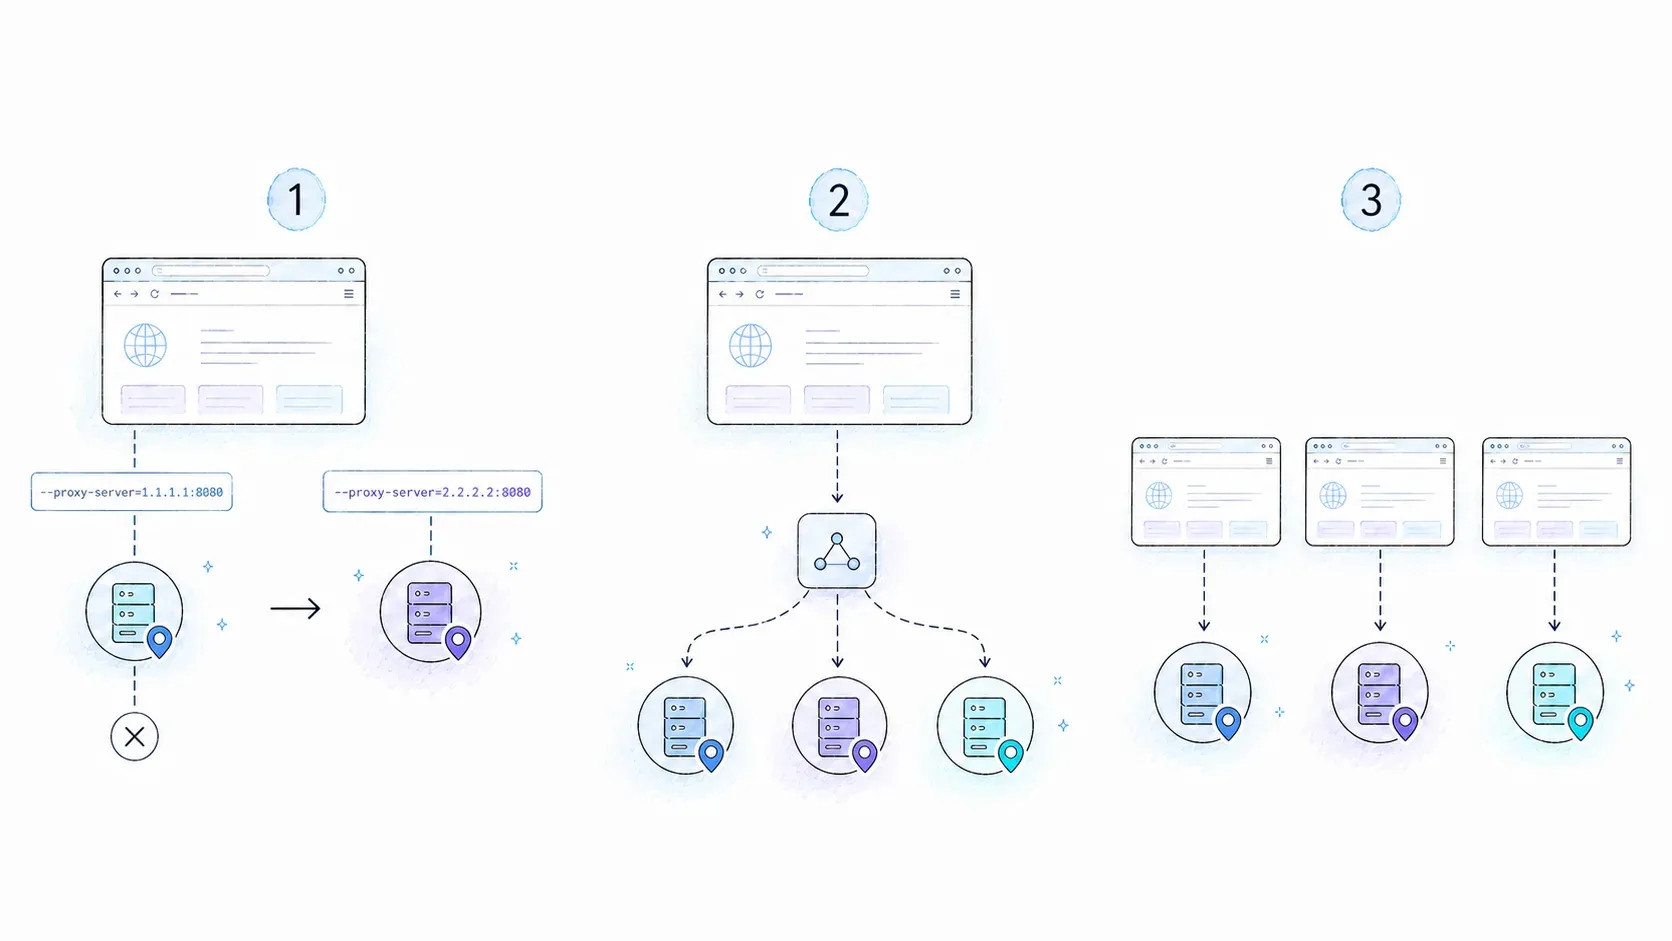
معظم الشروحات تعرض طريقة واحدة فقط وتكتفي بذلك، أو أسوأ من هذا تعرض فقط النسخة الأبسط. الحقيقة أن هناك ثلاث مستويات، واختيار الخاطئ منها يضيع وقتك أو يعقّد مهمة بسيطة بلا داعٍ.
| استراتيجية التدوير | مستوى الدقة | يتطلب إعادة تشغيل المتصفح؟ | التعقيد | الحالة المناسبة |
|---|---|---|---|---|
| لكل متصفح (`--proxy-server`) | بروكسي واحد لكل نسخة متصفح | نعم | منخفض | جمع بيانات صغير وبسيط |
| قائم على البوابة (`proxy-chain` + نقطة نهاية backconnect) | حسب سياسة المزوّد / الجلسة | لا | متوسط | بوابة تدوير موثّقة |
| تقسيم المتصفح أو مرحّل خارجي | بروكسي واحد لكل شريحة متصفح أو قاعدة توجيه | لا يوجد تبديل مباشر داخل عملية واحدة | مرتفع | تحكم دقيق بالتزامن والتوجيه |
ملاحظة مهمة: توثيق اعتراض الشبكة في Puppeteer يوضح بشكل صريح أن setRequestInterception ليس "زر أنيق لتبديل البروكسي مع كل طلب". الطلب المعترَض يبقى متوقفًا حتى تسمح صراحة بالمتابعة أو الاستجابة أو الإلغاء. إذا كنت تحتاج فعلًا توجيهًا على مستوى كل طلب، فالطريقة المعتادة ليست تبديل البروكسي مباشرة داخل معالج الطلب، بل تمرير الطلب عبر بوابة محلية قابلة للبرمجة مثل proxy-chain. تذكّر هذه النقطة قبل أن تصل إلى الطريقة الثالثة أدناه.
كيفية إعداد بروكسي دوّار في Puppeteer: دليل خطوة بخطوة
مستوى الصعوبة: متوسط
الوقت المتوقع: حوالي 30-45 دقيقة لتنفيذ الطرق الثلاث معًا
ما تحتاجه: Node.js 18+، وnpm، وقائمة بروكسيات أو حساب لدى مزوّد (بصيغة protocol://user:pass@host:port)، وحزم puppeteer وproxy-chain وpuppeteer-extra
المتطلبات المسبقة: ما تحتاجه قبل البدء
ثبّت الحزم الأساسية:
npm install puppeteer proxy-chain puppeteer-extra puppeteer-extra-plugin-stealth
احصل على قائمة من مزوّد البروكسي، أو على الأقل جهّز مجموعة بروكسيات اختبار للتحقق من الكود قبل تشغيله على حمل طلبات حقيقي. البروكسيات السكنية أفضل إن أمكن. احفظ بيانات الاعتماد دائمًا في متغيرات بيئة، ولا تضعها مباشرة في الكود، ومن الأفضل عدم وضعها في عناوين URL التي قد تظهر في السجلات.
الطريقة 1: تدوير البروكسي لكل متصفح باستخدام --proxy-server
هذه هي الطريقة الأساسية التي يبدأ بها معظم الناس، ولسبب وجيه: إنها قابلة للتنبؤ. توثيق LaunchOptions في Puppeteer يوضح أن args هي الطريقة المدعومة لتمرير معاملات سطر أوامر Chrome، و--proxy-server هو علم أصلي في Chromium.
import puppeteer from 'puppeteer';

const proxyPool = [
  'http://proxy1.example:8080',
  'http://proxy2.example:8080',
  'http://proxy3.example:8080',
];

let proxyIndex = 0;

async function scrapeWithRotation(url) {
  const proxy = proxyPool[proxyIndex % proxyPool.length];
  proxyIndex++;

  const browser = await puppeteer.launch({
    headless: true,
    args: [`--proxy-server=${proxy}`],
  });

  const page = await browser.newPage();

  // إذا كان البروكسي يتطلب مصادقة، يجب تنفيذ هذا قبل أي انتقال
  await page.authenticate({
    username: process.env.PROXY_USER,
    password: process.env.PROXY_PASS,
  });

  await page.goto(url, { waitUntil: 'domcontentloaded', timeout: 30_000 });
  const content = await page.content();

  await browser.close(); // يجب الإغلاق قبل التبديل إلى البروكسي التالي
  return content;
}
page.authenticate() يفعّل اعتراض الطلبات بصمت في الخلفية، بحسب توثيق Puppeteer. التكلفة على الأداء ليست كبيرة، لكن من المفيد معرفة هذا عندما تحاول فهم سبب بطء غير متوقع.
النتيجة المتوقعة: كل استدعاء ينتج متصفحًا جديدًا متصلًا ببروكسي مختلف. بما أن التدوير يتطلب الإغلاق وإعادة الفتح، فتكلفة بدء التشغيل حتمية. إذا كنت تجمع بيانات من 50 صفحة، فقد يكون وقت تشغيل المتصفح وحده أبطأ بشكل ملحوظ من الطريقتين الأخريين.
متى تناسبك هذه الطريقة: سكريبتات بتزامن منخفض، وجمع بيانات لمرة واحدة، وحالات تكون فيها بساطة تصحيح الأخطاء أهم من السرعة.
الطريقة 2: بوابة تدوير موثقة باستخدام proxy-chain
Chrome لا يقبل مباشرة عناوين URL للبروكسي التي تحتوي على بيانات اعتماد بصيغة user:pass@host. حزمة proxy-chain تحل مشكلة المصادقة هذه بتشغيل بروكسي محلي مجهول ينقل حركة المرور إلى البروكسي البعيد الموثّق الخاص بك. إذا كان البروكسي البعيد من مزوّد يوفر backconnect أو بوابة تدوير، فإن المزوّد يبدّل عنوان الخروج خلف نقطة النهاية الواحدة تلك حسب سياسة الجلسة. لكن proxy-chain نفسها لا توزّع تلقائيًا بروكسي مختلف لكل صفحة في Puppeteer.
import puppeteer from 'puppeteer';
import { anonymizeProxy, closeAnonymizedProxy } from 'proxy-chain';

async function scrapeThroughGateway(upstreamProxyUrl, targetUrl) {
  const localProxy = await anonymizeProxy(upstreamProxyUrl);
  let browser;

  try {
    browser = await puppeteer.launch({
      headless: true,
      args: [`--proxy-server=${localProxy}`],
    });
    const page = await browser.newPage();
    await page.goto(targetUrl, { waitUntil: 'domcontentloaded' });
    return await page.content();
  } finally {
    if (browser) await browser.close();
    await closeAnonymizedProxy(localProxy, true); // نظّف الموارد دائمًا
  }
}
كتلة finally هنا ليست زخرفة. ترك خادم بروكسي محلي دون إغلاق يواصل احتلال المنفذ، وهناك حالات فعلية حيث عدم إغلاق البروكسي المجهول أدى إلى استنزاف صامت لواصفات الملفات خلال الليل. توفر proxy-chain أيضًا رموز أخطاء محددة: 593 لمشاكل DNS، و594 لرفض الاتصال، و597 لفشل المصادقة. مفيدة جدًا لتصنيف الأعطال، وسنعود إليها لاحقًا.
متى تناسبك هذه الطريقة: عندما تترك مهمة التدوير لبوابة سكنية/مركز بيانات موثّقة يديرها المزوّد. وإذا احتجت عدة هويات بروكسي مستقرة في نفس الوقت، استخدم تقسيم المتصفح أو مرحّلًا خارجيًا مخصصًا لذلك الغرض. Puppeteer أصلًا لا يدعم رسميًا تخصيص بروكسي لكل صفحة على حدة.
الطريقة 3: التوجيه لكل طلب يتطلب مرحّلًا خارجيًا
هذه هي الطريقة الأكثر دقة. نظريًا، يمكن لكل صورة وسكريبت واستدعاء API داخل الصفحة أن يخرج عبر عنوان IP مختلف. لكن عمليًا، هي الأكثر هشاشة والأقل توثيقًا. اعتراض الطلبات في Puppeteer لم يُصمم لتبديل مسار نقل الشبكة مع كل طلب، بل لتصفية الطلبات وتعديلها.
import puppeteer from 'puppeteer';

async function inspectRequests(url) {
  const browser = await puppeteer.launch({ headless: true });
  const page = await browser.newPage();

  await page.setRequestInterception(true);

  page.on('request', async (request) => {
    // لتبديل البروكسي فعليًا مع كل طلب،
    // يجب التوجيه عبر مرحّل محلي (proxy-chain)
    // بدلًا من تبديل نقل المتصفح مباشرة أثناء التنفيذ.
    // Chrome لا يدعم هذا مباشرة.
    // معظم إعدادات الإنتاج تستخدم هذا المعالج فقط لتصفية/حظر الموارد،
    // بالتزامن مع تقسيم المتصفح أو البوابة.
    if (['image', 'font', 'stylesheet'].includes(request.resourceType())) {
      request.abort();
    } else {
      request.continue();
    }
  });

  await page.goto(url, { waitUntil: 'networkidle2' });
  await browser.close();
}
رأي صريح: تبديل عنوان IP الفعلي مع كل طلب داخل Puppeteer غير ممكن باستخدام setRequestInterception() وحدها. إذا كنت تحتاج فعلًا إلى هذا المستوى من الدقة، ضع Chrome خلف مرحّل خارجي قابل للبرمجة، أو استخدم إطار عمل جمع بيانات مبنيًا حول بروكسيات قائمة على الجلسات. في معظم المشاريع، يكون تقسيم المتصفح أو بوابة تدوير يديرها المزوّد أسهل بكثير في التشغيل والمراجعة.
طبقة مكافحة الاكتشاف الكاملة: البروكسيات الدوّارة وحدها لن تمنع الحظر
الشكوى الأكثر شيوعًا هي: "أستخدم بروكسي وما زلت أُحظر باستمرار." عنوان IP هو مجرد إشارة واحدة من عدة إشارات تراقبها أنظمة الحماية الحديثة من البوتات. إذا بدّلت IP فقط بينما بقيت باقي الإشارات غريبة، قد يصبح هذا في الواقع علامة شذوذ أكبر — مثلًا، عندما يقول المتصفح إنه Chrome على Windows بينما تشير Client Hints والمنطقة الزمنية واللغة إلى شيء آخر.
الطبقة 1: بروكسيات سكنية دوارة
كما شُرح أعلاه. عناوين الخروج السكنية عادة تبدو أكثر طبيعية من عناوين مراكز البيانات، لكن لا يوجد معيار عام لحجم المجمّع. لا تختر عدد عناوين IP عشوائيًا، بل صممه بناءً على حجم الطلبات الفعلي، ومدة الجلسة، وفترات التهدئة، وسياسة إعادة الاستخدام لدى المزوّد.
الطبقة 2: إضافة Stealth لإخفاء مؤشرات Chrome بوضع headless
puppeteer-extra-plugin-stealth يصلح أشهر الآثار الدالة على وضع headless، بما فيها navigator.webdriver، وسلاسل نصية لمُصيّر WebGL، وكائنات Chrome runtime المفقودة، وعدة إشارات كشف عبر CDP. طبقة توافق مفيدة جدًا، لكن كما يوضح ملف README الخاص بالمشروع بوضوح، هذه لعبة قط وفأر مستمرة. لا تضمن حظرًا كاملًا. استخدمها كخط أساس، ولا تعتبرها حلًا سحريًا شاملًا.
الطبقة 3: ملفات تعريف متصفح متسقة وتيرة استخدام مسؤولة
سلسلة User-Agent يجب أن تتطابق داخليًا مع المعلومات الأخرى التي يفصح عنها المتصفح فعليًا. User-Agent Client Hints الخاصة بـ Chrome تكشف معلومات المنصة بشكل منظم، لذا قد يتعارض User-Agent المكتوب يدويًا مع المنصة الفعلية. أفضل طريقة هي استخدام User-Agent الذي توفره نسخة Chromium كما هي، والحفاظ على ثبات حجم الشاشة والمنطقة الزمنية واللغة داخل الجلسة، وضبط السرعة بدلًا من إنشاء بصمة جديدة قسرًا لكل صفحة.
يمكن جمع هذه الطبقات الثلاث في إعداد تشغيل واحد كما يلي:
import puppeteer from 'puppeteer-extra';
import StealthPlugin from 'puppeteer-extra-plugin-stealth';
import { anonymizeProxy, closeAnonymizedProxy } from 'proxy-chain';

puppeteer.use(StealthPlugin());

function boundedDelay(minMs = 800, maxMs = 1800) {
  return new Promise((r) => setTimeout(r, minMs + Math.random() * (maxMs - minMs)));
}

async function stableProfileScrape(targetUrl, upstreamProxy) {
  const localProxy = await anonymizeProxy(upstreamProxy);
  let browser;

  try {
    browser = await puppeteer.launch({
      headless: true,
      args: [`--proxy-server=${localProxy}`, '--lang=en-US'],
    });
    const page = await browser.newPage();
    await page.setViewport({ width: 1366, height: 768 });
    await boundedDelay();
    await page.goto(targetUrl, { waitUntil: 'domcontentloaded' });
    return await page.content();
  } finally {
    if (browser) await browser.close();
    await closeAnonymizedProxy(localProxy, true);
  }
}
هذه الكتلة تجمع ما تغفله معظم الأدلة المنافسة. البروكسي وStealth وثبات البصمة كلها مجتمعة في مكان واحد جاهزة للتعديل مباشرة.
معالجة أخطاء بمستوى الإنتاج وفحص صحة البروكسيات
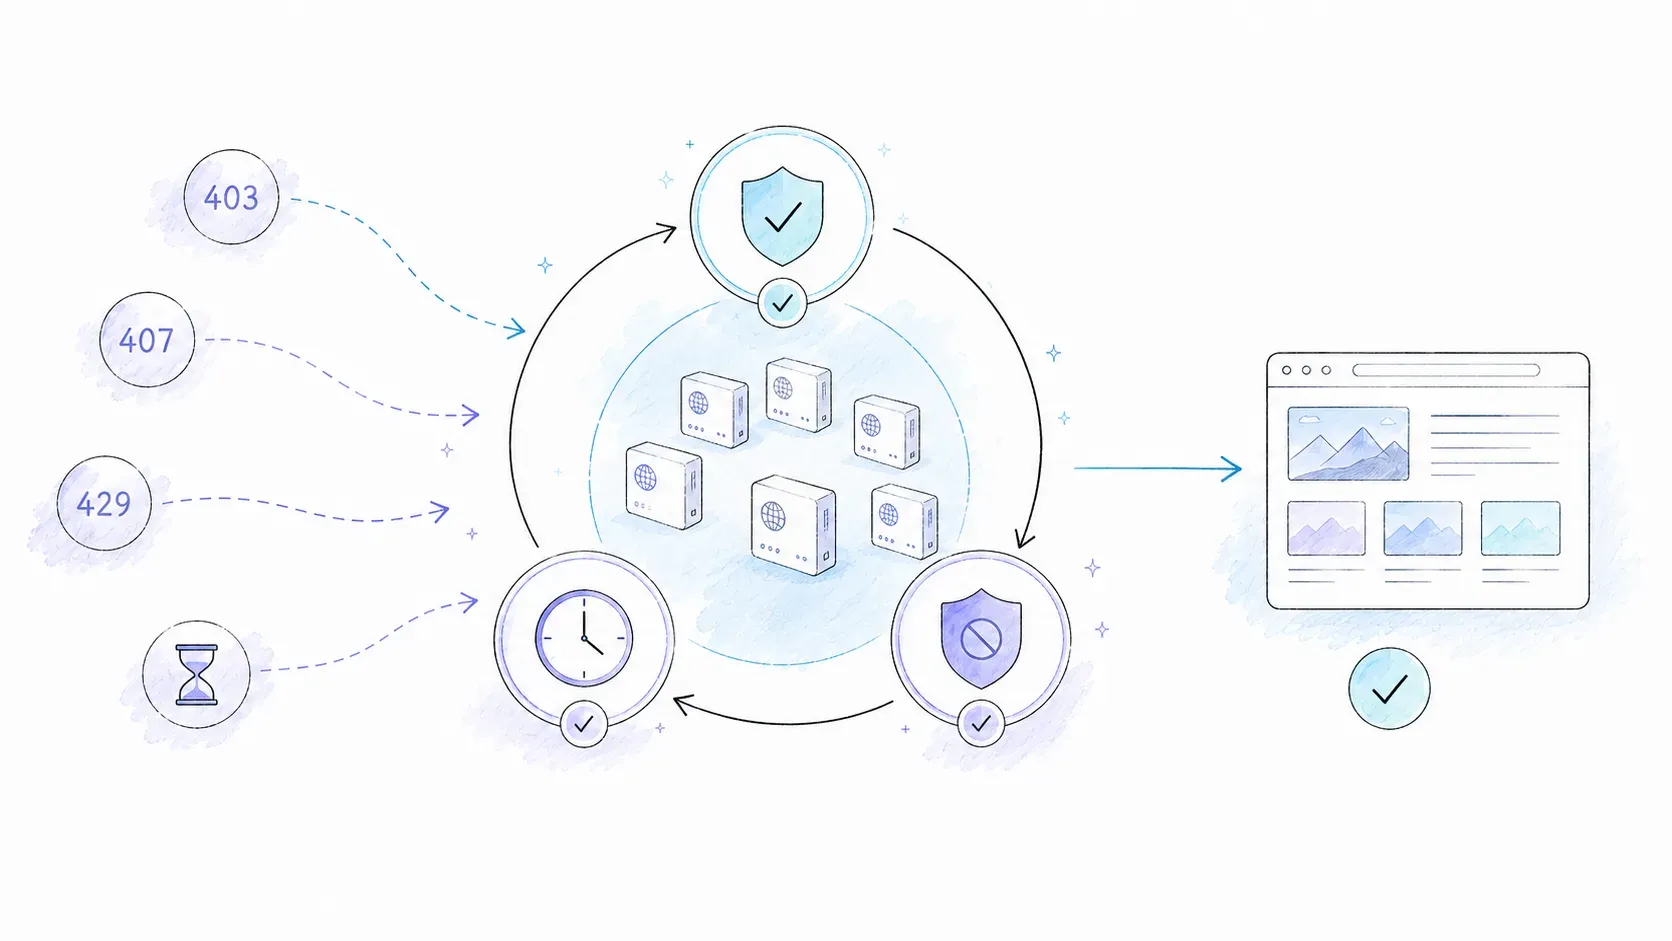
معظم الشروحات تتوقف عند نجاح المسار الطبيعي. لكن جمع البيانات الفعلي يستمر بالفشل. البروكسيات تتعطل، والمصادقة تنتهي صلاحيتها، والموقع المستهدف يفرض تحديد معدل أثناء التشغيل. هذا لا يُحل بالأمل وحده.
منطق إعادة المحاولة مع التراجع الأسي والـ jitter
function backoffMs(attempt, base = 1000, cap = 30_000) {
  const exponential = Math.min(cap, base * 2 ** attempt);
  return Math.floor(exponential * (0.5 + Math.random() * 0.5)); // jitter لمنع التدافع المتزامن
}

async function withRetry(fn, maxRetries = 4) {
  for (let attempt = 0; attempt <= maxRetries; attempt++) {
    try {
      return await fn();
    } catch (err) {
      if (attempt === maxRetries) throw err;
      const delay = backoffMs(attempt);
      console.warn(`المحاولة ${attempt + 1} فشلت: ${err.message}. سيُعاد المحاولة بعد ${delay}ms`);
      await new Promise((r) => setTimeout(r, delay));
    }
  }
}
الحظر التلقائي للبروكسيات التي تفشل باستمرار
const proxyStats = new Map(); // proxyUrl -> { success, failure }

function recordResult(proxyUrl, success) {
  const stats = proxyStats.get(proxyUrl) || { success: 0, failure: 0 };
  success ? stats.success++ : stats.failure++;
  proxyStats.set(proxyUrl, stats);
}

function isHealthy(proxyUrl) {
  const stats = proxyStats.get(proxyUrl);
  if (!stats) return true;
  const total = stats.success + stats.failure;
  if (total < 5) return true; // لا توجد بيانات كافية بعد
  return stats.failure / total < 0.5; // استبعد إذا تجاوزت نسبة الفشل 50%
}

function getHealthyProxy(pool) {
  const healthy = pool.filter(isHealthy);
  if (healthy.length === 0) throw new Error('لا يوجد بروكسي سليم متبقٍ في المجمّع');
  return healthy[Math.floor(Math.random() * healthy.length)];
}
لا تكتفِ بتسجيل النجاح/الفشل، بل سجّل نوع الخطأ أيضًا. الخطأ 407 (بيانات اعتماد خاطئة) والخطأ 429 (تحديد معدل) يتطلبان استجابتين مختلفتين تمامًا. إعادة محاولة سريعة لبروكسي بمصادقة خاطئة مجرد إهدار للوقت. ما تحتاجه في هذه الحالة ليس تدويرًا أسرع، بل التحقق من بيانات الاعتماد.
استكشاف أخطاء البروكسي الدوّار الشائعة في Puppeteer
| الخطأ | السبب الأكثر احتمالًا | الحل |
|---|---|---|
| `ERR_PROXY_CONNECTION_FAILED` | البروكسي معطل أو غير قابل للوصول | أزله من المجمّع وأعد المحاولة مع بروكسي آخر |
| `407 Proxy Authentication Required` | خطأ في بيانات الاعتماد أو طريقة مصادقة غير مدعومة | تحقق من قيم `page.authenticate()`، وعالج المصادقة المضمّنة في URL عبر `proxy-chain` |
| `TimeoutError` | البروكسي بطيء أو محظور من الطرف الآخر | زد المهلة الزمنية، وانتقل إلى بروكسي سكني |
| `403 Forbidden` | تم اكتشاف عنوان IP أو البصمة | فعّل تدوير البروكسي + stealth + عشوائية User-Agent |
| `ERR_TUNNEL_CONNECTION_FAILED` | مشكلة في نفق HTTPS | تحقق من دعم CONNECT، جرّب نفقًا محليًا عبر `proxy-chain` |
هناك نقطتان مهمتان لا تظهران بوضوح في الجدول. الحصول على رمز الحالة 200 لا يعني النجاح. الحظر الجزئي غالبًا ما يعيد صفحة HTML كاملة — صفحة تسجيل دخول أو صفحة تحدٍّ — برمز حالة طبيعي. لذا يجب فحص المحتوى الفعلي وليس فقط حالة الاستجابة. وعندما تُحظر، يوصي دليل تصحيح الأخطاء في Puppeteer بالتشغيل مع headless: false، وإضافة slowMo، واستخدام NODE_DEBUG="puppeteer:*" لرؤية سجل بروتوكول مفصّل. لكن هذه السجلات قد تحتوي على بيانات طلبات حساسة، لذا لا تتركها مفعّلة مع بيانات اعتماد إنتاجية.
مقارنة بين تدوير البروكسي ذاتيًا والبوابة الخارجية وواجهة استخراج بالذكاء الاصطناعي
| المعيار | قائمة تدوير مُدارة ذاتيًا | بوابة Backconnect (Bright Data، Oxylabs، Decodo) | واجهة استخراج بالذكاء الاصطناعي (Thunderbit) |
|---|---|---|---|
| التكلفة (نطاق صغير) | منخفضة إلى متوسطة | متوسطة إلى مرتفعة لكل GB | منخفضة (خطة مجانية ثم دفع حسب الاستخدام) |
| الموثوقية | تعتمد على فحوصات الصحة التي تبنيها بنفسك | مرتفعة (يديرها المزوّد) | مرتفعة (بنية تحتية مُدارة) |
| تجنّب الاكتشاف | عليك حله بنفسك | جزئي (تدوير IP فقط) | مدمج |
| مخرجات منظّمة | لا (HTML خام) | لا (HTML خام) | نعم (بمخطط JSON) |
| وقت الإعداد | ساعات | دقائق | دقائق |
| مستوى التحكم | كامل | يعتمد على واجهة برمجة المزوّد | يعتمد على نموذج المخطط |
أسعار المزوّدين الحالية، اعتبارًا من 2026-08-07، تعطي فكرة تقريبية عن منحنى تكلفة أسلوب البوابة. أسعار البروكسي السكني لدى Bright Data تقدّم دفعًا حسب الاستخدام وخططًا بحجم أكبر، والعروض الترويجية قابلة للتغيير. Oxylabs يعرض 6 دولارات/GB عند 5GB، و2.50 دولار/GB عند 1TB. Decodo (المعروف سابقًا باسم Smartproxy) يعرض 3.75 دولار/GB عند 3GB، و2.75 دولار/GB عند 100GB، و4 دولارات/GB حسب الاستخدام. يدّعي Decodo أيضًا أكثر من 115 مليون عنوان IP ونسبة نجاح 99.92%، لكن هذا ادعاء من المزوّد وليس نتيجة تحقق مستقل.
المعيار الذي أستخدمه فعليًا هو: هل تحتاج تفاعلًا مع الصفحة؟ نقرات، تمرير، تعبئة نماذج، الحفاظ على جلسة تسجيل دخول؟ في هذه الحالة، ابنِ الحل بـ Puppeteer وبروكسي. هل تحتاج فقط بيانات عامة منشورة؟ في هذه الحالة، انظر إلى واجهة استخراج قبل أن تبني بنية بروكسي بنفسك.
متى يكون Puppeteer + البروكسيات مبالغة؟ استخرج البيانات المنظمة عبر API بدلًا من ذلك
في أحد الأيام، بعد أن أعدت بناء نظام فحص صحة البروكسي للمرة الثالثة، في مشروع كل ما يحتاجه هو استخراج قائمة أسعار منتج واحدة، أدركت أن كل هذه البنية موجودة أصلًا لحل مشكلة واحدة: جمع HTML خام من الصفحة. لكن هذا ليس الهدف الحقيقي للمطوّر. الهدف هو بيانات منظّمة. HTML مجرد صيغة وسيطة مزعجة.
واجهة Thunderbit المفتوحة تتعامل مع الاستخراج كوظيفة أساسية، لا كنتيجة جانبية لأتمتة المتصفح. POST /extract يستقبل عنوان URL ومخطط JSON Schema، ويعيد بيانات منظّمة مطابقة لذلك المخطط. في الخلفية، تتعامل الواجهة مع رندرة JavaScript، والحماية من البوتات، وحل CAPTCHA، لذا لست بحاجة للتعامل مباشرة مع إضافات stealth ومجمّعات البروكسي.
curl -X POST https://openapi.thunderbit.com/openapi/v1/extract \
  -H "Authorization: Bearer $THUNDERBIT_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "url": "https://example.com/product",
    "schema": {
      "type": "object",
      "properties": {
        "name": {"type": "string"},
        "price": {"type": "number"}
      },
      "required": ["name", "price"]
    }
  }'
وإذا كنت تحتاج Markdown نظيفًا بدلًا من مخطط صارم، هناك نقطة نهاية POST /distill أيضًا، مع دعم للاستخراج الدفعي بنفس المخطط على عدة عناوين URL دفعة واحدة. بحسب أسعار Thunderbit API الحالية، يستهلك Distill وحدة واحدة لكل صفحة، بينما يستهلك Extract 20 وحدة لكل صفحة. تتضمن الخطة المجانية 600 وحدة لمرة واحدة، وهذا كافٍ لاختبار سير العمل قبل التبني الفعلي.
للمطوّرين الذين يعملون داخل Claude أو Cursor أو عملاء متوافقين مع MCP، يوفر Thunderbit أيضًا thunderbit_extract وthunderbit_distill كأدوات MCP. هذا يسمح للوكيل بأن يقرر بنفسه متى يحتاج لاستخراج بيانات من صفحة أثناء العمل. لكن يُنصح بمراجعة توثيق API المباشر أولًا قبل ربط MCP، لأن أسماء الأدوات أو المعاملات قد تتغير حسب إصدار التوثيق.
| البند | Puppeteer مُدار ذاتيًا + بروكسي دوّار | واجهة Thunderbit |
|---|---|---|
| تعقيد الإعداد | مرتفع — يشمل مجمّع بروكسي، ومنطق تدوير، وstealth، وإعادة محاولة | منخفض — مخطط JSON واستدعاء API واحد |
| التعامل مع الحماية من البوتات | يدوي | مدمج |
| المخرجات | HTML خام (يحتاج تحليلًا) | JSON منظّم مطابق للمخطط |
| الصيانة | مرتفعة — المحددات تتعطل والبروكسيات تموت | منخفضة |
| الحالة المناسبة | أتمتة مخصصة، تدفقات تسجيل دخول، تفاعلات خاصة | استخراج بيانات بحجم كبير |
بالإنصاف للأسلوب المبني ذاتيًا، إذا كان لديك حساب يتطلب تسجيل دخول، أو تدفق نقرات متعدد المراحل، أو تحتاج للحفاظ على حالة الجلسة، فواجهة الاستخراج غالبًا لا يمكنها تعويض ذلك. الأسئلة الشائعة لدى Thunderbit توضح أيضًا أن الواجهة الحالية لا تدعم تدفقات تسجيل الدخول التفاعلية. في هذه الحالة، يظل Puppeteer مع البروكسي هو الخيار الصحيح. لكن إذا كانت المهمة هي "استخراج بيانات منظّمة من عدة صفحات عامة ووضعها في مخطط أحدده بنفسي"، فبناء بنية بروكسي دوّار بنفسك يعني حل مشكلة أصعب من المشكلة الفعلية. للفرق التي تفضل تجنب البرمجة كليًا، تُوسّع Thunderbit لمتصفح Chrome نفس الاستخراج المعتمد على الذكاء الاصطناعي بضع نقرات فقط، وتستحق المقارنة مع استخراج الويب بدون برمجة وإعداد فريق تطوير كامل.
الخلاصة وأهم النقاط
تدوير البروكسي في Puppeteer ليس تقنية واحدة. التدوير لكل متصفح بسيط ومعزول. بوابة backconnect الموثّقة يمكنها تبديل عنوان IP الخارج على مستوى المتصفح خلف نقطة نهاية واحدة. أما التوجيه الدقيق لكل طلب أو الهويات المتعددة المتزامنة فتحتاج تقسيم المتصفح أو مرحّلًا خارجيًا، واعتراض الطلبات وحده لا يغيّر مسار شبكة Chrome.
لكن كل هذا لا يعني شيئًا كبيرًا بدون البنية الكاملة. البروكسي يحل مشكلة سمعة IP فقط. إضافة Stealth وثبات البصمة يعالجان مشكلة إشارات المتصفح. الـ jitter وضبط السرعة يحلّان مشكلة نمط السلوك. إذا غابت أي طبقة من هذه الطبقات، يبقى احتمال الحظر مرتفعًا، ويتغير فقط السبب.
إذا كنت تبني الحل بنفسك، ابدأ من مستودع proxy-chain وكتل الكود أعلاه. يمكنك الوصول لمسافة أبعد من معظم الدورات المدفوعة. وإذا كنت تريد تخطي إدارة البروكسي كليًا والحصول على بيانات منظّمة مباشرة، فقراءة توثيق Thunderbit API لعشر دقائق أفضل من قضاء عطلة نهاية أسبوع كاملة في بناء بنية فحص صحة. أي مسار تختاره جيد. لكن تأكد أنك تحل المشكلة الفعلية التي تواجهها، لا المشكلة التي تخيلتها المقالات بدلًا منك. إذا أردت نظرة أوسع على كيف يغيّر الذكاء الاصطناعي هذا المجال، اطّلع أيضًا على كيف يختلف استخراج الويب بالذكاء الاصطناعي عن الطرق التقليدية.
الأسئلة الشائعة
كم مرة يجب تدوير البروكسي في Puppeteer؟
يعتمد على مدى صرامة تحديد المعدل في الموقع المستهدف. المواقع ذات الحماية القوية من البوتات تحتاج تدويرًا لكل صفحة أو لكل جلسة. المواقع الأقل صرامة قد تكفيها جلسة واحدة أو عنوان IP ثابت واحد. لا يوجد معيار عالمي موحد. إذا رأيت أخطاء 403 أو 429 أو مهلات زمنية، اعتبر ذلك إشارة لتدوير أكثر قوة، وليس قاعدة ثابتة لعدد الطلبات.
هل يمكن استخدام بروكسيات مجانية لاستخراج بيانات Puppeteer؟
من الناحية التقنية، نعم. لكن لا يُنصح بذلك إلا للاختبار السريع. قوائم البروكسي المجانية عادة بطيئة وغير مستقرة، وغالبًا محظورة أصلًا لدى الموقع المستهدف. في بيئة الإنتاج، تستحق البروكسيات السكنية المدفوعة أو البوابات المُدارة التكلفة.
هل puppeteer-extra-plugin-stealth فعّال ضد كل أنظمة الحماية من البوتات؟
لا. ملف README الخاص بالإضافة يعترف بذلك أيضًا. الإضافة تقلل من الإشارات الشائعة لوضع headless في Chrome، لكن الموقع المستهدف لا يزال يستطيع تقييم سمعة الشبكة، وخصائص TLS، والكوكيز، وClient Hints، وأنماط السلوك. اعتبرها طبقة مساعدة، لا ضمانًا مطلقًا.
ما الفرق بين proxy-chain و--proxy-server في Puppeteer؟
--proxy-server هو علم أصلي يُستخدم عند تشغيل Chromium، ويحدد نقطة نهاية بروكسي واحدة لكل نسخة متصفح. Chrome لا يقبل مباشرة بيانات مصادقة البروكسي المضمّنة فيه. أما proxy-chain فتنشئ نفقًا محليًا مجهولًا يتصل ببروكسي بعيد موثّق. بعد ذلك، يجب التعامل مع التدوير إما بإعادة البدء ببروكسي آخر، أو عبر بوابة backconnect يديرها المزوّد، أو مرحّل خارجي مخصص لذلك. proxy-chain لا توزّع تلقائيًا بروكسي لكل صفحة في Puppeteer.
هل يمنع تدوير البروكسي وحده الحظر تمامًا؟
لا. هذا أكثر سوء فهم شائع. الأنظمة الحديثة مثل إدارة البوتات في Cloudflare تنظر معًا إلى سمعة IP، وبصمة المتصفح، وأنماط السلوك، وسجل الجلسة. البروكسي يحل جزءًا فقط من سمعة IP. لتجنّب الباقي، ما زلت بحاجة إلى إعدادات stealth، وبصمة متسقة، وتوقيت واقعي.
لمعرفة المزيد



