
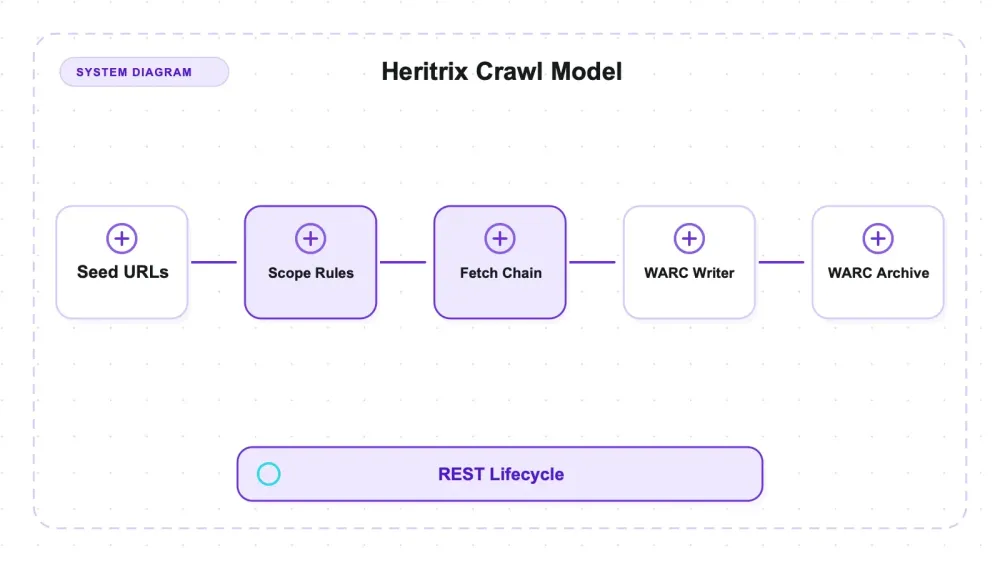
Heritrix هي زاحف الأرشفة مفتوح المصدر التابع لـ Internet Archive — سلالة البرمجيات التي تقف خلف Wayback Machine، وتعمل في الإنتاج منذ عقدين. مهمتها التقاط ما قدّمته الصفحة بأمانة، وحفظه في ملفات WARC يمكن إعادة تشغيلها بعد سنوات. تحت الغطاء هي محرك Java تُكتب فيه كل عملية زحف كرسم بياني لـ Spring beans بصيغة XML، وتُدار دورة حياة المهمة بالكامل عبر REST API. إنها ليست أداة استخراج: لا صياغة selector، ولا ربط حقول، ولا صفوف في النهاية.
اختبرت النسخة 3.16.0 مقابل fixture محلي مضبوط، وعددت ما كتبته فعليًا سجلًا سجلًا. الاكتمال هو ما يلفت الانتباه: أنتجت عشرون URI مجلوبة واحدًا وستين سجل WARC، مع payload digest وIP التقاط على كل استجابة، وكل طلب مرتبط بالاستجابة التي يخصها، دون الحاجة لضبط أي إعداد. أما تشغيلها فتجربة معاكسة تمامًا — 41 ميجابايت، و114 ملف jar (يحتوي lib/ على 142 ملفًا؛ 28 منها نصوص LICENSE وNOTICE مُرفَقة)، وإعداد مهمة بنحو 750 سطرًا قبل أول جلب — مع أن كل عملية زحف هنا عملت بلا واجهة عبر curl، دون أي نقرة في واجهة ويب.
كشفت نتيجة التخزين عن سلوك افتراضي أقل وضوحًا. أعاد رابطا fixture محتوى مطابقًا بايتًا ببايت، والملف القياسي جلب وأرشف كليهما بالكامل: سجلا response وصفر سجلات revisit، رغم إسناد نفس payload digest لكلا الاستجابتين. يعمل إزالة التكرار بالـ digest بعد إضافة معالجات history؛ وهو غير مفعّل في الملف القياسي، ويوفر مساحة التخزين لا عرض النطاق.
ما هي Heritrix فعليًا
الأرشفة ليست استخراج بيانات، وهذا خلط بين فئتين يستحق التوضيح. لا تسلّمك Heritrix صفوفًا. لا يوجد CSV في النهاية. مخرجها هو محادثة HTTP نفسها — ترويسات ومتون وبيانات وصفية للالتقاط — مُخزَّنة بصيغة مصمَّمة للحفظ، وهي التطبيق المرجعي لهذه الفئة الكاملة من العمل. طلب قائمة أسعار منتجات منها أشبه بطلب ملخص من مُقرِّر جلسة محكمة.
الأرقام الحالية حتى 27 يوليو 2026: يحمل المستودع 3,285 نجمة و36 issue مفتوحة، وأحدث إصدار هو 3.16.0، نُشر في 2026-07-03. هذا بالضبط الإصدار الذي اختبرته، فلا شكوى هنا عن نسخة قديمة. للترخيص عقدة واحدة: ملف LICENSE نفسه Apache-2.0 صريح، لكن كاشف GitHub يُبلغ عن "Other" لأن بعض الملفات الخارجية المُرفَقة تحمل شروطها الخاصة. إن كانت Heritrix ستُدمَج داخل منتج تجاري، فهذا يستحق خمس دقائق من انتباه قانوني حقيقي، لا مجرد نظرة على شارة الشريط الجانبي.
حقيقة بنيوية واحدة تشكّل كل شيء آخر: لا تُشغّل Heritrix متصفحًا. إنها تجلب عبر HTTP وتستخرج الروابط من البايتات العائدة. نظيرتها في الأرشفة الحديثة، Browsertrix Crawler، تفعل العكس — Chromium حقيقي يسجّل ما فعله المتصفح فعليًا. كلاهما يكتب WARC، لكن هذه المراجعة قاست فقط مسار Heritrix غير المعتمد على متصفح؛ ولم تقارن سعة أو إنتاجية أي من النظامين.
Chains وbeans وSURT: كيف تُبنى عملية الزحف فعليًا
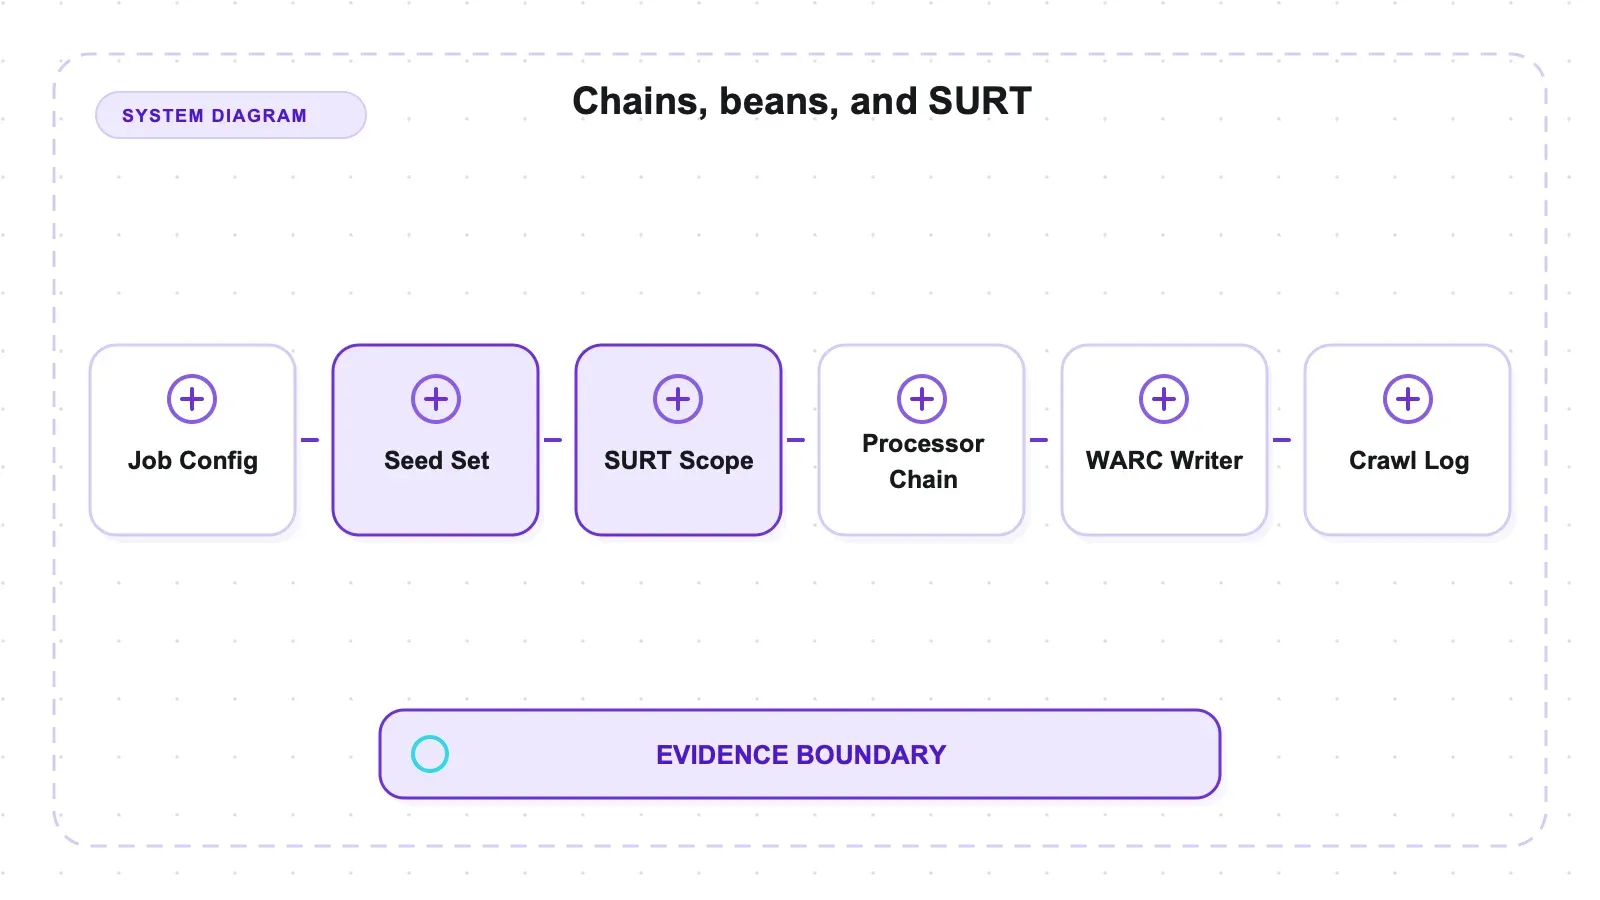
تحت الغطاء، مهمة Heritrix هي Spring application context. ليست "مُعدَّة باستخدام Spring" فحسب — بل هي رسم بياني لـ Spring beans، مكتوب بصيغة XML، وكل جزء من الزحف هو bean يمكنك استبداله.
الـ frontier يحمل طابور URI، مُقسَّمًا حسب المضيف. هذا التقسيم هو سبب عمل politeness بالطريقة التي تعمل بها، وسيكون مهمًا لاحقًا.
سلاسل المعالجة تنجز العمل على ثلاث مراحل: سلسلة مرشحين (هل يجب جدولة هذا الـ URI المُكتشَف؟)، وسلسلة جلب (DNS، robots، جلب HTTP، استخراج الروابط)، وسلسلة تصريف (الكتابة إلى WARC، تحديث الحالة). إضافة قدرة جديدة إلى Heritrix تعني عادةً إدراج processor bean في النقطة الصحيحة من السلسلة الصحيحة، وهذا بالضبط كيف فعّلت dedup.
الـ Scope كومة من DecideRules تعمل على SURT — اختصار Sort-friendly URI Reordering Transform، التي تعيد كتابة http://www.example.com/a إلى http://(com,example,www,)/a حتى تُرتَّب بادئات أسماء المضيفين هرميًا. يُولَّد الـ scope الافتراضي من بادئات SURT الخاصة بالـ seeds لديك. تقبل القواعد وترفض بالتتابع، وتفوز آخر مطابقة.
كاتب WARC يقع في سلسلة التصريف، وتعيش politeness في الـ frontier كثلاثة أرقام: delayFactor وminDelayMs وmaxDelayMs. أما طاعة robots فهي سلسلة سياسة نصية على الـ fetcher.
وكل هذا يمكن التحكم به عبر REST API، وهو أمر تبيّن أنه أهم مما توقعت.
الإعداد هو الجزء الأثقل في التجربة كلها
ما عليك نشره قبل أول عملية جلب:
| بُعد الإعداد | Heritrix 3.16.0 |
|---|---|
| حجم الملف المضغوط للتوزيع | نحو 41 ميجابايت |
عدد الملفات داخل lib/ بعد فك الضغط | 142 ملفًا إجمالاً: 114 ملف .jar و28 نص LICENSE/NOTICE |
| ما يُشغَّل عند بدء التشغيل | محرك Java مع واجهة Jetty مضمّنة على https://localhost:8443 خلف شهادة موقّعة ذاتيًا |
| الزمن حتى جاهزية REST على جهازي | نحو عشر ثوانٍ |
إعداد المهمة القياسي (crawler-beans.cxml) | نحو 750 سطرًا من Spring bean XML |
لن تلمس معظم إعداد تلك المهمة أبدًا. لكن لا يمكنك تجاوزه، وهناك حقلان إلزاميان قبل أن يجلب الزاحف أي شيء: الـ seed لديك، وmetadata.operatorContactUrl. القيمة القياسية مجرد عنصر نائب، ولن يعمل الزحف حتى تستبدلها برابط حقيقي يحدد هوية من يشغّل عملية الزحف.
هذا الشرط يخلق آلية مساءلة: يجب على المُشغِّل توفير رابط تواصل قبل أن يعمل الزاحف. هذا لا يُثبت دقة الهوية، ولا أن عملية الزحف مُصرَّح بها، ولا أنها تمتثل للقواعد المعمول بها، لكنه يجعل معلومات التواصل جزءًا من المهمة لا مجرد عرف اختياري.
أدهشتني فعليًا نتيجتان من الإعداد.
عملت على JDK أحدث من الحد الأدنى المذكور في التوثيق. يطلب دليل البدء إصدار Java 17 أو أحدث. لكن Heritrix 3.16.0 أقلعت، وشغّلت REST API، وأنهت كل عمليات الزحف في هذا الـ fixture على OpenJDK 26.0.1، دون --add-opens أو --enable-preview أو أي حلول التفافية لـ Security Manager. هذه نتيجة واحدة على macOS arm64، لا مصفوفة توافق كاملة، لكنها تؤكد أن هذا الإصدار المُختبَر لم يكن مقيَّدًا بـ JDK 17 على هذا الجهاز.
لست بحاجة أبدًا للمس واجهة الويب. دورة حياة المهمة بأكملها REST، وقد أتمتت العملية كاملة بأمر curl: إنشاء المهمة، رفع ملف beans عبر PUT، build، launch، unpause، استطلاع الحالة حتى تصبح FINISHED، ثم terminate وteardown. هذه هي الإجابة الحقيقية عن سؤال "هل Heritrix قابلة للتشغيل داخل pipeline؟" — نعم، بلا واجهة، ودون أي نقرة متصفح في أي مكان. تُظهر معظم المقالات لقطات شاشة لواجهة Jetty وتُوحي بأنها الواجهة الأساسية. إنها راحة إضافية، لا شرط.
ملاحظة نشر خاصة بهذا الجهاز: يشغّل هذا الـ Mac وكيل HTTP على مستوى النظام عبر Surge. ورث عميل Java الخاص بـ Heritrix ذلك الوكيل وأرسل عبره حتى حركة 127.0.0.1 الخاصة بالـ fixture، منتجًا استجابات 503 رغم قائمة استثناءات نظام التشغيل وNO_PROXY. تشغيل JVM بخيار -Djava.net.useSystemProxies=false غيّر النتيجة من 2×503 إلى 18×200. كان هذا تفاعلًا بيئيًا، لا خللاً في Heritrix؛ ويصبح الخيار مهمًا فقط حين لا تريد وراثة إعدادات وكيل النظام.
ما الذي ينتهي فعليًا في الأرشيف
شغّلت الملف القياسي الافتراضي مقابل fixture مضبوط — خادم محلي بمجموعة endpoints معروفة، تضم صفحات HTML، وسلسلة عمق من ثلاثة مستويات، وrobots.txt وsitemap، ومسارات 404 و500 متعمّدة — ثم حلّلت ملف WARC الناتج سجلًا سجلًا بدلاً من الثقة بسطر ملخّص.
أنتجت عشرون URI مجلوبة واحدًا وستين سجلاً:
| نوع سجل WARC | العدد | ما يحتويه |
|---|---|---|
warcinfo | 1 | معلومات مصدر على مستوى الزحف، تُكتب مرة واحدة لكل ملف |
response | 20 | الاستجابة الكاملة لـ HTTP، الترويسات والمتن |
request | 20 | الطلب الدقيق الذي أرسلته Heritrix |
metadata | 20 | ملاحظات الالتقاط الخاصة بـ Heritrix |
نسبة نظيفة 1:1:1 بين response وrequest وmetadata لكل URI، مباشرة من الصندوق، دون أي إعداد مني. واكتمال كل سجل صمد أمام الفحص:
| فحص كل سجل | العدد | لماذا يهم |
|---|---|---|
payload digest ببادئة sha1: على الاستجابات | 20/20 | — |
WARC-IP-Address على الاستجابات | 20/20 | عنوان IP الذي جاء منه المحتوى فعليًا، وهو ما تحتاجه بشدة بعد سنوات حين يتغيّر مالك النطاق |
سجلات request مرتبطة باستجاباتها عبر WARC-Concurrent-To | 20/20 | ليس "مرتبطة في الغالب". كلها مرتبطة. |
وحُفِظت حالة HTTP حرفيًا، بما فيها غير المريحة منها: تظهر 200 OK و404 Not Found و500 Internal Server Error جميعها كأسطر حالة حقيقية في الاستجابات المُخزَّنة بدلاً من إسقاطها كأخطاء.
هذه النقطة الأخيرة تفصل الأرشفة عن الاستخراج أكثر من أي شيء آخر. تتعامل أداة الاستخراج مع 500 كخطأ يُعاد المحاولة فيه أو يُتخطى. أما الأرشيف فيتعامل معه على أنه ما قاله الخادم في تلك اللحظة بالضبط، وهي حقيقة تستحق الحفظ. تصف صفحة ويكي Heritrix Output بنية هذا السجل؛ لكن ما لم أره في أي مكان آخر هو التعدد المقيس وارتباط 20/20 على مجموعة endpoints معروفة. والنتيجة صمدت.
نتيجة dedup، مقيسة من الجهتين
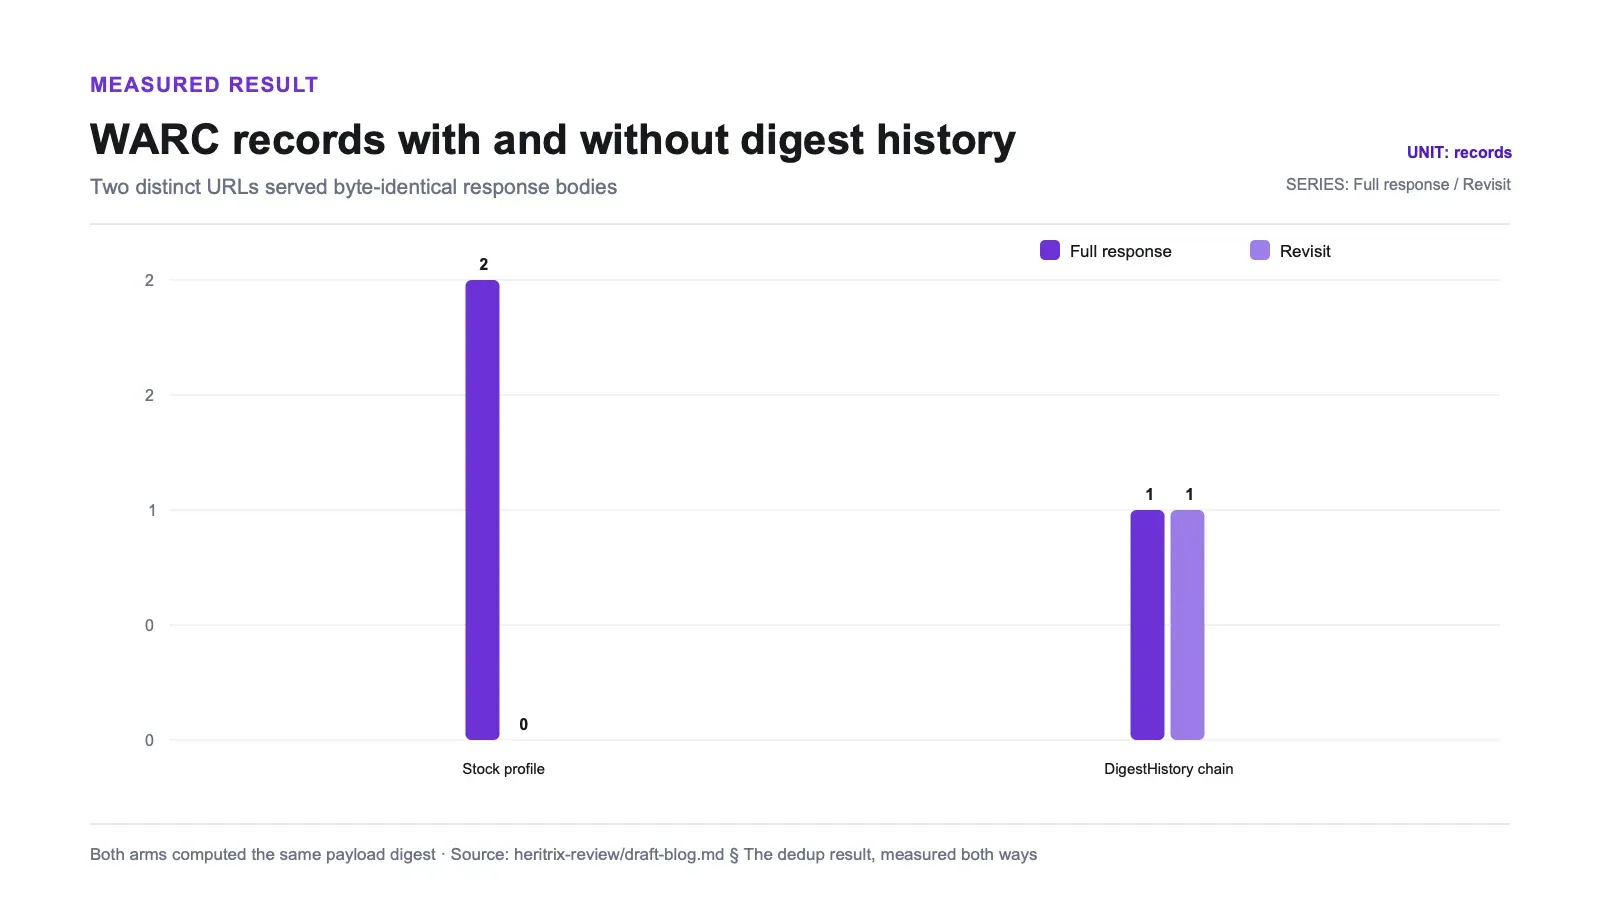
قدّم fixture الخاص بي /dup/one و/dup/two بمتنين متطابقين بايتًا ببايت. روابط مختلفة، محتوى واحد — بالضبط الحالة التي وُجد dedup القائم على digest لدمجها. شغّلته مرتين: مرة بالملف القياسي، ومرة بعد إدراج سلسلة digest-history (BdbContentDigestHistory، بالإضافة إلى ContentDigestHistoryLoader في سلسلة الجلب وContentDigestHistoryStorer بعد كاتب WARC).
| الملف القياسي الافتراضي | مع سلسلة ContentDigestHistory | |
|---|---|---|
سجلات response الكاملة المكتوبة | 2 | 1 |
سجلات revisit المكتوبة | 0 | 1 |
| payload digest مشترك | نعم (كلاهما) | نعم |
| نوع revisit | — | identical-payload-digest |
من الصندوق مباشرة، حصلت الاستجابتان على نفس digest، لكن لم يتصرف أي معالج history تجاهه وكُتب كلا الحمولتين بالكامل. إضافة السلسلة حوّلت الالتقاط الثاني إلى سجل revisit في WARC يشير إلى نفس payload digest، وهو السلوك الذي تُعرّفه مواصفة WARC 1.1 لسجلات revisit.
لا شيء من هذا سرّي. تنص صفحة ويكي Duplication Reduction Processors على أن skipIdenticalDigests قيمتها الافتراضية false، وأن dedup غير المرتبط بالـ URL يحتاج تلك الـ beans الخاصة بالـ loader وstorer. هذا ليس سلوكًا مخفيًا اكتُشف، بل مثل كل ما قِسته هنا تقريبًا، سلوك موثَّق لـ Heritrix مع رقم مباشر مُرفَق به. الفجوة هي بين التوثيق وما يعتقده الناس، وفي تجربتي عادة ما يكون الاعتقاد "Heritrix تُجري dedup"، نقطة، دون أي حاشية عن الإعداد.
نتيجتان تابعتان تستحقان الاستيعاب:
dedup يحدث وقت الكتابة، لا في عرض النطاق. هذه آلية وليست شيئًا قسته بشكل منفصل، لكنها تنبع مباشرة من طريقة عمل content digests: لا يمكنك مقارنة digest إلا بعد وصول البايتات، لذا يُجلَب الرابط الثاني من المصدر في كل الأحوال. تفعيل السلسلة يقلّل ما تخزّنه، لا ما تنقله ولا ما يجب على الخادم الهدف تقديمه. من يحسب dedup كمكسب في politeness أو عرض النطاق يفهمه بالمقلوب.
تقديرات التخزين المبنية على افتراض "سيحدث dedup" قد تكون خاطئة بشدة. إن كنت تؤرشف موقعًا فيه تكرار قوالب كثيف — ملفات PDF مكررة، صفحات هبوط قالبية، نسخ للطباعة من نفس المقالات — وحسبت سعة الأقراص على افتراض أن المتون المتطابقة ستُدمَج، فقد يستهلك الملف القياسي مساحة أكبر بكثير من ذلك التقدير. يُثبت fixture الرابطين السلوك الافتراضي فقط، لا أثره على نطاق مليون URI؛ ويعتمد ذلك الأثر على معدل التكرار وحجم الحمولة وتصميم إعادة الزحف.
Scope وrobots فعلا تمامًا ما وعدا به
كلام الزاحف نفسه عمّا لم يجلبه لا يساوي الكثير، لذا قِست الحالتان بعدّاد زيارات من طرف الخادم — الخادم الهدف نفسه يعدّ الطلبات، بمعزل عن أي شيء سجّلته Heritrix.
| الضابط | الحالة | زيارات الخادم للهدف | ما أظهره سجل الزحف |
|---|---|---|---|
| Scope | نطاق افتراضي؛ زرعت صفحة ترتبط بمضيف ثانٍ له authority مختلف في SURT | 0 | لم يظهر المضيف خارج النطاق أبدًا — أي رُفض عند الاكتشاف، لا أنه دخل الطابور وفشل |
| Robots | سياسة الطاعة الافتراضية؛ ربطت الصفحة الرئيسية بـ /robots-denied/secret، الممنوع في ملف robots.txt الخاص بالـ fixture | 0 | سُجِّل كمحظور (تم جلب robots.txt نفسه) |
| Robots | ضبط: تغيير robotsPolicyName إلى ignore، وإعادة التشغيل | 1 | — |
Scope. في المقابل، زُحف المضيف داخل النطاق بشكل طبيعي، فالانضباط في الـ scope كان قائمًا لا أن الزحف كان معطلاً. تجدر ملاحظة: شغّلت هنا فرع النطاق الافتراضي فقط، لا ضابط إيجابي بنطاق موسَّع، لذا اقرأ هذا كتأكيد لتصميم موثَّق لا كإثبات من الجهتين.
Robots. كان الرابط قابلاً للوصول دائمًا؛ سياسة robots فقط منعته. الطاعة حقيقية ومنفذ التجاوز حقيقي، وهذا هو الترتيب الصحيح — فبعض تفويضات الأرشفة تتجاوز robots بشكل مشروع، ويجب أن يتطلب ذلك كتابة ignore عمدًا في ملف الإعداد.
Politeness: 57.7 ثانية لزحف عشرين صفحة محلية
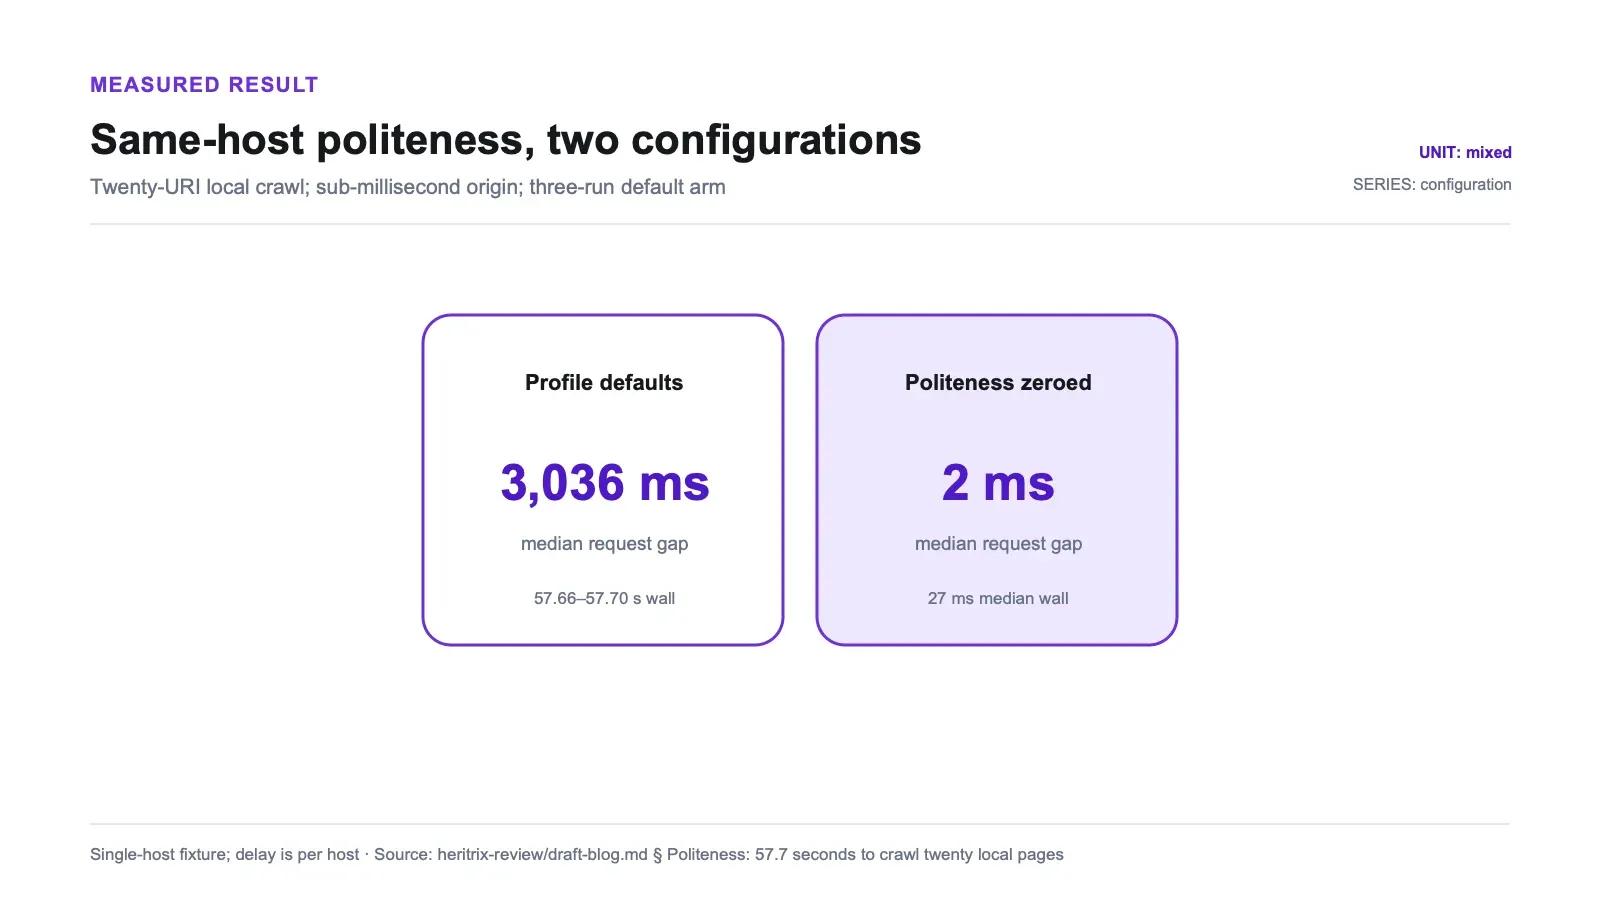
رقم واحد يحدد ما إذا كانت Heritrix تناسب مشروعك.
نفس الـ fixture، ونفس معالجة التشغيلات الثلاث، على مضيف محلي واحد بزمن استجابة أقل من مللي ثانية:
| إعداد politeness | الفاصل الوسيط بين الطلبات لنفس المضيف | الزمن الكلي لزحف 20 URI |
|---|---|---|
إعدادات الملف الافتراضية (delayFactor 5.0, minDelayMs 3000, maxDelayMs 30000) | 3,036 ms (أدنى 3,021، أقصى 9,107، عبر 48 فجوة مقيسة) | 57.66 ث / 57.66 ث / 57.70 ث (التشغيلات الثلاث) |
| politeness مضبوطة على صفر | 2 ms | 27 ms (وسيط) |
يقع التأخير الفعلي مباشرة عند حد minDelayMs الأدنى: على مصدر بزمن استجابة أقل من مللي ثانية، تكون delayFactor × زمن الجلب مهملة ويهيمن الحد الأدنى بحكم البنية. النسبة بين الصفّين غير مفيدة لأن مقام الصف الخالي من politeness ليس إلا عشرات المللي ثانية ويتذبذب من تشغيلة لأخرى. النتيجة الثابتة هي الحد الأدنى المطلق: انتظرت Heritrix الافتراضية نحو ثلاث ثوانٍ بين الطلبات لنفس المضيف في هذا الـ fixture، محوّلة زحف عشرين صفحة إلى نحو دقيقة من الزمن الكلي.
طريقة ملموسة لتلمّس الأمر. لنفترض أن مكتبة جامعية تحتاج أرشفة موقع حكومي من 50,000 صفحة قبل إيقافه، وكلها على مضيف واحد. عند حد 3 ثوانٍ لكل مضيف، هذا 150,000 ثانية من الانتظار الإلزامي — نحو 42 ساعة، أو يوم وثلاثة أرباع تقريبًا، قبل احتساب زمن الجلب نفسه. هذا حساب مبني على الحد الأدنى المقيس 3,036 ms — 50,000 × 3.036 ث = 151,800 ث = 42.2 ساعة؛ وحتى عند الحد الأدنى المضبوط 3,000 ms تكون النتيجة 41.7 ساعة، وتُقرَّب إلى 42 لا 41. ليست عملية زحف مقيسة فعليًا، لكنها الحساب الذي تحتاجه خطة مشروعك.
بالإنصاف، politeness في Heritrix هي لكل مضيف، لأن الـ frontier يُصفّف الطابور حسب المضيف. عملية زحف واسعة عبر آلاف النطاقات تتوازى عبر تلك الطوابير ولا ترث هذا السقف عالميًا. كان fixture الخاص بي مضيفًا واحدًا، وهو أسوأ حالة لهذا الرقم بالذات. إن كان هدف أرشفتك موقعًا كبيرًا واحدًا، فتلك الحالة الأسوأ هي حالتك.
وهذه ميزة. التأخير هو ما يجعل زاحف الأرشفة شيئًا يتحمله مالك الموقع بدلاً من حظره. خفضه قرار بشأن خادم شخص آخر، وتجعل الأداة هذا القرار صريحًا بدلاً من أن يكون الإعداد الافتراضي عدوانيًا.
ما لم أختبره
تغطي هذه القياسات انضباط الزحف على fixture مضبوط، ولا شيء أوسع من ذلك. خارج هذا الحد:
- dedup عبر عمليات زحف متعددة وإعادة الزحف. قست فقط dedup القائم على content-digest داخل عملية الزحف الواحدة. حفظ قاعدة بيانات تاريخ URI عبر عمليات زحف منفصلة (
FetchHistoryProcessor+PersistLog) آلية مختلفة ولم أختبرها. - الحجم والاستقرار طويل المدى. لا frontier بمليون URI، ولا checkpoint-and-restore، ولا تشغيل متعدد الأيام. يقيس fixture الخاص بي الانضباط لا التحمّل.
- الالتقاط المُنتَج عبر جافاسكربت. التقاط Heritrix الافتراضي غير معتمد على متصفح، وهذا ما قسته. السلوكيات الاختيارية القائمة على متصفح غير مُختبَرة هنا.
- politeness على مصدر عالي الكمون. الكمون المحلي أقل من مللي ثانية، لذا هيمن
minDelayMsبحكم البنية. كيفية تدرّجdelayFactorمقابل خادم واقعي بطيء غير معزولة في بياناتي. - استرجاع sitemap. طُلب robots.txt واتُّبع توجيه sitemap، لكنني لم أتحقق بشكل منفصل من استرجاع كل إدخال
<loc>.
ما يجب توضيحه قبل أول مهمة إنتاجية
الملف القياسي طويل، لكن القرارات التي تغيّر معنى الأرشيف مضغوطة نسبيًا. ابدأ بالـ scope. تُولّد الـ seeds بادئات SURT افتراضية، ويمكن لـ DecideRules توسيعها أو تضييقها بالتتابع. راجع ترتيب القواعد النهائي مع روابط تمثيلية داخل النطاق وخارجه، ثم تحقق منه مقابل حركة الخادم أو سجل طلبات مستقل آخر. تقرير الزحف وحده لا يُثبت أن مضيفًا مستبعدًا لم يُتصَل به إطلاقًا.
بعدها، حدد ما تعنيه سياسة robots وهوية المشغِّل بالنسبة للمجموعة. أطاع الإعداد الافتراضي المُختبَر قاعدة disallow في الـ fixture، بينما تسبب تغيير robotsPolicyName إلى ignore في جلب المسار المحظور. هذا التبديل بسيط تقنيًا لكنه مهم مؤسسيًا. سجّل من وافق عليه ولماذا، إلى جانب operatorContactUrl عامل؛ فالرابط المطلوب يمنح مالك الموقع مسارًا للعودة إلى المُشغِّل لكنه لا يوفر مبرر التفويض.
يحتاج تخطيط التخزين قرارًا صريحًا خاصًا به. إن كان يجب أن تصبح المتون المتطابقة سجلات revisit، فأضف معالجات content-digest history وراجعها قبل تقدير حجم الأرشيف. أثّرت السلسلة المُختبَرة في التمثيل بعد الجلب، لذا يجب أن تظل حركة المصدر مُحتسَبة لكلا الرابطين. dedup عبر عمليات الزحف آلية منفصلة ولا ينبغي استنتاجها من نتيجة رابطين ضمن زحف واحد. زحف تحقق صغير بمتون تكرار معروفة طريقة رخيصة للتأكد من أن رسم beans المنشور ينتج أنواع السجلات المقصودة.
أخيرًا، عامل politeness كمدخل جدولة لا كضبط لحظة أخيرة. في fixture المضيف الواحد المحلي، هيمن minDelayMs على الزمن الكلي. يجب على أي مشروع حقيقي حساب الحد الأدنى لكل مضيف مقابل عدد المضيفين المستهدفين وموعد التسليم، ثم الاختبار على كمون تمثيلي. تضغط عمليات الزحف الواسعة وعمليات الموقع الواحد على الـ frontier المُقسَّم حسب المضيف بشكل مختلف؛ وقاست هذه المراجعة الحالة الثانية فقط. احتفظ أيضًا بدورة حياة REST في دليل التشغيل: build وlaunch وunpause وpoll وterminate وteardown حالات منفصلة تستحق المراقبة في الأتمتة.
الإيجابيات والسلبيات
الإيجابيات
- اكتمال الأرشيف ممتاز افتراضيًا: 20/20 استجابة مع payload digest، وIP التقاط، وربط كامل بين request وresponse، دون أي إعداد مطلوب.
- يحفظ استجابات الأخطاء كحقائق — تُخزَّن أسطر الحالة 200 و404 و500 جميعها حرفيًا.
- انضباط scope تحقق مقابل عدّاد من طرف الخادم: صفر جلبات خارج النطاق بينما زُحف المضيف داخل النطاق بشكل طبيعي.
- طاعة robots تمنع الجلب فعليًا، مع منفذ
ignoreمتعمَّد للأرشفة المُفوَّضة. - بلا واجهة بالكامل عبر REST — إنشاء وbuild وlaunch وpoll وteardown، كلها عبر
curl، دون أي نقرات واجهة. - تعمل بنظافة على OpenJDK 26.0.1 دون أي أعلام JVM، وهو انضباط Java حديث أفضل مما تحققه معظم قواعد الكود العمرها عشرون عامًا.
- رابط تواصل المُشغِّل الإلزامي يعني أن الزاحف لا يمكن أن يعمل بشكل مجهول.
- كل جزء من الزحف bean قابل للاستبدال، ولهذا كان تفعيل dedup مجرد إدراج ثلاث beans لا fork كامل.
السلبيات
- dedup القائم على content-digest معطّل افتراضيًا ويكتب الحمولات المتطابقة كاملة — فخ حقيقي في تخطيط التخزين.
- النشر ثقيل: توزيعة 41 ميجابايت، و114 ملف jar، ومحرك Java مع Jetty، وإعداد مهمة Spring بنحو 750 سطرًا.
- تفرض politeness الافتراضية حدًا أدنى بنحو 3 ثوانٍ لكل مضيف؛ استغرق زحف 20 URI على مضيف واحد 57.7 ثانية.
- لا عرض جافاسكربت في المسار الافتراضي، فالمحتوى الذي يُنشأ على جانب العميل فقط لن يُلتقط.
- سطح الإعداد يكافئ الخبرة ويعاقب الاستخدام العابر؛ لا يوجد مسار من خمس دقائق إلى أول عملية زحف.
- لا شيء في المخرج بيانات مُهيكلة. استخراج الحقول من ملف WARC مشروع منفصل.
من يجب أن يستخدمها، ومن يجب أن يبتعد
Heritrix مخصصة للمؤسسات والفرق التي يكون مُخرجها الأرشيف نفسه. المكتبات، والأرشيفات الوطنية، والحفظ القانوني والامتثالي، ومجموعات البحث التي تلتقط الويب كمصدر أولي، وكل من يحتاج أن يُثبت بعد خمس سنوات ماذا قدّم رابط في يوم بعينه. إن كانت كلمات "WARC" و"replay" و"provenance" موجودة أصلاً في مفرداتك، فهذه هي الأداة التي بُني حولها بقية نظامك البيئي، ووزنها هو ثمن ذلك التوافق.
الـ frontier المُقسَّم حسب المضيف واستخدامها الطويل في أرشفة الويب يجعلانها مرشحًا معقولاً لعمليات زحف واسعة عبر نطاقات كثيرة. هذا اعتبار معماري وتاريخي للمشروع، لا نتيجة حجم من هذا الـ fixture؛ لا يزال أداء الإنتاجية طويل المدى، واستعادة checkpoint، وسلوك مليون URI غير مُختبَرة هنا.
تجاوزها إن كنت تريد بيانات لا أرشيفًا. إن كان هدفك جدول بيانات لمنتجات أو قوائم أو جهات اتصال، فستقوم Heritrix بعمل ممتاز في التقاط الصفحات التي عليك بعدها كتابة pipeline منفصل لتحليلها — وستكون قد دفعت ثمن محرك Java، وإعداد Spring، وحد politeness بثلاث ثوانٍ مقابل هذا الامتياز. تجاوزها أيضًا إن كانت أهدافك تطبيقات صفحة واحدة تُعرَض على جانب العميل، حيث يلتقط الجالب غير المعتمد على متصفح القالب لا المحتوى؛ وهنا يكون الأرشيف القائم على متصفح هو الأداة الصحيحة. وتجاوزها إن كنت تحتاج نتيجة أولى اليوم، لأن منحنى الإعداد حقيقي فعلاً.
البدائل، وأين تناسب واجهة API مُدارة
ضمن عالم الأرشفة، النظير الحديث المباشر هو Browsertrix Crawler — أرشيف قائم على متصفح يُشغّل Chromium ويسجّل ما فعله المتصفح. يمكنه التقاط محتوى ناتج عن جافاسكربت غائب عن استجابات HTTP الافتراضية لـ Heritrix، مقابل إضافة عبء نشر وتشغيل للمتصفح. لم تُجرِ هذه المراجعة مقارنة مباشرة بين الاثنين، لذا يبدأ القرار من متطلبات الالتقاط: الحالة المُولَّدة عبر متصفح تشير إلى أرشيف قائم على متصفح؛ بينما تبقى موارد HTTP التقليدية المسار الطبيعي لـ Heritrix.
مراجعة ذات صلة: مراجعة Browsertrix Crawler.
بالنسبة لمشكلة مختلفة تمامًا — حين لا تريد أرشيفًا بل بيانات مُهيكلة من الصفحات — قارن Heritrix بأنظمة الاستخراج من حيث المُخرَج لا بمعاملتها كزواحف مكافئة. Heritrix مجانية ومُستضافة ذاتيًا: تُشغّل JVM بنفسك، وتملك ملف beans، وتحسب سعة الأقراص، وتضبط politeness. هذا النموذج يناسب حين يكون الحفظ هو المُخرَج المطلوب.
إفصاح: Thunderbit منتج الناشر ولم تُختبَر في هذا الـ fixture الخاص بـ Heritrix. تنتمي إلى فئة الاستخراج المُدار: مُخرجها محتوى صفحة أو سجلات مُهيكلة لا ملفات WARC بجودة الحفظ. اختر أرشيفًا حين يكون الالتقاط القابل لإعادة التشغيل والـ provenance مطلوبَين؛ وفكّر في خدمة استخراج حين يكون المُخرَج المطلوب صفوفًا أو نص مستند وتكون الإدارة المُدارة مقبولة.
تحمل الأرشفة سؤال أذونات خاصًا بها، وهو ليس نفس سؤال الاستخراج. تطيع Heritrix ملف robots.txt افتراضيًا وتتطلب تعريف هويتك قبل جلب أي بايت، وهذا خط أساس جيد — لكن الزحف الملتزم بـ robots ليس مُصرَّحًا به تلقائيًا. حقوق النشر، وشروط الخدمة، والبيانات الشخصية، وتفويض مؤسستك نفسها كلها تعلو ذلك، وسياسة ignore موجودة للمؤسسات التي لديها أساس قانوني لاستخدامها، لا كمفتاح راحة. إن كنت تُنشئ برنامج أرشفة، رتّب نطاق التفويض قبل امتلاء الأقراص، واطّلع على الجانب القانوني لاستخراج الويب وأرشفته إن كانت أرضًا جديدة عليك.
جرّب Thunderbit لاستخراج بيانات الويب
الخلاصة
هل يجب أن تستخدم Heritrix؟ نعم — إن كان مُخرجك أرشيفًا ولديك من هو مستعد لتعلّم Spring beans.
يدعم الـ fixture قرارًا واضحًا: حفظ الملف القياسي بيانات response وrequest ووصف الالتقاط بثبات؛ وأثّرت ضوابط scope وrobots في الجلبات من طرف الخادم كما هو مُعَد؛ وعملت دورة حياة المهمة بأكملها عبر REST. هذه خصائص مفيدة لـ pipeline أرشفة، ضمن الحد الصغير لمضيف واحد المُختبَر هنا.
التكاليف التشغيلية واضحة بنفس القدر: توزيعة Java وإعداد Spring كبير، وتأخير مُعَد لكل مضيف هيمن على هذا الزحف المحلي، وdedup قائم على content-digest يتطلب معالجات history إضافية. الفرق التي تحتاج دقة WARC قد تقبل تلك التكاليف؛ أما الفرق التي تحتاج حقولاً مُستخرَجة فعليها أن تبدأ من فئة أخرى.
قبل أي زحف إنتاجي، تحقق من سلسلة dedup، وإعدادات politeness، وscope، وسياسة robots، وهوية المُشغِّل، وافتراضات التخزين مقابل إعداد المهمة الفعلي. الملف القياسي نقطة بداية، لا بيان ضمني لتلك القرارات التشغيلية.
جرّب Thunderbit لاستخراج بيانات الويب Get Started Free
الأسئلة الشائعة
هل يجعل operatorContactUrl عملية الزحف مُصرَّحًا بها؟
لا. إنه يُلزم المهمة بتضمين رابط تواصل، مما يمنح مشغّلي المواقع مسار مساءلة، لكنه لا يُثبت الإذن، ولا دقة الهوية، ولا حالة حقوق النشر، ولا الامتثال التنظيمي. تظل هذه قرارات نشر خارج الزاحف.
هل يقلّل dedup القائم على content-digest طلبات المصدر؟ لا، ليس في الإعداد المُختبَر هنا. جُلب كلا الرابطين قبل أن يمكن مقارنة payload digest الخاص بهما. غيّرت سلسلة history طريقة تمثيل الحمولة الثانية في تخزين WARC؛ لكنها لم تحوّل الرابط الثاني إلى طلب شبكة مُتخطّى.
هل يمكن تشغيل Heritrix دون واجهة الويب الخاصة بها؟
نعم. عملت دورة الحياة المُختبَرة — الإنشاء، رفع الإعداد، build، launch، unpause، poll، terminate، وteardown — بالكامل عبر REST API باستخدام curl. لم تكن واجهة Jetty المضمّنة مطلوبة.
هل يزيل الملف القياسي لـ Heritrix تكرار الحمولات المتطابقة؟ لا، ليس في الـ fixture كما هو مُعَد. خزّن الملف القياسي كلا الاستجابتين المتطابقتين كسجلي response كاملين. تغيير الالتقاط الثاني إلى سجل revisit جاء فقط بعد إضافة سلسلة content-digest history، فـ dedup خيار pipeline يجب إعداده والتحقق منه، لا إعداد افتراضي تلقائي.
كيف أختار تأخير politeness؟ عامل التوقيتات المحلية هنا كفحص آلية، لا كتوصية إنتاجية. اضبط التأخير بناءً على قواعد الموقع الهدف، واتفاق المُشغِّل، وسعة الخادم، وغرض الزحف، وسياسة إعادة المحاولة والتزامن الخاصة بك، ثم تحقق من فجوات الطلبات الفعلية لنفس المضيف في السجلات.




