
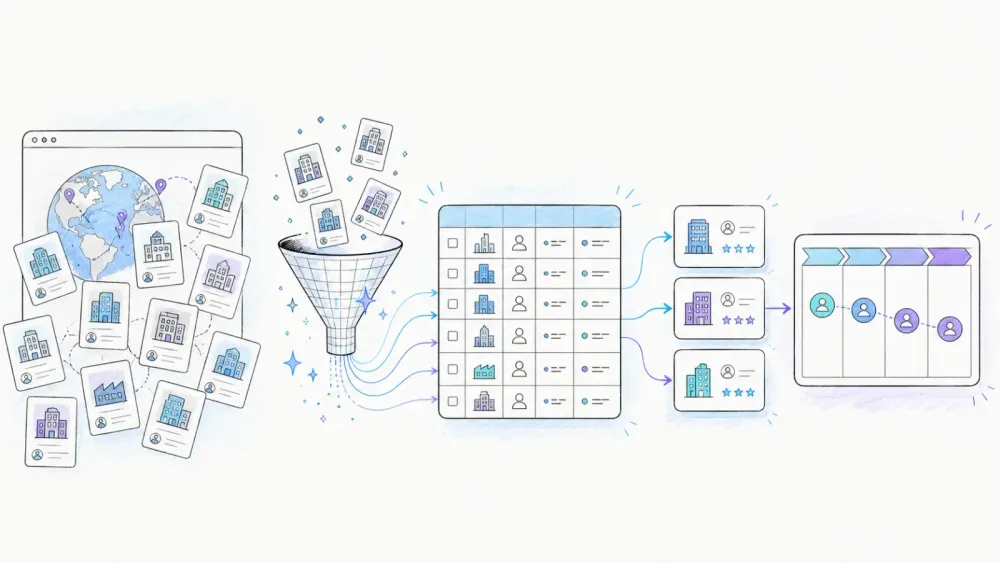
كل مؤسّس أعرفه سبق له في مرحلة ما أن اشترى قائمة تضم عشرة آلاف جهة اتصال «موثّقة»، ثم راقب معدل الرد وهو يحوم حول الصفر. فعلتُ الشيء نفسه في بداية مسيرتي المهنية، وعلّمني ذلك درسًا سريعًا: كومة من عناوين البريد الإلكتروني ليست خط مبيعات. ما يحرّك الصفقات فعلًا هو معرفة أي الشركات تستحق الحديث معها ولماذا — وهذه مشكلة مختلفة تمامًا عن مجرد حصد الأسماء من الإنترنت.
يُسوَّق استخراج بيانات الويب باعتباره طريقًا مختصرًا لـ«الحصول على 10,000 عميل محتمل قبل يوم الجمعة»، لكن الأدوات التي تنجح فعلًا في 2026 مبنية لغرض أنفع من ذلك: العثور على حسابات حقيقية، مدعومة بأدلة حقيقية، في اللحظة التي تُظهر فيها إشارة شراء. قضيتُ وقتًا طويلًا في Thunderbit أفكّر في كيفية استخراج الناس للبيانات لأغراض المبيعات، والفرق التي تحقق أفضل النتائج ليست تلك التي تستخرج أكبر عدد من الصفوف — بل تلك التي تستخرج الصفوف الصحيحة، مع سياق مرفق بها.
ماذا يعني فعلًا العثور على عملاء محتملين B2B عبر استخراج بيانات الويب؟
معظم الناس حين يسمعون «استخراج العملاء المحتملين» يتخيلون أداة تبتلع صفحة دليل وتُخرج ملف CSV يضم أسماء ومسميات وظيفية وعناوين بريد إلكتروني. هذا ليس توليدًا للعملاء المحتملين — هذا حصد لجهات الاتصال، وهو السبب الذي يجعل فرق مبيعات كثيرة تنتهي بقوائم يرتد بريدها بشدة وتحقق تحويلات أسوأ.
سجل العميل المحتمل الحقيقي يحتاج إلى أكثر من مجرد اسم. يحتاج إلى هوية الحساب (اسم الشركة والنطاق المعتمد)، ودليل على أن الشركة تطابق فعلًا ملف عميلك المثالي، وإشارة موثّقة بالتاريخ توضح لماذا هذه اللحظة مناسبة للتواصل، وقناة تواصل مسموح بها، وسجلًا لمصدر البيانات، وحالة يمكنك مراجعتها لاحقًا. تبدو قائمة طويلة، لكنها تتلخص في تسلسل بسيط: ابدأ من مصدر عام مسموح به، وأكّد هوية الشركة، واجمع أدلة الملاءمة، ودوّن الحدث المُحفِّز، واعثر على أقل قناة تواصل ضرورية، وتحقّق منها، وأزل التكرار، ثم ادفعها إلى CRM لديك. تجاوز خطوة واحدة وستحصل على ما يكرهه الجميع أصلًا — جدول بيانات مليء بالغرباء.
لماذا صار هذا أهم من أي وقت مضى
جعل الذكاء الاصطناعي البدء في الاستخراج سهلًا إلى حد سخيف، وجعل تنفيذه بشكل سيئ على نطاق واسع سهلًا إلى الحد نفسه. قبل بضع سنوات، كان بناء أداة استخراج يعني توظيف مطوّر أو المصارعة مع محددات XPath طوال عطلة أسبوع. أما اليوم فيستطيع أي شخص توجيه أداة استخراج بالذكاء الاصطناعي نحو صفحة والحصول على بيانات منظمة في دقائق. هذا ممتاز للإنتاجية، لكنه يعني أيضًا أن مزيدًا من فرق المبيعات تُغرق أنظمة CRM لديها ببيانات غير مؤهلة وغير مُتحقق منها بسرعة أكبر من أي وقت مضى، وتنظيف ذلك لاحقًا يكلّف وقتًا أطول بكثير من إنجازه بشكل صحيح من المرة الأولى.
وفي الوقت نفسه، لم تتزحزح الأرضية التنظيمية لمجرد أن الأدوات أصبحت أذكى. فقد كان مكتب مفوّض المعلومات البريطاني واضحًا في أن بيانات التواصل التجارية المتاحة للعموم قد تظل خاضعة لقانون حماية البيانات البريطاني UK GDPR، وأن الاعتراضات على التسويق المباشر يجب احترامها حتى في سياق B2B. وفي الولايات المتحدة، لا تمنح إرشادات لجنة التجارة الفيدرالية بشأن قانون CAN-SPAM استثناءً للبريد الإلكتروني الموجّه للشركات أيضًا — فكل رسالة تجارية تحتاج إلى ترويسات دقيقة، وآلية إلغاء اشتراك تعمل فعلًا، واحترام طلبات إلغاء الاشتراك خلال 10 أيام عمل. لا شيء من هذا تفاصيل قانونية غريبة؛ إنه الحد الأدنى الذي تعمل ضمنه سواء كنت تعرف ذلك أم لا.
قبل أن تبدأ: اقرأ المشهد (واقرأ شروط الخدمة)
سأكون صريحًا هنا: ليس كل موقع مباحًا، مهما كانت أداة الاستخراج لديك جيدة. شروط Google Maps تحظر صراحةً تصدير محتوى Maps أو استخراجه بالجملة. واتفاقية المستخدم في LinkedIn تمنع الاستخراج والأتمتة غير المصرّح بها منعًا تامًا. وشروط Clutch الحالية تحظر الاستخراج اليدوي والآلي كذلك. هذه ليست بنودًا غامضة — بل هي أول ما ينبغي أن تتحقق منه قبل توجيه أي أداة نحو موقع، وقد كتبتُ عن هذا بتفصيل أكبر فيما يخص استخراج بيانات LinkedIn تحديدًا لأن الموضوع يتكرر باستمرار.
يستحق ملف robots.txt أن تفهمه، لكن لا ينبغي التعامل معه كضوء أخضر قانوني. فبحسب مواصفة IETF نفسها، هو تعليمة زحف، وليس نظام أذونات ولا آلية للتحكم في الوصول. فقد يسمح موقع بالزحف في robots.txt ويظل يحظر الاستخراج في شروط الخدمة — والشروط هي التي تغلب عادةً عند النزاع. قاعدتي العملية: إذا كان الموقع يتطلب تسجيل دخول لرؤية البيانات، أو يضع CAPTCHA أمامها، أو يقول صراحةً «ممنوع الاستخراج» في أي موضع من شروطه، فهذا مصدر يجب تجاوزه، لا لغز يجب حلّه.
المصادر العامة التي تميل إلى أن تكون أكثر أمانًا وأكثر فائدة لأبحاث B2B تشمل مواقع الشركات، والملفات الحكومية، وأدلة العارضين والشركاء بإذن مسبق، وصفحات الوظائف، والغرف الإخبارية. فواجهات EDGAR البرمجية التابعة لهيئة الأوراق المالية والبورصات الأمريكية، مثلًا، توفّر ملفات JSON عامة مجانية وبيانات XBRL دون الحاجة إلى مفتاح API إطلاقًا — فقط أبقِ الطلبات الآلية عند 10 طلبات في الثانية أو أقل وفق إرشادات الهيئة نفسها بشأن حدود المعدل.
المسار الكامل: من الاستخراج الخام إلى عملاء محتملين جاهزين لـ CRM
إليك التسلسل الذي أنصح به فعليًا، وهو أقل ارتباطًا بـ«الاستخراج» وأقرب إلى عملية بحث مصغّرة تقف أداة الاستخراج في مركزها.
أولًا، اختر مصدرًا عامًا مسموحًا به واسحب الحقول على مستوى المؤسسة فقط: اسم الشركة، والنطاق، ورابط المصدر، والفئة، والموقع الجغرافي، وأي إشارة دفعتك للنظر إليها من البداية (إعلان وظيفة، بيان صحفي، إدراج في فعالية). ثانيًا، بالنسبة للحسابات التي تبدو واعدة، انتقل إلى موقعها الفعلي وأكّد ما الذي تفعله، وأين مقرها، وما قناة التواصل العامة المتاحة. ثالثًا، تحقّق وأثرِ البيانات فقط للحسابات التي اجتازت بالفعل معيار التأهيل لديك — لا تهدر أرصدة الإثراء على شركات لم تفحصها بعد. رابعًا، أزل التكرار مقارنةً ببيانات CRM الموجودة لديك قبل استيراد أي شيء. خامسًا، ادفعها مع حقل حالة حتى يعرف فريق المبيعات ما تمت مراجعته وما لا يزال يحتاج إلى نظرة.
الجزء الأخير هذا أهم مما يظن الناس. أقترح وسم كل سجل بشيء مثل candidate_account أو qualified_account أو contact_ready أو needs_review أو rejected. يبدو الأمر مبالغة إلى أن يسألك فريق SDR: «لحظة، هل تحقّق أحد فعلًا من أن هذه الشركة تطابق ملف عميلنا المثالي؟» فتكون لديك إجابة بدل هزّة كتف.
أين تجد حسابات B2B ذات إشارات قوية
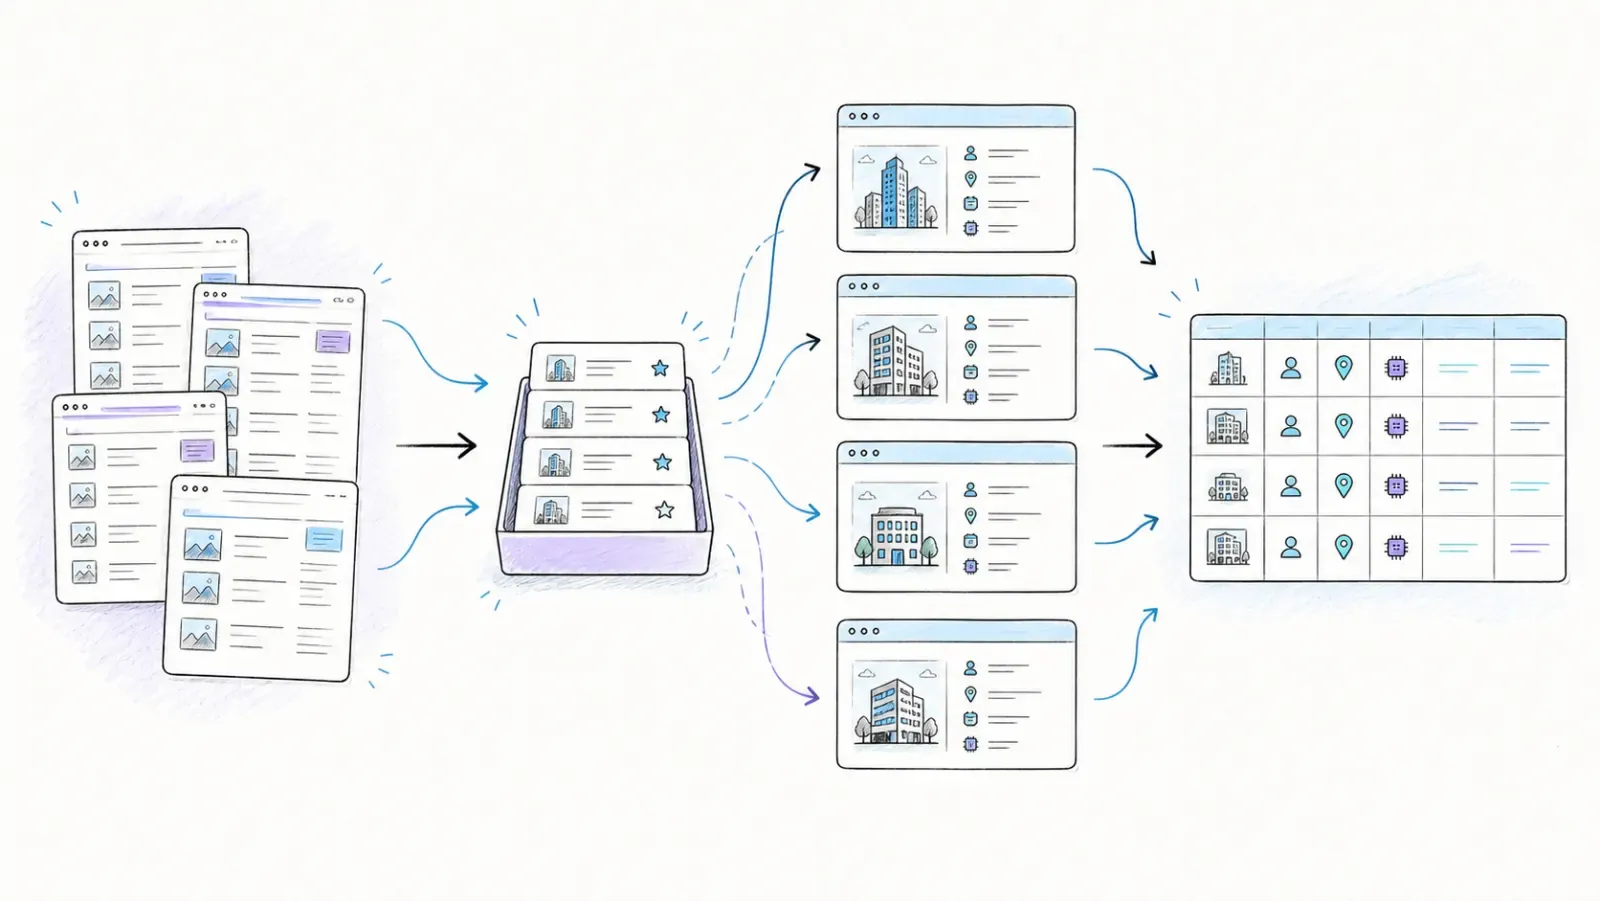
أفضل الإشارات ليست مخفية — إنها فقط متناثرة عبر مصادر لا تكلّف معظم الفرق نفسها عناء فحصها بشكل منهجي. صفحات الوظائف في الشركات تخبرك بمن يوظّف ولأي دور، وهو مؤشر لا بأس به على ما تستثمر فيه. والغرف الإخبارية وصفحات البيانات الصحفية تخبرك عن جولات التمويل والتوسع وإطلاق المنتجات. وصفحات الشركاء والعارضين (حين يكون الاستخراج مسموحًا) تُظهر لك من ينشط في منظومة بعينها. أما الملفات العامة، خصوصًا للشركات الأكبر، فتكشف الصحة المالية والأولويات الاستراتيجية بطريقة لن يفعلها منشور على LinkedIn أبدًا.
لا تُثبت أي من هذه الإشارات بمفردها نية الشراء — فإعلان وظيفة لـ«نائب رئيس المبيعات» لا يعني أن الشركة مستعدة لشراء منتجك غدًا. لكنها مجتمعة، ومقارنةً بمعايير ملف عميلك المثالي، مرشّح أفضل بكثير من قائمة ثابتة اشتُريت من سوق للعملاء المحتملين قبل ستة أشهر وصار 20% منها متقادمًا أصلًا.
لماذا يغيّر الاستخراج المدعوم بالذكاء الاصطناعي المعادلة
هنا تختلف الأمور اختلافًا حقيقيًا عن الاستخراج الذي أتذكر أنني كنت أقوم به قبل خمس أو ست سنوات. الاستخراج بالطريقة القديمة كان يعني كتابة محددات لكل تخطيط صفحة على حدة، وفي اللحظة التي يعيد فيها الموقع تصميم HTML الخاص به، تتعطل أداتك. أما أدوات الاستخراج المدعومة بالذكاء الاصطناعي فتقرأ الصفحة بطريقة أقرب إلى قراءة الإنسان — فهي تفهم سياقيًا أن «هذا اسم شركة، وهذا موقع جغرافي، وهذا مسمى وظيفي» بدل الاعتماد على مسارات CSS هشّة.
هذا التحوّل هو ما يتيح لأداة مثل Thunderbit أن تنظر إلى صفحة قائمة وتقترح الأعمدة الصحيحة تلقائيًا عبر «اقتراح الحقول بالذكاء الاصطناعي» بدل أن تضطر إلى مطابقة كل حقل يدويًا. ويمكنك أيضًا أن تكتب ما تريده بلغة بسيطة — «أعطني اسم الشركة والموقع الإلكتروني والقطاع والموقع الجغرافي» — ويكتشف الذكاء الاصطناعي كيفية سحبه. تحدثت مع فرق كانت تقضي نصف يوم لكل موقع في إعداد تكوين أداة الاستخراج؛ أما الآن فالأمر بضع نقرات ومراجعة سريعة. وهذا ليس لأن قواعد الامتثال تغيّرت — فهي لم تتغير — بل لأن الحاجز التقني أمام إنجاز هذا العمل بشكل جيد انخفض انخفاضًا هائلًا. ولمزيد من التفاصيل حول كيفية انعكاس هذا التحوّل على مجال الاستخراج بالذكاء الاصطناعي عمومًا، أنصحك بالاطلاع على شرحنا لاستخراج بيانات الويب بالذكاء الاصطناعي ومقارنته بالنهج القديم القائم على القواعد.
مشكلة الصفحات الفرعية (لماذا تتركك صفحات القوائم في منتصف الطريق)
إليك ما يوقع كل مبتدئ تقريبًا: صفحة القائمة ليست القصة كاملة أبدًا. قد تمنحك صفحة الدليل اسم شركة ورابطًا، لكن الدليل الفعلي الذي تحتاجه — ما الذي تفعله الشركة، وأين مقرها الرئيسي، وأي قطاع تخدمه — يقع عادةً على بُعد نقرة واحدة أعمق، في صفحة تفاصيل الشركة أو على موقعها الإلكتروني.
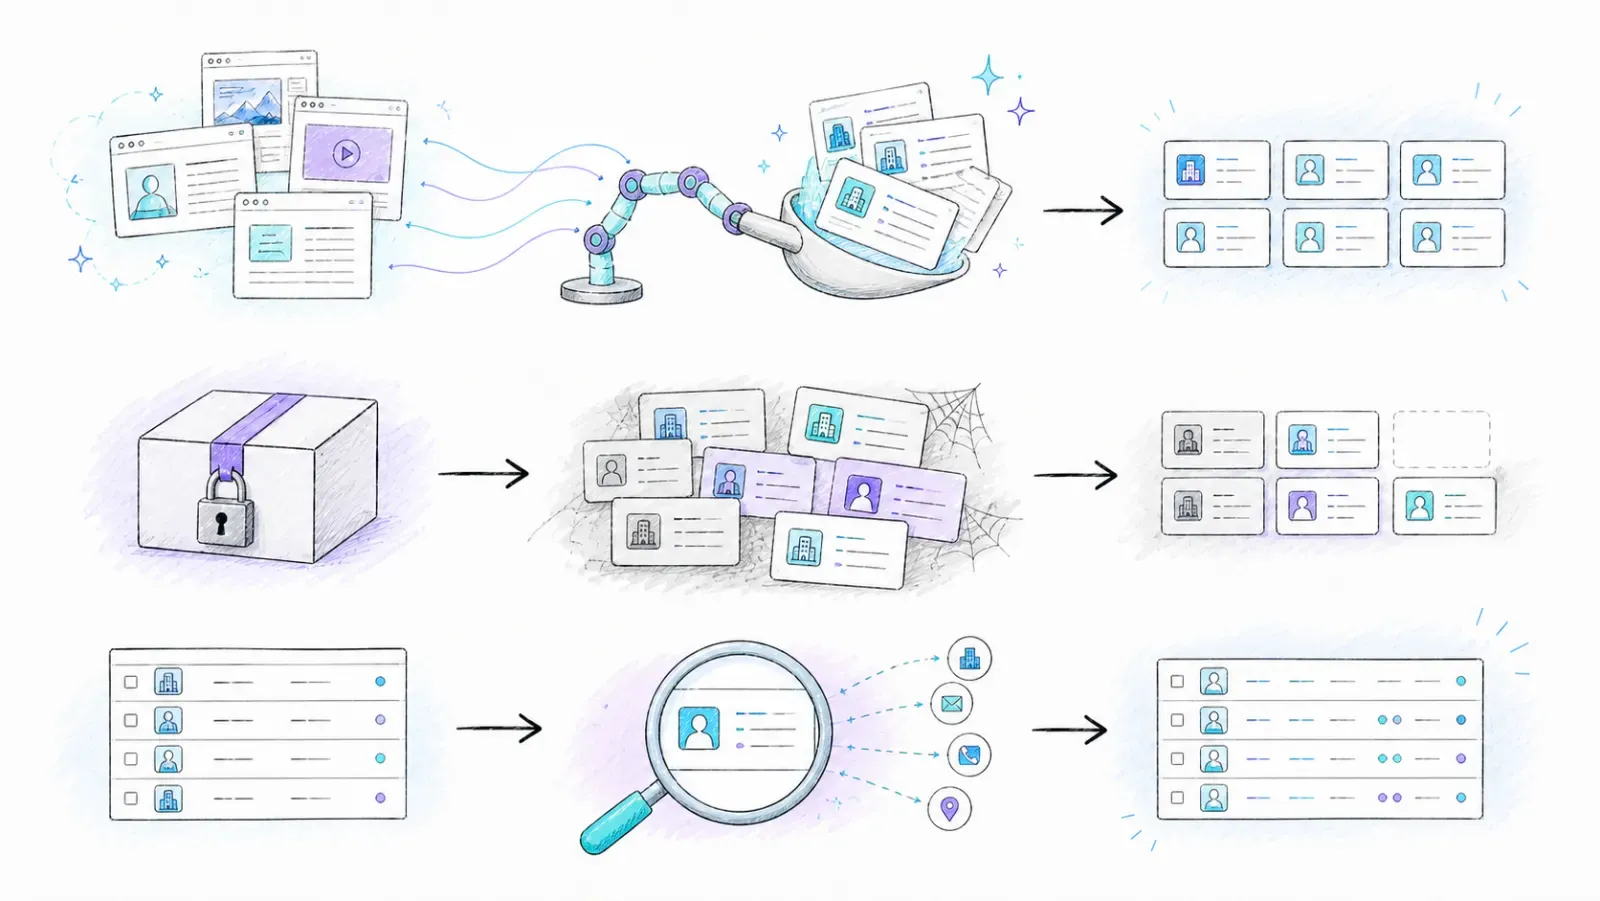
رأيت فرقًا تستخرج مئات الصفوف من دليل، ثم تكتشف أن نصف «العملاء المحتملين» ينقصهم الحقل الوحيد الذي كان يهم فعلًا في التأهيل. وهذا بالضبط سبب وجود استخراج الصفحات الفرعية كفئة من الميزات، لا كإضافة كمالية. فأداة الاستخراج الجيدة ينبغي أن تكون قادرة على زيارة صفحة القائمة، والتقاط رابط صفحة تفاصيل كل شركة، ثم متابعة ذلك الرابط تلقائيًا وسحب الحقول الأعمق قبل دمج كل شيء في صف واحد نظيف. تجاوز هذه الخطوة وستكون تؤهّل العملاء المحتملين بناءً على اسم شركة وتخمين.
خطوة بخطوة: العثور على عملاء محتملين B2B باستخدام Thunderbit
سأشرح هذا بالطريقة التي أنفّذها بنفسي فعلًا، وأنا جالس أمام دليل مستهدف مع فنجان قهوة.
الخطوة 1: ثبّت Thunderbit وافتح الدليل المستهدف
احصل على إضافة Thunderbit لمتصفح Chrome وانتقل إلى مصدر عام مسموح به — قائمة عارضين، أو دليل قطاعي، أو لوحة وظائف، أو أي شيء يناسب ملف عميلك المثالي. تأكد من أن شروط الموقع تسمح بهذا النوع من الاستخدام قبل المضي قدمًا؛ هذه الخطوة تستغرق دقيقتين وتوفّر عليك صداعًا لاحقًا.
الخطوة 2: انقر على «اقتراح الحقول بالذكاء الاصطناعي»
بدل النقر يدويًا عبر الصفحة لتحديد الأعمدة، دع الذكاء الاصطناعي يفحص بنية الصفحة ويقترح حقولًا مثل اسم الشركة والموقع الإلكتروني والموقع الجغرافي والفئة. يمكنك تعديل هذه الحقول أو إضافة حقول خاصة بك بلغة بسيطة — شيء مثل «استخرج القطاع الذي تخدمه هذه الشركة» يعمل جيدًا كتعليمة حقل.
الخطوة 3: شغّل عملية الاستخراج
ابدأ الاستخراج ودعه يعمل عبر صفحة القائمة (وعبر ترقيم الصفحات، إن كان الدليل يمتد على صفحات متعددة). هذه هي السحبة «الخام» — معرّفات على مستوى الشركة فقط، ولا شيء يمكن اعتباره جهة اتصال خاصة حتى الآن.
الخطوة 4: أثرِ البيانات عبر استخراج الصفحات الفرعية
بالنسبة للصفوف التي تبدو واعدة، استخدم استخراج الصفحات الفرعية لمتابعة رابط كل شركة إلى موقعها أو صفحة تفاصيلها، وسحب حقول أعمق مثل ما الذي تفعله، وأين مقرها، وأي قناة تواصل عامة مذكورة. هذه هي الخطوة التي تحوّل صفًا مجردًا في دليل إلى سجل حساب مؤهل فعلًا.
الخطوة 5: تحقّق ونظّف
قبل أن يصل أي شيء إلى CRM لديك، افحص عينة عشوائية. تأكد من أن النطاقات تعمل، وتأكد من أن سبب التأهيل صامد فعلًا، وضع علامة needs_review على أي شيء غامض بدل التخمين. وهنا أيضًا تُجري التحقق من عناوين البريد الإلكتروني عبر خدمة مثل Hunter إذا كنت قد حددت قناة تواصل عامة مشروعة — فقط تذكّر أن عنوان بريد «صالحًا» لا يعني الموافقة على تسويق منتجك لصاحبه.
الخطوة 6: صدّر وادفع البيانات إلى CRM
يوفّر Thunderbit تصديرًا مجانيًا إلى صيغ مثل CSV وExcel وGoogle Sheets وAirtable وNotion. وقبل الاستيراد إلى HubSpot أو Salesforce، وحّد البيانات على نطاق الشركة كمفتاح أساسي — فإرشادات الاستيراد الخاصة بـ HubSpot توصي باستخدام النطاق للشركات والبريد الإلكتروني لجهات الاتصال، كما أن قواعد التكرار في Salesforce قد تحظر استيرادك أو تضع عليه علامة بصمت إذا تجاوزت هذه الخطوة. وقد أنقذتني دفعة اختبارية صغيرة من 20 إلى 30 صفًا قبل الاستيراد الكامل من عمليات تنظيف فوضوية أكثر من مرة.
نصائح وأخطاء شائعة
بضعة أمور أقولها لأي شخص يبدأ هذه العملية اليوم. لا تعامل مسمى وظيفي أو دورًا مستخرجًا كدليل على نية الشراء — إنه تلميح، وليس ضوءًا أخضر. ولا تفترض أن حقلًا استخرجه الذكاء الاصطناعي صحيح تلقائيًا؛ افحص عينة قبل توسيع نطاق أي سير عمل. واحتفظ بجهات الاتصال المُسمّاة وعناوين البريد المباشرة في جزء منفصل وأكثر انضباطًا من مجموعة بياناتك مقارنةً بأبحاثك على مستوى الشركات، لأن كون النشاط B2B لا يعفي البيانات الشخصية تلقائيًا من قواعد الخصوصية. ولا تدع عبارة «الأداة قادرة تقنيًا على ذلك» تتحول إلى سياسة الامتثال لديك — تحقّق من شروط المصدر في كل مرة، لا في المرة الأولى فقط.
استخراج بيانات الويب مقابل شراء قاعدة بيانات عملاء محتملين
للنهجين موضع، والتظاهر بأن أحدهما أفضل على الإطلاق فيه شيء من عدم الأمانة.
| العامل | استخراج بيانات الويب (مصادر مسموح بها) | شراء قاعدة بيانات عملاء محتملين |
|---|---|---|
| حداثة البيانات | حديثة بقدر حداثة آخر عملية استخراج قمت بها | غالبًا ما تتقادم خلال أسابيع |
| جودة الإشارة | عالية — أنت تتحكم في المُحفِّز والسياق | منخفضة — عادةً مجرد بيانات ثابتة عن الشركات |
| اتساع التغطية | أضيق، ويعتمد على المصدر | أوسع وموحّد |
| نموذج التكلفة | وقتك بالأساس + اشتراك الأداة | تكلفة مستمرة لكل سجل أو لكل مقعد |
| مخاطر الامتثال | قابلة للإدارة إذا اختيرت المصادر والحقول بعناية | تعتمد بشدة على ممارسات المزوّد نفسه في جمع البيانات |
| الأنسب لـ | التواصل الخارجي المستهدف والمدفوع بالإشارات | رسم خريطة السوق الواسعة وتقدير حجم السوق المتاح مبكرًا |
رأيي الصريح: استخرج البيانات عندما تحتاج إلى السياق والتوقيت — قائمة عارضي فعالية محددة، أو صفحة منتج أطلقه منافس حديثًا، أو شركة نشرت للتو ثلاث وظائف في المبيعات. واشترِ البيانات أو استخدم مزوّدي إثراء مثل Apollo عندما تحتاج إلى تغطية واسعة وموحّدة وتكون مستعدًا للتحقق من حداثتها بنفسك. والنهجان ليسا متعارضين؛ فكثير من الفرق تستخرج البيانات بحثًا عن الإشارة ثم تُثري الحسابات المؤهلة بعد ذلك بدل أن تختار مسارًا واحدًا إلى الأبد.
سيناريو من الواقع
لنفترض أنك تبيع برنامجًا لإدارة أساطيل المركبات وتريد العثور على شركات لوجستية نامية. استخراج بيانات سجل ناقلين عام تابع لإدارة نقل ولائية، أو دليل أعضاء جمعية قطاعية، يمنحك أسماء الشركات ومواقعها وفئات حجم الأسطول — كلها بيانات عامة، وكلها مسموح بها. ثم تنتقل عبر الصفحات الفرعية إلى موقع كل شركة لتأكيد أنها تعمل فعليًا وللحصول على خط تواصلها العام. النتيجة ربما 200 حساب مؤهل بدل 5,000 اسم غير مُتحقق منه، لكن كل واحد منها يستحق وقت مندوب SDR، وهذا هو الهدف الحقيقي.
يعمل استخراج البيانات لأغراض العملاء المحتملين B2B على أفضل وجه حين تتوقف عن معاملته كبناء قوائم وتبدأ في معاملته كبحث بأدوات أفضل. لقد رأيت فرق مبيعات تحصد خط مبيعات أكبر من 150 حسابًا مؤهلًا جيدًا مما تحصده من 10,000 جهة اتصال مشتراة، لمجرد أن التواصل كان وثيق الصلة بدل أن يكون عامًا. وإذا كنت توازن بين المواضع التي يناسب فيها الاستخراج بالذكاء الاصطناعي حركة مبيعاتك الأوسع، فيستحق الأمر أن تقرأ عن كيف يعيد الذكاء الاصطناعي تشكيل توليد العملاء المحتملين وكيف تستخدم فرق المبيعات الذكاء الاصطناعي فعليًا في يومها — كلاهما يتعمق في سير العمل بما يتجاوز خطوة الاستخراج وحدها.
بناء خط مبيعات من هذا النوع يتطلب إعدادًا أكثر قليلًا من تنزيل قائمة جهات اتصال، هذا صحيح. لكن الحسابات التي تنتهي بها تريد فعلًا أن تسمع منك، وهو أمر — وأقول هذا بعد أن أرسلت الكثير من رسائل البريد الباردة إلى الفراغ على مر السنين — يستحق ثلاثين دقيقة إضافية من الإعداد.
الأسئلة الشائعة
هل استخراج بيانات الشركات B2B من الويب قانوني؟ يعتمد ذلك كليًا على المصدر. مواقع الشركات العامة والملفات الحكومية والأدلة التي تسمح بذلك صراحةً لا بأس عمومًا باستخراج بياناتها لأغراض البحث. أما مواقع مثل LinkedIn وGoogle Maps فتحظر الاستخراج صراحةً في شروطها، بغض النظر عما هو ممكن تقنيًا. تحقّق دائمًا من شروط خدمة الموقع قبل الاستخراج، وتعامل مع robots.txt كتعليمة زحف لا كإذن قانوني.
ما الفرق بين «العميل المحتمل» و«جهة الاتصال» في هذا السياق؟ جهة الاتصال مجرد اسم وطريقة للوصول إليه. أما العميل المحتمل، إذا أُنجز بشكل صحيح، فهو سجل شركة مدعوم بأدلة على أنها تطابق ملف عميلك المثالي، إضافةً إلى إشارة موثّقة بالتاريخ تشرح لماذا تتواصل معها الآن. واستخراج جهات الاتصال بالجملة دون هذا السياق هو سبب ضعف أداء الكثير من حملات التواصل البارد.
هل تستطيع أدوات الاستخراج بالذكاء الاصطناعي ضمان دقة البيانات؟ لا، وأي أداة تدّعي غير ذلك ينبغي أن تثير شكّك. الاستخراج بالذكاء الاصطناعي بارع جدًا في هيكلة الصفحات الفوضوية، لكنه ما زال قادرًا على إساءة قراءة الحقول الغامضة. وفحص عينة قبل توسيع نطاق أي عملية استخراج هو عادة تستحق التمسك بها أيًا كانت الأداة التي تستخدمها.
هل أستخرج عناوين البريد الإلكتروني مباشرةً، أم أستخدم أداة إثراء بعد ذلك؟ أدوات الإثراء تميل إلى أن تكون أكثر موثوقية في العثور على عناوين بريد جهات الاتصال المُسمّاة والتحقق منها مقارنةً بمحاولة استخراجها مباشرةً من الصفحات، وهي عادةً توثّق حالة التحقق بوضوح. اقتراحي أن تستخرج أولًا للتأهيل على مستوى الشركة، ثم تُثري فقط الحسابات التي اجتازت معايير الملاءمة لديك — فهذا أكثر كفاءة ويقلل تعرضك لمخاطر الامتثال.
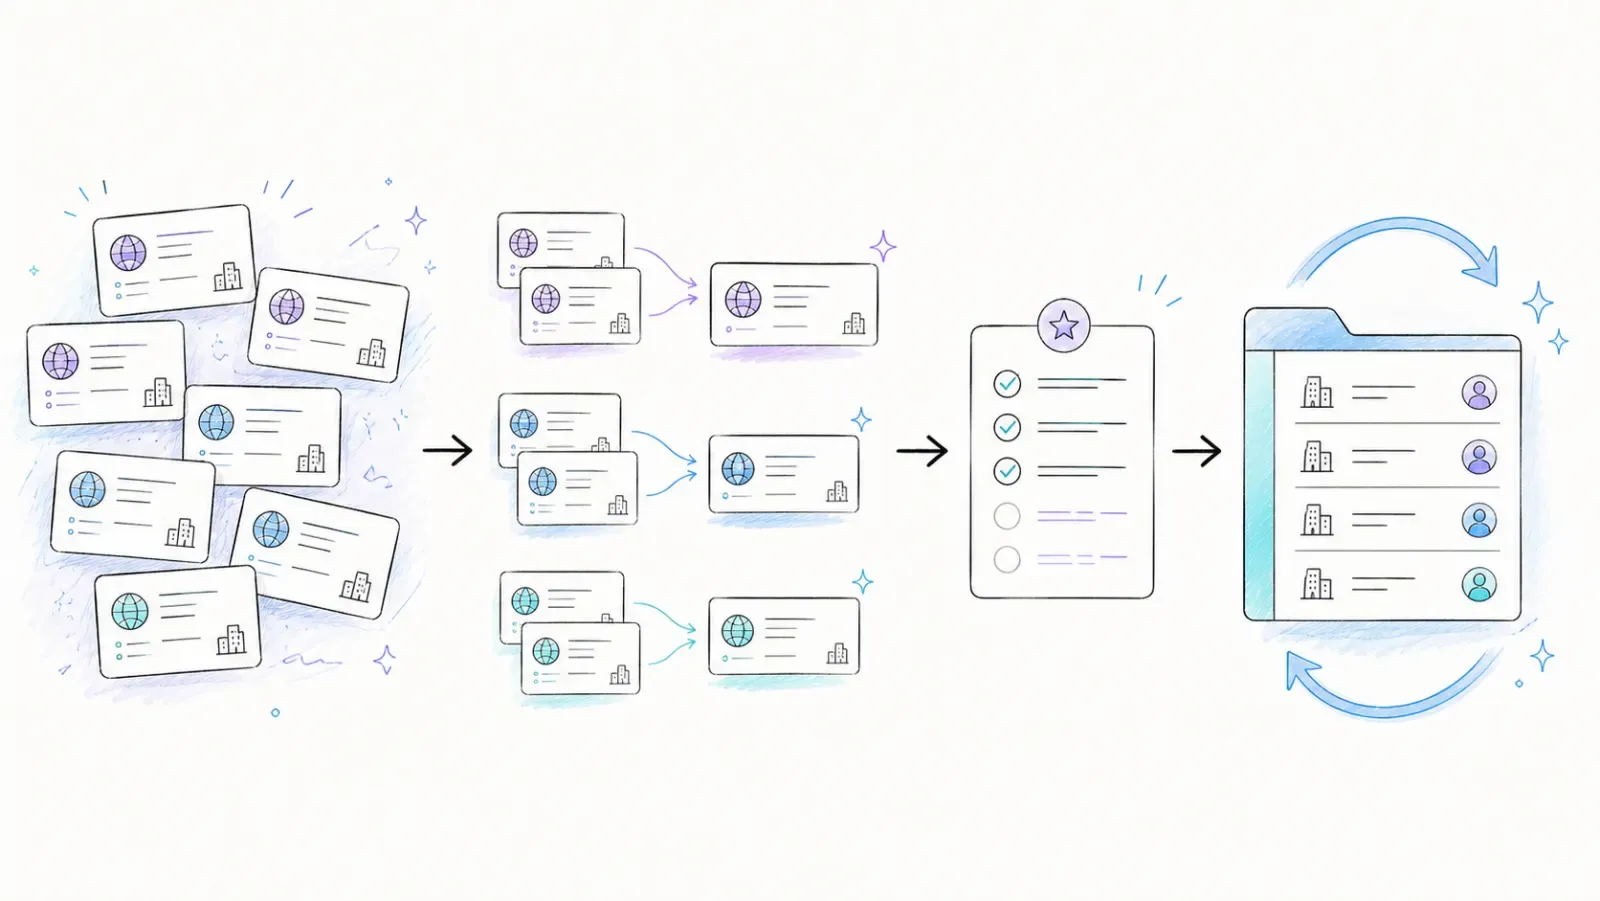
كيف أتجنب استيراد عملاء محتملين مكررين إلى CRM لديّ؟ وحّد البيانات على نطاق الشركة كمعرّف أساسي قبل الاستيراد، لا على اسم الشركة — فالأسماء لها صيغ كثيرة جدًا يصعب معها إزالة التكرار بشكل موثوق. ولدى كل من HubSpot وSalesforce توثيق لكيفية عمل قواعد المطابقة لديهما، كما أن تشغيل دفعة اختبارية صغيرة قبل الاستيراد الكامل سيلتقط معظم المشكلات قبل أن تتحول إلى فوضى في خط مبيعاتك.



