
في الأسبوع الماضي، أرسل لي أحد الزملاء عقدًا مع أحد المورّدين من 47 صفحة، وطلب مني أن "أستخرج جداول الأسعار فقط إلى ملف Excel." حدقت في ملف الـPDF لثلاث ثوانٍ تقريبًا قبل أن أغلِقه وأفتح أداة لاستخراج بيانات PDF بدلًا منه. لم يكن ذلك بسبب الكسل، بل لأنني رأيت لسنوات كيف يضيع الناس بعد الظهيرة كاملة وهم يحاولون انتزاع البيانات من ملفات لم تُصمَّم أصلًا لتسليمها بسهولة.
والأرقام تؤكد هذا الإحباط. أظهر استطلاع Airbase لعام 2024 على 745 من المتخصصين الماليين أن 38% من الفرق تقضي أكثر من ربع وقتها الإجمالي في المهام اليدوية. كما يضيف تقرير أتمتة الحسابات الدائنة من SAP Concur أن 60% من إدخالات الفواتير في أنظمة ERP أو المحاسبة ما تزال تُنجز يدويًا.
ملفات PDF موجودة في كل مكان — الفواتير، العقود، القوائم المالية، الإيصالات الممسوحة ضوئيًا — وما يزال جزء كبير من العمل يعتمد على النسخ واللصق. وفي 2026، تتراوح أدوات استخراج PDF بين مكتبات Python المجانية وأدوات No-Code المدعومة بالذكاء الاصطناعي، واختيار الأداة الخطأ قد يكلفك أيامًا بدل أن يوفرها. لذلك اختبرت 12 من أفضل أدوات استخراج PDF عبر معايير مثل استخراج الجداول، وOCR، والتسعير، وسهولة الاستخدام، حتى تجد ما يناسبك خلال دقائق.
ما هي أداة استخراج PDF ولماذا يجب أن تهتم بها؟
أداة استخراج PDF هي برنامج يستخرج تلقائيًا النصوص والجداول والحقول والبيانات المنظمة من ملفات PDF. إذا حاولت يومًا نسخ جدول من PDF إلى Excel وشاهدت الأعمدة تنهار في سطر واحد مشوّش، فأنت تعرف أصل المشكلة بالفعل.
وغالبًا ما يختلط على الناس الفرق بين أدوات استخراج PDF وأدوات استخراج بيانات الويب. لذا فالتفريق السريع مفيد: أداة استخراج الويب تقرأ HTML، وهو على الأقل يحتوي على بعض البنية مثل العناوين والجداول وdivs. أما أداة استخراج PDF فتبدأ من تنسيق يصف الصفحة بصريًا. وتوضح وثائق Adobe ذلك بجلاء: تم تصميم PDF للحفاظ على شكل الصفحة بشكل متسق عبر الأجهزة، لا لكشف بنية جدولية أو دلالية نظيفة. لهذا فإن النسخ واللصق يدمّر الصفوف والأعمدة وترتيب القراءة.
أين يوفر استخراج PDF الوقت فعلًا؟
- معالجة الفواتير: استخراج أسماء المورّدين، وأرقام الفواتير، والإجماليات، والضرائب، وبنود السطر
- التقارير المالية: استخراج الجداول من التقارير السنوية والقوائم والإفصاحات
- السجلات الممسوحة ضوئيًا: استرجاع بيانات الاتصال أو بيانات المعاملات من ملفات PDF المعتمدة على الصور فقط
- ترحيل الأرشيف القديم: تحويل الأرشيفات القديمة إلى سجلات قابلة للبحث ومنظمة
ولا يتوقف الأثر التجاري عند سير عمل واحد. فما تزال Gartner ترى أن ضعف جودة البيانات يكلف المؤسسات ما لا يقل عن 12.9 مليون دولار سنويًا في المتوسط. وفي فبراير 2025 قالت Gartner إن 63% من المؤسسات لا تمتلك، أو ليست متأكدة من امتلاكها، ممارسات إدارة البيانات المناسبة للذكاء الاصطناعي. وحتى 2026، تتوقع Gartner أن تتخلى المؤسسات عن 60% من مشاريع الذكاء الاصطناعي التي لا تدعمها بيانات جاهزة للذكاء الاصطناعي. وإذا كانت ملفات PDF ما تزال مكانًا تعيش فيه نسبة كبيرة من البيانات الخام، فإن جودة استخراج المستندات أصبحت مرتبطة مباشرة بجاهزية الذكاء الاصطناعي.
وأظهر استطلاع Adobe لعام 2025 بين المتخصصين الماليين أن 61% يحررون بانتظام مستندات قائمة على PDF و64% يوقعونها بانتظام. كما تشير PDF Association إلى أن PDF جاء في المرتبة الثالثة كأكثر تنسيقات الملفات شيوعًا على الويب بحسب بيانات CommonCrawl. ملفات PDF لن تختفي قريبًا.
كيف قيّمنا أفضل أدوات استخراج PDF
قبل أن ندخل في الأدوات، إليك الإطار الذي استخدمته. المعايير الثمانية التالية ترتبط مباشرة بنقاط الألم التي أراها باستمرار في المنتديات، ومشكلات GitHub، ومراجعات المنتجات:
| المعيار | ما الذي يقيسه | لماذا يهم المستخدمين |
|---|---|---|
| أنواع ملفات PDF المدعومة | نص أصلي، ممسوح ضوئيًا/صور فقط، مختلط | كثير من الأدوات تفشل قبل أن تبدأ عملية الاستخراج |
| دقة استخراج الجداول | جداول بسيطة، بلا حدود، متعددة الصفحات، وخلايا مدمجة | أكبر شكوى في استخراج PDF |
| قدرة OCR | مدمج، إضافة اختيارية، أو غير متوفر | ملفات PDF الممسوحة عديمة الفائدة بدون OCR |
| صيغ الإخراج/التصدير | Excel، CSV، JSON، Sheets، Notion، APIs | لا فائدة من البيانات إذا لم تخرج من الأداة بشكل نظيف |
| صعوبة الإعداد | No-code، Low-code، أو Code-first | تحتاج الفرق إلى مستويات مختلفة جدًا من التحكم |
| التسعير / الخطة المجانية | السعر العلني، التجربة، نقطة الدخول الواقعية | نماذج الفوترة تختلف بشكل كبير |
| الأتمتة / التكاملات | Zapier، API، الجدولة، Webhooks | التصدير اليدوي لا يتوسع |
| أفضل حالة استخدام | ما الذي تتقنه الأداة فعلًا | معظم الأدوات ليست مثالية لكل شيء—بل لحالات سير عمل محددة |
ولتبسيط الصورة، تنقسم الأدوات الـ12 إلى ثلاث فئات: أدوات AI بدون كود، ومحللات مستندات SaaS أو المعتمدة على القوالب، ومكتبات المطورين / APIs / الأدوات مفتوحة المصدر.
نظرة سريعة على أفضل 12 أداة لاستخراج PDF
إليك جدول المقارنة الرئيسي حتى تتعرف على الفئة التي تناسبك وتنتقل مباشرة إلى القسم المناسب:
| الأداة | النوع | استخراج الجداول | OCR مدمج | بدون كود | خطة مجانية | الأفضل لـ |
|---|---|---|---|---|---|---|
| Thunderbit | أداة AI بدون كود | ✅ مدعوم بالذكاء الاصطناعي | ✅ نعم | ✅ نعم | ✅ رصيد مجاني | مستخدمو الأعمال، وتخطيطات متعددة |
| Tabula | سطح مكتب مفتوح المصدر | ✅ جيد (ملفات PDF النصية) | ❌ لا | ✅ واجهة رسومية | ✅ مجاني بالكامل | ملفات PDF النصية البسيطة الغنية بالجداول |
| Parseur | SaaS هجين | ⚠️ قوالب + ذكاء اصطناعي | ✅ نعم | ✅ نعم | ⚠️ محدود | فواتير/بريد متكرر وتحليله |
| Nanonets | SaaS IDP بالذكاء الاصطناعي | ✅ قوي | ✅ نعم | ✅ Low-code | ⚠️ رصيد تجريبي | أتمتة المستندات عالية الحجم |
| Adobe Acrobat | حزمة إنتاجية لملفات PDF | ⚠️ أساسي | ✅ نعم | ✅ نعم | ❌ التصدير مدفوع | تحويل PDF إلى Excel بين الحين والآخر |
| PyMuPDF | مكتبة Python | ⚠️ تحليل يدوي | ❌ لا (Tesseract اختياري) | ❌ يتطلب كود | ✅ مجاني بالكامل | المطورون، والملفات النصية الكثيفة |
| Camelot | مكتبة جداول Python | ✅ قوي (lattice + stream) | ❌ لا | ❌ يتطلب كود | ✅ مجاني بالكامل | المطورون، والجداول المعقدة |
| Docparser | SaaS قائم على القوالب | ⚠️ معتمد على القوالب | ✅ نعم | ✅ نعم | ⚠️ تجربة | المستندات المتكررة + سير عمل Zapier |
| pdfplumber | مكتبة Python | ✅ جيد (تفصيلي) | ❌ لا | ❌ يتطلب كود | ✅ مجاني بالكامل | المطورون، والتحكم الدقيق |
| AWS Textract | API سحابي | ✅ قوي | ✅ نعم | ❌ يتطلب API | ⚠️ خطة مجانية محدودة | خطوط العمل المؤسسية واسعة النطاق |
| Docling | Python مفتوح المصدر | ✅ جيد | ✅ عبر تكامل | ❌ يتطلب كود | ✅ مجاني بالكامل | خطوط عمل LLM/RAG |
| Parsio | SaaS هجين | ⚠️ مدعوم بالذكاء الاصطناعي | ✅ نعم | ✅ نعم | ⚠️ محدود | أنواع المستندات المتكررة |
هل تريد إعدادًا صفريًا؟ ابدأ بخيارات No-code أو SaaS. هل تحتاج أقصى قدر من التحكم؟ ابدأ بخيارات المطورين. هل تعمل على ملفات PDF ممسوحة ضوئيًا؟ استبعد أي صف تكون فيه OCR = لا.
1. Thunderbit
 Thunderbit هي أداة استخراج PDF التي كنت سأعطيها لأي شخص يقول: "أريد فقط إخراج البيانات من هذا الـPDF" ولا يريد أن يسمع عن Python أو القوالب أو مفاتيح API. إنها وكيل بيانات ويب بالذكاء الاصطناعي — إضافة Chrome — تقرأ ملفات PDF والصور والمواقع، ثم تُخرج بيانات منظمة. لا قوالب، ولا برمجة.
بنينا Thunderbit للتعامل مع السيناريو الذي يربك أغلب الأدوات: تحصل على ملفات PDF من خمسة مورّدين مختلفين، وكل واحد بتنسيق مختلف قليلًا، وتحتاج الحقول نفسها من جميعها. يقرأ الذكاء الاصطناعي كل مستند من جديد، ويقترح أسماء الأعمدة وأنواع البيانات عبر ميزة "AI Suggest Fields"، ثم يستخرج البيانات إلى جدول منظم. كما يتعامل OCR المدمج مع ملفات PDF الممسوحة والصور بشكل أصلي، مع دعم 34 لغة.
الميزات الرئيسية:
- One Click Extract يحدد الأعمدة وأنواع البيانات من أي تخطيط PDF دون إعداد يدوي
- OCR مدمج للملفات الممسوحة والصور
- تصدير إلى Excel وGoogle Sheets وAirtable وNotion وCSV وJSON — مجانًا بالكامل
- وسم وإعادة تنسيق بالذكاء الاصطناعي: يمكن للذكاء الاصطناعي ترجمة البيانات المستخرجة أو تصنيفها أو إعادة هيكلتها أثناء الاستخراج، وليس بعده فقط
- استخراج الجداول يقرأ التخطيط بصريًا مثل الإنسان، ويتكيف مع الجداول غير المنتظمة وبدون حدود وتنسيقات الموردين المختلفة
طريقة استخراج PDF باستخدام Thunderbit:
- ثبّت Thunderbit Chrome Extension
- افتح ملف PDF أو ارفعه داخل المتصفح
- اضغط على "One Click Extract" — سيقرأ الذكاء الاصطناعي المستند ويستنتج أسماء الأعمدة وأنواعها
- اضغط "Scrape" — ثم تُستخرج البيانات في جدول منظم
- صدّر البيانات إلى Google Sheets أو Excel أو Airtable أو Notion أو CSV أو JSON
التسعير: خطة مجانية مع رصيد (حوالي 6 صفحات مجانًا، و10 مع التجربة). الخطة Starter تبدأ من نحو $15 شهريًا أو قرابة $9 شهريًا عند الفوترة السنوية. يعتمد الرصيد على الصفوف (1 رصيد = صف إخراج واحد). راجع Thunderbit Pricing للتفاصيل.
الأفضل لـ: المستخدمين غير التقنيين الذين يتعاملون مع تنسيقات PDF مختلفة (فواتير من عدة مورّدين، تقارير بصيغ مختلطة) ويريدون النتائج بنقرة واحدة.
الإيجابيات: أسهل إعداد في هذه القائمة؛ OCR مدمج؛ تصدير مباشر إلى Sheets وNotion وAirtable وExcel؛ يعمل على تنسيقات متنوعة بدون قوالب.
السلبيات: الفوترة المعتمدة على الرصيد تحتاج قليلًا من الوقت لفهم تكلفتها لكل صفحة؛ عدد المراجعات من جهات خارجية أقل من مزودي SaaS الأكبر.
جرّب Thunderbit لاستخراج PDF ارفع فواتير من خمسة مورّدين مختلفين ودع الذكاء الاصطناعي يحدد الأعمدة لكل تخطيط — بدون إعداد منفصل لكل قالب. Get Started Free
2. Tabula
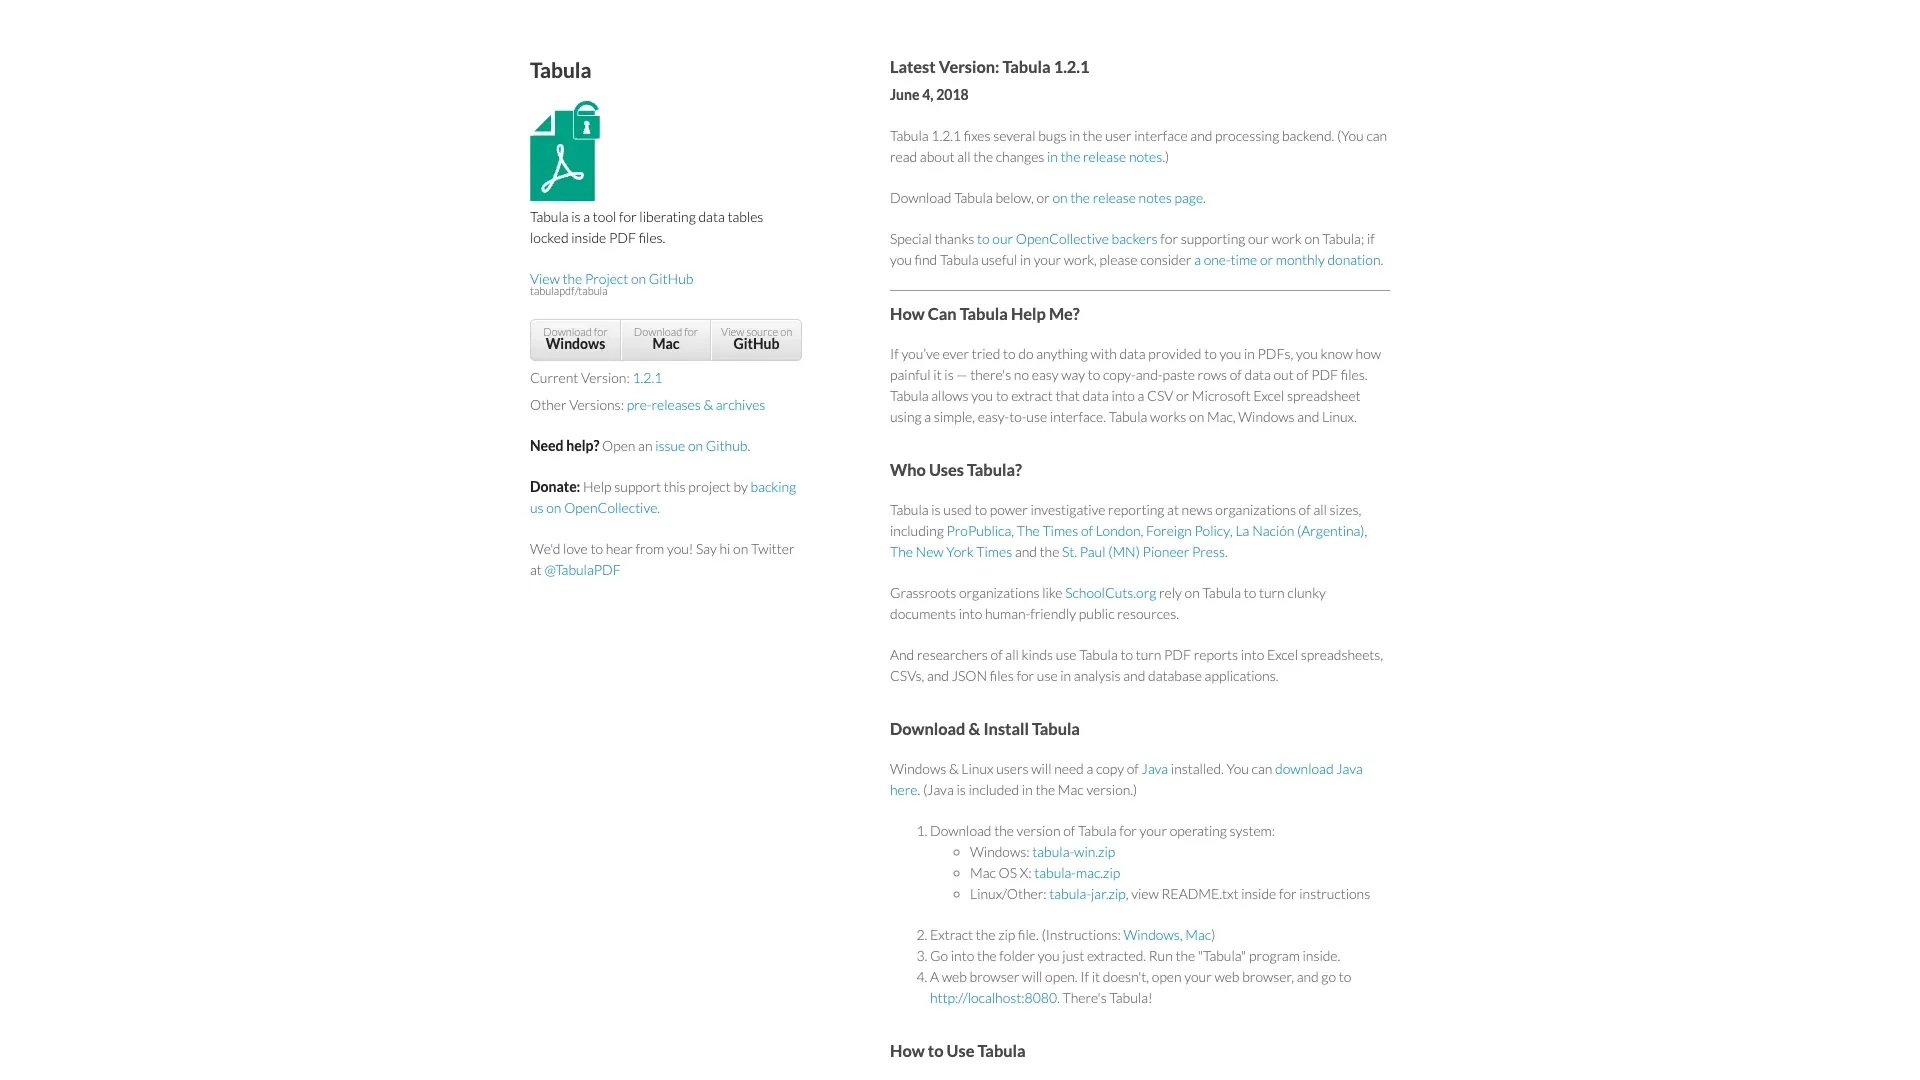 Tabula هي الإجابة المجانية الكلاسيكية لاستخراج جداول PDF النصية، لكنها أيضًا تبدو بوضوح مشروعًا قديمًا في هذه المرحلة. يذكر المستودع أنه مشروع يعمل عليه متطوعون، ومن غير المرجح أن يشهد تطبيق سطح المكتب تحديثات قريبًا. وما يزال أحدث إصدار لسطح المكتب 1.2.1 من عام 2018، بينما كان آخر إصدار tabula-java هو 1.0.5 في 2021.
الميزات الرئيسية:
- واجهة رسومية بنظام النقر والتحديد لاختيار مناطق الجداول
- يعمل محليًا — فلا تغادر البيانات جهازك
- لا حساب، لا اشتراك، لا تسجيل
التسعير: مجاني بالكامل مدى الحياة. مفتوح المصدر.
الأفضل لـ: المستخدمين الذين لديهم ملفات PDF نصية بسيطة مع جداول واضحة الحدود ويريدون حلًا محليًا مجانيًا.
الإيجابيات: مجاني؛ محلي؛ سهل جدًا للجداول الأساسية.
السلبيات: لا يحتوي على OCR (فالملفات الممسوحة غير مناسبة له)؛ ضعيف مع الجداول بلا حدود؛ لا أتمتة ولا API؛ لا خيار سحابي؛ ويُعد فعليًا غير مُصان.
3. Parseur
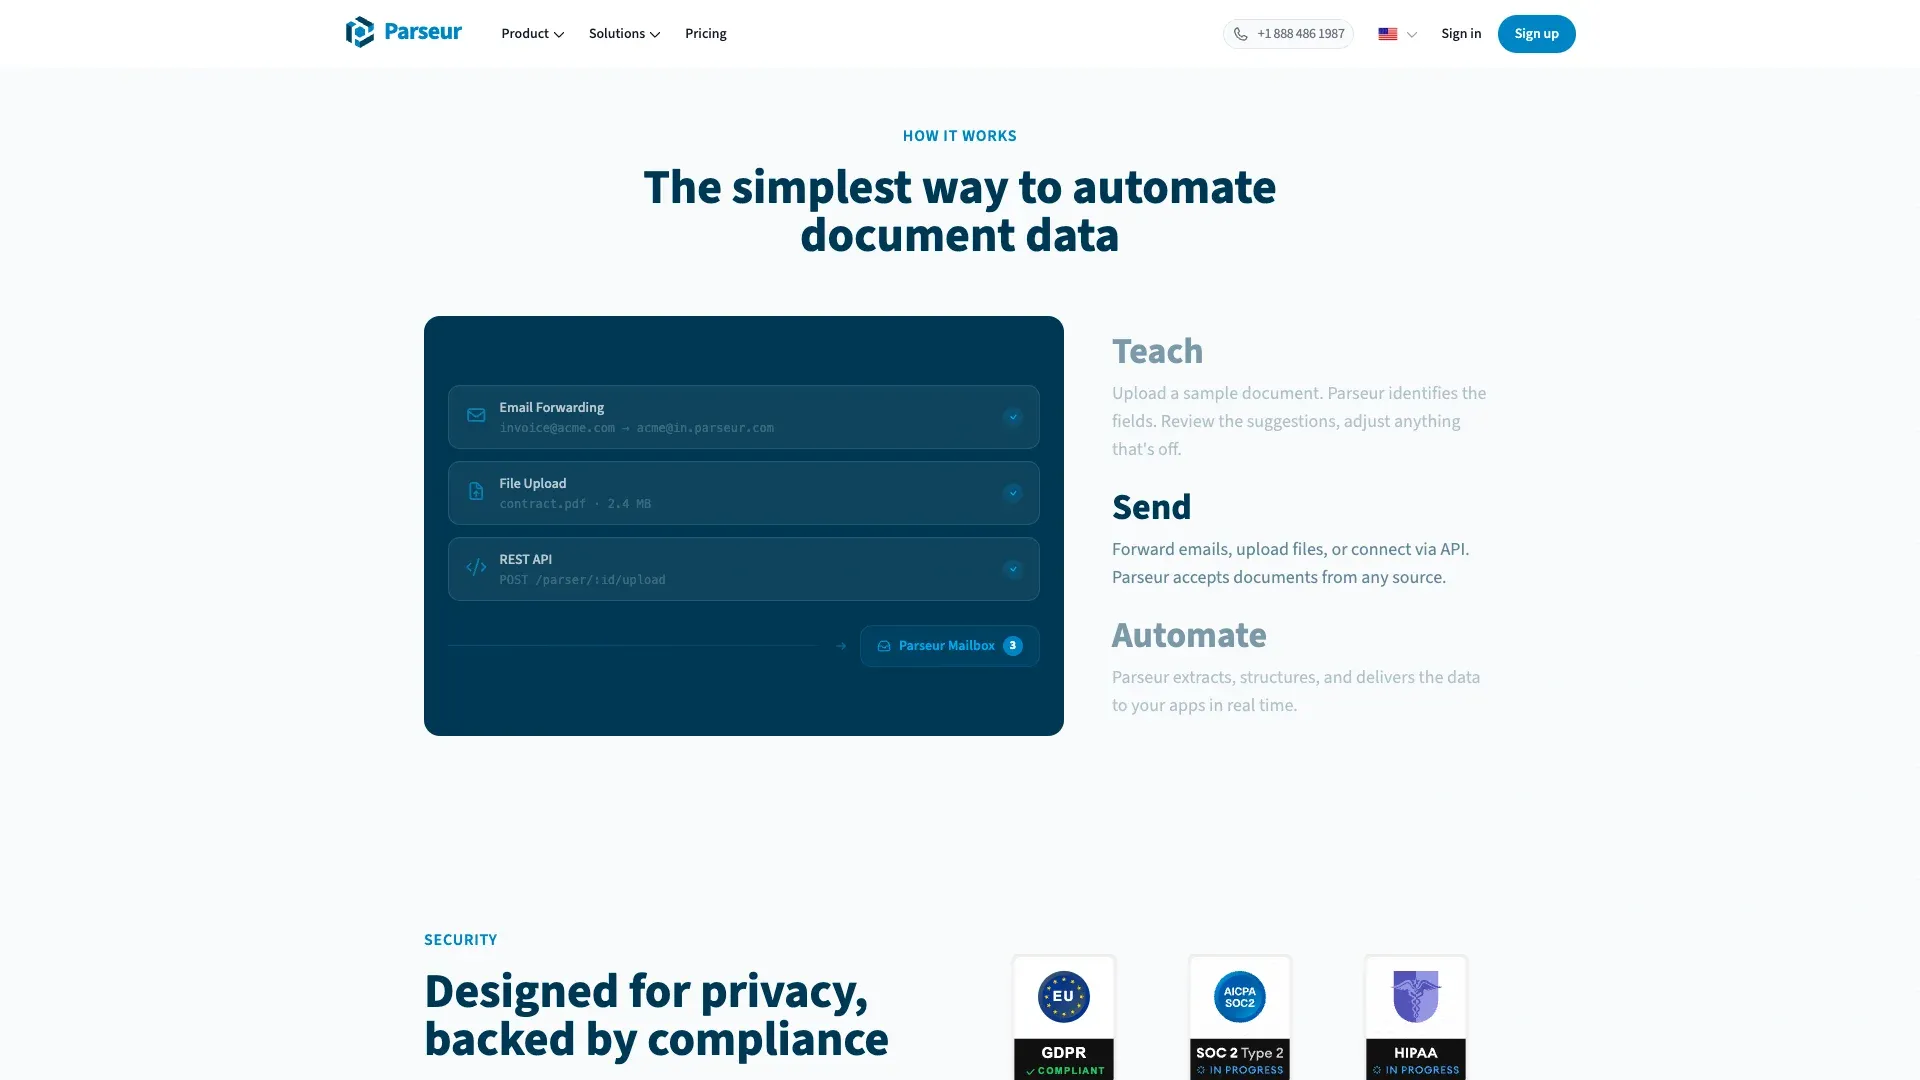 Parseur هو الأقوى ضمن فئة SaaS الهجينة لأنه يجمع بين التحليل بالذكاء الاصطناعي، والتحليل بالقوالب، وOCR الديناميكي. وهذا يجعله أكثر مرونة من المحلل الموضعي البحت، لكنه لا يزال أكثر تنظيمًا من أداة AI عامة بالكامل.
الميزات الرئيسية:
- OCR مدمج مع دعم أكثر من 60 لغة (و160+ بشكل تجريبي)
- تكاملات مع Zapier وMake وPower Automate وAPI وWebhooks وGoogle Sheets
- مناسب جدًا للفواتير وإشعارات الشحن وتأكيدات الطلبات وأنواع المستندات المتكررة
التسعير: خطة مجانية تقارب 20 صفحة شهريًا. أدنى باقة مدفوعة ذاتية الخدمة تبدأ من نحو 39 دولارًا شهريًا. وتبلغ التكلفة المعيارية في الباقة الأصغر قرابة 390 دولارًا لكل 1000 صفحة، مع انخفاض المعدل الفعلي عند زيادة الحجم.
الأفضل لـ: الفرق التي تتلقى الأنواع نفسها من المستندات مرارًا وتريد أتمتة بدون برمجة.
الإيجابيات: OCR مدمج؛ حزمة أتمتة قوية؛ يتعامل جيدًا مع التخطيطات المتكررة.
السلبيات: قد يحتاج كل تخطيط جديد أو متغير إلى قوالب أو إلى الرجوع لذكاء اصطناعي؛ وما تزال هياكل الجداول المعقدة أصعب.
4. Nanonets
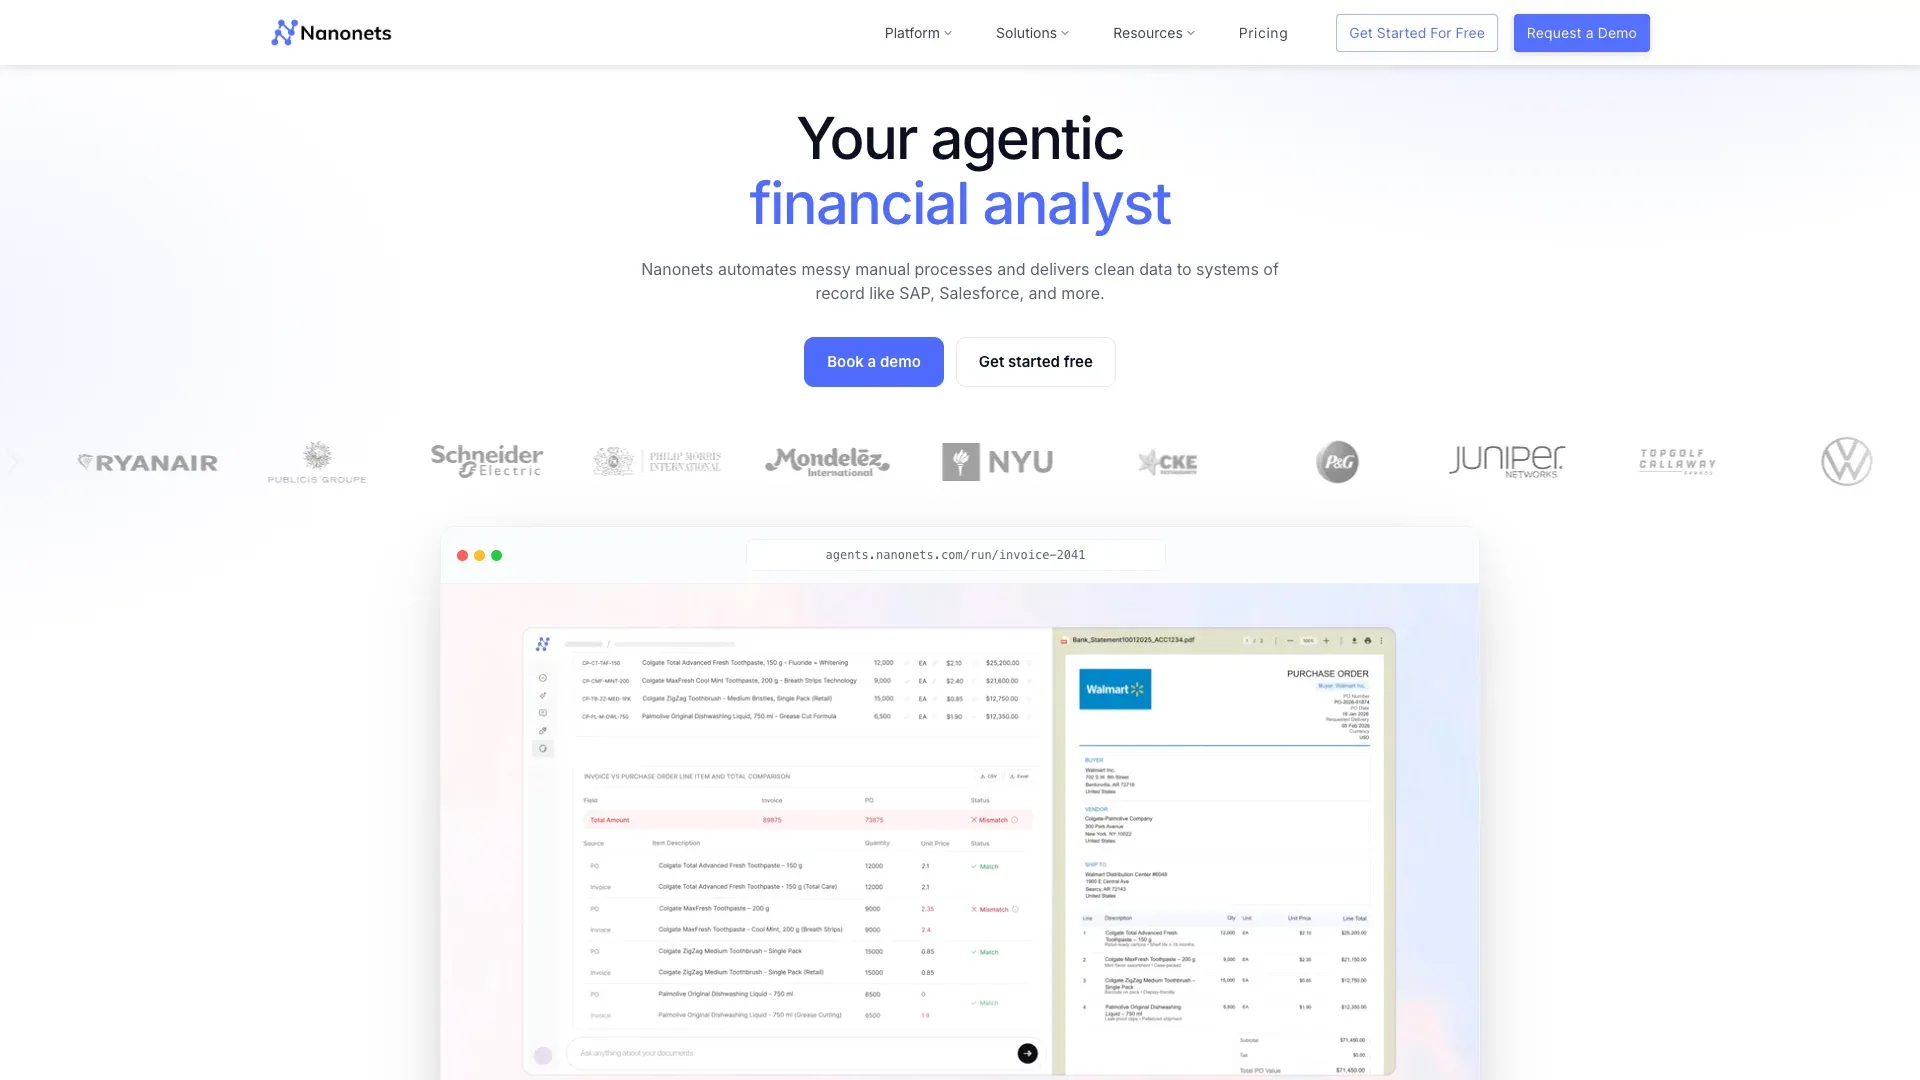 Nanonets أقرب إلى منصة معالجة مستندات ذكية (IDP) منه إلى أداة PDF بسيطة — وهذا مصدر قوته وتعقيده في الوقت نفسه. وقد غيّرت الشركة التسعير في 31 يناير 2025، بالانتقال إلى أرصدة استخدام مدفوعة مسبقًا بدلًا من خطة بسيطة تعتمد على عدد الصفحات.
الميزات الرئيسية:
- استخراج جداول وحقول مدعوم بالذكاء الاصطناعي
- OCR مدمج مع دعم أكثر من 40 لغة
- أتمتة سير العمل مع خطوات اعتماد
- حزمة تكاملات واسعة على مستوى المؤسسات
التسعير: أرصدة عند التسجيل. فوترة حسب الاستخدام. والتقدير التقريبي استنادًا إلى وثائق التسعير العلنية هو نحو 300–380 دولارًا لكل 1000 صفحة لسير عمل استخراج بسيط.
الأفضل لـ: الفرق المتوسطة إلى الكبيرة التي تعالج آلاف المستندات شهريًا (أتمتة الحسابات الدائنة، اللوجستيات، مطالبات التأمين).
الإيجابيات: استخراج قوي بالذكاء الاصطناعي؛ تكاملات مؤسسية؛ أتمتة لسير العمل.
السلبيات: يصعب التنبؤ بالتسعير؛ منحنى تعلم لسير العمل المتقدمة؛ خطة مجانية محدودة.
5. Adobe Acrobat
 Adobe Acrobat هو أداة PDF الأساسية التي يعرفها تقريبًا الجميع. وهو قوي في OCR والتحويل، لكنه ليس بالمعنى الحقيقي أداة استخراج مثل بقية هذه القائمة.
الميزات الرئيسية:
- OCR مدمج في Pro
- التصدير إلى Word وExcel وPowerPoint وHTML وTXT وصيغ الصور
- دعم واسع لـ OCR بعدة لغات
التسعير: Acrobat Standard بسعر 14.99 دولارًا شهريًا؛ وAcrobat Pro بسعر 19.99 دولارًا شهريًا. Reader مجاني، لكن ميزات التصدير تتطلب خطة مدفوعة.
الأفضل لـ: المستخدمين الذين يحتاجون أحيانًا إلى تحويل PDF إلى Word أو Excel ولديهم أصلًا اشتراك في Adobe.
الإيجابيات: موثوق على نطاق واسع؛ OCR مدمج؛ كثير من المستخدمين يمتلكونه بالفعل.
السلبيات: استخراج الجداول أساسي في التخطيطات المعقدة؛ لا أتمتة ولا API لمعالجة الدفعات؛ ليس مصممًا ليكون "أداة استخراج".
6. PyMuPDF
 PyMuPDF (المعروف أيضًا باسم "fitz") ما يزال أسرع مكتبة Python عامة لاستخراج PDF في هذه المقارنة. والإصدار الحالي هو 1.27.2.2 من مارس 2026، كما أن المعايير القياسية لا تزال تُظهره أسرع بكثير من العديد من مكتبات PDF الأخرى في Python.
الميزات الرئيسية:
- استخراج نص خام بسرعة عالية جدًا
- استخراج الصور والوصول إلى البيانات الوصفية
- OCR اختياري عبر Tesseract (مع ملاحظة أن الوثائق تشير إلى أن OCR أبطأ بنحو 1000 مرة من الاستخراج القياسي)
- اكتشاف الجداول عبر
find_tables()
التسعير: مجاني بالكامل، مفتوح المصدر.
الأفضل لـ: المطورين الذين يبنون خطوط معالجة ويعملون أساسًا على ملفات PDF النصية الكثيفة.
الإيجابيات: سريع جدًا؛ خفيف؛ مجتمع نشط؛ استخراج نص قوي.
السلبيات: لا OCR مدمج؛ استخراج الجداول يتطلب منطق تحليل يدوي؛ يتطلب كتابة كود.
7. Camelot
 Camelot ما تزال واحدة من أشهر أدوات استخراج الجداول في Python لأنها تضع الجداول في المقدمة بدلًا من التعامل مع المستندات عمومًا. والمستودع الحالي ما يزال مُدارًا، مع إصدار v1.0.9 في أغسطس 2025.
الميزات الرئيسية:
- وضعا استخراج:
latticeللجداول ذات الحدود، وstreamللجداول بلا حدود أو المعتمدة على الفراغات - مقاييس دقة في تقرير التحليل — وهي من أكثر ميزات Camelot فائدة لأتمتة سير العمل
- إخراج إلى pandas DataFrames وCSV وJSON وExcel
التسعير: مجاني بالكامل، مفتوح المصدر.
الأفضل لـ: المطورين الذين يحتاجون إلى استخراج دقيق للجداول من ملفات PDF النصية المنظمة.
الإيجابيات: دقة ممتازة في الجداول؛ وضعي استخراج؛ تقييم للدقة.
السلبيات: لا OCR؛ يعمل مع ملفات PDF النصية فقط؛ يتطلب كود؛ وقد يكون بطيئًا على المستندات الكبيرة.
8. Docparser
 Docparser هي أوضح أداة SaaS قائمة على القواعد في هذه المجموعة. فهي تستخدم OCR الموضعي، وكلمات الربط، وقواعد تحليل ثابتة التخطيط بدلًا من محاولة التصرف كقارئ AI عام متعدد التخطيطات.
الميزات الرئيسية:
- OCR مدمج
- تكامل مع Zapier وWorkato وPower Automate وGoogle Sheets وSalesforce وREST API
- مناسبة لتوجيه البيانات المستخرجة إلى سير العمل التجاري
التسعير: Starter بسعر 39 دولارًا شهريًا؛ Professional بسعر 74 دولارًا شهريًا؛ Business بسعر 159 دولارًا شهريًا. تجربة مجانية لمدة 14 يومًا. الفوترة حسب المستند، لذا تعتمد التكلفة المعيارية لكل 1000 صفحة على طول المستند — تقريبًا 78–390 دولارًا في فئة Starter.
الأفضل لـ: الفرق التي تحتاج إلى أتمتة سير عمل المستندات المتكررة مع تكامل وثيق مع أدوات مثل Zapier أو Salesforce.
الإيجابيات: OCR مدمج؛ تكاملات قوية لسير العمل؛ جيد للتخطيطات المستقرة.
السلبيات: يعتمد على القوالب — فكل تخطيط جديد يتطلب إعدادًا؛ استخراج الجداول يعتمد على تعريف المناطق؛ الأقوى غالبًا في الصفحة الأولى.
9. pdfplumber
 pdfplumber ما تزال أكثر مكتبة للمطورين تفصيلًا في هذه القائمة. والإصدار الحالي هو 0.11.9 من يناير 2026، ويذكر المستودع أنه في تطوير نشط.
الميزات الرئيسية:
- تحكم دقيق جدًا في كائنات الأحرف والخطوط والمستطيلات واستراتيجيات العثور على الجداول
- تصفية قائمة على القص مع تصحيح بصري
- إخراج البيانات كقوائم/قواميس Python لسهولة المعالجة
التسعير: مجاني بالكامل، مفتوح المصدر.
الأفضل لـ: مطوري Python الذين يحتاجون منطق استخراج جداول دقيقًا وقابلًا للتخصيص.
الإيجابيات: تحكم منخفض المستوى ممتاز؛ دقة جيدة في الجداول المعقدة؛ تطوير نشط.
السلبيات: لا OCR؛ منحنى تعلم أصعب من Camelot؛ يتطلب كود.
10. AWS Textract
 AWS Textract هو أكثر API ملائمًا للمؤسسات في هذه القائمة. فهو مصمم للتوسع وتنوع المستندات والاستخدام البرمجي بدلًا من راحة الواجهة الرسومية.
الميزات الرئيسية:
- استخراج الجداول والنماذج مدعوم بالذكاء الاصطناعي
- OCR مدمج مع دعم الكتابة اليدوية (الأقرب في هذه القائمة، لكنه ما يزال غير مثالي)
- قابلية توسع بمستوى مؤسسي
- تكامل نظيف مع منظومة AWS
التسعير: فواتير حسب الصفحة. الخطة المجانية: 1000 صفحة شهريًا لمدة 3 أشهر. بعد ذلك: OCR نصي فقط مقابل 1.50 دولار/1000 صفحة؛ والجداول مقابل 15 دولارًا/1000 صفحة؛ والنماذج + الجداول مقابل 65 دولارًا/1000 صفحة؛ ومستندات المصروفات مقابل 10 دولارات/1000 صفحة.
الأفضل لـ: فرق المؤسسات التي تعالج 10,000+ مستند شهريًا عبر خط API.
الإيجابيات: استخراج دقيق للنماذج والجداول؛ OCR مدمج؛ قابلية توسع مؤسسية.
السلبيات: API فقط؛ لا توجد واجهة مرئية؛ ترتفع التكاليف سريعًا في الأوضاع المتقدمة؛ ارتباط واضح بمنظومة AWS.
11. Docling
 Docling هي الأداة مفتوحة المصدر الأكثر توجهًا نحو المستقبل هنا لأنها موجهة مباشرة لخطوط العمل من المستند إلى LLM. والإصدار الحالي هو 2.90.0 من 17 أبريل 2026، والمشروع يتحرك بسرعة.
الميزات الرئيسية:
- إخراج إلى Markdown وHTML وWebVTT وDocTags وJSON بدون فقدان
- دعم OCR عبر عدة محركات مدمجة
- مصمم للعمل مع LangChain وLlamaIndex وCrewAI وHaystack وما يشبهها
- نمو قوي في المجتمع
التسعير: مجاني بالكامل، مفتوح المصدر.
الأفضل لـ: المطورين الذين يبنون تطبيقات LLM/RAG ويحتاجون إلى تحويل PDF إلى Markdown منظم وجاهز للذكاء الاصطناعي.
الإيجابيات: إخراج Markdown نظيف؛ OCR عبر التكامل؛ مصمم لسير العمل الحديث للذكاء الاصطناعي؛ تطوير نشط.
السلبيات: يتطلب كود؛ موجه أساسًا للمطورين؛ واجهة أو خيارات تصدير أقل صقلًا مقارنة بأدوات SaaS.
12. Parsio
 Parsio هي محلل SaaS هجين يجمع بين القوالب وOCR والذكاء الاصطناعي والتحليل المدعوم بـ GPT. وهي تقف بين Parseur وDocparser من حيث الفكرة: أكثر مرونة من المناطق البحتة، لكنها ما تزال محسنة لاستقبال المستندات المتكررة.
الميزات الرئيسية:
- OCR مدمج
- اكتشاف الحقول بمساعدة الذكاء الاصطناعي
- تكامل مع Google Sheets وWebhooks وAPI وZapier وMake وn8n وPabbly
التسعير: Sandbox مع 30 رصيدًا. خطة Starter بسعر 41 دولارًا شهريًا مقابل 1000 رصيد؛ وGrowth بسعر 124 دولارًا شهريًا؛ وBusiness بسعر 249 دولارًا شهريًا. قد تكلف وثيقة أو صفحة PDF واحدة 1 أو 2 أو 5 أرصدة حسب وضع التحليل، لذا فإن التقدير المعياري في خطة Starter يقع تقريبًا بين 41 و205 دولارات لكل 1000 صفحة.
الأفضل لـ: الفرق الصغيرة إلى المتوسطة التي تعالج أنواعًا متكررة من المستندات (الفواتير، الإيصالات) وتريد حل SaaS بدون كود مع لمسة خفيفة من الذكاء الاصطناعي.
الإيجابيات: OCR مدمج؛ تغطية واسعة لأنواع المستندات؛ حزمة أتمتة واسعة.
السلبيات: عمق مراجعات الجهات الخارجية محدود؛ التسعير أقل وضوحًا عبر أوضاع التحليل؛ ليس مميزًا بوضوح مثل Parseur أو Nanonets.
مواجهة استخراج الجداول: كيف تتعامل أفضل أدوات PDF مع جداول العالم الحقيقي
استخراج الجداول هو أكثر نقطة ألم يتحدث عنها مستخدمو أدوات PDF باستمرار — ولسبب وجيه. فالمعايير الحديثة مثل OmniDocBench (1,651 صفحة عبر 10 أنواع مستندات) والبحث الأكاديمي حول استخراج الجداول غير المتجانسة يؤكدان أن "استخراج الجداول" ليس مهمة واحدة موحدة، بل طيف من المهام.
الجداول البسيطة (حدود واضحة، صفحة واحدة)
معظم الأدوات تتعامل معها جيدًا. Tabula وCamelot وpdfplumber وThunderbit وAWS Textract تؤدي أداءً جيدًا هنا. إذا كانت ملفات PDF لديك تحتوي فقط على جداول بسيطة ذات حدود واضحة، فستنجح تقريبًا أي أداة في هذه القائمة.
الجداول بلا حدود والمعتمدة على الفراغات
هنا يظهر الفرق بوضوح. من دون خطوط مرسومة، تجد المحللات القائمة على القواعد صعوبة في اكتشاف حدود الأعمدة. وضع stream في Camelot وضبط المعلمات بشكل مخصص في pdfplumber مناسبان جدًا للمطورين القادرين على تحسين الإعدادات. أما الأدوات المدعومة بالذكاء الاصطناعي مثل Thunderbit وNanonets وAWS Textract فَتَفهم التخطيط بصريًا، وغالبًا ما يكون هذا أفضل للمستخدمين غير التقنيين الذين يتعاملون مع تنسيقات غير ثابتة.
الجداول الممتدة عبر عدة صفحات
وهذا فشل شائع جدًا. غالبًا ما تتعامل الأدوات القائمة على القوالب والمستخرجات البسيطة مع كل صفحة كأنها جدول منفصل، ما لم يعِد سير العمل ربطها صراحةً. أما أدوات الذكاء الاصطناعي فتملك أفضلية هنا لأنها تستطيع فهم الاستمرارية دلاليًا لا هندسيًا فقط — رغم أنه لا ينبغي اعتبار أي مزود مثاليًا في هذه الفئة.
الخلايا المدمجة والعناوين المتداخلة
وهو السيناريو الأصعب. تشير ورقة EMNLP 2024 حول استخراج معلومات الجداول غير المتجانسة إلى أن نطاق F1 يتراوح بين 74.2 و96.1 بحسب الطريقة والسيناريو. تميل الأدوات المدعومة بالذكاء الاصطناعي (Thunderbit وNanonets وAWS Textract) إلى التفوق على المحللات القائمة على القواعد هنا لأنها تفسر التخطيط دلاليًا بدلًا من الاعتماد على الخطوط المرسومة.
مقارنة OCR: أي أدوات PDF تتعامل مع المستندات الممسوحة؟
OCR هو الحد الفاصل بين الأدوات التي تستطيع التعامل مع ملفات PDF التجارية الحقيقية، وتلك التي تتعامل فقط مع المستندات المثالية المولدة آليًا. إليك الجدول:
| الأداة | OCR أصلي | دعم PDF الممسوح | OCR متعدد اللغات | دعم الكتابة اليدوية |
|---|---|---|---|---|
| Thunderbit | ✅ مدمج | ✅ نعم | ✅ 34 لغة | ⚠️ محدود |
| Adobe Acrobat | ✅ مدمج | ✅ نعم | ✅ قوي | ⚠️ محدود |
| AWS Textract | ✅ مدمج | ✅ نعم | ✅ عدة لغات رئيسية | ✅ الأقرب، لكنه غير مثالي |
| Nanonets | ✅ مدمج | ✅ نعم | ✅ أكثر من 40 لغة | ⚠️ محدود |
| Parseur | ✅ مدمج | ✅ نعم | ✅ أكثر من 60 لغة | ❌ لا |
| Parsio | ✅ مدمج | ✅ نعم | ✅ متعدد اللغات | ⚠️ محدود |
| Docparser | ✅ مدمج | ✅ نعم | ✅ نعم | ⚠️ محدود |
| Docling | ✅ عبر تكامل | ✅ نعم | يعتمد على المحرك | ⚠️ محدود |
| Tabula | ❌ لا يوجد | ❌ لا | غير متاح | غير متاح |
| PyMuPDF | ❌ لا (Tesseract اختياري) | ❌ يتطلب إضافة | يعتمد على المحرك | يعتمد على المحرك |
| Camelot | ❌ لا يوجد | ❌ لا | غير متاح | غير متاح |
| pdfplumber | ❌ لا يوجد | ❌ لا | غير متاح | غير متاح |
لا توجد أداة تتعامل مع الكتابة اليدوية بشكل موثوق في كل الحالات عام 2026. AWS Textract هو أقرب API مؤسسي، لكن الكتابة اليدوية ما تزال ميزة يجب استخدامها بحذر. إذا كانت ملفات PDF لديك ممسوحة ضوئيًا لكنها مطبوعة، فستكون أي أداة تحتوي على OCR مدمج مناسبة جدًا. أما إذا كانت بخط اليد، فضع توقعات واقعية.
مدعوم بالذكاء الاصطناعي أم قائم على القواعد أم قائم على القوالب: ثلاثة أجيال لاستخراج PDF
أسهل طريقة لفهم سوق أدوات PDF في 2026 هي النظر إليه كأنه ثلاثة أجيال:
الجيل الأول: قائم على القواعد (Tabula، Camelot، pdfplumber)
يعمل هذا الجيل أفضل ما يكون على ملفات PDF النصية المنظمة ذات التخطيطات الثابتة. وهو قوي بين أيدي المطورين، لكنه هش عندما تتغير التخطيطات. وإذا كانت مستنداتك متوقعة، فهو ما يزال ممتازًا — ومجانيًا.
الجيل الثاني: قائم على القوالب (Parseur، Docparser، Parsio)
يحدد المستخدمون مناطق أو حقولًا لكل نوع مستند. وهذا رائع للتنسيقات المتكررة مثل الفواتير من المورد نفسه. لكن المفارقة أن أي تخطيط جديد أو تغير في التخطيط يتطلب إعدادًا أو صيانة.
الجيل الثالث: مدعوم بالذكاء الاصطناعي/LLM (Thunderbit، Nanonets، AWS Textract، Docling لخطوط عمل LLM)
يقرأ الذكاء الاصطناعي المستند دلاليًا، ويتكيف مع التخطيطات الجديدة دون قوالب، ويمكنه وسم البيانات وتحويلها في الوقت نفسه. وهذا هو الاتجاه الذي يسير نحوه السوق. كل من تقييم Everest Group لـ IDP في 2025 وبحث ACL 2025 عن الجداول متعددة الوسائط يشيران إلى أن الاستخراج المعتمد على LLM والوكلاء سيكون المعيار التالي.
وللمستخدمين غير التقنيين، هذا مهم عمليًا: إذا كانت ملفات PDF تأتيك من مصادر متعددة (مورّدون، شركاء، عملاء)، فإن الأدوات المعتمدة على القوالب تصبح عبئًا للصيانة. أما الأدوات المدعومة بالذكاء الاصطناعي فتتعامل مع التنوع مباشرة. وهذه بالضبط الفجوة التي بُنيت Thunderbit لسدها — مستخدمو الأعمال الذين لديهم ملفات PDF متنوعة ولا يريدون كتابة Python أو صيانة قوالب استخراج.
استخراج PDF بالذكاء الاصطناعي للتخطيطات المتنوعة ليس من الضروري أن يناسب مخطط واحد كل مورّد — فالذكاء الاصطناعي يقرأ كل مستند ويكتشف بنيته بنفسه. Get Started Free
تفصيل التسعير: ما التكلفة الحقيقية لأفضل أدوات استخراج PDF؟
هذه هي المقارنة التي لا ينشرها غيرنا، وهي الأكثر طلبًا من المستخدمين. إليك الصورة بصراحة:
| الأداة | الخطة المجانية | سعر البداية المدفوع | التكلفة التقديرية لكل 1000 صفحة | مفتوح المصدر؟ |
|---|---|---|---|---|
| Thunderbit | ✅ رصيد مجاني | ~$15/شهر (أو $9/شهر سنويًا) | ~$18–$30 | لا |
| Tabula | ✅ غير محدود | مجاني دائمًا | $0 | نعم |
| Camelot | ✅ غير محدود | مجاني دائمًا | $0 | نعم |
| PyMuPDF | ✅ غير محدود | مجاني دائمًا | $0 | نعم |
| pdfplumber | ✅ غير محدود | مجاني دائمًا | $0 | نعم |
| Docling | ✅ غير محدود | مجاني دائمًا | $0 | نعم |
| Parseur | ⚠️ نحو 20 صفحة/شهر | ~$39/شهر | ~$390 (أدنى باقة) | لا |
| Nanonets | ⚠️ أرصدة عند التسجيل | حسب الاستخدام | ~$300–$380 | لا |
| Docparser | ⚠️ تجربة 14 يومًا | $39/شهر | ~$78–$390 | لا |
| Parsio | ⚠️ 30 رصيدًا | $41/شهر | ~$41–$205 | لا |
| Adobe Acrobat | ❌ (التصدير مدفوع) | $19.99/شهر Pro | غير محسوبة بالصفحات | لا |
| AWS Textract | ⚠️ 1000 صفحة/شهر (3 أشهر) | حسب الاستخدام | $1.50–$65 | لا |
والتكلفة الخفية أهم من السعر الظاهر على الموقع. أدوات Python مفتوحة المصدر مجانية من حيث المال، لكنها تستهلك وقت المطورين في الإعداد والصيانة وتصحيح الأخطاء. أدوات SaaS القائمة على القوالب بسيطة عندما يكون التنوع قليلًا، لكنها تصبح مكلفة عندما تتغير التخطيطات. أدوات AI بدون كود مثل Thunderbit تكلف أرصدة لكل صف، لكنها تقلل وقت الإعداد بشكل كبير. أما APIs السحابية مثل AWS Textract فهي الأرخص على نطاق واسع — ولكن فقط عندما تكون البنية الهندسية جاهزة أصلًا.
وعندما أفكر في "التكلفة الحقيقية"، فإنني أضيف راتب الشخص الذي يقوم بالعمل. فالساعة التي يقضيها محلل بيانات في إعداد القوالب أو كتابة Python ليست مجانية، حتى لو كان البرنامج نفسه مجانيًا.
أي أداة لاستخراج PDF يجب أن تختار؟
إليك دليلًا سريعًا لاتخاذ القرار:
| حالتك | الأداة/الأدوات الموصى بها |
|---|---|
| غير تقني، تخطيطات PDF متنوعة، وتريد نتائج سريعة | Thunderbit، Nanonets |
| فواتير/إيصالات متكررة بنفس التنسيق | Parseur، Docparser، Parsio |
| مطور يبني خط معالجة بيانات | PyMuPDF، Camelot، pdfplumber |
| مؤسسة، أكثر من 10,000 مستند/شهر، وتحتاج API | AWS Textract، Nanonets |
| تبني تطبيق LLM/RAG | Docling |
| تحويل PDF إلى Excel أحيانًا، ولديك Adobe بالفعل | Adobe Acrobat |
| مجاني، محلي، يركز على الجداول، بدون برمجة | Tabula |
إذا كنت مستخدم أعمال وتريد فقط إخراج البيانات من ملفات PDF دون كتابة كود أو إعداد قوالب، فابدأ بـ Thunderbit. فهي تقرأ كل ملف PDF من جديد بالذكاء الاصطناعي وتصدّر النتائج إلى الأدوات التي تستخدمها أصلًا. وإذا كانت مستنداتك تتكرر بتخطيطات يمكن التعرف عليها، فـ Parseur أو Docparser خياران أفضل. وإذا كنت تريد تحكمًا هندسيًا كاملًا، فالمجموعة مفتوحة المصدر ما تزال هي الحد الأدنى من حيث التكلفة.
الخلاصة
لم يعد استخراج PDF في 2026 مشكلة واحدة لها جواب واحد. فالأداة المناسبة تعتمد على ما إذا كنت مطورًا أو محلل أعمال أو فريقًا مؤسسيًا — وعلى ما إذا كانت ملفات PDF لديك مرتبة ونصية، أم صورًا ممسوحة عشوائية من عشرات الموردين.
إذا أردت أن ترى كيف يبدو استخراج PDF المدعوم بالذكاء الاصطناعي عمليًا، فجرب الخطة المجانية من Thunderbit. أعتقد أنك ستتفاجأ بكمية البيانات التي يمكنك استخراجها من PDF خلال بضع نقرات فقط. وإذا لم تكن Thunderbit هي الخيار المثالي، فجرب بعض الأدوات الأخرى من هذه القائمة. لم يكن الوقت أفضل من الآن للتوقف عن النسخ واللصق من ملفات PDF، والبدء فعلًا في استخدام البيانات الموجودة بداخلها.
ولمزيد من المعلومات حول استخراج البيانات والأتمتة، اطلع على أدلتنا حول استخراج البيانات من مواقع الويب إلى Excel، وأفضل أدوات استخراج البيانات، واستخراج البيانات بالذكاء الاصطناعي للأعمال، وكيفية تحويل الصور إلى Excel. يمكنك أيضًا مشاهدة شروحات خطوة بخطوة على قناة Thunderbit على YouTube.
جرّب Thunderbit مجانًا الجداول وOCR والتقارير المختلطة في تمريرة واحدة. الخطة المجانية تكفي لتجربة ما إذا كانت الأداة تتعامل مع مستنداتك. Get Started Free
الأسئلة الشائعة
1. ما أفضل أداة مجانية لاستخراج PDF؟
لغير المطورين، Tabula هي أبسط أداة مجانية بالكامل بواجهة رسومية للجداول النصية في PDF. وللمطورين، تعد Camelot وpdfplumber وPyMuPDF وDocling خيارات مجانية قوية. وإذا أردت خيارًا بدون كود مع خطة مجانية، فـ Thunderbit هو أفضل نقطة بداية.
2. هل تستطيع أدوات استخراج PDF التعامل مع المستندات الممسوحة؟
فقط الأدوات التي تحتوي على OCR مدمج يمكنها التعامل مع ملفات PDF الممسوحة مباشرة. ويشمل ذلك Thunderbit وAdobe Acrobat وAWS Textract وNanonets وParseur وDocparser وParsio وDocling (مع محركات OCR مدمجة). أما Tabula وCamelot وpdfplumber فلا تستطيع التعامل مع ملفات PDF الممسوحة بمفردها — وتحتاج إلى ربطها بـ OCR خارجي مثل Tesseract.
3. ما مدى دقة استخراج الجداول من ملفات PDF؟
يعتمد ذلك كثيرًا على تعقيد الجدول. معظم الأدوات تتعامل جيدًا مع الجداول البسيطة ذات الحدود الواضحة. أما الجداول بلا حدود، والخلايا المدمجة، والجداول متعددة الصفحات فهي أصعب بكثير. تميل الأدوات المدعومة بالذكاء الاصطناعي مثل Thunderbit وNanonets وAWS Textract إلى التفوق على المحللات القائمة على القواعد عند اختلاف التخطيطات، بينما تظل الأدوات القائمة على القواعد ممتازة مع ملفات PDF النصية الثابتة.
4. هل أحتاج إلى مهارات برمجية لاستخراج PDF؟
لا. أدوات مثل Thunderbit وParseur وDocparser وParsio وNanonets وAdobe Acrobat يمكن استخدامها بدون برمجة. كما أن Tabula يملك واجهة رسومية. أما مكتبات Python مثل PyMuPDF وCamelot وpdfplumber وDocling فتتطلب كتابة كود.
5. هل يمكنني تصدير بيانات PDF مباشرة إلى Excel أو Google Sheets؟
معظم الأدوات تدعم التصدير إلى CSV أو Excel كحد أدنى. كما يصدّر Thunderbit مباشرة إلى Google Sheets وAirtable وNotion مجانًا. ويدعم Parseur وDocparser وParsio التصدير إلى سير العمل التجاري عبر تكاملات مثل Zapier وWebhooks وAPIs.
جرّب استخراج PDF بالذكاء الاصطناعي مع Thunderbit Get Started Free
اعرف المزيد



