
Facebook 爬取在 2026 年依然值得做,但前提是你选对采集方式。皮尤研究中心(Pew Research Center)于 2025 年 11 月 20 日发布报告称,71% 的美国成年人使用 Facebook。Meta 则在 2026 年 4 月 29 日表示,其 Family of Apps 在 2026 年 3 月触达了 35.6 亿日活用户。正因为规模足够大,Facebook 依然适合用于 Marketplace 监测、公开页面研究、线索开发以及竞品追踪。难点从来不是有没有场景,而是如何在不被登录墙、动态加载、临时封禁或脆弱爬虫方案卡住的情况下,拿到干净数据。
这份年度精选榜单的目标是帮你快速做决策。我在 2026 年 8 月重新核对了官方产品页、文档和价格信号,然后只保留那些对真实业务用户仍然有意义的工具。如果你需要 API 级别的基础设施,Bright Data、Apify 和 Nimble by Nimbleway 都值得排在前列。如果你的工作还包括云端自动化,或者采集后的后续动作,PhantomBuster 也很值得重点看一眼。
按场景快速推荐
- 需要针对自己管理的资产走官方路径? 先用 Meta 的管理工具和已获批准的 API。
- 需要专门的公开数据 API? 根据目标页面和允许的使用范围,评估 Bright Data 或 Apify。
- 需要通用的网页数据基础设施层? 用一个限定范围的 PoC 来评估 Nimble 或 ScrapingBot。
- 需要可视化工作流来处理一个允许的非 Meta 来源? Octoparse 可能更适合由分析师主导的流程。
为什么 Facebook 爬取在 2026 年仍然很难
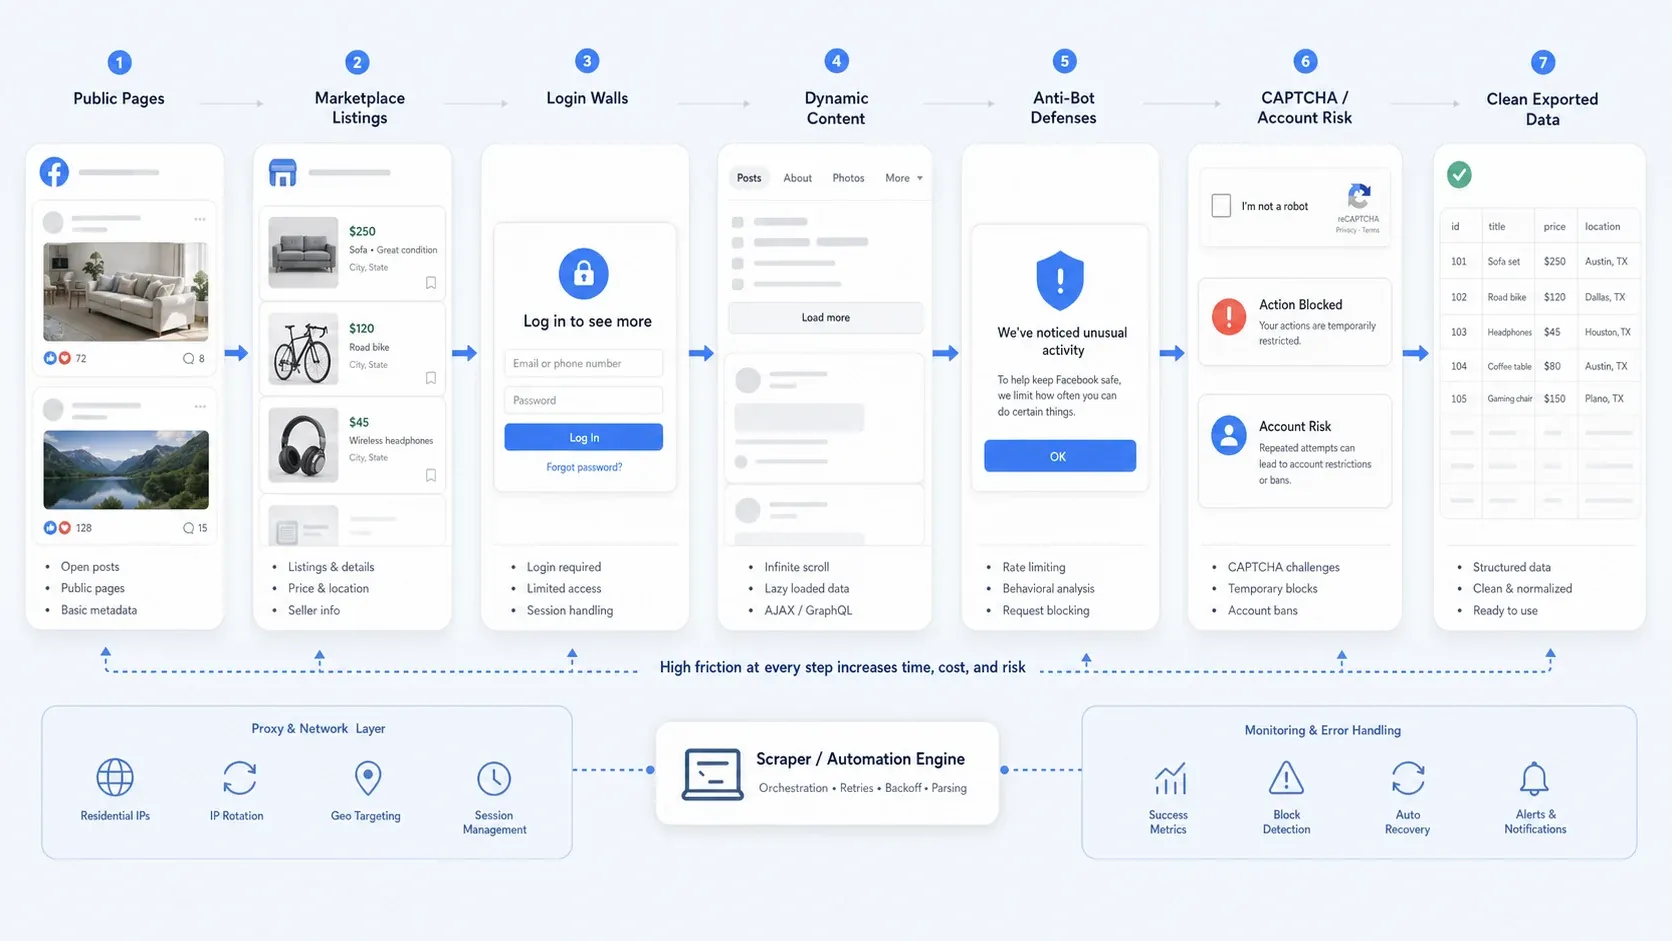
如今,Facebook 数据采集早已不只是“找选择器”这么简单。实际操作中,大多数团队都会碰到下面一种或多种问题:
- 公开访问不完整: 有些页面保持公开,但其他流程会引导你先登录才能看到更多细节。
- 动态内容: Marketplace 页面、长评论串和主页内容往往是分批加载的。
- 反爬机制: 限速、行为检测、CAPTCHA 和临时操作封禁,都会让简单粗暴的自动化失效。
- 运营风险: 只靠登录账号采集的风险远高于公开页面抓取,尤其当你在意账号安全和结果可复现性时。
我是如何评估这些工具的
这篇文章的重点是帮你缩小选择范围,而不是堆砌功能。我从以下几个维度比较了这些工具:
- 工作流匹配度: 这个产品是否真的适合真实团队在做的 Facebook 和 Marketplace 采集任务?
- 易用性: 非开发人员或精干团队能否快速得到可用结果?
- 规模与稳定性: 一旦不只是单次抓取,这个工具是否还站得住?
- 反爬与会话处理: 产品能帮你减少多少基础设施上的折腾?
- 输出质量: 能否把结构化数据顺利导出到 CSV、Sheets 或下游系统,而无需大量清洗?
- 价格信号: 这个产品是否适合直接评估,还是必须走重度企业销售流程?
- 合规姿态: 这个工具是否明确面向公开数据采集和负责任使用?
你需要哪种类型的 Facebook 爬虫?
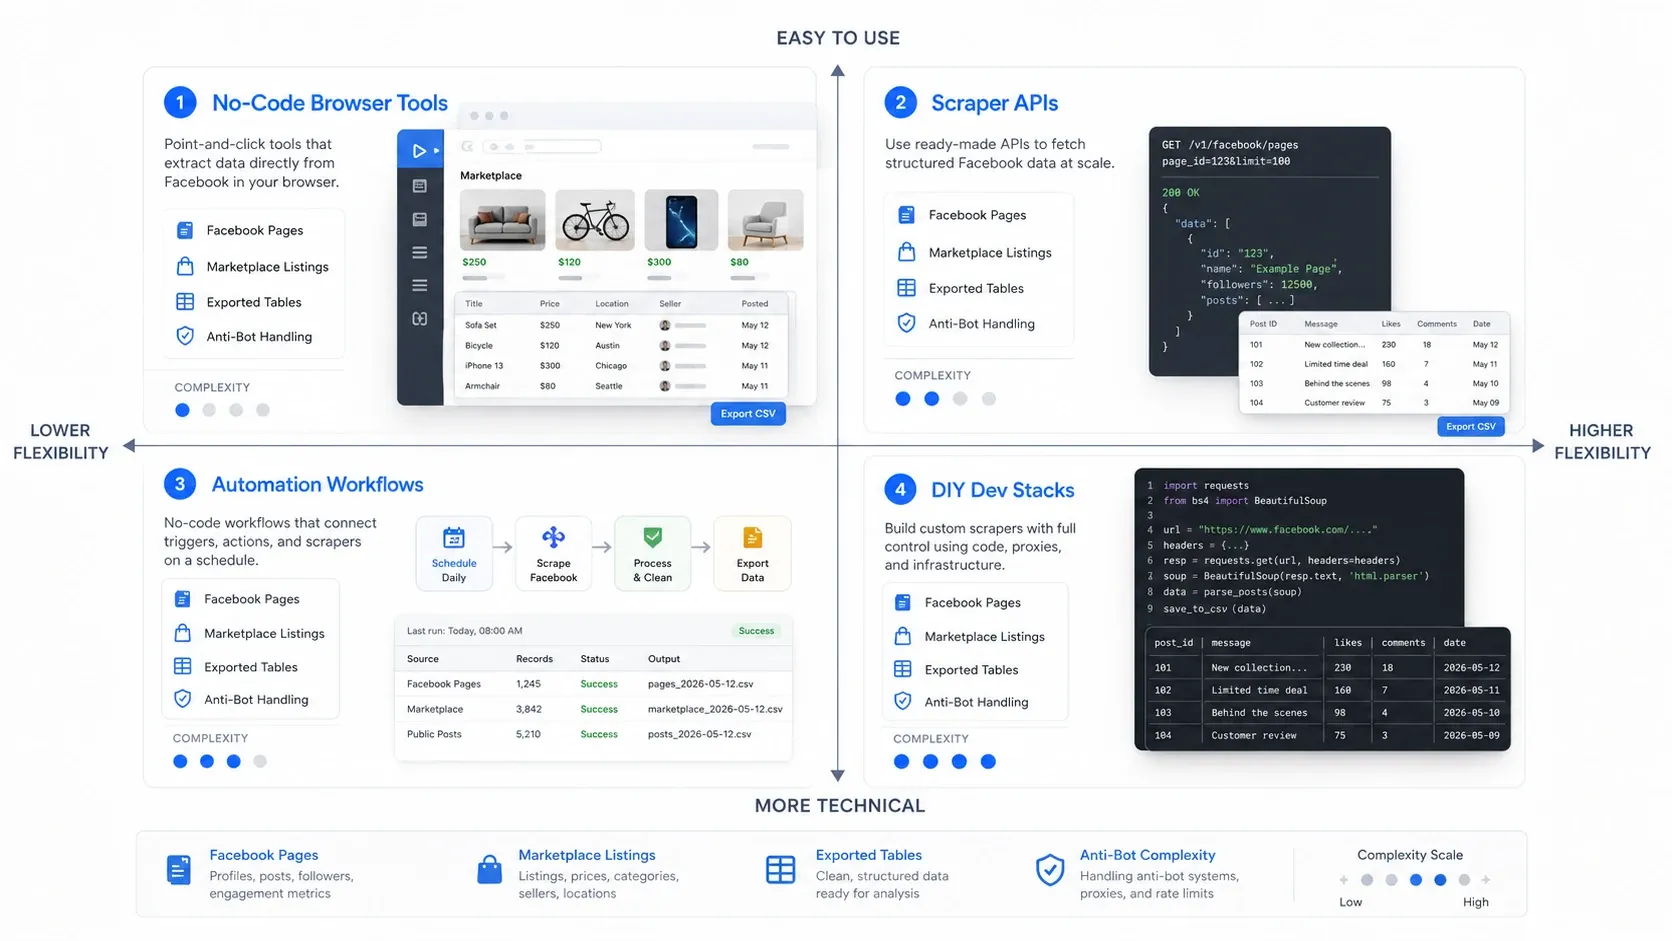
最快的选择方式,就是先选对类别。Facebook 爬取工具通常分成四种运行模式:
- 无代码浏览器工具: 适合你想从当前已经打开的页面快速提取数据。
- 爬虫 API: 适合需要高频、稳定、可重复采集的场景。
- 自动化工作流: 适合爬取只是更大增长流程中的一步。
- 自建开发栈: 适合希望拥有最高控制权、并愿意承担维护成本的团队。
对比表
| 工具 | 最适合 | 运行模式 |
|---|---|---|
| Bright Data | 托管式公开数据 API 流程 | 专用 API 与交付层 |
| Apify | 可重复执行的页面或主页任务 | 云端 actor 与数据集输出 |
| Nimble | 面向工程团队的评估 | 通用公开网页 API |
| ScrapingBot | 需要渲染能力的测试场景 | 通用抓取 API |
| PhantomBuster | 由账号持有者主导的 GTM 工作流 | 线索开发自动化 |
| Octoparse | 分析师主导的可视化任务 | 无代码可视化工作流 |
1. Bright Data
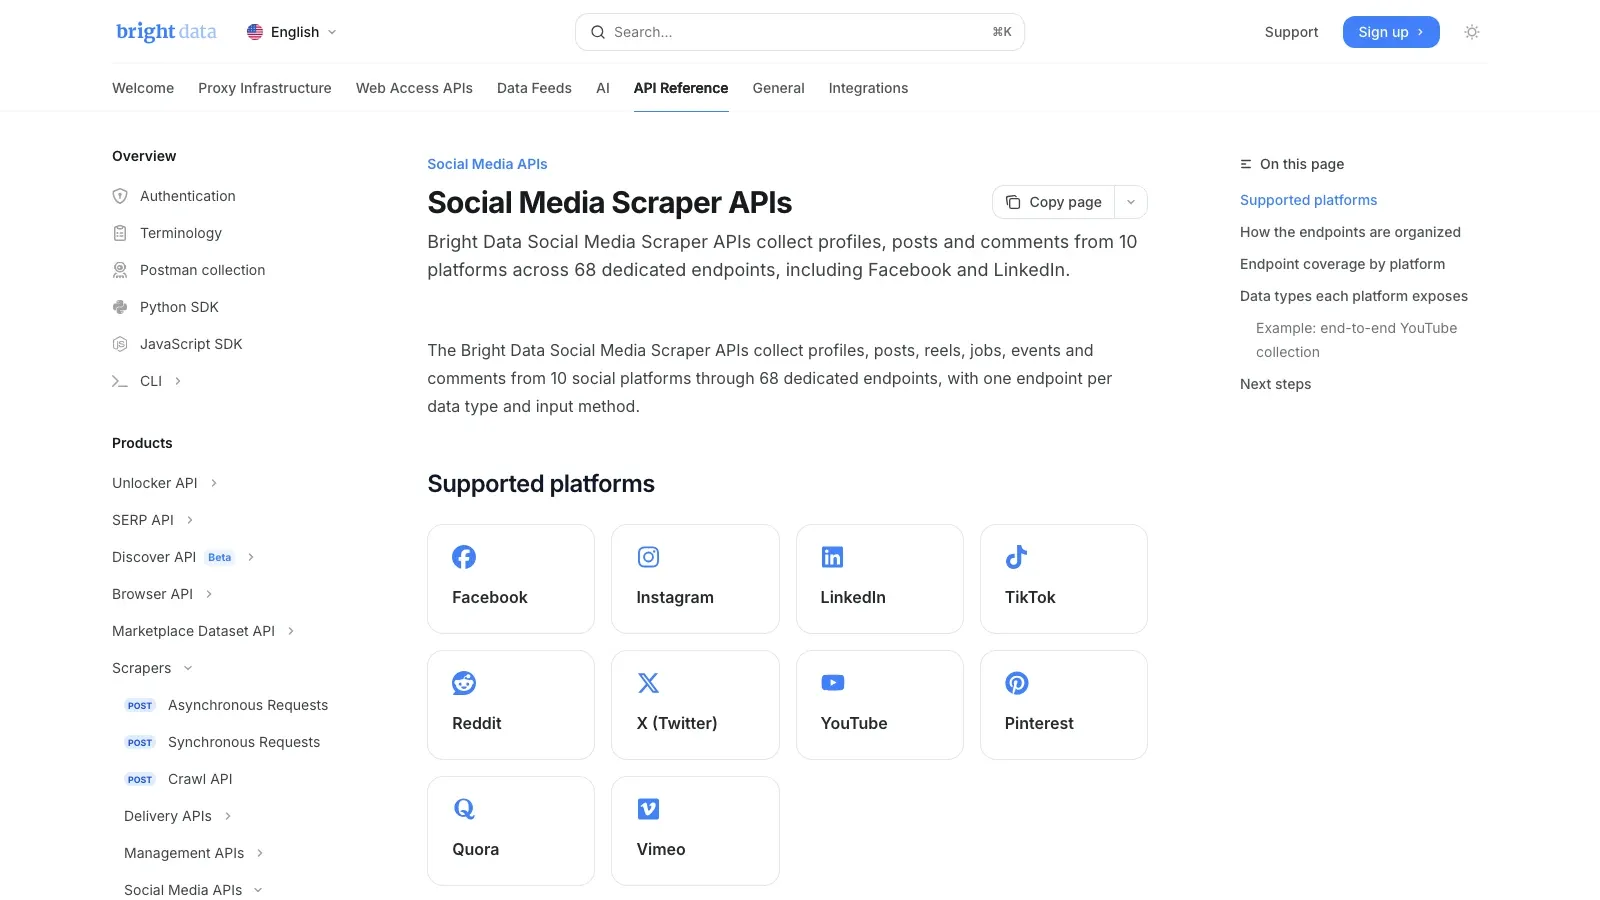
Bright Data 是最偏基础设施优先的选择。Bright Data 自己的文档说明,其 Social Media Scraper APIs 覆盖 10 个平台和 68 个专用端点,其中就包括 Facebook。如果你的任务是大规模公开数据采集,那么这种托管式 API 方案,通常比浏览器插件或手工拼接的爬虫更现实。
它入选榜单的原因:
- 专门的社交媒体抓取端点
- 托管式解封与提取能力
- 适合数据管道的结构化输出交付
- 更适合对稳定性要求高的监测与分析任务
最适合: 分析师、数据团队、大型监测项目,以及大规模公开社交数据集。
价格信号: 价格会根据产品和用量而变化。请以 Bright Data 当前价格 为准。
2. Apify
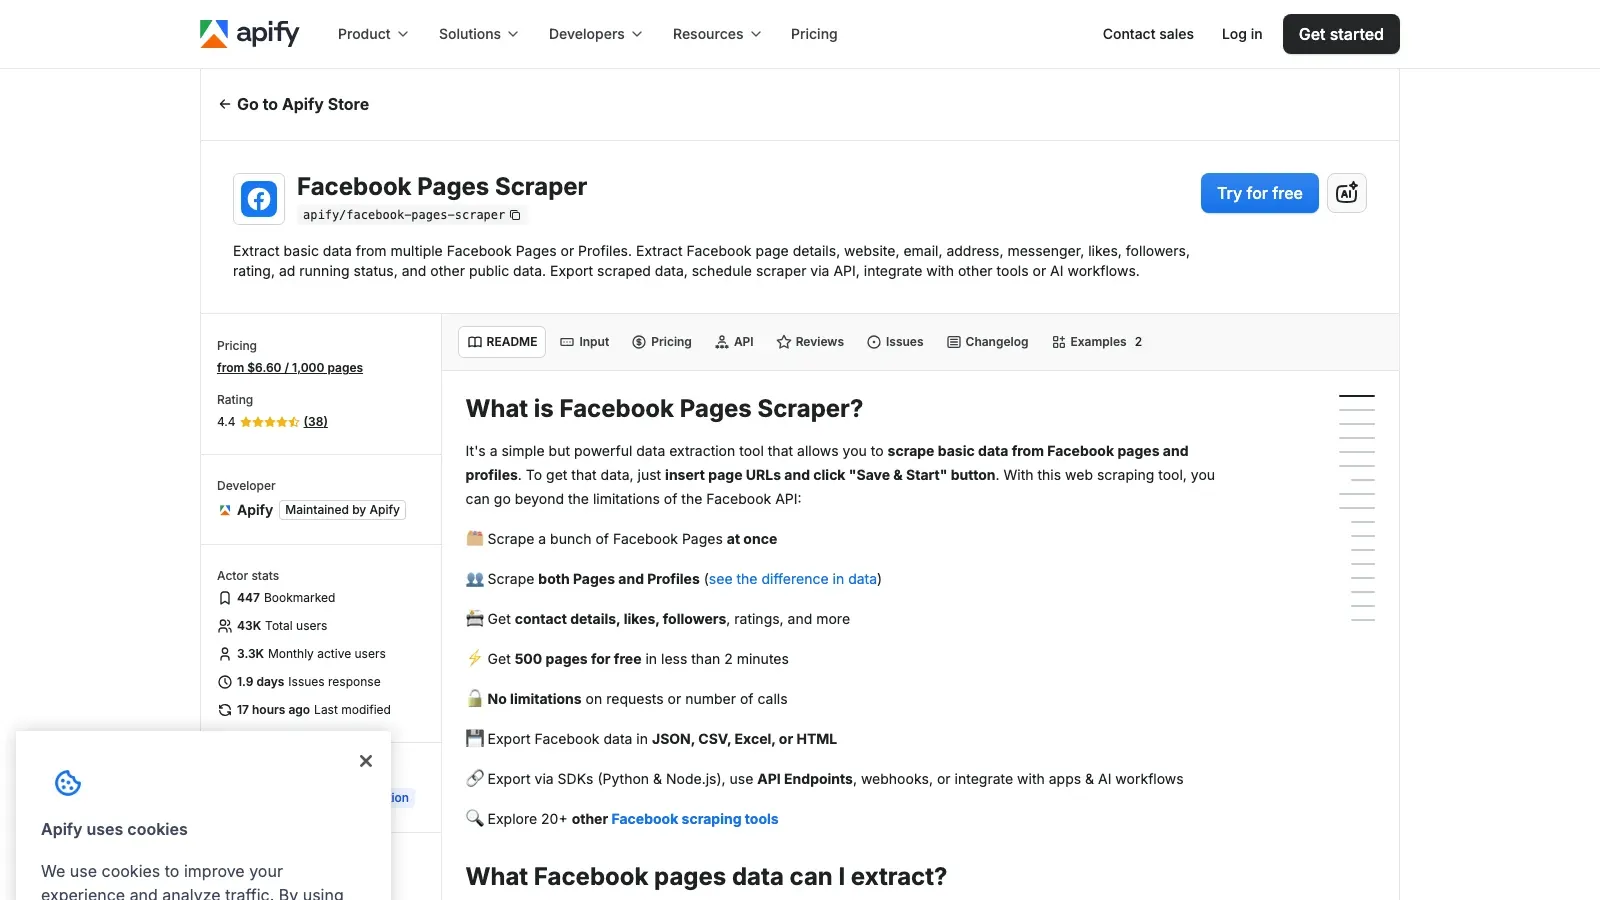
Apify 之所以依然重要,是因为它在模板化和完全自定义之间提供了一个很好的平衡点。它的 Facebook Pages Scraper actor 是一个不错的起点,而整个 Apify 平台还提供云端运行、定时任务、API,以及在需求变复杂时继续扩展工作流的空间。
它入选的原因:
- 现成的 Facebook actors
- 云端执行与循环调度
- 灵活导出与 API 访问
- 比纯无代码浏览器流程更容易扩展
最适合: 技术型营销人员、代理机构、运营团队,以及跨多个站点的周期性采集任务。
价格信号: 平台套餐为付费制,actor 用量另行计费。查看 Apify 价格页。
3. Nimble by Nimbleway
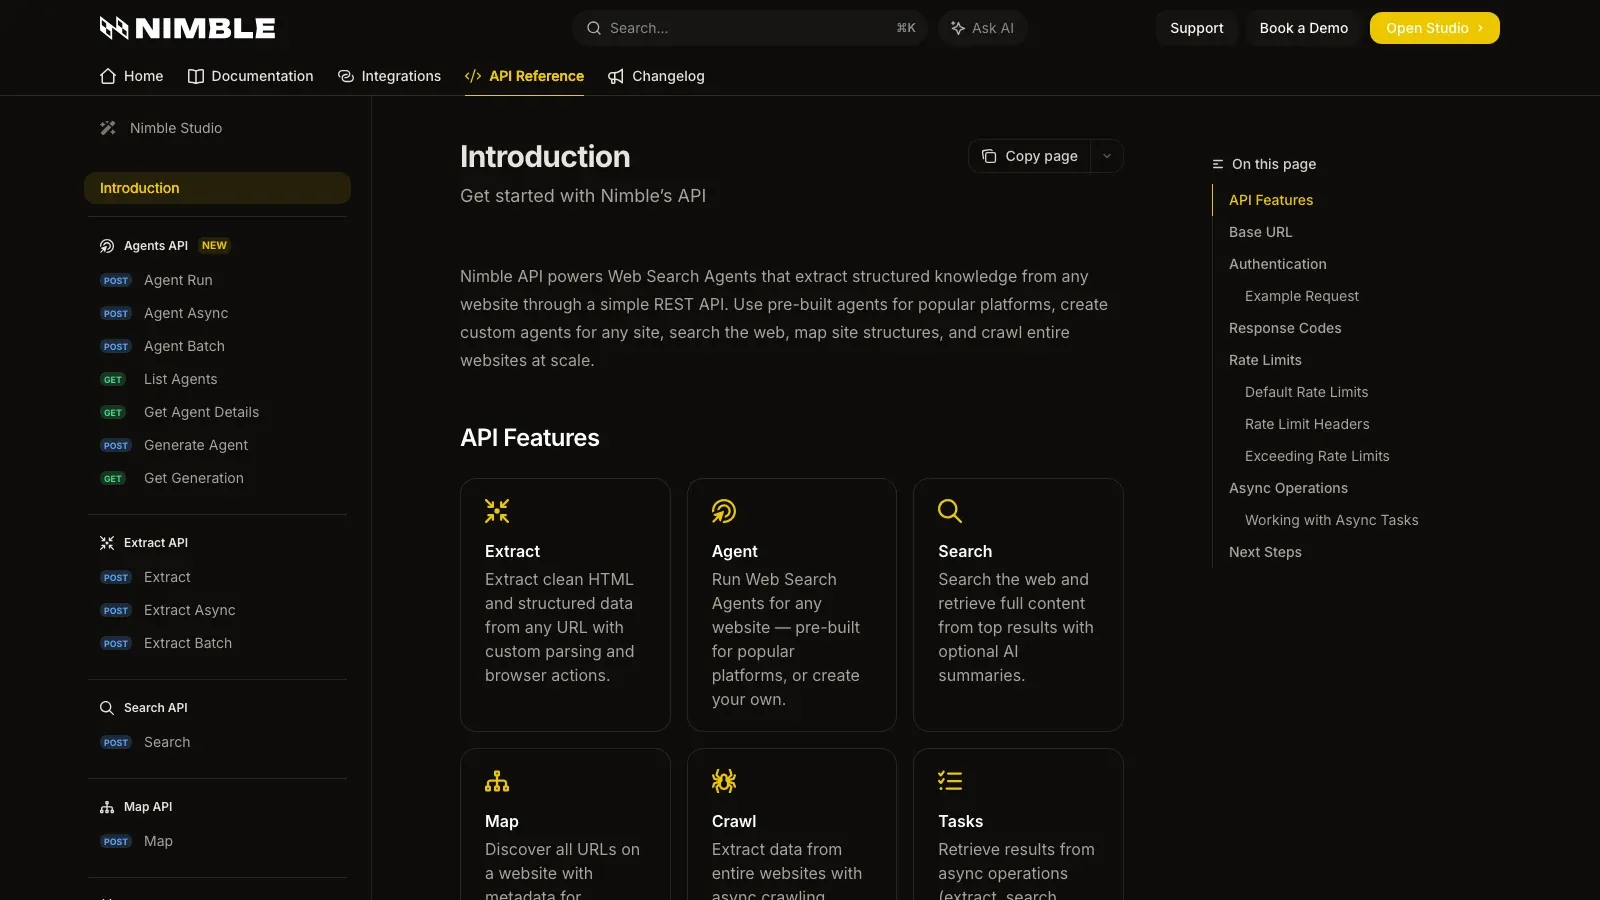
Nimble by Nimbleway 是偏 API-first 的方案,适合那些只想提交一个 URL,然后让平台负责访问、渲染和交付的团队。Nimble 将其 Web Scraper API 定位为端到端的公开网页数据采集工具,这意味着当 Facebook 爬取只是更大数据栈中的一环时,它会特别有用。
值得评估的原因:
- 以 URL 为起点的 API 工作流
- 减少工程团队维护爬虫的负担
- 适合稳健的公开网页提取
- 适合把抓取数据供给内部产品或仪表盘
最适合: 由工程团队主导的项目、产品数据管道,以及希望用基础设施抽象而不是单点工具的组织。
价格信号: Nimble 在核心 API 页面上并不强调公开自助定价,因此更可能采用销售驱动报价,建议直接向 Nimble by Nimbleway 咨询确认。
4. ScrapingBot
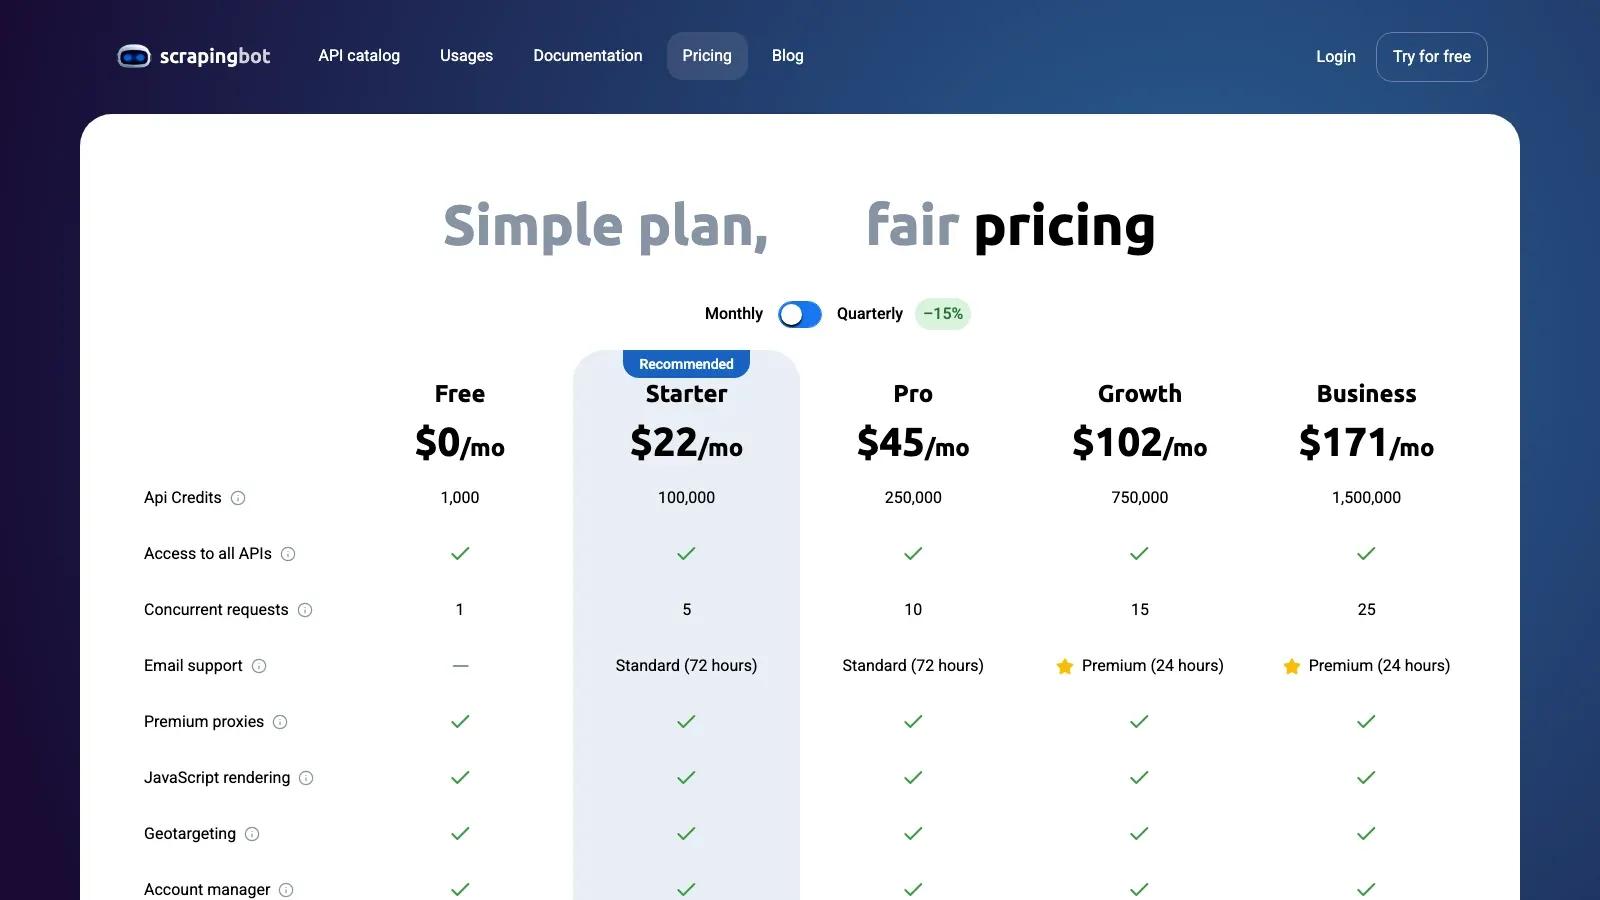
ScrapingBot 是这份榜单里更看重预算的 API 选项。它未必是这里最深入的 Facebook 专项平台,但对于规模较小的公开数据任务来说,它依然很有意义,因为你可以用 API、渲染支持,并且以比企业级抓取基础设施更低的成本起步。
适用场景:
- 简单的 API 驱动公开抓取
- 更低的入门价格
- 内置渲染与代理处理
- 比大型情报项目更适合原型验证和轻量周期采集
最适合: 初创公司、中小企业,以及测试轻量公开页面采集场景的开发者。
价格信号: 提供免费套餐;当前公开价格页显示,付费计划大约从 每月 22 美元 起。
5. PhantomBuster
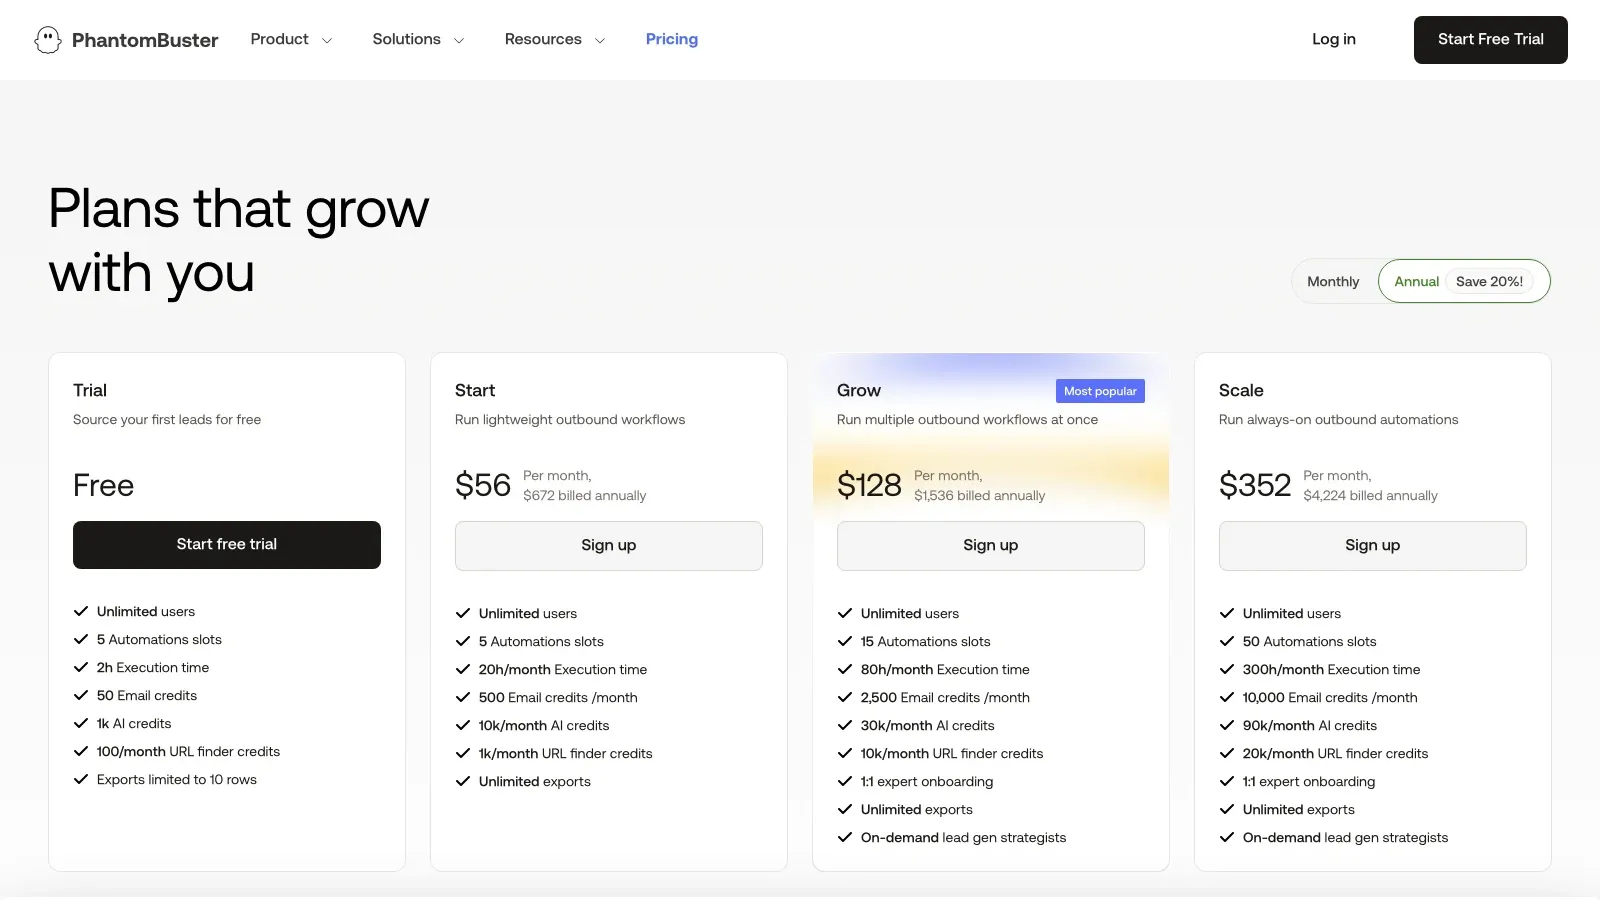
PhantomBuster 的重点不只是原始抓取基础设施,而是采集之后会发生什么。如果你的需求是“先把数据抓下来,再触发外联、补全信息或后续动作”,那么 PhantomBuster 往往比纯粹的提取器更实用,因为它就是围绕云端自动化和浏览器动作工作流设计的。
团队仍然会把它列入候选的原因:
- 基于云的自动化工作流
- 适合线索开发和 GTM 运营
- 当爬取只是更大流程中的一步时更合适
- 对在意动作而不仅仅是导出的运营人员很实用
最适合: GTM 团队、增长团队、招聘团队,以及需要把采集结果串到下游动作中的运营人员。
价格信号: 提供免费试用;当前价格页显示,付费计划大约从 每月 56 美元 起。
6. Octoparse
Octoparse 仍然是比较优秀的无代码可视化抓取工具之一,适合想要可重复工作流和定时云端运行的用户。它让非开发人员能更明确地控制提取逻辑如何构建和重复执行,不过也意味着它的前期设置会比轻量的一次性流程更多。
它依然有价值的原因:
- 点选式可视化工作流构建器
- 云端提取与调度
- 适合结构化、可重复任务
- 更适合希望不用写代码也能保持可复现性的分析师
最适合: 非技术型分析师、中小企业运营团队,以及需要更明确工作流逻辑的重复采集任务。
价格信号: Octoparse 的公开价格页显示,付费计划从 Standard 方案每月约 69 美元,按年计费 起。
按团队类型的推荐
- API 优先的工作流: Bright Data 或 Apify
- 由工程团队主导的公开网页评估: Nimble 或 ScrapingBot
- 由账号持有者主导的线索开发流程: PhantomBuster
- 可视化、可编辑的工作流: Octoparse
在选择任何方案之前,先测试你团队被允许使用的具体页面类型和字段。Facebook 在 Pages、Profiles、Marketplace、Groups、地理位置以及账号状态之间,能看到的内容并不一样。
最终结论
正确的路径取决于数据本身、访问方式,以及团队对验证工作的责任。对于你自己管理的资产,应该先从官方 Meta 工具和已获批准的 API 入手。对于超出该范围的研究,只有在确认页面类型、允许用途、隐私义务和当前产品行为之后,才应该选择相应的供应商或数据源。
常见问题
非技术用户应该先考虑哪种方式?
如果是你所在组织管理的资产,先用 Meta 自己的管理和分析工具。如果是更广泛的研究需求,先找一个你能评估其工作流和数据使用权的允许来源。
哪种方案最适合软件集成或数据管道集成?
可以评估像 Bright Data 这样的 Facebook 专项 API,像 Apify 这样的 actor 平台,或者通过限定范围测试具体目标来评估通用公开网页 API。
这些工具能绕过 Facebook 的访问限制吗?
不能。不要使用任何工具去绕过平台控制、登录墙或隐私保护。




