
如今,网络对数据的渴求前所未有。到了 2026 年,Node.js 已经成了那些想“更聪明地抓数据,而不是更辛苦地埋头干”的团队首选。无论你是做销售、电商,还是像我一样只是个数据控,你大概率都已经发现,网页爬虫早就不只是“把东西抓下来”这么简单了——重点在于抓得快、抓得多,而且还不能把自己的 IP 送进数字监狱。需求也没有放缓的迹象——公开网页数据早已悄悄成为现代团队构建一切的基础输入,从价格情报到 LLM 训练流水线,竞争和门槛都比以往更高。
但问题在于:现代网页就像一座堡垒,动态内容、反爬陷阱、页面结构变化层出不穷。我见过太多网页爬虫“出师未捷身先死”——通常就是因为忽略了最佳实践,或者低估了反爬手段到底有多聪明。所以,今天我们就来聊聊 Node.js 网页爬虫提效的实战最佳实践,穿插一些真实经验、轻松吐槽,以及一堆能直接上手的建议。
为什么选择 Node.js 做网页爬虫提效?
如果你曾经一次要抓几百甚至几千个页面,就会知道速度和并发有多重要。Node.js 的优势就在这里。它的异步、非阻塞 I/O 模型天生就是为处理海量并发网络请求而设计的——可以把它想象成网页世界里的终极多线程选手(Node.js Docs)。其他语言可能会卡在等待每个请求返回,Node.js 却能继续转动事件循环,一边接一边处理请求,就像一位喝了咖啡的马戏团杂技演员。
我见过 Node.js 在需要实时更新和大规模抓取的场景里,表现超过 Python 和 Java,尤其是目标网站大量依赖 JavaScript 渲染时。事实上,约 40% 的开发者 现在都在用 Node.js 处理后端和自动化任务,这也让它成为全球最受欢迎的网页技术之一。
Node.js 与其他网页爬虫框架对比
我们稍微“硬核”一点,看看 Node.js 和其他方案相比怎么样:
| 框架 | 优势 | 劣势 | 适用场景 |
|---|---|---|---|
| Node.js | 异步、并发能力强、npm 生态庞大、原生支持 JS,适合动态网站 | 可能比较吃内存;如果不用 async/await,容易陷入回调地狱 | 实时抓取、JS 重度网站、可扩展微服务 |
| Python | 抓取库很多(BeautifulSoup、Scrapy),语法简单 | 大规模并发时速度偏慢;处理 JS 渲染站点比较吃力 | 静态 HTML、研究、原型验证 |
| Java | 类型系统强,适合企业级开发 | 代码偏冗长,不太适合快速写脚本 | 大规模、企业级抓取 |
| Go | 速度快,并发效率高 | 生态较小,上手曲线更陡 | 高性能、低延迟抓取 |
对大多数业务用户来说,Node.js 正好踩在那个平衡点上:速度快、够灵活,而且非常适配当下这个 JavaScript 驱动的网页环境(Thunderbit Blog)。
搭建稳定的 Node.js 网页爬虫环境
一个好网页爬虫,先得有稳的基础设施。下面是我常用的配置思路:
- 项目结构: 尽量模块化。使用
/src、/libs、/config这类目录。把 API 密钥、代理等敏感信息放进环境变量里,用dotenv管理(Thunderbit Guide)。 - HTTP 客户端: 请求可以用 axios、got 或 node-fetch。
- HTML 解析: 静态 HTML 用 Cheerio,动态内容则用 Puppeteer 或 Playwright。
- 工具库: 用 Lodash 处理数据,用 validator.js 或 Joi 做数据校验。
- 测试与代码规范: 测试用 Mocha,代码质量用 ESLint(LogRocket)。
必备的 Node.js 网页爬虫库
- HTTP 客户端(axios / got / 原生
fetch): 用于发起请求。先提醒一句:从 Node.js v18 开始,你就可以原生使用fetch,无需额外安装;到了 Node.js v22,它已经正式稳定。对于基于较新 Node 版本的新项目,其实大概率不需要node-fetch,直接调用fetch就行。我个人在需要拦截器、自动 JSON 处理,以及希望 Node 和浏览器都保持一致的 promise API 时,会更常用 axios;而当我需要内置重试、流式处理或 HTTP/2 时,就会选 got。选哪个都行,按你的技术栈来;如果只是写个小脚本,原生fetch完全够用。 - Cheerio: 速度很快,语法像 jQuery 的 HTML 解析器。非常适合静态页面——解析通常只要约 0.5 秒(Oxylabs)。
- Playwright / Puppeteer: 用于无头浏览器自动化,适合动态、JS 重度的网站。速度相对慢一些(每页约 4 秒),但对页面加载后才渲染内容的网站非常必要(Bright Data)。如果你是 2026 年才开始新项目,Playwright 通常是默认首选——原生跨浏览器支持(Chromium / Firefox / WebKit)、自带 trace viewer,而且最初打造 Puppeteer 的团队现在也在微软继续推进它。Puppeteer 当然还在维护,适合只做 Chrome 相关工作,但这段时间的更新更多偏向 Chrome 兼容修复,而不是新增能力。
- dotenv: 管理环境变量。
- csv-writer/jsonfile: 导出数据用。
避免常见的 Node.js 网页爬虫坑
我已经数不清有多少次看到网页爬虫被封、崩溃,或者干脆吐出一堆乱七八糟的数据。下面这些点一定要注意:
- 忽略 robots.txt 和服务条款: 抓取前一定先看清楚。违反规则可能会让你的 IP 被封,严重时还会惹上法律麻烦(ScraperAPI)。
- 压垮服务器: 不要疯狂轰请求。给网页爬虫加随机延迟(1–3 秒)、设置并发控制,别像个过度活跃的机器人一样乱冲(ScrapeGraphAI)。
- 不处理错误: 请求一定要包在 try/catch 里,处理 HTTP 错误并记录失败。对临时性错误使用指数退避重试(ScrapeGraphAI)。
- 忘记请求头: 使用真实感更强的 User-Agent,并定期轮换。再加上 Accept-Language、Referer 等头部信息,尽量模拟真实浏览器(ScrapeGraphAI)。
如何绕过反爬机制
现代网站几乎都装上了全套反机器人技术。下面是我通常用来避开这些“数字地雷”的办法:
- 轮换代理 / IP: 使用代理池,定期切换 IP,避免被封(Medium)。
- 随机化请求头: 每次请求都轮换 User-Agent、Accept-Language 等头部。
- 无头浏览器隐身: 使用
puppeteer-extra-plugin-stealth之类的插件隐藏自动化特征。 - 模拟人类行为: 加随机延迟、鼠标移动、滚动,甚至故意打错字(ZenRows)。
在 Node.js 爬虫中模拟人类行为
这里就开始有点“好玩”也有点“离谱”了。不要一上来就瞬间点击和滚动,而是让你的网页爬虫这样做:
- 在每个动作之间随机等待一段时间(
await page.waitForTimeout(randomDelay)) - 让鼠标小幅、抖动式移动(
page.mouse.move(x, y)) - 输入时加入随机延迟,偶尔故意输错字(
page.type(selector, text, {delay: random(100,200)})) - 不要只是一口气滚到底,而是非均匀地滚动页面
这些技巧在受保护网站上,能明显提高成功率(ScraperAPI)。
用 Thunderbit 简化复杂数据提取
使用 AI 从任何网站抓取数据 跳过样板代码:Thunderbit 的智能网页爬虫可读取任意页面,一键提取数据,无需维护 Node.js 代码。 Get Started Free
现在来说说大家心里都明白的事:网页爬虫很难。但它也可以没那么难。这也是我们打造 Thunderbit 的原因。
Thunderbit 是一款智能网页爬虫 Chrome 扩展,你可以用自然语言从任意网站提取数据。只要点一下“One Click Extract”,让 AI 自己判断页面内容,再点击“Scrape”即可。它就像一个不会睡觉、也从不涨工资的初级开发。
更棒的是,Thunderbit 还提供 API,你可以直接接入自己的 Node.js 工作流。你不必再写成千上万行网页爬虫代码,而是把动态内容、子页面、分页这些繁琐工作交给 Thunderbit。你只需要拿到结构化数据(CSV、JSON,或者直接同步到 Google Sheets、Airtable、Notion),然后继续忙你的事(Thunderbit Blog)。
免费试用 Thunderbit Chrome 扩展 安装免费 Chrome 扩展,一键提取结构化数据——或者在你的 Node.js 应用中直接调用 Thunderbit API。 Get Started Free
Thunderbit vs. 传统 Node.js 爬虫
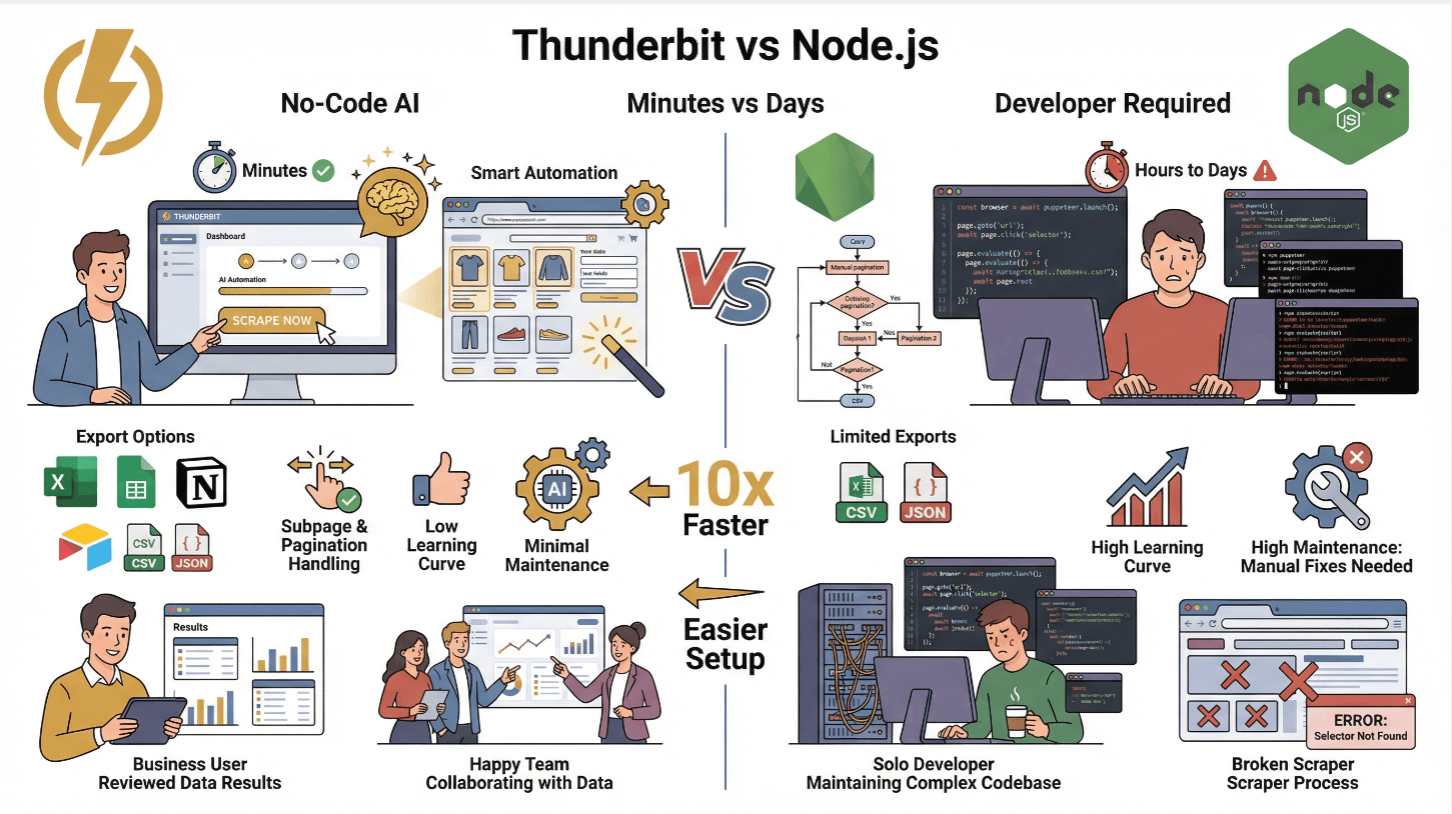
| 功能 | Thunderbit | 传统 Node.js 爬虫 |
|---|---|---|
| 搭建时间 | 几分钟(无需写代码) | 几小时到几天(编码、测试) |
| 支持动态内容 | 支持(AI + 浏览器) | 支持(需 Puppeteer/Playwright) |
| 子页面与分页 | 一键处理 | 需手动编写代码 |
| 数据导出 | Excel、Sheets、Notion、Airtable、CSV、JSON | CSV/JSON(自定义代码) |
| 学习门槛 | 低(业务用户可用) | 高(开发者) |
| 维护成本 | 很低(AI 可自适应) | 较高(页面变化需手动修复) |
Thunderbit 非常适合非技术团队,或者任何想跳过繁琐工作、直接专注洞察的人。对于高级用户,你也可以通过 Thunderbit 的 API 来实现大规模自动化抓取(Thunderbit Docs)。
结合 Cheerio 和 Puppeteer 处理动态内容
这是我最喜欢的一套 Node.js 网页爬虫组合拳。流程是这样的:
- 先用 Puppeteer 打开页面并执行 JavaScript(等待
networkidle,确保内容都加载完成)。 - 获取 HTML:使用
await page.content()把页面 HTML 抓下来。 - 交给 Cheerio 解析:把 HTML 喂给 Cheerio,使用超快的、类似 jQuery 的方式做解析和数据提取。
这种混合方案能兼顾两边的优点:Puppeteer 负责动态内容,Cheerio 负责快速解析(Browserless)。
性能建议: 只选你真正需要的元素。Cheerio 会把整个 DOM 加载进内存,所以别用太宽泛的选择器;如果你会反复抓同一批页面,记得缓存结果(Oxylabs)。
优化 HTML 解析和数据提取
- 使用更精准的选择器: 不要写
$('body *')这种全覆盖写法,尽量只定位目标内容。 - 流式处理大页面: 对于超大的 HTML,可以考虑流式处理,或者把任务拆分开。
- 缓存渲染后的 HTML: 如果你会重复访问同一 URL,缓存页面 HTML 可避免重复请求。
- 校验并清洗数据: 用验证库确保你不会把垃圾数据塞进数据库(ScrapeGraphAI)。
在云端部署可扩展的 Node.js 爬虫
要做大规模抓取?那就该上云了。
- 把网页爬虫容器化: 编写
Dockerfile,复制代码、安装依赖、设置入口命令。 - 部署到云端: 简单任务可以用 AWS EC2、Google Cloud Compute 或 Azure VM。若要真正扩展到更大规模,可以上 Kubernetes,或者使用 AWS ECS/EKS、Google Cloud Run、Azure Kubernetes Service 等托管服务(DigitalOcean)。
- 用 Kubernetes 进行编排: 运行多个 Pod,根据需求自动扩缩容,并用负载均衡分发 URL。
- 定时执行任务: 使用云端调度器(CloudWatch Events、Cloud Scheduler)或 cron 定时触发抓取。
在一个真实案例里,把 Kubernetes Pod 从 5 个扩到 10 个后,原本需要几分钟才能完成的 400 页抓取,缩短到了不到 1 分钟(DigitalOcean)。
监控与自动扩容你的抓取基础设施
- 日志监控: 将日志发送到 CloudWatch、Stackdriver 或 Datadog,并为错误或性能下降设置告警。
- 健康检查: 使用 Prometheus 和 Grafana 监控每分钟抓取页数、错误率、Pod 健康状况等指标。
- 自动扩容: 配置 Kubernetes HPA(Horizontal Pod Autoscaler),根据 CPU 或请求数自动扩缩容。
同时一定要加入指数退避重试机制,方便在网络波动或临时封禁时自动恢复。
数据存储与后处理最佳实践
抓到数据之后,接下来就要存储和清洗:
- 小规模任务: 导出为 CSV、JSON,或者同步到 Google Sheets、Airtable、Notion(Thunderbit 开箱即用)。
- 大规模任务: 结构化数据用 SQL(MySQL/PostgreSQL),半结构化或 schema 会变化的数据则用 NoSQL(MongoDB、DynamoDB)(ScrapeHero)。
- 云存储: 原始文件和备份可放在 S3 或 Google Cloud Storage。
- 数据清洗: 一定要校验字段、统一格式(日期、数字),并去重。使用 schema 验证器来保证数据质量(ScrapeGraphAI)。
原始数据和清洗后的数据都要保留——因为你永远不知道什么时候需要重新处理,或者排查问题。
结论:Node.js 网页爬虫提效的关键要点
跳过网页爬虫代码 了解 Thunderbit 的智能网页爬虫,和自己编写并维护爬虫脚本相比到底有何不同。 Get Started Free
最后,我们来快速总结一下重点:
- 发挥 Node.js 的异步能力,实现大规模并发抓取——尤其适合 JS 重度网站。
- 组合合适的工具: 请求用 axios/got,静态 HTML 用 Cheerio,动态内容用 Puppeteer,并按需混合使用,兼顾速度与灵活性。
- 避开反爬陷阱: 轮换代理和请求头,模拟人类行为,并尊重 robots.txt。
- 用 Thunderbit 简化流程: 对业务用户或快速原型来说,Thunderbit 可以用 AI 把复杂数据提取出来,并通过 API 接入你的 Node.js 技术栈。
- 规模化部署: 容器化、Kubernetes 编排,并做好监控,确保稳定可靠。
- 存储并清洗数据: 根据场景选择合适的存储方式,并在使用前始终做好校验。
互联网不会变得更简单,但只要掌握这些最佳实践,你的 Node.js 网页爬虫就能保持高速、稳定,并在这场反爬军备竞赛中始终领先一步。如果你哪天凌晨两点还在调 selector,记住:Thunderbit 的 AI 一直在线。
想继续深入学习?欢迎查看 Thunderbit Blog 获取更多深度内容,或者试试 Thunderbit Chrome 扩展,亲自感受抓取可以有多简单。
使用 Thunderbit 智能网页爬虫抓取 Thunderbit 的网页爬虫 API 支持你直接在自己的 Node.js 代码中触发提取,而且提供免费额度供你起步。 Get Started Free
常见问题
1. 为什么 Node.js 在 2025 年特别适合网页爬虫?
Node.js 的异步、事件驱动模型让它可以同时处理成千上万的并发请求,因此特别适合抓取海量数据或实时更新。其庞大的 npm 生态和原生 JavaScript 支持,也非常适合现代的 JS 重度网站(Node.js Docs)。
2. 用 Node.js 抓取时,怎么避免被封?
使用轮换代理、随机化请求头、通过随机延迟控制请求频率,并借助 Puppeteer 等工具模拟人类行为(鼠标移动、滚动、打字)。同时一定要遵守 robots.txt 和网站条款(Medium)。
3. 在 Node.js 爬虫里,什么时候用 Cheerio,什么时候用 Puppeteer?
如果是静态 HTML,而且数据本身就在原始页面里,用 Cheerio 最快。如果网站内容依赖 JavaScript 动态加载,就用 Puppeteer。最好的做法是先用 Puppeteer 渲染页面,再用 Cheerio 解析 HTML(Bright Data)。
4. Thunderbit 如何简化 Node.js 网页爬虫?
Thunderbit 允许你通过 AI 和自然语言提示词从任意网站提取结构化数据——无需写代码。它能处理动态内容、子页面和分页,并提供 API 方便接入 Node.js。数据还可以直接导出到 Excel、Google Sheets、Airtable 或 Notion(Thunderbit Blog)。
5. 在云端扩展和监控 Node.js 爬虫的最佳方式是什么?
把网页爬虫容器化,部署到 Kubernetes 或托管云服务上,并通过自动扩缩容应对流量高峰。使用 CloudWatch 或 Prometheus 监控日志和指标,并为错误或性能下降设置告警(DigitalOcean)。
准备好升级你的网页爬虫能力了吗?试试 Thunderbit,让你的网页爬虫又快、又稳、又隐蔽,始终领先一步。
试用智能网页爬虫 Get Started Free
了解更多




