
以前,一提到网页爬虫,很多人都会觉得那是黑客或资深程序员才会的技能,像是技术圈里的“暗号”。但到了 2026 年,它已经变成了一项必备能力:不管你是想更聪明地做业务决策、节省时间,还是单纯不想天天做复制粘贴这种特别耗精力的活,都能用得上。我亲眼见过销售团队、电商经理,甚至房地产经纪人都在用网页爬虫搭建潜在客户名单、监控竞争对手、收集洞察——而且全程不用写一行代码。
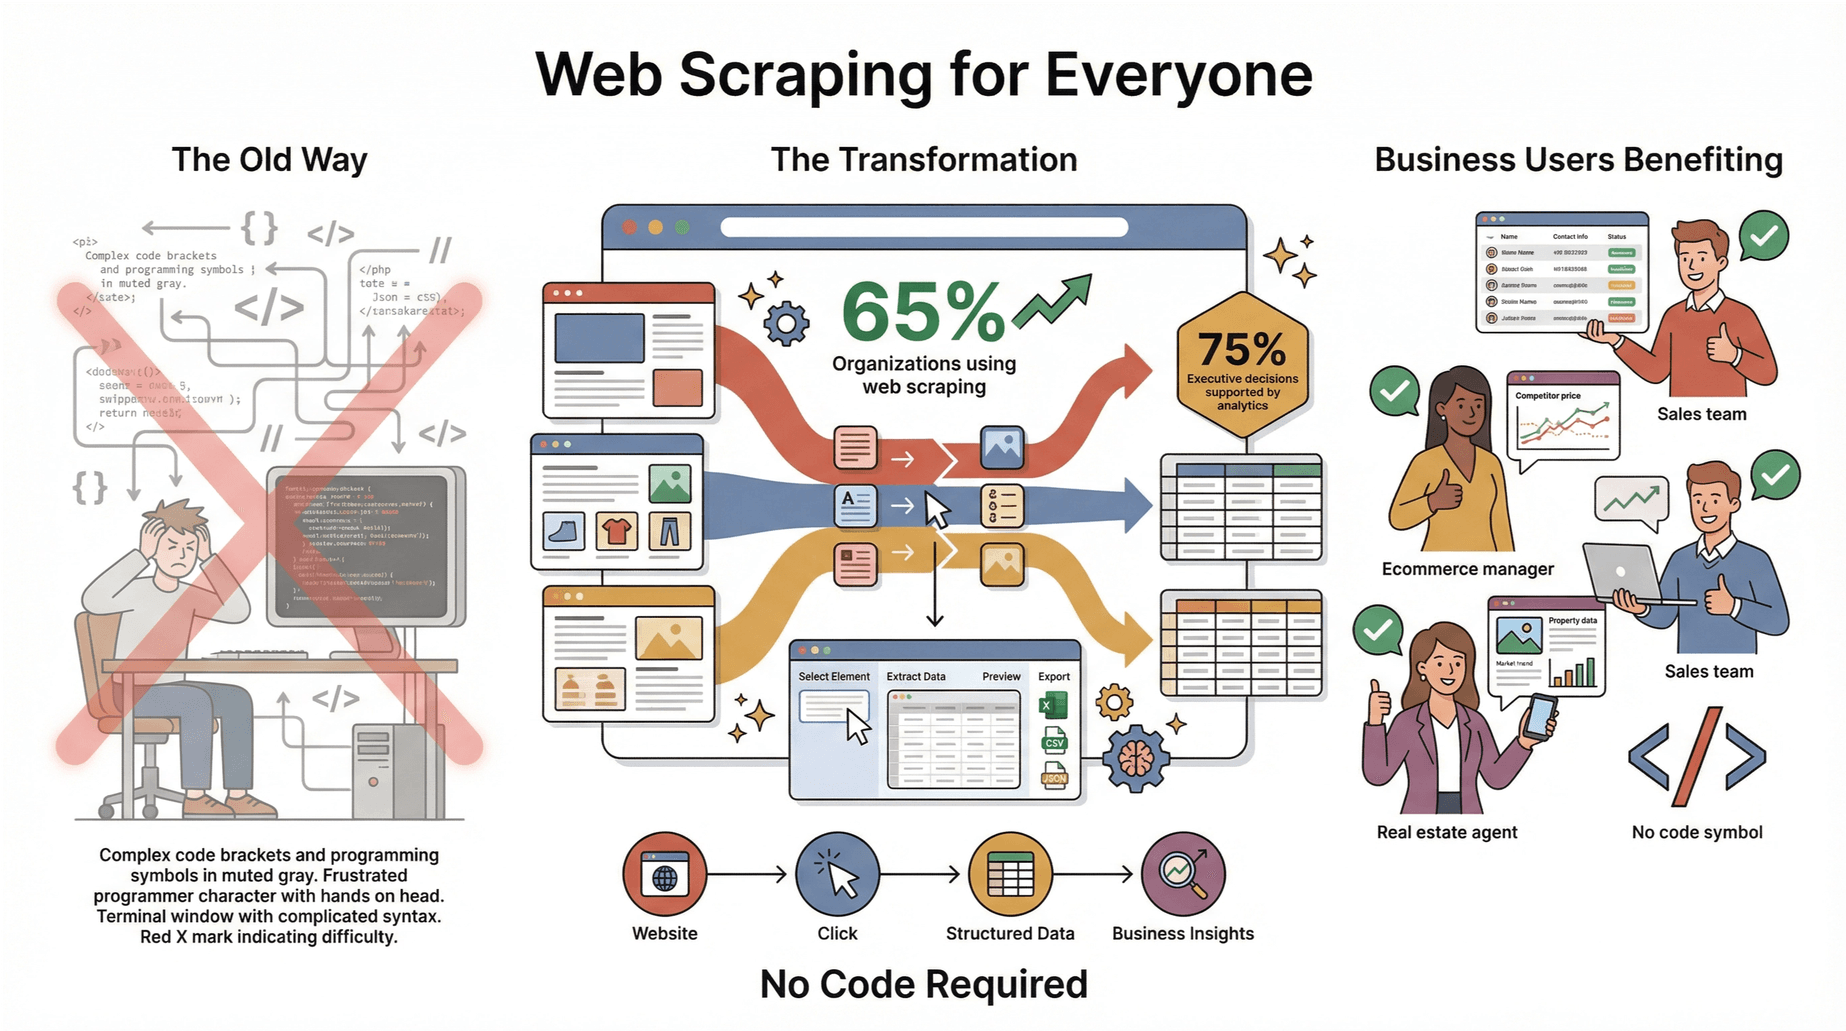
数据也印证了这一点:65% 的组织现在会用网页爬虫来支持 AI 项目和日常运营,而 LinkedIn 对 2024 年领导力的分析则预测,大约 75% 的高管决策都会由数据分析和自动化提供支持。最棒的是,借助 Thunderbit 这样的工具,网页爬虫现在对完全零基础的人也同样友好。所以,如果你想把网页变成自己的数据金矿——还不想被技术门槛折腾到头大——这篇指南就是为你准备的。
网页爬虫入门:关键术语与核心概念
先从基础讲起。如果你刚接触网页爬虫,会遇到一些听起来很技术化的词,其实拆开来看都很容易理解。
-
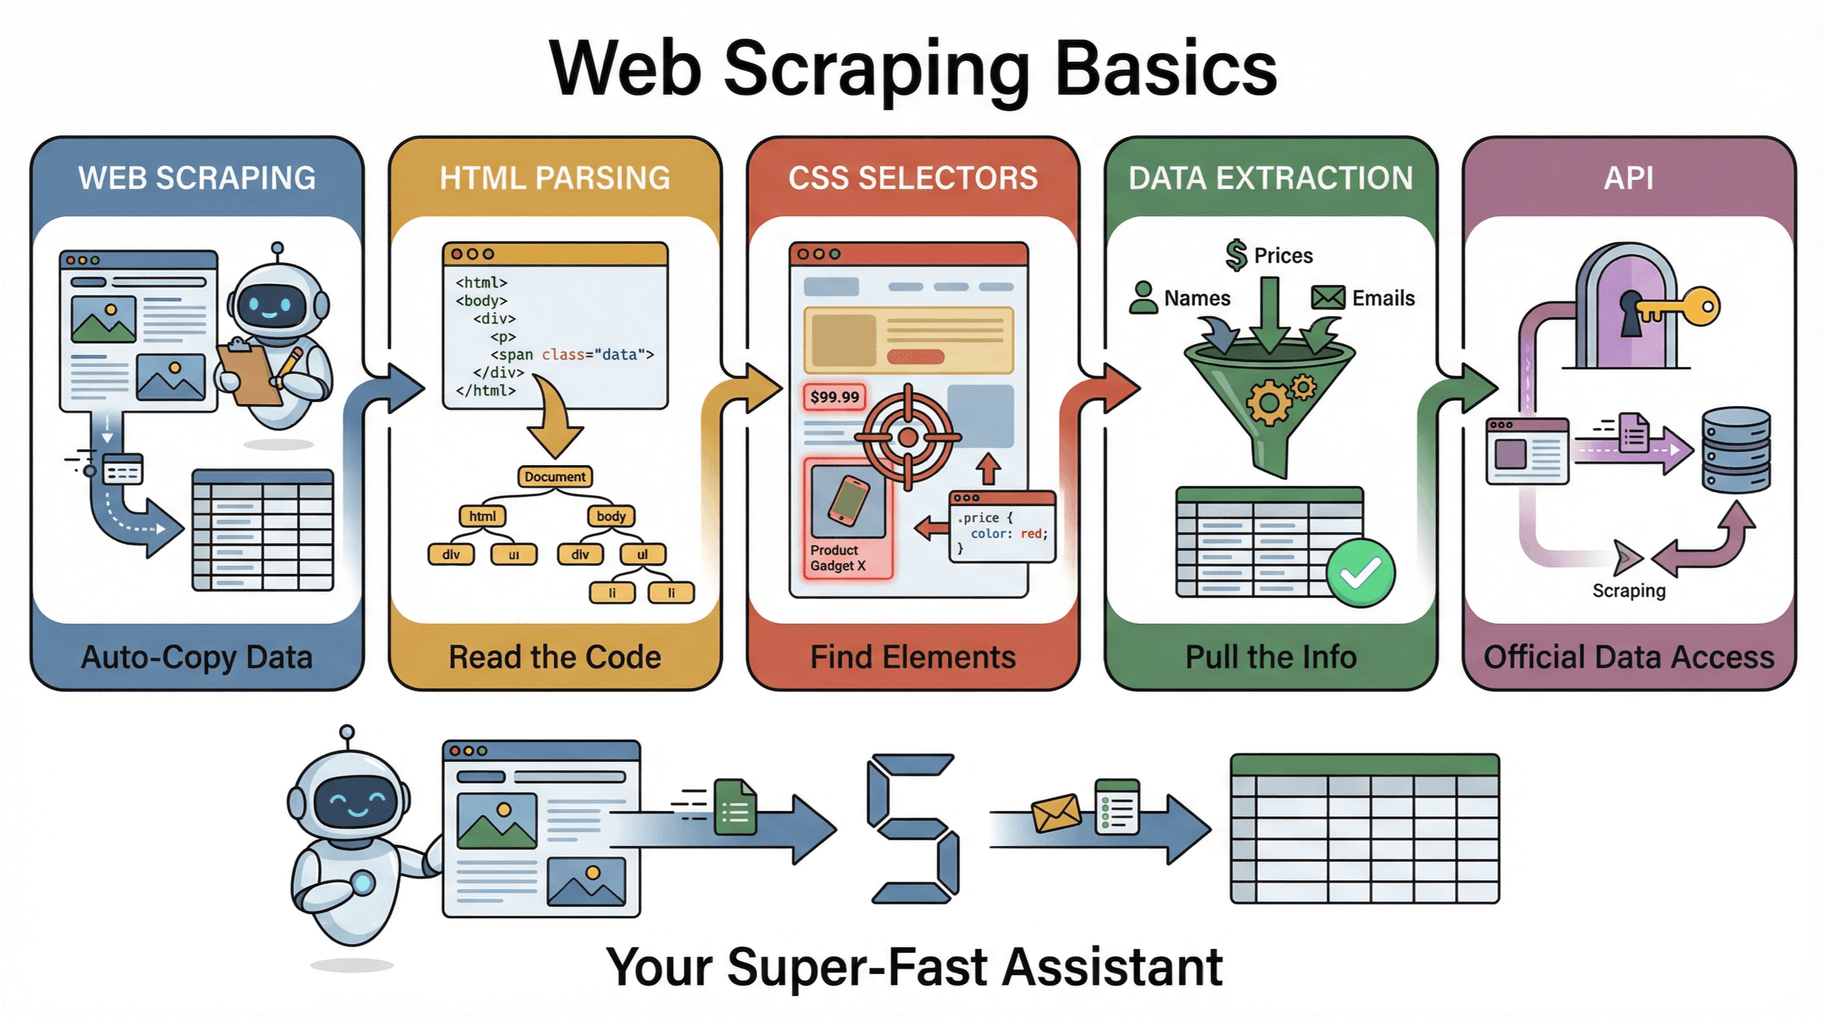
网页爬虫(Web Scraping):可以把它理解成用软件自动从网站上复制信息,并整理到电子表格或数据库里。相比手动复制粘贴,网页爬虫能在几分钟内完成原本要花好几个小时的工作 (Wikipedia)。
-
HTML 解析(HTML Parsing):每个网页都是用 HTML 构建的,也就是告诉浏览器该显示什么内容的代码。解析就是把这些代码读出来,并转成一张地图(叫做 DOM),这样爬虫才能找到你想要的数据 (Firecrawl)。
-
CSS 选择器(CSS Selectors):它们就像网页上的定位地址。比如你想抓取商品页里所有价格,CSS 选择器就能告诉爬虫精确该去哪里找(例如“找到所有 class 为 ‘price’ 的元素中的文本”)。
-
数据提取(Data Extraction):这是最终目的,也就是把你关心的信息(姓名、价格、邮箱等)提取出来,并放进可直接使用的结构化格式中。
-
API(应用程序编程接口):有些网站会提供官方方式来获取数据,也就是 API。如果网站有 API,通常比直接抓 HTML 更简单、更稳定。但并不是所有网站都有 API,这也是网页爬虫这么流行的原因之一 (Initial Data Offering)。
一句话理解: 网页爬虫就像派一个超高速助手去网站上帮你找信息,然后把内容整整齐齐地抄进表格里——完全不用你手动操作。
为什么网页爬虫对新手很重要
什么是数据抓取,以及 2025 年如何上手 Get Started Free
如果你不是开发者,为什么还要学网页爬虫?因为它能大幅节省时间,也是商业用户的一项竞争优势。下面是一些真实场景:
| 应用场景 | 商业价值 |
|---|---|
| 线索挖掘(销售) | 几分钟内从名录或 LinkedIn 生成潜在客户名单,而不是耗费几个小时。 |
| 价格监控(电商) | 自动追踪竞争对手的价格和库存,并据此调整自己的定价,保持竞争力。 |
| 客户评价(营销) | 汇总多个网站的评价,洞察客户情绪并优化产品。 |
| 市场调研 | 持续监控行业新闻、招聘信息或竞争对手动态,获取战略洞察。 |
例如,BrowserCat 关于网页爬虫优势的汇总提到,一家英国零售商在使用竞争对手价格抓取后,销售额提升了约 4%,因为它能更快对价格变化做出反应。还有一份 被广泛引用的整理指出,数据驱动型公司拥有 19 倍更高的盈利能力,以及 52% 更好的客户理解能力(这些数字最早来自较早期的行业调查)。
归根结底,网页爬虫能帮你把重复、枯燥的工作自动化,让你更快做出更聪明的决策,把精力放在真正能推动业务增长的事情上。
避免常见网页爬虫错误:保持简单最重要
和新手交流时,我总会发现一些反复出现的错误。下面这些最常见,也最值得提前避开:
-
没有明确目标: 没有计划就直接上手,最后往往只会得到杂乱的数据和白白浪费的时间。开始前一定先想清楚,你需要什么数据,以及为什么要抓取它 (Infatica)。
-
一上来就抓太多: 想做大项目很正常,但第一次就抓几千个页面,通常只会让人崩溃。建议从小范围开始——先抓一个页面,确保流程正确,再逐步扩展。
-
数据重复或混乱: 新手经常会抓到重复条目,或者格式不统一的数据(比如价格有的写成“$1,299”,有的写成“1299 USD”)。建议边抓边检查重复项,并统一数据格式 (Medium)。
-
遗漏分页或子页面: 只抓列表第一页,结果漏掉后面的内容,这是最经典的新手失误之一。要确保你的工具能处理“下一页”按钮,并能继续跟进详情页链接。
-
忽视网站规则: 不查看网站的 robots.txt 或服务条款,轻则被封,重则惹来麻烦。务必尊重网站规则 (Dev.to)。
实用建议: 选用像 Thunderbit 这样对新手友好的工具,很多麻烦它都会替你处理掉。选对工具,能帮你省下大量时间,也能避开最常见的坑。
零代码网页爬虫:Thunderbit 为什么更简单
使用 AI 从任何网站抓取数据 Get Started Free
这些年我接触过很多网页爬虫工具,但 Thunderbit 是我第一个会推荐给非技术朋友和商业用户的工具。为什么?因为它就是为“只想要结果”的人设计的,不需要看懂一堆技术术语。
Thunderbit 的亮点包括:
-
两步 AI 抓取: 只要打开 Thunderbit Chrome 扩展程序,点击“AI Suggest Fields”,Thunderbit 的 AI 就会扫描页面并推荐最合适的提取字段(比如“商品名称”“价格”“评分”)。再点一下“Scrape”,就完成了。无需编程、无需选择器、也没有头疼的调试 (Thunderbit 博客)。
-
子页面抓取: 想要更详细的信息?Thunderbit 可以自动访问每个链接子页面(比如商品详情页),并把额外信息提取出来,一键加入表格中 (Thunderbit 博客)。
-
自动分页: Thunderbit 会自动处理“下一页”按钮和无限滚动,让你不会漏掉任何结果 (Thunderbit 博客)。
-
现成模板: 对 Amazon、Zillow 或 LinkedIn 这类热门网站,Thunderbit 提供了现成模板——选一个,点一下就能导出数据 (Thunderbit)。
-
免费导出数据: 结果可以直接导出到 Excel、Google Sheets、Airtable 或 Notion,无需额外付费,也没有限制 (Thunderbit)。
-
AI 数据清洗: Thunderbit 在抓取过程中就能帮你标注、格式化、翻译,甚至总结数据,让你的表格从一开始就可以直接使用 (Thunderbit)。
-
云端或浏览器抓取: 你可以选择云端模式来追求速度(一次最多 50 个页面),也可以用浏览器模式处理需要登录的网站。
它就像一个永远不累、从不抱怨、而且总能把数据格式整理得完美无缺的 AI 实习生。
逐步操作:用 Thunderbit 完成你的第一个网页爬虫项目
准备试试了吗?下面教你如何用 Thunderbit 完成第一次抓取,全程不需要编程。
-
安装 Thunderbit: 把 Thunderbit Chrome 扩展程序添加到浏览器中,并注册免费账户(每月可免费抓取 6 个页面,或在试用加成下获得 10 个页面)。
-
打开目标网站: 进入你想抓取的页面,例如房源列表、商品页或目录页。
-
打开 Thunderbit: 点击浏览器工具栏中的 Thunderbit 图标,侧边面板就会弹出。
-
点击“AI Suggest Fields”: Thunderbit 的 AI 会自动扫描页面,并推荐最适合提取的字段。你也可以按需编辑或新增字段。
-
点击“Scrape”: Thunderbit 会把页面数据提取出来——如果有多页,还会自动处理分页。
-
(可选)抓取子页面: 如果你还想获取每个条目的更多细节,点击“Scrape Subpages”。Thunderbit 会依次访问每个链接页面并提取额外信息。
-
导出数据: 点击“Export”,然后选择 Excel、Google Sheets、Airtable 或 Notion。数据就可以直接使用了。
-
检查结果: 快速浏览一下表格,确认内容是否正确。如果发现缺失或格式混乱的数据,可以调整字段后重新抓取。
就这么简单。你已经抓取了一个网站,而且一行代码都没写。
故障排查建议: 如果遇到问题,比如数据缺失或页面需要登录,可以尝试在云端模式和浏览器模式之间切换,或者检查网站布局是否发生变化。如果卡住了,Thunderbit 的 文档和支持团队都很有帮助。
网页爬虫新手需要注意的伦理与法律问题
在你准备大规模抓取网站之前,我们先聊聊规则。对于公开数据,网页爬虫通常是合法的,但仍然有一些重要边界必须遵守:
-
检查 robots.txt 和服务条款: 约有 60% 的网站明确禁止未经授权的抓取。请务必查看网站的 robots.txt 文件(只要在网址后加上
/robots.txt),并阅读服务条款。如果禁止抓取,就找官方 API,或者申请授权。 -
不要抓取个人或敏感数据: 除非这些信息是公开的,而且你有合理合法的用途,否则不要收集个人信息(如邮箱、电话号码等)。GDPR 和 CCPA 这类隐私法规不是闹着玩的。
-
不要重新发布受版权保护的内容: 抓取内容可用于分析或内部使用,但不要未经允许转载他人的文章或图片。
-
保持克制: 不要用过多请求压垮网站。尽可能加上延迟,并尽量在访问低峰时段抓取。
-
妥善保护数据: 如果你收集的是敏感商业信息,请安全存储,不要公开分享。
伦理抓取检查清单:
- 检查 robots.txt 和服务条款
- 避免抓取个人/私人数据
- 不要重新发布受版权保护的内容
- 控制请求频率
- 有 API 时优先使用 API
- 安全保存数据
只要遵守这些原则,你就能合法合规地使用网页爬虫,也能让整个网络环境对所有人都更友好 (Initial Data Offering)。
适合新手的网页爬虫策略:从小项目开始,逐步进阶
我给新手最重要的建议就是:先做一个小而稳的项目,再慢慢扩展。你可以按下面的顺序来:
-
先抓单页: 试着抓取一个商品列表或联系人列表。先熟悉工具和数据格式。
-
处理分页: 等你上手后,再把列表里的所有页面都抓下来(让 Thunderbit 帮你处理“下一页”按钮)。
-
抓取子页面: 进一步提取链接页面里的详细信息,比如商品详情或经纪人简介。
-
尝试不同数据类型: 试试抓文本、图片,甚至 PDF。Thunderbit 都能处理 (Thunderbit 文档)。
-
用定时任务自动化: 当你准备好了,就设置定时抓取,让数据持续更新。
每一次小胜利,都会提升你的能力和信心。别小看第一次抓到 100 行数据——这就是一个里程碑!
如何整理和格式化抓取到的数据
干净的数据才好用。以下方法能帮助你保持结果整洁,并随时可投入使用:
-
字段名称保持统一: 尽量使用清晰、统一的命名,比如“Price”或“Email”。Thunderbit 的 AI 推荐字段可以让这一步更轻松。
-
统一格式: 确保数字、日期和文本在整个数据集中格式一致。Thunderbit 在抓取时还能帮你格式化,甚至翻译数据 (Thunderbit)。
-
检查重复项: 用 Excel 或 Google Sheets 删除重复行。
-
边抓边验证: 在抓取过程中和结束后都抽查一下数据,尽早发现错误。
-
记录数据来源: 标明来源、日期和你做过的任何转换,方便你和团队后续理解背景。
一个整理得井井有条的表格,意味着你可以直接进入分析或分享,不需要再来一轮大清理。
进阶:什么时候以及如何处理更复杂的网页爬虫任务
当你已经掌握基础后,就可能想挑战更大的项目了。下面告诉你何时算准备好了,以及如何升级而不至于手忙脚乱:
这些信号说明你可以进阶了:
- 你已经成功完成了几个抓取任务,想继续扩大规模。
- 你需要定期监控数据,比如每天检查价格。
- 你正在处理页面很多或布局复杂的网站。
如何扩展:
- 使用云端抓取: Thunderbit 的云端模式一次最多可抓取 50 个页面,非常适合大批量任务 (Thunderbit 博客)。
- 设置定时抓取: 把重复任务自动化,让数据主动送上门。
- 处理登录和动态内容: 对需要登录或页面结构复杂的网站,使用浏览器模式。
- 持续监控并调整: 定期检查结果,网站一旦变化就及时调整设置。
进阶的关键就是在既有基础上稳步扩展,一步一步来。
总结:网页爬虫新手最佳实践
把前面的内容串起来,就是这些核心原则:
- 从简单开始: 先明确目标,先抓一个页面,确认流程正确再继续。
- 使用适合新手的工具: Thunderbit 让网页爬虫变得更简单、更快、更准确,而且无需编程。
- 避免常见错误: 提前规划、保持数据整洁,并尊重网站规则。
- 整理好数据: 使用清晰的字段名、统一的格式,并记录你的流程。
- 聪明地扩展规模: 随着你越来越熟练,再去自动化、定时化和监控。
网页爬虫不再只是技术人员的专属技能。只要方法和工具选对了,任何人都能释放网页数据的力量,并为业务做出更快、更好的决策。
准备好试试看了吗?下载 Thunderbit ,今天就开始你的第一个项目吧。如果你想获得更多技巧、教程或灵感,也可以看看 Thunderbit 博客。
免费试用 AI 网页爬虫 Get Started Free
常见问题
1. 新手做网页爬虫合法吗?
对于公开数据,网页爬虫通常是合法的,但你必须遵守每个网站的 robots.txt、服务条款和隐私法规。不要抓取个人信息或受版权保护的内容,并且在有官方 API 的情况下优先使用 API (Initial Data Offering)。
2. 开始做网页爬虫一定要会编程吗?
完全不用!像 Thunderbit 这样的工具就是为非技术用户设计的。只需点几下,就能完成数据抓取,不需要编程。
3. 新手在网页爬虫中最常犯哪些错误?
最常见的问题包括:没有明确目标、一次抓太多、漏掉分页或子页面、数据混乱,以及忽视网站规则。先从小项目做起,并使用适合新手的工具,就能避开这些坑。
4. 怎么让抓取到的数据保持整洁、有序?
使用统一的字段名、标准化格式、检查重复项,并在抓取过程中持续验证数据。Thunderbit 的 AI 可以帮你做标注、格式化,并导出到 Excel 或 Google Sheets。
5. 随着熟练度提高,我该如何扩展网页爬虫项目?
当你更熟练后,可以使用 Thunderbit 的云端抓取、子页面提取和定时任务功能,处理更大或更复杂的任务。始终记得监控结果,并根据情况调整。
祝你抓取顺利——愿你的表格永远整洁,数据永远新鲜!
延伸阅读



