
如今,接近一半的互联网流量都来自机器人,其中大多数都在大规模抓取链接、数据和 URL。如果你还在手动处理这些工作,那就已经落后了。
我测试了 12 款链接提取工具——从 AI 驱动的 Chrome 扩展到 Python 库——想看看当你需要快速抓取成千上万个 URL 时,哪些工具真的好用。
下面就是我的发现。
为什么链接提取器如此重要
说实话,网页上的数据已经多到炸了,企业都在争分夺秒把这些零散信息变成能直接用的洞察。链接提取器 和 URL 提取器 现在已经成了很多团队的刚需,尤其适合想要:
- 生成潜在客户:销售团队可以在几分钟内从目录或 LinkedIn 中提取公司主页链接,再把这些 URL 交给工具继续抓取联系方式。再也不用没完没了地手动点击了。
- 聚合内容并提升 SEO:营销人员可以收集博客里的所有文章链接,监控竞品外链,或者检查网站结构,找出失效链接。
- 监控竞争对手并做市场调研:运营团队可以自动收集新产品、价格页或新闻稿链接,轻松掌握竞品动态。
- 自动化工作流并节省时间:现代链接爬虫可以批量处理 URL,继续抓取子页面,并把数据导出成结构化格式(CSV、Excel、Google Sheets、Notion 等)。这意味着不用再经历漫长的复制粘贴,也不用再整理乱糟糟的文本文件。
考虑到如今每天都有数百亿网页被爬取,手动操作根本不现实。合适的链接提取器,就像一个永远不累、永远不会漏掉链接、还不用喝咖啡休息的超级助手。
我们如何挑选最佳链接提取器
市面上的工具太多了,挑选合适的链接提取器,就像在科技大会上相亲——每个都说自己是“真命天子”,但真正靠谱的没几个。以下是我筛选出前 12 名的标准:
- 易用性:非程序员能不能不用研究正则表达式也上手?无代码和低代码方案会加分。
- 批量与多层级抓取:能不能一次处理成百上千个 URL?能不能自动继续抓取子页面并顺着链接往下爬?
- 导出与集成:能不能导出到 CSV、Excel、Google Sheets、Notion、Airtable,或者通过 API 输出?越少手工操作越好。
- 适用人群与灵活性:适合商业用户、分析师,还是开发者?有些工具面向所有人,有些则更垂直。
- 高级功能:AI 识别、定时任务、云端扩展、数据清洗,以及常见网站模板等。
- 价格与扩展性:免费版、按量付费,还是企业版?我会重点看性价比。
我把浏览器扩展、企业级平台都纳入了评测,所以无论你是独立创业者,还是财富 500 强的数据团队,都能找到合适的选择。
Thunderbit:最适合商业用户的智能链接提取器
先说结论。 Thunderbit 是我最推荐的链接提取工具,而且不只是因为我参与了它的开发。Thunderbit 是一款 AI 驱动的网页爬虫 Chrome 扩展,专门为想快速拿到结果的商业用户设计。
Thunderbit 的亮点是什么?它就像一个真的会听你指挥的 AI 实习生。你只需要用自然语言说出需求(比如“把这个页面里的所有产品链接和价格抓下来”),Thunderbit 的 AI 就会自动把后面的事做完。你不用研究选择器,也不用自己写脚本。
而且它不止这些:
- 支持批量 URL:不管你粘贴的是一个 URL,还是上百个 URL,Thunderbit 都能一次处理。
- 支持子页面跳转:如果你想先从列表页抓链接,再进入每个详情页继续提取更多 URL,Thunderbit 的多层级抓取逻辑可以轻松搞定。
- 结构化导出:提取完成后,你可以重命名字段、分类整理,并直接导出到 Google Sheets、Notion、Airtable、Excel 或 CSV。后期整理不再让人头大。
使用 AI 从任何网站抓取链接 Get Started Free
Thunderbit 受到全球 20 多万用户信赖,客户覆盖销售团队、房产经纪人和独立电商卖家等各类人群。是的,它也提供免费方案(可抓取最多 6 个页面,试用加成后可到 10 个),你可以零风险体验。
Thunderbit 的核心亮点
下面看看 Thunderbit 到底强在哪里:
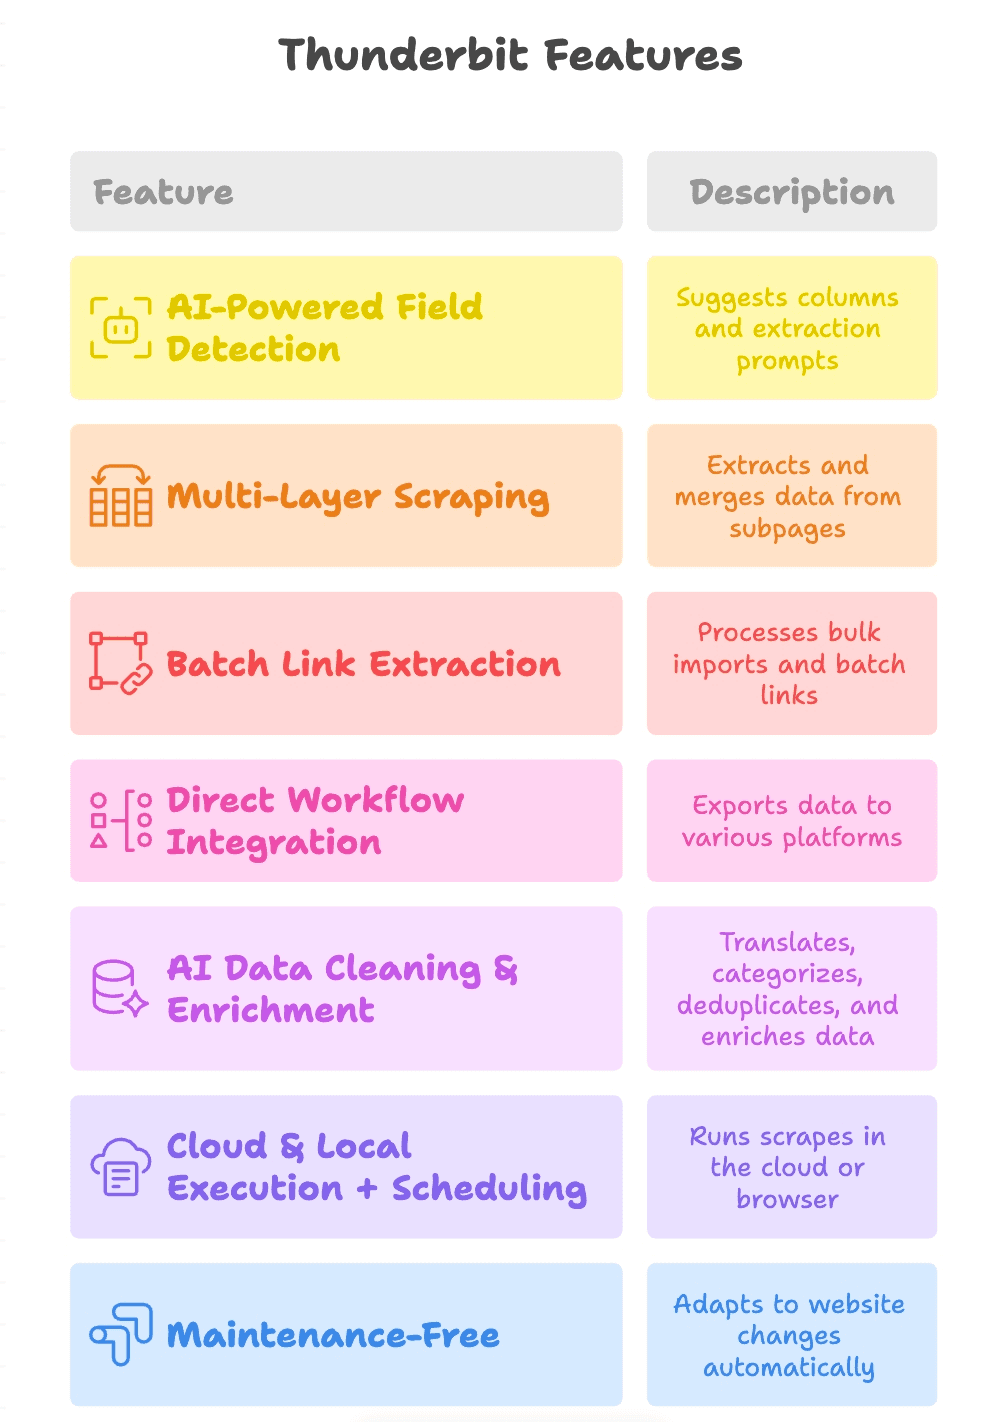
- AI 智能字段识别:只要点一下“AI Suggest Fields”,Thunderbit 就会读取页面内容,自动建议字段列(比如“产品链接”“PDF URL”“联系人邮箱”),甚至会为每个字段生成提取提示词。
- 多层级抓取:Thunderbit 可以从主页面跟进到子页面(比如产品详情页或 PDF 下载页),继续提取更多链接,并把结果合并到同一张表里。
- 批量链接提取:不管你抓的是一页还是一千页,Thunderbit 都能轻松处理批量导入和批量提取。
- 直接对接工作流:结果可直接导出到 Google Sheets、Notion、Airtable,或者下载成 CSV/Excel。数据会准确落到团队需要的地方。
- AI 数据清洗与增强:Thunderbit 在抓取时就能帮你翻译、分类、去重,甚至补全数据,让输出结果不是原始杂乱信息,而是可以直接用的成品。
- 云端与本地双模式 + 定时任务:你可以在云端运行任务以获得更快速度,也可以在浏览器中运行以应对需要登录的网站。还可以设置周期性任务,持续更新数据。
- 几乎免维护:Thunderbit 的 AI 会适应网站变化,所以你不用总是修修补补失效的爬虫,可以把更多时间放在真正有价值的事情上。
Octoparse:人人都能上手的无代码链接爬虫
Octoparse 是无代码抓取领域的老牌工具。它是一款桌面应用(Windows/Mac),采用可视化的点选式界面。你打开网页,点一下想要的链接,剩下的交给 Octoparse。
- 非常适合新手:不用编程,点一点就能开始抓取。
- 支持分页与动态内容:Octoparse 可以点击“下一页”按钮、滚动页面,甚至登录网站。
- 支持云端抓取与定时:付费方案可在云端运行任务,并设置重复执行。
- 导出选项丰富:可下载为 CSV、Excel、JSON,也可以推送到数据库。
它的免费方案对小任务很友好(最多 10 个任务、每月 50,000 行),但如果你是重度用户,就需要付费方案了(起价约 69 美元/月)。
Apify:适合自定义工作流的灵活 URL 提取器
Apify 可以说是网页抓取界的瑞士军刀。它既提供现成的“actors”(抓取工具)市场,也支持你用 JavaScript 或 Python 编写自己的脚本。
- 现成工具 + 可自定义:可以直接使用社区 actor 完成常见任务,也可以自己搭建适合特定工作流的方案。
- 支持批量与定时抓取:可以排队处理 URL、并行运行任务,还能设置周期性抓取。
- API 优先:支持导出到 JSON、CSV、Excel 或 Google Sheets,并可直接接入数据管道。
- 按量付费:每月有免费额度,之后按实际使用计费。
Apify 特别适合半技术团队和开发者,既要灵活性,也要可扩展性。
Bright Data URL Scraper:企业级链接抓取方案
Bright Data 专为需要大规模抓取的企业打造。它的 Web Scraper API 提供预设好的现成抓取器,适合高并发任务。
- 轻松应对超大规模:可抓取成千上万甚至数百万页面,并依托强大的代理基础设施降低封禁风险。
- 预设模板:面向电商、社交、房产等场景提供现成抓取器。
- 企业级能力:合规工具、专家支持,以及更高级的反封禁能力。
- 定价:免费额度为每月 5,000 credits,之后按量收费为 1.50 美元/1000 条记录,或选择 499 美元/月的 Scale 套餐——依然是企业级价格。
如果你是初创公司,这款工具可能有点“大炮打蚊子”。但对于关键业务和高频大规模抓取,Bright Data 确实很强。
WebHarvy:点哪抓哪的可视化链接提取器
WebHarvy 是一款 Windows 桌面应用,你只要在内置浏览器里点一下链接,就能开始抓取。
- 极其简单:点一下链接,WebHarvy 就会高亮所有相似元素并提取它们。
- 支持正则表达式:内置常见任务模式,不用写代码。
- 可导出为 Excel、CSV、JSON、XML、SQL:很适合希望用熟悉格式处理数据的商业用户。
- 一次性授权:买断后可长期使用。
它特别适合小型企业、研究人员,或者任何想快速、轻松抓取链接但又不想写代码的人。
Web Scraper(Chrome 扩展):在浏览器里快速抓取链接
Web Scraper Chrome Extension 是一款免费的开源工具,可以把你的浏览器直接变成抓取器。
- 定义站点地图:告诉它怎么导航,以及要提取什么内容。
- 支持分页与多层级爬取:可抓取分类页、子分类页和详情页。
- 导出为 CSV/XLSX:直接在浏览器里下载数据。
- 社区模板丰富:有很多热门网站共享的站点地图。
它很适合临时性、一次性的任务,也适合预算有限的学生和小团队。
ScraperAPI:为开发者打造的可扩展链接抓取 API
ScraperAPI 面向那些希望大规模抓取网页、又不想操心代理、封禁和验证码的开发者。
- API 驱动:发送一个 URL,就能返回 HTML 或抓取后的数据。
- 支持规模化与反爬机制:内置代理轮换、JS 渲染和验证码处理。
- 可接入你的代码:可用于 Python、Node.js 或其他任何语言。
- 定价:提供免费试用(约 5,000 API credits),之后按请求计费。
它非常适合自定义爬虫,或者你需要在大规模场景下保证稳定性和速度时使用。
ParseHub:带高级选择功能的可视化链接爬虫
ParseHub 是一款桌面应用(Windows、Mac、Linux),可以通过可视化方式搭建抓取项目。
- 高级选择与导航:点击、循环、条件提取链接,甚至可以处理动态元素或隐藏元素。
- 支持嵌套页面:先抓分类页,再抓详情页,然后继续提取更多链接。
- 可导出到 CSV、Excel、JSON:付费方案还支持云端运行和 API 访问。
- 免费方案:可创建 5 个项目,每次运行最多抓取 200 个页面。
ParseHub 很受营销人员和研究人员欢迎,因为它兼具强大功能和无代码体验。
Scrapy:面向开发者的 Python 链接提取框架
Scrapy 是 Python 开发者心中的黄金标准,适合需要完全掌控流程的人。
- 以代码为中心:可构建自定义蜘蛛,在任意规模下抓取并提取链接。
- 支持分布式爬取:高效、异步,而且高度可定制。
- 可导出为 CSV、JSON、XML 或数据库:输出方式完全由你控制。
- 开源免费:但你需要自己维护运行环境。
如果你熟悉 Python,Scrapy 几乎就是你能拿到的最强解决方案之一。
Diffbot:用 AI 提取结构化数据的链接爬虫
Diffbot 可以看作网页抓取领域的“AI 大脑”。它会自动分析页面并返回结构化数据——包括链接——而不用手动配置。
- 自动内容识别:输入 URL,就能得到结构化数据(文章、产品、链接等)。
- Crawlbot 与 Knowledge Graph:可以抓取整个网站,也可以查询它庞大的网页索引。
- API 驱动:可接入 BI 工具或数据管道。
- 企业级定价:起价约 299 美元/月,但一分钱一分货。
它最适合那些希望直接拿到干净、结构化数据,而不想自己维护爬虫的企业。
Cheerio:轻量级 Node.js 链接提取工具
Cheerio 是一个快速、类似 jQuery 的 HTML 解析器,适用于 Node.js。
- 速度极快:几毫秒即可解析 HTML。
- 语法熟悉:如果你懂 jQuery,上手 Cheerio 会很轻松。
- 适合静态页面:不渲染 JS,但非常适合服务端渲染内容。
- 开源免费:通常搭配 axios 或 fetch 发起请求使用。
它非常适合想同时兼顾速度和简洁性的开发者自定义脚本项目。
Puppeteer:适用于高级链接抓取的浏览器自动化工具
Puppeteer 是一个 Node.js 库,可用于在无头模式下控制 Chrome。
- 完整浏览器自动化:加载页面、点击、滚动、交互,像真实用户一样操作。
- 支持动态内容与登录场景:特别适合 JavaScript 重度网站或复杂工作流。
- 精细控制:可等待元素、截图、拦截网络请求。
- 开源免费:但资源消耗较大,速度也比轻量工具慢。
当你需要抓取那些对基础爬虫不太友好的网站时,Puppeteer 就派上用场了。
一眼看懂:哪款链接提取器最适合你?
下面是这 12 款工具的快速对比:
| 工具 | 最适合 | 批量与子页面支持 | 数据导出选项 | 价格 |
|---|---|---|---|---|
| Thunderbit | 非程序员、商业用户 | 支持(AI、多层级) | Excel、CSV、Sheets、Notion、Airtable | 免费试用,约 $9/月起 |
| Octoparse | 无代码用户、分析师 | 支持 | CSV、Excel、JSON、云存储 | 免费版,约 $69/月起 |
| Apify | 半技术用户、开发者 | 支持 | CSV、JSON、通过 API 导出到 Sheets | 免费额度,按量计费 |
| Bright Data | 企业用户 | 支持(高容量) | CSV、JSON、NDJSON,通过 API 输出 | 免费版,之后 $1.50/1000 条记录 |
| WebHarvy | 非程序员、桌面用户 | 支持 | Excel、CSV、JSON、XML、SQL | 付费授权 |
| Web Scraper 扩展 | 任何人,适合快速/免费需求 | 支持 | CSV、XLSX | 免费、开源 |
| ScraperAPI | 开发者、API 用户 | 支持 | JSON(通过 API 获取 HTML) | 免费 5k 试用 credits,付费套餐 |
| ParseHub | 非程序员、高级用户 | 支持 | CSV、Excel、JSON、API | 免费 5 个项目,付费版可选 |
| Scrapy | 开发者、Python 用户 | 支持 | CSV、JSON、XML、数据库 | 免费、开源 |
| Diffbot | 企业用户、AI 场景 | 支持(AI 抓取) | JSON(通过 API 获取结构化数据) | 约 $299/月起 |
| Cheerio | 开发者、Node.js | 支持(需自定义代码) | 自定义(JSON 等) | 免费、开源 |
| Puppeteer | 开发者、复杂网站 | 支持(完整自动化) | 自定义(脚本输出) | 免费、开源 |
如何为你的业务选择合适的链接爬虫
那到底该怎么选?这是我的快速建议:
- 不会写代码? 先试 Thunderbit、Octoparse、ParseHub、WebHarvy,或者 Web Scraper 扩展。
- 需要自定义工作流? Apify、ScraperAPI 或 Cheerio 很适合开发者。
- 企业级规模? Bright Data 或 Diffbot 更适合你。
- Python 或 Node.js 开发者? Scrapy(Python)或 Cheerio/Puppeteer(Node.js)能给你最大的控制力。
- 想直接导出到 Sheets/Notion? Thunderbit 是最佳选择。
根据你的技术水平、数据量和集成需求来匹配工具。大多数工具都提供免费试用,所以别怕多试几款。
探索更多网页抓取指南 Get Started Free
Thunderbit 在 2026 年链接提取中的独特价值
再回到 Thunderbit 为什么与众不同:
- AI 驱动的极简体验:用日常语言描述你的需求,剩下的交给 Thunderbit 的 AI。
- 多层级抓取:从主页面提取链接,再跟进子页面继续抓取更多 URL,一次流程全搞定。
- 批量导入与批处理:粘贴数百个 URL,批量提取链接,并立即导出结构化数据。
- 工作流集成:可直接导出到 Google Sheets、Notion、Airtable,或者下载为 CSV/Excel。
- 零维护成本:Thunderbit 的 AI 会适应网站变化,让你不用不停修复失效的爬虫。
Thunderbit 连接了“只是抓数据”和“真正拿来就能用的数据”之间的鸿沟。这是我希望自己很多年前就拥有的工具,那时我还在被大量手工数据任务淹没。
结语:更聪明地抓取链接,提升你的工作流效率
网页数据是业务增长的燃料,而合适的链接提取器就是你的引擎。无论你是在搭建潜在客户名单、监控竞争对手,还是自动化调研流程,这里总有一款工具适合你的需求和技能水平。
如果你想看看现代链接提取到底是什么样子,欢迎试试 Thunderbit 的免费方案。我想你会惊讶于,只需几次点击就能完成这么多工作。如果 Thunderbit 不是最合适的选择,也可以试试这个列表里的其他工具——现在是自动化重复工作、专注真正重要事情的最佳时机。
祝你抓取顺利,也祝你的链接永远干净、结构清晰、随时可用。如果你想进一步了解网页抓取,欢迎查看 Thunderbit Blog,获取更多指南和技巧。
免费试用 Thunderbit 链接提取器 Get Started Free
常见问题
1. 为什么链接提取器如此重要?
如今接近一半的互联网流量来自机器人,企业也在积极抓取数据,因此链接提取器对于把混乱的网页信息转化为可执行洞察至关重要。它们可以自动完成潜在客户开发、内容聚合、SEO 审计和竞品监控等任务,节省大量时间和精力。
2. Thunderbit 和其他链接提取器相比有什么优势?
Thunderbit 通过 AI 简化抓取流程——你只需用自然语言描述目标,剩下的它来处理。它支持批量导入 URL、多层级抓取、智能字段识别,并可无缝导出到 Google Sheets、Notion 等平台。对于非程序员和商业用户来说,它既强大又省心。
3. 有没有适合开发者和自定义工作流的链接提取工具?
有。Apify、ScraperAPI、Cheerio、Puppeteer 和 Scrapy 都非常适合开发者。它们支持脚本编写、API 集成,以及处理复杂抓取任务、大规模作业和高级自动化。
4. 哪些工具适合没有编程经验的用户?
Thunderbit、Octoparse、ParseHub、WebHarvy 和 Web Scraper Chrome 扩展都是非技术用户的热门选择。这些工具提供可视化界面、预置模板和 AI 驱动功能,让任何人都能轻松完成链接提取。
5. 我该如何选择适合自己的链接提取器?
要结合你的技术能力、数据量和导出需求来判断。不会编程的人可以选择 Thunderbit 或 Octoparse;开发者可能更偏爱 Scrapy 或 Puppeteer;企业则可以考虑 Bright Data 或 Diffbot 来处理大规模任务。最好先试用免费方案,看看哪一款最适合自己。



