Thunderbit’in PubMed Scraper aracı, AI kullanarak PubMed sayfalarını temiz ve düzenli veri setlerine dönüştürmenizi sağlar. Trend tıbbi araştırmaları, klinik çalışma kanıtlarını, özetleri, yazarları, kurum bilgilerini, yayın tarihlerini, PMID’leri ve makale bağlantılarını çıkarabilir; ardından verileri Excel, Google Sheets, Airtable veya Notion’a aktarabilirsiniz. Tek yapmanız gereken PubMed’i Chrome’da açmak, AI’ın en uygun sütunları önermesine izin vermek ve ardından veriyi çekmektir.
🧬 PubMed Scraper nedir
PubMed Scraper, PubMed | US National Library of Medicine için geliştirilmiş bir AI Web Scraper’dır. Thunderbit (AI web scraper Chrome eklentisi) ile istediğiniz PubMed sonuç sayfasına gidebilir, AI Suggest Columns’a tıklayabilir ve ardından Scrape ile kod yazmadan yapılandırılmış veri çıkarabilirsiniz.
🔎 PubMed ile neleri çekebilirsiniz
PubMed, çok değerli biyomedikal meta verilerle doludur; ancak bu veriler her zaman analiz için hazır olmayabilir. Thunderbit’in AI Web Scraper’ı (https://thunderbit.com/), PubMed listelerini toplamanıza ve Subpage Scraping ile makale düzeyindeki ayrıntılarla zenginleştirmenize yardımcı olur (her makale sayfasını açıp özet, kurum bilgileri, DOI ve daha fazlasını ekleyebilirsiniz).
Aşağıda dakikalar içinde çalıştırabileceğiniz iki yaygın iş akışı yer alıyor.
📈 PubMed trend tıbbi araştırma takibi çekme
Bu iş akışını, PubMed trend sayfasında öne çıkan tıbbi araştırmaları takip etmek için kullanın. Güncel kalmak, şirket içi özetler oluşturmak, rakip yayınlarını izlemek veya literatür izleme hattınızı beslemek için oldukça faydalıdır.
Hedef sayfa örneği: PubMed Trending
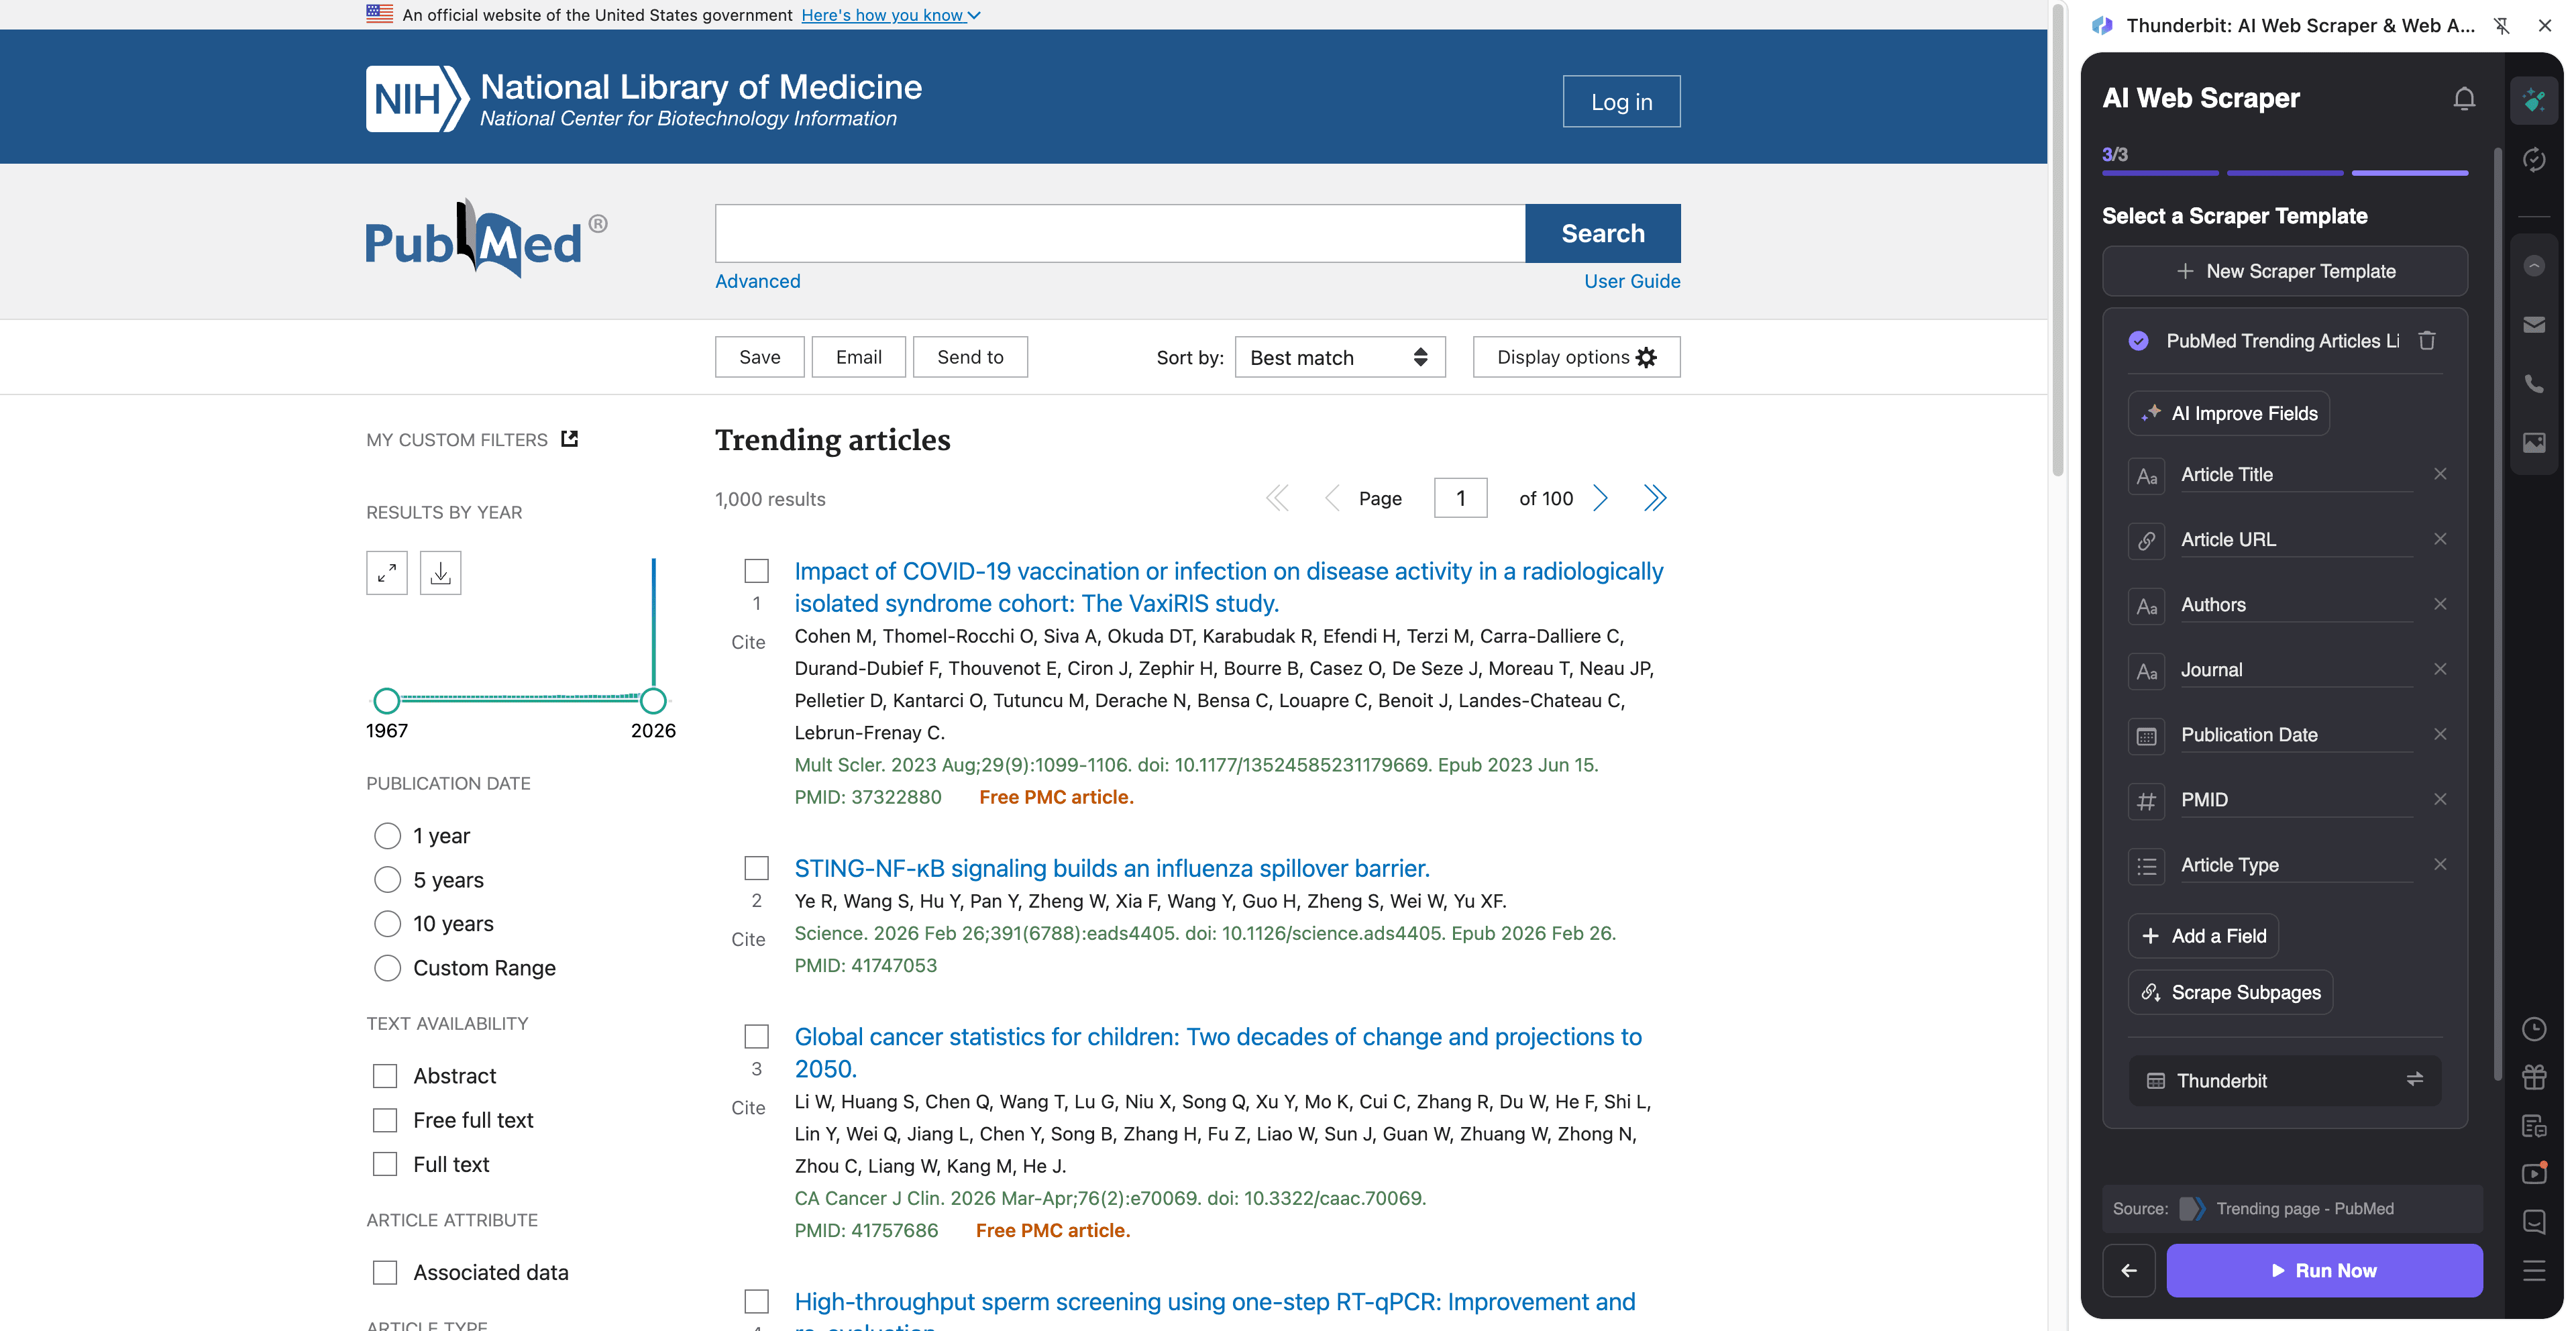
Adımlar:
- Thunderbit Chrome Extension eklentisini indirin ve bir hesap oluşturun.
- Hedef sayfaya gidin, örneğin: PubMed Trending.
- AI’ın en uygun sütun adlarını ve veri türlerini önermesi için AI Suggest Columns’a tıklayın.
- Veriyi çekmek için Scrape’a tıklayın, ardından verileri Excel, Google Sheets, Airtable veya Notion’a aktarın.
Sütun adları
| Sütun | Açıklama |
|---|---|
| 🧾 Makale Başlığı | Trend olan PubMed makalesinin başlığı. |
| 🔗 Makale URL’si | PubMed kayıt sayfasına doğrudan bağlantı. |
| 🆔 PMID | Kaydın PubMed tanımlayıcısı (kalıcı bir anahtar olarak kullanışlıdır). |
| 🏛️ Dergi | Makalenin yayınlandığı dergi adı. |
| 📅 Yayın Tarihi | Listede görünen yayın tarihi. |
| ✍️ Yazarlar | Sonuç kartında görünen yazar dizisi. |
| 🧪 Makale Türü | Varsa yayın türü (ör. Review, Clinical Trial). |
| 🏷️ Anahtar Kelimeler / Konular | Listede görünen konu etiketleri veya anahtar kelimeler (varsa). |
| 📝 Kısa Özet / Snippet | Listede görünen kısa açıklama metni (varsa). |
| 🧷 DOI | DOI bilgisi (çoğu zaman subpage scraping ile daha iyi yakalanır). |
| 🧑🔬 Kurum Bilgileri | Yazar kurum bilgileri (genellikle subpage scraping ile çıkarılır). |
| 📄 Özet | Abstract metni (genellikle subpage scraping ile çıkarılır). |
🧫 PubMed klinik çalışma kanıtı çıkarma
Bu iş akışını, PubMed arama sonuçlarından klinik çalışma ile ilgili kanıtları çıkarmak için kullanın; ardından inceleme için gereken abstract, trial sinyalleri ve meta verileri toplamak üzere her satırı makale sayfasını ziyaret ederek zenginleştirin.
Hedef sayfa örneği: Clinical trial search results
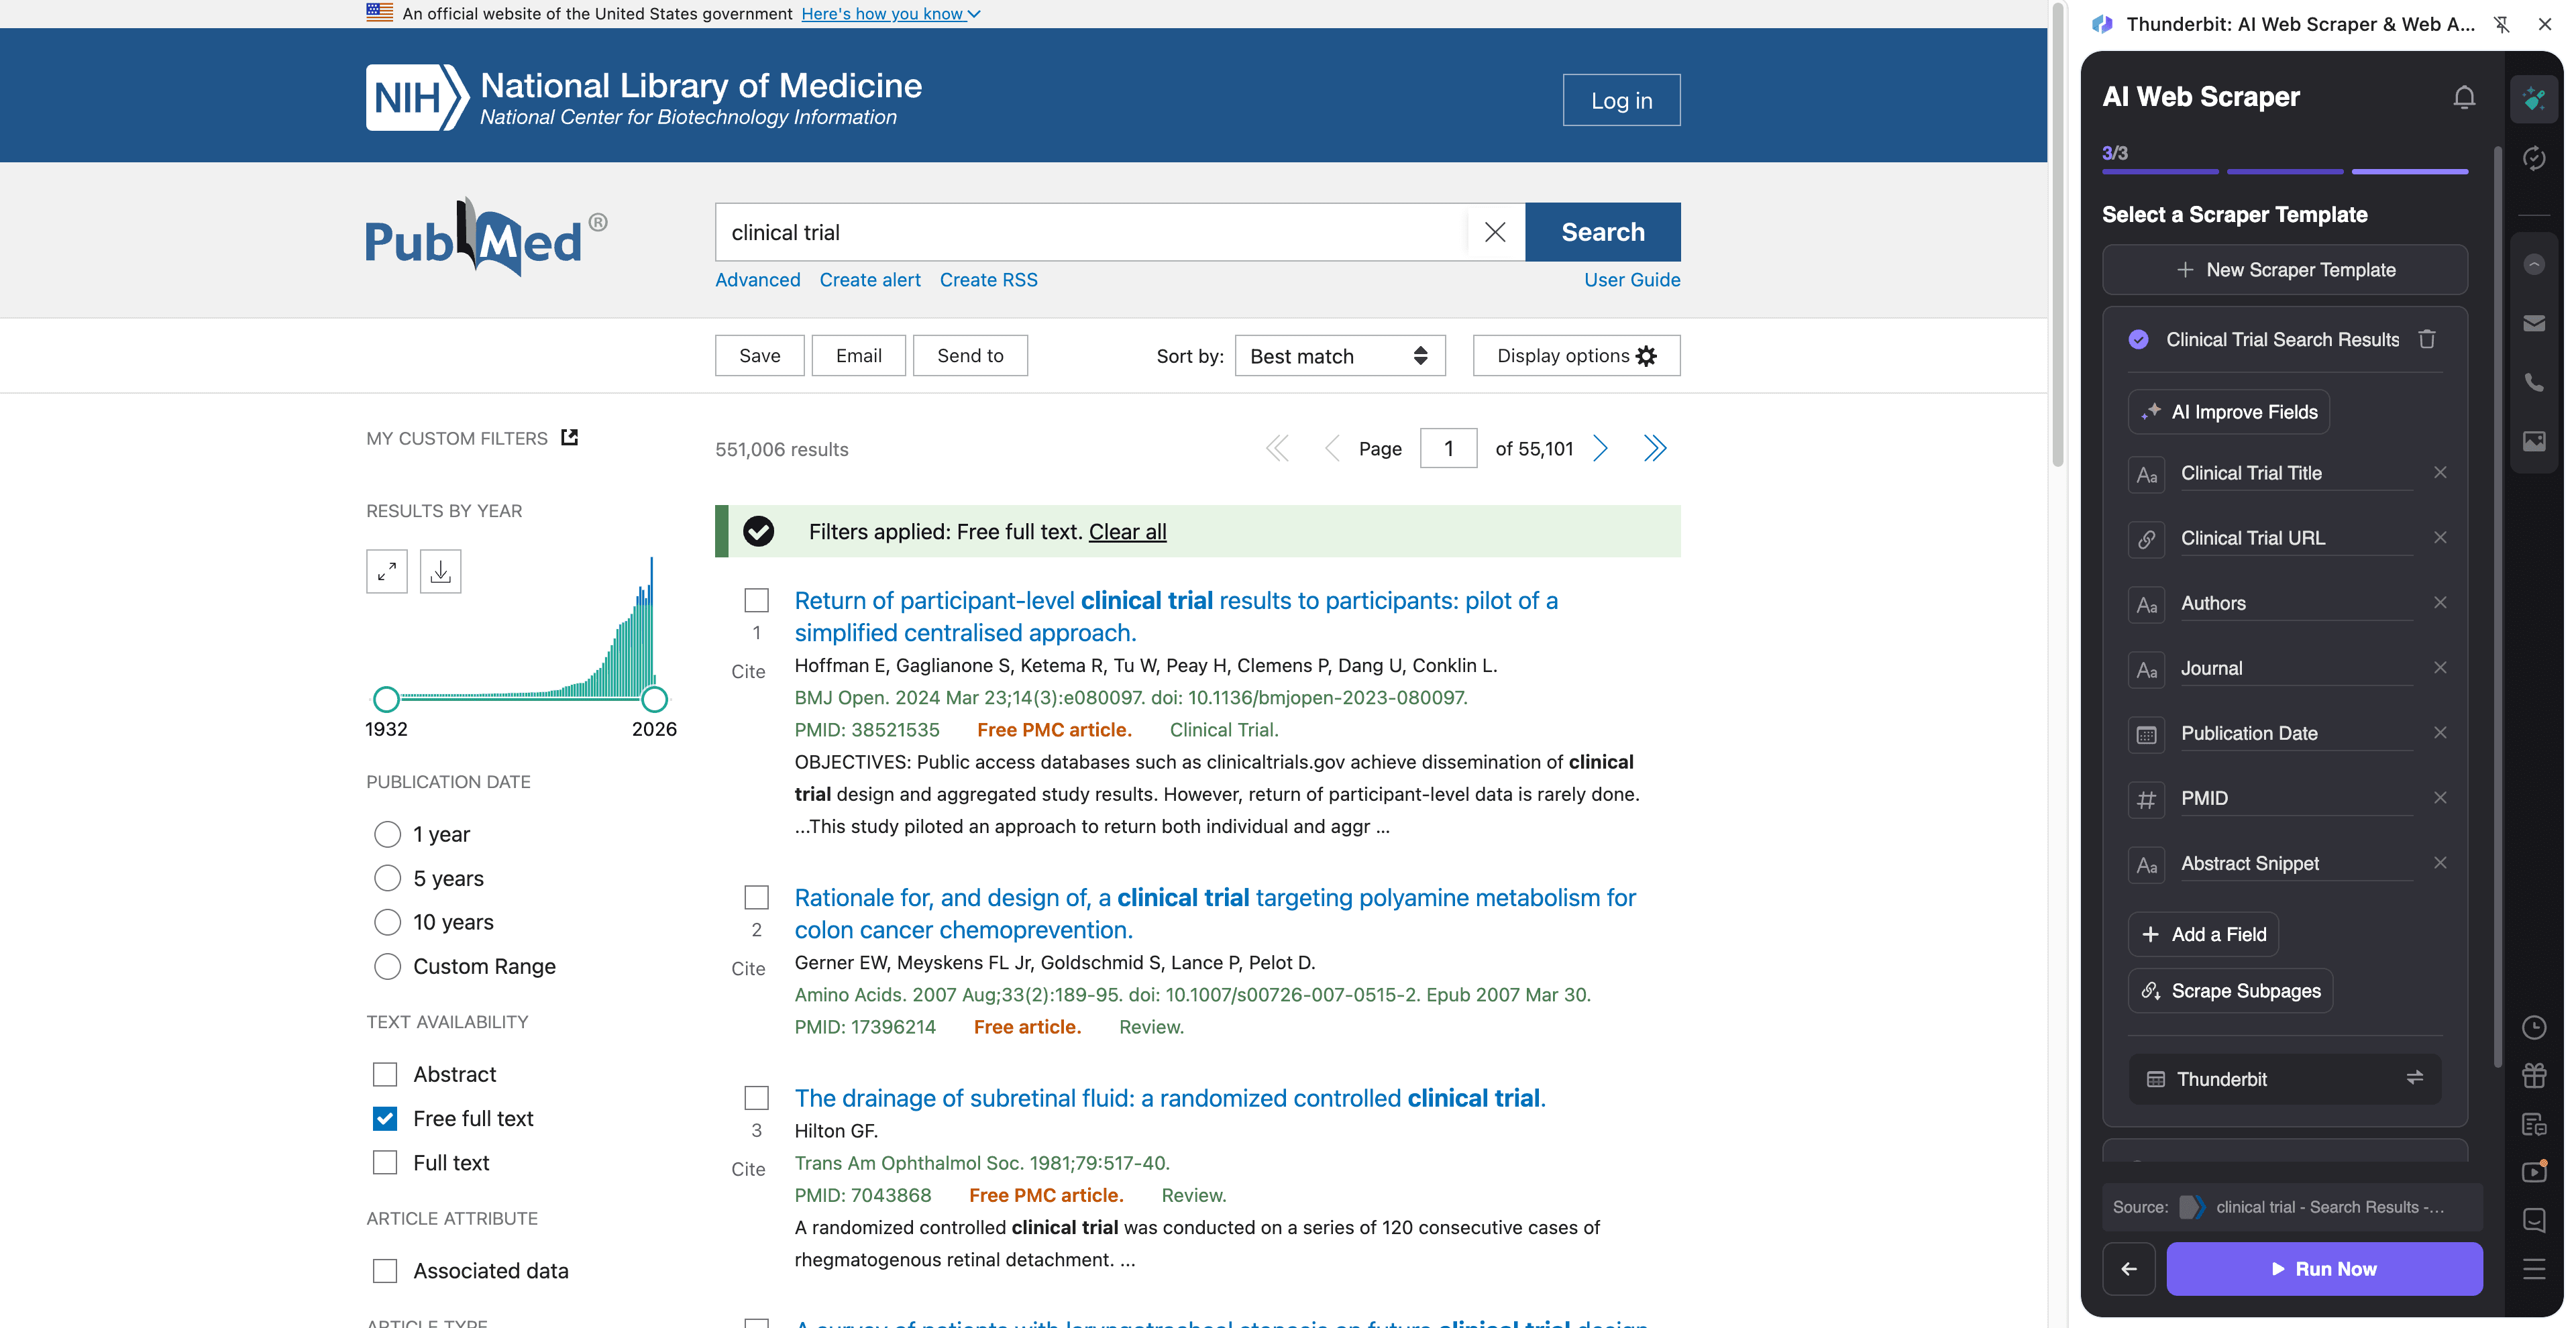
Adımlar:
- Thunderbit Chrome Extension eklentisini indirin ve bir hesap oluşturun.
- Hedef sayfaya gidin, örneğin: Clinical trial search results.
- Önerilen alanları oluşturmak için AI Suggest Columns’a tıklayın (isterseniz alan adlarını değiştirebilir veya kendiniz yenilerini ekleyebilirsiniz).
- Sonuçları toplamak için Scrape’a tıklayın, ardından her satırı abstract, kurum bilgileri, DOI ve daha fazlasıyla zenginleştirmek için Scrape Subpages özelliğini kullanın.
Sütun adları
| Sütun | Açıklama |
|---|---|
| 🧾 Başlık | Arama sonuçlarında görünen makale başlığı. |
| 🔗 PubMed URL’si | Alt sayfa zenginleştirmesi için PubMed makale sayfası bağlantısı. |
| 🆔 PMID | Tekilleştirme ve referanslama için PubMed tanımlayıcısı. |
| 🧑⚕️ Yazarlar | Sonuç özetinde listelenen yazarlar. |
| 🏛️ Dergi | Sonuçlarda görünen dergi adı ve atıf bilgileri. |
| 📅 Tarih | Listede görünen yayın tarihi (veya ePub tarihi). |
| 🧪 Yayın Türü | Clinical Trial, Randomized Controlled Trial, Meta-Analysis gibi sinyaller (çoğu zaman makale sayfasında daha net görünür). |
| 🧾 Özet | Tam abstract metni (en iyi sonuç için subpage scraping kullanın). |
| 🧬 MeSH Terimleri | Varsa Medical Subject Headings bilgileri (çoğu zaman makale sayfasında yer alır). |
| 🧷 DOI | Yayıncı sayfalarına ve referans yöneticilerine bağlantı kurmak için DOI. |
| 🏥 Kurum Bilgileri | Kurum analizi için yazar afiliasyonları (subpage scraping ile). |
| 🌍 Ülke / Kurum | Field AI Prompts kullanılarak kurum bilgilerinden ayrıştırılır (isteğe bağlı). |
| 🔍 Klinik Çalışma Anahtar Kelimeleri | “randomized”, “double-blind”, “placebo” gibi AI etiketli işaretler (Field AI Prompt ile isteğe bağlı). |
| 📎 Tam Metin Bağlantıları | Varsa yayıncıya veya ücretsiz tam metne giden dış bağlantılar. |
🎯 Neden PubMed aracı kullanılır
PubMed’i çekmek; hız, tutarlılık ve araştırma verisini iş akışınız içinde kullanılabilir hale getirmekle ilgilidir. Atıfları tek tek kopyalamak yerine, filtreleyebileceğiniz, etiketleyebileceğiniz ve paylaşabileceğiniz yapılandırılmış bir veri seti oluşturabilirsiniz.
Ekiplerin PubMed’i kullanmasının yaygın nedenleri:
- Medical affairs ve ilaç ekipleri: Belirli bir terapötik alandaki yeni yayınları takip eder, rakip çalışmalarını izler ve iç incelemeler için kanıt tabloları oluşturur.
- Biotech ve klinik operasyon ekipleri: Çalışma ilişkili yayınları toplar, kurumları ve araştırmacıları eşleştirir, yaşayan bir kaynakça oluşturur.
- Sağlık pazarlaması ve içerik ekipleri: İçerik planlaması için trend konuları, etkili dergileri ve yükselen anahtar kelimeleri belirler.
- Akademik araştırmacılar ve kütüphaneciler: Literatür taraması için veri setleri oluşturur, PMID ile tekilleştirme yapar ve tarama için tablolar halinde dışa aktarır.
- Veri ekipleri: Sonraki analizler, panolar veya iç bilgi tabanları için yapılandırılmış girdiler üretir.
Thunderbit özellikle yalnızca liste sayfası yetmediğinde çok işe yarar. Subpage Scraping ile özetleri, kurum bilgilerini, DOI’yi, MeSH terimlerini ve tam metin bağlantılarını büyük ölçekte çıkarabilirsiniz.
🧩 PubMed Chrome Extension nasıl kullanılır
- Thunderbit Chrome Extension’ı yükleyin: Chrome Web Store üzerinden indirin ve hesabınızı oluşturun.
- Bir PubMed sayfasına gidin: PubMed, Trending gibi bir trend sayfası veya clinical trial results gibi bir sorgu açın.
- AI destekli scraper’ı etkinleştirin: Alanları oluşturmak için AI Suggest Columns’a tıklayın, veri türlerini (text/date/url) ayarlayın ve isteğe bağlı Field AI Prompts ekleyin (etiketleme, biçimlendirme veya trial sinyallerini çıkarmak için).
- Veriyi çekin ve dışa aktarın: Scrape’a tıklayın. Abstract/kurum bilgileri/MeSH gerekiyorsa her satırı zenginleştirmek için Scrape Subpages’ı çalıştırın, ardından verileri Excel, Google Sheets, Airtable veya Notion’a aktarın.
Tekrarlanabilir bir iş akışı kuruyorsanız şu içerikler de faydalı olabilir:
- AI Kullanarak Herhangi Bir Web Sitesi Nasıl Kazınır
- Data Scraping Nedir ve 2025’te Nasıl Yapılır
- AI Kullanarak Web Sitesi Verileri Excel’e Nasıl Çekilir
- List Crawling Nedir ve AI ile Nasıl Yapılır
💳 PubMed için fiyatlandırma
Thunderbit basit bir kredi sistemi kullanır:
- 1 kredi = sonuç tablonuzda 1 çıktı satırı (örneğin, bir PubMed kaydı).
- Veri dışa aktarma ücretsizdir: CSV/JSON indirilebilir veya Excel, Google Sheets, Airtable ya da Notion’a gönderilebilir.
Şunlarla başlayabilirsiniz:
- Ücretsiz plan: ayda 6 sayfa kazıyın (Free planında sayfa bazlı hak tanımlıdır).
- Ücretsiz deneme: 10 sayfa ücretsiz kazıyın; bu, PubMed trend sayfalarını ve birkaç klinik çalışma sonuç sayfasını test etmek için idealdir.
Düzenli olarak veri çekiyorsanız (haftalık takip, kanıt güncellemeleri veya büyük sorgular), ücretli planlar size daha fazla kredi sağlar. Yıllık plan, aylık ödemeye kıyasla indirim içerdiği için genellikle daha ekonomiktir.
Seçenekleri Thunderbit Pricing sayfasında inceleyebilirsiniz.
❓ SSS
-
AI destekli PubMed Scraper nedir?
AI destekli PubMed Scraper, Thunderbit içinde yer alan ve PubMed arama sonuçları ile makale sayfalarından yapılandırılmış veri çıkaran bir iş akışıdır. AI ile sütun önerileri alabilir, liste verisini çekebilir ve her satırı makale alt sayfalarını ziyaret ederek abstract, kurum bilgileri, DOI ve daha fazlasıyla zenginleştirebilirsiniz. -
Thunderbit nedir?
Thunderbit, web sitelerinden yapılandırılmış veriye ihtiyaç duyan iş ve araştırma iş akışları için tasarlanmış bir AI web scraper Chrome eklentisidir. Kazıma scriptleri yazmadan veya bakımını yapmadan veriyi hızlıca çıkarmanıza, etiketlemenize ve dışa aktarmanıza yardımcı olur. -
PubMed trend sayfalarını ve normal arama sonuçlarını kazıyabilir misiniz?
Evet. PubMed Trending sayfasını, standart anahtar kelime aramalarını ve filtrelenmiş sonuç sayfalarını (örneğin klinik çalışma odaklı sorgular) çekebilirsiniz. Thunderbit’in AI’ı sayfayı okuyup alanlar önerdiği için farklı düzenlere uyum sağlar. -
Thunderbit abstract, kurum bilgileri ve MeSH terimlerini çıkarabilir mi?
Evet, özellikle burada Subpage Scraping çok etkilidir. Önce sonuç listesini çekebilir, ardından Thunderbit’in her PubMed kayıt sayfasını açarak abstract metnini, kurum bilgilerini, MeSH terimlerini, DOI’yi ve diğer meta verileri aynı tabloya eklemesini sağlayabilirsiniz. -
PubMed’de sayfalama ve sonsuz kaydırma nasıl çalışır?
Thunderbit, “next page” tarzı gezinmeyi içeren sayfalama kazımayı destekler. PubMed sonuçları farklı şekilde yüklense bile, AI tabanlı çıkarım katı seçicilere göre daha dayanıklıdır; çünkü her çalıştırmada sayfa yapısını yeniden okur. -
PubMed verilerini hangi formatlara dışa aktarabilirim?
Verileri CSV veya JSON olarak dışa aktarabilir ya da Excel, Google Sheets, Airtable veya Notion’a gönderebilirsiniz. Bu, tarama iş akışları, kanıt tabloları, panolar ve işbirliği yapılan ekiplerle paylaşım için kullanışlıdır. -
Ücretsiz olarak kaç PubMed kaydı çekebilirim?
Free planda ayda 6 sayfa kazıyabilirsiniz; bu genellikle küçük takip işleri için yeterlidir. Ücretsiz denemede ise sütun kurulumunuzu ve alt sayfa zenginleştirme stratejinizi test etmek için 10 sayfayı ücretsiz çekebilirsiniz. -
Belirli kanıt çıkarma ihtiyaçları için sütunları özelleştirebilir miyim?
Evet. Sütun adlarını değiştirebilir, veri türlerini (text/date/url) ayarlayabilir ve trial tasarımı anahtar kelimeleri, popülasyon, müdahale, karşılaştırma, sonuçlar veya kurum bilgilerinden ülke gibi bilgileri çıkarmak ya da etiketlemek için Field AI Prompts ekleyebilirsiniz. Böylece ham kazımadan yapılandırılmış kanıt hazırlığına geçebilirsiniz. -
PubMed’i kazımak uygun mu?
PubMed herkese açık bir kaynaktır ve birçok ekip bibliyografik meta verileri araştırma ve analiz için toplar. Yine de geçerli yasalara uymalı, site kullanım şartlarını dikkate almalı ve özellikle büyük ve sık görevler yürütüyorsanız sorumlu kazıma uygulamaları kullanmalısınız.
📚 Daha Fazla Bilgi
- Eklentiyi indirin: Thunderbit Chrome Extension Download Page
- Thunderbit Blog üzerindeki rehberleri inceleyin
- Temelleri öğrenin: Data Scraping Nedir ve 2025’te Nasıl Yapılır
- Liste iş akışları oluşturun: List Crawling Nedir ve AI ile Nasıl Yapılır
- Tablolara aktarın: AI Kullanarak Web Sitesi Verileri Excel’e Nasıl Çekilir
- Araştırma operasyonlarında PDF de kazıyorsanız: AI Kullanarak PDF’den Veri Nasıl Çekilir