
Bir terminali açıp tek bir komut yazdığınızda, sanki Matrix’i yeni aralamışsınız gibi ham web verisinin akışını izlemekten daha zamansız çok az şey vardır. Geliştiriciler ve teknik ileri seviye kullanıcılar için cURL tam da o sihirli değnektir: bulut sunucularından akıllı buzdolaplarına kadar milyarlarca cihazda sessizce çalışan, gösterişsiz bir komut satırı aracıdır. Üstelik 2026’da, ortada tüm o parlak no-code ve AI tabanlı kazıma araçları varken bile, web kazımada cURL; hız, kontrol ve betiklenebilirlik isteyen herkes için hâlâ ilk tercihlerden biridir.
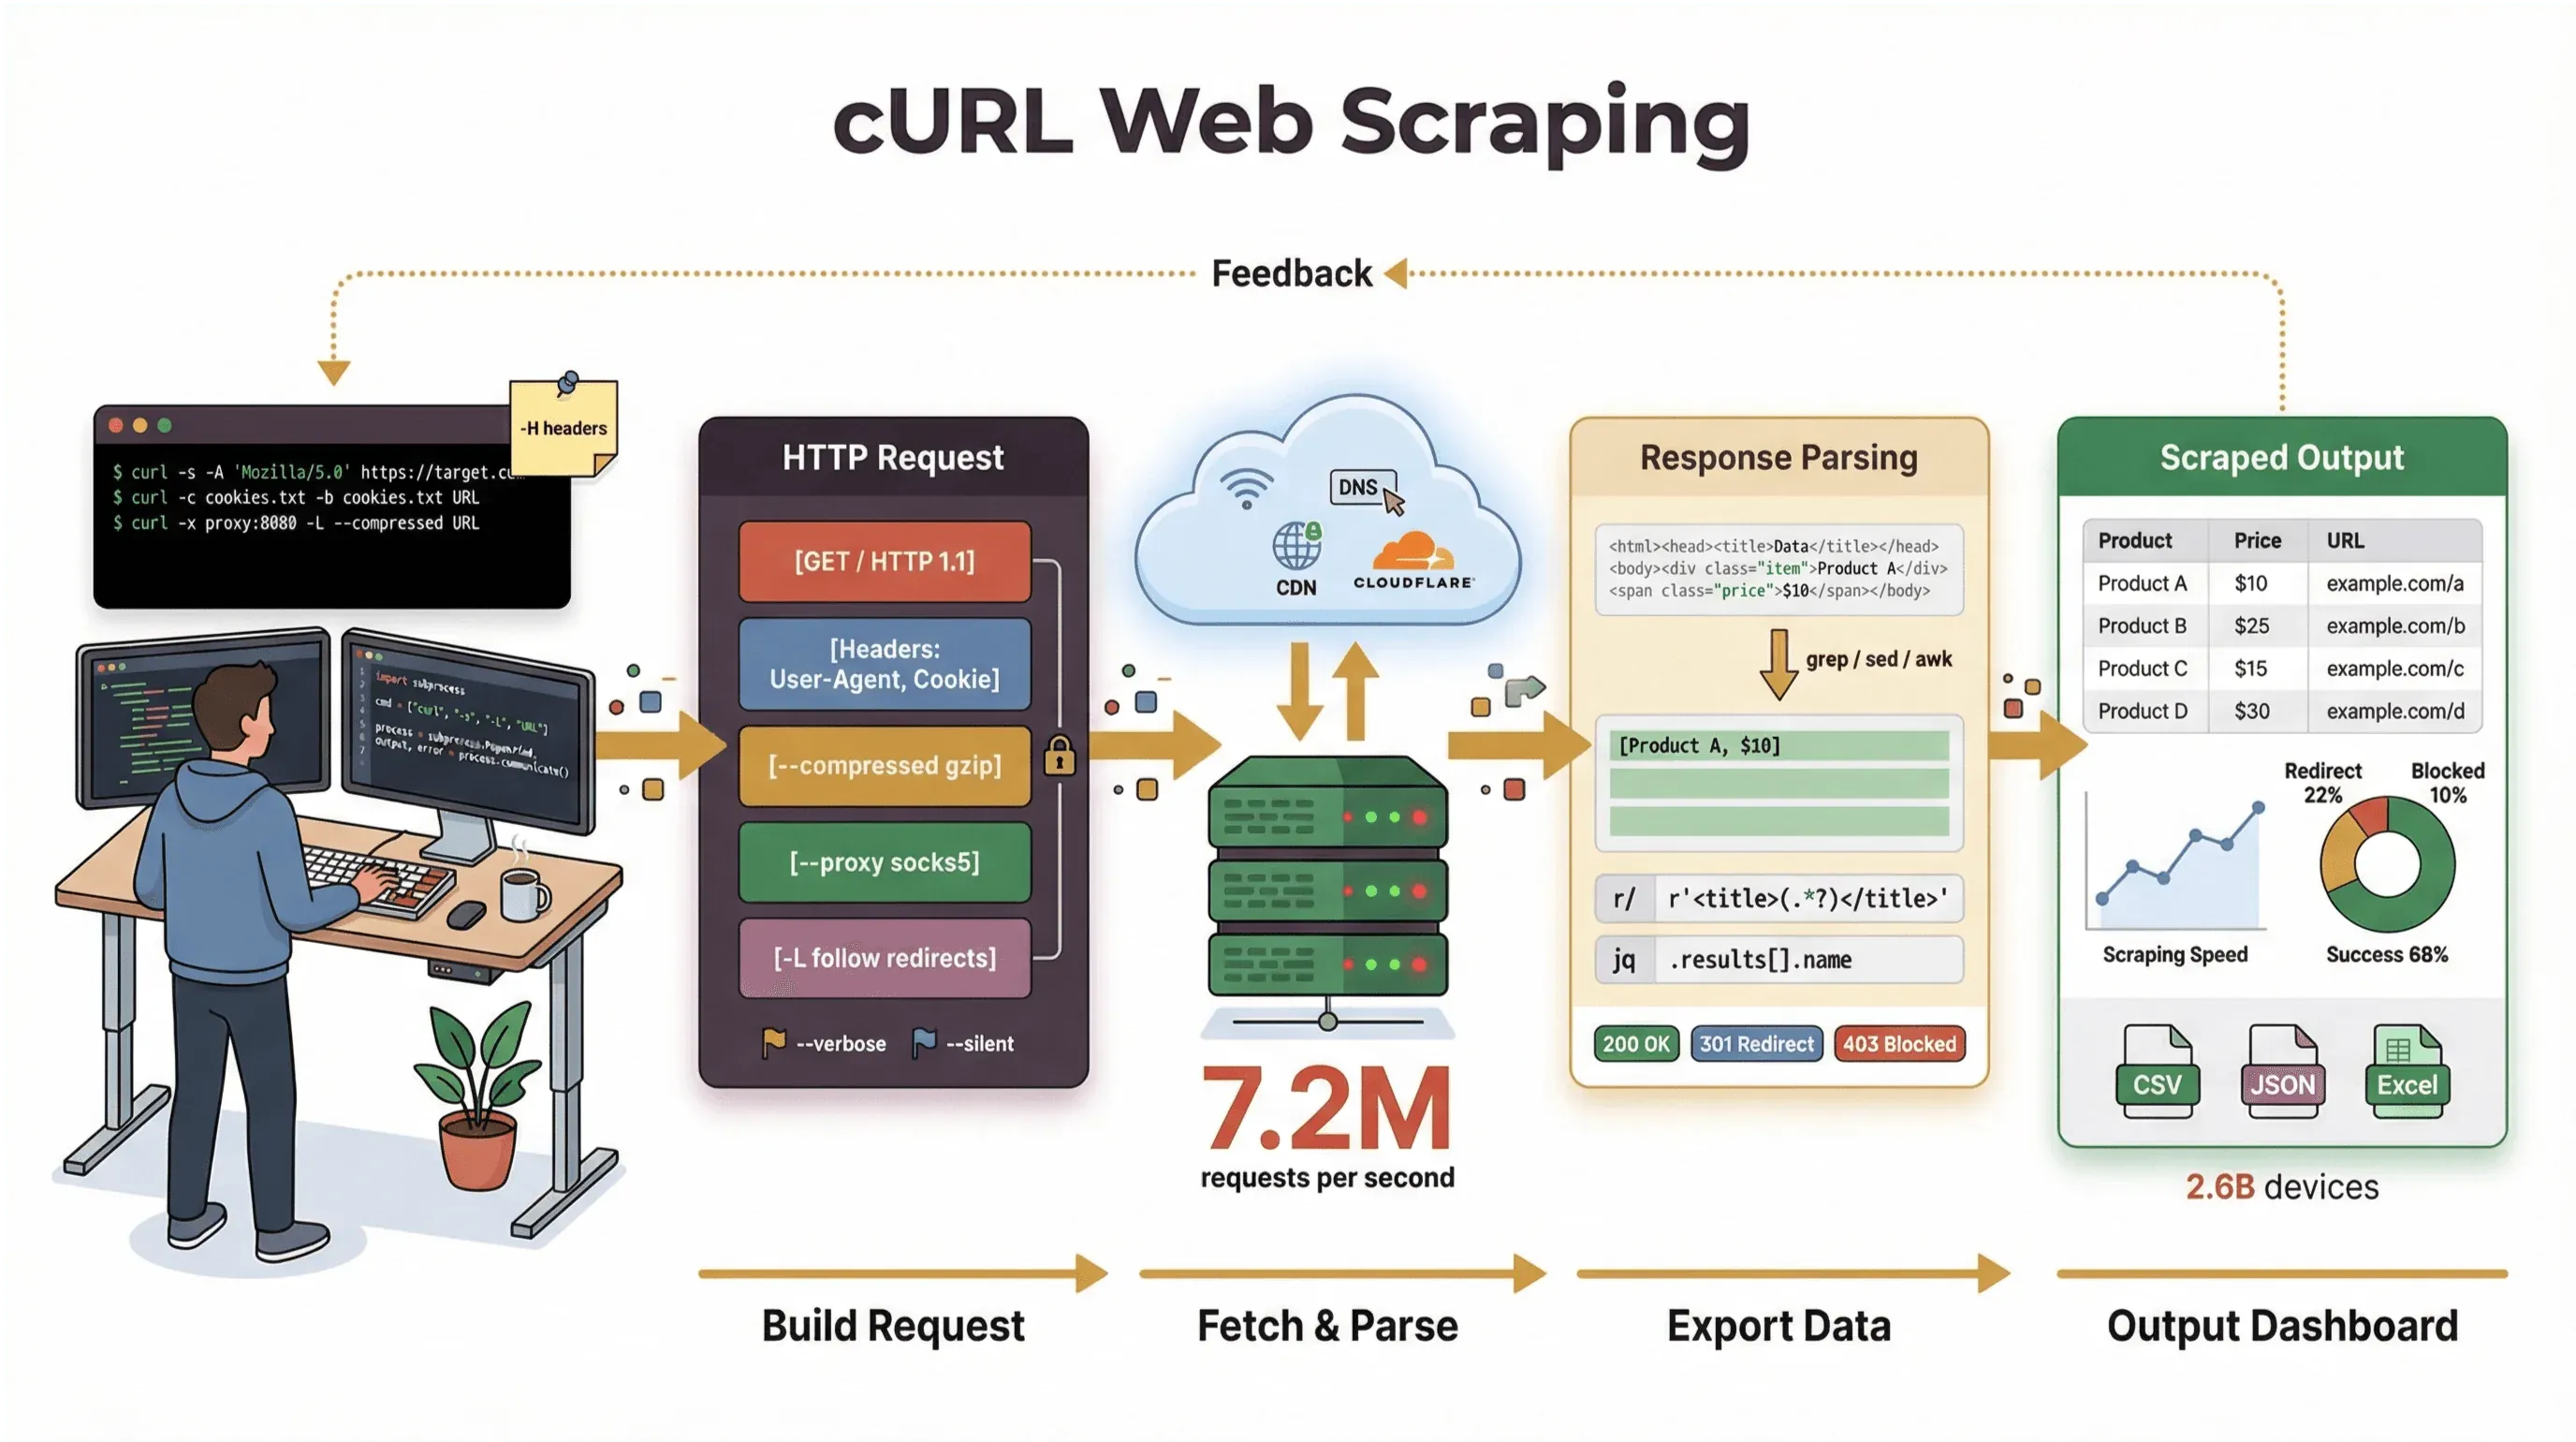 Yıllardır otomasyon araçları geliştiriyor ve ekiplerin web verisini düzenlemesine yardımcı oluyorum; bir sayfayı çekmem, bir API’yi hata ayıklamam ya da bir kazıma iş akışını prototiplemem gerektiğinde hâlâ ilk olarak cURL’e başvuruyorum. Bu rehberde, hem temel bilgileri hem de profesyonel ipuçlarını kapsayan bir cURL web kazıma eğitiminden geçeceğiz — gerçek komut örnekleri, pratik öneriler ve cURL’ün nerede parladığına, nerede duvara tosladığına dair net bir bakışla birlikte. Eğer komut satırına hiç dokunmak istemeyen bir iş kullanıcısıysanız, AI destekli web kazıyıcımız Thunderbit ile “Bu veriye ihtiyacım var” noktasından “İşte çalışma sayfam” noktasına iki tıkta nasıl ulaşabileceğinizi de göstereceğim — kod gerekmez.
Hadi başlayalım ve cURL’ün 2026’da web kazıma için neden hâlâ önemli olduğunu, onu etkili biçimde nasıl kullanacağınızı ve ne zaman daha güçlü bir araca geçmeniz gerektiğini birlikte görelim.
cURL nedir? cURL ile Web Kazımanın Temeli
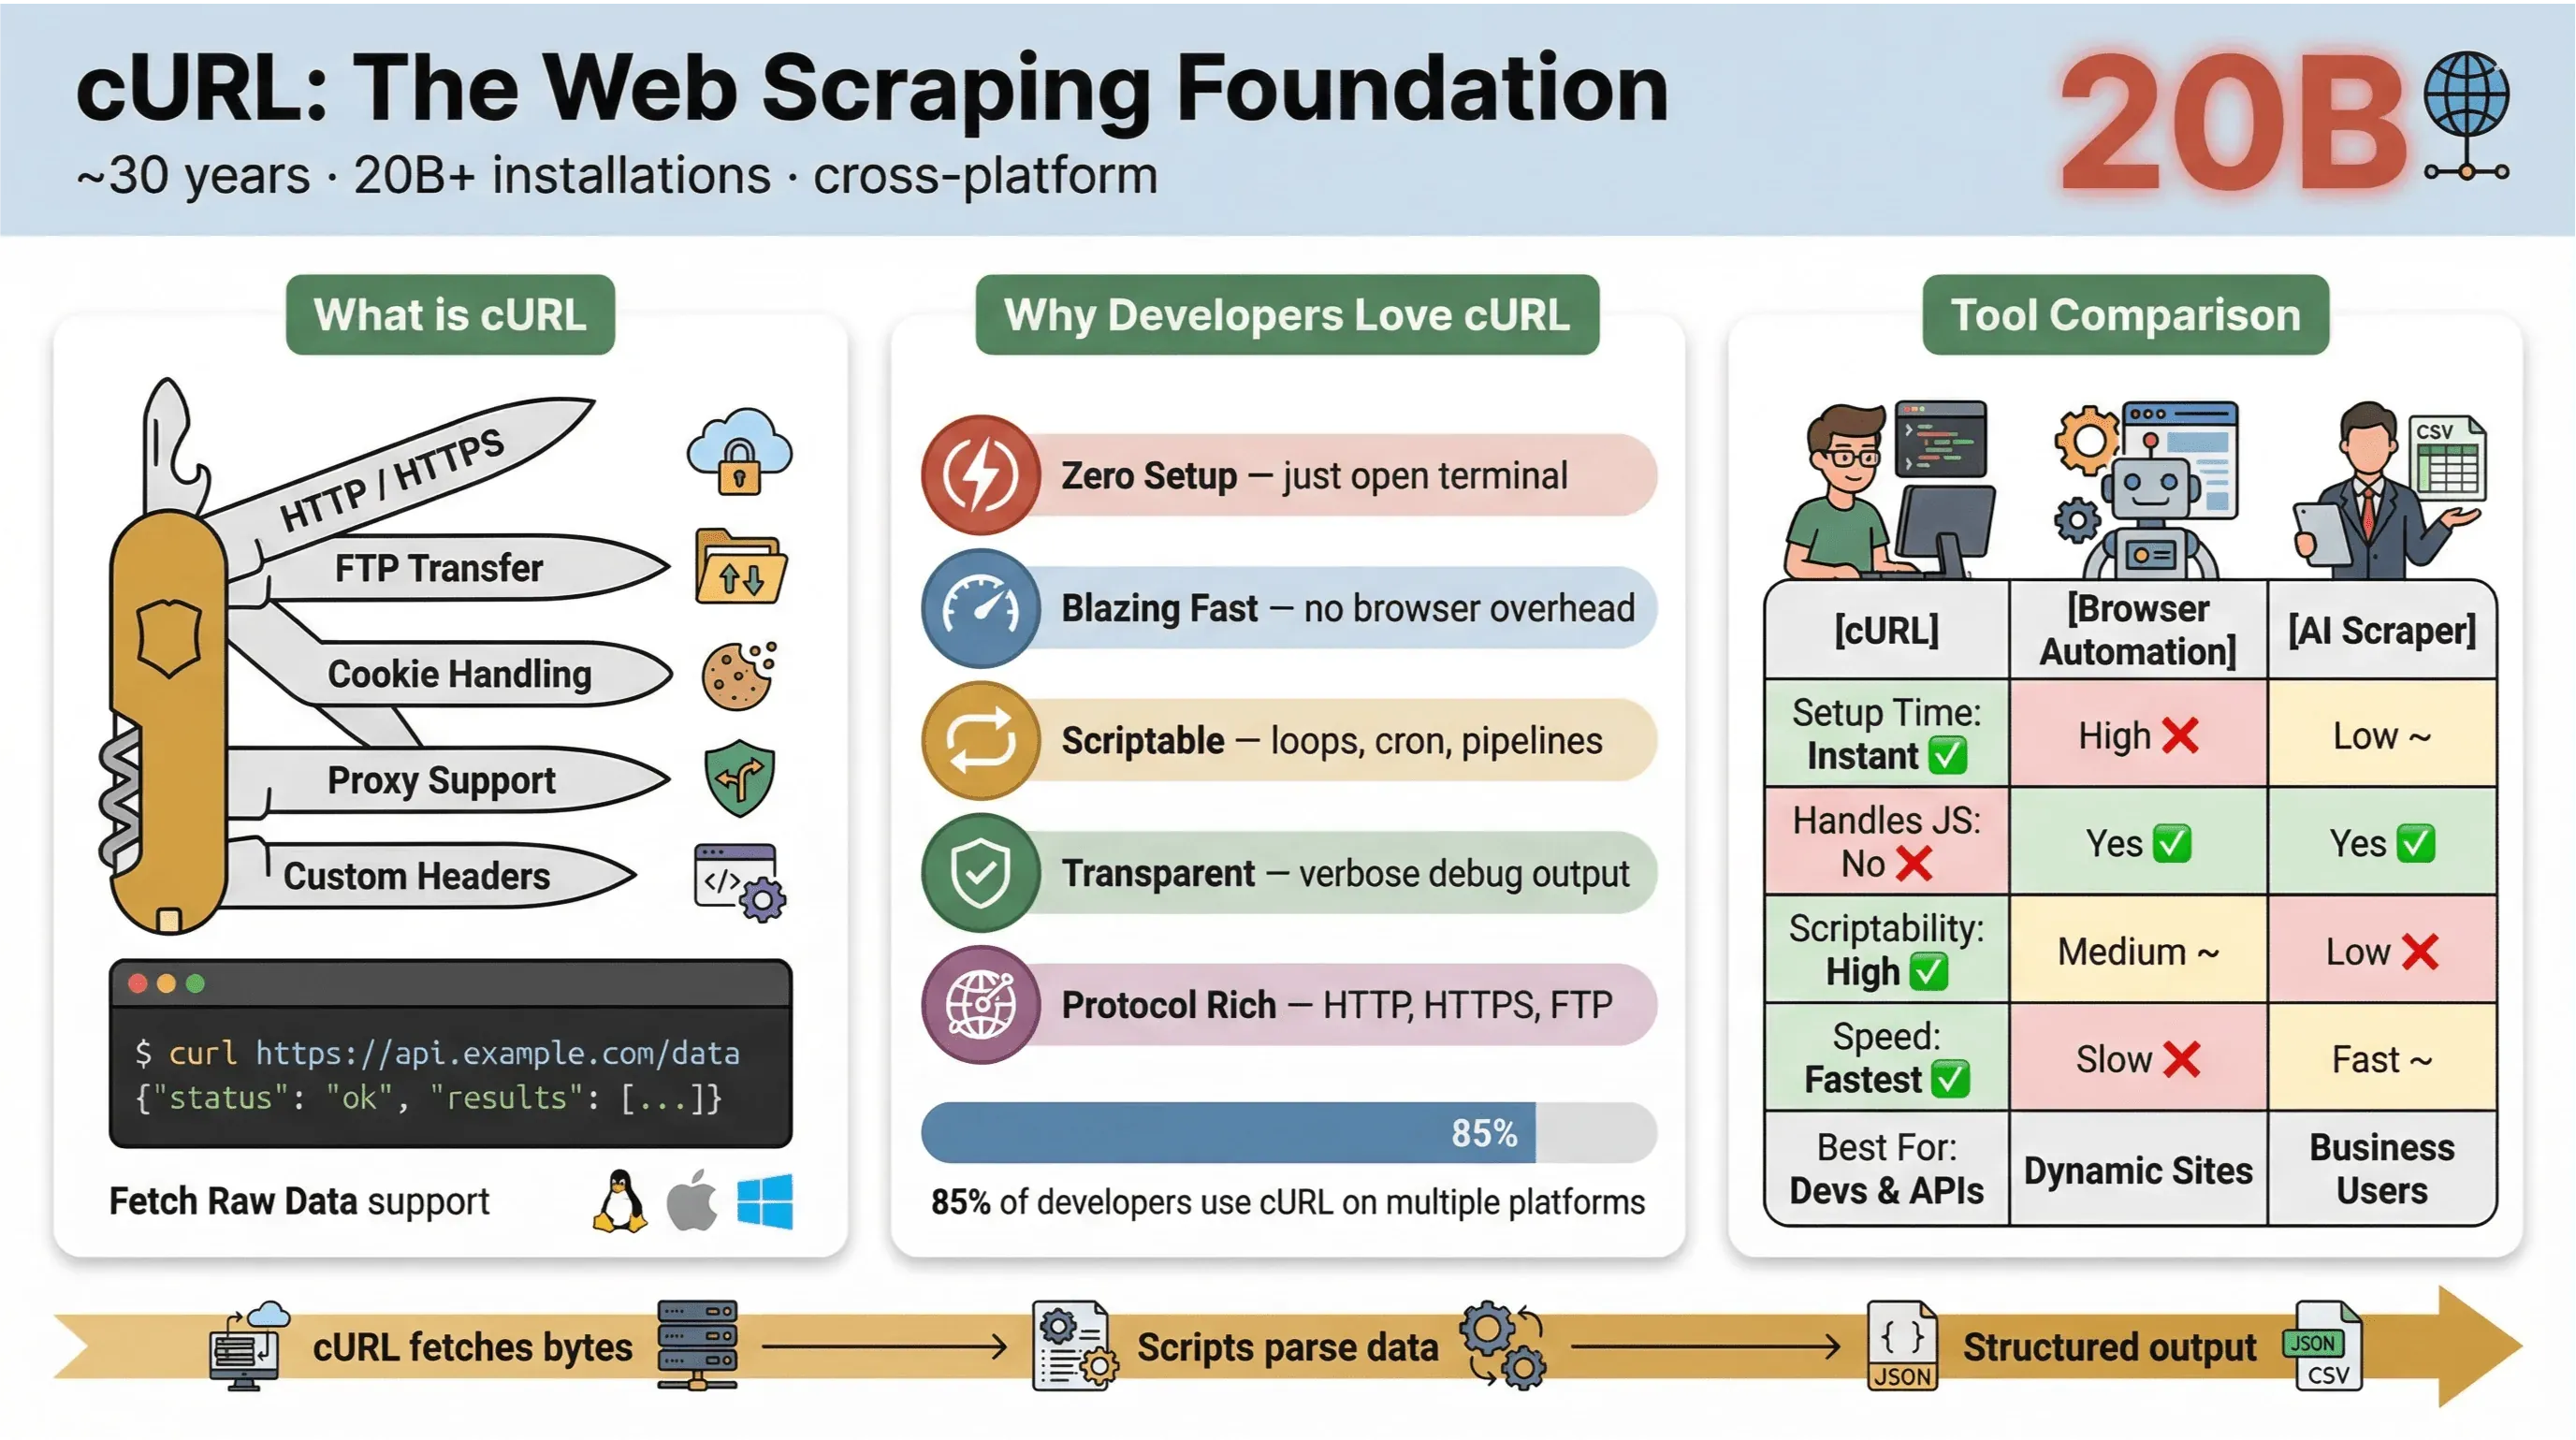
cURL özünde, URL’ler üzerinden veri aktarımı için kullanılan bir komut satırı aracı ve kütüphanedir. Neredeyse 30 yıldır ortalıkta olan bu araç (evet, gerçekten) her yerdedir — işletim sistemlerine gömülü halde, betiklere güç vererek ve yirmi milyardan fazla kurulumu sessizce veri aktarımını yöneterek çalışır. Hiç hızlıca bir web sayfası çekmek, bir API’yi test etmek ya da bir dosya indirmek için komut çalıştırdıysanız, büyük olasılıkla cURL kullanmışsınızdır.
 cURL’ü web kazıma için bu kadar popüler yapan şeyler şunlardır:
- Hafif ve çok platformlu: Linux, macOS, Windows ve hatta gömülü cihazlarda çalışır.
- Protokol desteği: HTTP, HTTPS, FTP ve daha fazlasını destekler.
- Betiklenebilir: Otomasyon, cron işleri ve ara katman kodlar için idealdir.
- Kullanıcı etkileşimi gerektirmez: Etkileşimsiz kullanım için tasarlanmıştır — toplu işler ve işlem hatları için harikadır.
Ama şunu netleştirelim: cURL’ün asıl işi ham veriyi — HTML, JSON, görseller, ne olursa olsun — çekmektir. Bu veriyi sizin için ayrıştırmaz, render etmez ya da yapılandırmaz. cURL’ü web kazımanın “ilk kilometresi” gibi düşünebilirsiniz: baytları size getirir, ama bunları yapılandırılmış bilgiye dönüştürmek için başka araçlara (Python betikleri, grep/sed/awk ya da bir AI web kazıyıcı gibi) ihtiyacınız olur.
Resmî belgeleri görmek isterseniz, cURL’ün HTTP betikleme rehberine göz atabilirsiniz.
Web Kazıma İçin Neden cURL Kullanılır? (curl web scraping tutorial)
Peki geliştiriciler ve teknik kullanıcılar, ortada bunca yeni araç varken neden web kazıma için cURL’e dönüp duruyor? İşte onu öne çıkaran şeyler:
- Minimum kurulum: Yükleme yok, bağımlılık yok — terminali açıp başlayın.
- Hız: Tarayıcının yüklenmesini beklemeden veriyi anında çekin.
- Betiklenebilirlik: URL’ler üzerinde kolayca döngü kurun, istekleri otomatikleştirin ve komutları zincirleyin.
- Protokol ve özellik desteği: Çerezler, proxy’ler, yönlendirmeler, özel başlıklar ve daha fazlasını yönetin.
- Şeffaflık: Ayrıntılı/hata ayıklama çıktısıyla tam olarak ne olduğunu görün.
2025 cURL kullanıcı anketinde katılımcıların %85,7’si cURL komut satırı aracını kullandıklarını, %96,2’si ise Linux üzerinde kullandıklarını bildirdi — bu hâlâ cURL için açık ara en güçlü platform.
--- Hâlâ HTTP istekleri, hızlı veri çekimleri ve sorun giderme için bir İsviçre çakısı.
İşte cURL ile diğer kazıma yöntemlerinin kısa bir karşılaştırması:
| Özellik | cURL | Tarayıcı Otomasyonu (örn. Selenium) | AI Web Scraper (örn. Thunderbit) |
|---|---|---|---|
| Kurulum Süresi | Anında | Yüksek | Düşük |
| Betiklenebilirlik | Yüksek | Orta | Düşük (kod gerekmez) |
| JavaScript’i İşleme | Hayır | Evet | Evet (Thunderbit: tarayıcı üzerinden) |
| Çerez/Oturum Desteği | Manuel | Otomatik | Otomatik |
| Veri Yapılandırma | Manuel (sonradan ayrıştırılır) | Manuel (sonradan ayrıştırılır) | AI/şablon tabanlı |
| En Uygun Olduğu Alan | Geliştiriciler, hızlı çekimler | Karmaşık, dinamik siteler | İş kullanıcıları, yapılandırılmış dışa aktarma |
Kısacası: cURL, özellikle statik sayfalar, API’ler ya da basit iş akışlarını otomatikleştirmek istediğinizde, hızlı ve betiklenebilir veri çekimi için rakipsizdir. Ama karmaşık HTML’yi ayrıştırmanız, JavaScript’i işlemeniz veya yapılandırılmış veri aktarmanız gerektiği anda daha uzman bir şeye geçmek isteyeceksiniz.
Başlarken: Temel cURL Web Kazıma Komutu Örnekleri
Hadi pratiğe geçelim. cURL’ü temel web kazıma görevleri için adım adım nasıl kullanacağınızı gösterelim.
cURL ile Ham HTML Çekme
En basit kullanım senaryosu: bir web sayfasının HTML’ini almak.
curl https://books.toscrape.com/
Bu komut, web kazıma için herkese açık bir demo sitesi olan Books to Scrape ana sayfasını çeker. Terminalinizde ham HTML çıktısını görürsünüz — <title> gibi etiketlere ya da “In stock” gibi parçalara bakın.
Çıktıyı Dosyaya Kaydetme
O HTML’i sonra ayrıştırmak üzere saklamak mı istiyorsunuz? -o bayrağını kullanın:
curl -o page.html https://books.toscrape.com/
Artık tam HTML içeriğini içeren bir page.html dosyanız olur. Bu, daha sonra analiz yapmak ya da başka araçlarla ayrıştırmak için idealdir.
cURL ile POST İsteği Gönderme
Bir form göndermeniz veya bir API ile etkileşmeniz mi gerekiyor? POST istekleri için -d bayrağını kullanın. İşte HTTP testi için tasarlanmış httpbin sitesini kullanan bir örnek:
curl -X POST https://httpbin.org/post -d "key1=value1&key2=value2"
Gönderdiğiniz veriyi geri yansıtan bir JSON yanıtı alırsınız — test ve prototipleme için harika.
Başlıkları İnceleme ve Hata Ayıklama
Bazen yanıt başlıklarını görmek ya da isteği hata ayıklamak istersiniz:
-
Sadece başlıklar (HEAD isteği):
curl -I https://books.toscrape.com/ -
Başlıkları gövdeyle birlikte dahil etme:
curl -i https://httpbin.org/get -
Ayrıntılı/hata ayıklama çıktısı:
curl -v https://books.toscrape.com/
Bu bayraklar, perde arkasında neler olduğunu anlamanıza yardımcı olur — sorun giderme için olmazsa olmazdır.
İşte bu komutlar için hızlı bir başvuru tablosu:
| Görev | Komut Örneği | Notlar |
|---|---|---|
| HTML çekme | curl URL | HTML’yi terminale yazar |
| Dosyaya kaydetme | curl -o dosya.html URL | Çıktıyı dosyaya yazar |
| Başlıkları inceleme | curl -I URL veya curl -i URL | -I yalnızca HEAD içindir, -i başlıkları gövdeyle birlikte dahil eder |
| Form verisiyle POST | curl -d "a=1&b=2" URL | Form kodlu veri gönderir |
| İstek/yanıtı hata ayıklama | curl -v URL | Ayrıntılı istek/yanıt bilgisi gösterir |
Daha fazla örnek için resmî cURL betikleme belgelerine göz atın.
Bir Üst Seviye: cURL ile Gelişmiş Web Kazıma (web-scraping-with-curl)
Temellere alıştıktan sonra, cURL daha karmaşık kazıma görevleri için gelişmiş özellikler dünyasının kapısını açar.
Çerez ve Oturum Yönetimi
Birçok site, giriş oturumlarını korumak ya da kullanıcıları izlemek için çerezlere ihtiyaç duyar. cURL ile çerezleri istekler arasında saklayıp yeniden kullanabilirsiniz:
# Giriş sonrası çerezleri sakla
curl -c cookies.txt https://example.com/login

# Sonraki isteklerde çerezleri kullan
curl -b cookies.txt https://example.com/account
Bu sayede tarayıcı oturumlarını taklit edebilir ve giriş duvarlarının arkasındaki sayfalara erişebilirsiniz (tabii JavaScript tabanlı bir doğrulama yoksa).
User-Agent Taklidi ve Özel Başlıklar
Bazı web siteleri, User-Agent’inize veya başlıklarınıza göre farklı içerik sunar. Varsayılan olarak cURL kendini “curl/VERSION” olarak tanıtır; bu da engellere veya alternatif içeriklere yol açabilir. Bir tarayıcıyı taklit etmek için:
curl -A "Mozilla/5.0 (Windows NT 10.0; Win64; x64)" https://example.com/
Dil tercihleri gibi özel başlıklar da belirleyebilirsiniz:
curl -H "Accept-Language: en-US,en;q=0.9" https://example.com/
Bu, gerçek bir tarayıcının göreceği içeriğe ulaşmanıza yardımcı olur.
Web Kazıma İçin Proxy Kullanma
İsteklerinizi bir proxy üzerinden yönlendirmeniz mi gerekiyor (coğrafi testler ya da IP engellerinden kaçınmak için)? -x bayrağını kullanın:
curl -x http://proxy.example.org:4321 https://remote.example.org/
Yalnızca proxy’leri sorumlu biçimde ve sitenin kullanım şartlarına uygun olarak kullandığınızdan emin olun.
Çok Sayfalı Kazımayı Otomatikleştirme
Sayfalandırılmış ürün listeleri gibi birden fazla sayfayı mı kazımak istiyorsunuz? Basit bir kabuk döngüsü kullanın:
for p in $(seq 2 5); do
  curl -s -o "books-page-${p}.html" \
    "https://books.toscrape.com/catalogue/category/books_1/page-${p}.html"
  sleep 1
done
Bu komut, Books to Scrape kataloğunun 2 ila 5. sayfalarını alır ve her birini ayrı bir dosyaya kaydeder. (1. sayfa ana sayfadır.)
cURL ile Web Kazımanın Sınırları: Bilmeniz Gerekenler
cURL’ü ne kadar sevsem de, o bir sihirli çözüm değil. İşte yetersiz kaldığı noktalar:
- JavaScript çalıştırmaz: cURL, içeriği render etmek veya anti-bot zorluklarını aşmak için JavaScript gerektiren sayfaları işleyemez (developers.cloudflare.com).
- Manuel ayrıştırma gerekir: Ham HTML veya JSON alırsınız, ama bunları kendiniz ayrıştırmanız gerekir — çoğu zaman ek betikler ya da araçlarla.
- Sınırlı oturum yönetimi: Karmaşık girişler, token’lar veya çok adımlı formları yönetmek hızla karmaşıklaşabilir.
- Yerleşik veri yapılandırması yoktur: cURL, web sayfalarını satırlara, tablolara veya çalışma sayfalarına dönüştürmez.
- Anti-bot algılamasına açık: Birçok site artık cURL’ün tek başına aşamayacağı gelişmiş bot savunmaları (JavaScript, parmak izi oluşturma, CAPTCHA’lar) kullanıyor (datadome.co).
İşte kısa bir karşılaştırma tablosu:
| Sınırlama | Yalnızca cURL | Modern Kazıma Araçları (örn. Thunderbit) |
|---|---|---|
| JavaScript Desteği | Hayır | Evet |
| Veri Yapılandırma | Manuel | Otomatik (AI/şablon) |
| Oturum Yönetimi | Manuel | Otomatik |
| Anti-Bot Aşımı | Sınırlı | Gelişmiş (tarayıcı tabanlı/AI) |
| Kullanım Kolaylığı | Teknik | Teknik olmayan kullanıcılar için uygun |
Statik sayfalar ve API’ler için cURL mükemmeldir. Daha dinamik ya da korumalı her şey için araç zincirinde bir üst seviyeye çıkmanız gerekir.
Thunderbit vs. cURL: Teknik Olmayan Kullanıcılar İçin En İyi Web Kazıma Yaklaşımı
Şimdi Thunderbit hakkında konuşalım; bu, AI destekli web kazıyıcı Chrome Uzantımızdır. Eğer satış, pazarlama ya da operasyon tarafında çalışıyor ve komut satırına dokunmadan bir web sitesindeki veriyi Excel, Google Sheets veya Notion’a aktarmak istiyorsanız, Thunderbit tam size göre.
Thunderbit’in cURL ile karşılaştırması şöyle:
| Özellik | cURL | Thunderbit |
|---|---|---|
| Kullanıcı Arayüzü | Komut satırı | Tıklayarak kullanım (Chrome Uzantısı) |
| AI Alan Önerisi | Hayır | Evet (AI sayfayı okur, sütun önerir) |
| Sayfalandırma/Alt Sayfaları İşleme | Manuel betikleme | Otomatik (AI algılar ve kazır) |
| Veri Dışa Aktarma | Manuel (ayrıştır + kaydet) | Doğrudan Excel, Google Sheets, Notion, Airtable |
| JavaScript/Korumalı Sayfalar | Hayır | Evet (tarayıcı tabanlı kazıma) |
| Kod Gerektirmez | Hayır (betik gerekir) | Evet (herkes kullanabilir) |
| Ücretsiz Katman | Her zaman ücretsiz | 6 sayfaya kadar ücretsiz (deneme desteğiyle 10) |
Thunderbit ile yalnızca uzantıyı açar, “AI Alan Öner”e tıklar ve AI’nın hangi veriyi çekeceğini belirlemesine izin verirsiniz. Tablo, liste, ürün ayrıntıları ve hatta alt sayfaları otomatik olarak ziyaret ederek kazıyabilirsiniz. Ardından verinizi doğrudan favori iş araçlarınıza aktarabilirsiniz — ayrıştırma yok, baş ağrısı yok.
Thunderbit, dünya çapında 100.000’den fazla kullanıcı tarafından güvenle kullanılıyor ve özellikle hızlı biçimde yapılandırılmış veri ihtiyacı olan satış, e-ticaret ve gayrimenkul ekipleri arasında oldukça popüler.
Web Kazıma için Thunderbit Chrome Uzantısını Deneyin
Denemek ister misiniz? Chrome Uzantısını buradan indirin.
cURL ve Thunderbit’i Birleştirmek: Esnek Web Kazıma Stratejileri
Teknik bir kullanıcıysanız, yalnızca bir araç seçmek zorunda değilsiniz. Hatta pek çok ekip, maksimum esneklik için cURL ve Thunderbit’i birlikte kullanır:
- cURL ile prototipleme: Uç noktaları hızlıca test etmek, başlıkları incelemek ve bir sitenin nasıl yanıt verdiğini anlamak için cURL kullanın.
- Thunderbit ile ölçeklendirme: Yapılandırılmış veriye, çok sayfalı kazımaya veya tekrarlanabilir bir iş akışına ihtiyacınız olduğunda, tıklayarak çıkarım ve doğrudan dışa aktarma için Thunderbit’e geçin.
Pazar araştırması için örnek bir iş akışı şöyle olabilir:
- Birkaç sayfayı çekmek ve HTML yapısını incelemek için cURL kullanın.
- İstediğiniz veri alanlarını belirleyin (ör. ürün adları, fiyatlar, yorumlar).
- Thunderbit’i açın, “AI Alan Öner”e tıklayın ve AI’nın kazıyıcıyı kurmasına izin verin.
- Tüm sayfaları (alt sayfalar veya sayfalandırılmış listeler dahil) kazıyın ve Google Sheets’e aktarın.
- Verinizi analiz edin, paylaşın ve aksiyon alın — manuel ayrıştırma gerekmez.
İşte hızlı bir karar tablosu:
| Senaryo | cURL Kullan | Thunderbit Kullan | İkisini Birlikte Kullan |
|---|---|---|---|
| Hızlı API veya statik sayfa çekimi | ✅ | ||
| Çalışma sayfasında yapılandırılmış veri gerekli | ✅ | ||
| Başlıkları/çerezleri hata ayıklama | ✅ | ||
| Dinamik/JS ağırlıklı sayfaları kazıma | ✅ | ||
| Tekrarlanabilir, kodsuz bir iş akışı oluşturma | ✅ | ||
| Prototipleme, ardından ölçeklendirme | ✅ | ✅ | Hibrit iş akışı |
cURL ile Web Kazımada Yaygın Zorluklar ve Tuzaklar
cURL’ü ne kadar kullansanız da, gerçek dünyada karşılaşacağınız bazı zorluklar var:
- Anti-bot sistemleri: Birçok site artık cURL’ün aşamayacağı gelişmiş savunmalar (JavaScript meydan okumaları, CAPTCHA’lar, parmak izi oluşturma) kullanıyor (developers.cloudflare.com).
- Veri kalitesi sorunları: HTML değişiklikleri, eksik alanlar veya tutarsız düzenler betiklerinizi bozabilir.
- Bakım yükü: Bir site her değiştiğinde ayrıştırma mantığınızı güncellemeniz gerekir.
- Hukuki ve uyumluluk riskleri: Kazımadan önce her zaman sitenin kullanım şartlarını, robots.txt dosyasını ve ilgili yasaları kontrol edin. Verinin herkese açık olması, onu kullanmakta özgür olduğunuz anlamına gelmez (calawyers.org, polsinelli.com).
- Ölçek sınırları: cURL küçük işler için harikadır; ancak büyük ölçekli kazıma için proxy’leri, hız sınırlarını ve hata yönetimini kontrol etmeniz gerekir.
Sorun giderme ve uyumlu kalma ipuçları:
- Her zaman izin verilmiş ya da demo sitelerle başlayın (ör. Books to Scrape).
- Hız sınırlarına uyun — uç noktalara yüklenmeyin.
- Yasal bir dayanağınız yoksa kişisel veri kazımaktan kaçının.
- JavaScript veya CAPTCHA duvarlarına takılırsanız, Thunderbit gibi tarayıcı tabanlı bir araca geçmeyi düşünün.
Adım Adım Özet: cURL ile Web Siteleri Nasıl Kazınır
İşte cURL ile web kazıma için hızlı başvuru kontrol listeniz:
- Hedef URL(ler)i belirleyin: Statik bir sayfa veya API uç noktasıyla başlayın.
- Sayfayı çekin:
curl URL - Çıktıyı bir dosyaya kaydedin:
curl -o dosya.html URL - Başlıkları inceleyin/hata ayıklayın:
curl -I URL,curl -v URL - POST verisi gönderin:
curl -d "a=1&b=2" URL - Çerezleri/oturumları yönetin:
curl -c cookies.txt ...,curl -b cookies.txt ... - Özel başlıklar/User-Agent ayarlayın:
curl -A "..." -H "..." URL - Yönlendirmeleri takip edin:
curl -L URL - Proxy kullanın (gerekirse):
curl -x proxy:port URL - Çok sayfalı kazımayı otomatikleştirin: Kabuk döngüleri veya betikler kullanın.
- Veriyi ayrıştırın ve yapılandırın: Gerektikçe ek araçlar/betikler kullanın.
- Yapılandırılmış, kodsuz kazıma veya dinamik sayfalar için Thunderbit’e geçin.
Sonuç ve Temel Çıkarımlar: Doğru Web Kazıma Aracını Seçmek
Yapay zekâ ile herhangi bir web sitesinden veri kazıyın Get Started Free
cURL ile web kazıma, 2026’da teknik kullanıcılar için hâlâ güçlü bir beceri — özellikle hızlı veri çekimleri, prototipleme ve otomasyon için. cURL’ün hızı, betiklenebilirliği ve her yerde bulunması, onu her geliştiricinin araç setinde temel bir araç yapıyor. Ancak web daha dinamik ve daha korumalı hale geldikçe, iş kullanıcıları da kod yazmadan yapılandırılmış veri talep ettikçe, Thunderbit gibi araçlar nelerin mümkün olduğunu yeniden tanımlıyor.
Temel çıkarımlar:
- Statik sayfalar, API’ler ve hızlı prototipleme için cURL kullanın — özellikle tam kontrol istediğinizde.
- Yapılandırılmış veri, dinamik/JavaScript ağırlıklı sayfalar veya kodsuz, iş dostu bir iş akışı gerektiğinde Thunderbit’e (veya benzer AI web kazıyıcılara) geçin.
- Maksimum esneklik için ikisini birleştirin: cURL ile prototipleyin, Thunderbit ile ölçeklendirin ve yapılandırın.
- Her zaman sorumlu biçimde kazıyın — site şartlarına, hız sınırlarına ve yasal sınırlarına saygı gösterin.
Web kazımanın ne kadar kolay olabileceğini merak ediyor musunuz? Thunderbit’in ücretsiz Chrome Uzantısını deneyin ve AI destekli veri çıkarımını kendiniz deneyimleyin. Daha derine inmek isterseniz, daha fazla eğitim, ipucu ve sektör içgörüsü için Thunderbit Blog sayfasına göz atın. Şunları da beğenebilirsiniz:
- Yapay Zekâ Kullanarak Herhangi Bir Web Sitesi Nasıl Kazınır
- Yapay Zekâ Kullanarak Web Sitesi Verisi Excel’e Nasıl Kazınır
- Veri Kazıma Nedir ve 2025’te Nasıl Yapılır
Keyifli kazımalar — veriniz her zaman temiz, yapılandırılmış ve yalnızca bir komut (veya tık) kadar yakın olsun.
Ölçeklenebilir Web Kazıma için Thunderbit Paketlerini İnceleyin
SSS
1. cURL, JavaScript ile oluşturulan web sayfalarını işleyebilir mi?
Hayır, cURL JavaScript çalıştıramaz. Sunucunun sunduğu ham HTML’yi çeker. Bir sayfanın içeriği render etmek veya anti-bot zorluklarını çözmek için JavaScript’e ihtiyacı varsa, cURL veriye erişemez. Bu tür durumlarda Thunderbit gibi tarayıcı tabanlı araçları kullanın.
2. cURL çıktısını doğrudan bir dosyaya nasıl kaydederim?
-o bayrağını kullanın: curl -o dosyaadi.html URL. Bu, yanıt gövdesini terminalde göstermek yerine bir dosyaya yazar.
3. Web kazıma için cURL ile Thunderbit arasındaki fark nedir?
cURL, ham web verisini çekmek için kullanılan bir komut satırı aracıdır — teknik kullanıcılar ve otomasyon için uygundur. Thunderbit ise herhangi bir web sitesinden yapılandırılmış veri çıkarmak, dinamik sayfaları işlemek ve Excel ya da Google Sheets gibi araçlara doğrudan aktarmak isteyen iş kullanıcıları için tasarlanmış AI destekli bir Chrome Uzantısıdır — kod gerekmez.
4. cURL ile web kazımak yasal mı?
Herkese açık verileri kazımak, son mahkeme kararlarından sonra ABD’de genel olarak yasaldır; ancak yine de sitenin kullanım şartlarını, robots.txt dosyasını ve ilgili yasaları kontrol etmelisiniz. İzin olmadan kişisel veya korunan verileri kazımaktan kaçının ve hız sınırlarına ile etik kurallara uyun (calawyers.org, polsinelli.com).
5. cURL’den ne zaman Thunderbit gibi daha gelişmiş bir araca geçmeliyim?
Dinamik/JavaScript ağırlıklı sayfaları kazımanız gerekiyorsa, çalışma sayfasında yapılandırılmış veri istiyorsanız veya kodsuz bir iş akışını tercih ediyorsanız Thunderbit daha iyi seçimdir. Hızlı ve teknik işler için cURL’ü; iş dostu, tekrarlanabilir veri çıkarımı için Thunderbit’i kullanın.
Daha fazla web kazıma ipucu ve eğitimi için Thunderbit Blog sayfasını ziyaret edin veya YouTube Kanalımıza göz atın.
Thunderbit Yapay Zekâ Web Kazıyıcısını Deneyin Get Started Free



