
Son zamanlarda “Python ile IMDb’yi kazıma” diye arattıysanız muhtemelen bir şey fark etmişsinizdir: Bulduğunuz eğitimlerin çoğu bozuk. “Biraz eski” bozuk değil — daha çok “sıfır sonuç dönüyor ve NoneType hataları sağanağa dönüşmüş” seviyesinde bozuk.
Son birkaç haftayı bulabildiğim tüm büyük IMDb kazıma eğitimlerini test ederek geçirdim — GeeksforGeeks, Medium, freeCodeCamp, Kaggle notebook’ları, aklınıza ne gelirse. IMDb kazıma için etiketlenmiş 214’ten fazla herkese açık GitHub deposu içinde büyük çoğunluk, IMDb’nin Top 250 sayfasını Haziran 2023’te yeniden tasarlamasından beri var olmayan CSS seçicilere (td.titleColumn, td.ratingColumn) referans veriyor. Sonuç mu? Forumlarda “kodum neden boş dönüyor?” diye soran geliştiriciler ve Cinemagoer’in kabul ettiği gibi popüler kütüphane bakımcıları: “Tüm ayıklayıcıları tek tek düzeltmek dışında yapabileceğimiz pek bir şey yok.” Bu rehber, şu anda gerçekten çalışan iki Python yöntemini, sayfalama ve yaygın hataları nasıl yöneteceğinizi, Python’un ne zaman doğru araç olmadığını ve kazıyıcınızı mezarlığa katılmayacak şekilde nasıl geleceğe hazırlayacağınızı anlatıyor.
Python ile IMDb’yi Kazımak Ne Demek?
Web kazıma, web sayfalarından veriyi programlı olarak çıkarma sürecidir — elle kopyala-yapıştır yapmak yerine bunu sizin için yapan bir script yazarsınız. “IMDb’yi kazımak” derken, Python kullanarak IMDb sayfalarından yapılandırılmış film verilerini (başlıklar, puanlar, türler, oyuncular, süre, oy sayıları) çekmeyi kastediyoruz.
Bunun için tipik Python yığını üç kütüphaneden oluşur: requests (web sayfasını çekmek için), BeautifulSoup (HTML’yi ayrıştırıp veriyi bulmak için) ve pandas (sonuçları düzenlemek ve dışa aktarmak için). Bazı eğitimler, JavaScript render gerektiren sayfalar için Selenium ya da Playwright da kullanır; ancak birazdan göreceğiniz gibi, daha hızlı yaklaşımlar var.
Önemli bir not: Bu rehberdeki her şey, IMDb’nin 2025 ortası itibarıyla geçerli olan mevcut sayfa yapısına göre doğrulanmıştır. IMDb yaklaşık her 6–12 ayda bir değişiklik yapıyor; bu yüzden bunu 2027’de okuyorsanız bazı seçiciler değişmiş olabilir. (Bununla nasıl başa çıkacağınızı da anlatacağım.)
Neden Python ile IMDb Kazımalısınız? Gerçek Kullanım Senaryoları
Tek satır kod yazmadan önce, IMDb verisiyle gerçekte ne yapacaksınız? Cevap, kim olduğunuza bağlı.
IMDb inceleme veri kümesi, dünyada en yaygın kullanılan NLP ölçütlerinden biridir — Maas ve arkadaşlarının (2011) temel çalışması 5.706 atıf topladı ve veri kümesi TensorFlow, Keras ve PyTorch’a gömülü halde geliyor. Hugging Face’te stanfordnlp/imdb veri kümesi ayda 213.321 kez indiriliyor ve 1.500’den fazla modeli eğitmek için kullanıldı. Yani makine öğrenmesi alanındaysanız, IMDb verisine muhtemelen zaten aşinasınızdır.
Ama kullanım alanları akademiyle sınırlı değil:
| Kullanım Alanı | Kimler İçin | Gerekli Veri Alanları |
|---|---|---|
| Film öneri motoru | Veri bilimcileri, hobi amaçlı çalışanlar | Başlıklar, türler, puanlar, oyuncular |
| Yayın platformu içerik stratejisi | Ürün/içerik ekipleri | Puanlar, oy sayıları, çıkış yılı, türler |
| Duygu analizi / NLP eğitimi | ML araştırmacıları, öğrenciler | İncelemeler, puanlar |
| Rekabetçi içerik analizi | Eğlence sektörü analistleri | Gişe, çıkış tarihleri, puan trendleri |
| Film turizmi araştırması | Turizm kurulları, seyahat şirketleri | Çekim yerleri, popülerlik metrikleri |
| Akademik araştırma | Üniversite araştırmacıları | Her türlü yapılandırılmış film meta verisi |
Sadece film turizmi pazarı bile 2025’te küresel ölçekte tahminen 66 milyar dolar değerinde. Netflix, 2024’te içerik için 17 milyar doların üzerinde harcama yaptı ve izleyici etkinliğinin %80’i kişiselleştirilmiş öneriler tarafından yönlendirildi. Kısacası: IMDb verisi, sektörler arasında gerçek kararları besliyor.
IMDb Verisini Elde Etme Seçenekleriniz (Bir Satır Kod Yazmadan Önce)
Bu bölüm, çoğu eğitimin tamamen atladığı kısım. Python ile kazımaya, bunun sizin durumunuz için doğru yaklaşım olup olmadığını sormadan doğrudan pip install beautifulsoup4 ile atlıyorlar.
İşte tam tablo:
| Yol | Kimler İçin En Uygun | Artıları | Eksileri |
|---|---|---|---|
| Python + BeautifulSoup | Öğrenme, özel çıkarım | Tam kontrol, esnek | Kırılgan seçiciler, sık bozulur |
JSON-LD / __NEXT_DATA__ çıkarımı | Stabilite isteyen geliştiriciler | JS içeriğini işler, daha dayanıklı | JSON yapısını anlamak gerekir |
| IMDb Resmî Veri Kümeleri | Büyük ölçekli analiz, akademik kullanım | Yasal, eksiksiz, 26M+ başlık, günlük güncelleme | TSV formatı, yorum/görsel yok |
| Cinemagoer (IMDbPY) kütüphanesi | Programatik tekil başlık sorguları | Python’a uygun API, zengin alanlar | 88 açık sorun, son sürüm Mayıs 2023 |
| TMDb API | Film meta verisi + görseller | Ücretsiz API anahtarı, JSON, iyi dokümante edilmiş | Farklı kaynak (IMDb puanları değil) |
| Thunderbit (kodsuz) | Kod yazmayanlar, hızlı dışa aktarma | 2 tıkla kazıma, AI alanları önerir, Excel/Sheets’e aktarır | Büyük işlemler için kredi bazlı |
Bu seçeneklerle ilgili birkaç not. Cinemagoer’in PyPI sürümü Mayıs 2023’ten beri yayınlanmadı ve IMDb’nin Haziran 2025 yeniden tasarımından sonra ayrıştırıcılarının çoğu bozuldu — şu anda üretim kullanımına önermem. TMDb mükemmel ama kendi puan sistemini kullanıyor, IMDb’ninkini değil. IMDb’nin resmî kurumsal API’si ise AWS Data Exchange üzerinden yıllık 50.000 doların üzerinde maliyete sahip; dolayısıyla çoğumuz için seçenek değil.
Hiç kod yazmak istemeyen okurlar için, Thunderbit’in AI web kazıyıcısı IMDb sayfasını okur, çıkarım alanlarını otomatik önerir (başlık, puan, yıl, tür) ve veriyi iki tıkla Excel, Google Sheets, Airtable veya Notion’a aktarır. IMDb düzenini değiştirdiğinde AI uyum sağlar; dolayısıyla bakımı yapılacak seçici yoktur. Buna birazdan döneceğiz.
Şimdi Python yazmak isteyenler için — çalışan iki yöntem var.
Yöntem 1: BeautifulSoup Kullanarak Python ile IMDb Kazıma (Geleneksel Yaklaşım)
Bu, çoğu eğitimde bulacağınız klasik yaklaşımdır. Çalışır; ama açık konuşayım: ele alacağım yöntemler içinde en kırılgan olanıdır. IMDb’nin CSS sınıf adları otomatik üretilir ve yeniden tasarımlarla değişir. Yine de web kazımanın temellerini öğrenmek için en iyi yoldur.
1. Adım: Python Kütüphanelerinizi Kurun ve İçeri Aktarın
Dört pakete ihtiyacınız var:
pip install requests beautifulsoup4 pandas lxml
Her biri ne yapar:
requests— web sayfasını çekmek için HTTP istekleri gönderirbeautifulsoup4— HTML’yi ayrıştırır, böylece belirli öğeleri arayabilirsinizpandas— çıkarılan veriyi tablolara düzenler ve CSV/Excel’e aktarırlxml— hızlı bir HTML ayrıştırıcısıdır (BeautifulSoup bunu arka uç olarak kullanabilir)
İçeri aktarma bloğunuz:
import requests
from bs4 import BeautifulSoup
import pandas as pd
2. Adım: IMDb’ye Bir HTTP İsteği Gönderin
Yeni başlayanların çoğu ilk duvara burada tosluyor. IMDb, uygun bir User-Agent başlığı içermeyen istekleri engeller — 403 Forbidden hatası alırsınız. Python Requests’in varsayılan user-agent dizesi (python-requests/2.31.0) anında işaretlenir.
url = "https://www.imdb.com/chart/top/"
headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36",
    "Accept-Language": "en-US,en;q=0.9"
}

response = requests.get(url, headers=headers)

if response.status_code != 200:
    print(f"Sayfa alınamadı: {response.status_code}")
else:
    print("Sayfa başarıyla alındı")
Accept-Language başlığı da önemlidir — bu başlık olmadan IMDb, IP’nizin coğrafi konumuna göre farklı bir dilde içerik döndürebilir.
3. Adım: HTML’yi BeautifulSoup ile Ayrıştırın
HTML’yi aldıktan sonra bir BeautifulSoup nesnesi oluşturun ve doğru öğeleri aramaya başlayın. Chrome’da IMDb Top 250 sayfasını açın, bir film başlığında sağ tıklayın ve altında yatan HTML yapısını görmek için “İncele”yi seçin.
soup = BeautifulSoup(response.text, "lxml")
2025 ortası itibarıyla Top 250 sayfası şu seçicileri kullanıyor:
- Film kapsayıcısı:
li.ipc-metadata-list-summary-item - Başlık:
h3.ipc-title__text - Yıl:
span.cli-title-metadata-item(ilk span) - Puan:
span.ipc-rating-star--rating
Uyarı: Baştaki ipc- sınıf adları IMDb’nin bileşen sistemi tarafından üretilir. Haziran 2023 yeniden tasarımından beri stabiller, ama tekrar değişmeyeceklerinin garantisi yok.
4. Adım: Film Verisini Çıkarın (Başlık, Yıl, Puan)
Burada çoğu eğitimden farklı davranıyorum: try/except hata yönetimi ekliyorum. İncelediğim rakip rehberlerin hiçbiri bunu yapmıyor; bu yüzden seçici değiştiğinde kodları sessizce bozuluyor.
movies = []
movie_items = soup.select("li.ipc-metadata-list-summary-item")

for item in movie_items:
    try:
        title_tag = item.select_one("h3.ipc-title__text")
        title = title_tag.text.strip() if title_tag else "N/A"

        year_tag = item.select_one("span.cli-title-metadata-item")
        year = year_tag.text.strip() if year_tag else "N/A"

        rating_tag = item.select_one("span.ipc-rating-star--rating")
        rating = rating_tag.text.strip() if rating_tag else "N/A"

        movies.append({
            "title": title,
            "year": year,
            "rating": rating
        })
    except Exception as e:
        print(f"Film ayrıştırılırken hata: {e}")
        continue

print(f"{len(movies)} film çıkarıldı")
5. Adım: Pandas ile CSV veya Excel’e Kaydedin
df = pd.DataFrame(movies)
df.to_csv("imdb_top_250.csv", index=False)
df.to_excel("imdb_top_250.xlsx", index=False)
print(df.head())
Örnek çıktı:
                          title  year rating
0  1. The Shawshank Redemption  1994    9.3
1           2. The Godfather    1972    9.2
2     3. The Dark Knight        2008    9.0
3  4. The Godfather Part II     1974    9.0
4         5. 12 Angry Men       1957    9.0
Çalışıyor. Ama bir gün bozulabilecek CSS seçicilere dayanıyor — bu da bizi gerçekten önerdiğim yaklaşıma getiriyor.
Yöntem 2: JSON-LD Triki — HTML Ayrıştırmayı Tamamen Atlayın
Bu, rakip makalelerin hiçbirinin anlatmadığı ve ciddi bir proje için benim kullanacağım tekniktir. IMDb, her sayfada <script type="application/ld+json"> etiketleri içinde yapılandırılmış veriyi JSON-LD (Linked Data için JavaScript Object Notation) olarak gömer. Bu veri Schema.org standardını takip eder, Google tarafından zengin arama sonuçları için kullanılır ve CSS sınıf adlarına göre çok daha seyrek değişir.
Üretim düzeyinde bir araç olan Apify IMDb Scraper, çıkarım önceliğini şu sırayla kullanır: “JSON-LD > NEXT_DATA > DOM.” Ben de önereceğim hiyerarşi bu.
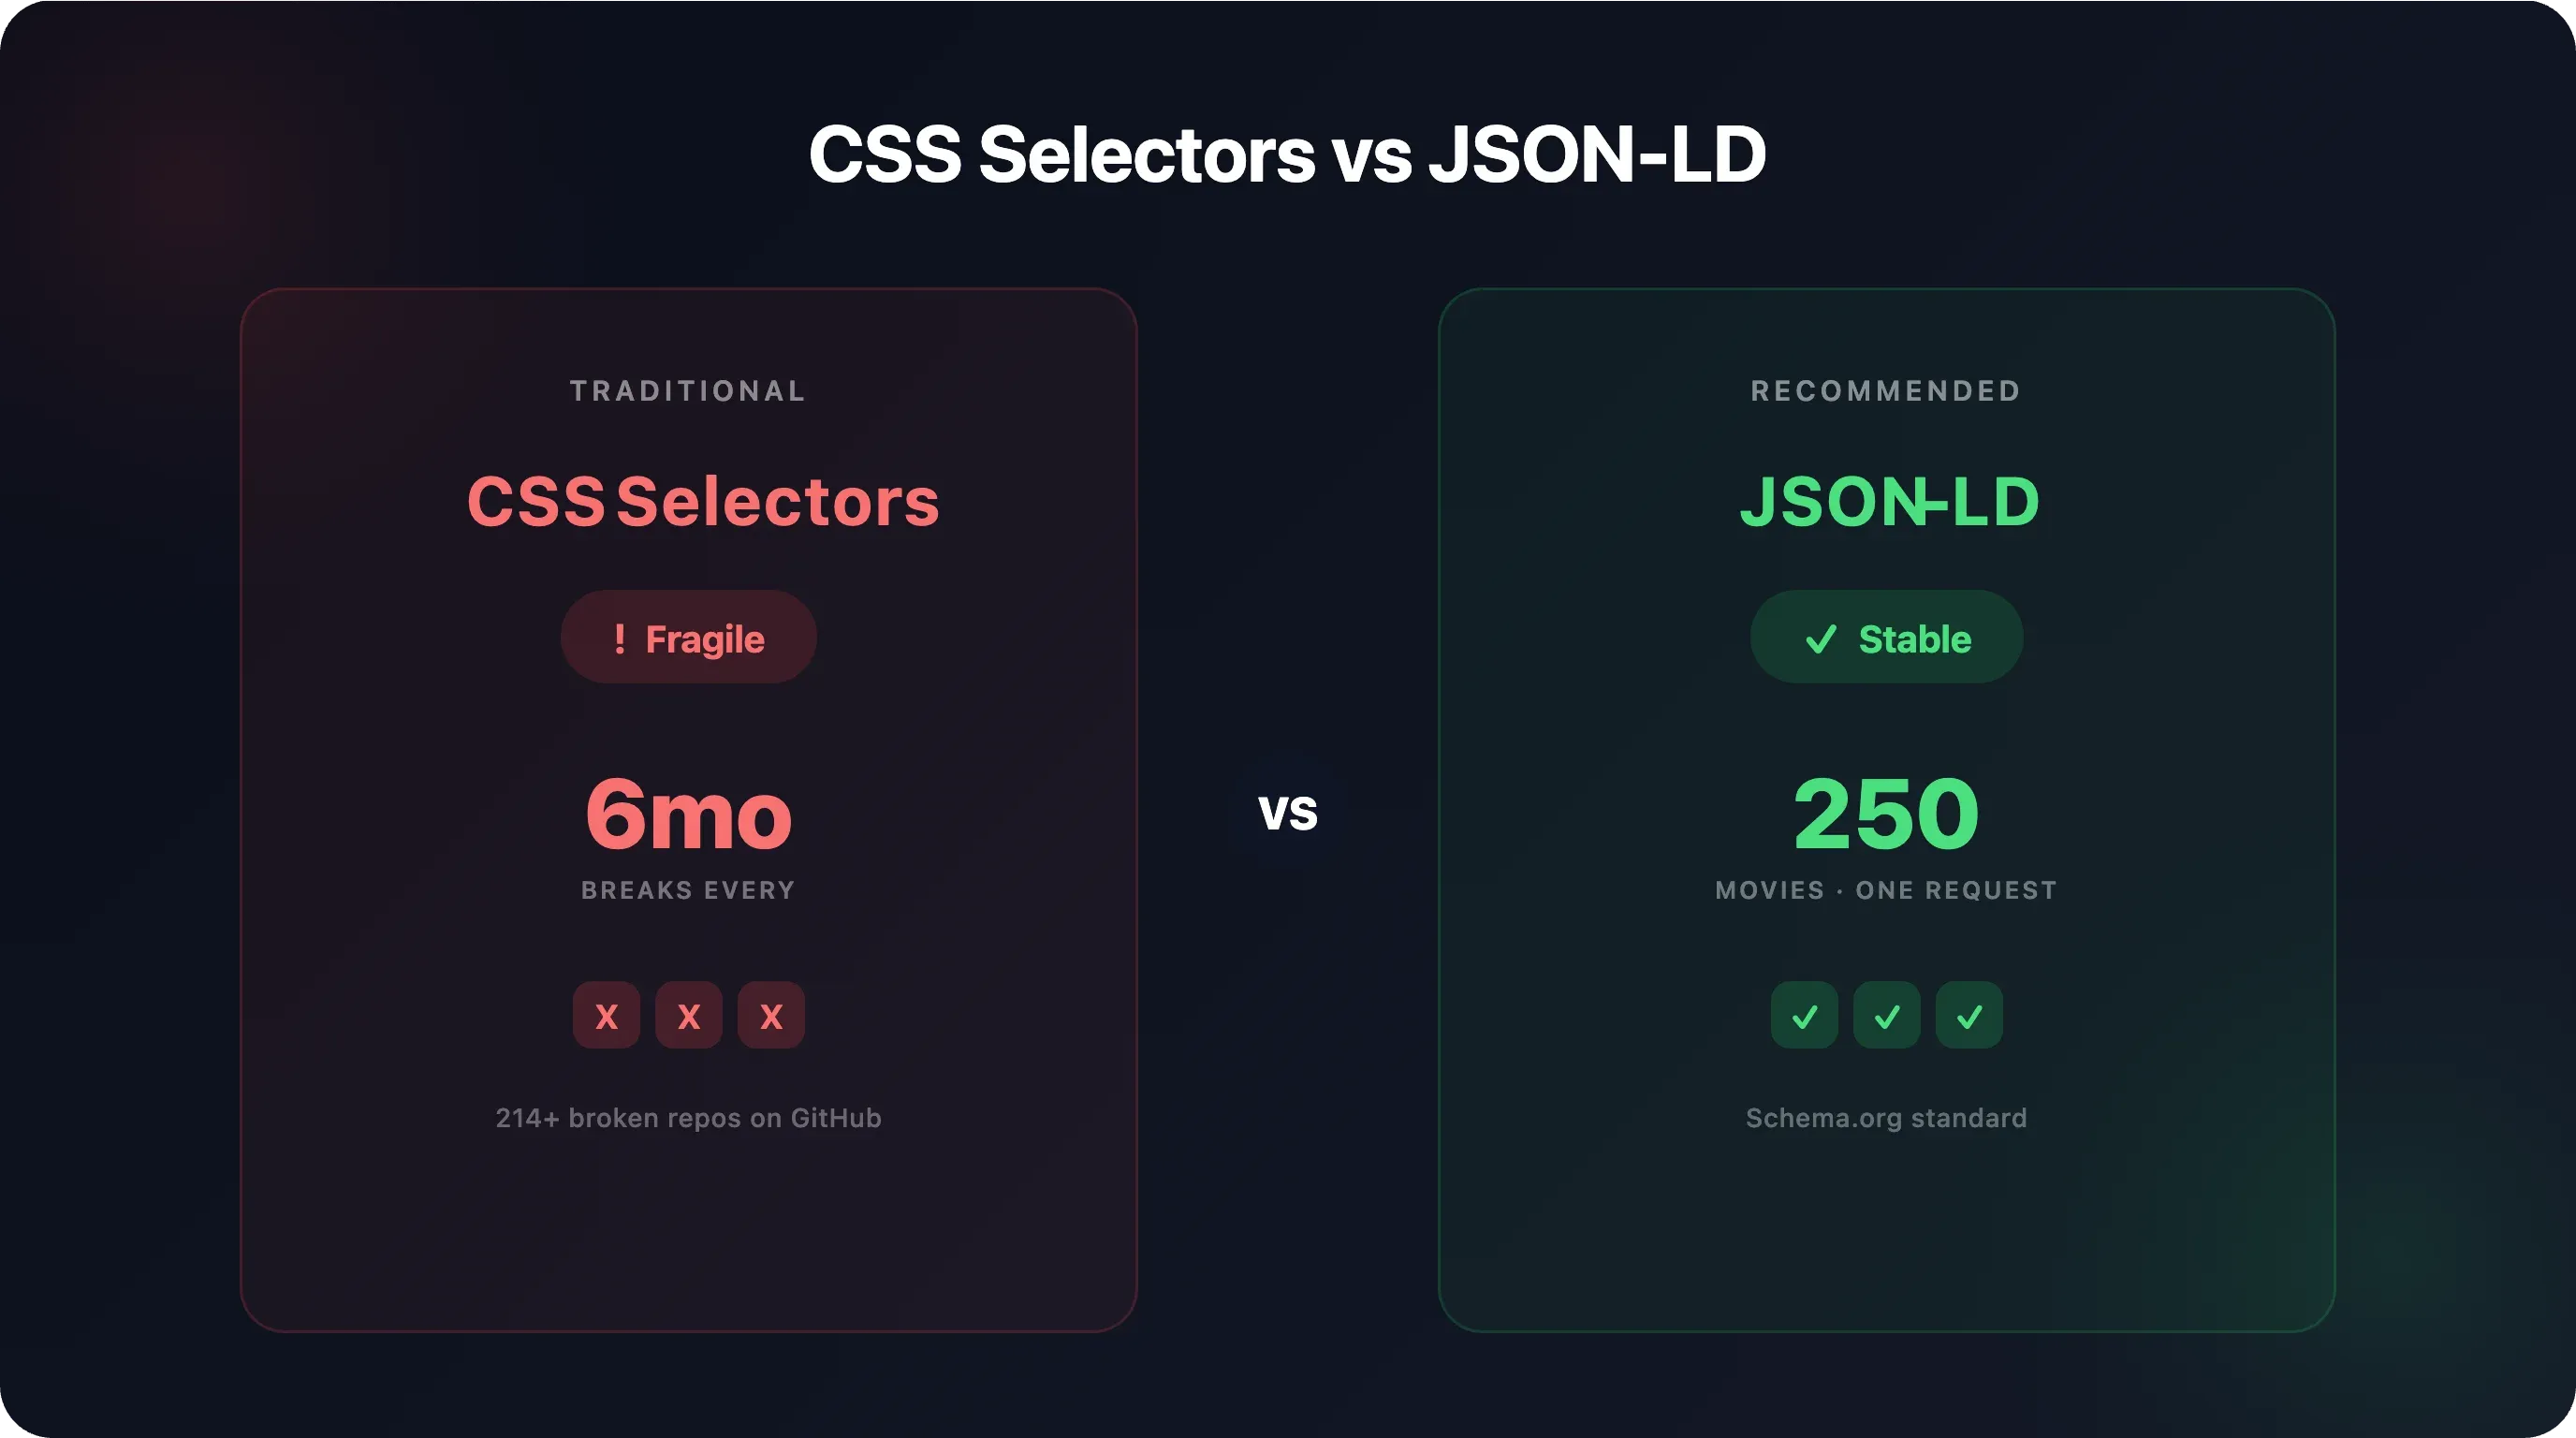
JSON-LD Neden CSS Seçicilerden Daha Güvenilir?
| Yaklaşım | JS İçeriğini İşler mi? | Arayüz Değişimlerine Dayanıklı mı? | Hız | Karmaşıklık |
|---|---|---|---|---|
| BeautifulSoup + CSS seçiciler | ❌ Hayır | ⚠️ Kırılgan (sınıf adları değişir) | Hızlı | Düşük |
| JSON-LD çıkarımı | ✅ Evet | ✅ Schema.org standardını izler | Hızlı | Düşük-Orta |
__NEXT_DATA__ JSON çıkarımı | ✅ Evet | ✅ Oldukça stabil | Hızlı | Düşük-Orta |
| Selenium / Playwright | ✅ Evet | ⚠️ Kırılgan | Yavaş | Orta-Yüksek |
| Thunderbit (kodsuz, 2 tık) | ✅ Evet (AI sayfayı okur) | ✅ AI otomatik uyum sağlar | Hızlı | Yok |
ipc-metadata-list-summary-item gibi CSS sınıf adları, IMDb’nin React bileşen sistemi tarafından otomatik oluşturulur ve her yeniden tasarımda değişir. JSON-LD şeması ise görsel katmanı değil, gerçek veri modelini temsil eder. Bu, bir kitabın içindekiler bölümünü okumakla bölümleri yalnızca yazı tipi boyutuna bakarak ayırt etmeye çalışmak arasındaki farka benzer.
Adım Adım: IMDb Verisini JSON-LD’den Çekin
1. Adım: Sayfayı Alın
Öncekiyle aynı — uygun bir User-Agent başlığıyla requests kullanın.
import requests
from bs4 import BeautifulSoup
import json
import pandas as pd

url = "https://www.imdb.com/chart/top/"
headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36",
    "Accept-Language": "en-US,en;q=0.9"
}

response = requests.get(url, headers=headers)
soup = BeautifulSoup(response.text, "lxml")
2. Adım: JSON-LD Script Etiketini Bulun
script_tag = soup.find("script", {"type": "application/ld+json"})

if not script_tag:
    print("Bu sayfada JSON-LD bulunamadı")
else:
    data = json.loads(script_tag.string)
    print(f"Bulunan JSON-LD türü: {data.get('@type', 'bilinmiyor')}")
3. Adım: Yapılandırılmış Veriyi Ayrıştırın
Top 250 sayfasında JSON-LD, tüm 250 filmi içeren bir itemListElement dizisi barındırır. Her giriş; konum, ad, URL, aggregateRating, datePublished, genre, description, director ve actor dizilerini içerir.
movies = []

for item in data.get("itemListElement", []):
    movie = item.get("item", {})
    rating_info = movie.get("aggregateRating", {})

    movies.append({
        "rank": item.get("position"),
        "title": movie.get("name"),
        "url": movie.get("url"),
        "rating": rating_info.get("ratingValue"),
        "vote_count": rating_info.get("ratingCount"),
        "date_published": movie.get("datePublished"),
        "genre": ", ".join(movie.get("genre", [])),
        "description": movie.get("description"),
    })
4. Adım: CSV’ye Aktarın
df = pd.DataFrame(movies)
df.to_csv("imdb_top_250_json_ld.csv", index=False)
print(df.head())
Örnek çıktı:
   rank                      title                                     url  rating  vote_count date_published              genre
0     1  The Shawshank Redemption  https://www.imdb.com/title/tt0111161/     9.3     2900000     1994-10-14     Drama
1     2            The Godfather   https://www.imdb.com/title/tt0068646/     9.2     2000000     1972-03-24     Crime, Drama
2     3          The Dark Knight   https://www.imdb.com/title/tt0468569/     9.0     2800000     2008-07-18     Action, Crime, Drama
Tüm 250 film. Temiz, yapılandırılmış, CSS seçici cambazlığı yok. Ve bu veri Schema.org standardına uyduğu için (Google’ın arama sonuçlarında dayandığı standart), görsel düzene göre değişme ihtimali çok daha düşüktür.
Bonus: Tekil Film Sayfaları için __NEXT_DATA__
Tekil başlık sayfalarından daha zengin veri almak için (süre, tam oyuncu kadrosu, özet, poster görselleri), IMDb ayrıca bir __NEXT_DATA__ JSON nesnesi gömer. Bu, React’ın sayfayı hydrate etmek için kullandığı veridir — siteyi bozmadan kaldırılamaz.
# /title/tt0111161/ gibi tekil bir film sayfasında
next_data_tag = soup.find("script", {"id": "__NEXT_DATA__"})

if next_data_tag:
    next_data = json.loads(next_data_tag.string)
    above_fold = next_data["props"]["pageProps"]["aboveTheFoldData"]

    title = above_fold["titleText"]["text"]
    year = above_fold["releaseYear"]["year"]
    rating = above_fold["ratingsSummary"]["aggregateRating"]
    runtime_seconds = above_fold.get("runtime", {}).get("seconds", 0)
    genres = [g["text"] for g in above_fold["genres"]["genres"]]
    plot = above_fold["plot"]["plotText"]["plainText"]
Grafik/liste sayfaları için JSON-LD, tekil başlık sayfaları için __NEXT_DATA__ kullanın. Üretim düzeyinde yaklaşım budur.
IMDb Kazıyıcınız Neden Sürekli Bozuluyor? (Ve Nasıl Düzeltilir)
Bu, incelediğim her IMDb kazıma forumunda en çok dile getirilen sorun. Kullanıcılar şunu yazıyor: “Kodun bir kısmı arayüz değişiklikleri yüzünden bozuldu” ve “2024’te çalışmıyor!” — cevap ise genelde sessizlik veya “Selenium deneyin.”
Kök neden, IMDb’nin React/Next.js ön yüzüne devam eden geçişi. İşte büyük kırılma değişikliklerinin zaman çizelgesi:
| Tarih | Ne Değişti | Ne Bozuldu |
|---|---|---|
| Kasım 2022 | İsim sayfaları yeniden tasarlandı | Eski isim sayfası kazıyıcıları |
| Haziran 2023 | Top 250 sayfası yeniden tasarlandı | Tüm td.titleColumn / td.ratingColumn seçicileri |
| Nisan 2023 | Başlık alt sayfaları yeniden tasarlandı | Biyografi, ödül, haber kazıyıcıları |
| Ekim 2023 | Gelişmiş Arama yeniden tasarlandı | Arama tabanlı kazıyıcılar |
| Haziran 2025 | /reference sayfaları yeniden tasarlandı | Cinemagoer kütüphanesi (çoğu ayrıştırıcı) |
Bu, yaklaşık her 6–12 ayda bir büyük kırılma değişikliği demek. Kazıyıcınız CSS sınıf adlarına dayanıyorsa, bitmeyen bir koşu bandındasınız.
Yaygın Hatalar ve Nasıl Düzeltilir
Boş sonuçlar / NoneType hataları
En yaygın hata. AttributeError: 'NoneType' object has no attribute 'text' görürsünüz. Bu, BeautifulSoup’un aradığınız öğeyi bulamadığı anlamına gelir — genellikle CSS sınıf adı değişmiştir ya da içerik JavaScript ile render ediliyordur.
Çözüm: JSON-LD çıkarımına geçin (yukarıdaki Yöntem 2). Veri ilk HTML yanıtında zaten var; JavaScript gerekmez.
403 Forbidden
IMDb, botları tespit etmek ve engellemek için AWS WAF kullanır. Bir numaralı tetikleyici, eksik ya da açıkça sahte bir User-Agent başlığıdır. Bu durum, birden fazla açık kaynak projede ve IMDb’nin kendi topluluk forumlarında belgelenmiştir; orada bir IMDb çalışanı sorunu kabul etmiştir.
Çözüm: Her zaman gerçekçi bir tarayıcı User-Agent dizesi ve Accept-Language: en-US başlığı ekleyin. Bağlantı havuzu için requests.Session() kullanın.
Yalnızca 25 sonuç dönüyor
IMDb arama sayfaları ve “En Popüler” listeleri lazy loading kullanır — başlangıçta yalnızca yaklaşık 25 sonuç render edilir ve siz aşağı kaydırdıkça geri kalanı AJAX ile yüklenir.
Çözüm: URL parametreli sayfalama kullanın (bir sonraki bölümde anlatılıyor) ya da tüm 250 filmin tek yanıtta yüklendiği Top 250 sayfasına geçin.
Seçiciler bir anda çalışmayı bırakıyor
Artık çalışmayan eski seçiciler: td.titleColumn, td.ratingColumn, .lister-item-header, .inline-block.ratings-imdb-rating. Kodunuz bunlardan herhangi birini kullanıyorsa bozulmuştur.
Çözüm: Otomatik oluşturulan sınıf adları yerine data-testid özniteliklerini tercih edin (ör. h1[data-testid="hero-title-block__title"]). Daha iyisi, JSON-LD kullanın.
Bir Karar Çerçevesi: Kısa Vadeli ve Uzun Vadeli Çözümler
- Hızlı çözüm: Her seçicinin etrafına
try/exceptblokları ekleyin, HTTP durum kodlarını doğrulayın, çökmeden hata kaydedin - Orta vadeli çözüm: CSS seçicilerden JSON-LD çıkarımına geçin (Yöntem 2)
- Uzun vadeli çözüm: Büyük ölçekli analiz için IMDb’nin resmî toplu veri kümelerini ya da sayfa yapısını her seferinde yeniden okuyan AI kullanan Thunderbit gibi bir aracı kullanın — bakımı yapılacak seçici yok, AI düzen değişikliklerine otomatik uyum sağlar
25 Sonuç Sınırının Ötesi: IMDb Sayfalama ve Büyük Veri Kümeleri
İncelediğim rakip eğitimlerin hepsi tam olarak bir sayfa kazıyor. Kimse sayfalamayı ele almıyor. Ama tek bir liste yeterli değilse, kısa sürede duvara çarparsınız.
Sayfalama Gerektirmeyen Sayfalar
İyi haber: Top 250 sayfası, tüm 250 filmi tek bir sunucu taraflı yanıtta yüklüyor. JSON-LD ve __NEXT_DATA__ tam veri kümesini içeriyor. Sayfalama gerekmez.
IMDb Arama Sayfalaması Nasıl Çalışır?
IMDb arama sayfaları start= URL parametresi kullanır ve 50’şer artar:
https://www.imdb.com/search/title/?groups=top_1000&start=1
https://www.imdb.com/search/title/?groups=top_1000&start=51
https://www.imdb.com/search/title/?groups=top_1000&start=101
Sonuçlar arasında dolaşan bir Python döngüsü:
import time

all_movies = []

for start in range(1, 1001, 50):  # İlk 1000 arasında sayfalar
    url = f"https://www.imdb.com/search/title/?groups=top_1000&start={start}"
    response = requests.get(url, headers=headers)

    if response.status_code != 200:
        print(f"start={start} noktasında başarısız oldu: {response.status_code}")
        break

    soup = BeautifulSoup(response.text, "lxml")
    # Tercih ettiğiniz yöntemle filmleri çıkarın
    # ...

    print(f"{start} başlangıçlı sayfa kazındı")
    time.sleep(3)  # Saygılı olun — IMDb yaklaşık 50 hızlı isteğin ardından engeller
Bu time.sleep(3) önemli. Topluluk raporları, IMDb’nin yaklaşık 50 hızlı istekten sonra IP’leri engellemeye başladığını gösteriyor. 2–5 saniye arasında rastgele bir gecikme iyi bir uygulamadır.
Kazımayı Tamamen Atlamanız Gereken Durum: IMDb’nin Resmî Toplu Veri Kümeleri
Gerçekten büyük ölçekli ihtiyaçlar için IMDb, datasets.imdbws.com adresinde günlük yenilenen 7 ücretsiz TSV dosyası sağlar:
| Dosya | İçerik | Boyut |
|---|---|---|
| title.basics.tsv.gz | Başlıklar, türler, süre, yıl | ~800 MB |
| title.ratings.tsv.gz | Ortalama puan, oy sayısı | ~25 MB |
| title.crew.tsv.gz | Yönetmenler, yazarlar | ~300 MB |
| title.principals.tsv.gz | Üst sıralı oyuncu/ekip | ~2 GB |
| title.akas.tsv.gz | Bölgeye göre alternatif adlar | ~1.5 GB |
| title.episode.tsv.gz | TV bölümü bilgileri | ~200 MB |
| name.basics.tsv.gz | Kişiler: ad, doğum yılı, bilinen işler | ~700 MB |
Bunları Pandas’a yüklemek oldukça basittir:
ratings = pd.read_csv("title.ratings.tsv.gz", sep="\t", compression="gzip")
basics = pd.read_csv("title.basics.tsv.gz", sep="\t", compression="gzip", low_memory=False)

# tconst (IMDb başlık kimliği) üzerinden birleştir
merged = basics.merge(ratings, on="tconst")
top_movies = merged[merged["titleType"] == "movie"].nlargest(250, "averageRating")
Bu veri kümeleri 26 milyondan fazla başlığı kapsar. Sayfalama yok, seçici yok, 403 hatası yok. Lisans yalnızca kişisel ve ticari olmayan kullanım içindir — veriyi yeniden yayımlayamaz veya yeniden satamazsınız.
Kodsuz Kestirme Yol: Thunderbit Sizin Yerine Sayfalamayı Yapar
Sayfalanmış IMDb verisine ihtiyaç duyup sayfalama mantığı yazmak istemeyen okurlar için, Thunderbit hem tıklama tabanlı sayfalamayı hem de sonsuz kaydırmayı doğal olarak destekler. Siz kazımasını söylersiniz, gerisini o halleder — yavaş yüklenen içerik içinde kaydırma da dahil.
Sayfalanmış IMDb verisi için Thunderbit’i deneyin
Python ile IMDb Kazıma: Tam Çalışan Kod (Kopyala-Yapıştır Hazır)
Aşağıda hemen çalıştırabileceğiniz, kendi içinde yeterli iki script var.
Script A: BeautifulSoup Yöntemi (CSS Seçiciler)
import requests
from bs4 import BeautifulSoup
import pandas as pd

url = "https://www.imdb.com/chart/top/"
headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36",
    "Accept-Language": "en-US,en;q=0.9"
}

response = requests.get(url, headers=headers)

if response.status_code != 200:
    print(f"Hata: {response.status_code}")
    exit()

soup = BeautifulSoup(response.text, "lxml")
movie_items = soup.select("li.ipc-metadata-list-summary-item")
movies = []

for item in movie_items:
    try:
        title = item.select_one("h3.ipc-title__text")
        year = item.select_one("span.cli-title-metadata-item")
        rating = item.select_one("span.ipc-rating-star--rating")

        movies.append({
            "title": title.text.strip() if title else "N/A",
            "year": year.text.strip() if year else "N/A",
            "rating": rating.text.strip() if rating else "N/A",
        })
    except Exception as e:
        print(f"Hata nedeniyle film atlanıyor: {e}")

df = pd.DataFrame(movies)
df.to_csv("imdb_top250_bs4.csv", index=False)
print(f"{len(df)} film kaydedildi")
print(df.head())
Script B: JSON-LD Yöntemi (Önerilen)
import requests
from bs4 import BeautifulSoup
import json
import pandas as pd

url = "https://www.imdb.com/chart/top/"
headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36",
    "Accept-Language": "en-US,en;q=0.9"
}

response = requests.get(url, headers=headers)

if response.status_code != 200:
    print(f"Hata: {response.status_code}")
    exit()

soup = BeautifulSoup(response.text, "lxml")
script_tag = soup.find("script", {"type": "application/ld+json"})

if not script_tag:
    print("JSON-LD verisi bulunamadı")
    exit()

data = json.loads(script_tag.string)
movies = []

for item in data.get("itemListElement", []):
    movie = item.get("item", {})
    rating_info = movie.get("aggregateRating", {})
    directors = movie.get("director", [])
    director_names = ", ".join(
        d.get("name", "") for d in (directors if isinstance(directors, list) else [directors])
    )

    movies.append({
        "rank": item.get("position"),
        "title": movie.get("name"),
        "url": movie.get("url"),
        "rating": rating_info.get("ratingValue"),
        "votes": rating_info.get("ratingCount"),
        "year": movie.get("datePublished", "")[:4],
        "genre": ", ".join(movie.get("genre", [])),
        "director": director_names,
        "description": movie.get("description"),
    })

df = pd.DataFrame(movies)
df.to_csv("imdb_top250_jsonld.csv", index=False)
print(f"{len(df)} film kaydedildi")
print(df.head())
Her iki script de hata yönetimi içerir ve temiz CSV çıktısı üretir. Script B size daha zengin veri verir — yönetmen, açıklama, URL — ve düzen değişikliklerine karşı daha dayanıklıdır.
Hiç Kod Yazmadan IMDb Nasıl Kazınır? (Thunderbit ile)
Herkes Python yazmak istemez veya buna ihtiyaç duymaz. Belki de sadece bu haftanın en yüksek puanlı filmlerini bir tabloya almak isteyen bir operasyon analistisiniz. Belki de yıllar arasındaki tür trendlerini karşılaştırmak isteyen bir içerik stratejisiniz. Bu durumlarda bir kazıyıcı yazmak gereğinden fazladır.
Aynı veriyi Thunderbit ile şöyle alabilirsiniz:
Başlamadan önce:
- Zorluk: Başlangıç
- Gerekli Süre: ~2 dakika
- Gerekenler: Chrome tarayıcısı, Thunderbit Chrome Uzantısı (ücretsiz katman çalışır)
1. Adım: Kazımak istediğiniz IMDb sayfasına gidin. Chrome’da IMDb Top 250’yi (veya herhangi başka bir IMDb liste/arama sayfasını) açın.
2. Adım: Thunderbit kenar çubuğunda “AI Alan Öner”e tıklayın. AI sayfayı tarar ve sütunlar önerir — genellikle Başlık, Yıl, Puan, Tür ve sayfaya bağlı olarak birkaç alan daha. Önerilen alanlarla bir önizleme tablosu göreceksiniz.
3. Adım: Gerekirse alanları düzenleyin. İhtiyacınız olmayan sütunları kaldırın ya da “+ Sütun Ekle”ye tıklayıp ne istediğinizi düz İngilizceyle tarif ederek özel sütunlar ekleyin (ör. “Yönetmen adı” veya “Oy sayısı”).
4. Adım: “Kazı”ya tıklayın. Thunderbit veriyi çıkarır. Sonsuz kaydırma veya sayfalama olan sayfalarda kaydırmayı otomatik olarak yönetir.
5. Adım: Dışa aktarın. Dışa aktarma düğmesine tıklayın ve formatınızı seçin — Excel, Google Sheets, CSV, Airtable veya Notion. Veri saniyeler içinde hedefinize ulaşır.
Buradaki temel avantaj sadece kolaylık değil — Thunderbit’in AI’sı sayfa yapısını her seferinde sıfırdan okur. IMDb düzenini değiştirdiğinde (değiştirecek), AI uyum sağlar. Güncelleyecek seçici, düzeltilecek kod yok. Son teslim tarihinden önce gece 2’de bozuk bir kazıyıcı yüzünden canı yanmış herkes için bu çok değerli.
Thunderbit ayrıca alt sayfa kazımayı da destekler — her film detay sayfasına girip tablonuzu oyuncu kadrosu, yönetmen, süre ve liste sayfasında görünmeyen diğer alanlarla zenginleştirebilirsiniz. Nasıl çalıştığını görmek isterseniz, Thunderbit YouTube Kanalı’na göz atın.
IMDb’yi Kazımak Yasal mı? Bilmeniz Gerekenler
Kullanıcılar forumlarda bunu açıkça soruyor: “Böyle bir şey yasal mı?… IMDb insanların sitesini kazımasını istemiyor.” Bu makul bir soru ve rakip yazıların hiçbiri bunu ele almıyor.
IMDb robots.txt: Top 250 tablosu (/chart/top/), tekil başlık sayfaları (/title/ttXXXXXXX/) ve isim sayfaları (/name/nmXXXXXXX/) robots.txt tarafından ENGELLENMİŞ değildir. Engellenen yollar arasında /find, / _json/*, /search/name-text, /user/ur*/ratings ve çeşitli AJAX uç noktaları bulunur. Belirlenmiş bir Crawl-delay yönergesi yoktur.
IMDb Kullanım Koşulları: İlgili madde şunu söyler: “Bu sitede, açık yazılı iznimiz olmadan veri madenciliği, robotlar, ekran kazıma veya benzeri veri toplama ve çıkarma araçlarını kullanamazsınız.” Ek bir madde, kazınmış verinin yeniden satılmasını veya ticari kullanımını yasaklar.
Pratikte bunun anlamı: 2024’teki son mahkeme kararları (Meta v. Bright Data, X Corp v. Bright Data), hiç kabul etmediğiniz Kullanım Koşulları’nın sizi bağlamayabileceğini ortaya koydu — kamuya açık veriyi giriş yapmadan kazıyorsanız, ToS’un uygulanabilirliği tartışmalıdır. Ancak bu alan hukuken hâlâ gelişmektedir.
Güvenli alternatifler: IMDb’nin resmî indirilebilir veri kümeleri açıkça kişisel ve ticari olmayan kullanım için onaylıdır. TMDb API, ücretsiz API anahtarıyla oldukça esnektir. Hukuken net kalmak istiyorsanız her ikisi de sağlam seçeneklerdir.
Pratik öneri: Eğer kazıma yapacaksanız, saygılı bir istek hızı kullanın (time.sleep(3)), uygun başlıklar ekleyin ve robots.txt tarafından engellenen yollara istek göndermeyin. Ticari projeler için bir hukuk uzmanına danışın ya da resmî veri kümelerini/API’yi kullanın.
Web kazımanın yasal sonuçlarını Thunderbit blogunda ayrıntılı olarak ele aldık.
Sonuç: Python ile IMDb’yi Kazımak İçin Doğru Yolu Seçin
Kısa versiyon:
- BeautifulSoup + CSS seçiciler: Temelleri öğrenmek için iyi. Her 6–12 ayda bir bozulmasını bekleyin. Her zaman hata yönetimi ekleyin.
- JSON-LD çıkarımı: Devam eden herhangi bir Python projesi için önereceğim yaklaşım. Schema.org standardını izler, CSS sınıflarına göre çok daha seyrek değişir ve JavaScript render olmadan temiz yapılandırılmış veri verir.
__NEXT_DATA__JSON: Tekil başlık sayfalarında daha zengin veri için bunu tamamlayıcı olarak kullanın (süre, tam oyuncu kadrosu, özet, poster görselleri).- IMDb Resmî Veri Kümeleri: Büyük ölçekli analiz için en iyi seçenek. 26M+ başlık, günlük güncelleme, kazıma gerekmez. Yalnızca kişisel/ticari olmayan kullanım içindir.
- Thunderbit: Kod yazmayanlar veya kodu bakımda tutmadan hızlı veri isteyen herkes için en iyi seçenek. AI düzen değişikliklerine uyum sağlar, sayfalama işlemlerini yönetir, Excel/Sheets/Airtable/Notion’a aktarır.
Bu rehberi yer imlerine ekleyin — IMDb’nin yapısı bir sonraki değiştiğinde güncelleyeceğim. Ve kodu tamamen atlamak istiyorsanız, Thunderbit’in ücretsiz katmanını deneyin ve bir IMDb sayfasından temiz bir tabloya ne kadar hızlı geçebileceğinizi görün. Başka sitelerle de çalışıyorsanız, web sitesinden Excel’e veri kazıma rehberimiz daha geniş iş akışını kapsıyor.
IMDb ve daha fazlası için AI Web Scraper’ı deneyin Get Started Free
SSS
IMDb’yi kazımak yasal mı?
IMDb’nin Kullanım Koşulları, izin olmadan kazımayı yasaklar; ancak 2024’teki son mahkeme kararlarından sonra, kamuya açık verilerde ToS’un uygulanabilirliği hukuken tartışmalıdır. En güvenli seçenekler IMDb’nin resmî ücretsiz veri kümeleri (kişisel/ticari olmayan kullanım) veya TMDb API’dir (ücretsiz anahtar). Kazıma yapacaksanız robots.txt’ye uyun, istekler arasında makul gecikme kullanın ve engellenmiş yollardan kaçının. Ticari kullanım için hukuk uzmanına danışın.
IMDb kazıyıcım neden boş sonuç döndürüyor?
Nedeni neredeyse her zaman eski CSS seçicilerdir — td.titleColumn ve td.ratingColumn gibi sınıf adları Haziran 2023’ten beri yok. Çözüm, JSON-LD çıkarımına geçmek (<script type="application/ld+json"> etiketini ayrıştırmak) veya seçicilerinizi mevcut ipc- ön ekli sınıflara güncellemektir. Ayrıca uygun bir User-Agent başlığı eklediğinizden emin olun; eksik başlık, boş sonuç gibi görünebilen bir 403 hatasını tetikler.
IMDb’den 25’ten fazla sonucu nasıl kazıyabilirim?
Top 250 sayfası tüm 250 filmi tek bir yanıtta yükler — sayfalama gerekmez. Arama sonuçları için, sonuçlar arasında ilerlemek adına start= URL parametresini kullanın (50’şer artar). Örneğin: start=1, start=51, start=101. Engellenmemek için istekler arasına time.sleep(3) ekleyin. Alternatif olarak, datasets.imdbws.com adresindeki IMDb resmî veri kümeleri sayfalama gerektirmeyen 26M+ başlık içerir.
__NEXT_DATA__ nedir ve IMDb kazımada neden kullanmalıyım?
__NEXT_DATA__, IMDb’nin React/Next.js sayfalarında <script id="__NEXT_DATA__"> etiketinin içine gömülü bir JSON nesnesidir. React’ın sayfayı oluşturmak için kullandığı eksiksiz yapılandırılmış veriyi içerir — başlıklar, puanlar, oyuncular, türler, süre ve daha fazlası. Görsel düzen yerine alttaki veri modelini temsil ettiği için, CSS seçicilere kıyasla arayüz yeniden tasarımlarına daha dayanıklıdır. En sağlam çıkarım yaklaşımı için JSON-LD ile birlikte kullanın.
Kod yazmadan IMDb kazıyabilir miyim?
Evet. İki ana seçenek var: (1) IMDb’nin resmî toplu veri kümelerini indirin — 26M+ başlığı kapsayan, günlük güncellenen 7 TSV dosyası; ticari olmayan kullanım için ücretsiz. (2) IMDb sayfasını okuyan, çıkarım alanlarını otomatik öneren ve veriyi iki tıkla Excel, Google Sheets veya CSV’ye aktaran Thunderbit’in AI web kazıyıcısını kullanın — kod yok, bakım gerektiren seçici yok.
Daha Fazla Bilgi



