
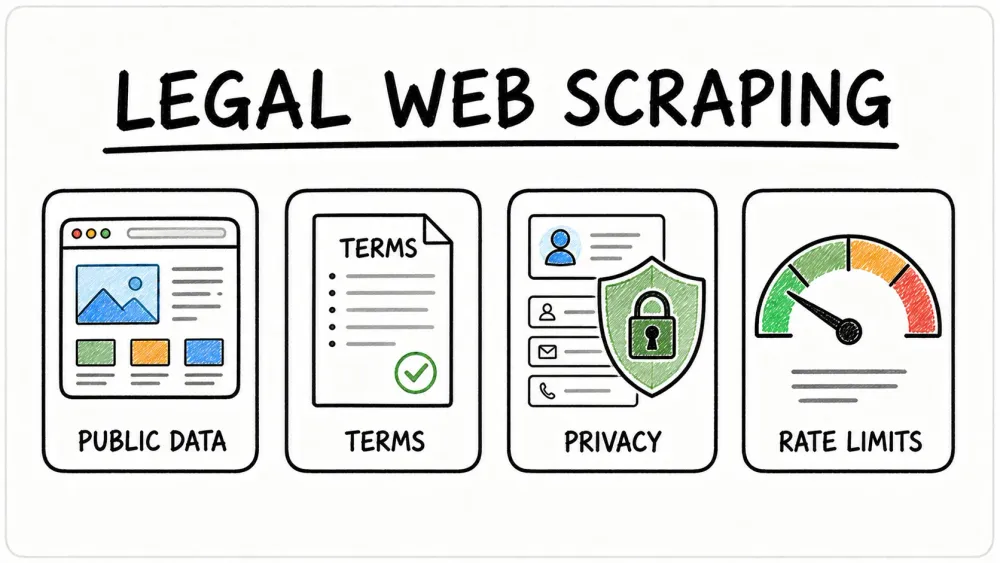
“Web sitelerinden veri çekmek yasal mı?”—satış, operasyon ve pazarlama ekiplerinden neredeyse her hafta duyduğum milyon dolarlık soru bu. Web scraping; lead oluşturma işlerinden rekabet analizine kadar her alanda kullanılırken, herkesin net bir yanıt istemesi hiç şaşırtıcı değil. Peki gerçek ne? Hukuki tablo, bir gün öncesinden kalmış kahve kadar bulanık. Manşetlere bir bakın yeter: bir mahkeme kamuya açık verinin çekilmesini serbest sayarken, diğeri “hukuka aykırı veri toplama” uyarısı yapıyor. Bu yüzden birçok ekibin çizgiyi aşmaktan çekinmesi gayet normal.
Şunu da unutmayalım: artık kuruluşların üçte ikisinden fazlası analiz ve yapay zekâ projelerini beslemek için web scraping kullanıyor; ayrıca e-ticaret şirketlerinin tam %78’i fiyat istihbaratı için buna güveniyor. Ama LinkedIn ile hiQ Labs davası gibi çok konuşulan davalar ortadayken, riskler hiç olmadığı kadar büyük. Peki web verisinin değerinden nasıl yararlanırsınız—hem de hukuki sıkıntıya düşmeden? Gelin, her iş kullanıcısının bilmesi gereken yasal çerçeveleri, uyumluluk kontrollerini ve en iyi uygulamaları birlikte inceleyelim. Evet, Thunderbit ile uyumlu scraping’in nasıl çok daha kolay hale geldiğini de göstereceğim.
Hukuki Tabloyu Anlamak: Web Sitelerinden Veri Çekmek Yasal mı?
Thunderbit'in Uyumlu Web Scraper'ını Deneyin Thunderbit’in agentic web scraper’ı herkese açık sayfaları kendi başına okur ve veriyi tek tıkla çıkarır; uyumluluğu önemseyen ekipler düşünülerek tasarlanmıştır. Get Started Free
Kısa ve net söyleyelim: web scraping’in yasal olup olmaması; neyi, nasıl ve nerede çektiğinize bağlıdır. “Scraping yasaldır” ya da “scraping yasadışıdır” diyen tek ve evrensel bir kanun yok. Bunun yerine; siber suç yasaları, gizlilik düzenlemeleri, telif hakkı ve hatta web sitesinin kullanım şartları gibi kuralların oluşturduğu bir yama işiyle uğraşırsınız (Thunderbit Blog).
Scraping projenizin hukuka uygun olup olmadığını belirleyen başlıca unsurlar şunlardır:
- Kamuya Açık Veri mi, Özel Veri mi? Herkese açık veriyi (giriş gerektirmeyen, ödeme duvarı olmayan içerik) çekmek genelde daha güvenlidir. Giriş arkasındaki içeriklere ulaşmaya çalışıyorsanız, hukuken riskli bir alana giriyorsunuz demektir.
- Verinin Türü: Kişisel veriler (isim, e-posta, sosyal profil gibi) ve telifli içerikler (makaleler, görseller) fiyat, ürün özellikleri veya işletme listeleri gibi olgusal verilere kıyasla çok daha risklidir.
- Kullanım Amacı: Çekilen veriyi şirket içinde analiz veya araştırma için kullanmak, yeniden yayımlamaya ya da satmaya göre çok daha az risk taşır.
- Site Kurallarına Uyumluluk: Bir sitenin kullanım şartlarını ihlal etmek veya robots.txt dosyasını yok saymak, veri kamuya açık olsa bile başınızı ağrıtabilir.
- Teknik Yaklaşım: İnsan davranışına benzer hızda çekim yapmak ve CAPTCHA ya da IP engeli gibi güvenlik önlemlerini aşmaya çalışmamak sizi daha sağlam zeminde tutar.
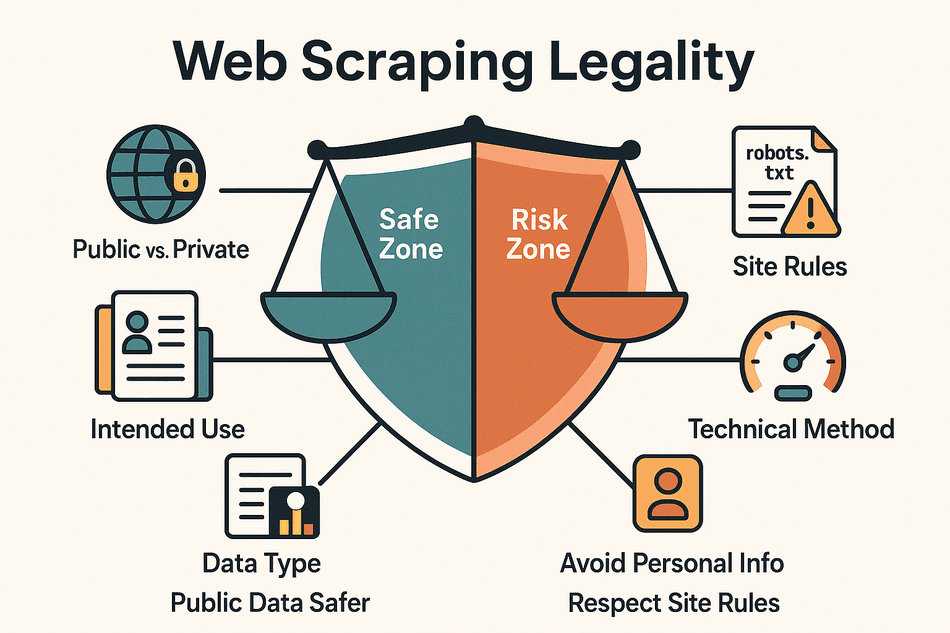
 Özetle: Kamuya açık ve kişisel olmayan veriyi şirket içi kullanım için çekmek birçok bölgede genel olarak kabul görür; ancak özellikle gizlilik, telif ve ne kadar agresif çekim yaptığınız konusunda önemli istisnalar vardır (Thunderbit Blog).
Veri Çekmenin Hukuki Çerçevesi: Başlıca Küresel Düzenlemelere Genel Bakış
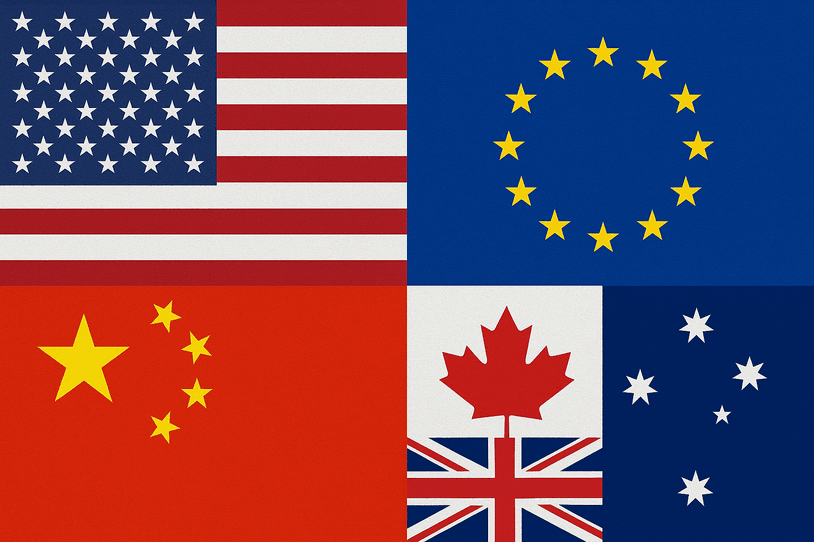 Web scraping için dünyadaki başlıca yasal çerçevelere hızlıca bakalım:
Amerika Birleşik Devletleri: CFAA, Telif ve Sözleşmeler
- Computer Fraud and Abuse Act (CFAA): Bu siber suç karşıtı yasa, bilgisayar sistemlerine “izinsiz” erişimi yasa dışı sayar. Ancak mahkemeler, kamuya açık web sitelerinden veri çekmenin CFAA’yı ihlal etmediğini netleştirmiştir; çünkü burada gereken bir “yetkilendirme” yoktur (California Lawyers Association).
- Dönüm Noktası Niteliğinde Dava: hiQ Labs v. LinkedIn davasında Dokuzuncu Bölge, kamuya açık LinkedIn profillerinin çekilmesinin CFAA ihlali olmadığına hükmetti. Ancak LinkedIn yine de sözleşme ihlali (kullanım şartlarını çiğneme) veya telif hakkı ihlali nedeniyle dava açabilir.
- Diğer Riskler: Eğer çok agresif çekim yaparsanız (eBay v. Bidder’s Edge davasındaki botun günde 100.000 istek göndermesi gibi), “trespass to chattels” yani başkasının sistemine/altyapısına hukuka aykırı müdahale sorumluluğu doğabilir (Wikipedia).
Avrupa Birliği: GDPR ve Veritabanı Hakları
- GDPR: AB’nin Genel Veri Koruma Tüzüğü, kamuya açık kişisel veriler için bile geçerlidir. Bir kişiyi tanımlamaya yarayan herhangi bir veriyi çekiyorsanız, meşru bir hukuki dayanağa (örneğin açık rıza veya meşru menfaat) ihtiyacınız vardır ve sıkı gizlilik kurallarına uymanız gerekir.
- Veritabanı Direktifi: AB, veritabanlarını bir bütün olarak da korur. Yapılandırılmış bir veritabanının “önemli bir kısmını” çekmek, tek tek veriler telifli olmasa bile veritabanı haklarını ihlal edebilir (Thunderbit Blog).
Birleşik Krallık: UK GDPR ve Veri Koruma Yasası
- UK GDPR: Brexit sonrası Birleşik Krallık kuralları AB’ye oldukça benzer. Kamuya açık, kişisel olmayan verilerin çekilmesi genellikle sorun değildir; ancak kişisel veri çekimi sıkı biçimde düzenlenir.
- Computer Misuse Act: CFAA’ya benzer şekilde, bu yasa da izinsiz erişimi suç haline getirebilir.
Çin: PIPL ve Veri Güvenliği Yasası
- Kişisel Bilgilerin Korunması Yasası (PIPL): Kişisel verileri toplamak için onay gerektirir. Çin web sitelerinden izin almadan kişisel bilgi çekmek büyük bir hayırdır.
- Veri Güvenliği Yasası: Veri sahiplerine zarar veren veya haksız rekabet yaratan scraping faaliyetlerine karşı kullanılabilir.
Diğer Bölgeler
- Kanada, Avustralya, APAC: Çoğunda AB/UK’ye benzer siber suç ve gizlilik kuralları vardır. Scraping yapmadan önce mutlaka yerel mevzuatı kontrol edin.
Ana çıkarım: En güvenli yaklaşım, kamuya açık ve kişisel olmayan veriyi şirket içi kullanım için çekmek ve kendi bölgenizdeki kuralları daima kontrol etmektir (Thunderbit Blog).
Uyumluluk Kontrol Listesi: Veri Çekiminizin Yasal Olduğundan Nasıl Emin Olursunuz?
Scraping’e başlamadan önce şu uyumluluk kontrol listesini gözden geçirin:
- Web sitesinin Kullanım Şartlarını okuyun: ToS “scraping yok” diyorsa, durmayı düşünün veya önce izin alın (Thunderbit Blog).
- Kamuya açık veriye bağlı kalın: Açık yetki olmadan giriş arkasındaki veya ödeme duvarı altındaki hiçbir şeyi çekmeyin.
- robots.txt dosyasını kontrol edin:
site.com/robots.txtadresinden botların hangi bölümlere erişmemesi gerektiğini görün. Hukuken bağlayıcı olmasa da buna saygı göstermek iyi bir alışkanlıktır. - Kişisel veriden kaçının: Hukuki dayanağınız ve bir gizlilik planınız yoksa isim, e-posta ve diğer kişisel verileri çekmeyin.
- Yaratıcı içerikleri kopyalamayın: Olgulara ve veri noktalarına odaklanın. Makale, görsel veya büyük içerik parçalarını yeniden yayımlamak telif iddialarını tetikleyebilir.
- Mümkünse resmi API’leri kullanın: Site bir API sunuyorsa onu tercih edin; daha güvenlidir ve çoğu zaman daha stabildir.
- Nazikçe çekim yapın: Sunucuları zorlamayın. İnsan hızına yakın çalışın ve teknik korumaları aşmaya kalkmayın.
- Süreci belgeleyin: Neleri, ne zaman ve neden çektiğinizi kayıt altına alın. Sonradan soru çıkarsa bu işinize yarar.
- Durmaya hazır olun: Bir cease-and-desist mektubu alırsanız scraping’i hemen durdurun ve durumu yeniden değerlendirin.
Thunderbit’in Uyumlu Scraping Yaklaşımı: Veri Çekimini Daha Güvenli ve Daha Güvenilir Hale Getirmek
Thunderbit’i geliştirirken uyumluluk en öncelikli konulardan biriydi. Thunderbit’in sizi hukuken daha güvenli tarafta tutmaya nasıl yardımcı olduğuna bakalım:
- Tarayıcı Tabanlı Scraping: Thunderbit yalnızca tarayıcınızda görebildiğiniz içeriği çeker—gizli API çağrıları yok, girişleri aşmaya çalışmak yok. Siz göremiyorsanız, Thunderbit de çekemez (Thunderbit Blog).
- Dahili Uyarılar: Çok sıkı scraping politikaları olan bir siteyi çekmeye çalışırsanız Thunderbit size uyarı gösterir. Yanınızda bir uyumluluk uzmanı varmış gibi düşünebilirsiniz.
- Tek Tıkla Çıkarma: Thunderbit’in yapay zekâsı sayfayı tarar ve yalnızca ilgili alanları önerir—böylece yanlışlıkla hassas veya gereksiz veri çekme riskiniz azalır (Thunderbit Blog).
- İnsan Hızına Benzer Çalışma: İster yerelde ister bulutta kullanın, Thunderbit sunucuları bunaltmamak için işlemleri kontrollü hızda yürütür.
- Sunucularımızda Veri Saklanmaz: Çektiğiniz veri doğrudan size gider—Thunderbit bir kopyasını tutmaz. Bu da gizlilik uyumluluğu açısından büyük avantajdır.
- Uyumluluğa Uygun Dışa Aktarım: Veriyi doğrudan Google Sheets, Excel, Airtable veya Notion’a aktarın—iç kullanım için idealdir.
- Alt Sayfa ve Sayfalama Desteği: Thunderbit, gerçek bir kullanıcı gibi sitelerde gezinir; uç noktalara kaba kuvvet uygulamak yerine sayfalar ve alt sayfalar arasında dolaşır.
- Ölçülü Planlı Scraping: Siteye her dakika yüklenmemek için makul aralıklarla zamanlanmış çekimler kurabilirsiniz.
- Çok Dilli Destek: Thunderbit’in arayüzü artık Chrome Web Store’da 55 dili destekliyor; böylece uyumluluk uyarıları ve alan ipuçları İngilizce bilmeyen ekipler için de anlaşılır kalıyor (Chrome Web Store listing).
Kısacası Thunderbit, “uyumluluğu ürünün içine gömüyor”; böylece hukuki uzman olmasanız bile doğru şekilde veri çekmeniz yönünde yönlendiriliyorsunuz (Thunderbit Blog).
Uyumlu Web Scraping için Thunderbit’i Deneyin Thunderbit’in ücretsiz Chrome uzantısını yükleyin ve herkese açık herhangi bir sayfadan veriyi tek tıkla çıkarın. Get Started Free
Veri Çekme ve Veriyi Yeniden Kullanma: Hukuki Sınır Nerede Başlıyor?
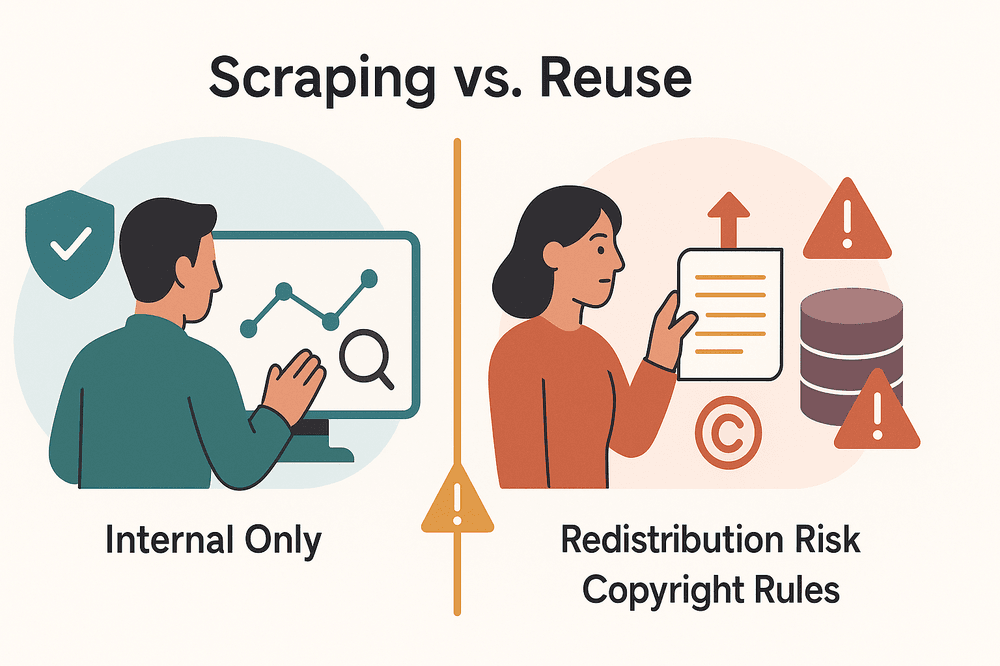 Veriyi kendi iç kullanımınız için çekmek bir şeydir; onu yeniden yayımlamak, satmak ya da başka şekilde yeniden kullanmak bambaşka bir şeydir. Hukuki çizginin keskinleştiği yer tam olarak burasıdır:
- İç Kullanım: Kamuya açık veriyi iç analiz için çekmek (örneğin satış lead’leri veya fiyat takibi) genellikle güvenlidir—tabii kişisel veri çekmiyor ve gizlilik yasalarını ihlal etmiyorsanız.
- Yeniden Dağıtım veya Satış: Çekilen veriyi kendi sitenizde, bir üründe veya satış amacıyla yeniden yayımlamak telif, veritabanı hakkı veya sözleşme ihlali iddialarını tetikleyebilir.
- Telif ve Veritabanı Hakları: ABD’de olguların telifi olmaz; ancak verinin seçimi veya düzenleniş biçimi koruma görebilir. AB/UK’de ise bir veritabanının “önemli bir kısmını” çekmek, sui generis veritabanı haklarını ihlal edebilir.
- Fair Use: ABD hukukunda bazı durumlarda “adil kullanım” mümkün olabilir (yorum veya analiz gibi), fakat büyük içerik bloklarını olduğu gibi kopyalayıp yapıştırmak neredeyse hiçbir zaman fair use sayılmaz.
- Kaynak Gösterme: Çekilen veriyi kamuya açık kullanıyorsanız kaynak belirtin—ama unutmayın, atıf yapmak diğer hakları ihlal ediyorsanız işlemi yasal hale getirmez.
- Ham Veriyi Satmayın: Değiştirilmemiş veri setlerini satmak özellikle risklidir. Çektiğiniz veriyi bir ürün olarak değil, içgörü üretmek için kullanın.
Profesyonel ipucu: Çektiğiniz veriyi iç istihbarat ve karar alma süreçlerinde kullanın. Dışarıyla paylaşmanız gerekiyorsa veriyi mutlaka toplulaştırın veya dönüştürün; ayrıca izin gerekip gerekmediğini kontrol edin (Thunderbit Blog).
Sektör Vakaları: Hukuki Riskler Nasıl Azaltılır?
Gelin gerçek dünya örneklerine bakalım—çünkü uyumluluğu, başkalarının nerede hata yaptığını görerek öğrenmek kadar etkili bir şey yok:
LinkedIn ve hiQ Labs
- Ne oldu: hiQ Labs, çalışan kaybı analizleri üretmek için herkese açık LinkedIn profillerini çekti. LinkedIn bunu engellemeye çalıştı, ancak mahkeme kamuya açık verinin çekilmesinin CFAA ihlali olmadığına karar verdi.
- Ders: ABD’de kamuya açık veriyi çekmek hukuken savunulabilir; fakat yine de kullanım şartları ve gizlilik iddialarına dikkat etmeniz gerekir (California Lawyers Association).
eBay ve Bidder’s Edge
- Ne oldu: Bidder’s Edge, eBay’in açık artırma ilanlarını agresif şekilde çekti (günde 100.000 istek), eBay’in şartlarını ve robots.txt kurallarını ihlal etti. Mahkeme “trespass to chattels” nedeniyle ihtiyati tedbir verdi.
- Ders: Kamuya açık veri bile, fazla agresif çekildiğinde veya açık site kuralları ihlal edildiğinde hukuka aykırı olabilir (Wikipedia).
Facebook (Meta) ve Power Ventures
- Ne oldu: Power Ventures, kullanıcı onayıyla Facebook verisi çekiyordu; ancak Facebook erişimi geri çekip IP’leri engelledikten sonra Power Ventures çekime devam etti. Mahkeme bunu “izinsiz erişim” olarak değerlendirdi.
- Ders: Site sahibi size scraping’i durdurmanızı söylediyse, durmak zorundasınız—aksi halde siber suç yasalarını ihlal etme riskiniz olur.
Uyumluluk Başarı Hikâyeleri
AB’deki birçok fiyat karşılaştırma sitesi, yalnızca olgusal verileri çekerek, opt-out taleplerine saygı göstererek ve tüm veritabanlarını çekmeyerek yasal şekilde faaliyet gösteriyor. Bu şirketlere karşı dava açılmaması, kamuya açık ve kişisel olmayan veriye bağlı kalmanın ve site kurallarına uymanın işe yaradığını gösteriyor.
Thunderbit Nasıl Yardımcı Olur?
Thunderbit’in yerleşik uyarıları, hız limitleri ve tarayıcı tabanlı yaklaşımı; riskli siteleri kullanıcıya önceden bildirerek ve varsayılan olarak nazik scraping uygulayarak bu tür hukuki hataların çoğunu önlemeye yardımcı olur.
İş Senaryolarında Veri Çekimi İçin Uyumluluk Öz-Değerlendirme Listesi
Bir sonraki scraping projeniz için pratik bir öz kontrol listesi:
- Veri kamuya açık mı? (Giriş gerekmiyor)
- Sitenin şartları ne diyor? (Scraping karşıtı maddeler var mı?)
- robots.txt dosyasını kontrol ettiniz mi? (Hedef bölüm yasaklı mı?)
- Kişisel veri çekiyor musunuz? (Evetse gizlilik planınız var mı?)
- Sitenin büyük bir bölümünü mü çekiyorsunuz? (Tüm veritabanını çekmekten kaçının)
- Amacınız ne? (İç kullanım = daha güvenli; kamuya yeniden kullanım = daha riskli)
- Nazikçe mi çekiyorsunuz? (İnsan hızına yakın, teknik aşma yok)
- API olup olmadığını kontrol ettiniz mi? (Varsa kullanın)
- İstenirse durmaya hazır mısınız? (Cease-and-desist için planınız olsun)
- Veriyi nasıl saklayıp koruyacaksınız? (Erişimi sınırlandırın, gizliliği koruyun)
- Süreci belgeliyor musunuz? (Uyumluluk için kayıt tutun)
Bu maddelerden herhangi birine “hayır” diyorsanız veya emin değilseniz, ilerlemeden önce durun ve netlik kazanın (Thunderbit Blog).
Thunderbit Kullanıcıları İçin Uyumlu Veri Çekimine Örnek İş Akışı
 Gelin tipik, uyumluluk dostu bir Thunderbit iş akışına bakalım:
- Çekim öncesi kontrol: Sitenin robots.txt ve kullanım şartlarını inceleyin. Scraping’e karşı açık bir ifade yok mu? Yeşil ışık.
- Thunderbit’i açın: Hedef sayfaya gidin ve Thunderbit Chrome Extension’ı çalıştırın.
- Tek Tıkla Çıkarma: Thunderbit’in yapay zekâsının ilgili ve hassas olmayan alanları önermesine izin verin. Hukuki dayanağınız yoksa kişisel veri eklenmediğini mutlaka kontrol edin.
- Alanları özelleştirin: Gerektikçe sütunları ve veri türlerini ayarlayın—yalnızca gerçekten ihtiyacınız olanı toplayın.
- Scrape edin: “Scrape”e tıklayın. Thunderbit, site yapısına saygı göstererek veriyi insan hızına benzer şekilde çeker.
- Alt sayfa scraping’i: Gerekirse verinizi zenginleştirmek için Thunderbit’in alt sayfa özelliğini kullanın—yine yalnızca herkese açık bilgiler için.
- Dışa aktarın: Veriyi doğrudan Google Sheets, Excel, Airtable veya Notion’a gönderip iç analizde kullanın.
- Zamanlayın (isteğe bağlı): Makul aralıklarla planlı çekimler kurun—asla çok sık olmayacak şekilde.
- Belgeleyin: Neleri, ne zaman ve neden çektiğinizi kaydedin.
Thunderbit arayüzü, her adımda uyumlulukla ilgili bir husus varsa sizi uyarır—yani hiçbir zaman karanlıkta ilerlemezsiniz.
Thunderbit'in Uyumluluk Özellikleri Hakkında Daha Fazla Bilgi Edinin Ücretsiz plan ayda 6 sayfayı kapsar, kredi kartı gerekmez — herkese açık sayfalarda çıkarma işlemini düşük riskle denemenin iyi bir yoludur. Get Started Free
Sonuç ve Temel Öneriler: Veri Değerini Güvenli ve Uyumlu Şekilde Açığa Çıkarma
Web scraping, işletme büyümesi için güçlü bir araçtır—ama kuralsız bir alan değildir. Hukuki tablo karmaşık olsa da temel prensipler nettir:
- Mümkün olduğunda kamuya açık, kişisel olmayan veriyi iç kullanım için çekin.
- Başlamadan önce her zaman site şartlarını, robots.txt dosyasını ve ilgili yasaları kontrol edin.
- Hukuki dayanağınız ve gizlilik planınız yoksa kişisel veri veya yaratıcı içerik çekmekten kaçının.
- İş akışınızı yönlendirmek ve riski azaltmak için Thunderbit gibi uyumluluk dostu araçlar kullanın.
- Sürecinizi belgelendirin ve istenirse durmaya hazır olun.
Uyumluluğu bir alışkanlığa dönüştürdüğünüzde, web verisinin değerini hukuki baş ağrısı yaşamadan ortaya çıkarabilirsiniz. Uyumlu scraping’in ne kadar kolay olabileceğini görmek istiyorsanız, Thunderbit’i deneyin. Hukuk ekibiniz de gelecekteki siz de size teşekkür edecek.
Web scraping, uyumluluk ve otomasyon üzerine daha fazla derinlemesine içerik için Thunderbit Blog’a göz atın.
Uyumlu Veri Çekimi için Agentic Web Scraper’ı Deneyin Get Started Free
Sıkça Sorulan Sorular
1. Herhangi bir web sitesinden veri çekmek yasal mı?
Her zaman değil. Kamuya açık ve kişisel olmayan veriyi iç kullanım için çekmek birçok bölgede genellikle yasaldır; ancak kişisel veri, telifli içerik veya giriş arkasındaki verileri çekmek riskli ya da doğrudan yasa dışı olabilir. Scraping yapmadan önce mutlaka sitenin şartlarını ve yerel yasaları kontrol edin (Thunderbit Blog).
2. Scraping ile veriyi yeniden kullanmak arasındaki fark nedir?
Scraping, veriyi toplama eylemidir; yeniden kullanım ise bu veriyi yayımlamak, satmak ya da başka şekilde dağıtmaktır. İç kullanım çok daha güvenlidir. Çekilen veriyi yeniden yayımlamak veya satmak telif, veritabanı hakkı ya da sözleşme ihlali iddialarına yol açabilir (Thunderbit Blog).
3. Thunderbit uyumluluğu nasıl destekler?
Thunderbit yalnızca tarayıcınızda görünen veriyi çeker, riskli siteler konusunda uyarır, ilgili (hassas olmayan) alanları önerir ve sunucuları zorlamamak için istekleri kontrollü hızda gönderir. Ayrıca verinizi saklamaz ve dışa aktarma seçenekleri de iç kullanım için tasarlanmıştır (Thunderbit Blog).
4. Cease-and-desist mektubu alırsam ne yapmalıyım?
Scraping’i derhal durdurun ve projenizi yeniden değerlendirin. Doğrudan durma talebinden sonra devam etmek, gri alanı açık bir siber suç veya sözleşme ihlaline çevirebilir (Thunderbit Blog).
5. Kamuya açıksa kişisel veri çekebilir miyim?
Hukuki dayanak olmadan hayır. GDPR ve CCPA gibi gizlilik yasaları kamuya açık kişisel veriler için bile geçerlidir. Açık rıza ya da güçlü bir meşru menfaat gerekir ve veriyi sorumlu biçimde ele almalısınız (Thunderbit Blog).
Bu rehber yalnızca bilgilendirme amaçlıdır ve hukuki tavsiye niteliği taşımaz. Karmaşık veya yüksek riskli projelerde, kendi yargı alanınızdaki veri ve gizlilik hukukuna hâkim nitelikli bir avukata danışın.
Daha Fazla Oku




