
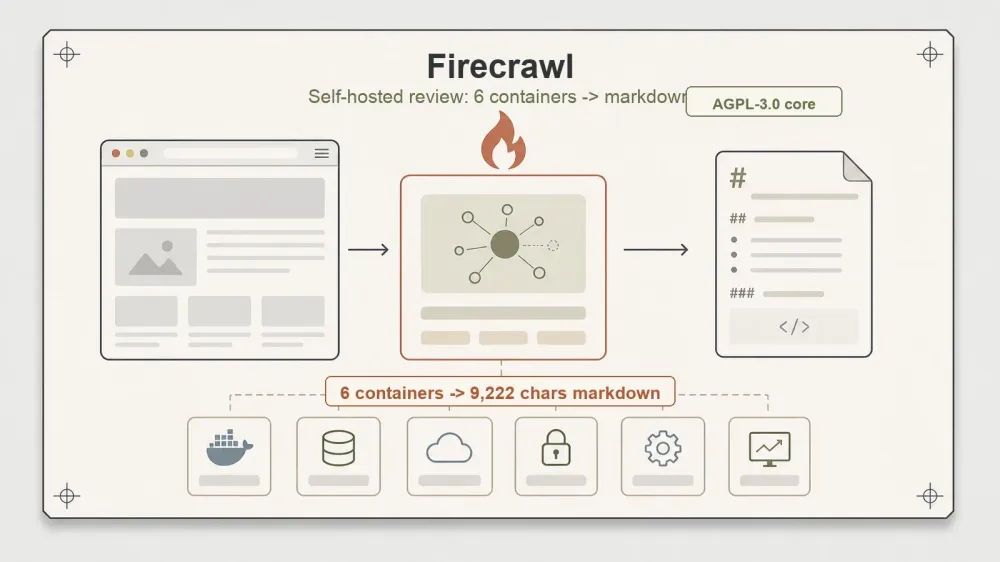
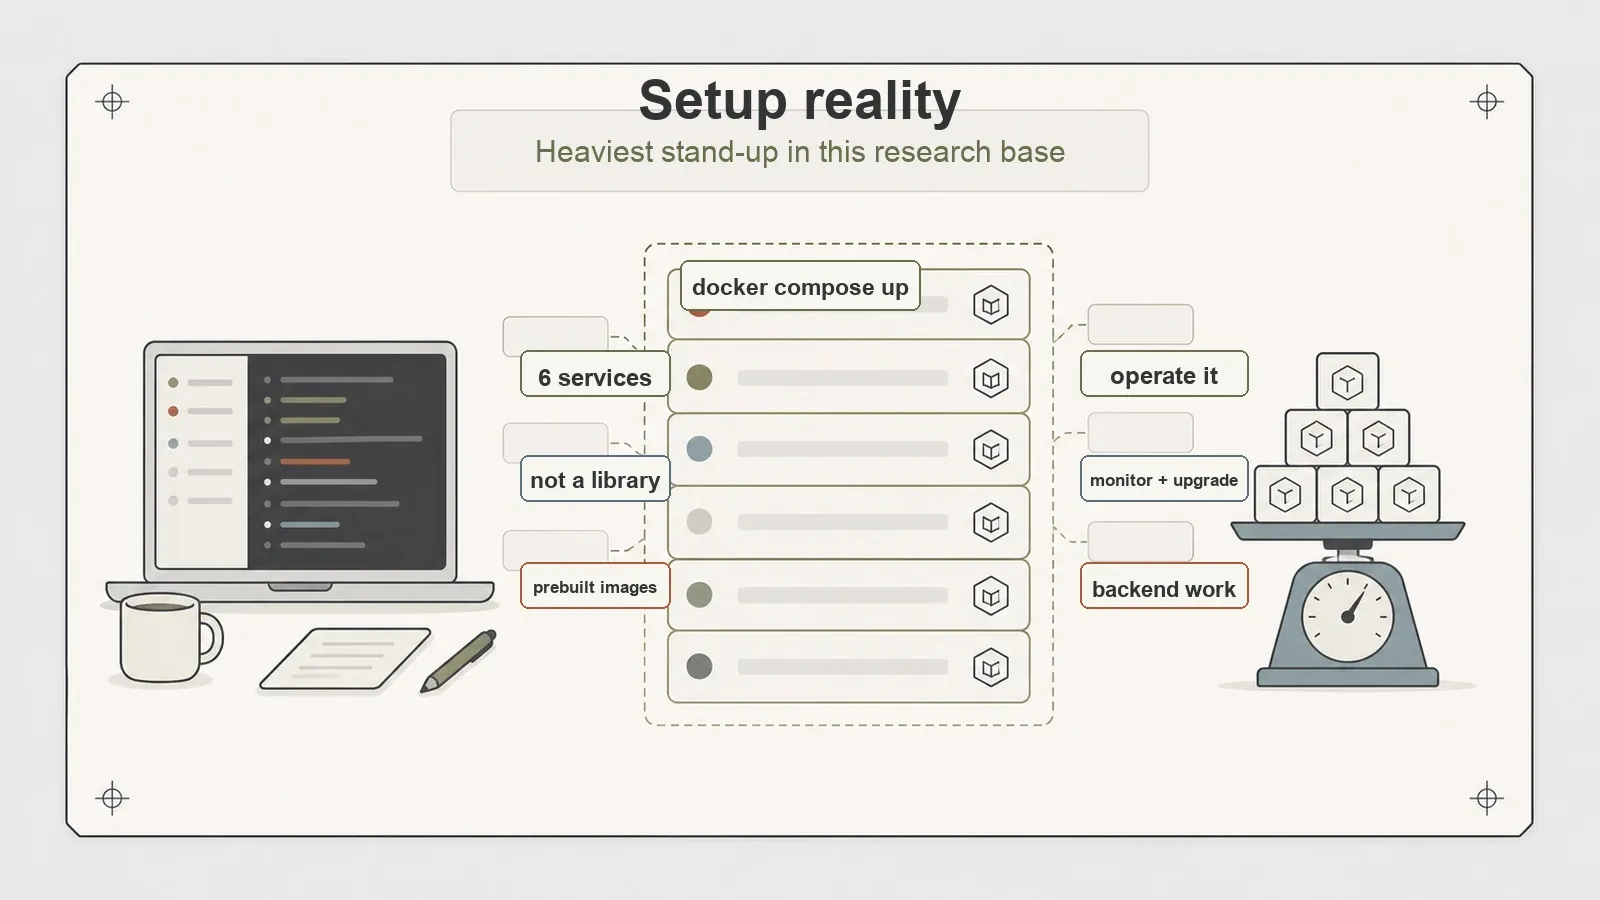
Çoğu kişi Firecrawl'u, pip install yapıp, bir betik yazıp işi bitiren diğer scraping kütüphaneleriyle aynı kefeye koyar. Ancak bu bakış açısı yanlış ve tek bir komut bile yazmadan önce aradaki farkı anlamak çok önemli. Firecrawl, kendi kendine barındırılan bir kütüphane değil; çalıştırdığınız bir hizmettir ve onu ayağa kaldırmak, birbiriyle konuşan altı Docker konteynerini çalıştırmak anlamına gelir.
Kendi kendine barındırılan bu yığını bir Mac'te (arm64, colima aracılığıyla Docker) bulut anahtarı olmadan çalıştırdım. /v1/scrape uç noktasını birkaç scraping dostu demo siteye yönlendirdim ve sonuçları gözlemledim. Kısaca özetlemek gerekirse: temel vaat yerine getirildi — bir sayfa girdi, temiz, LLM'ye hazır Markdown çıktı — ancak kurulum, bu araştırma için kullandığım tüm araçlar arasında en zahmetlisiydi. Bu, nihai bir değerlendirme değil, geçici bir bakış açısıdır ve neyi test edip etmediğimi açıkça belirteceğim.
Firecrawl Bir Hizmettir, Bir Kütüphane Değil
Öncelikle düzeltmemiz gereken zihinsel model bu. Çoğu geliştiricinin kullandığı scraping araçları kütüphanelerdir: bir bağımlılık eklersiniz, bir fonksiyon çağırırsınız ve kendi sürecinizde HTML veya ayrıştırılmış veri alırsınız. Firecrawl ise kendi kendine barındırılan farklı bir yapıya sahip. Kendi API'si olan çalışan bir platformdur ve onunla HTTP üzerinden iletişim kurarsınız.
Resmi konumlandırması "web'i büyük ölçekte aramak, kazımak ve etkileşim kurmak için API" şeklindedir ve ürünün yapısı tam olarak budur — sayfalar girer, temiz Markdown veya yapılandırılmış veri çıkar. Kendi kendine barındırdığınızda, Firecrawl'a bağlanmıyorsunuz. Bir docker compose yığını kuruyor ve bir uç noktaya istek gönderiyorsunuz, tıpkı herhangi bir dahili mikro hizmete istek gönderir gibi.
Çalıştırdığım yığın altı hizmetten oluşuyordu:
- api — aslında çağırdığınız HTTP arayüzü
- playwright-service — JavaScript oluşturma için başsız bir tarayıcı
- redis — kuyruk ve önbellek
- rabbitmq — mesaj aracısı
- nuq-postgres — iş durumu için bir Postgres çeşidi
- foundationdb — dağıtılmış anahtar-değer depolama
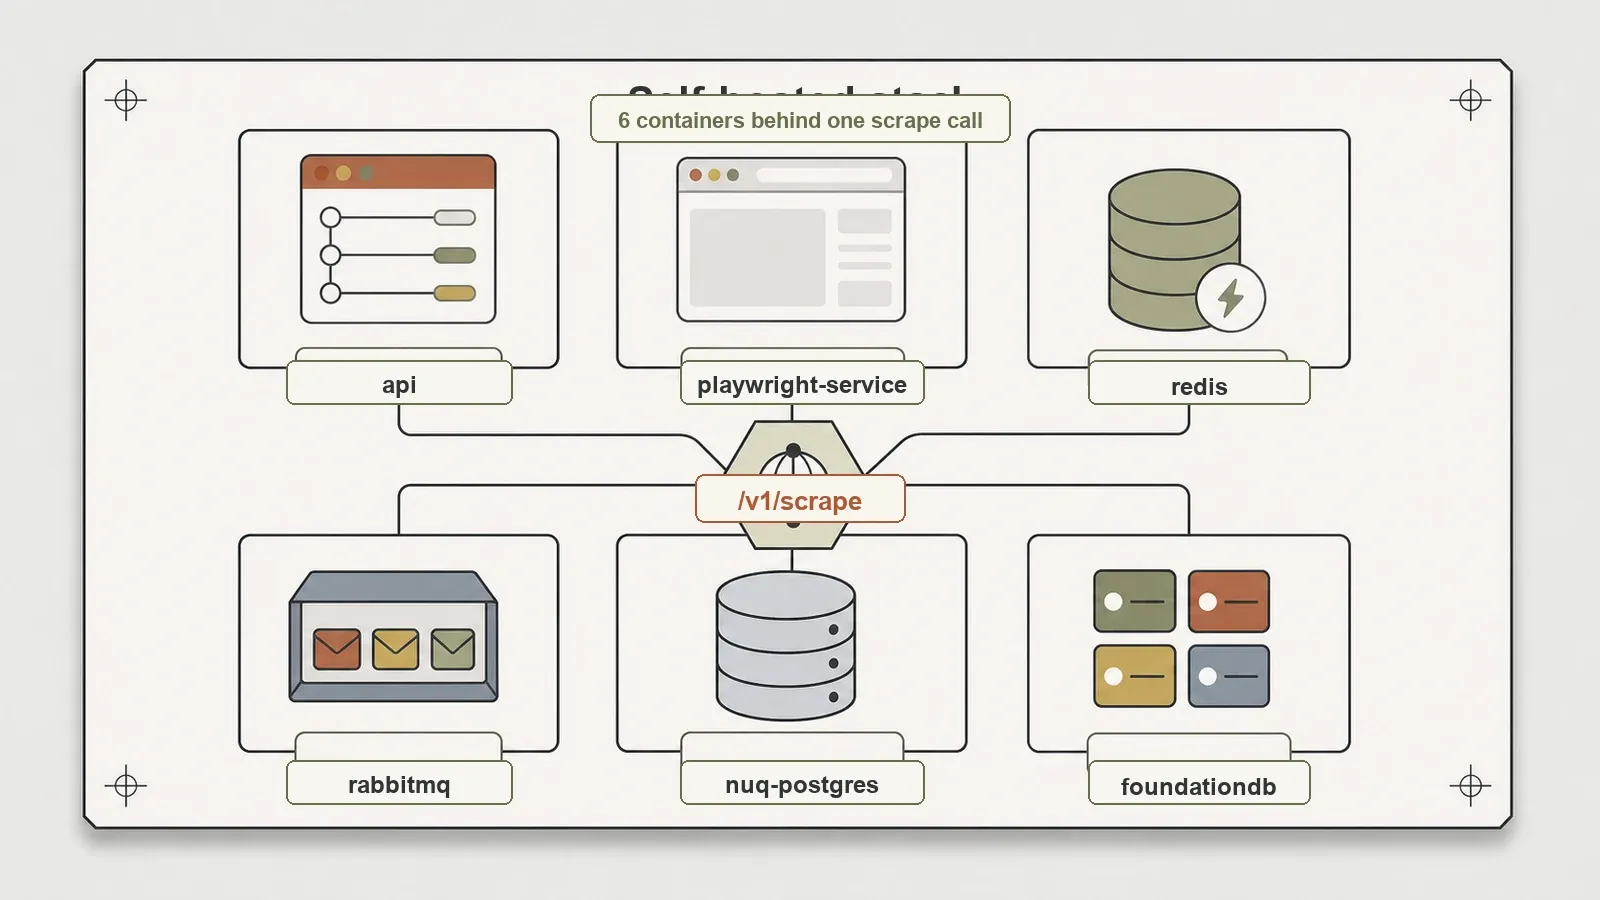
Bu, bir yardımcı betik değil, gerçek bir arka uç. Redis, RabbitMQ, Postgres ve FoundationDB'nin hepsi kendi başlarına endüstriyel düzeyde altyapı bileşenleridir. Bunun karşılığı, Firecrawl'ın scraping'in karmaşık kısımlarını — kuyruklama, oluşturma, yeniden denemeler — tek bir API çağrısının arkasında halletmesidir. Maliyeti ise bu altı konteyneri işletmenizdir. Bu takas aklınızda bulunsun; bu incelemenin ana fikri budur.
Referans olarak, firecrawl-py 4.32.0 ve firecrawl-js 4.30.0 SDK'larına karşı test yaptım, 2026-07-09 tarihinde resmi önceden oluşturulmuş ghcr.io/firecrawl/firecrawl:latest görüntüsünü çektim. Depo bu tarihte yaklaşık 148 bin yıldıza sahip (bunu bir kalite puanı değil, meta veri olarak kabul edin), AGPL-3.0 lisansı altında — ticari kullanım için hesaplamayı değiştirdiği için geri döneceğim bir detay.
Temel Test: Bir Sayfa Temiz Markdown'a Dönüşür
Firecrawl'ın var olma nedeni, bir web sayfasını bir LLM'in gerçekten okuyabileceği bir Markdown'a dönüştürmektir. Bu yüzden ilk kontrol ettiğim şey buydu.
/v1/scrape'i books.toscrape.com'a yönlendirdim, özellikle scraping pratiği için oluşturulmuş statik bir katalog. Sonuç: All products | Books to Scrape sayfa başlığı doğru bir şekilde ayrıştırılmış, temiz, LLM'ye hazır 9.222 karakter Markdown. Bir dizeye dökülmüş ham HTML değil — başlıklar, bağlantılar ve resim referansları sağlam, yapılandırılmış Markdown. Doğrudan bir geri alma hattına bırakabileceğiniz veya ikinci bir temizleme geçişi olmadan bir modele besleyebileceğiniz türden bir çıktı.
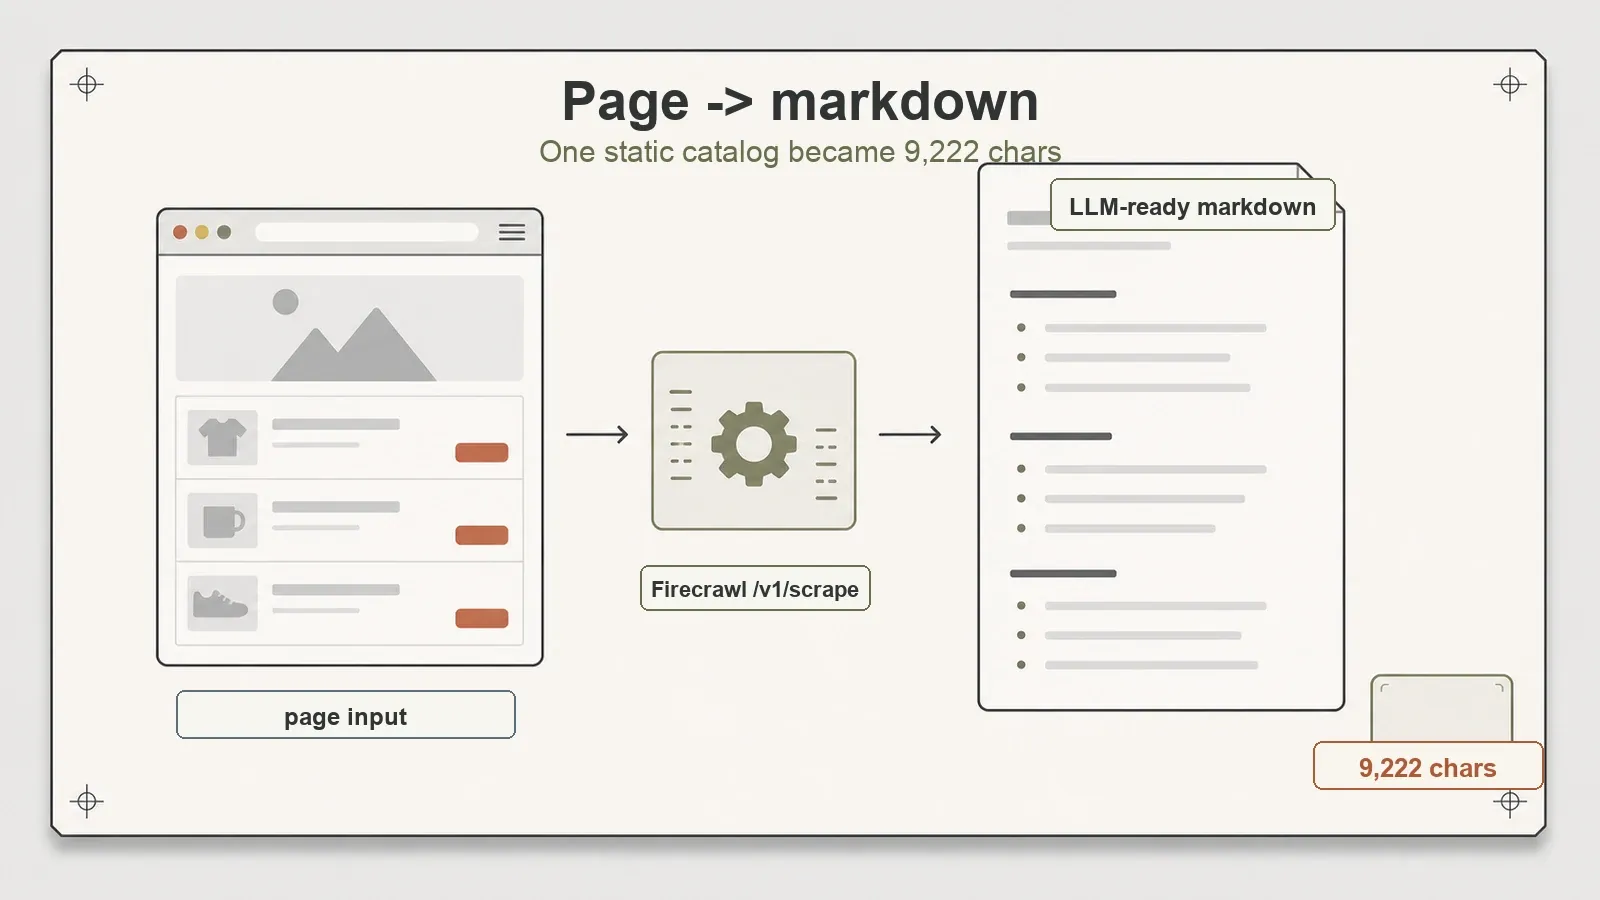
Bu, Firecrawl'ın en güçlü yönüdür ve kendi kendine barındırılan sürüm bunu sorunsuz bir şekilde sağladı. İşiniz "bu sayfanın okunabilir özünü Markdown olarak ver" ise, statik bir sayfa tam olarak reklamı yapıldığı gibi geri döndü. Bu gerçekten kullanışlı bir ilkeldir ve aracın bu kadar takipçisi olmasının nedenidir.
Kapsam hakkında kesin olmak gerekirse: tek sayfalık /v1/scrape yolunu kullandım. Tüm bir siteyi gezen çok sayfalı tarayıcı /v1/crawl'ı test etmedim. Bu, kendi hata modlarına sahip ayrı bir yetenektir ve onu çalıştırmadığımda çalıştığını iddia etmeyeceğim.
JavaScript Sayfaları: Paketlenmiş Tarayıcı Konteynerini Hak Ediyor
Statik bir sayfa kolay durumdur. Herhangi bir scraper için daha zor soru, içeriğin yalnızca JavaScript çalıştıktan sonra ortaya çıkması durumunda ne olacağıdır — ki modern web'de çoğu zaman böyledir.
İşte bu noktada playwright-service konteyneri ek yük olmaktan çıkıp asıl mesele olmaya başlar. Scraper'ı quotes.toscrape.com/js/'ye yönlendirdim, demo sitenin alıntılarını istemci tarafında oluşturan bir versiyonu. Firecrawl sadece ham HTML'yi getirseydi, alıntılar orada olmazdı — tarayıcı sayfanın betiğini yürütmeden önce var olmazlardı.
Scrape 1.574 karakter Markdown ile geri döndü ve Einstein alıntısı içindeydi. Bu alıntı JavaScript sonrası içeriktir: varlığı, playwright-service'in metni çıkarmadan önce sayfayı gerçek bir tarayıcı motorunda gerçekten oluşturduğunu, boş ön-oluşturma kabuğunu almadığını kanıtlar.
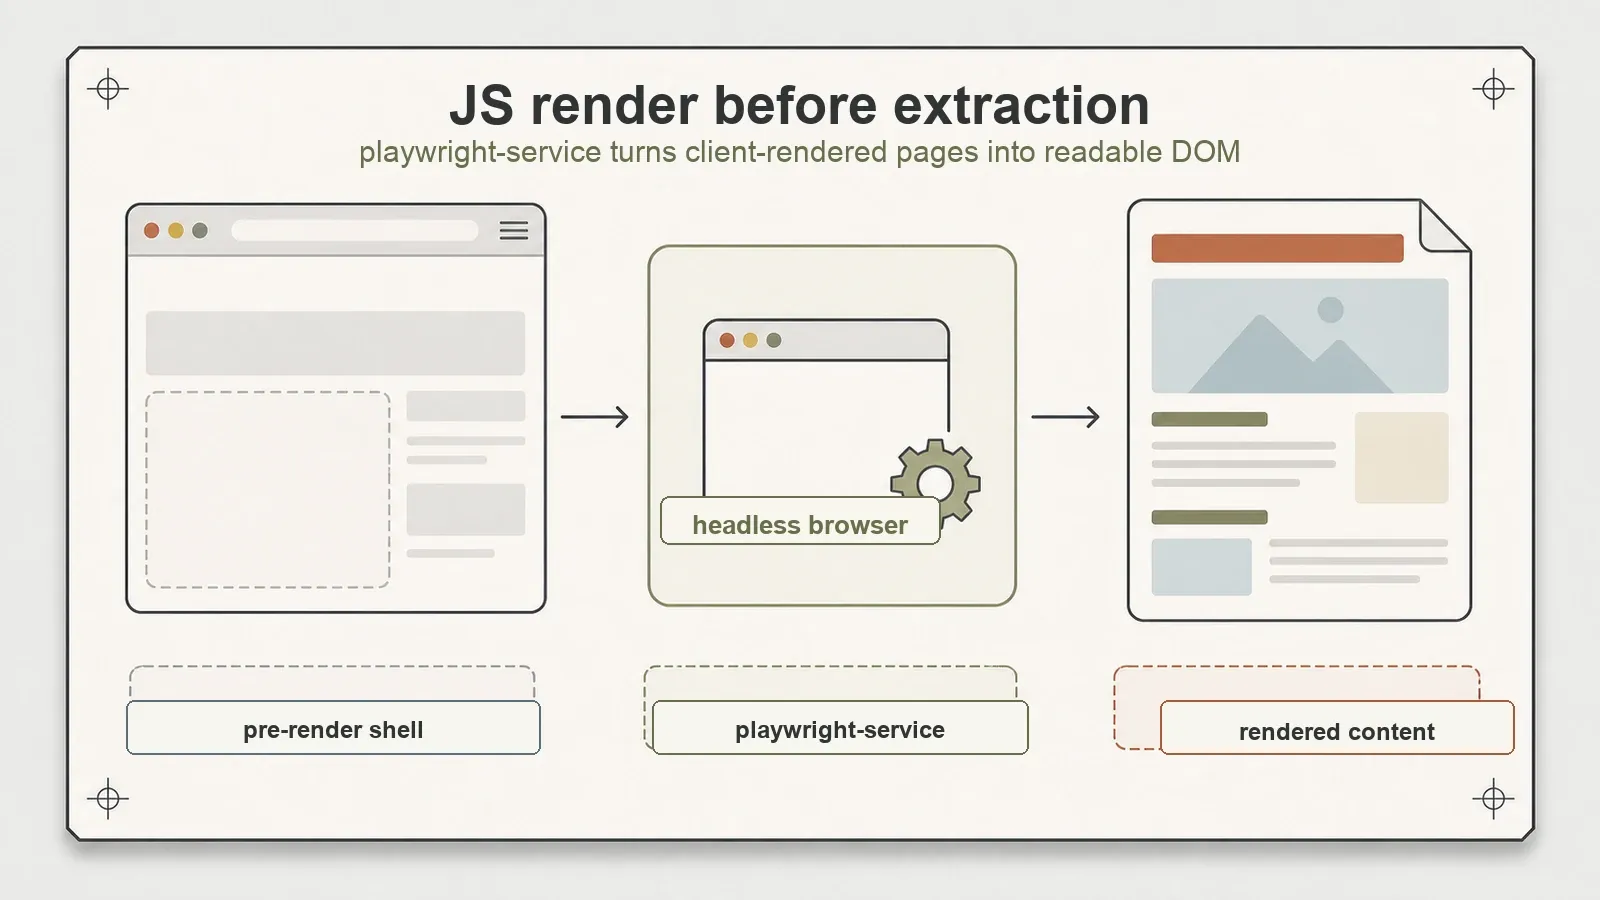
Dolayısıyla altı konteynerden biri başsız bir tarayıcıdır ve işini yapar. Bu, daha ağır mimarinin somut gerekçesidir: sadece konteynerler için ödeme yapmıyorsunuz, kendi tarayıcı otomasyonunuzu kurmadan JS ağırlıklı sayfaları oluşturma yeteneği için ödeme yapıyorsunuz. Birçok gerçek dünya hedefi için bu, kullanılabilir çıktı ile boş div'ler arasındaki farktır.
Hedef Kötü Olduğunda: Yapılandırılmış Hatalar, Çökme Yok
Scraper'lar hayatlarının şaşırtıcı bir kısmını çalışmayan şeylere — ölü ana bilgisayarlar, yazım hatası olan URL'ler, takılan sunucular — işaret ederek geçirirler. Bir aracın nasıl başarısız olduğu, nasıl başarılı olduğu kadar önemlidir.
API'ye bilerek geçersiz bir ana bilgisayar besledim. Yapılandırılmış bir HTTP 500 döndürdü ve çalışmaya devam etti — istemciye kusulan bir yığın izi yok, devrilen bir konteyner yok, takılan bir süreç yok. Hata, arayanın dallanabileceği temiz bir yanıt olarak geri döndü.
Bu, bir boru hattına koyacağınız bir şeyden istediğiniz sıkıcı, doğru davranıştır. Kötü bir hedefte panikleyen bir scraper, etrafında otomasyon yapamayacağınız bir scraper'dır. Bu, yakalayıp devam edebileceğiniz bir hata döndürdü. Yalnızca tek bir hata durumunu test ettim, bu yüzden bunu "attığım tek hatayı doğru bir şekilde ele aldı" olarak okuyun, kapsamlı bir dayanıklılık denetimi olarak değil — ancak tek veri noktası doğru sonuçtu.
Kurulum Gerçekliği: Tabanın En Ağır Yükü
Şimdi lansman tweet'i için kimsenin ekran görüntüsü almadığı kısım. Firecrawl kendi kendine barındırılan, abartısız, bu araştırma tabanındaki herhangi bir aracın en karmaşık kurulumuydu — ve birçoğunu kurdum.
Altı konteyner temel maliyettir. Ancak yolda iki aksaklık da yaşadım ve bunların kimin hatası olduğunu tam olarak belirtmek istiyorum — Firecrawl'ın değil, ortaya çıktığı gibi.
Birinci aksaklık: kaynaktan derleme. Görüntüleri kaynaktan derlemek, colima VM'imin içinde bir containerd snapshotter hatası nedeniyle başarısız oldu. Bu, derleme ile colima'nın depolama katmanı arasındaki bilinen, kararsız bir etkileşimdir — Firecrawl'da bir hata değil, ortamımdaki bir altyapı aksaklığı. Compose dosyası bir alternatif belgeliyor: yerel olarak derlemek yerine resmi önceden oluşturulmuş ghcr.io/firecrawl/* görüntülerini kullanın. Bunlara geçtim ve tüm yığın temiz bir şekilde kuruldu. Colima yerine standart bir Docker daemon kullanıyorsanız, bunu hiç görmeyebilirsiniz; bunu bir ortam uyarısı olarak işaretliyorum ve temiz bir daemon üzerinde katkıda bulunan derlemesini doğrulamak eksiklikler listemde.
İkinci aksaklık: SSRF koruması. İlk scraping'lerim Firecrawl'ın özel IP / SSRF koruması tarafından engellendi. Neden? Colima'nın ağ iletişimi genel ana bilgisayar adlarını 198.18.x.x adreslerine eşler, bunlar Firecrawl'ın doğru bir şekilde özel olarak kabul ettiği ayrılmış bir aralıkta yaşar — bu yüzden güvenlik katmanı işini yaptı ve dahili bir hedef gibi görünen şeyi getirmeyi reddetti. Yalnızca yerel test için bunu aşmak için ALLOW_LOCAL_WEBHOOKS=true ayarladım.
Bu bayrak üretime kopyalanır ve olaylara neden olur, bu yüzden ne olduğunu tam olarak belirtin: SSRF koruması bir engel değil, bir özelliktir. Bir scraping hizmetinin dahili ağınıza vurmak için kandırılmasını engelleyen şey budur. Colima'nın DNS'indeki bir tuhaflık, meşru genel hedeflerimin VM içinde özel görünmesine neden olduğu için onu devre dışı bıraktım. Gerçek bir dağıtımda SSRF korumasını kapatmayın. Bu incelemeden tek bir operasyonel not alırsanız, onu alın.
Her iki aksaklık da, açıkça söylemek gerekirse, Docker'ı bir dizüstü bilgisayarda colima aracılığıyla çalıştırmanın eserleriydi — yazılımdaki kusurlar değil. Öte yandan, kurulum ağırlığı gerçek ve bu Firecrawl'ın tasarımı gereği. Bu, hızlı bir yerel betik istediğinizde başvurduğunuz araç değildir; oluşturma yeteneğine sahip bir scraping hizmeti istediğinizde ve bunun için altyapı çalıştırmaya istekli olduğunuzda kurduğunuz araçtır.
Test Etmediklerim ve Yapmadıkları
İşte ele almadıklarım ve aracın size vermedikleri.
Kendi kendine barındırılan Fire-engine'e sahip değil. Firecrawl'ın bulut ürünü, bot savunmalarını aşmak için tescilli anti-blok katmanı olan Fire-engine'i içerir. Projenin kendi SELF_HOST.md belgesine göre, kendi kendine barındırılan örnekler buna sahip değildir. Bu yüzden, kendi kendine barındırılan Firecrawl'ın kutudan çıktığı gibi agresif anti-bot sistemlerini deldiğini hayal ediyorsanız, resmi düzeltin — bu yetenek bulut katmanında yaşar ve çalıştırdığım şeyin bir parçası değildi.
Bulut API'si burada test edilmedi. Bulut anahtarım yoktu, bu yüzden yukarıdaki her şey yalnızca kendi kendine barındırılan yığındır. Yönetilen bulut hizmeti — Fire-engine, barındırılan ölçeklendirme ve AI özellikleri ile — farklı bir üründür ve performansını dışarıdan karakterize etmeyeceğim. Herhangi bir bulut iddiasını bu incelemenin kapsamı dışında tutun.
AI özellikleri bir anahtar gerektirir. json yapılandırılmış çıktı formatı ve /extract uç noktası bir LLM'ye dayanır, bu da bir OpenAI anahtarı getirmek veya Ollama'yı bağlamak anlamına gelir. Bu, model seçimini malzeme listesine koyar: bir kurulum yapmadan önce, getirebileceğiniz sağlayıcıların mevcut API fiyatlandırmasını karşılaştırın. Bu yolları kullanmadım, bu yüzden /extract ve yapılandırılmış json çıktısı da test edilmeyen sütunda yer alıyor.
Proxy'ler bir uyarıdır, başlık değil. Firecrawl proxy yapılandırmasını destekler, ancak bunu bilerek bir dipnot olarak listeliyorum — bu, çevirebileceğiniz bir düğmedir, aracı seçmek için bir neden değildir ve kendi kendine barındırılan sürümde bulutun anti-blok katmanı hala eksiktir.
AGPL-3.0 gerçek bir uyumluluk kararıdır. Bu, kendi başına bir başlık hak ediyor.
Lisans: Göndermeden Önce AGPL-3.0'ı Okuyun
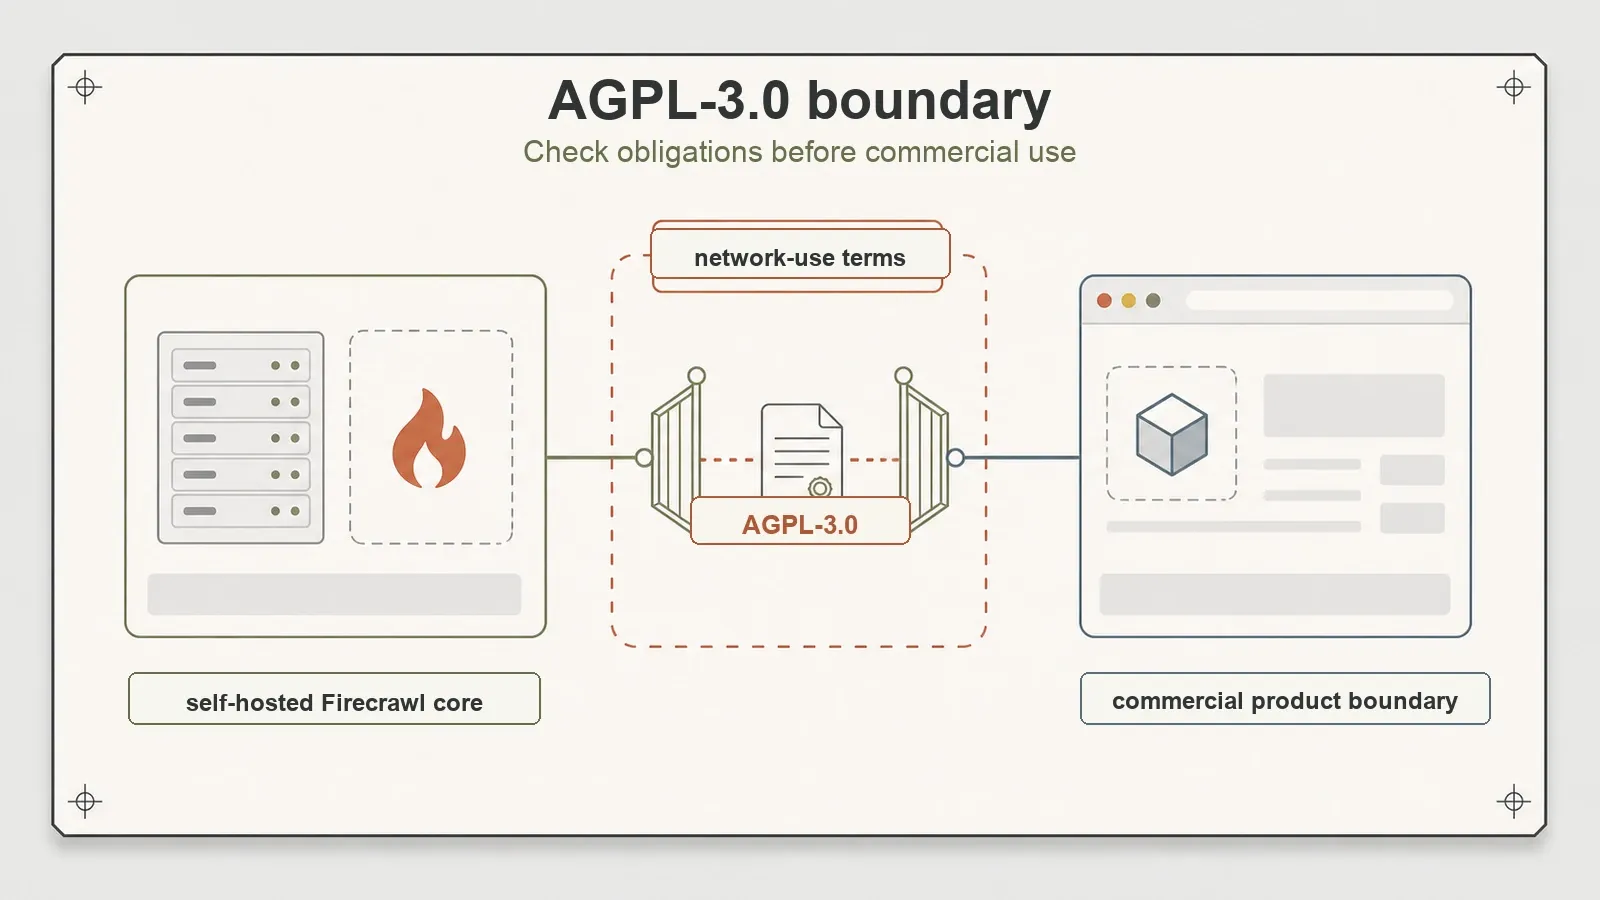
Firecrawl AGPL-3.0 altında lisanslanmıştır. Bu, bir README'nin altındaki önemsiz bir satır değildir — ağ kullanım maddesi olan güçlü bir copyleft'tir ve kendi kendine barındırılan bir örnek üzerine ticari bir ürün inşa edip edemeyeceğinizi doğrudan etkileyebilir.
Kısacası: standart GPL yükümlülükleri dağıtım üzerine tetiklenir. AGPL daha da ileri gider — ağ kullanım hükmü, yazılımın işlevselliğini bir ağ üzerinden kullanıcılara sunmanın, kaynak kullanılabilirliği yükümlülüklerini taşıyan bir kullanım türü olarak sayılabileceği anlamına gelir. Kendi kendine barındırılan Firecrawl'ı müşterilerinizin internet üzerinden ulaştığı bir hizmetin içine yerleştiriyorsanız, bu madde doğrudan kapsamdadır ve "hiçbir zaman bir ikili dosya göndermedik" insanların sandığı kaçış yolu değildir.
Ben avukatınız değilim ve lisans yorumu tam olarak nasıl dağıttığınıza bağlıdır. Ancak herhangi bir ticari tavsiye için AGPL-3.0, ince yazı değil, birinci sınıf bir husustur. Üzerine inşa etmeden önce şirketinizdeki lisanslamadan sorumlu kişiyi dahil edin. Bunu işaretlemek Firecrawl'a bir eleştiri değildir — birçok mükemmel araç AGPL'dir — sadece masada erken olması gereken bir gerçektir.
Thunderbit'in Geliştirici Yığını Nereye Uyar
Web Veri Çıkarma için Thunderbit'i Deneyin
Gerçek hedefiniz "sayfa → LLM'ye hazır Markdown" veya "sayfa → yapılandırılmış veri" ise ve altı konteynerlik operasyonel vergi artı AGPL sorunu sahip olmak istemediğiniz şeylerse, Thunderbit'in geliştirici yığınının tam olarak bu boşluğu doldurmak için inşa edildiği yer burasıdır. 100.000'den fazla uzantı kullanıcımızın arkasındaki aynı AI motoru, teknik çalışmalar için üç şekilde sunulur — altyapı bizim tarafımızda tutulur.
- Açık API (REST).
POST /distillbir sayfayı temiz, LLM'ye hazır Markdown'a dönüştürür;POST /extracttanımladığınız bir JSON Şemasına göre yapılandırılmış veri döndürür. JS oluşturma, anti-bot işleme ve dinamik içerik sunucu tarafında ele alınır — çalıştırmanız gereken bir tarayıcı konteyneri yok. BirrenderModebayrağı (none/basic/full) ne kadar yoğun oluşturduğunu kontrol eder ve toplu uç noktalar distill için 100 URL'ye kadar işler. - MCP sunucusu. Resmi bir Model Bağlam Protokolü sunucusu, böylece Claude veya Cursor içindeki bir AI ajanı görev sırasında scraping yapabilir: bir çıkarma planlamak için
thunderbit_suggest_fields(ücretsiz), Markdown içinthunderbit_distill, yapılandırılmış veri içinthunderbit_extract. Ajan, ortamından ayrılmadan ne zaman veri çekeceğine karar verir. - CLI.
npx -y @thunderbit/thunderbit-cliterminalden, betiklerden, CI'dan veya cron'dan scraping yapar — tarayıcı yok, bakılacak bir yığın yok. Doğrudan diğer araçlara aktarın:thunderbit distill "$URL" -f markdown | claude -p "summarise".
Kendi kendine barındırılan Firecrawl ile karşıtlık temizdir. Firecrawl kendi kendine barındırılan, size tam kontrol ve tam operasyonel sahiplik verir: altı konteyner, kurulum ağırlığı, AGPL koşulları ve anti-blok için Fire-engine yok. Thunderbit'in API/MCP/CLI'si, bu kontrolü, konteynerler, anti-bot katmanı ve copyleft yükümlülükleri sizin üzerinizden kaldırılmış, şema eşleşmeli yapılandırılmış JSON — sadece ham Markdown değil — döndüren barındırılan bir motorla takas eder. Altyapıya farklı iştahlar için farklı araçlar.
İşte takas tek bir görünümde:
| Husus | Firecrawl kendi kendine barındırılan | Thunderbit geliştirici yığını (API · MCP · CLI) |
|---|---|---|
| Dağıtım şekli | İşlettiğiniz hizmet (6 konteyner) | Çağırdığınız barındırılan API |
| Çalıştırmak için | docker compose ile 6 hizmetlik bir yığın kurun | API anahtarı, sonra istek yapın |
| JS oluşturma | Paketlenmiş playwright-service (siz çalıştırırsınız) | Sunucu tarafı, renderMode bayrağı |
| Yapılandırılmış çıktı | LLM anahtarı gerektirir (/extract, json) | JSON Şeması ile POST /extract |
| Anti-bot katmanı | Kendi kendine barındırılan yok (Fire-engine sadece bulutta) | Sunucu tarafında ele alınır |
| Lisans | AGPL-3.0 (ağ kullanımı copyleft) | Ticari API, kodunuzda copyleft yok |
| En iyi ne zaman | Tam kontrol istiyorsanız ve altyapıyı çalıştıracaksanız | Operasyonel yük olmadan Markdown/yapılandırılmış veri istiyorsanız |
Hiçbiri evrensel olarak "daha iyi" değildir. Platformu çalıştırmak sizin için önemliyse — tam veri kontrolü, harici bağımlılık yok ve AGPL durumunuza uyuyorsa — kendi kendine barındırılan Firecrawl yetenekli, aktif olarak bakımı yapılan bir seçimdir. Bir API çağrısı yapmayı ve altı konteynerli hayattan kaçınmayı tercih ediyorsanız, bu Thunderbit yığınının vaadidir.
Firecrawl'ı Kimler Kendi Kendine Barındırmalıdır
Hype'ı bir kenara bırakın ve resim ihtiyaca göre sıralamak için yeterince açıktır.
Firecrawl'ı kendi kendine barındırın eğer scraping altyapınız üzerinde tam kontrol istiyorsanız, Redis / RabbitMQ / Postgres / FoundationDB'yi üretimde çalıştırmaktan rahatsanız, oluşturma ihtiyaçlarınız playwright-service konteynerini haklı çıkarıyorsa ve AGPL-3.0 dağıtım şeklinize uyuyorsa. Temel yetenek gerçektir: hem statik hem de JS ile oluşturulmuş bir sayfadan temiz, yapılandırılmış, LLM'ye hazır Markdown aldım ve tüm yığın önceden oluşturulmuş görüntüler üzerinde çalıştı.
Başka bir yere bakın eğer hızlı bir yerel betik istiyorsanız (bu, tabandaki en ağır kurulumdur, nokta), kendiniz çalıştırmadan bulut düzeyinde anti-blok istiyorsanız (kendi kendine barındırılan Fire-engine'e sahip değil) veya AGPL ağ kullanım maddesi ticari planlarınızla çelişiyorsa. "Sadece bir URL'den Markdown veya yapılandırılmış veri istiyorum, operasyonel yük olmadan" durumu için, Thunderbit'in /distill ve /extract gibi barındırılan bir API'si, konteynerler olmadan aynı alanı kapsar.
Geçici okumam: güçlü çekirdek, ağır operasyonel taahhüt ve ticari olarak inşa etmeden önce temizlemeniz gereken bir lisans. Tüm boru hattına sahip olmak isteyen ekipler için yerini hak ediyor — ve diğer herkesten çok şey istiyor. /v1/crawl'ı çalıştırdıktan, /extract'i bir LLM anahtarıyla kullandıktan ve kaynaktan derlemeyi colima olmayan bir daemon üzerinde doğruladıktan sonra buna tekrar bakacağım; bunlar bu ve nihai bir karar arasındaki açık sorulardır.
Web Veri Çıkarma için Thunderbit'i Deneyin Get Started Free
SSS
Kendi kendine barındırılan Firecrawl bulut sürümüyle aynı mı?
Hayır. Kendi kendine barındırılan sürüm, temel scrape-to-Markdown motorunu ve paketlenmiş playwright-service aracılığıyla JavaScript oluşturmayı sağlar, ancak bulut ürününün tescilli anti-blok katmanı olan Fire-engine'i içermez. /extract uç noktası ve json çıktısı gibi AI özellikleri de kendi LLM anahtarınızı (OpenAI veya Ollama) gerektirir. Bu incelemede yalnızca kendi kendine barındırılan yığını test ettim; bulut API'si kapsam dışıydı.
Kendi kendine barındırılan Firecrawl aslında kaç konteynere ihtiyaç duyar? Altı: api, playwright-service, redis, rabbitmq, nuq-postgres ve foundationdb. Bu, tek bir ikili dosya değil, tam bir hizmet yığınıdır — bu yüzden bu araştırma tabanındaki herhangi bir aracın en ağır kurulumuydu. Sadece bir betik değil, mesaj aracısı, önbellek ve veritabanı altyapısını çalıştırmanın operasyonel yükünü planlayın.
Firecrawl, kendi kendine barındırıldığında JavaScript ağırlıklı sayfaları işleyebilir mi? Evet, testlerimde. Paketlenmiş playwright-service, çıkarmadan önce sayfaları gerçek bir tarayıcı motorunda oluşturur. Bunu quotes.toscrape.com/js/ adresinde doğruladım, burada Einstein alıntısı — yalnızca JavaScript çalıştıktan sonra var olan içerik — döndürülen Markdown'da göründü. Bu oluşturma yeteneği, altı konteynerden birinin başsız bir tarayıcı olmasının tam nedenidir.
AGPL-3.0 lisansı ticari kullanımı etkiler mi? Etkileyebilir ve bunu birinci dereceden bir soru olarak ele almalısınız. AGPL-3.0, ağ kullanım maddesi olan güçlü bir copyleft'tir, bu da yazılımın işlevselliğini bir ağ üzerinden kullanıcılara sunmanın, kaynak kullanılabilirliği yükümlülüklerini taşıyabileceği anlamına gelir — bir ikili dosya dağıtmasanız bile. Kendi kendine barındırılan bir örnek üzerine ticari bir ürün inşa etmeyi planlıyorsanız, taahhütte bulunmadan önce şirketinizdeki lisanslamayı yöneten kişiyle konuşun. Bu inceleme lisansı işaretler; yasal tavsiye değildir.
Firecrawl ile Thunderbit'in geliştirici araçları arasındaki fark nedir?
Firecrawl kendi kendine barındırılan, işlettiğiniz bir hizmettir — kendiniz çalıştırdığınız altı konteyner, AGPL-3.0 koşulları ve yerleşik anti-blok katmanı yok. Thunderbit'in geliştirici yığını (Açık API, MCP sunucusu, CLI) çağırdığınız barındırılan bir motordur: Markdown için POST /distill, JSON-Şema yapılandırılmış veri için POST /extract, JS oluşturma ve anti-bot işleme sunucu tarafında ve kendi kodunuzda copyleft yükümlülüğü yok. Firecrawl, tam altyapı kontrolü isteyen ekiplere uygundur; Thunderbit, operasyonel yük olmadan çıktı isteyenlere uygundur.




