
Sanırım on dördüncü tarayıcı sekmesinden ve üçüncü fiyat hesaplayıcısından sonra şunu fark ettim: 2026'da bir web scraping hizmeti seçmek, veriyi gerçekten çekmekten daha zor. Pazar iyice patladı — no-code Chrome eklentileri, ham API'ler, proxy ağırlıklı kurumsal paketler, AI tabanlı veri çıkarıcılar ve tam hizmet ajanslar aynı bütçe kalemi için yarışıyor.
Birkaç hafta boyunca 12 web scraping hizmetini gerçek işler üzerinde test ettim: e-ticaret sitelerinden ürün verisi çekme, iş rehberlerinden lead çıkarma ve sayfalama ile alt sayfaları olan ilanları kazıma. Amacım özellikleri soyut biçimde sıralamak değildi; asıl soru şuydu: hangi hizmet, hangi ekip için gerçekten uygun?
Bright Data'nın kamuya açık web verisi raporuna göre, kuruluşların %82'si artık kamuya açık web verisini gelecekleri için kritik görüyor. ScrapeOps'un 2025 pazar raporu, kuruluşların %65'inden fazlasının analiz ve yapay zekâ için veri seti oluşturmak amacıyla web scraping kullandığını söylüyor. Buna rağmen Apify'nin 2026 anketi, profesyonellerin %46,7'sinin hâlâ tamamen şirket içi koda güvendiğini ve bunun bakım yükünü taşıdığını gösteriyor.
Araçlara geçmeden önce, scraping'in hukuki tarafına kısa bir bakış atalım.
En İyi Web Scraping Hizmetlerini Nasıl Değerlendirdim
Baktığım kriterler şunlardı. Bunları özellik sayfalarına göre değil, demo sonrasında nelerin bozulduğunu görerek seçtim.
- Kurulum kolaylığı / gereken teknik bilgi — Teknik olmayan biri 10 dakikadan kısa sürede değer görebilir mi?
- Anti-bot ve proxy yönetimi — Servis proxy ve CAPTCHA çözümünü kendi mi yönetiyor, yoksa bu sizin sorununuz mu?
- JavaScript render etme — Dinamik, JS ağırlıklı sayfaları kutudan çıktığı gibi işleyebiliyor mu?
- Dışa aktarma formatları ve entegrasyonlar — Veriyi Sheets, Airtable veya Notion'a ek kod yazmadan taşıyabilir misiniz?
- Zamanlama / otomatik izleme — Cron job olmadan düzenli scraping kurabilir misiniz?
- Ölçeklenebilirlik — 100 sayfada çalışıp 1 milyon sayfada da çalışmaya devam ediyor mu?
- Fiyat şeffaflığı ve ölçek maliyeti — Gelecek ayki faturayı öngörebilir misiniz, yoksa sürpriz mi geliyor?
- AI destekli çıkarım vs. manuel seçiciler — Alanları anlamak için AI mı kullanıyor, yoksa CSS/XPath'i elle mi yazıyorsunuz?
- Zaman içindeki bakım yükü — Hedef site tasarımını değiştirdiğinde ne oluyor?
Son madde özellikle önemli. Octoparse, Apify, Browse AI ve Bright Data gibi araçların kullanıcı yorumlarında aynı şikâyetler tekrar tekrar çıkıyor: kredi fiyatlandırmasının kafa karıştırması, site değişince seçicilerin bozulması, korumalı sayfalarda cloud çalıştırmalarının başarısız olması ve ilk demo sonrasında öğrenme eğrisinin sertleşmesi. "Bakım yükü" güzel bir ek özellik değil. Altı ay sonra hâlâ o aracı kullanıp kullanmayacağınızı belirleyen şey bu.
Hangi Tür Web Scraping Hizmeti Sizin Ekibinize Uyar?
Tek tek araçları kıyaslamadan önce, en faydalı şey sizi doğru kategoriye hızlıca yönlendirmek olur. Web scraping pazarı tek bir pazar değil. Birbiriyle örtüşen beş ayrı pazar var ve yanlış kategori seçmek, doğru kategori içinde yanlış araç seçmekten çok daha fazla zaman kaybettirir.
| Durumunuz | Önerilen Hizmet Türü | Neden | Listeden Uygun Örnekler |
|---|---|---|---|
| Teknik olmayan ekip (satış, pazarlama, operasyon) hızlı veriye ihtiyaç duyuyor | No-code Chrome eklentisi | Web sitesinden tabloya en hızlı geçiş, en düşük kurulum sürtünmesi | Thunderbit, Browse AI, Octoparse |
| Bir uygulama veya iş akışı içine scraping ekleyen geliştirici | Scraping API | Daha fazla kontrol, webhook'lar, asenkron işler, CI/CD ile daha uyumlu | ScrapingBee, ScraperAPI, ZenRows |
| Veriyi AI/LLM iş akışlarına aktaran ekip | AI-native çıkarım API'si | Markdown/JSON öncelikli çıktı, daha az HTML temizleme | Thunderbit API, Firecrawl, Diffbot |
| Proxy altyapısı + yüksek hacim ölçeği isteyen kurumsal ekip | Tam yığın veri toplama platformu | Paketlenmiş proxy'ler, anti-bot, SLA'ler, yüksek eşzamanlılık | Bright Data, Oxylabs, Apify |
| Araç değil, doğrudan veri teslimi isteyen şirket | Yönetilen hizmet / ajans | Kurulum, izleme, kalite kontrol ve teslimat sağlayıcı tarafından yürütülür | ScrapeHero |
Bu teori değil. Zyte'nin 2026 build-vs-buy rehberi bu dengeyi açıkça ortaya koyuyor: kendin yap modeli kontrol sağlar ama sürekli bakım gerektirir; karma yığınlar operasyonel yamalı bohçaya dönüşür; yönetilen hizmetler iç yükü kaldırır ama self-servis esnekliğini azaltır.
AI Destekli Çıkarım mı, Geleneksel CSS/XPath Seçiciler mi?
Şu anda pazardaki en büyük teknik ayrım bu.
Geleneksel scraping, tam koordinatlarla verilen bir hazine haritasını takip etmeye benzer. Sayfayı incelersiniz, .product-title gibi bir seçici bulursunuz, bir çıkarım kuralı yazarsınız, test edersiniz ve sitenin yarın da aynı görüneceğini umarsınız. Ön yüz ekibi bir class adını değiştirir ya da içeriği yeni bir div içine sararsa scraper bozulur.
AI destekli scraping ise akıllı bir asistana şunu sormaya benzer: "Bu sayfadaki ürün adını, fiyatı ve stok durumunu bul." Yolu sabitlemek yerine hedefi tarif edersiniz.
Pratikte iki akış şöyle görünür:
Geleneksel akış:
- DevTools'ta elementi incele
.product-titleclass'ını veya XPath'i belirle- Çıkarım kuralını yaz
- Örnek sayfalarda test et
- Site class adlarını değiştirdikçe düzelt
AI destekli akış (ör. Thunderbit):
- Sayfayı aç ve bir kez tıkla
- AI hangi sütunların değerli olduğunu seçer — ürün adı, fiyat, puan
- Farklı bir şey istersen müdahale et ya da neye ihtiyacın olduğunu söyle
- Yoksa çalışır ve tabloyu sana verir
Yayınlanan araştırmalar, pazarlamanın söylediğinden daha dar kapsamlı. 2025 Scientific Reports makalesi, AI crawler'ın geleneksel olanlara göre %35 daha iyi çıkarım doğruluğu ve %40 daha iyi işleme verimliliği sunduğunu bildiriyor; ancak test ortamı ürün sayfaları veya iş rehberleri değil, gazete arşivleri olduğu için bu rakamları bu yazıdaki sitelere doğrudan taşımam. 2025 Springer incelemesi ise daha yararlı: AI modelleri dinamik yapılara daha iyi uyum sağlıyor, ancak alan adı veya desenler anlamlı biçimde değiştiğinde hâlâ yeniden eğitim ya da yedek mantık gerekiyor.
| Boyut | Geleneksel (CSS/XPath) | AI Destekli Çıkarım |
|---|---|---|
| Kurulum süresi | Site başına 15–60 dk | Yaklaşık 30 sn |
| Teknik beceri | Geliştirici seviyesi | Gerekmez |
| Düzen değişiklikleri ve yeni siteler | Bozulur — her yeniden tasarımda yeni kural gerekir, her yeni site için yeni kural gerekir | Genellikle uyum sağlar — her çalıştırmada sayfayı yeniden okur |
| Öngörülebilirlik | Deterministik — aynı kural her çalıştırmada aynı alanı çeker | Olasılıksal — yanlış alanı seçebilir, bu yüzden sonuçları kontrol etmek gerekir |
| Veri etiketleme / dönüştürme | Ayrı bir son işlem adımı | Çıkarma sırasında etiketleyebilir, çevirebilir, kategorize edebilir |
| En uygun kullanım | Kararlı, yüksek hacimli ve geliştirici sahipliğindeki iş akışları | Uzun kuyruklu siteler, değişken düzenler, teknik olmayan kullanıcılar |
Gerçek dünyadaki en keskin fark bakımdır. Scraper'ların ne sıklıkla bozulduğuna dair güvenilir bir kamu verisi yok; bu yüzden burada bir sayı vermeyeceğim. Ama G2 ve Capterra'daki seçici tabanlı araç yorumlarında şikâyetlerin şekli çok tutarlı: araç veriyi hiç çekemediği için değil, çoğunlukla site değiştikten sonra çekemez hâle geldiği için eleştiriliyor.
Thunderbit, bu listedeki AI-first yaklaşımın en temiz örneği. AI'si, tek bir tıkla çekilecek alanları seçer; ya da istediğiniz veriyi tek cümlede tarif edebilirsiniz. Field AI Prompts ile veriyi sadece sonradan değil, çıkarım sırasında da etiketleyebilir, çevirebilir, özetleyebilir veya kategorize edebilirsiniz. Open API'si, hem Distill hem de Extract uç noktalarını sunar; böylece aynı AI çıkarım modeli programatik olarak da çalıştırılabilir.
Thunderbit ile AI destekli scraping'i deneyin
Bir Bakışta 12 En İyi Web Scraping Hizmeti
| Hizmet | Tür | En İyi Olduğu Alan | Anti-Bot/Proxy | JS Render | AI Çıkarım | Ücretsiz Plan | Başlangıç Fiyatı (aydan aya) | Dışa Aktarma Seçenekleri |
|---|---|---|---|---|---|---|---|---|
| Thunderbit | No-code Chrome eklentisi + API | Teknik olmayan ekipler | ⚠️ Bulut tabanlı işleme | ✅ | ✅ AI ile eşlenen alanlar | ✅ 6 sayfa ücretsiz | Ücretsiz; ücretli planlar $15/ay'dan başlar | Excel, CSV, JSON, Sheets, Airtable, Notion |
| Bright Data | Tam yığın platform | Kurumsal ölçekli iş akışları | ✅ Sınıfının en iyisi proxy ağı | ✅ | ⚠️ Kısmi / yeni AI katmanları | ✅ ayda 5K kayıt | Aylık minimum yok | JSON, CSV, API, webhook |
| Oxylabs | Kurumsal proxy + scraping | SERP scraping, korumalı siteler | ✅ Residential/DC proxy'ler | ✅ | ⚠️ Sınırlı | ⚠️ Deneme | ~$49/ay | JSON, CSV, API |
| Apify | Platform + pazar yeri | Geliştiriciler, otomasyon kurucuları | ✅ Proxy yapılandırmasıyla | ✅ | ⚠️ Bazı actor'lar | ✅ ayda $5 ücretsiz | $29/ay + kullanım | JSON, CSV, Excel, API |
| ScrapingBee | API hizmeti | Geliştirici iş akışları | ✅ Dahili | ✅ | ⚠️ Bazı AI çıkarım özellikleri | ✅ 1.000 kredi | $49/ay | JSON, HTML, Markdown, API |
| ScraperAPI | API hizmeti | Ölçekli fiyat takibi | ✅ Dahili rotasyon | ✅ | ❌ | ⚠️ 7 günlük deneme, 5K kredi | $49/ay | JSON, CSV, API |
| ZenRows | API hizmeti | Anti-bot ağırlıklı siteler | ✅ Premium anti-bot | ✅ | ⚠️ Beta | ✅ ayda 5K kredi | $19/ay | JSON, API |
| Octoparse | No-code masaüstü + bulut | Görsel no-code scraping | ✅ Dahili | ✅ | ⚠️ Sınırlı otomatik algılama | ✅ Ücretsiz plan (10 görev) | $39/ay | Excel, CSV, JSON, HTML, XML, DB, Sheets |
| Diffbot | AI/NLP platformu | Yapılandırılmış kurumsal veri | ⚠️ Temelden orta seviyeye | ✅ | ✅ NLP tabanlı | ✅ ayda 10K kredi | $299/ay | JSON, CSV, API |
| Firecrawl | Geliştirici API'si (AI) | LLM/RAG iş akışları | ✅ Dahili | ✅ | ✅ Markdown + yapılandırılmış | ✅ ayda 1.000 kredi | $19/ay | Markdown, JSON, HTML, API |
| Browse AI | No-code izleme | Değişim tespiti, teknik olmayan kullanıcılar | ⚠️ Temel | ✅ | ⚠️ Şablon tabanlı | ✅ ayda 50 kredi | $48/ay | CSV, JSON, Sheets, Airtable, API |
| ScrapeHero | Yönetilen hizmet/ajans | Elle uğraşmak istemeyen kurumsal ekipler | ✅ Tam yönetilen | ✅ | N/A | ❌ | $199/ay'dan başlar | Özel teslimat |
Örüntü oldukça net.
Thunderbit, Browse AI ve Octoparse kurulum hızını optimize eder. ScrapingBee, ScraperAPI ve ZenRows geliştirici kontrolünü optimize eder. Bright Data, Oxylabs ve Apify ölçek ve altyapıyı optimize eder. Firecrawl ve Diffbot AI biçimli çıktılar için optimize edilmiştir. ScrapeHero ise sizin hiçbir şeyi işletmek zorunda kalmamanız için optimize edilmiştir.
1. Thunderbit
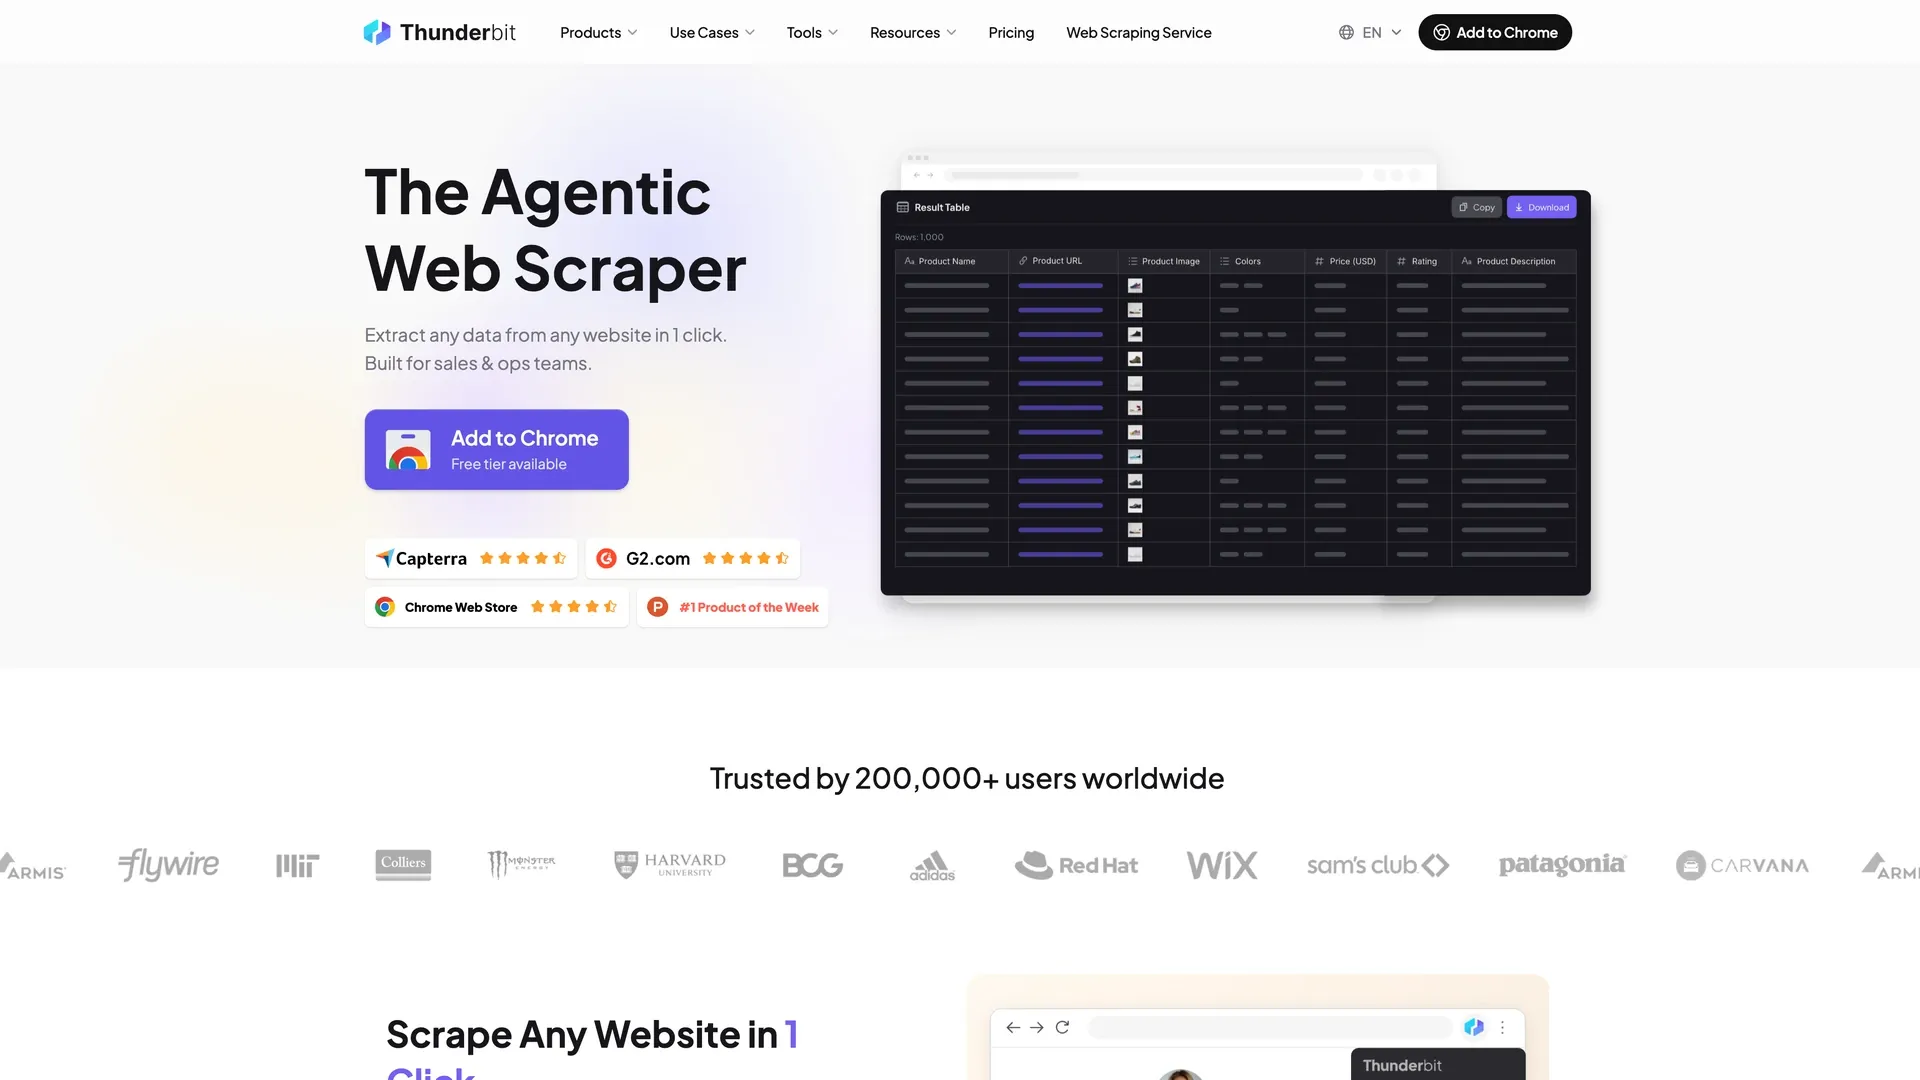 Thunderbit, tek bir seçiciye bile dokunmadan bir web sitesinden tabloya geçmek isteyen teknik olmayan kullanıcılar için listedeki en kolay ürün. Temel iş akışı alışılmadık derecede doğrudan: Chrome eklentisini herhangi bir sayfada açın ve bir kez tıklayın — AI hangi alanların çekilmeye değer olduğunu kendi kendine anlar ve işi çalıştırır; daha spesifik bir şey istiyorsanız bunu düz İngilizce ile tarif etmeniz yeterlidir. Çoğu sayfada süreç gerçekten bu kadar basit. CSS seçicisi yok. XPath yok. Element inceleme yok.
Thunderbit'i farklı kılan şey, yalnızca alan çekmiyor olması. Field AI Prompts kullanarak çıkarım sırasında alanları etiketleyebilir, çevirebilir, özetleyebilir, kategorize edebilir ve yeniden biçimlendirebilirsiniz. Bu önemli, çünkü iş kullanıcıları için asıl darboğaz çoğu zaman çıkarımın kendisi değil, dışa aktarmadan sonra başlayan temizlik süreci. Thunderbit ile Fransızca bir ürün sayfasını tek geçişte çekip İngilizce çıktı ve duygu etiketleri alabilirsiniz.
Temel özellikler:
- Sıfır seçiciyle kurulum — bir tıkla AI sütunları seçer veya ne istediğinizi söylersiniz
- Giriş yapılmış sayfalar için tarayıcı modu ve hızlı herkese açık sayfa scraping'i için bulut modu (bir seferde 50 sayfa)
- Liste sayfalarını otomatik olarak detay sayfası verisiyle zenginleştiren alt sayfa scraping'i
- Yerleşik sayfalama ve sonsuz kaydırma desteği
- Tekrarlayan izleme için doğal dil ile zamanlama (ör. "her Pazartesi sabah 9'da")
- Amazon, Zillow, Google Maps ve Indeed gibi popüler siteler için anında scraper şablonları
- Geliştirici kullanımı için
DistillveExtractuç noktalarına sahip Open API - Çıkarma sırasında çeviri dahil 34 dil desteği
Dışa aktarma tarafı Thunderbit'in en net avantajlarından biri. Excel, CSV, JSON, Google Sheets, Airtable ve Notion'a ücretsiz ve yerel dışa aktarma sunar — Airtable ve Notion dışa aktarmalarında görseller de dahil. Sheets'te çalışan bir satış ekibi ya da araştırmasını Notion'da düzenleyen bir pazarlama ekibi için bu, API-first araçların size bıraktığı bütün bir dönüşüm adımını ortadan kaldırır.
Fiyatlandırma: Kredi bazlı. Ayda 6 sayfalık ücretsiz plan ve Pro özellikleri için 7 günlük deneme var. Ücretli tarayıcı planları aydan aya $15/ay'dan veya yıllık faturalandırmada $9/ay'dan başlıyor. API'nin ayrı bir fiyatlandırması var: başlangıçta 600 ücretsiz birim, ardından Starter'da 6.000 birim için $29/ay, Pro 1'de 60.000 için $72/ay, Pro 2'de 120.000 için $120/ay ve ayda 480.000 birime kadar çıkan bir ölçeklendirme kaydırıcısı. Yıllık faturalandırmada Starter için yılda 60.000 birime $16/ay, Pro 1 için yılda 600.000 birime $40/ay.
Artılar:
- Bu karşılaştırmanın tamamında en düşük kurulum sürtünmesi
- Yerel, tablo odaklı dışa aktarma (JSON'u al sonra uğraş değil)
- Sadece sonrasında değil, çıkarım sırasında da AI dönüşümü
- Satış, e-ticaret, araştırma ve emlak için güçlü uyum
Eksiler:
- Farklı birimlerde iki kredi sistemi var: eklenti çıktı satırı başına 1 kredi alır (alt sayfa scraping ile 2), API ise Distill sayfa başına 1 birim ve Extract sayfa başına 20 birim alır — bütçeyi ayrı ayrı planlamak gerekir
- Ücretsiz plan ayda 6 sayfa; bu, burada sunduğumuz API rakiplerinin verdiğinden çok daha düşük (Firecrawl 1.000 kredi/ay, ZenRows 5.000, Diffbot 10.000)
- Self-serve tarafı kurumsal hacimde sona eriyor: yayınlanan en üst tarayıcı planı aydan aya $38/ay olan Pro ve sonrasında özel Business teklifi var
En uygun olduğu alan: Satış lead üretimi, e-ticaret rakip takibi, pazarlama araştırması, iş ve rehber scraping'i, emlak ilanları.
2. Bright Data
 Bright Data, proxy'ler, scraping API'leri, veri setleri, SERP API'leri ve giderek artan biçimde AI destekli çıkarım için tek bir sağlayıcı isteyen kurumsal alıcıların tercihidir. Tek bir ürün olmaktan ziyade tam bir veri toplama yığınıdır.
Web Scraper API fiyatlandırması herkese açıktır: ayda 5.000 kayıtlık ücretsiz katman, 1.000 kayıt başına yaklaşık $1.50 ile kullandıkça öde ve 384.000 kayıt dahil $499/ay'lık ölçek planı, sonrasında 1.000 kayıt başına $1.30. Buradaki kayıt, yüklenen bir sayfa değil, çıkarılan bir öğedir — tablodaki bir satır. Residential proxy'ler $4/GB'den başlıyor. Ayrıca yapılandırılmış veri setleri, Scraper Studio, AI scraper'lar ve MCP desteği de var.
Temel özellikler:
- Son derece güçlü proxy ağı (residential, datacenter, mobile, ISP)
- Web Scraper API fiyatına dahil tam tarayıcı render ve CAPTCHA çözümü
- Önceden toplanmış veriler için dataset pazaryeri
- Trust Center ve sertifikalarla kurumsal uyum yaklaşımı
Fiyatlandırma: 1.000 kayıt başına yaklaşık $1.50'dan kullandıkça öde; ölçek planı $499/ay'dan başlıyor.
Artılar: Eşsiz ölçek ve proxy altyapısı. Geniş kurumsal yönetişim. Eksiler: Orta ölçekli ekiplerin çoğunun ihtiyacından daha karmaşık. API, proxy ve ek katmanlar bir araya geldiğinde fiyat hızla yükselir. Yeni AI özelliklerine rağmen platform hâlâ teknik bir sahip varsayar.
En uygun olduğu alan: Fortune 500 veri akışları, milyonlarca sayfa çeken veri ekipleri, proxy kalitesinin kritik olduğu coğrafyalar arası scraping, resmî uyum gerektiren kurumlar.
3. Oxylabs
 Oxylabs, korumalı hedeflerde güvenilirliğe en çok önem veren ekipler için en güçlü kurumsal proxy + scraping seçeneğidir. Residential ve datacenter proxy'ler, Web Scraper API, SERP Scraper API, Web Unblocker ve daha yeni Headless Browser katmanı sunar.
Pricing Web Scraper API için $49/ay'dan başlıyor; sayfa başı oran, hedef siteye ve bulunduğunuz plan kademesine bağlı. $49 Micro planında genel bir site — Amazon veya Google olmayan herhangi bir şey — JS render olmadan 1.000 sonuç başına $1.15, JS ile $1.35; $249 Advanced planında bu iki rakam sırasıyla $0.95 ve $1.25 oluyor ve üst kademelerde düşmeye devam ediyor. Residential proxy'ler $6/GB'den başlıyor ve 1TB'de $2.50/GB'a düşüyor.
Temel özellikler:
- Otomatik rotasyon ve oturum yönetimiyle çok güçlü proxy altyapısı
- Arama motoru izleme için özel SERP Scraper API
- Büyük ürünlerde yalnızca başarılı istek için ücretlendirme yaklaşımı
- Net Trust Center ve uyum duruşu
Fiyatlandırma: $49/ay'dan başlar; sürekli ücretsiz katman yoktur (deneme bazlı).
Artılar: Güvenilir proxy'ler, SERP scraping için mükemmel, güçlü kurumsal güven duruşu.
Eksiler: Her plandaki başlık sonuç sayısı Amazon ve JS render olmadan varsayılır — genel bir sitede $49 Micro planı 98.000 değil, yaklaşık 42.600 sonuç verir. 1.000 başına ücret hem hedef siteye hem de plan kademesine göre değiştiği için aynı hacmi çeken iki ekip çok farklı faturalar görebilir.
En uygun olduğu alan: SEO ekipleri, kurumsal SERP izleme, proxy ağırlıklı büyük ölçekli işler.
4. Apify
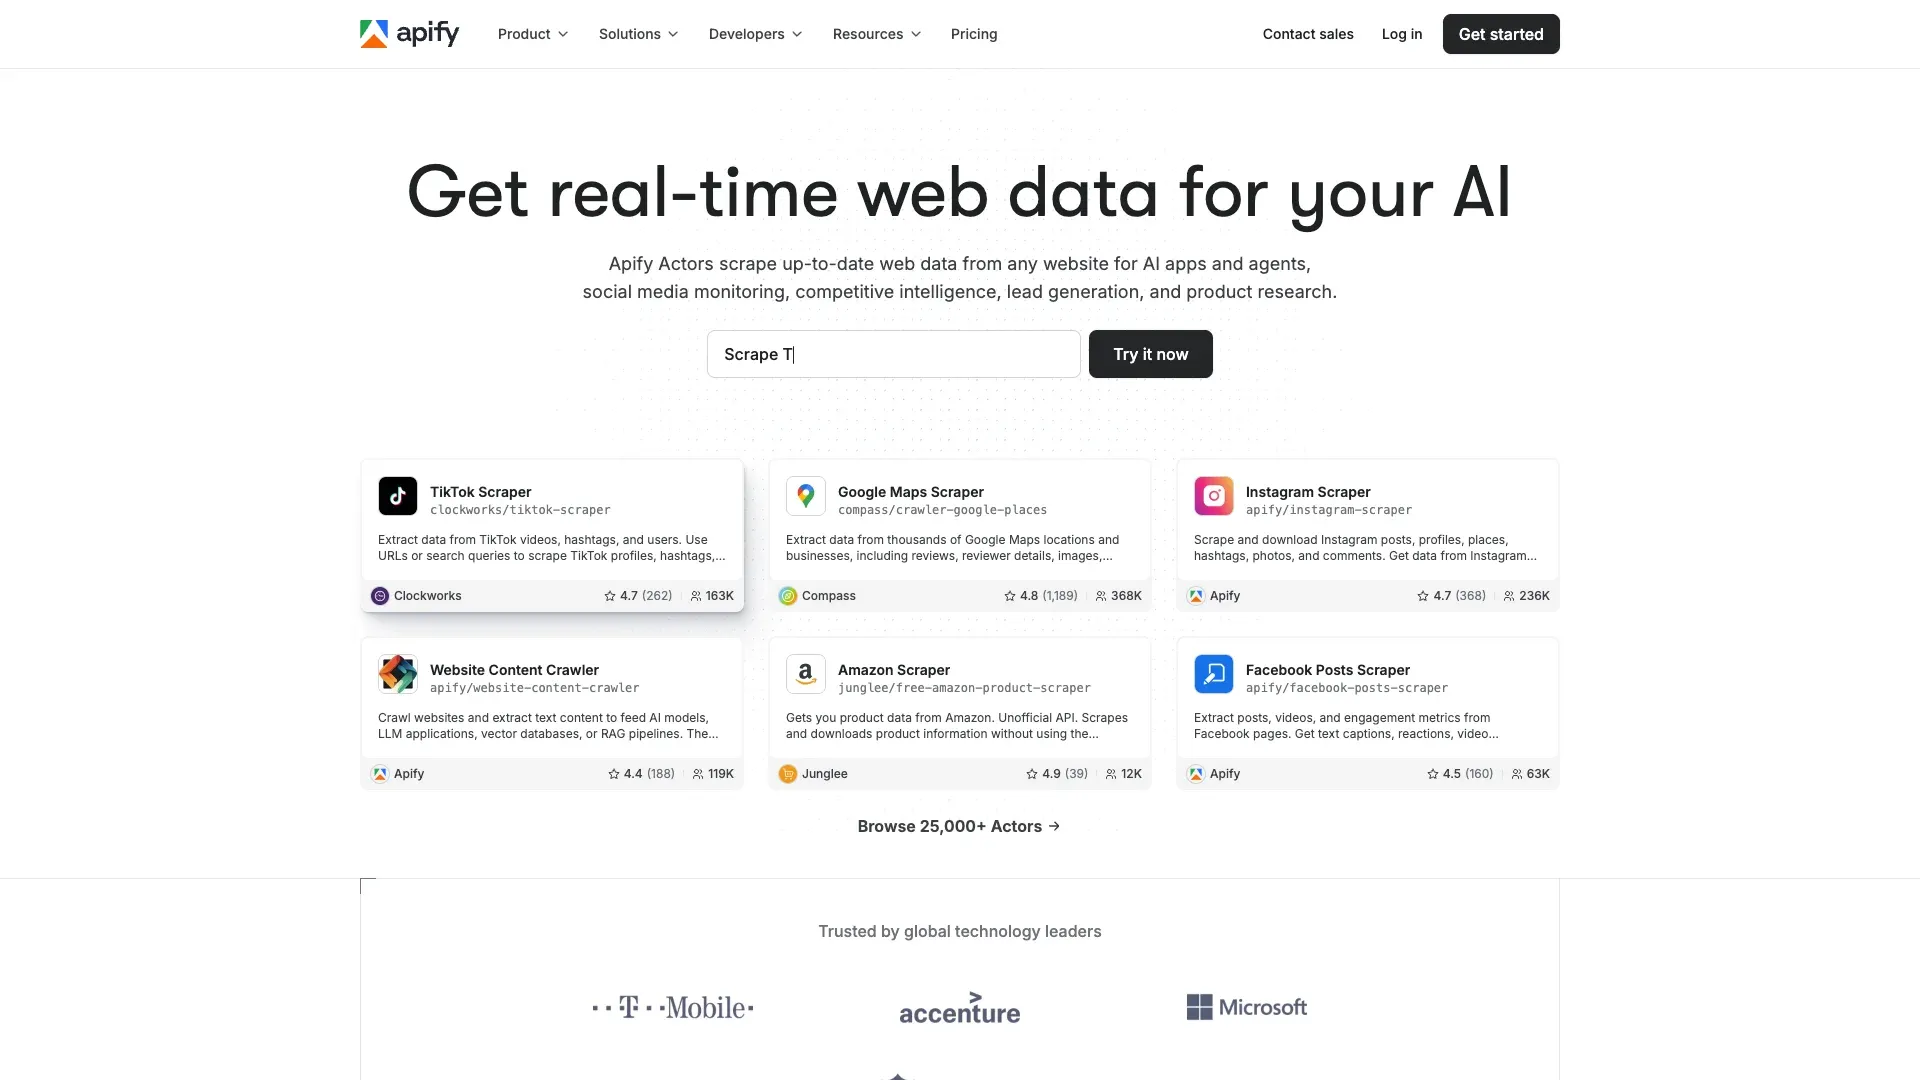 Apify, burada en esnek pazar yeri tarzı platform. Cloud çalıştırma, depolama, zamanlama, loglar, API'ler ve devasa bir önceden hazırlanmış "Actor" ekosistemi bir araya geliyor — Apify Store artık 59.000'den fazla Actor listeliyor. Her scraper'ı sıfırdan inşa etmek yerine Google Maps, Amazon, Instagram, TikTok veya genel web sitesi içerik tarayıcıları için var olan bir actor'dan başlayabilirsiniz.
Temel özellikler:
- Hazır scraper'lardan oluşan dev pazar yeri
- Özel actor geliştirme için Apify SDK
- Yerleşik proxy yönetimi ve cloud çalıştırma
- Güçlü API, depolama, zamanlama ve log yapısı
Pricing kullanım bazlıdır: $5 harcama içeren ücretsiz plan, ardından Starter'da $29/ay, Scale'de $199, Business'ta $999 — hepsi compute unit faturasıyla birlikte. Bu esneklik güçlüdür; ancak aylık maliyeti basit API ürünlerine göre öngörmek daha zordur.
Artılar: Devasa topluluk, çok sayıda hazır scraper, hobi seviyesinden prod'a ve ciddi otomasyona kadar iyi uyum.
Eksiler: Actor'ları özelleştirmek veya hata ayıklamak öğrenme eğrisi gerektirir. Compute-unit fiyatlandırması, actor ücretleri ve proxy'ler nedeniyle tahmin yapmak zor olabilir. Tablo odaklı iş kullanıcılarından çok builder'lar için daha uygundur.
En uygun olduğu alan: Geliştiriciler ve otomasyon kurucuları, mevcut scraper'ları yeniden kullanmak isteyen ekipler, build-and-buy karma iş akışları.
5. ScrapingBee
 ScrapingBee, anlaması ve entegre etmesi en kolay scraping API'lerinden biridir. Görsel bir platform olmaya çalışmak yerine headless Chrome render'ına, proxy rotasyonuna ve temiz API ergonomisine odaklanır.
Pricing 250.000 kredi ve 50 eşzamanlı istek için $49/ay'dan başlar; Startup planı 1.000.000 kredi ve 100 eşzamanlı istek için $99/ay'dır. Yeni kullanıcılar 1.000 ücretsiz API kredisi alır. Ancak JS render, premium proxy'ler, ekran görüntüleri ve AI çıkarımının hepsi daha yüksek çarpanlarla kredi tüketir.
Temel özellikler:
- Çok temiz REST API
- Amazon, Google, YouTube, Walmart ve ChatGPT için özel uç noktalar
- HTML, JSON, Markdown veya düz metin döndürebilir
- Markdown çıktısı temizliği azalttığı için AI/LLM iş akışları için iyi uyum
Artılar: Geliştirici dostu, güvenilir JS render, şeffaf taban fiyatlandırma.
Eksiler: $49 planı 250.000 kredi görünür; ama bu yalnızca 250.000 düz istek demektir — JS render, premium proxy, ekran görüntüsü ve AI çıkarımının her biri istek başına birden fazla kredi tüketir, bu yüzden gerçek hedeflerde başlık rakamdan çok daha az sayfa alırsınız. Eşzamanlılık planla bağlıdır (Freelance'te 50 paralel istek), bu yüzden hacim artmadan önce throughput sizi üst plana taşıyabilir. Yine de kod sahipliği gerektirir.
En uygun olduğu alan: Scraping'i backend'e gömmek isteyen geliştiriciler, basit API ergonomisi isteyen ekipler, metin öncelikli çıktılar isteyen LLM iş akışları.
6. ScraperAPI
 ScraperAPI, e-ticaret izleme ve düzenli toplu scraping için en güçlü yapılandırılmış API seçeneklerinden biri olmaya devam ediyor. Ürün odağı basit: proxy, retry, JS render, coğrafi hedefleme ve yapılandırılmış çıktıyı tek bir uç noktada toplamak.
Pricing 100.000 kredi ve 20 thread için $49/ay'dan başlıyor; Startup planı 1.000.000 kredi ve 50 thread için $149/ay. Ayrıca kart gerekmeden 5.000 kredi içeren 7 günlük deneme var. ScraperAPI'nin güçlü yanı yapılandırılmış katmanıdır: asenkron API'ler, webhook teslimatı, daha az kodlu projeler için DataPipeline ve Amazon, eBay, Google, Redfin ve Walmart için yapılandırılmış uç noktalar.
Temel özellikler:
- Büyük e-ticaret ve arama alanları için güçlü yapılandırılmış uç noktalar
- İyi asenkron ve webhook desteği
- Yüksek hacimli izleme için rekabetçi
- Geniş coğrafi hedefleme ve render seçenekleri
Artılar: Cömert deneme kredileri, iyi dokümantasyon, e-ticaret izleme için güvenilir.
Eksiler: Kredi çarpanları maliyet modelini zorlaştırır. Rastgele sayfalar için gerçek AI çıkarımı yoktur. Yalnızca geliştiricilere yöneliktir.
En uygun olduğu alan: E-ticaret fiyat izleme, rekabet istihbaratı, arama ve pazar yeri iş akışları.
7. ZenRows
 ZenRows, anti-bot uzmanıdır. Modern bir geliştirici deneyimi sunarken Cloudflare, DataDome, Akamai, Imperva ve benzeri korumaları aşmaya odaklanır.
Pricing Build planında $19/ay'dan başlar (45.000 kredi, 20 eşzamanlı istek). Build planı da bir kaydırıcıdır — 80.000 kredi için $29, 120.000 için $39 — ve bunun üstünde 250.000 kredi ve 50 eşzamanlı istek için $69/ay Launch ile 1,2 milyon için $199 Growth bulunur; bunlar aylık fiyattır, yıllık faturalandırma %17 indirim sağlar. Maliyet modeli çarpan bazlıdır: JS render 5x, premium proxy'ler 10x ve ikisinin birlikte kullanımı 25x.
Temel özellikler:
- Yoğun korumalı sitelere mükemmel odak
- Geniş anti-bot dokümantasyonu ve kapsama alanı
- LangChain, LlamaIndex ve MCP dahil modern entegrasyon ekosistemi
- Yalnızca başarılı isteklerden ücret alır
Artılar: Zor hedeflerde mükemmel anti-bot başarı oranı.
Eksiler: Korumalı iş yüklerinde maliyet hızla artar. Hem JS render hem premium proxy gereken bir sayfa 1 kredi yerine 25 krediye mal olur; bu yüzden 45.000 sayfa gibi görünen $19 planı zor hedeflerde 1.800 sayfaya düşer.
En uygun olduğu alan: Zor hedefleri kazıyan geliştiriciler, anti-bot ağırlıklı izleme işleri, tablo UX'inden çok hedefe ulaşmaya önem veren ekipler.
8. Octoparse
 Octoparse, klasik no-code masaüstü scraper'dır: görsel bir iş akışı oluşturucu, masaüstü yürütme, bulut zamanlama, yerleşik tarayıcı navigasyonu ve geniş bir dışa aktarma yüzeyi sunar. Thunderbit AI-first "tek tık" seçeneğiyken, Octoparse çıkarım mantığını adım adım modellemek isteyen kullanıcılar için görsel akış oluşturucu seçeneğidir.
Pricing ilk bakışta göründüğünden daha karmaşıktır. Yardım merkezi aylık ücretleri listeler — Basic $39/ay, Standard $83/ay'dan, Professional $299/ay'dan başlar — ana fiyatlandırma sayfası ise varsayılan olarak yıllık faturalandırmayı gösterir; bu yüzden başlık fiyatları Standard için $69/ay ve Professional için $249/ay görünür. Bunlar iki çelişkili liste değil, aynı planların iki farklı fatura dönemi fiyatlarıdır; asıl eksik olan, fiyatlandırma sayfasında hiç gösterilmeyen Basic planıdır. Bu yüzden bir fiyatı başka bir şeyle kıyaslamadan önce hangi faturalandırma dönemine ait olduğuna bakın. Fiyatlandırma sayfası ayrıca residential proxy, CAPTCHA çözümü, crawler kurulumu ve tam yönetilen veri hizmeti gibi ek hizmetleri vurgular.
Temel özellikler:
- Olgun görsel iş akışı oluşturucu
- Geniş dışa aktarma: Excel, CSV, JSON, HTML, XML, Google Sheets, veritabanları
- Bulut zamanlama ve otomasyon yerleşik
- Yaygın siteler için scraper şablonları
Artılar: Kod gerekmez, orta ölçekli tekrarlayan scraping için iyi, geniş dışa aktarma seçenekleri.
Eksiler: Düzen değiştiğinde AI-native araçlara göre daha fazla bakım ister (seçici tabanlı). Dinamik veya korumalı siteler hâlâ sürtünme yaratabilir. Masaüstü öncelikli UX, tarayıcı öncelikli araçlara göre daha ağır hissettirebilir.
En uygun olduğu alan: Basit AI isteminden daha fazla kontrol isteyen no-code kullanıcılar, orta ölçekli tekrarlayan scraping, görsel akışlara alışkın ekipler.
9. Diffbot
 Diffbot, listedeki en kurumsal seviye AI çıkarım platformudur. Sloganı "bu sayfayı kazı" değil, "bu sayfa tipini anla ve bunu ölçekli yapılandırılmış veriye dönüştür" gibidir. Ürünler arasında Extract, Crawl, Natural Language ve Knowledge Graph bulunur.
Pricing ücretsiz 10.000 kredi ile başlar; ardından Startup için $299/ay (250.000 kredi), Plus için $899/ay (1.000.000 kredi) ve özel kurumsal planlar gelir. Standart bir çıkarılmış web sayfası bir krediye mal olur; Knowledge Graph kayıt dışa aktarımı ise çok daha pahalıdır.
Temel özellikler:
- Sayfa tipi algılamada güçlü otomasyon (makaleler, ürünler, tartışmalar)
- Knowledge graph oluşturma ve entity pipeline'ları için çok iyi uyum
- Seçici gerektirmeyen NLP tabanlı çıkarım
- Premium destek ve kurumsal konumlandırma
Artılar: Sayfa yapısını güçlü AI ile anlama, knowledge graph kurmak için mükemmel.
Eksiler: Küçük veya sıradan projeler için pahalı. DQL ve KG iş akışlarının öğrenme eğrisi var. Basit tablo scraping'i için aşırı güçlü.
En uygun olduğu alan: Yapılandırılmış veri setleri oluşturan kurumlar, knowledge graph ve entity resolution projeleri, NLP ağırlıklı veri alma iş akışları.
10. Firecrawl
 Firecrawl, gruptaki en geliştirici-yerli LLM veri alma aracıdır. URL'leri temiz Markdown, HTML, ekran görüntüsü veya yapılandırılmış JSON'a dönüştürür ve görsel bir uygulamadan çok basit bir API yüzeyi etrafında tasarlanmıştır.
Pricing nettir: ayda 1.000 krediyle ücretsiz, Hobby'de 5.000 kredi, Standard'da 100.000, Growth'ta 500.000, Scale'de 1.000.000 ve sonrasında Enterprise. Giriş planı $19/ay, yıllık faturalandırmada $16/ay'dır.
Temel özellikler:
- RAG ve LLM iş akışları için temiz Markdown çıktısı
- Şema veya istem ile yapılandırılmış JSON desteği
- İyi geliştirici dokümantasyonu ve aktif açık kaynak kullanımı
- Daha üst planlarda güçlü eşzamanlı tarayıcı kademeleri
Artılar: Veriyi LLM'lere beslemek için özel olarak tasarlanmış. Uygun giriş fiyatı. Temiz çıktı.
Eksiler: Geliştiriciler için tasarlanmış. Bir playground ve bir dizi ücretsiz tek sayfa aracı var, ama ikisi de tekrarlanabilir iş çalıştırmaz — zamanlamak, toplu işlemek ya da bir pipeline'a bağlamak istediğiniz her şey bir API çağrısı veya SDK gerektirir. Scale dışındaki tüm planlarda kredi ay sonu sıfırlanır. Ayrıca plan merdiveninin ortasında bir boşluk var: kredi kaydırıcısı ayda 5.000, 6.500, 8.000 sayfa gidiyor ve sonra doğrudan 100.000'e atlıyor — $99'luk Standard planı.
En uygun olduğu alan: RAG iş akışları, AI agent'ları, içerik alma ve analiz.
11. Browse AI
 Browse AI, scraping yapan bir araçtan çok izleme ürünü olarak anlaşılmalı. En güçlü kullanım alanı tekrarlayan değişim tespiti: fiyatlar, stok durumu, metin, ekran görüntüleri ve sayfa değişiklikleri.
Pricing ayda 50 kredilik ücretsiz planla başlar; ardından Personal $48/ay için 2.000 kredi ve Professional, bir kaydırıcı olarak sunulur — 5.000 kredi için $87, 10.000 için $162, 30.000'e kadar $399 — Premium ise yıllık faturalandırmada $500/ay'dan başlar. Yıllık faturalandırmada Personal $19/ay, Professional $69'dur. Krediler satır sayısı ve görev karmaşıklığına göre tüketilir: kendi verisi için açtığınız bir sayfa bir görevdir ve en az bir kredi gerekir; on satır da bir kredi eder; premium siteler ise iki ila on kat daha pahalıdır.
Temel özellikler:
- Mükemmel izleme ve alarm odaklı yapı
- Düzenli fiyat veya stok kontrolü için iyi uyum
- Sheets, Airtable, webhook ve API iş akışlarıyla entegre olur
- Teknik olmayan kullanıcılar için hızlı ilk kurulum
Artılar: "Ne değişti" kullanım senaryoları için harika, teknik olmayanlar için kolay kurulum.
Eksiler: Tanımadık veya karmaşık sitelerde genel amaçlı scraper'lara göre daha az esnek. Thunderbit'e kıyasla sınırlı yerel AI dönüşümü.
En uygun olduğu alan: Rakip fiyatlarını izleyen e-ticaret ekipleri, değişim uyarısı isteyen teknik olmayan kullanıcılar.
12. ScrapeHero
 ScrapeHero, esasen bir yazılım aracı olmadığı için istisnadır. Bu bir yönetilen scraping hizmetidir. Siz ne veriye ihtiyacınız olduğunu söylersiniz; onların ekibi veri setini kurar, sürdürür, kalite kontrolünden geçirir ve teslim eder.
Pricing hizmet modelini yansıtır: talep üzerine projeler site başına $550'dan başlar, aylık Business planı iki siteye kadar ve her biri 1–5K sayfa için $199'dan başlar, Enterprise Basic $1,500/ay'dan başlayarak site başına sayfaları birleştirir ve ek hacim için milyon başına $650–$2,200 arası ücret uygular; Enterprise Premium $8,000'dan başlar. Business ve Enterprise Basic için kurulum ayrı bir tek seferlik ücrettir. Teslimat süreci özel proje ekipleri, insan kalite kontrolü ve özel formatları içerir.
Temel özellikler:
- Müşteri için neredeyse sıfır bakım
- İnsan QC ve özel teslimat formatları
- Karmaşık, çok siteli projeler için iyi uyum
- Kurumsal gereksinimler için uyum yaklaşımı
Artılar: Sıfır bakım, karmaşık projeleri yönetir, beyaz eldiven hizmeti.
Eksiler: Self-serve araçlara göre pahalı. İlk dönüş süresi kendiniz yapmaya göre daha yavaş. Hiç self-serve değil.
En uygun olduğu alan: Scraping'i dışarıya veren kurumlar, araç sahipliğinden çok teslimata önem veren ekipler, sık değişen karmaşık çok siteli projeler.
10K, 100K ve 1M Sayfada Web Scraping Hizmetlerinin Gerçek Maliyeti
Bu hizmetleri fiyat üzerinden karşılaştırmak zor, çünkü sağlayıcılar farklı birimlerle faturalandırıyor — sayfa, kayıt, kredi, compute zamanı, satır veya proje minimumu. Bu yüzden aşağıdaki tablo, çeviride ayakta kalan tek rakamı gösteriyor: kartınızın o ay gerçekten ne kadar çekildiği. Her rakam, düz sayfa hacmini kapsayan en ucuz planın aydan aya liste fiyatıdır — JavaScript render yok, premium proxy yok — ve sağlayıcının kendi aylık ücretsiz hakkı zaten düşülmüştür. Proxy ücretleri, CAPTCHA ek ücretleri ve mühendislik saatleri hiçbir zaman rakama dahil edilmez; son sütunda açıkça belirtilir. Bir sağlayıcının yayımladığı hiçbir plan o hacme ulaşmıyorsa, hücrede planı zorlamak yerine Custom quote yazılır. Bir sağlayıcı sayfa bazında satmıyorsa, uydurma bir sayfa fiyatı vermek yerine gerçekten ne sattığı yazılır.
| Hizmet | Ücretsiz katman | 10K sayfada aylık fatura | 100K sayfada aylık fatura | 1M sayfada aylık fatura | Nasıl ücretlendirir ve rakamın dışında ne kalır |
|---|---|---|---|---|---|
| Thunderbit API | 600 birim, tek seferlik | $72 Pro 1 | $120 Pro 2 | Özel teklif | Distill sayfa başına 1 birim, Extract 20 birim faturalandırır. Ücretsiz birimler tek seferlik bir haktır, aylık kota değildir; bu yüzden düşülecek bir şey yoktur. Self-serve aylık 480.000 birimde durur. |
| Bright Data | Ayda 5.000 kayıt | 10K kayıt için $7.50 | 100K kayıt için $142.50 | 1M kayıt için $1.293 | Sayfa başına değil, kayıt başına ücretlendirir — tablodaki bir satır, bir çıkarılmış öğe — bu yüzden tek bir liste sayfası birçok kayıt edebilir. 5.000 ücretsiz kayıt tüm üç senaryoda düşülmüştür. 1M'de Scale, kullandıkça ödeye göre daha iyidir: $499 + 1.30/1K ile 611.000 ek kayıt. |
| Oxylabs | Deneme, 2K sonuç | $49 Micro | $249 Advanced | $999 Business | Başarılı sonuç başına, hedef siteye ve plan kademesine göre değişen oranla ücret alır. Başlık sonuç sayıları Amazon ve JS render olmadan varsayılır — genel sitede 1.000 başına $1.15 ile $49 Micro planı 98.000 değil, yaklaşık 42.600 sonuç verir. Deneme sonuçları yenilenmez, bu yüzden düşülecek bir şey yoktur. |
| Apify | Ayda $5 kullanım | $29/ay'dan + kullanım | $29/ay'dan + kullanım | $29/ay'dan + kullanım | Sayfa başına faturalandırılmaz. Plan ücreti peşin kullanım gibidir — Starter $29, Scale $199, Business $999 — compute unit'ler ve kendi fiyatını belirleyen Store Actor'lar için harcanır; bu yüzden yalnızca sayfa sayısı faturayı belirlemez. Proxy'ler ayrı bir eklentidir. |
| ScrapingBee | 1.000 kredi, tek seferlik | $49 Freelance | $49 Freelance | $99 Startup | Düz istek başına 1 kredi. JS render, premium proxy'ler, ekran görüntüleri ve AI çıkarımının her biri daha fazla kredi tüketir; bu yüzden gerçek bir hedefte başlık rakamdan çok daha az sayfa alırsınız. Kayıt kredileri yenilenmez, dolayısıyla düşülecek bir şey yoktur. |
| ScraperAPI | 7 günlük deneme, 5.000 kredi | $49 Hobby | $49 Hobby | $149 Startup | Düz istek başına 1 kredi, ancak Amazon'da 5 ve Google'da 25. 100K sayfada Hobby planı tam dolar; tekrar için kredi kalmaz. Deneme kredileri yenilenmez, bu yüzden düşülecek bir şey yoktur. |
| ZenRows | Ayda 5.000 kredi | $19 Build | $39 Build | $199 Growth | Düz sayfa başına 1 kredi, JS + premium proxy gereken sayfa için 25 kredi. Ücretsiz 5.000 kredi önce düşülür — 5.000, 95.000 ve 995.000 ücretli sayfa — bu da hangi kademeye geçtiğinizi değiştirmez. |
| Octoparse | Ücretsiz plan, 10 görev | $39/ay'dan | $39/ay'dan | $39/ay'dan | Sayfa yerine görev sayısı ve cloud eşzamanlılığıyla fiyatlanır; bu nedenle hiçbir sayfa hacmi bir kademeye bire bir karşılık gelmez: Basic $39, Standard $83, Professional $299 aydan aya. Residential proxy ve CAPTCHA çözümü ek hizmet olarak satılır: $3/GB ve bin çözüm başına $1–1.5. |
| Diffbot | Ayda 10.000 kredi | $0, ücretsiz katman yeterli | $299 Startup | $899 Plus | Çıkarılan sayfa başına 1 kredi. Ayda verilen 10.000 ücretsiz kredi burada da diğer yerlerde olduğu gibi düşülür: 10K'de ayı tamamen karşılar, 100K'de 90.000 sayfa satın alınır, 1M'de 990.000. |
| Firecrawl | Ayda 1.000 kredi | $99 Standard | $99 Standard | $749 Scale | Kazınan sayfa başına 1 kredi. Ücretsiz krediler düştüğünde 10K hedefte alınacak 9.000 sayfa kalır; bu da hâlâ Hobby'nin 5.000'inin üzerindedir, dolayısıyla kademe değişmez. Scale altındaki planlarda krediler devretmez. |
| Browse AI | Ayda 50 kredi | $162 Professional | Özel teklif | Özel teklif | Kredilerle ücretlendirir: detay sayfası bir görev ve en az bir kredi; on satır da bir kredi eder, bu yüzden 50 satırlık bir liste sayfası beş kredi tüketir. Premium siteler iki ila on kat daha pahalıdır. Self-serve ayda 30.000 kredide durur, daha üstü teklif usulüdür. |
| ScrapeHero | Yok | $199/ay'dan | $1.500/ay'dan | $1.500/ay'dan | Sayfa başına değil, site, karmaşıklık ve yenileme sıklığına göre teklif verir: Business en fazla 2 site için ve her biri 1–5K sayfa; Enterprise Basic en fazla 4 site arasında sayfaları birleştirir ve ek milyon başına $650–$2.200 ekler. Kurulum ücretleri tek seferliktir ve ayrı faturalandırılır. |
Birkaç önemli not:
- Thunderbit'in tarayıcı ürünü satır bazlı ve son kullanıcıya dönük; bu yüzden yukarıdaki satır API'yi kullanıyor — özellikle de Distill uç noktasını, Markdown sayfası başına 1 birim — çünkü diğer API satırları da bunu yapıyor. Yapılandırılmış Extract ise sayfa başına 20 birimdir; bu da 10K sayfayı $72 yerine $240'a çıkarır.
- Apify maliyeti actor çalışma süresi, bellek ve proxy gibi ek hizmetlere çok bağlıdır.
- ZenRows, ScrapingBee ve ScraperAPI temel herkese açık sayfalarda ucuz görünür; ancak JS render, premium proxy veya anti-bot ağırlıklı hedefler devreye girdiğinde hızla pahalanır.
- ScrapeHero'nun birim ekonomisi farklıdır; çünkü yalnızca compute için değil, mühendislik, kalite kontrol ve proje yönetimi için ödeme yaparsınız.
Fiyat sayfalarının çoğunun olduğundan düşük gösterdiği gizli maliyet bakım maliyetidir. Sadece proxy maliyetine bakınca kârlı görünür; fakat tekrar denemeleri, parser bakımı, engellenen oturumlar ve mühendislik saatlerini de eklediğinizde, paketli scraping hizmetleri toplam sahip olma maliyetinde çoğu zaman daha iyi çıkar.
Ara sıra scraping yapıyorsanız, no-code tarafı başlangıç için daha ucuzdur: Thunderbit'in ücretsiz planı ayda 6 sayfa içerir ve ücretli tarayıcı planları $15/ay'dan, yıllık faturalandırmada yaklaşık $9/ay'dan başlar. Buradaki API hizmetleri kapıda her zaman daha pahalı değildir — ZenRows ve Firecrawl ikisi de $19/ay'dan başlar — ama sattıkları en küçük blok ayda binlerce sayfadır; yani kullanmayacağınız kapasite için ödeme yaparsınız. 1M+ sayfalık kurumsal iş akışlarında, full-stack platformlar veya yönetilen hizmetler daha yüksek etiket fiyatına rağmen daha ekonomiktir çünkü proxy maliyetini paketler.
Kazıdığınız Veri Nereye Gidiyor? Dışa Aktarma ve Entegrasyon Karşılaştırması
JSON, Google Sheets ile aynı şey değildir. Teknik olmayan kullanıcılar için kazınan verinin nereye gittiği, çıkarım kadar önemlidir.
| Hizmet | CSV | JSON | Excel | Google Sheets | Airtable | Notion | CRM/API/Webhook |
|---|---|---|---|---|---|---|---|
| Thunderbit | ✅ | ✅ | ✅ | ✅ Yerel | ✅ Yerel | ✅ Yerel | API mevcut |
| Bright Data | ✅ | ✅ | ❌ Yerel yok | Dolaylı | Dolaylı | Dolaylı | Güçlü API/webhook |
| Oxylabs | ✅ | ✅ | ❌ Yerel yok | Dolaylı | Dolaylı | Dolaylı | Güçlü API |
| Apify | ✅ | ✅ | ✅ | Entegrasyonlarla | Entegrasyonlarla | Entegrasyonlarla | Güçlü API |
| ScrapingBee | Araçlarla | ✅ | ❌ | ❌ | ❌ | ❌ | Güçlü API |
| ScraperAPI | Yapılandırılmış uç noktalarda ✅ | ✅ | ❌ | ❌ | ❌ | ❌ | Güçlü API/webhook |
| ZenRows | Sınırlı | ✅ | ❌ | ❌ | ❌ | ❌ | Güçlü API |
| Octoparse | ✅ | ✅ | ✅ | ✅ Yerel | ⚠️ Zapier üzerinden | ❌ | API, DB, Zapier |
| Diffbot | ✅ | ✅ | ❌ | Desteklenen iş akışları | Dolaylı | Dolaylı | API |
| Firecrawl | ❌ | ✅ | ❌ | ❌ | ❌ | ❌ | API |
| Browse AI | ✅ | ✅ | ❌ | ✅ Yerel | ✅ Yerel | ❌ | API, webhook, Zapier/Make |
| ScrapeHero | ✅ | ✅ | ✅ | Özel teslimat | Özel teslimat | Özel teslimat | Özel API/DB teslimatı |
Bu, Thunderbit'in en net avantajlarından biridir. Google Sheets veya Notion'da çalışan bir iş ekibiyseniz, API-only hizmetler ekstra adımlar ekler: JSON'u dönüştürmek için kod yaz, elle yükle, tekrar et. Thunderbit'in Sheets, Airtable ve Notion'a ücretsiz dışa aktarması — Notion ve Airtable'a görsel yüklemeleri de dahil — bu sürtünmeyi tamamen ortadan kaldırır. Zamanlanmış scraping ile birleşince veri, glue code olmadan düzenli bir ritimde doğrudan belirli bir hedefe akabilir.
Web Sitesi Değiştiğinde Ne Olur? Bakım ve Güvenilirlik
Scraper'lar bozulur. Bu, bütün pazardaki bir numaralı ağrı noktası.
Pazar üç bakım profiline ayrılıyor:
- Seçici tabanlı araçlar (Octoparse, birçok Apify actor'ı, Browse AI şablonları): site düzeni değişince bozulur, manuel kural güncellemesi gerekir.
- Parser soyutlamalı API hizmetleri (ScraperAPI yapılandırılmış uç noktalar, Bright Data yapılandırılmış veri setleri): yaygın sitelerde iyi çalışır ama parser'ın önceden hazırlanmadığı uzun kuyruk veya niş sayfalarda zorlanır.
- AI destekli araçlar (Thunderbit, Firecrawl, Diffbot): her çalıştırmada sayfayı yeniden okur, bu yüzden çoğu düzen değişikliği kural güncellemesi gerektirmez. Hata modu "seçici bozuldu" olmaktan çıkıp "AI yanlış yorumladı"ya döner — bu da genelde tam bir seçici yeniden yazımından ziyade prompt düzeltmesiyle daha kolay çözülür.
Düzen kaymasından başka bir güvenilirlik darboğazı daha var: anti-bot yönetimi.
- Bright Data, Oxylabs ve ZenRows bu konuda en güçlü seçenekler.
- ScraperAPI ve ScrapingBee, yaygın korumalı hedeflerde sağlamdır.
- Browse AI ve Octoparse, yoğun korumalı dinamik sitelerde daha fazla sorun yaşayabilir.
- Thunderbit'in tarayıcı modu, API-only araçların çoğu zaman ekstra karmaşıklık eklediği giriş yapılmış ve kişiselleştirilmiş sayfalarda yardımcı olur.
Sonuç şu: en düşük bakım yükünü istiyorsanız, AI destekli çıkarım (Thunderbit, Firecrawl, Diffbot) düzen kaymasına seçici tabanlı araçlardan daha iyi dayanır. Birincil güvenilirlik kaygınız anti-bot korumasıysa, en güçlü seçenekler Bright Data, Oxylabs ve ZenRows'dur. Çoğu ekip her iki sorunla da karşılaşır; bu yüzden yazının başındaki "hangi tür ekibinize uyar" kararı, tek tek özellik karşılaştırmalarından daha önemlidir.
Web Scraping İçin Hukuki ve Etik Hususlar
Kamuya açık veriyi scraping etmek çoğu zaman yasaldır; ancak bu, her kullanım senaryosunun güvenli olduğu anlamına gelmez. Ekipler uygun durumlarda robots.txt'ye saygı göstermeli, kullanım şartlarını kontrol etmeli ve kişisel veri söz konusu olduğunda GDPR ve CCPA gibi gizlilik yasalarına uymalıdır. hiQ v. LinkedIn çizgisindeki davalar, kamuya açık veriyi scraping etmenin ABD'de otomatik olarak CFAA ihlali olmadığı fikrini destekler; ancak sözleşme, telif hakkı ve gizlilik sorunları ayrı riskler olarak kalır. Bright Data, Oxylabs ve ScrapeHero gibi kurumsal sağlayıcılar uyum ve yönetişim özelliklerini özellikle öne çıkarır. Diğer herkes için: ölçekli scraping'e başlamadan önce kullanım senaryonuza özel hukukî tavsiye alın. Daha fazla arka plan için web scraping'in hukuki sonuçları rehberimize bakın.
Gerçekte Hangi Web Scraping Hizmetini Seçmelisiniz?
Yeterince karşılaştırma tablosu oldu. 12 aracın tamamını test ettikten sonra kısa versiyon şu:
Teknik olmayan iş ekipleri (satış, operasyon, pazarlama): Thunderbit. Tek tıkla AI scraping, Sheets/Airtable/Notion'a ücretsiz dışa aktarma ve bir site düzen değiştirdiğinde çok daha az yeniden iş.
İki büyük sürtünme kaynağını — kurulum karmaşıklığı ve scraping sonrası dışa aktarma sürtünmesini — aynı anda ortadan kaldırır.
Scraping iş akışları inşa eden geliştiriciler:
- En temiz API deneyimi istiyorsanız ScrapingBee
- Yapılandırılmış uç noktalar ve tekrarlayan e-ticaret izleme istiyorsanız ScraperAPI
- Asıl sorununuz anti-bot korumasıysa ZenRows
Veriyi AI/LLM iş akışlarına besleyen ekipler:
- Çıktınızın Markdown veya şemaya dayalı JSON olması gerekiyorsa Firecrawl
- Aynı ekip no-code bir yola da ihtiyaç duyuyorsa Thunderbit API; çünkü eklenti ve API aynı çıkarım modelini çalıştırır
- Kurumsal bir bilgi katmanı kuruyorsanız Diffbot
Devasa ölçek + proxy altyapısı isteyen kurumlar:
- En geniş kurumsal yığın için Bright Data
- Korumalı hedeflerde güvenilirlik en önemli konuysa Oxylabs
Hazır scraper pazaryeri isteyen ekipler: Apify.
Elle uğraşmak istemeyen teslimat isteyen şirketler: ScrapeHero.
Bütçeye dikkat eden, no-code izleme isteyen ekipler: Browse AI.
Görsel masaüstü oluşturucu isteyen ve daha manuel kontrol arayan no-code kullanıcılar: Octoparse.
En geniş iş kullanıcısı yelpazesi için Thunderbit hâlâ önde, çünkü benimsenmeyi öldüren iki engeli ortadan kaldırıyor: teknik kurulum ve dışa aktarma sürtünmesi. Siz de görmek için ücretsiz planı deneyin ya da Chrome eklentisini indirin. Thunderbit size uymazsa, listedeki diğerlerinden birkaçını da deneyin — elle kopyala-yapıştırı bırakmak için daha iyi bir zaman hiç olmamıştı. Bu araçların pratikte nasıl çalıştığını video anlatımla görmek için Thunderbit YouTube kanalına göz atın.
Thunderbit Chrome eklentisini deneyin
SSS
Web scraping hizmeti nedir?
Web scraping hizmeti, sizin için web sitelerinden veri toplayan bir araç veya yönetilen sağlayıcıdır. Bazıları tarayıcınızda çalıştırdığınız no-code uygulamalardır, bazıları geliştiriciler için API'lerdir, bazıları ise altyapı çalıştırmanızı gerektirmeden temizlenmiş veriyi teslim eden tam yönetilen ajanslardır.
Web scraping hizmetlerini kullanmak için kod bilmek gerekir mi?
Her zaman değil. Thunderbit, Browse AI ve Octoparse gibi araçlar teknik olmayan kullanıcılar için tasarlanmıştır. ScrapingBee, ScraperAPI, Firecrawl ve ZenRows gibi API hizmetleri geliştirici katılımı bekler. ScrapeHero ise işin diğer ucundadır — ekibi tüm projeyi sizin yerinize yürütür.
Küçük işletmeler için en iyi web scraping hizmeti hangisi?
Çoğu küçük işletme için en güvenli öneri Thunderbit'tir. Süresi dolmayan ücretsiz planı vardır (ayda 6 sayfa), kurulum sürtünmesi düşüktür ve Google Sheets, Airtable, Notion gibi iş dostu hedeflere doğrudan dışa aktarım sunar. Değişimleri zaman içinde izlemek ana kullanım senaryosuysa Browse AI da iyi bir seçimdir.
Web scraping hizmetleri ne kadar tutar?
Aralık çok geniştir. Bazı hizmetler ücretsiz katmanlar veya denemeler sunar. Bu listedeki geliştirici API'leri ayda $19 ile $49 arasında başlar; kurumsal AI platformları çok daha yukarıdan, Diffbot'ta $299'dan başlar. No-code araçlar yaklaşık $15 ile $48 arasında başlar. Kurumsal ve yönetilen hizmetler hızla ayda yüzlerce ya da binlerce dolara çıkabilir. Daha büyük maliyet hikâyesi yalnızca abonelik fiyatı değil; JS render çarpanları, premium proxy'ler ve scraper'ları çalışır tutmak için gereken iç zaman da buna dahildir.
Web scraping hizmetlerini kullanmak yasal mı?
Genellikle kamuya açık veri için evet; ancak yasallık siteye, veri türüne, bulunduğunuz ülkeye ve çıktıyla ne yaptığınıza bağlıdır. Kamuya açık sayfaları kazırken bile gizlilik, telif hakkı ve sözleşme meseleleri önemlidir. Kendi kullanım senaryonuz için hukukî danışmanlık alın.
AI web scraping için Thunderbit'i deneyin Get Started Free
Daha Fazla Bilgi



