
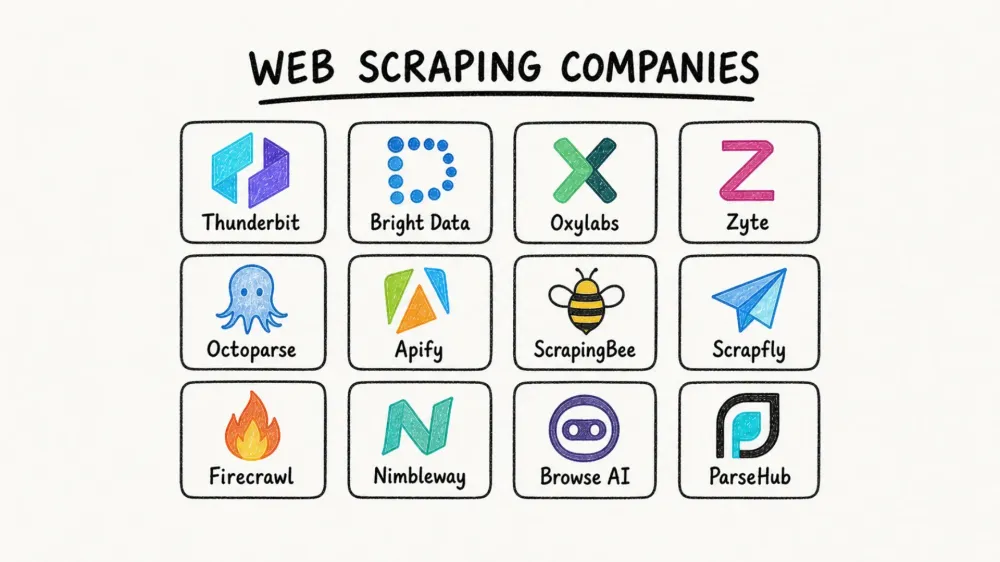
Web scraping pazarı 2024’te 754 milyon dolara ulaştı ve 2034’e kadar 2,87 milyar dolara çıkması bekleniyor. Buna rağmen çoğu alıcı ilk denemesinde yanlış tedarikçiyi seçiyor.
Bu uyumsuzluk pek şaşırtıcı değil. “Web scraping şirketi” ifadesi, on saniyede kurulan bir Chrome Extension’dan milyon dolarlık kurumsal veri altyapılarına kadar uzanan geniş bir şemsiye terim. Üstüne belirsiz fiyat sayfaları, sürekli bozulan scraper’lar (bir Reddit kullanıcısı her hafta scraper’ların %10–15’inin bozulduğunu aktarıyor) ve “her siteyi scrape ederiz” diyen yüzlerce sağlayıcı eklenince kafa karışıklığı gayet normal.
Thunderbit Resmi Web Sitesi ekibinde çalışıyorum; bu yüzden alıcıların karar vermeden önce sorduğu soruları ve hedef site arayüzünü değiştirdiği anda çalışmayı bırakan eski araçlardan kalan hayal kırıklığını yakından görüyorum. Bu rehber, bu alanda araştırmaya başladığımda keşke elimde olsaydı dediğim kaynak: 12 şirket, üç net kategori, gerçek 2026 fiyatları, tek bir karşılaştırma tablosu ve gerçekten seçim yapmanıza yardımcı olacak bir karar çerçevesi.
2026’da Doğru Web Scraping Şirketini Bulmak Neden Önemli?
Web scraping artık geliştiricilerin yan projesi değil. Fiyat istihbaratı, lead generation, pazar araştırması, içerik toplama ve giderek daha fazla AI ile LLM iş akışlarını besleyen bir iş girdisi haline geldi. Market.us web scraping pazarının %25,8’ini yalnızca fiyat takibi ve dinamik fiyatlamaya bağlıyor. Mordor Intelligence, 2026 pazarını 1,17 milyar dolar olarak değerlendiriyor ve fiyat ile rekabet takibinin %19,23 CAGR ile büyüdüğünü söylüyor. İki şirket kategoriyi farklı tanımladığı için rakamlar birebir örtüşmüyor; bu nedenle bunları kesin veri değil, ölçeği anlamaya yarayan yaklaşık göstergeler olarak düşünün.
Getiri ise ölçülebilir. Sağlayıcıların vaka çalışmaları bunu sayısallaştırıyor: Zyte bir küresel perakendeci için her spider’da geliştirme süresinde %25 tasarruf sağlandığını bildiriyor. Apify lead generation vakası ise kampanya döngüsü başına 40 saatten fazla manuel işin ortadan kaldırıldığını söylüyor.
Ama sorunlar da bir o kadar tutarlı:
- Hedef siteler tasarımını değiştirdiğinde veya anti-bot katmanları eklediğinde scraper’lar sürekli bozulur.
- Özellikle kullanım bazlı modellerde fiyatlandırma ölçek büyüdükçe öngörülemez hale gelir.
- Pek çok araç hâlâ çoğu iş ekibinde olmayan geliştirici zamanını varsayar.
En pahalı hata yanlış sağlayıcıyı değil, yanlış kategoriyi seçmektir. Geliştirici odaklı bir API’ye kayıt olan satış ekibi, no-code bir araca ihtiyaç duyduğunu fark edene kadar haftalar kaybedebilir. Nokta-tıkla bir araç seçen mühendislik ekibi ise bir ay içinde hacim limitlerine çarpar. Önce kategori seçilir. Sonra sağlayıcı.
Web Scraping Şirketlerinin Üç Türü Var (ve Neden Önemli)
Tek bir “web scraping şirketi” etiketi altındaki bireysel sağlayıcıları değerlendirmeden önce, arkasındaki üç işletim modelini anlamanız gerekir. Bunları karıştırmak, kullanıcı pişmanlığının en büyük nedenidir.
| Kategori | Ne Alırsınız | Kimler İçin Uygun | Bu Listeden Örnekler |
|---|---|---|---|
| Tam hizmet / yönetilen scraping | Scraper’ları sizin için kurar ve bakımını yaparlar; size temiz, yapılandırılmış veri gelir | Geliştirici kaynağı olmayan ekipler veya karmaşık, yüksek hacimli hedefler | Bright Data (datasets), Zyte, Nimbleway |
| Scraping API’leri ve altyapı | Siz bir API çağırırsınız; onlar proxy, rendering ve anti-bot tarafını yönetir | Altyapı yönetmek istemeyen ama kontrol isteyen geliştiriciler | ScrapingBee, Scrapfly, Oxylabs, Firecrawl, Apify |
| No-code / tarayıcı tabanlı araçlar | Nokta-tıkla arayüz; minimum ya da sıfır kodlama | Satış, e-ticaret, pazarlama, emlak gibi iş kullanıcıları | Thunderbit, Octoparse, Browse AI, ParseHub |
Tam Hizmet / Yönetilen Web Scraping Şirketleri
Bu sağlayıcılar tüm hattı uçtan uca yönetir. Hangi veriye ihtiyacınız olduğunu siz belirlersiniz; çıkarma, anti-bot, rendering, bakım ve teslimatı onlar yapar. Takas nettir: en düşük bakım yükü, en yüksek maliyet. Ekibinizde hiç geliştirici yoksa ve yoğun korunan hedeflerden yüksek ölçekte veri almanız gerekiyorsa, başlangıç için bakmanız gereken kategori budur.
Scraping API ve Altyapı Sağlayıcıları
Bir URL’yi veya görevi bir endpoint’e gönderirsiniz. Onlar render edilmiş HTML, yapılandırılmış veri veya ekran görüntüsü döndürür; proxy, tarayıcı rendering’i, yeniden deneme ve CAPTCHA çözümünü arkada yönetir. Entegrasyon kodu, ayrıştırma mantığı ve aşağı akış iş akışları hâlâ size aittir. Takas: orta maliyet, orta-yüksek bakım ve hattın üzerinde tam kontrol.
No-Code / Tarayıcı Tabanlı Web Scraping Araçları
Bu araçlar mühendisler için değil, operasyon ekipleri için tasarlanmıştır. Çoğu, yapılandırılmış veriyi hızlı üretmek için tarayıcı eklentisi, görsel iş akışı oluşturucu veya AI destekli bir arayüz kullanır. Takas: başlamak en hızlısıdır, ancak kapasite sınırları genellikle API öncelikli sağlayıcılardan daha düşüktür.
Thunderbit bu üçüncü kategoriye tam oturur. Bir sayfayı açarsınız, bir kez tıklarsınız ve AI hangi alanların alınacağını çözüp tabloyu sizin yerinize doldurur. Belirli alanlar istiyorsanız bunu sade İngilizce ile söylersiniz; sistem onları kullanır. Çoğu iş için süreç bu kadardır.
En iyi Web Scraping şirketlerini nasıl değerlendirdik
Tüm 12 sağlayıcıyı aynı yedi kritere göre değerlendirdik.
| Kriter | Neden Önemli? |
|---|---|
| Şirket türü (tam hizmet / API / no-code / extension) | İşin fiilen kim tarafından yapıldığını belirler |
| Anti-bot ve proxy yönetimi | En büyük teknik sorun budur — engellenmek çoğu zaman parser yazmaktan daha fazla zaman alır |
| Bakım yükü | Scraper’lar bozulur; asıl soru bunları kimin düzelttiğidir |
| Şeffaf fiyatlandırma (gerçek 2026 plan ücretleri, ücretsiz katman) | “Satışla iletişime geçin” bir cevap değildir |
| No-code dostu olması | Alıcıların büyük kısmı teknik olmayan kullanıcılardır |
| Veri dışa aktarma formatları ve entegrasyonlar | Çıktı uyumluluğu, tüm aşağı akış iş akışını belirler |
| En iyi kullanım senaryosu etiketi | Okuyucuların sağlayıcıyı senaryoyla hızlı eşleştirmesine yardımcı olur |
Bu kriterler, kullanıcıların kamuya açık topluluklarda neye takıldığını doğrudan yansıtıyor. Hacker News üzerindeki 2025 tartışmasında API’lerin birer sözleşme, scraping’in ise doğası gereği kırılgan olduğu savunuldu. GitHub’da ise “All scraping engines failed!” başlıklı bir Firecrawl issue’su, modern AI dostu araçların bile uç durumlarda zorlandığını iyi hatırlattı.
1. Thunderbit
 Thunderbit, kod yazmadan veya selector yönetmeden web siteleri, PDF’ler ve görsellerden yapılandırılmış veri alması gereken teknik olmayan kullanıcılar için geliştirilmiş AI destekli bir Chrome Extension’dır.
Kategori: İsteğe bağlı API’ye sahip no-code / tarayıcı tabanlı araç
Temel iş akışı: Herhangi bir sayfayı aç → bir kez tıkla → AI hangi alanları çekeceğini kendi belirler ve tabloyu tek başına tamamlar. Belirli alanlar istiyorsanız bunu doğal dille söyleyin, araç onları kullanır. Çoğu işte süreç budur.
Öne çıkan özellikler:
- Otomatik alan algılama: Sayfadaki veri sütunlarını tespit eder ve sizden kurulum gerektirmeden çıkarır.
- Alt sayfa scraping: Her detay sayfasını ziyaret ederek ana tabloyu zenginleştirir — manuel yapılandırma gerekmez.
- Zamanlanmış scraping: Aralığı doğal dille tarif edin; sistem bulutta planlı çalışsın.
- Bulut ve tarayıcı modu: Giriş gerektiren sayfalarda tarayıcı modunu, hız için bulut modunu kullanın (tek seferde 50 sayfa).
- Ücretsiz e-posta, telefon ve görsel çıkarıcılar: Ek araçlara gerek kalmadan lead-gen iş akışlarında işe yarar.
- Ücretsiz dışa aktarma: Excel, Google Sheets, Airtable, Notion, CSV, JSON — ek dışa aktarma ücreti yok.
Anti-bot ve bakım: AI, her scraping işleminde sayfayı yeniden okuyarak tasarım değişikliklerine otomatik uyum sağlar. Bu da farklı ve uzun kuyruktaki sitelerde çalışan iş kullanıcıları için en yaygın bozulma nedenini ortadan kaldırır. Elbette tamamen bakım gerektirmez (hiçbir araç gerektirmez), ama teknik olmayan ekipleri en çok zorlayan bu özel hata moduna doğrudan saldırır.
Fiyatlandırma: Ücretsiz plan (ayda 6 sayfa) ve Pro özelliklerinin 7 günlük denemesi var. Starter aylık 15 dolar veya yıllık faturalamada aylık 9 dolar. Pro aylık 38 dolar veya yıllık faturalamada aylık 24 dolar. Business özel fiyatlı. Thunderbit’in Web Scraper API’si ayrıca ücretlendirilir; aylık 29 dolardan başlar (yıllık faturalamada aylık 16 dolar) ve başlangıç için 600 ücretsiz birim sunar. Krediler çıktı satırı başına hesaplanır: satır başına 1, satır bir alt sayfadan geliyorsa 2, kişisel veri zenginleştirme sorgusu başına 30. Güncel ayrıntılar için Thunderbit Pricing sayfasına bakın.
Geliştirici seçeneği: Thunderbit Open API, bir Distill endpoint’i (web sayfası → Markdown) ve bir Extract endpoint’i (şema üzerinden web sayfası → yapılandırılmış JSON) içerir.
Kimler için uygun: Satış ekipleri (dizinlerden lead üretimi), e-ticaret operasyonları (fiyat izleme, rakip SKU scraping), emlak danışmanları (ilan verileri) ve mühendislik desteği olmadan yapılandırılmış web verisine ihtiyaç duyan pazarlamacılar/operasyon ekipleri.
Sınırlamalar: 100K+ sayfalık kurumsal SERP izleme için veya yoğun bot koruması olan siteler için en iyi seçenek değildir — bu listede bunun için proxy ve API sağlayıcıları var. Hacim limiti, özel API altyapısı sunan sağlayıcılardan daha düşüktür.
2. Bright Data
 Bright Data, devasa proxy ağı, scraper API’leri, Web Scraper IDE’si ve hazır dataset’leri bir araya getirerek dünya çapındaki en geniş web data platformlarından biridir.
Kategori: Hibrit — yönetilen hizmet + API altyapısı
Öne çıkan özellikler:
- 400M+ IP proxy ağı (residential, datacenter, mobile, ISP)
- Web Scraper API, Web Unlocker, tarayıcı tabanlı scraping IDE
- 350+ dataset ve 437+ hazır scraper
- Kurumsal teslimat ve uyumluluk altyapısı
Anti-bot ve bakım: Cloudflare, CAPTCHA ve JS rendering’i ölçekli şekilde yönetir. Yönetilen dataset’ler bakım yükünü tamamen üstlenir.
Fiyatlandırma: Web Scraper API, kullanıma göre 1.000 kayıt başına 1,5 dolar; Scale planı aylık 499 dolar. Proxy maliyetleri hacim arttıkça ciddi şekilde yükselebilir — bütçe için dikkatli takip gerekir.
Kimler için uygun: Karmaşık ve yüksek hacimli scraping ihtiyaçları olan, buna uygun bütçesi bulunan büyük işletmeler.
Sınırlamalar: Teknik olmayan kullanıcılar için öğrenme eğrisi diktir. Fiyatlandırma karmaşıktır ve ölçek büyüdükçe maliyet sıçramaları olabilir.
3. Oxylabs
 Oxylabs, sektördeki en büyük IP havuzlarından birine sahip premium bir proxy ve scraping altyapı sağlayıcısıdır.
Kategori: Scraping API + proxy altyapısı
Öne çıkan özellikler:
- Gelişmiş coğrafi hedeflemeli residential ve datacenter proxy’ler
- Web Scraper API, SERP Scraper API, E-commerce Scraper API
- Geliştirilmiş ayrıştırma için AI Web Scraping API / OxyCopilot
- 2.000 sonuca kadar ücretsiz deneme
Anti-bot ve bakım: Yüksek hacimli ve IP yoğun scraping için güçlü engel aşma. Ölçekli, tekrar eden veri çekimi için uygundur.
Fiyatlandırma: Web Scraper API aylık 49 dolardan başlar. Proxy paketleri ve IP havuzu ek paketleri toplam maliyeti artırabilir.
Kimler için uygun: Büyük ölçekli, tekrar eden veri çekimi için güvenilir proxy altyapısına ihtiyaç duyan geliştirici ekipleri — özellikle SERP ve ürün istihbaratı için.
Sınırlamalar: İş kullanıcıları için gerçek bir no-code yolu yoktur. Proxy’ler ve gelişmiş kullanım senaryoları eklendikçe toplam maliyet yükselir.
4. Zyte
 Zyte, açık kaynak Scrapy çerçevesinin yaratıcıları tarafından kuruldu ve AI destekli scraping API’lerini Scrapy Cloud barındırma ve yönetilen extraction hizmetleriyle birleştiriyor.
Kategori: Hibrit — API + yönetilen hizmet
Öne çıkan özellikler:
- AI destekli otomatik çıkarım sunan Zyte API
- Spider’ları dağıtmak ve yönetmek için Scrapy Cloud
- Dahili akıllı proxy yönetimi ve browser rendering
- Kurumsal müşteriler için Zyte Data yönetilen extraction
Anti-bot ve bakım: Dahili akıllı proxy rotasyonu ve selector bakımını azaltmaya yardımcı AI özellikleri.
Fiyatlandırma: Başlangıç için 5 dolar ücretsiz kredi. Kullanım bazlı Zyte API fiyatlandırması. Scrapy Cloud aylık birim başına 9 dolardan başlar.
Kimler için uygun: AI destekli çıkarım sunan yönetilen bir bulut ortamı isteyen Python/Scrapy ekipleri.
Sınırlamalar: Teknik olmayanlar için öğrenme eğrisi daha diktir. No-code tarafı, tarayıcı tabanlı araçlara kıyasla sınırlıdır.
5. Octoparse
 Octoparse, görsel nokta-tıkla iş akışı oluşturucusu etrafında şekillenen en köklü no-code web scraping markalarından biridir.
Kategori: No-code araç
Öne çıkan özellikler:
- Sürükle-bırak mantıklı görsel iş akışı oluşturucu
- Masaüstü uygulaması + bulut tabanlı zamanlanmış çalıştırma
- Pagination, sonsuz kaydırma ve giriş korumalı sayfaları destekler
- Popüler siteler için hazır şablonlar
- CSV, Excel, JSON, HTML ve XML’e dışa aktarma
Anti-bot ve bakım: Dahili CAPTCHA yönetimi ve IP rotasyonlu bulut scraping. Ancak site tasarımı değiştiğinde kullanıcıların iş akışlarını güncellemesi gerekir.
Fiyatlandırma: Süresiz ücretsiz plan (10 görev, ayda 50.000 dışa aktarılan satır). Standard aylık 83 dolar veya yıllık faturalamada aylık 69 dolar. Professional aylık 299 dolar veya yıllık faturalamada aylık 249 dolar. Enterprise özel fiyatlı.
Kimler için uygun: Kodsuz görsel scraping arayüzü isteyen pazarlamacılar, araştırmacılar ve e-ticaret ekipleri.
Sınırlamalar: Masaüstü yazılımının kurulması gerekir. Hedef site değiştiğinde iş akışı bakımı kullanıcıya kalır; çünkü iş akışı her seferinde sayfayı yeniden okumak yerine kaydedilmiş selector’lara dayanır.
6. Apify
 Apify sadece bir scraper değil — bir platform ve bir marketplace’tir. Bu da hedeflediğiniz site için hazır bir scraper zaten varsa onu özellikle güçlü kılar.
Kategori: API / marketplace’li geliştirici platformu
Öne çıkan özellikler:
- Yaklaşık 59.000 hazır scraper ve otomasyon içeren Actor marketplace (Apify Store, Ağustos 2026)
- Özel crawler’lar için Apify SDK
- Zapier, Google Sheets, webhook ve API entegrasyonları
- Platform planlarına dahil proxy yönetimi
Anti-bot ve bakım: Tek tek Actor kalitesine bağlıdır. Resmi Actor’lar iyi bakım alır; topluluk Actor’ları ise uyarı vermeden bozulabilir.
Fiyatlandırma: 5 dolarlık kullanım kredisi olan ücretsiz plan. Starter aylık 29 dolardan başlar. Buna ek olarak kullanım bazlı compute kredileri vardır.
Kimler için uygun: Sıfırdan geliştirmek yerine belirli ve popüler bir site için hazır scraper isteyen ekipler (Google Maps, Amazon, Instagram).
Sınırlamalar: Topluluk Actor’ları arasında kalite değişkendir. Karmaşık veya niş siteler hâlâ özel geliştirme gerektirir. Özel scraper’lar için tam anlamıyla no-code değildir.
7. ScrapingBee
 ScrapingBee, bu kategorideki en temiz geliştirici API’lerinden biridir — sayfa çekme, rendering ve proxy rotasyonunu tek bir API çağrısı kadar basit hale getirmeye odaklanır. Artık Oxylabs grubunun bir parçasıdır ve yine ayrı bir ürün olarak çalışmaya devam eder; kısa liste oluştururken bunu bilmek faydalıdır.
Kategori: Scraping API
Öne çıkan özellikler:
- Tek çağrılı REST API (URL gönder, HTML veya JSON al)
- Yerleşik headless Chrome rendering
- Residential ve datacenter proxy rotasyonu
- Google Search API ve screenshot API
- Daha yeni Markdown ve AI extraction seçenekleri
Anti-bot ve bakım: JS rendering ve proxy rotasyonunu otomatik yönetir. Ayrıştırma mantığı ve şema tasarımı size aittir.
Fiyatlandırma: Denemede 1.000 ücretsiz kredi. Planlar aylık 49 dolardan başlar.
Kimler için uygun: Rendering ve sayfa çekme için temiz, basit bir API isteyen; sonra veriyi kendisi ayrıştıracak geliştiriciler.
Sınırlamalar: Çekirdek ürün hâlâ sayfa getirmeye odaklıdır. Çıkarım, yapılandırma ve aşağı akış güvenilirliğinden siz sorumlusunuz.
8. Scrapfly
 Scrapfly, bu listedeki anti-bot odağı en açık şekilde vurgulanan API’dir; yoğun korumalı web sitelerini hedefleyen geliştiriciler için tasarlanmıştır.
Kategori: Scraping API
Öne çıkan özellikler:
- Cloudflare, DataDome, PerimeterX ve benzeri korumalara karşı anti-bot bypass
- Headless browser rendering
- Residential proxy rotasyonu
- Webhook teslimatı, otomatik yeniden deneme ve ekran görüntüsü alma
Anti-bot ve bakım: Zor scrape edilen hedeflerde uzmandır. Anti-bot karmaşıklığının büyük kısmını üstlenir. Ayrıştırma yine sizdedir.
Fiyatlandırma: 1.000 kredi içeren ücretsiz katman. Ücretli planlar aylık 30 dolardan başlar.
Kimler için uygun: Kendi proxy/bypass yığınını yönetmeden yüksek başarı oranına ihtiyaç duyan ve güçlü anti-bot korumalı siteleri scrape eden geliştiriciler.
Sınırlamalar: Çekme ve rendering’e odaklanır — yapılandırılmış çıkarım sizin sorumluluğunuzdadır. Bright Data veya Oxylabs’a kıyasla ekosistemi daha küçüktür.
9. Firecrawl
 Firecrawl, yalnızca ham HTML değil, AI iş akışları için temiz web içeriği isteyen geliştiriciler için tasarlanmıştır.
Kategori: AI / LLM iş akışları için scraping API
Öne çıkan özellikler:
- Scrape ve crawl endpoint’leri
- Markdown öncelikli çıktı (özellikle RAG ve LLM ingestion için tasarlanmış)
- LLM üzerinden yapılandırılmış veri çıkarımı
- JS rendering ve proxy modları
- Agent sistemleri için toplu işlem dostu iş akışı
Anti-bot ve bakım: Rendering ve temel anti-bot yönetimini yapar. Hacimden çok içerik kalitesine odaklanır.
Fiyatlandırma: Ayda 1.000 ücretsiz kredi. Hobby aylık 19 dolar veya yıllık faturalamada aylık 16 dolar. Standard aylık 99 dolar veya yıllık faturalamada aylık 83 dolar.
Kimler için uygun: Temiz web içeriğine ihtiyaç duyan RAG boru hatları, bilgi tabanları veya LLM destekli uygulamalar kuran AI/ML ekipleri ve geliştiriciler.
Sınırlamalar: Kurumsal sağlayıcılara kıyasla daha yeni ve özellik seti daha küçüktür. Yüksek hacimli e-ticaret takibi için tasarlanmamıştır. Sadece geliştirici odaklıdır; no-code seçeneği yoktur.
10. Nimbleway
 Nimbleway, KOBİ’lere yönelik kendi kendine servis bir scraping aracından ziyade yapılandırılmış veri teslim platformu gibi konumlandırılıyor.
Kategori: API katmanlı tam hizmet / yönetilen scraping
Öne çıkan özellikler:
- Nimble Browser (scraping için bulut tarayıcı)
- Arama, e-ticaret ve haritalar için gerçek zamanlı yapılandırılmış veri API’leri
- AI tabanlı ayrıştırma ve engel aşma altyapısı
- Yönetilen pipeline teslimatı
Anti-bot ve bakım: Tamamen yönetilen. Nimbleway pipeline bakımı, anti-bot ve veri teslimini üstlenir.
Fiyatlandırma: extract, crawl ve map için 1.000 istek başına 1 dolardan başlayan kullanıma göre ücret; hazır extraction şablonları için 1.000 başına 3 dolar. Managed Data Services yıllık faturalamada aylık 2.500 dolardan başlar.
Kimler için uygun: Scraper yönetmeden temiz, yapılandırılmış veri almak isteyen orta ve büyük ölçekli işletmeler.
Sınırlamalar: Birçok KOBİ iş akışı için fazla pahalıdır. Basit veya tek seferlik scraping işleri için gereğinden fazladır.
11. Browse AI
 Browse AI, iş akışının tek seferlik veri çekiminden çok tekrar eden izleme ve uyarılar etrafında döndüğü durumlarda en güçlüdür.
Kategori: No-code araç
Öne çıkan özellikler:
- Nokta-tıkla robot eğitimi
- Uyarılarla değişiklik algılama ve izleme
- Google Sheets, Airtable, Zapier, webhook ve API entegrasyonları
- Toplu extraction ve tekrar eden planlı çalıştırmalar
Anti-bot ve bakım: Temel anti-bot yönetimi sunar. Site yapısı ciddi biçimde değiştiğinde robotların yeniden eğitilmesi gerekebilir.
Fiyatlandırma: Süresiz ücretsiz plan (ayda 50 kredi). Personal aylık 48 dolar veya yıllık faturalamada aylık 19 dolar. Professional aylık 87 dolar veya yıllık faturalamada aylık 69 dolar.
Kimler için uygun: Rakip fiyatlarını, iş ilanlarını veya ürün stok durumunu zaman içinde izleyen iş kullanıcıları.
Sınırlamalar: Yoğun dinamik veya JS ağırlıklı sitelerde zorlanabilir. Düzen değiştiğinde robotun yeniden eğitilmesi gerekir.
12. ParseHub
 ParseHub, küçük projeler, öğrenciler ve scraping’i ilk kez deneyen ekipler için hâlâ iyi bir seçenektir.
Kategori: No-code araç
Öne çıkan özellikler:
- Görsel nokta-tıkla extraction
- JS ile render edilen sayfa desteği
- CSV, JSON, Excel, API ve webhook çıktıları
- Tanınabilir ücretsiz katman (5 proje, çalıştırma başına 200 sayfa)
Anti-bot ve bakım: Temel seviye destek. Gelişmiş proxy altyapısı yoktur. İş akışları site değişikliklerinde bozulabilir.
Fiyatlandırma: Ücretsiz plan mevcut. Ücretli planlar aylık 189 dolardan başlar.
Kimler için uygun: Altyapıya yatırım yapmadan scraping’i keşfetmek isteyen bütçe dostu küçük projeler veya kullanıcılar.
Sınırlamalar: Ücretli planların fiyatı, sunduğu özellik derinliğine göre yüksektir. AI-yerel rakiplere kıyasla daha eski bir ürün hissi verir. Modern, bulut öncelikli seçeneklerden daha yavaş ve daha az esnektir.
En İyi Web Scraping Şirketleri Karşılaştırması: Ana Tablo
Yukarıdakilerin hepsi tek yerde. Giriş fiyatları aylık baz oranıdır; sağlayıcı yıllık faturalama sunuyorsa parantez içinde yıllık fiyat yer alır. “Free Tier?” sütununda “Yes”, yenilenen ya da hiç bitmeyen bir ücretsiz hak anlamına gelir; “Trial” ise tek seferlik bir deneme hakkı demektir.
| Şirket | Kategori | Kimler İçin Uygun | Ücretsiz Katman? | Başlangıç Fiyatı | Fiyatlandırma Modeli | Anti-Bot | Bakım Yükü | No-Code? | Temel Dışa Aktarma Formatları |
|---|---|---|---|---|---|---|---|---|---|
| Thunderbit | No-code + API | İş ekipleri, farklı siteler | Evet (ayda 6 sayfa) | 15 $/ay (yıllıkta 9 $/ay) | Satır başına kredi; API birimleri | Orta | 🟡 | Evet | Excel, Sheets, Airtable, Notion, CSV, JSON |
| Bright Data | Hibrit yönetilen + API | Kurumsal ölçekte extraction | Evet (ayda 5K kayıt) | 1.000 kayıt başına 1,5 $ veya 499 $/ay | Sonuç başına, istek başına, dataset | Çok güçlü | 🟢 dataset’ler / 🟠 API | Kısmi | API çıktıları, dataset teslimi |
| Oxylabs | API + proxy altyapısı | Proxy ağırlıklı tekrar eden extraction | Deneme | 49 $/ay | Sonuç bazlı + proxy paketleri | Çok güçlü | 🟠 | Hayır | API / kullanıcı tanımlı |
| Zyte | Hibrit yönetilen + API | Scrapy/Python ekipleri | Evet (5 $ kredi) | Kullanıma göre; cloud 9 $/birim/ay | Kullanım bazlı API + cloud | Güçlü | 🟢 Zyte Data / 🟠 Zyte API | Sınırlı | CSV, JSON, XML, storage |
| Octoparse | No-code | Görsel scraping iş akışları | Evet (10 görev) | 83 $/ay (yıllıkta 69 $/ay) | Abonelik + ek paketler | Orta | 🟡 | Evet | CSV, Excel, JSON, HTML, XML |
| Apify | Platform + marketplace | Siteye özel hazır scraper’lar | Evet (5 $ kredi) | 29 $/ay | Abonelik + kullanım + Actor | İyi (değişken) | 🟠 | Kısmi | Datasets, API, entegrasyonlar |
| ScrapingBee | API | Basit rendering/engel aşma | Deneme | 49 $/ay | Aylık krediler | İyi | 🟠 | Hayır | HTML, Markdown, JSON |
| Scrapfly | API | Zorlu anti-bot hedefleri | Evet (1K kredi) | 30 $/ay | Aylık API kredileri | Çok güçlü | 🟠 | Hayır | HTML, ekran görüntüleri, JSON |
| Firecrawl | AI/LLM scraping API | Markdown ve AI veri hatları | Evet (ayda 1K kredi) | 19 $/ay (yıllıkta 16 $/ay) | Kredi bazlı | Orta-güçlü | 🟠 | Hayır | Markdown, HTML, JSON |
| Nimbleway | Yönetilen + API | Yapılandırılmış kurumsal veri | Evet (ayda 5K istek) | 1.000 istek başına 1 $ veya 2.500 $/ay yönetilen | PAYG API + yıllık planlar | Güçlü | 🟢 yönetilen / 🟠 API | Hayır | Yapılandırılmış feed’ler, API’ler |
| Browse AI | No-code | İzleme ve değişiklik uyarıları | Evet (ayda 50 kredi) | 48 $/ay (yıllıkta 19 $/ay) | Krediler + limitler | Temel-orta | 🟡 | Evet | Sheets, Airtable, Zapier, API |
| ParseHub | No-code | Küçük ücretsiz projeler | Evet (çalıştırma başına 200 sayfa) | 189 $/ay | Abonelik katmanları | Temel | 🟡 | Evet | CSV, JSON, Excel, API |
Bakım yükü ölçeği:
- 🟢 En düşük: bakımın çoğunu sağlayıcı üstlenir
- 🟡 Düşük-orta: sağlayıcı çekme ve ayrıştırmayı yönetir, kullanıcı iş akışını çalıştırır ve araç kaydedilmiş selector’lara dayanıyorsa bozulduğunda düzeltir
- 🟠 Orta-yüksek: sağlayıcı çekme/engel aşmayı yönetir, ayrıştırma ve entegrasyon kullanıcıya aittir
- 🔴 En yüksek: neredeyse her şey kullanıcıya aittir
Güvenilirlik ve Bakım: Neler Bozulur ve Kim Düzeltir?
Bu bölüm, özellik karşılaştırmalarının hepsinden daha önemlidir.
Alıcıların scraping sağlayıcılarından mutsuz olmasının ana nedeni ilk çalıştırmanın başarısız olması değildir. Beşinci, ellinci ya da beş yüzüncü çalıştırmanın başarısız olmasıdır — ve ekipte birinin bu dağınıklığın sorumluluğunu alması gerekir.
| Bakım Seviyesi | Sağlayıcı Türü | Sizin Sorumluluğunuz | Onların Sorumluluğu |
|---|---|---|---|
| 🟢 En düşük | Tam hizmet (Bright Data datasets, Zyte managed, Nimbleway) | Gereksinimler ve çıktı doğrulama | Scraping, anti-bot, tasarım değişiklikleri, QA, teslimat |
| 🟡 Düşük-Orta | No-code araçlar (Thunderbit, Octoparse, Browse AI, ParseHub) | İş akışını çalıştırmak, çıktıyı kontrol etmek ve araç kaydedilmiş selector’lara dayanıyorsa yeniden oluşturmak | Çekme, ayrıştırma, barındırma ve zamanlama |
| 🟠 Orta-Yüksek | Scraping API’leri (ScrapingBee, Scrapfly, Oxylabs, Apify, Firecrawl) | Entegrasyon kodu, ayrıştırma, yeniden deneme, şema kontrolleri | Proxy’ler, rendering, engel aşma katmanının bir kısmı |
| 🔴 En yüksek | DIY / açık kaynak çerçeveler | Her şey | Hiçbir şey |
No-code araçlar burada orta noktada yer alır. Hiçbiri tüm hata modlarını ortadan kaldırmaz; kaydedilmiş selector’lara dayananlar sayfa yeniden oluşturulduğunda yine bozulur. AI-first yaklaşımın hedeflediği özel hata budur: Thunderbit sabit selector’lara güvenmek yerine her sayfayı yeniden okur. Tutarsız sitelerin uzun kuyruğuyla uğraşan iş kullanıcıları için bu, geleneksel bir görsel iş akışı oluşturucudan çok daha kolay yönetilir.
Tam hizmet sağlayıcılar toplam bakım yükünün en büyüğünü üstlenir. Fiyatları da en yüksektir. Bedava öğle yemeği yok — her zaman operasyonel acıyı kimin üstleneceğine karar verirsiniz.
Gerçek 2026 Fiyatlandırması: Şeffaf Maliyet Karşılaştırması
Çoğu liste yazısı bu bölümü geçiştirir. “Satışla iletişime geçin” bir fiyatlandırma sayfası değildir. İşte rakamlar gerçekte nasıl görünüyor. Yukarıdaki ana tabloyla aynı kurallar geçerlidir; ayrıca başlık fiyatında görünmeyen maliyetler için bir sütun ekledik.
| Şirket | Ücretsiz Katman? | Başlangıç Fiyatı | Fiyatlandırma Modeli | Gizli Maliyet Riskleri |
|---|---|---|---|---|
| Thunderbit | Evet (ayda 6 sayfa) | 15 $/ay (yıllıkta 9 $/ay) | Satır başına kredi | Alt sayfa satırları 2 kredi, zenginleştirme sorguları 30 |
| Bright Data | Evet (ayda 5K kayıt) | 1.000 kayıt başına 1,5 $ veya Scale planında 499 $/ay | Sonuç başına veya istek başına | Proxy maliyetleri hacimde sıçrar |
| Oxylabs | Deneme (2.000 sonuç) | 49 $/ay | İstek bazlı + proxy paketleri | IP havuzu ek paketleri |
| Zyte | Evet (5 $ kredi) | Kullanıma göre | API kullanımı + cloud birimleri | Rendering ve karmaşıklık katmanları |
| Octoparse | Evet (10 görev) | 83 $/ay (yıllıkta 69 $/ay) | Abonelik + ekstralar | Proxy, CAPTCHA ve hizmet ek paketleri |
| Apify | Evet (5 $ kredi) | 29 $/ay | Abonelik + compute + Actor ücretleri | Actor ve kullanım değişkenliği |
| ScrapingBee | Deneme (1.000 kredi) | 49 $/ay | Kredi bazlı | Rendering seçenekleri daha fazla kredi kullanır |
| Scrapfly | Evet (1.000 kredi) | 30 $/ay | Kredi bazlı | Residential ve gelişmiş modlar daha pahalıdır |
| Firecrawl | Evet (ayda 1K kredi) | 19 $/ay (yıllıkta 16 $/ay) | Kredi bazlı | Gelişmiş proxy ve daha zengin extraction modları |
| Nimbleway | Evet (ayda 5K istek) | 1.000 istek başına 1 $ veya 2.500 $/ay yönetilen | API + yıllık planlar | Yönetilen planlar yıllık faturalıdır |
| Browse AI | Evet (ayda 50 kredi) | 48 $/ay (yıllıkta 19 $/ay) | Krediler + limitler | Premium siteler ve site kotaları |
| ParseHub | Evet (çalıştırma başına 200 sayfa) | 189 $/ay | Abonelik katmanları | Fiyatlandırma net, ücretli katmanlarda değer zayıf |
Sabit aylık fiyat sunan araçlar arasında Thunderbit (15 $) ve Firecrawl (19 $) en düşük giriş fiyatına sahip; onları Apify (29 $) ve Scrapfly (30 $) takip ediyor. No-code tarafında ise Octoparse (83 $) ve ParseHub (189 $) en pahalı giriş noktaları. Bright Data ve Zyte kullanım bazlı faturalandırma yapıyor; bu yüzden küçük bir pilot çalışma, bunların hepsinden daha ucuza gelebilir. Bright Data, Oxylabs ve Nimbleway; hacim, hedef zorluğu ve kurumsal gereksinimler basit bütçelemenin önüne geçtiğinde daha mantıklıdır.
Hangi Web Scraping Şirketi Sizin İçin Uygun? Karar Çerçevesi
Alanı hızlıca daraltmak için şu sırayı kullanın.
1. Veri hacminiz nedir?
- Aylık 1.000 sayfanın altı → no-code araçlar (Thunderbit, Browse AI, Octoparse, ParseHub)
- Aylık 10K+ sayfa → API’ler (Oxylabs, ScrapingBee, Apify, Scrapfly, Firecrawl)
- Aylık 100K+ sayfa → kurumsal yönetilen çözümler (Bright Data, Nimbleway, Zyte Data)
2. Ekibinizde geliştirici var mı?
- Evet → API araçları size kontrol sağlar (Oxylabs, ScrapingBee, Apify, Scrapfly, Firecrawl, Zyte API)
- Hayır → no-code (Thunderbit, Browse AI, Octoparse) veya tam hizmet (Bright Data datasets, Nimbleway)
3. Kaç hedef siteniz var?
- Az sayıda, bilinen ve stabil site → şablonlar ve hazır Actor’lar yeterlidir
- Farklı, uzun kuyrukta yer alan ve sık değişen siteler → AI uyum kabiliyeti önemlidir (Thunderbit burada öne çıkar)
4. Bütçe tavanınız nedir?
- Aylık 50 doların altı → ücretsiz katmanlar (Thunderbit, ParseHub, Apify, Scrapfly, Firecrawl)
- Aylık 50–500 dolar → orta seviye API’ler ve ücretli no-code planları
- Aylık 500+ dolar → kurumsal yönetilen hizmetler
5. Tek seferlik extraction mı, sürekli izleme mi?
- Sürekli → zamanlanmış scraping yeteneği önemlidir (Thunderbit, Browse AI, Bright Data datasets)
- Tek seferlik → neredeyse her araç olur; kurulum hızını önceliklendirin
Hızlı cevap özeti:
- Teknik olmayan ekip, farklı siteler, geliştirici kaynağı yok → Thunderbit
- Ölçekte bir veri hattı kuran geliştirici → Oxylabs, ScrapingBee veya Apify
- Her şeyi başkasının yönetmesini istiyorsanız → Bright Data veya Zyte yönetilen hizmetler
- AI/LLM veri hatları kuruyorsanız → Firecrawl veya Thunderbit API
Gerçek Kullanım Senaryoları: Hangi Web Scraping Şirketi Hangi Duruma Uyar?
E-Ticaret Fiyat Takibi
Shopify mağazasında rakip fiyatlarını izleyen bir operasyon ekibi için en hızlı yol Thunderbit’tir. Kategori sayfasını açın ve bir kez tıklayın. AI, hangi alanların alınacağını çözer — genelde ürün adı, fiyat, stok durumu ve URL — ve tabloyu kendi doldurur. Farklı alanlar istiyorsanız bunu bir cümleyle tarif edin; araç onları kullanır. Ardından bulut modunda zamanlayarak çalıştırın. Her ürünün detay sayfasını da kontrol etmeniz gerekiyorsa, alt sayfa scraping tabloyu otomatik zenginleştirir. Google Sheets’e dışa aktarın ve fiyatlandırma iş akışınızı oradan yönetin.
Bright Data aynı problemi diğer uçtan çözer. İş akışını işletmek yerine yönetilen bir e-ticaret dataset’i satın alabilir veya kurumsal yığını kullanabilirsiniz. Bu daha az operasyon gerektirir, ama maliyet profili tamamen farklıdır.
B2B Lead Generation (E-posta ve Telefon Numaraları)
Küçük ve orta ölçekli prospecting projelerinde Thunderbit’in ücretsiz e-posta ve telefon çıkarıcıları; herkese açık dizinler, yerel listeleme sayfaları ve niş iş siteleri için pratiktir. Değer, hızdır: listeyi çekin, dışa aktarın, teknik kurulum olmadan CRM’inize alın.
Kaynak büyük ve popüler bir platformsa, olgun bir Actor ekosistemi nedeniyle Apify daha güçlüdür. Google Maps lead listelerini yüksek hacimde istiyorsanız, hazır bir Actor sıfırdan başlamaktan daha hızlı sonuç verir.
Büyük Ölçekli SERP İzleme
Burada dürüst olmak gerekir. Thunderbit, günlük 100K+ SERP sorgusu için en uygun seçenek değildir. Bu ölçekte, başarı oranı, IP kalitesi ve hız limiti yönetimi kullanım kolaylığından daha önemli olduğundan Oxylabs SERP API’lerine, Bright Data SERP ürünlerine veya benzeri kurumsal altyapılara bakmalısınız.
Scraped Veriyi AI / LLM İş Akışlarına Beslemek
Amacınız kamuya açık sayfaları RAG veya agent iş akışları için temiz içeriğe dönüştürmekse, Markdown öncelikli tasarımı nedeniyle Firecrawl açık bir kısa liste adayıdır. Thunderbit de karşılaştırmaya değerdir; çünkü Distill API web sayfalarını Markdown’a dönüştürür ve Extract API sayfaları bir şema kullanarak yapılandırılmış JSON’a çevirir. Bu, tek bir platformun hem iş kullanıcılarına yönelik scraping’i (Chrome Extension) hem de geliştiriciye yönelik AI boru hatlarını (API katmanı) destekleyebileceği anlamına gelir. Thunderbit’in iş için AI data extraction yaklaşımı hakkında daha fazla bilgi için daha detaylı anlatımımıza göz atabilirsiniz.
Herhangi Bir Web Scraping Şirketinden En İyi Verimi Alma İpuçları
- Bütçe ayırmadan önce ücretsiz katman veya denemeyi kullanın. Bu listedeki her sağlayıcı bir tane sunuyor.
- Scrape etmeden önce şemanızı tanımlayın. Hangi alanlara, formatlara ve hedeflere ihtiyacınız olduğunu önce belirleyin. Bu tek adım, aşağı akıştaki sorunların çoğunu önler.
- Maliyeti ölçeklemeden önce veriyi 50–100 sayfada test edin. Veri kalitesini ve başarı oranını değerlendirin.
- Dışa aktarma formatını baştan doğrulayın. Her araç her hedefi aynı iyi şekilde desteklemez. Airtable veya Notion kullanacaksanız, başlamadan önce kontrol edin.
- Tekrarlayan işler için manuel ad-hoc işlemler yerine zamanlanmış çalıştırmalar kurun. Thunderbit, Browse AI, Octoparse ve Bright Data bunu destekler.
- Zaman içinde kalite sapmasını izleyin. Yönetilen hizmetler bile hedefler değiştiğinde kalitede düşebilir.
- Ölçeklenmeden önce kredi tüketimini ve rate limit’leri anlayın. Kullanım bazlı fiyatlandırma, takip etmiyorsanız hızla şişebilir.
Başlangıç seviyesindeki hata genellikle teknik değildir. Operasyoneldir. Ekipler, hangi çıktı yapısına ihtiyaç duyduklarına veya veriyi aşağı akışta nasıl tüketeceklerine karar vermeden scraping’e başlar. Data scraping nedir ve nasıl yapılır öğrenmek istiyorsanız, temelleri anlatan başlangıç dostu rehberimize göz atabilirsiniz.
Sonuç
Bu pazardan satın almanın doğru yolu: önce kategoriyi seçin, sonra sağlayıcıyı.
Eğer tüm hattın sorumluluğunu başkasının üstlenmesini istiyorsanız, Bright Data, Zyte Data veya Nimbleway gibi yönetilen sağlayıcılardan başlayın. Geliştiriciniz varsa ve doğrudan altyapı kontrolü istiyorsanız, Oxylabs, ScrapingBee, Scrapfly, Apify ve Firecrawl gibi API’ler daha uygun olacaktır. Kod yazamayan operasyon ve iş kullanıcıları için hızlı bir yol gerekiyorsa, gerçek kaldıraç no-code katmanındadır — ve Thunderbit tam da burada yer almak için tasarlandı.
Senaryoya göre en güçlü seçenekler:
- Teknik olmayan ekipler için en hızlı başlangıç: Thunderbit
- En güçlü kurumsal altyapı: Bright Data veya Oxylabs
- Basitlik açısından en iyi geliştirici API’si: ScrapingBee
- AI/LLM veri hatları için en iyisi: Firecrawl veya Thunderbit API
- Küçük projeler için en iyi ücretsiz seçenek: ParseHub veya Apify ücretsiz katmanı
Çoğu teknik olmayan ekip, farklı web sitelerinin karışımından veri çekerken en pratik başlangıç noktası olarak Thunderbit’i bulur. Ücretsiz plan riski düşürür, kurulum minimumdur ve AI-first iş akışı, 2026’nın bakım gerçekleriyle eski görsel scraping oluşturuculara kıyasla daha uyumludur. Thunderbit Chrome Extension’ı deneyin ve tek tıklamanın sizi ne kadar ileri götürebileceğini görün. Ayrıca kurulum yapmadan önce aracın nasıl çalıştığını görmek isterseniz, Thunderbit YouTube Channel en yaygın kullanım senaryoları için rehberler sunuyor.
Thunderbit AI Web Scraper’ı Deneyin Get Started Free
SSS
1. Web scraping şirketi ile web scraper aracı arasındaki fark nedir?
Web scraping şirketi, altyapı, bakım, destek ve veri teslimi dahil olmak üzere tam hizmet sunabilir. Web scraper aracı ise sizin bizzat kullandığınız yazılımdır. Bazı sağlayıcılar (Bright Data ve Zyte gibi) her iki modeli de kapsar. Diğerleri (Thunderbit gibi) ise öncelikle araçtır; geliştiriciler için isteğe bağlı bir API katmanı da sunar.
2. Web scraping şirketlerini kullanmak yasal mı?
Kamusal olarak erişilebilir verileri scrape etmek birçok yargı alanında genel olarak yasaldır; ancak ayrıntılar web sitesine, toplanan veriye ve yerel düzenlemelere göre değişir. Her zaman Kullanım Şartları’na, robots.txt’ye ve GDPR ile CCPA gibi veri gizliliği yasalarına uyun. Saygın sağlayıcılar platformlarına uyumluluk hususlarını dahil eder. Daha derinlemesine inceleme için web scraping yasal sonuçları rehberimize bakın.
3. 2026’da web scraping şirketleri ne kadar tutuyor?
Pazar, ücretsiz katmanlardan ve aylık 50 doların altındaki başlangıç planlarından, yaklaşık 500 dolar/aydan başlayan ve çok daha yukarı çıkan kurumsal yönetilen hizmetlere kadar uzanıyor. Thunderbit, ParseHub ve Apify ücretsiz katman sunuyor. ScrapingBee ve Scrapfly gibi orta seviye API’ler aylık 30–49 dolardan başlıyor. Kurumsal sağlayıcılar daha yüksekten başlıyor: Bright Data’nın Scale planı aylık 499 dolar, Nimbleway’in yönetilen planları ise aylık 2.500 dolardan başlıyor.
4. Kod yazmadan web scraping şirketi kullanabilir miyim?
Evet. Thunderbit, Octoparse, Browse AI ve ParseHub gibi no-code araçlar teknik olmayan kullanıcılar için tasarlanmıştır. Thunderbit sıfır kod gerektirir: Chrome Extension’ı kurun, bir sayfa açın ve bir kez tıklayın — AI hangi alanların alınacağını çözüp işi kendi tamamlar. İstediğiniz veriyi sade İngilizce ile de tarif edebilirsiniz. Veri doğrudan spreadsheet’inize veya veritabanınıza akar.
5. Küçük işletmeler için en iyi web scraping şirketi hangisi?
Farklı sitelerden yapılandırılmış veri alması gereken ve geliştirici kurulumu olmayan küçük işletmeler için varsayılan en güçlü öneri Thunderbit’tir. Ücretsiz planı ve satır başına kredi fiyatlandırmasıyla başlamak kolaydır; kaç satıra ihtiyacınız olduğunu kabaca bildiğiniz anda faturayı tahmin etmek de kolaydır. İhtiyacınız olan belirli site için hazır bir Actor varsa Apify de caziptir; ParseHub ise hacmin düşük olduğu küçük ücretsiz katman projelerinde işe yarar.
Daha Fazla Bilgi



