
Otomatik trafik artık web’in %53’ünü oluşturuyor, insanlardan daha fazla ve anti-bot sistemleri her zamankinden daha sert karşılık veriyor.
Kendi deneyimlerimden biliyorum: yanlış user agent kullanmak gibi tek bir hata bile veri projenizi 403 hatalarıyla dolu bir duvara çevirebilir. Satış, e-ticaret ve operasyon ekipleri için engellenmek; kaçan lead’ler, güncelliğini yitirmiş fiyatlar ya da gelir kaybı demek.
Burada, kazıma için user agent kullanımı hakkında öğrendiklerimi paylaşıyorum — temel iyi uygulamalar, sık yapılan hatalar ve Thunderbit gibi araçların bunların tamamını nasıl otomatik yönettiği dahil.

Kazıma İçin En İyi User Agent’ı Seçmek Neden Önemli?
Önce temelden başlayalım: user agent nedir? Bunu tarayıcınızın “kimlik kartı” gibi düşünebilirsiniz. Bir web sitesini ziyaret ettiğinizde — ister insan olun ister bot — tarayıcınız istek başlıklarında bir User-Agent dizisi gönderir. Bu, “Merhaba, ben Windows’ta Chrome’um” ya da “Ben iPhone’daki Safari’yim” gibi kısa bir tanıtım gibidir (ScraperAPI). Tipik bir Chrome user agent örneği şöyle görünür:
Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36
Web siteleri bu bilgiyi iki ana nedenle kullanır:
- Doğru içeriği sunmak için (mobil ya da masaüstü düzeni gibi).
- Botları ve scraper’ları tespit etmek için.
Eğer user agent’ınız “python-requests/2.28.1” ya da “Scrapy/2.9.0” diyorsa, sanki boynunuza “Merhaba, ben bir botum!” yazan bir kart takmış gibi olursunuz. Siteler bu tür açık kimlikleri kara listeye alır ve sizi “403 Forbidden” demeye kalmadan engeller. Buna karşılık, yaygın kullanılan ve güncel bir tarayıcı user agent’ı, kalabalığın içinde kaybolmanıza yardımcı olur.
Kısacası: user agent’ınız sizin kılık değiştirmenizdir. Kılık ne kadar iyi olursa, ihtiyacınız olan veriye ulaşma şansınız da o kadar artar.
Web Scraping Başarısında User Agent’ın Rolü
User agent seçimi neden bu kadar kritik? Çünkü çoğu anti-bot sisteminin ilk savunma hattı budur. Yanlış seçerseniz neler olur:
- Anında engeller (403/429 hataları): Varsayılan bir scraping kütüphanesi UA’sı kullanırsanız, ana sayfayı bile görmeden bloklanabilirsiniz (Webmasters StackExchange).
- Boş ya da sahte veri: Bazı siteler şüpheli user agent’lara boş ya da “kukla” sayfalar döndürür.
- CAPTCHA ya da yönlendirme: Bot benzeri bir UA, “İnsan mısınız?” testlerini veya bitmeyen giriş döngülerini tetikler.
- Hız sınırlama ve ban: Aynı UA ile bir siteye sürekli istek atarsanız, hızınız kısılır ya da IP’niz banlanır.
Farklı user agent’ların pratikte nasıl sonuç verdiğine bakalım:
| User Agent Dizisi | 2026’da Çoğu Sitedeki Sonuç |
|---|---|
python-requests/2.28.1 | Anında engellenir, bot olarak işaretlenir |
Scrapy/2.9.0 (+https://scrapy.org) | Engellenir ya da sahte içerik döndürülür |
Mozilla/5.0 (Windows NT 10.0; Win64; x64)... | Gerçek kullanıcı gibi değerlendirilir, erişim verilir |
AhrefsBot/7.0 (+http://ahrefs.com/robot/) | Engellenir, bilinen crawler |
| Boş ya da anlamsız UA | Bazen geçer, ama çoğu zaman şüpheli |
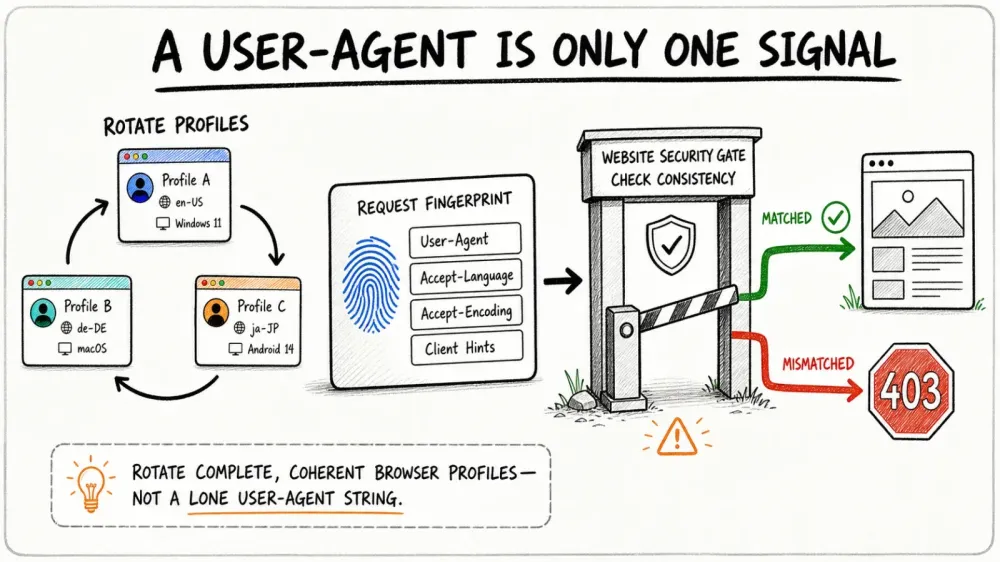
Ders şu: Kılık değiştirmenizi akıllıca seçin. Ve unutmayın — modern anti-bot sistemleri sadece user agent’a bakmaz. Accept-Language veya Referer gibi diğer istek başlıklarınızın da uyumlu olup olmadığını kontrol ederler. Chrome olduğunuzu iddia edip doğru başlıkları göndermiyorsanız, yine yakalanırsınız (ScraperAPI).
Yapay Zekâ ile Herhangi Bir Web Sitenin Verisini Çekin Thunderbit'in agentic web scraper'ı, render ve sayfa yapısını kendi başına yönetir; böylece user agent’larla manuel uğraşmanıza gerek kalmaz. Get Started Free
Tam da burada Thunderbit devreye giriyor. Satış temsilcileri, e-ticaret yöneticileri, emlakçılar gibi birçok iş kullanıcısıyla konuştum — onların istediği şey veri; HTTP başlıkları üzerine bir ders değil. Bu yüzden Thunderbit’i user agent yönetimini görünmez ve otomatik hale getirecek şekilde tasarladık.
Thunderbit: User Agent Yönetimini Herkes İçin Sadeleştiriyor
Thunderbit’in tek tıkla scraping özelliğinde, herhangi bir user agent seçmeniz gerekmez. Yapay zekâ motorumuz bunu sizin yerinize yapar ve her site için en gerçekçi, en güncel tarayıcı izini seçer. İster Thunderbit Chrome Uzantısı kullanın (ki bu uzantı doğrudan Chrome’un gerçek UA’sını kullanır), ister bulut kazıma yapın (burada yapay zekâ güncel tarayıcı UA’ları arasında rotasyon yapar), her zaman normal trafik gibi görünürsünüz.
Üstelik mesele sadece user agent da değil. Thunderbit, Accept-Language, Accept-Encoding, Client Hints ve daha fazlasını içeren tam ve tutarlı bir başlık seti gönderir; böylece istekleriniz gerçek bir tarayıcı gibi görünür ve davranır. Artık uyumsuz başlıklar yok, “bot” uyarısı yok.
En güzel kısmı ne mi? Hiçbir şey ayarlamanıza gerek yok. Thunderbit’in yapay zekâsı tüm teknik detayları perde arkasında yönetir; size sadece güvenilir ve yüksek kaliteli veri almak kalır.
Thunderbit Agentic Web Scraper’ı Ücretsiz Deneyin Ücretsiz Chrome uzantısını yükleyin ve herhangi bir sayfadan yapılandırılmış veriyi tek tıkla çıkarın; başlık maskeleme gerekmez. Get Started Free
Dinamik User Agent Rotasyonu Neden Olmazsa Olmaz Bir İyi Uygulama?
Diyelim ki mükemmel bir user agent buldunuz. Bunu her istekte aynı şekilde mi kullanmalısınız? O kadar hızlı değil. 2026’da aynı UA’yı tekrar tekrar kullanmak açık bir ipucudur. Gerçek kullanıcıların farklı tarayıcıları, sürümleri ve cihazları vardır. Scraper’ınız bir siteye art arda 500 kez aynı UA ile istek atarsa, bu adeta sahneye birbirinin aynısı ikizlerden oluşan bir kortej göndermek gibidir — kimse kandırılmaz.
Bu yüzden dinamik user agent rotasyonu artık sektör standardı. Mantık basit: Her istek ya da oturum için gerçekçi ve güncel user agent’lardan oluşan bir liste arasında dönüş yapın. Böylece scraper’ınız tek bir otomasyon script’i yerine, farklı gerçek ziyaretçilerden oluşan bir topluluk gibi görünür (Capsolver).
Thunderbit’in yapay zekâ destekli rotasyonu bunu bir adım öteye taşır. Çok sayfalı taramalar ya da zamanlanmış görevler için Thunderbit user agent’ları otomatik değiştirir ve hatta bunları farklı proxy IP’lerle eşleştirir. Bir site şüphelenmeye başlarsa, Thunderbit gerçek zamanlı uyum sağlar — UA değiştirir, başlıkları ayarlar veya gerekiyorsa istek hızını düşürür. Tüm bunlar arka planda olur; böylece kazımanız fark edilmeden devam eder ve veri akışı kesilmez.
User Agent ve İstek Başlıkları: Tutarlılığın Gücü
İşte profesyonel bir ipucu: user agent, isteğinizin “parmak izi”nin sadece bir parçasıdır. Modern anti-bot sistemleri UA’nızın Accept-Language, Accept-Encoding ve Referer gibi diğer başlıklarla uyumlu olup olmadığını kontrol eder. Windows’ta Chrome olduğunuzu iddia edip New York IP’sinden Fransızca bir Accept-Language gönderirseniz, bu şüpheli görünür (ScraperAPI).
En iyi uygulama:
- User agent’ınızla uyumlu tam bir başlık seti gönderin.
- Accept-Language ve Accept-Encoding değerlerini UA’nız ve mümkünse IP coğrafi konumunuzla uyumlu tutun.
- Gerçek istekleri incelemek ve seçtiğiniz UA için tam başlık setini kopyalamak üzere tarayıcı geliştirici araçlarını kullanın.
Thunderbit bunların hepsini sizin için halleder. Yapay zekâmız, her isteğin mükemmel eşleşmesini sağlar — user agent, başlıklar ve hatta browser fingerprinting bile. Hiç çaba harcamadan insan benzeri bir istek profili elde edersiniz.
Sık Yapılan Hatalardan Kaçınmak: User Agent’larda NELER YAPILMAMALI?
Birçok scraping projesinin aynı nedenlerle başarısız olduğunu gördüm. Kaçınmanız gereken en büyük hatalar şunlar:
- Varsayılan scraping kütüphanesi UA’larını kullanmak:
python-requests/2.x,Scrapy/2.9.0veyaJava/1.8gibi diziler anında blok tetikler. - Güncel olmayan tarayıcı sürümleri: 2026’da Chrome 120 olduğunuzu iddia etmek mi? Şüpheli — o sürüm iki yıldan daha eski. Her zaman güncel kararlı kanaldan bir UA kullanın (bu yazı yazılırken Chrome 147); on iki ay eski bir liste bile artık bot belirtisidir.
- Uyumsuz başlıklar: Chrome UA’sı gönderip eksik veya uyumsuz Accept-Language, Accept-Encoding ya da Client Hints kullanmayın.
- Bilinen crawler UA’ları: “bot”, “crawler”, “spider” ya da araç isimleri (AhrefsBot gibi) içeren her şey kırmızı bayraktır.
- Boş ya da anlamsız UA’lar: Bazen geçebilir, ama çoğu zaman şüpheli ve güvenilmezdir.
Güvenli user agent için hızlı kontrol listesi:
- Gerçek ve güncel tarayıcı UA’ları kullanın (Chrome, Firefox, Safari).
- Birden fazla UA arasında rotasyon yapın.
- Başlıkları UA’nızla tutarlı tutun.
- UA listenizi her ay güncelleyin (tarayıcılar hızla değişir).
- “Otomasyon” diye bağıran her şeyden kaçının.
Thunderbit Sahada: Satış ve Operasyon için Gerçek Dünya Senaryoları
Gelin biraz pratik bakalım. Thunderbit’in user agent yönetimi gerçek ekiplerde nasıl iş görüyor:
| Kullanım Senaryosu | Eski Yöntem: Manuel Kazıma | Thunderbit ile | Sonuç |
|---|---|---|---|
| Satış Lead Üretimi | Sık sık blok, eksik veri | Yapay zekâ en iyi UA’yı seçer, rotasyon yapar, gerçek taramayı taklit eder | Daha fazla lead, daha yüksek kalite, daha az hata |
| E-ticaret İzleme | Script bozulur, IP banları | Dinamik UA ve proxy rotasyonlu bulut kazıma | Güvenilir fiyat/stok takibi |
| Emlak İlanları | Yorucu düzeltmeler, bloklar | Yapay zekâ UA/başlıkları uyarlar, alt sayfaları otomatik işler | Eksiksiz, güncel mülk listeleri |

Thunderbit kullanan bir satış ekibi, binlerce web sitesini lead için taradı ve satın alınmış listelerdeki %15–20’ye kıyasla yalnızca yaklaşık %8 e-posta bounce oranı gördü (Reddit). Taze ve insan benzeri kazımanın gücü tam olarak bu.
Adım Adım: Thunderbit ile En İyi User Agent Kullanarak Nasıl Kazıma Yapılır?
Thunderbit ile başlamak ne kadar kolay, görün — teknik bilgi gerekmez:
- Thunderbit Chrome Uzantısı kurun.
- Hedef web sitenize gidin. Gerekirse giriş yapın — Thunderbit giriş yapılmış sayfalarda da çalışır.
- “One Click Extract”e tıklayın. Thunderbit’in yapay zekâsı sayfayı tarar ve kazımak için en uygun sütunları önerir.
- İsterseniz alanları gözden geçirip düzenleyin. Gerekirse sütunları yeniden adlandırın, ekleyin veya kaldırın.
- “Scrape”e tıklayın. Thunderbit veriyi çeker, arka planda user agent ve başlıkları döndürür.
- Verinizi dışa aktarın. Doğrudan Excel, Google Sheets, Airtable, Notion’a gönderin ya da CSV/JSON olarak indirin.
User agent seçmek ya da güncellemekle uğraşmanıza gerek yok — Thunderbit’in yapay zekâsı bunu sizin yerinize yapar ve her siteye uyum sağlayarak başarı şansını en üst düzeye çıkarır.
Yapay Zekâ Destekli User Agent Rotasyonu ile Kazıyın Thunderbit, kazıma işlerini kendi altyapısı üzerinden çalıştırır; böylece tek tık, manuel user-agent rotasyon script’lerinin yerini alır. Get Started Free
Thunderbit ile Geleneksel User Agent Yönetiminin Karşılaştırması
Gelin Thunderbit’i eski usul manuel yöntemle karşılaştıralım:
| Özellik/Görev | Manuel Kazıma Yaklaşımı | Thunderbit Yaklaşımı |
|---|---|---|
| User Agent Kurulumu | Araştırma yapıp kodda ayarlama | Otomatik, siteye göre AI seçimi |
| UA’ları Güncel Tutma | Manuel, unutması kolay | Yapay zekâ tarayıcı trendlerine göre otomatik günceller |
| UA Rotasyonu | Kendi rotasyon mantığını yazma | Yerleşik, akıllı rotasyon |
| Başlık Tutarlılığı | Başlıkları elle UA ile eşleştirme | Yapay zekâ tam ve tutarlı başlık seti sağlar |
| Blok/CAPTCHA Yönetimi | Manuel değişim, yüksek bakım ihtiyacı | Yapay zekâ gerektiğinde uyum sağlar, yeniden dener ve rotasyon yapar |
| Gerekli Teknik Bilgi | Yüksek (kodlama, HTTP bilgisi) | Yok—iş kullanıcıları için tasarlandı |
| Sorun Giderme Süresi | Sık, can sıkıcı | Minimum—odak veride, scraping baş ağrısında değil |
Thunderbit, teknik yük olmadan güvenilir ve ölçeklenebilir kazıma isteyen herkes için tasarlandı.
Agentic Web Scraping Nasıl Çalışır, Görün Thunderbit’in yapay zekâsı bir sayfayı insan gibi okur ve veriyi tek tıkla çıkarır; manuel scraper ayarı yapma ihtiyacını ortadan kaldırır. Get Started Free
Temel Çıkarımlar: Geleceğe Dayanıklı Bir User Agent Stratejisi Kurmak
2026’da user agent yönetimi hakkında öğrendiklerimden bazıları — bazen zor yoldan:
- Varsayılan veya güncel olmayan user agent’lar kullanmayın. Scraper’ların engellenmesinin bir numaralı nedeni bunlar.
- User agent rotasyonunu dinamik yapın. Çeşitlilik sizin dostunuz; scraper’ınızın robot geçidine benzemesine izin vermeyin.
- Başlıkları tutarlı ve gerçekçi tutun. User agent’ınız, eşlik eden başlıklar kadar iyidir.
- Güncel kalın. Tarayıcı sürümleri hızla değişir; UA listeniz de öyle olmalı.
- Zor işleri yapay zekâya bırakın. Thunderbit gibi araçlar en iyi uygulamaları doğrudan içine işler; böylece siz isteklere değil sonuçlara odaklanırsınız.
Engellenmekten, script’lerle uğraşmaktan yorulduysanız ya da sadece zahmetsizce profesyonel gibi veri çekmek istiyorsanız, Thunderbit’i deneyin. Agentic web scraper’ımız dünya genelinde binlerce kullanıcı tarafından güvenle kullanılıyor ve web verisini herkes için erişilebilir hale getirmek üzere tasarlandı — teknik baş ağrısı yok.
Web scraping hakkında daha fazla ipucu, eğitim ve derinlemesine içerik için Thunderbit Blog’a göz atın.
SSS
1. User agent nedir ve web scraping için neden önemlidir?
User agent, her web isteğiyle birlikte gönderilen ve tarayıcınızı ile işletim sisteminizi tanımlayan bir dizidir. Web siteleri bunu doğru içeriği sunmak ve botları tespit etmek için kullanır. Doğru user agent’ı kullanmak, scraper’ınızın kalabalığa karışmasına ve bloklardan kaçınmasına yardımcı olur.
2. Neden scraping kütüphanemin varsayılan user agent’ını kullanmamalıyım?
python-requests/2.x gibi varsayılan user agent’lar iyi bilinen bot imzalarıdır ve çoğu zaman anında engellenir. Her zaman gerçekçi ve güncel tarayıcı user agent’ları kullanın.
3. Thunderbit user agent rotasyonunu nasıl yönetiyor?
Thunderbit’in yapay zekâsı, her istek ya da oturum için güncel ve gerçekçi tarayıcı user agent’larından oluşan bir havuz arasında otomatik rotasyon yapar. Bu da kazımanızın gerçek ve çeşitli kullanıcı trafiği gibi görünmesini sağlar.
4. Thunderbit ile Accept-Language veya Referer gibi başlıkları manuel ayarlamam gerekir mi?
Hayır! Thunderbit’in yapay zekâsı tüm başlıkların tutarlı olmasını ve user agent’ınızla eşleşmesini sağlar; böylece istekleriniz gerçek bir tarayıcı gibi görünür ve davranır.
5. Bir site yine de isteklerimi engellemeye başlarsa ne olur?
Thunderbit engelleri veya CAPTCHA’ları algılar ve gerçek zamanlı uyum sağlar — user agent değiştirir, başlıkları ayarlar veya gerektiğinde yeniden dener. Manuel sorun gidermeye gerek kalmadan güvenilir veri alırsınız.
Daha akıllı kazımaya hazır mısınız? Thunderbit’i indirin ve user agent kovalamacasını yapay zekâmıza bırakın. Keyifli kazımalar!
Daha Fazla Öğrenin
- AI Agent’lar nedir? Nasıl çalışır ve nasıl kullanılır?
- Manus AI Agent nedir? Nasıl çalışır ve nasıl kullanılır?
- Başlangıç Rehberi: Adım Adım AI Agent Nasıl Oluşturulur?
- Dikey AI Agent’lar Rehberi: Kavramlar ve Gerçek Dünya Kullanım Örnekleri
- AI Agent İstatistiklerini Anlamak: Doğruluktan Ölçeklenebilirliğe
Agentic Web Scraper’ı Deneyin Get Started Free



