
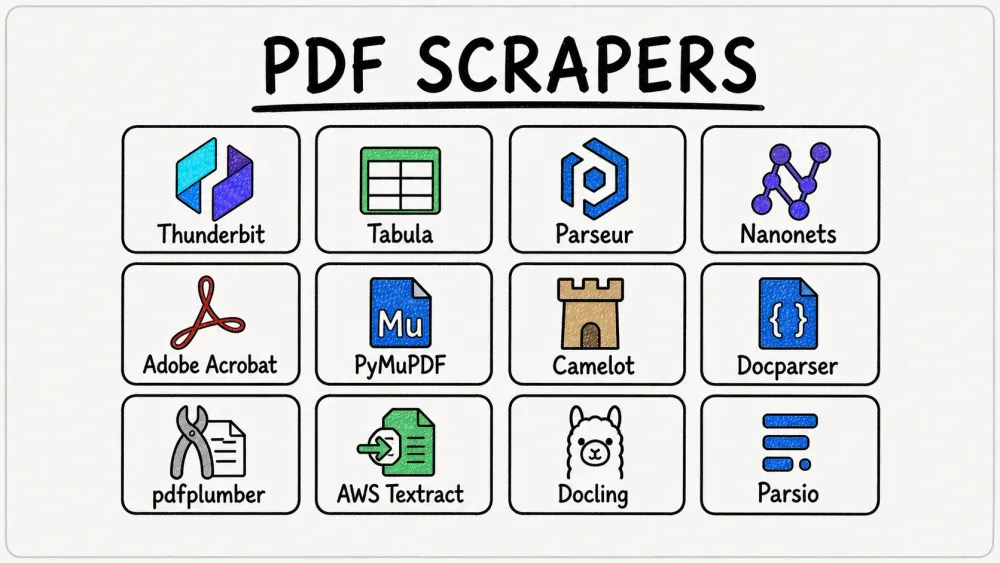
Geçen hafta bir çalışma arkadaşım bana 47 sayfalık bir tedarikçi sözleşmesi gönderip "fiyat tablolarını alıp bir tabloya aktarır mısın?" dedi. PDF’ye yaklaşık üç saniye baktıktan sonra kapatıp bir PDF scraper açtım. Bu refleks tembellikten gelmiyordu; yıllardır insanların, veri vermek için tasarlanmamış dosyalardan veri çıkarmak uğruna bütün öğleden sonralarını harcadığını gördüğüm için böyle davranıyordum.
Rakamlar da bu sıkıntıyı doğruluyor. Airbase’in 2024’te yaptığı 745 finans profesyoneli araştırmasına göre ekiplerin %38’i toplam zamanlarının dörtte birinden fazlasını manuel işlere ayırıyor. SAP Concur’un AP otomasyon raporu ise ERP veya muhasebe sistemlerine girilen fatura kayıtlarının %60’ının hâlâ elle yapıldığını söylüyor.
PDF’ler her yerde: faturalar, sözleşmeler, finansal tablolar, taranmış makbuzlar… ama işin önemli bir kısmı hâlâ kopyala-yapıştırdan ibaret. 2026’da PDF scraper’lar ücretsiz Python kütüphanelerinden yapay zekâ destekli kodsuz araçlara kadar uzanıyor; yanlış aracı seçmek size zaman kazandırmak yerine günler kaybettirebilir. Ben de tablo çıkarma, OCR, fiyatlandırma ve kullanım kolaylığı açısından 12 güçlü PDF scraper’ı test ettim; böylece size uygun seçeneği dakikalar içinde bulabilirsiniz.
PDF Scraper Nedir ve Neden Önemlidir?
PDF scraper, PDF dosyalarından metin, tablo, alan ve yapılandırılmış verileri otomatik olarak çıkaran yazılımdır. PDF içindeki bir tabloyu Excel’e kopyalayıp sütunların tek bir karmaşık satırda dağıldığını gördüyseniz, sorunu zaten biliyorsunuz demektir.
PDF scraper’lar ile web scraper’lar sık sık karıştırılır, bu yüzden kısa bir ayrım faydalıdır. Web scraper HTML okur; HTML’de başlıklar, tablolar, div’ler gibi yapısal etiketler vardır. PDF scraper ise görsel sayfa tanımı formatından başlar. Adobe’nin kendi dokümantasyonu bunu net biçimde açıklar: PDF, temiz tablo yapısı ya da anlamsal yapı sunmak için değil, sayfa görünümünü cihazlar arasında tutarlı biçimde korumak için tasarlanmıştır. Bu yüzden kopyala-yapıştır satırları, sütunları ve okuma sırasını bozar.
PDF scraping tam olarak nerede zaman kazandırır?
- Fatura işleme: tedarikçi adları, fatura ID’leri, toplam tutarlar, vergi ve kalemleri çekmek
- Finansal raporlar: yıllık raporlar, tablolar ve açıklamalardan veri çıkarmak
- Taranmış kayıtlar: yalnızca görüntüden oluşan PDF’lerden iletişim bilgisi veya işlem verisi kurtarmak
- Eski arşivlerin taşınması: eski belgeleri aranabilir, yapılandırılmış kayıtlara dönüştürmek
İş etkisi tek bir iş akışının ötesine geçiyor. Gartner, zayıf veri kalitesinin kuruluşlara ortalama yılda en az 12,9 milyon dolar kaybettirdiğini hâlâ vurguluyor. Şubat 2025’te Gartner, kuruluşların %63’ünün yapay zekâ için doğru veri yönetimi uygulamalarına sahip olmadığını ya da buna emin olmadığını açıkladı. 2026’ya kadar Gartner, AI-ready veriyle desteklenmeyen yapay zekâ projelerinin %60’ının terk edileceğini söylüyor. Ham verinin önemli bir kısmı hâlâ PDF’lerde duruyorsa, belge çıkarma kalitesi artık doğrudan yapay zekâ hazırlık düzeyine bağlanmış durumda.
Adobe’nin 2025’te yaptığı finans profesyonelleri araştırmasına göre %61’i PDF tabanlı belgeleri düzenli olarak düzenliyor ve %64’ü bunları düzenli olarak imzalıyor. PDF Association da CommonCrawl verilerinde PDF’yi web üzerindeki 3. en popüler dosya formatı olarak gösteriyor. Kısacası PDF’ler ortadan kalkmıyor.
En İyi PDF Scraper’ları Nasıl Değerlendirdik?
Araçlara geçmeden önce kullandığım çerçeve şu şekildeydi. Aşağıdaki sekiz kriter, forumlarda, GitHub sorunlarında ve ürün yorumlarında en sık gördüğüm sıkıntılara doğrudan karşılık geliyor:
| Kriter | Ne Ölçüyor? | Kullanıcı İçin Neden Önemli? |
|---|---|---|
| Desteklenen PDF türleri | Yerel metin, taranmış/görüntü, karma | Birçok araç çıkarma başlamadan başarısız olur |
| Tablo çıkarma doğruluğu | Basit, çizgisiz, çok sayfalı, birleşik hücreli tablolar | PDF çıkarma konusunda en büyük şikâyet |
| OCR yeteneği | Dahili, eklenti ya da yok | OCR olmadan taranmış PDF’ler kullanılamaz |
| Çıktı/dışa aktarma formatları | Excel, CSV, JSON, Sheets, Notion, API’ler | Veri aracı temiz biçimde terk edemiyorsa işe yaramaz |
| Kurulum zorluğu | Kodsuz, düşük kodlu, kod odaklı | Ekiplerin kontrol ihtiyacı çok farklıdır |
| Fiyatlandırma / ücretsiz katman | Açık fiyat, deneme, gerçekçi başlangıç noktası | Faturalama modelleri çok değişken |
| Otomasyon / entegrasyonlar | Zapier, API, zamanlama, webhook | Manuel dışa aktarma ölçeklenmez |
| En uygun kullanım senaryosu | Aracın gerçekten iyi olduğu alan | Çoğu araç her iş için iyi değildir; iş akışına özeldir |
Okunabilirlik için 12 aracı üç kategoriye ayırdım: kodsuz AI scraper’lar, şablon tabanlı veya SaaS belge ayrıştırıcılar, ve geliştirici kütüphaneleri / API’ler / açık kaynak araçlar.
En İyi 12 PDF Scraper'a Hızlı Bakış
İşte profilinize göre hızlıca tarayıp uygun bölüme geçebilmeniz için ana karşılaştırma:
| Araç | Tür | Tablo Çıkarma | Dahili OCR | Kodsuz | Ücretsiz Katman | En Uygun Olduğu Alan |
|---|---|---|---|---|---|---|
| Thunderbit | AI kodsuz scraper | ✅ Yapay zekâ destekli | ✅ Evet | ✅ Evet | ✅ Ücretsiz kredi | İş kullanıcıları, farklı düzenler |
| Tabula | Açık kaynak masaüstü | ✅ İyi (metin PDF’leri) | ❌ Hayır | ✅ GUI | ✅ Tamamen ücretsiz | Basit, tablo ağırlıklı metin PDF’leri |
| Parseur | Hibrit SaaS | ⚠️ Şablon + AI | ✅ Evet | ✅ Evet | ⚠️ Sınırlı | Tekrarlayan fatura/e-posta ayrıştırma |
| Nanonets | AI IDP SaaS | ✅ Güçlü | ✅ Evet | ✅ Düşük kod | ⚠️ Kredi denemesi | Yüksek hacimli belge otomasyonu |
| Adobe Acrobat | PDF üretkenlik paketi | ⚠️ Temel | ✅ Evet | ✅ Evet | ❌ Dışa aktarma ücretli | Ara sıra PDF’den Excel’e dönüşüm |
| PyMuPDF | Python kütüphanesi | ⚠️ Elle ayrıştırma | ❌ Hayır (Tesseract opsiyonel) | ❌ Kod gerekir | ✅ Tamamen ücretsiz | Geliştiriciler, metin ağırlıklı PDF’ler |
| Camelot | Python tablo kütüphanesi | ✅ Güçlü (lattice + stream) | ❌ Hayır | ❌ Kod gerekir | ✅ Tamamen ücretsiz | Geliştiriciler, karmaşık tablolar |
| Docparser | Şablon SaaS | ⚠️ Şablon tabanlı | ✅ Evet | ✅ Evet | ⚠️ Deneme | Tekrarlayan belgeler + Zapier iş akışları |
| pdfplumber | Python kütüphanesi | ✅ İyi (ince ayarlı) | ❌ Hayır | ❌ Kod gerekir | ✅ Tamamen ücretsiz | Geliştiriciler, ayrıntılı kontrol |
| AWS Textract | Bulut API | ✅ Güçlü | ✅ Evet | ❌ API gerekir | ⚠️ Ücretsiz katman sınırlı | Kurumsal ölçekli akışlar |
| Docling | Açık kaynak Python | ✅ İyi | ✅ Entegrasyonla | ❌ Kod gerekir | ✅ Tamamen ücretsiz | LLM/RAG akışları |
| Parsio | Hibrit SaaS | ⚠️ AI destekli | ✅ Evet | ✅ Evet | ⚠️ Sınırlı | Tekrarlayan belge türleri |
Sıfır kurulum mu istiyorsunuz? Kodsuz ya da SaaS satırlarından başlayın. En yüksek kontrol mü lazım? Geliştirici satırlarından başlayın. Taranmış PDF’ler ile mi çalışıyorsunuz? OCR = Hayır olan satırları eleyin.
1. Thunderbit
 Thunderbit, "Bu PDF’den sadece veriyi almak istiyorum" deyip Python, şablon ya da API anahtarı duymak istemeyen herkese önereceğim PDF scraper’dır. Bu araç bir AI web veri ajanıdır; PDF’leri, görselleri ve web sitelerini okuyan bir Chrome uzantısıdır ve çıktıyı yapılandırılmış veri olarak verir. Şablon yok, kod yok.
Thunderbit’i, çoğu aracın tökezlediği senaryo için geliştirdik: Beş farklı tedarikçiden PDF alırsınız, her biri biraz farklı bir düzene sahiptir ve siz hepsinden aynı alanları çıkarmak istersiniz. AI her belgeyi baştan okur, “AI Suggest Fields” özelliğiyle sütun adlarını ve veri türlerini önerir ve veriyi yapılandırılmış bir tabloya çıkarır. Yerleşik OCR, taranmış PDF’leri ve görselleri doğal olarak işler; 34 dili destekler.
Öne çıkan özellikler:
- Tek Tıkla Çıkarma, herhangi bir PDF düzeninden sütunları ve veri türlerini otomatik belirler — manuel ayar gerekmez
- Yerleşik OCR ile taranmış PDF ve görsel desteği
- Dışa aktarma: Excel, Google Sheets, Airtable, Notion, CSV ve JSON — hepsi ücretsiz
- AI etiketleme ve yeniden biçimlendirme: AI, veriyi yalnızca sonradan değil, çıkarım sırasında da çevirebilir, sınıflandırabilir veya yeniden yapılandırabilir
- Tablo çıkarma, düzeni insan gibi görsel olarak okur; çizgisiz, düzensiz ve çok tedarikçili formatlara uyum sağlar
Thunderbit ile PDF nasıl taranır?
- Thunderbit Chrome Extension uzantısını yükleyin
- PDF’nizi tarayıcıda açın veya yükleyin
- “Tek Tıkla Çıkarma”ya basın — AI belgeyi okur ve sütun adlarıyla türlerini çıkarır
- “Scrape” düğmesine basın — veri yapılandırılmış tabloya aktarılır
- Google Sheets, Excel, Airtable, Notion, CSV veya JSON’a dışa aktarın
Fiyatlandırma: Kredi içeren ücretsiz katman (yaklaşık 6 sayfa ücretsiz, deneme ile 10 sayfa). Starter plan yıllık faturalamada yaklaşık 9$/ay, aylık faturalamada yaklaşık 15$/ay. Krediler satır bazlıdır (1 kredi = 1 çıktı satırı). Ayrıntılar için Thunderbit Pricing sayfasına bakın.
Kimler için uygun: Farklı PDF düzenleriyle çalışan teknik olmayan kullanıcılar (birden fazla tedarikçiden faturalar, karışık formatlı raporlar) ve tek tıkla sonuç almak isteyenler.
Artıları: Bu listedeki en kolay kurulum; yerleşik OCR; Sheets, Notion, Airtable ve Excel’e doğrudan dışa aktarma; şablon olmadan farklı düzenlerle çalışır.
Eksileri: Kredi bazlı faturalama, sayfa başı maliyeti anlamak için biraz zaman ister; büyük SaaS rakiplerine göre üçüncü taraf inceleme sayısı daha azdır.
PDF scraping için Thunderbit’i deneyin Beş farklı tedarikçiden faturaları yükleyin ve AI’nin her düzen için sütunları kendi belirlemesine izin verin — şablon başına kurulum yok. Get Started Free
2. Tabula
 Tabula, metin tabanlı PDF tablo çıkarma için klasik ücretsiz çözümdür; ancak artık açıkça eski bir projedir. Depo açıklamasına göre gönüllüler tarafından yürütülüyor ve masaüstü uygulamanın yakın gelecekte güncelleme alması pek olası değil. En son masaüstü sürümü hâlâ 2018’den kalma 1.2.1; tabula-java ise en son 2021’de 1.0.5 sürümünü yayınladı.
Öne çıkan özellikler:
- Tablo bölgelerini seçmek için tıkla-seç GUI
- Yerelde çalışır — veri cihazınızdan dışarı çıkmaz
- Hesap yok, abonelik yok, kayıt yok
Fiyatlandırma: Sonsuza kadar tamamen ücretsiz. Açık kaynak.
Kimler için uygun: Net kenarlıklı tablolar içeren, basit metin tabanlı PDF’lerle çalışan ve ücretsiz, yerel bir çözüm isteyen kullanıcılar.
Artıları: Ücretsiz; yerel; temel tablolar için çok basit.
Eksileri: OCR yok (taranmış PDF’ler için uygun değil); çizgisiz tablolarda zayıf; otomasyon veya API yok; bulut seçeneği yok; pratikte bakımsız sayılabilir.
3. Parseur
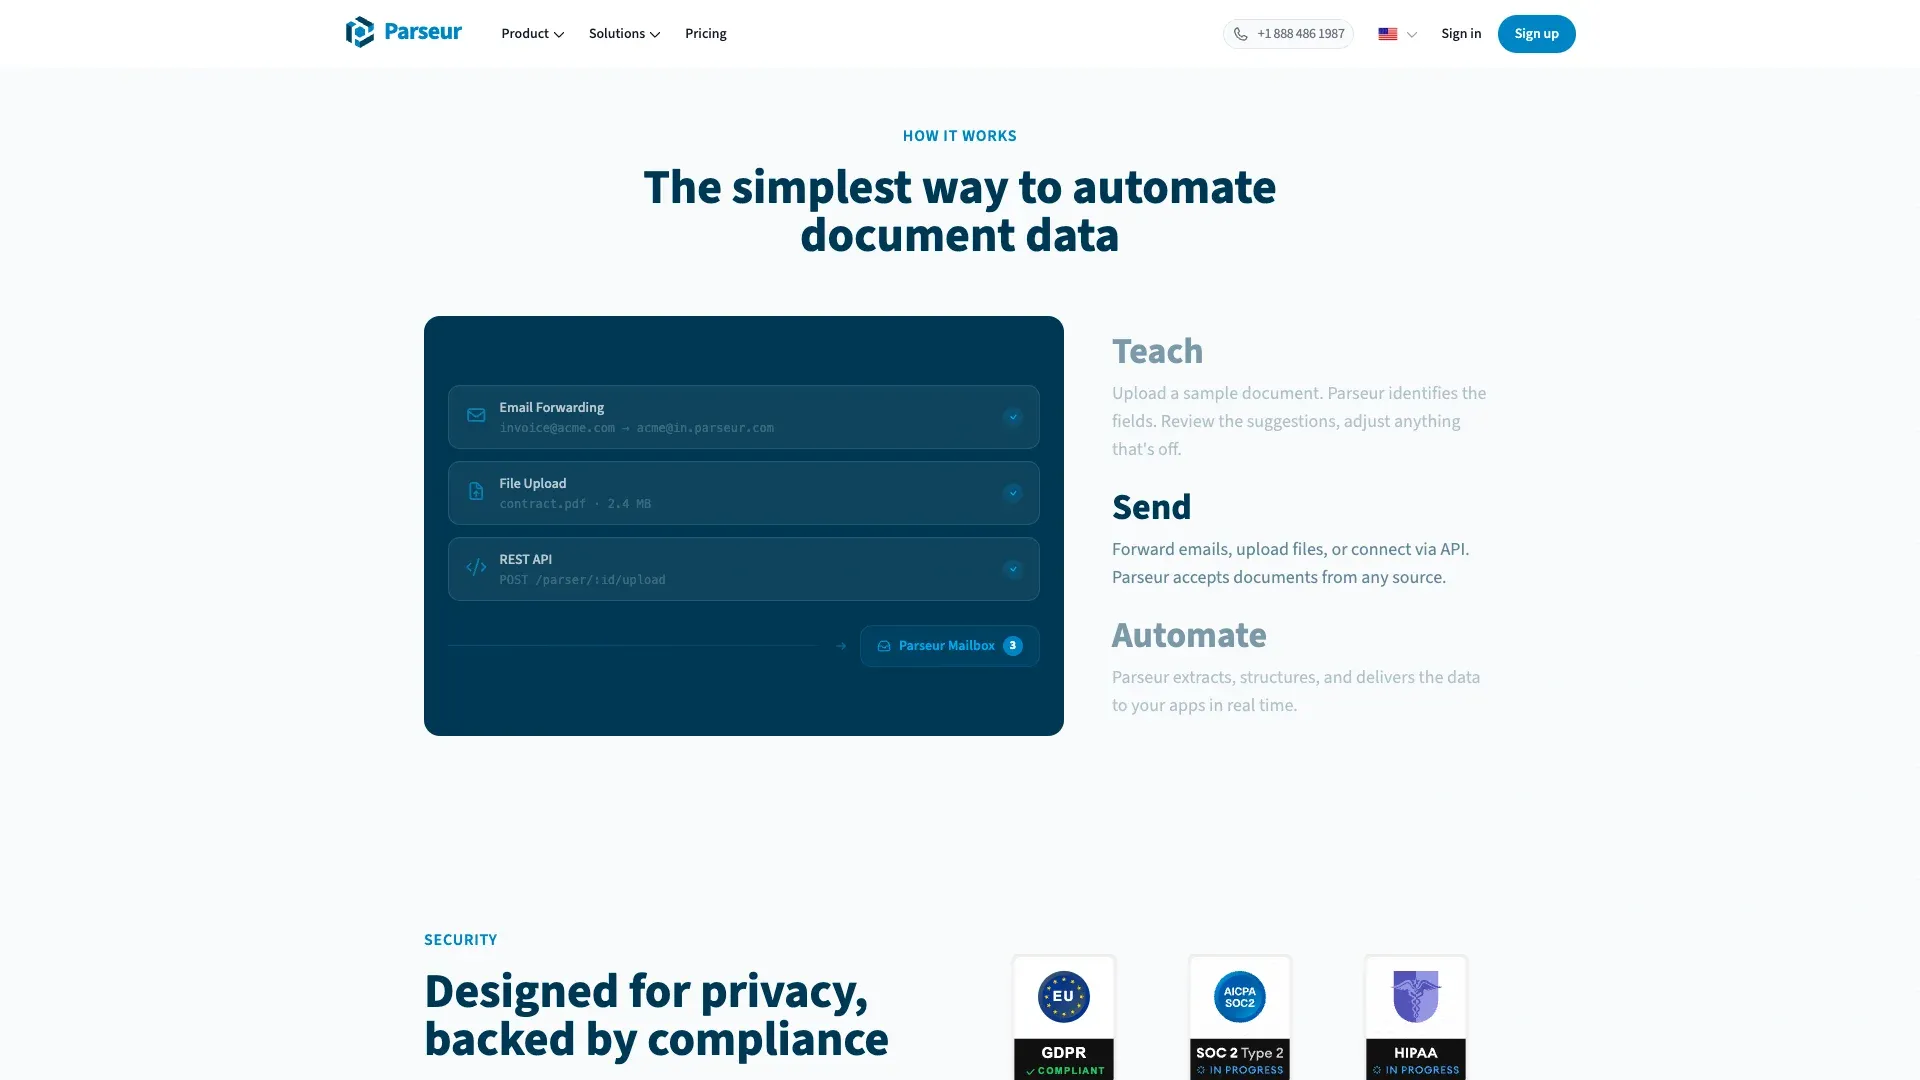 Parseur, SaaS grubundaki en güçlü hibrit çözümdür; çünkü AI ayrıştırma, şablon ayrıştırma ve dinamik OCR özelliklerini birleştirir. Bu da onu saf bölge tabanlı ayrıştırıcılardan daha esnek, ama tam genel amaçlı AI scraper’lardan daha yapılandırılmış hale getirir.
Öne çıkan özellikler:
- 60+ dili destekleyen yerleşik OCR (160+ deneysel)
- Zapier, Make, Power Automate, API, webhook’lar ve Google Sheets entegrasyonları
- Faturalar, sevk bildirimleri, sipariş onayları ve tekrarlayan belge türleri için uygun
Fiyatlandırma: Ayda yaklaşık 20 sayfalık ücretsiz katman. En düşük self-serve ücretli giriş seviyesi yaklaşık 39$/ay. En küçük planda normalize edilmiş maliyet yaklaşık 1.000 sayfa başına 390$ civarındadır; ancak yüksek hacimde efektif oran düşer.
Kimler için uygun: Aynı tür belgeleri tekrar tekrar alan ve kod yazmadan otomasyon isteyen ekipler.
Artıları: Yerleşik OCR; güçlü otomasyon altyapısı; tekrarlayan düzenlerde iyi çalışır.
Eksileri: Her yeni ya da değişen düzen için şablon çalışması veya AI yedeği gerekebilir; karmaşık tablo yapıları hâlâ zorlayıcıdır.
4. Nanonets
 Nanonets, basit bir PDF scraper’dan çok akıllı belge işleme (IDP) platformuna daha yakındır; bu hem güçlü yanı hem de karmaşıklığıdır. Şirket 31 Ocak 2025’te fiyatlandırmasını değiştirdi ve basit sayfa bazlı plan yerine ön ödemeli kullanım kredilerine geçti.
Öne çıkan özellikler:
- AI destekli tablo çıkarma ve alan tespiti
- 40+ dili destekleyen yerleşik OCR
- Onay adımlarıyla iş akışı otomasyonu
- Geniş kurumsal entegrasyon altyapısı
Fiyatlandırma: Kayıtta kredi verilir. Kullanım bazlı faturalama. Açık blok fiyatlandırma dokümantasyonuna göre basit bir çıkarım iş akışı için yaklaşık 1.000 sayfa başına 300–380$ aralığında olabilir.
Kimler için uygun: Aylık binlerce belge işleyen orta ve büyük ekipler (AP otomasyonu, lojistik, sigorta talepleri).
Artıları: Güçlü AI çıkarımı; kurumsal entegrasyonlar; iş akışı otomasyonu.
Eksileri: Fiyatı tahmin etmek daha zordur; gelişmiş iş akışları için öğrenme eğrisi vardır; ücretsiz katman sınırlıdır.
5. Adobe Acrobat
 Adobe Acrobat, neredeyse herkesin tanıdığı temel PDF aracıdır. OCR ve dönüştürme konusunda güçlüdür; ancak bu listedeki diğer araçlar gibi gerçek anlamda bir scraper değildir.
Öne çıkan özellikler:
- Pro sürümde yerleşik OCR
- Word, Excel, PowerPoint, HTML, TXT ve görsel formatlara dışa aktarma
- Geniş çok dilli OCR desteği
Fiyatlandırma: Acrobat Standard 14,99$/ay; Acrobat Pro 19,99$/ay. Reader ücretsizdir, ancak dışa aktarma özellikleri ücretli plan ister.
Kimler için uygun: Ara sıra PDF’yi Word’e veya Excel’e çevirmesi gereken ve zaten Adobe aboneliği olan kullanıcılar.
Artıları: Yaygın olarak güvenilir; yerleşik OCR; birçok kullanıcıda zaten mevcut.
Eksileri: Karmaşık düzenlerde tablo çıkarma temel seviyededir; toplu işlem için otomasyon veya API yoktur; “scraper” olarak tasarlanmamıştır.
6. PyMuPDF
 PyMuPDF ("fitz" olarak da bilinir), bu derlemedeki en hızlı genel amaçlı Python PDF çıkarma kütüphanesi olmaya devam ediyor. Mevcut sürüm Mart 2026’dan 1.27.2.2 ve benchmark’lar hâlâ onu birçok Python PDF kütüphanesinden belirgin biçimde daha hızlı gösteriyor.
Öne çıkan özellikler:
- Son derece hızlı ham metin çıkarma
- Görsel çıkarma ve meta veri erişimi
- Tesseract ile opsiyonel OCR (dokümantasyonda OCR’nin standart çıkarımdan yaklaşık 1.000 kat daha yavaş olduğu belirtiliyor)
find_tables()ile tablo tespiti
Fiyatlandırma: Tamamen ücretsiz, açık kaynak.
Kimler için uygun: Ağırlıklı olarak metin içeren yerel PDF’lerle çalışan pipeline geliştiren yazılımcılar.
Artıları: Çok hızlı; hafif; aktif topluluk; güçlü metin çıkarma.
Eksileri: Dahili OCR yok; tablo çıkarma için manuel ayrıştırma mantığı gerekir; kod gerekir.
7. Camelot
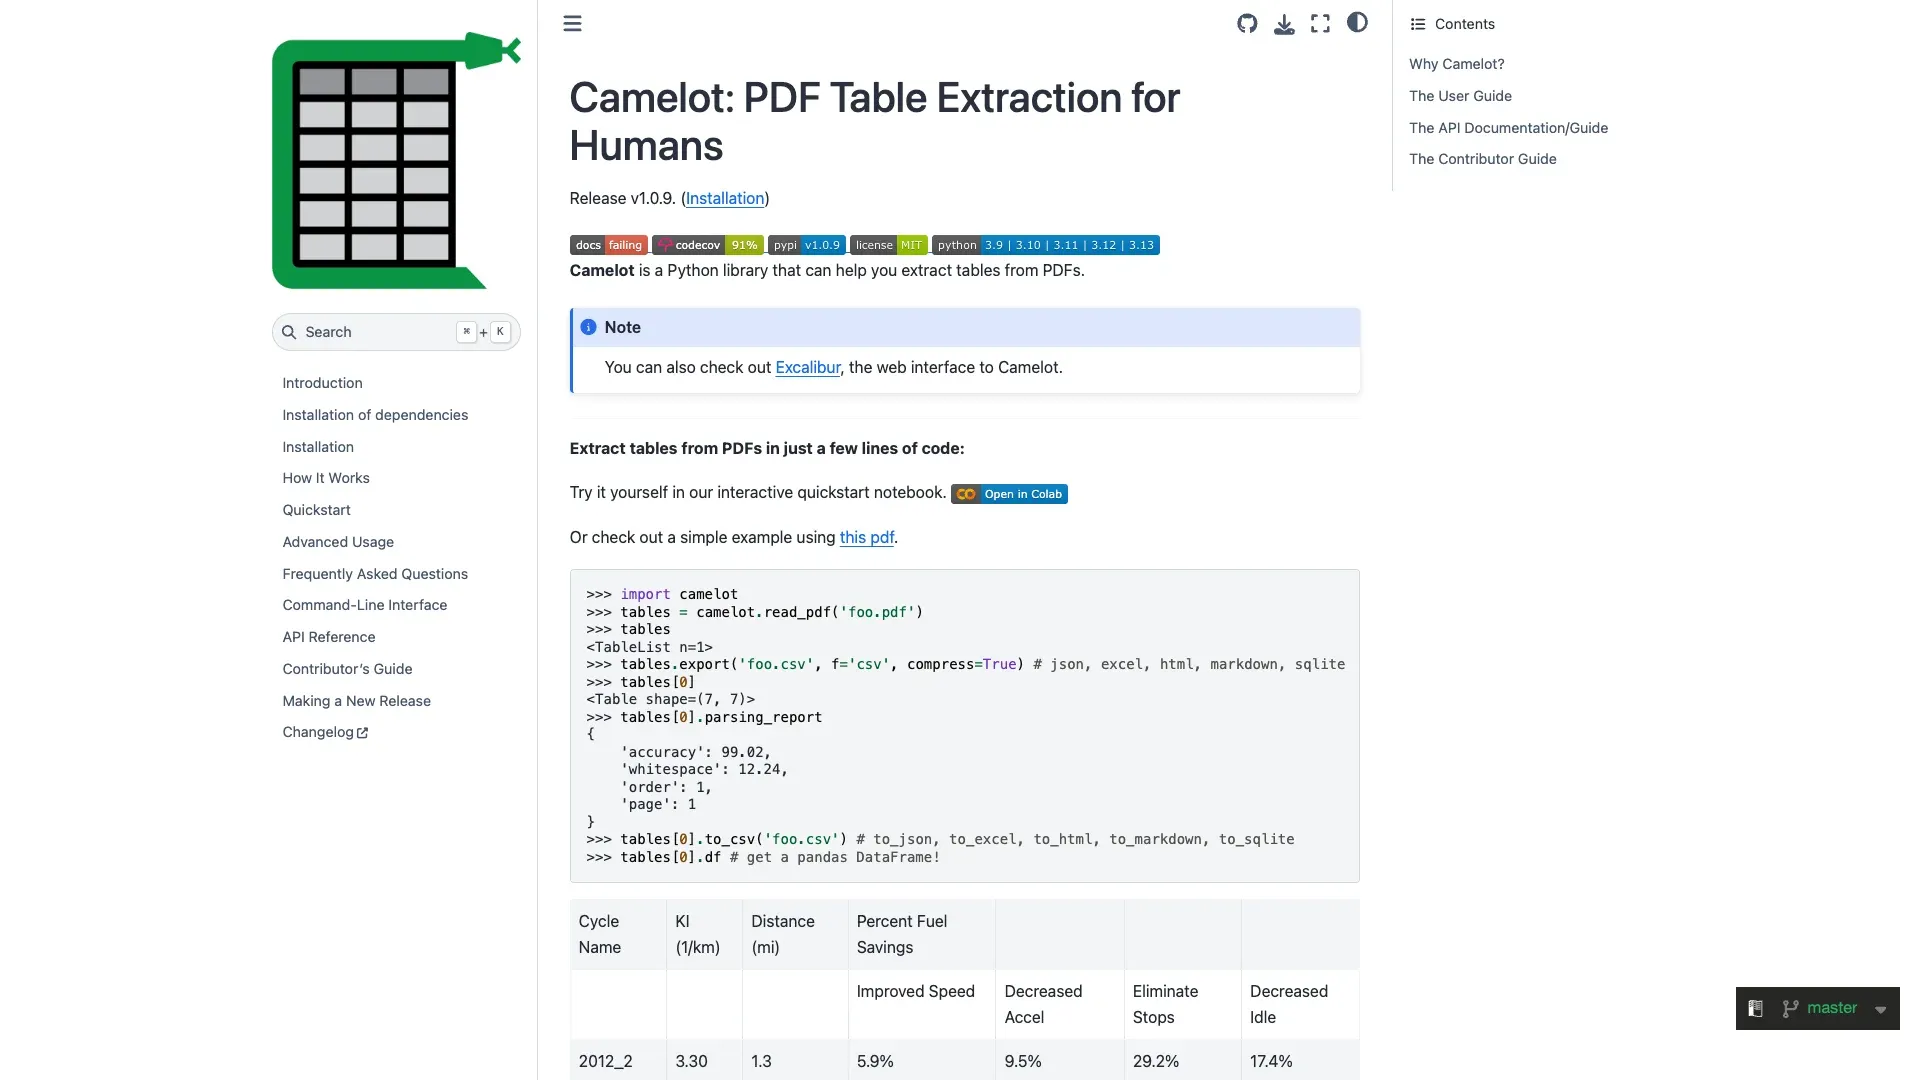 Camelot, tablo odaklı olduğu için hâlâ en bilinen Python tablo çıkarma araçlarından biridir. Mevcut depo aktif olarak sürdürülüyor ve v1.0.9 Ağustos 2025’te yayınlandı.
Öne çıkan özellikler:
- İki çıkarım modu: kenarlıklı tablolar için
lattice, çizgisiz/boşluk tabanlı tablolar içinstream - Parsing report içinde doğruluk metrikleri — otomasyon akışları için Camelot’un en kullanışlı özelliklerinden biri
- Çıktı olarak pandas DataFrame, CSV, JSON, Excel
Fiyatlandırma: Tamamen ücretsiz, açık kaynak.
Kimler için uygun: Yapılandırılmış, metin tabanlı PDF’lerden hassas tablo çıkarımı isteyen geliştiriciler.
Artıları: Mükemmel tablo doğruluğu; çift çıkarım modu; doğruluk skoru.
Eksileri: OCR yok; yalnızca metin tabanlı PDF’ler; kod gerekir; büyük belgelerde yavaş olabilir.
8. Docparser
 Docparser, bu listedeki en kural odaklı SaaS araçtır. Genel bir AI okur gibi davranmaya çalışmak yerine bölgesel OCR, ankraj anahtar kelimeleri ve sabit düzen ayrıştırma kuralları kullanır.
Öne çıkan özellikler:
- Yerleşik OCR
- Zapier, Workato, Power Automate, Google Sheets, Salesforce ve REST API entegrasyonları
- Çıkarılan veriyi iş süreçlerine yönlendirmek için iyi bir seçenek
Fiyatlandırma: Starter 39$/ay; Professional 74$/ay; Business 159$/ay. 14 günlük ücretsiz deneme var. Belge başına ücretlendirildiği için 1.000 sayfa başına normalize maliyet belge uzunluğuna bağlıdır — starter seviyede kabaca 78–390$.
Kimler için uygun: Zapier veya Salesforce gibi araçlarla sıkı entegrasyon içinde tekrarlayan belge iş akışlarını otomatikleştirmesi gereken ekipler.
Artıları: Yerleşik OCR; güçlü iş akışı entegrasyonları; sabit düzenlerde iyi.
Eksileri: Şablon tabanlıdır — her yeni düzen için kurulum gerekir; tablo çıkarma bölge tanımlarına bağlıdır; en güçlü olduğu yer çoğunlukla ilk sayfadır.
9. pdfplumber
 pdfplumber, bu listedeki en ayrıntılı geliştirici kütüphanesi olmaya devam ediyor. Mevcut sürüm Ocak 2026’dan 0.11.9 ve depo aktif geliştirme altında olduğunu belirtiyor.
Öne çıkan özellikler:
- Karakter nesneleri, çizgiler, dikdörtgenler ve tablo bulma stratejileri üzerinde ince ayarlı kontrol
- Kırpma tabanlı filtreleme ve görsel hata ayıklama
- Veriyi kolay işlemek için Python listeleri/sözlükleri olarak çıktı
Fiyatlandırma: Tamamen ücretsiz, açık kaynak.
Kimler için uygun: Ayrıntılı ve özelleştirilebilir tablo çıkarma mantığına ihtiyaç duyan Python geliştiricileri.
Artıları: Düşük seviyede mükemmel kontrol; karmaşık tablolarda iyi doğruluk; aktif geliştirme.
Eksileri: OCR yok; Camelot’a göre öğrenmesi daha zor; kod gerekir.
10. AWS Textract
 AWS Textract, bu listedeki en kurumsal yerel API’dir. GUI rahatlığından çok ölçek, belge çeşitliliği ve programatik kullanım için tasarlanmıştır.
Öne çıkan özellikler:
- AI destekli tablo ve form çıkarma
- El yazısı desteğiyle yerleşik OCR (bu listedekilere en yakın olanı, ama yine de kusursuz değil)
- Kurumsal düzeyde ölçeklenebilirlik
- AWS ekosistemiyle temiz entegrasyon
Fiyatlandırma: Sayfa bazlı ücretlendirme. Ücretsiz katman: 3 ay boyunca ayda 1.000 sayfa. Sonrasında: sadece metin OCR için 1.000 sayfa başına 1,50$; tablolar için 15$/1.000 sayfa; form + tablo için 65$/1.000 sayfa; gider belgeleri için 10$/1.000 sayfa.
Kimler için uygun: API hattı üzerinden ayda 10.000+ belge işleyen kurumsal ekipler.
Artıları: Doğru form ve tablo çıkarımı; yerleşik OCR; kurumsal ölçeklenebilirlik.
Eksileri: Sadece API; görsel arayüz yok; gelişmiş modlarda maliyet hızla artar; AWS ekosistemine bağımlılık yaratır.
11. Docling
 Docling, burada en geleceğe dönük açık kaynak araçtır; çünkü doğrudan belge→LLM akışlarına odaklanır. Mevcut sürüm 17 Nisan 2026 tarihli 2.90.0 ve proje hızlı ilerliyor.
Öne çıkan özellikler:
- Markdown, HTML, WebVTT, DocTags ve kayıpsız JSON çıktısı
- Birden fazla entegre motorla OCR desteği
- LangChain, LlamaIndex, CrewAI, Haystack ve benzeri ekosistemler için tasarlandı
- Güçlü topluluk büyümesi
Fiyatlandırma: Tamamen ücretsiz, açık kaynak.
Kimler için uygun: PDF’leri yapılandırılmış, AI’ye hazır Markdown’a dönüştürmesi gereken LLM/RAG uygulaması geliştirenler.
Artıları: Temiz Markdown çıktısı; entegrasyonla OCR; modern AI iş akışları için tasarlanmış; aktif geliştirme.
Eksileri: Kod gerekir; öncelikle geliştiricilere yöneliktir; SaaS araçlara kıyasla daha az cilalı GUI ve dışa aktarma seçenekleri vardır.
12. Parsio
 Parsio, şablonları, OCR’yi, AI ayrıştırmayı ve GPT destekli ayrıştırmayı birleştiren hibrit bir SaaS çözümdür. Mantık olarak Parseur ile Docparser arasında bir yerde durur: saf bölge yaklaşımından daha esnek, ancak yine de tekrarlayan belge girişleri için optimize edilmiştir.
Öne çıkan özellikler:
- Yerleşik OCR
- AI destekli alan tespiti
- Google Sheets, webhook’lar, API, Zapier, Make, n8n, Pabbly entegrasyonları
Fiyatlandırma: 30 kredilik sandbox. Starter plan 1.000 kredi için 41$/ay; Growth 124$/ay; Business 249$/ay. Ayrıştırma moduna bağlı olarak tek bir belge veya PDF sayfası 1, 2 ya da 5 kredi tutabilir; bu yüzden starter planda normalize maliyet kabaca 41–205$/1.000 sayfa aralığındadır.
Kimler için uygun: Tekrarlayan belge türlerini (faturalar, makbuzlar) işleyen küçük ve orta ölçekli ekipler; hafif AI içeren, kodsuz bir SaaS çözüm isteyenler.
Artıları: Yerleşik OCR; geniş belge türü kapsamı; geniş otomasyon altyapısı.
Eksileri: Üçüncü taraf inceleme derinliği sınırlı; fiyatlandırma modlar arasında daha az şeffaf; Parseur veya Nanonets kadar net ayrışmıyor.
Tablo Çıkarma Karşılaştırması: En İyi PDF Scraper’lar Gerçek Hayattaki Tabloları Nasıl İşliyor?
Tablo çıkarma, PDF scraper kullanıcılarının en çok konuştuğu sorun ve bunun haklı bir nedeni var. OmniDocBench gibi yakın dönem benchmark’lar (10 belge türü boyunca 1.651 sayfa) ve heterojen tablo çıkarımı üzerine akademik çalışmalar, “tablo çıkarma”nın tek tip bir iş olmadığını doğruluyor. Bu bir spektrum.
Basit Tablolar (Net Kenarlar, Tek Sayfa)
Çoğu araç bunları rahatça işler. Tabula, Camelot, pdfplumber, Thunderbit ve AWS Textract burada iyi performans gösterir. PDF’nizde yalnızca basit kenarlıklı tablolar varsa, listedeki araçların neredeyse hepsi iş görür.
Çizgisiz ve Boşluk Tabanlı Tablolar
Ayrışmanın netleştiği yer burasıdır. Kılavuz çizgileri olmadığında, kural tabanlı ayrıştırıcılar sütun sınırlarını tespit etmekte zorlanır. Camelot’un stream modu ve pdfplumber’ın özel parametre ayarı, ayarları ince ayar yapabilen geliştiriciler için güçlüdür. Thunderbit, Nanonets ve AWS Textract gibi AI destekli araçlar düzeni görsel olarak yorumlar; bu da düzensiz formatlarla uğraşan teknik olmayan kullanıcılar için genellikle daha iyi sonuç verir.
Çok Sayfalara Taşan Tablolar
Sık görülen bir başarısızlık senaryosu. Şablon araçlar ve basit çıkarıcılar, iş akışı onları açıkça birbirine bağlamadıkça her sayfayı ayrı tablo olarak görebilir. AI öncelikli araçların avantajı burada ortaya çıkar; çünkü sürekliliği sadece geometrik olarak değil, anlamsal olarak da yorumlayabilirler — ancak hiçbir satıcı bu problem sınıfında kusursuz kabul edilmemelidir.
Birleşik Hücreler ve İç İçe Başlıklar
En zor senaryo. Heterojen tablo bilgi çıkarımı üzerine 2024 EMNLP makalesi yönteme ve senaryoya bağlı olarak F1 puanlarının 74,2 ile 96,1 arasında değiştiğini bildiriyor. AI destekli araçlar (Thunderbit, Nanonets, AWS Textract) bu noktada kural tabanlı ayrıştırıcılardan daha iyi performans gösterme eğilimindedir; çünkü düzeni çizgilerden çok anlamsal olarak yorumlarlar.
OCR Karşılaştırması: Hangi PDF Scraper’lar Taranmış Belgeleri İşliyor?
OCR, gerçek iş PDF’lerini işleyebilen araçlarla yalnızca ideal, makine tarafından üretilmiş belgeleri işleyebilen araçlar arasındaki ayrım çizgisidir. İşte tablo:
| Araç | Yerleşik OCR | Taranmış PDF Desteği | Çok Dilli OCR | El Yazısı Desteği |
|---|---|---|---|---|
| Thunderbit | ✅ Dahili | ✅ Evet | ✅ 34 dil | ⚠️ Sınırlı |
| Adobe Acrobat | ✅ Dahili | ✅ Evet | ✅ Güçlü | ⚠️ Sınırlı |
| AWS Textract | ✅ Dahili | ✅ Evet | ✅ Birden fazla ana dil | ✅ En yakın, ama kusursuz değil |
| Nanonets | ✅ Dahili | ✅ Evet | ✅ 40+ dil | ⚠️ Sınırlı |
| Parseur | ✅ Dahili | ✅ Evet | ✅ 60+ dil | ❌ Hayır |
| Parsio | ✅ Dahili | ✅ Evet | ✅ Çok dilli | ⚠️ Sınırlı |
| Docparser | ✅ Dahili | ✅ Evet | ✅ Evet | ⚠️ Sınırlı |
| Docling | ✅ Entegrasyonla | ✅ Evet | Motora bağlı | ⚠️ Sınırlı |
| Tabula | ❌ Yok | ❌ Hayır | N/A | N/A |
| PyMuPDF | ❌ (Tesseract opsiyonel) | ❌ Eklenti gerekir | Motora bağlı | Motora bağlı |
| Camelot | ❌ Yok | ❌ Hayır | N/A | N/A |
| pdfplumber | ❌ Yok | ❌ Hayır | N/A | N/A |
2026 itibarıyla hiçbir araç el yazısını tüm durumlarda güvenilir biçimde işleyemez. AWS Textract kurumsal API’ler arasında en yakınıdır, fakat el yazısı hâlâ “dikkatli kullanın” kategorisindedir. PDF’leriniz taranmış ama yazılıysa, yerleşik OCR olan herhangi bir araç işinizi görür. El yazısıysa, beklentileri gerçekçi tutun.
AI Destekli, Kural Tabanlı ve Şablon Tabanlı: PDF Scraping’in Üç Nesli
2026’daki PDF scraper pazarını anlamanın en kolay yolu onu üç nesil halinde düşünmektir:
1. Nesil: Kural tabanlı (Tabula, Camelot, pdfplumber)
Bunlar, düzeni tutarlı, yapılandırılmış ve metin tabanlı PDF’lerde en iyi sonucu verir. Geliştiricilerin elinde güçlüdürler, ancak düzen değiştiğinde kırılgan hale gelirler. Belgeleriniz öngörülebilirse hâlâ mükemmeldirler — ve ücretsizdirler.
2. Nesil: Şablon tabanlı (Parseur, Docparser, Parsio)
Kullanıcılar, belge türü başına bölge veya alan tanımlar. Aynı tedarikçiden gelen faturalar gibi tekrarlayan formatlar için harikadır. Ancak yeni bir düzen ya da düzen kayması olduğunda kurulum veya bakım gerekir.
3. Nesil: AI/LLM destekli (Thunderbit, Nanonets, AWS Textract, LLM akışları için Docling)
AI belgeyi anlamsal olarak okur, şablona gerek duymadan yeni düzenlere uyum sağlar ve veriyi aynı anda etiketleyip dönüştürebilir. Pazarın yöneldiği yer burasıdır. Everest Group’un 2025 IDP değerlendirmesi ve ACL 2025 çok modlu tablo araştırması da LLM ve ajan tabanlı çıkarımın yeni standart olacağına işaret ediyor.
Teknik olmayan kullanıcılar için bunun pratik anlamı şudur: PDF’leriniz birçok farklı kaynaktan geliyorsa (tedarikçiler, iş ortakları, müşteriler), şablon tabanlı araçlar bakım yüküne dönüşür. AI destekli araçlar çeşitliliği kutudan çıktığı haliyle yönetir. Thunderbit’in hedeflendiği niş tam da budur — farklı PDF’lerle çalışan ve Python yazmak ya da çıkarım şablonlarını yönetmek istemeyen iş kullanıcıları.
Farklı düzenler için AI PDF scraping Tek bir şema her tedarikçiye uymak zorunda değil — AI her belgeyi okuyup yapısını kendi çıkarır. Get Started Free
Fiyatlandırma Dökümü: En İyi PDF Scraper’lar Gerçekte Ne Kadar Tutar?
Bu, başka kimsenin yayınlamadığı ve kullanıcıların en çok sorduğu karşılaştırma. İşin dürüst tarafı şöyle:
| Araç | Ücretsiz Katman | Başlangıç Ücretli Fiyat | Tahmini 1.000 Sayfa Maliyeti | Açık Kaynak mı? |
|---|---|---|---|---|
| Thunderbit | ✅ Ücretsiz kredi | ~$15/ay (yıllık ~$9/ay) | ~$18–$30 | Hayır |
| Tabula | ✅ Sınırsız | Sonsuza kadar ücretsiz | $0 | Evet |
| Camelot | ✅ Sınırsız | Sonsuza kadar ücretsiz | $0 | Evet |
| PyMuPDF | ✅ Sınırsız | Sonsuza kadar ücretsiz | $0 | Evet |
| pdfplumber | ✅ Sınırsız | Sonsuza kadar ücretsiz | $0 | Evet |
| Docling | ✅ Sınırsız | Sonsuza kadar ücretsiz | $0 | Evet |
| Parseur | ⚠️ Ayda ~20 sayfa | ~$39/ay | ~$390 (en düşük kademe) | Hayır |
| Nanonets | ⚠️ Kayıtta kredi | Kullanım bazlı | ~$300–$380 | Hayır |
| Docparser | ⚠️ 14 günlük deneme | $39/ay | ~$78–$390 | Hayır |
| Parsio | ⚠️ 30 kredi | $41/ay | ~$41–$205 | Hayır |
| Adobe Acrobat | ❌ (dışa aktarma ücretli) | Pro için $19,99/ay | Sayfa bazlı değil | Hayır |
| AWS Textract | ⚠️ Ayda 1.000 sayfa (3 ay) | Kullandıkça öde | $1,50–$65 | Hayır |
Gizli maliyet farkı, etiket fiyatından daha önemlidir. Açık kaynak Python araçları dolar olarak ücretsizdir, ancak kurulum, bakım ve hata ayıklama için geliştirici zamanı ister. Şablon tabanlı SaaS araçları düşük çeşitlilikte kolaydır, fakat düzenler değiştikçe pahalılaşır. Thunderbit gibi AI kodsuz araçlar satır başına kredi tüketir, ama kurulum süresini ciddi biçimde azaltır. AWS Textract gibi bulut API’leri ise ölçekte en ucuz seçenektir — ancak yalnızca arka planda zaten bir mühendislik yapınız varsa.
“Gerçek maliyet”i düşünürken işi yapan kişinin maaşını da hesaba katarım. Bir veri analistinin şablon kurmak ya da Python yazmak için harcadığı bir saat, yazılım ücretsiz olsa bile ücretsiz değildir.
Hangi PDF Scraper’ı Seçmelisiniz?
İşte kısa bir karar rehberi:
| Durumunuz | Önerilen Araç(lar) |
|---|---|
| Teknik olmayan kullanıcı, farklı PDF düzenleri, hızlı sonuç istiyor | Thunderbit, Nanonets |
| Aynı formatta tekrarlayan faturalar/makbuzlar | Parseur, Docparser, Parsio |
| Veri pipeline’ı geliştiren bir geliştirici | PyMuPDF, Camelot, pdfplumber |
| Kurumsal yapı, ayda 10.000+ belge, API gerekiyor | AWS Textract, Nanonets |
| LLM/RAG uygulaması geliştiriyorsunuz | Docling |
| Ara sıra PDF’den Excel’e dönüşüm, Adobe zaten var | Adobe Acrobat |
| Ücretsiz, yerel, tablo odaklı, kodsuz | Tabula |
Eğer amacınız yalnızca PDF’lerden kod yazmadan ya da şablon kurmadan veri almaksa, Thunderbit ile başlayın. Her PDF’yi AI ile yeniden okur ve veriyi zaten kullandığınız araçlara aktarır. Belgeleriniz tanınabilir düzenlerde tekrar ediyorsa, Parseur veya Docparser daha uygun olabilir. Mühendislik kontrolü istiyorsanız, açık kaynak yığını hâlâ en düşük maliyet çizgisidir.
Sonuç
2026’da PDF scraping artık tek bir sorunun tek bir cevabı değil. Doğru araç; geliştirici, iş analisti veya kurumsal ekip olmanıza ve PDF’lerinizin düzenli metin dosyaları mı yoksa bir düzine tedarikçiden gelen kaotik taranmış görseller mi olduğuna bağlı.
AI destekli PDF çıkarımının pratikte nasıl göründüğünü görmek istiyorsanız, Thunderbit’in ücretsiz katmanını deneyin. Birkaç tıklamayla PDF’den ne kadar veri çıkarabildiğinize şaşıracağınızı düşünüyorum. Thunderbit tam uymazsa, listedeki diğer araçlardan birkaçını da deneyin. PDF’lerdeki veriyi kopyalayıp yapıştırmayı bırakıp içindeki veriyi gerçekten kullanmaya başlamak için hiç bu kadar iyi bir zaman olmamıştı.
Veri çıkarma ve otomasyon hakkında daha fazla bilgi için web sitelerinden Excel’e veri çıkarma, en iyi veri çıkarma araçları, işletmeler için AI veri çıkarımı ve görselleri Excel’e dönüştürme rehberlerimize göz atın. Ayrıca Thunderbit YouTube Kanalı üzerinden adım adım anlatımları da izleyebilirsiniz.
Thunderbit’i ücretsiz deneyin Tablolar, OCR ve karışık formatlı raporlar tek geçişte. Ücretsiz plan, belgelerinizle uyumlu olup olmadığını test etmek için yeterlidir. Get Started Free
SSS
1. En iyi ücretsiz PDF scraper hangisi?
Teknik olmayan kullanıcılar için Tabula, metin tabanlı PDF tabloları için en basit tamamen ücretsiz GUI aracıdır. Geliştiriciler için Camelot, pdfplumber, PyMuPDF ve Docling güçlü ücretsiz seçeneklerdir. Kodsuz ve ücretsiz katmanı olan bir seçenek arıyorsanız, Thunderbit en iyi başlangıç noktasıdır.
2. PDF scraper’lar taranmış belgeleri işleyebilir mi?
Yalnızca yerleşik OCR’a sahip araçlar taranmış PDF’leri doğrudan işleyebilir. Buna Thunderbit, Adobe Acrobat, AWS Textract, Nanonets, Parseur, Docparser, Parsio ve Docling (entegre OCR motorlarıyla) dahildir. Tabula, Camelot ve pdfplumber taranmış PDF’leri tek başına işleyemez; Tesseract gibi harici OCR ile birlikte kullanılmaları gerekir.
3. PDF’lerden tablo çıkarma ne kadar doğru?
Bu, büyük ölçüde tablo karmaşıklığına bağlıdır. Çoğu araç basit kenarlıklı tabloları iyi işler. Çizgisiz tablolar, birleşik hücreler ve çok sayfalı tablolar çok daha zordur. Thunderbit, Nanonets ve AWS Textract gibi AI destekli araçlar, farklı düzenlerde kural tabanlı ayrıştırıcılardan genellikle daha iyi performans gösterir; buna karşın kural tabanlı araçlar istikrarlı, metin tabanlı PDF’lerde hâlâ çok başarılı olabilir.
4. PDF taramak için kod bilmem gerekir mi?
Hayır. Thunderbit, Parseur, Docparser, Parsio, Nanonets ve Adobe Acrobat kod yazmadan kullanılabilir. Tabula’nın da bir GUI’si vardır. PyMuPDF, Camelot, pdfplumber ve Docling gibi Python kütüphaneleri kod gerektirir.
5. PDF verisini doğrudan Excel veya Google Sheets’e aktarabilir miyim?
Çoğu araç en azından CSV veya Excel’e dışa aktarmayı destekler. Thunderbit ayrıca Google Sheets, Airtable ve Notion’a doğrudan ücretsiz aktarım sağlar. Parseur, Docparser ve Parsio; Zapier, webhook ve API gibi entegrasyonlar aracılığıyla veriyi iş akışlarına aktarabilir.
Thunderbit ile AI PDF scraping’i deneyin Get Started Free
Daha Fazla Bilgi



