
Bozuk bağlantılar. Sahipsiz sayfalar. 2019’dan kalma bir “test” sayfası ve Google’ın bir şekilde bunu dizine eklemiş olması. Bir web sitesi yönetiyorsanız, bu dertlerin ne kadar can sıkıcı olduğunu çok iyi bilirsiniz.
İyi bir website crawler bunların hepsini yakalar — ve sitenizin tamamını haritalandırır, böylece sorunları gerçekten çözebilirsiniz. Ama çoğu kişi “web crawler” ile “web scraper” kavramlarını birbirine karıştırıyor. Aynı şey değiller.
10 ücretsiz crawler’ı gerçek sitelerde test ettim. Kimisi SEO denetimleri için çok iyi. Kimisi ise veri çekme işinde daha güçlü. İşe yarayanları ve yaramayanları burada paylaşıyorum.
Website Crawler Nedir? Temelleri Anlayalım
Önce bir şeyi netleştirelim: bir website crawler, bir web scraper ile aynı şey değildir. Biliyorum, bu terimler sürekli birbirinin yerine kullanılıyor; ama aslında farklılar. Crawler’ı sitenizin haritacısı gibi düşün: her köşeyi bucayı dolaşır, tüm bağlantıları takip eder ve sayfalarınızın tam bir haritasını çıkarır. Onun işi keşiftir: URL’leri bulmak, site yapısını ortaya çıkarmak ve içerikleri dizine uygun biçimde taramak. Google gibi arama motorlarının botlarla yaptığı şey de budur; SEO araçları da sitenizin sağlığını kontrol etmek için bunu kullanır (Thunderbit Blog: Web Crawler Nedir?).
Öte yandan bir web scraper, veri toplama ustasıdır. Onun derdi tüm harita değil; asıl amacı altın değerinde verileri çekmektir: ürün fiyatları, şirket adları, yorumlar, e-postalar, aklına ne gelirse. Scraper’lar, crawler’ın bulduğu sayfalardan belirli alanları alır (Thunderbit Blog: Bir Site Nasıl Web Crawl Edilir?).
Bir benzetme yapalım:
- Crawler: Marketin tüm raflarını gezen, her ürünün envanterini çıkaran kişi.
- Scraper: Doğrudan kahve rafına gidip her organik karışımın fiyatını not eden kişi.
Neden önemli? Çünkü sitenizdeki tüm sayfaları bulmak istiyorsanız (mesela bir SEO denetimi için) bir crawler’a ihtiyacınız var. Rakibinizin sitesindeki tüm ürün fiyatlarını çekmek istiyorsanız bir scraper’a — ya da ideal olarak ikisini de yapabilen bir araca.
Neden Online Bir Web Crawler Kullanmalısınız? Başlıca İş Faydaları
Peki neden bir web crawler kullanmaya uğraşasınız? Çünkü web küçülmüyor. Hatta kurumsal markaların %54’ünden fazlası özel crawling platformları kullanıyor sitelerini optimize etmek için ve bazı SEO araçları günde 7 milyar sayfayı tarıyor.
Crawler’ların sizin için yapabilecekleri:
- SEO Denetimleri: Kırık bağlantıları, eksik başlıkları, yinelenen içerikleri, sahipsiz sayfaları ve daha fazlasını bulun (SEO.ai).
- Bağlantı Kontrolü ve QA: Kullanıcılarınız fark etmeden önce 404 hatalarını ve yönlendirme döngülerini yakalayın (Screaming Frog).
- Site Haritası Oluşturma: Arama motorları ve planlama için XML site haritalarını otomatik üretin (PowerMapper).
- İçerik Envanteri: Tüm sayfalarınızın listesini, hiyerarşisini ve meta verilerini çıkarın.
- Uyumluluk ve Erişilebilirlik: Her sayfayı WCAG, SEO ve yasal uygunluk açısından kontrol edin (SiteOne Crawler).
- Performans ve Güvenlik: Yavaş sayfaları, büyük boyutlu görselleri veya güvenlik sorunlarını tespit edin (SiteOne Crawler).
- AI ve Analiz İçin Veri: Taranan verileri analiz araçlarına veya AI çözümlerine aktarın (Thunderbit Blog: Crawl4AI İncelemesi).
İş kullanım alanlarını rollerle eşleyen hızlı bir tablo:
| Kullanım Alanı | Kimler İçin İdeal | Fayda / Sonuç |
|---|---|---|
| SEO ve Site Denetimi | Pazarlama, SEO, küçük işletme sahipleri | Teknik sorunları bulun, yapıyı optimize edin, sıralamaları iyileştirin |
| İçerik Envanteri ve QA | İçerik yöneticileri, web yöneticileri | İçeriği denetleyin ya da taşıyın, kırık bağlantıları/görselleri yakalayın |
| Lead Oluşturma (Scraping) | Satış, iş geliştirme | Potansiyel müşteri bulmayı otomatikleştirin, CRM’i yeni lead’lerle doldurun |
| Rekabet Analizi | E-ticaret, ürün yöneticileri | Rakip fiyatlarını, yeni ürünleri, stok değişimlerini takip edin |
| Site Haritası ve Yapı Klonlama | Geliştiriciler, DevOps, danışmanlar | Yeniden tasarım veya yedekleme için site yapısını kopyalayın |
| İçerik Toplama | Araştırmacılar, medya, analistler | Analiz veya trend takibi için birden fazla siteden veri toplayın |
| Pazar Araştırması | Analistler, AI eğitim ekipleri | Analiz veya AI model eğitimi için büyük veri kümeleri toplayın |
(Thunderbit Blog: Bir Site Nasıl Web Crawl Edilir?)
En İyi Ücretsiz Website Crawler Araçlarını Nasıl Seçtik?
Crawler araçlarını kurcalarken, dokümantasyon okurken ve test crawl’ları çalıştırırken epey gece geçirdim — itiraf edeyim, yanında da bolca kahve tükettim. Şunlara baktım:
- Teknik Yetkinlik: Modern siteleri (JavaScript, giriş gerektiren yapılar, dinamik içerik) tarayabiliyor mu?
- Kullanım Kolaylığı: Teknik olmayan kullanıcılar için uygun mu, yoksa komut satırı sihirbazlığı mı gerekiyor?
- Ücretsiz Plan Sınırları: Gerçekten ücretsiz mi, yoksa sadece deneme amaçlı mı?
- Online Erişilebilirlik: Bulut aracı mı, masaüstü uygulaması mı, yoksa kod kütüphanesi mi?
- Özel Özellikler: AI çıkarımı, görsel site haritaları ya da olay tabanlı crawling gibi farklı bir şey sunuyor mu?
Her aracı test ettim, kullanıcı geri bildirimlerini inceledim ve özellikleri yan yana karşılaştırdım. Eğer bir araç beni laptop’ı pencereden atma noktasına getirdiyse, listeye girmedi.
Hızlı Karşılaştırma Tablosu: Bir Bakışta 10 En İyi Ücretsiz Website Crawler
| Araç ve Türü | Temel Özellikler | En Uygun Kullanım | Teknik Gereksinim | Ücretsiz Plan Detayları |
|---|---|---|---|---|
| Bright Data (Cloud/API) | Kurumsal crawling, proxy’ler, JS render, CAPTCHA çözme | Büyük ölçekli veri toplama | Bir miktar teknik bilgi faydalı | Ücretsiz katman: Web Scraper API’de ayda 5.000 kayıt, kredi kartı gerekmez |
| Crawlbase (Cloud/API) | API ile crawling, anti-bot, proxy’ler, JS render | Arka uç crawl altyapısına ihtiyaç duyan geliştiriciler | API entegrasyonu | Ücretsiz: Başlangıç için 20.000 isteğe kadar, kredi kartı gerekmez; sonrasında istek başı ücretlendirme |
| ScraperAPI (Cloud/API) | Proxy rotasyonu, JS render, asenkron crawl, hazır endpoint’ler | Geliştiriciler, fiyat takibi, SEO verisi | Minimum kurulum | Ücretsiz: İlk 7 gün 5.000 API çağrısı, ardından aylık 1.000 |
| Diffbot Crawlbot (Cloud) | AI ile crawl + veri çıkarımı, bilgi grafiği, JS render | Ölçekli yapılandırılmış veri, AI/ML | API entegrasyonu | Ücretsiz: Extract, Natural Language, Knowledge Graph ve Search için aylık 10.000 kredi; Crawl için Plus plan gerekir |
| Screaming Frog (Masaüstü) | SEO denetimi, bağlantı/meta analizi, site haritası, özel çıkarım | SEO denetimleri, site yöneticileri | Masaüstü uygulaması, GUI | Ücretsiz: Tarama başına 500 URL, yalnızca temel özellikler |
| SiteOne Crawler (Masaüstü) | SEO, performans, erişilebilirlik, güvenlik, çevrimdışı dışa aktarma, Markdown | Geliştiriciler, QA, göç, dokümantasyon | Masaüstü/CLI, GUI | Ücretsiz ve açık kaynak, GUI raporunda 1.000 URL (ayarlanabilir) |
| Crawljax (Java, Açık Kaynak) | JavaScript ağırlıklı siteler için olay tabanlı crawl, statik dışa aktarma | Geliştiriciler, dinamik web uygulamaları için QA | Java, CLI/konfigürasyon | Ücretsiz ve açık kaynak, limit yok |
| Apache Nutch (Java, Açık Kaynak) | Dağıtık yapı, eklenti tabanlı mimari, Hadoop entegrasyonu, özel arama | Özel arama motorları, büyük ölçekli crawl | Java, komut satırı | Ücretsiz ve açık kaynak, yalnızca altyapı maliyeti |
| YaCy (Java, Açık Kaynak) | Eşler arası crawl ve arama, gizlilik, web/intranet indeksleme | Özel arama, merkeziyetsizlik | Java, tarayıcı arayüzü | Ücretsiz ve açık kaynak, limit yok |
| PowerMapper (Masaüstü/SaaS) | Görsel site haritaları, erişilebilirlik, QA, tarayıcı uyumluluğu | Ajanslar, QA, görsel haritalama | GUI, kolay | Ücretsiz deneme: 30 gün, tarama başına 100 sayfa (masaüstü) veya 10 sayfa (online) |
Devam etmeden önce küçük bir not: Son sütundaki “ücretsiz” birkaç farklı anlama geliyor. SiteOne, Crawljax, Nutch ve YaCy açık kaynak; yani kendi donanımınız dışında bir üst sınır yok. Screaming Frog sonsuza kadar ücretsiz, ama tarama başına 500 URL ile sınırlı. Bright Data, ScraperAPI ve Diffbot gerçekten var olan ama küçük tutulan ücretsiz katmanlar sunuyor; Diffbot’ta crawler kısmı ücretsiz plana dahil değil. Crawlbase size baştan bir blok ücretsiz istek veriyor, sonra istek başı ücret alıyor. PowerMapper ise listedeki tek saf deneme sürümü; 30 gün bitince ödeme yapmanız gerekiyor.
Bright Data: Kurumsal Seviyede Cloud Website Crawler
Bright Data, web crawling dünyasının “ağır topu”dur. Devasa bir proxy ağı, JavaScript render, CAPTCHA çözme ve özel crawl’lar için bir IDE sunan bir bulut platformudur. Yüzlerce e-ticaret sitesinin fiyatlarını izlemek gibi büyük ölçekli veri toplama işleriniz varsa, Bright Data’nın altyapısını geçmek zor (aimultiple.com).
Güçlü Yanları:
- Anti-bot önlemleri olan zor siteleri yönetir
- Kurumsal ihtiyaçlar için ölçeklenebilir
- Sık kullanılan siteler için hazır şablonlar sunar
Sınırlamalar:
- Ücretsiz katman gerçek ama küçük: Web Scraper API’de ayda 5.000 kayıt
- Basit denetimler için gereğinden fazla olabilir
- Teknik olmayan kullanıcılar için öğrenme eğrisi vardır
Web’i büyük ölçekte crawl etmeniz gerekiyorsa, Bright Data Formula 1 arabası kiralamak gibidir. Aylık 5.000 kayıtlık ücretsiz kota, aracı sokağın başında bir tur attırmanıza yeter; sonrası kullanıma göre ücretlenir (Bright Data Pricing).
Crawlbase: Geliştiriciler İçin API Odaklı Ücretsiz Web Crawler
Crawlbase (eski adıyla ProxyCrawl) tamamen programatik crawling üzerine kurulu. Bir URL ile API’lerini çağırırsınız, onlar da arka planda proxy, coğrafi hedefleme ve CAPTCHA’larla uğraşarak HTML’i size döndürür (Capterra).
Güçlü Yanları:
- Yüksek başarı oranı (%99+)
- JavaScript ağırlıklı siteleri yönetir
- Kendi uygulamalarınıza veya iş akışlarınıza entegre etmek için idealdir
Sınırlamalar:
- Bir miktar API veya SDK entegrasyonu gerekir
- Ücretsiz plan: başlangıç için 20.000 isteğe kadar (kredi kartı gerekmez), ardından istek başı ücretlendirme
Eğer proxy yönetmeden ölçekli crawl yapmak isteyen bir geliştiriciyseniz, Crawlbase sağlam bir seçenektir (Crawlbase Pricing).
ScraperAPI: Dinamik Web Crawling’i Kolaylaştırıyor
ScraperAPI, “bunu benim için çekiver” türü bir API’dir. Siz URL’yi verirsiniz, o proxy’leri, headless browser’ları ve anti-bot önlemlerini yönetir; size HTML’i (veya bazı sitelerde yapılandırılmış veriyi) teslim eder. Özellikle dinamik sayfalar için iyidir; ancak ücretsiz kısmı sınırlıdır: ilk 7 gün için 5.000 API kredisi, kart gerekmez; ardından devam eden ücretsiz planda ayda 1.000 kredi (ScraperAPI Pricing).
Güçlü Yanları:
- Geliştiriciler için son derece kolaydır (sadece bir API çağrısı)
- CAPTCHA, IP engelleri, JavaScript sorunlarını aşar
- Ücretsiz: 7 gün 5.000 API çağrısı, ardından ayda 1.000
Sınırlamalar:
- Görsel crawl raporu yok
- Bağlantıları takip etmek istiyorsanız crawl mantığını sizin yazmanız gerekir
Web crawling’i dakikalar içinde kod tabanınıza eklemek istiyorsanız, ScraperAPI çok mantıklı bir tercih.
Diffbot Crawlbot: Otomatik Website Yapısı Keşfi
Diffbot Crawlbot işlerin akıllandığı noktadır. Sadece crawl etmez; sayfaları AI ile sınıflandırır ve yapılandırılmış veriyi (makaleler, ürünler, etkinlikler vb.) JSON olarak çıkarır. Okuduğunu gerçekten anlayan bir robot stajyeriniz varmış gibi düşünebilirsiniz (Diffbot Free Plan).
Güçlü Yanları:
- Sadece crawling değil, AI destekli çıkarım
- JavaScript ve dinamik içeriği yönetir
- Ücretsiz: ayda 10.000 kredi, kredi kartı gerekmez; Extract, Natural Language, Knowledge Graph ve Search kapsam dahilinde
Sınırlamalar:
- Geliştirici odaklıdır (API entegrasyonu)
- Görsel bir SEO aracı değildir — daha çok veri projeleri içindir
- Tüm siteyi tarayan Crawlbot kısmı Plus plan ve üzerindedir; ücretsiz krediler çıkarım API’lerini kapsar (Diffbot Pricing)
Özellikle AI veya analitik için ölçekli yapılandırılmış veriye ihtiyacınız varsa, Diffbot oldukça güçlüdür.
Screaming Frog: Ücretsiz Masaüstü SEO Crawler’ı
Screaming Frog, SEO denetimleri için klasik masaüstü crawler’dır. Ücretsiz sürümde tarama başına 500 URL’ye kadar çıkar ve kırık bağlantılar, meta etiketleri, yinelenen içerik, site haritaları ve daha fazlasını sunar (Screaming Frog User Guide).
Güçlü Yanları:
- Hızlı, kapsamlı ve SEO dünyasında güvenilir
- Kod gerekmez — URL’yi girin, başlayın
- Tarama başına 500 URL’ye kadar ücretsiz
Sınırlamalar:
- Sadece masaüstünde çalışır (bulut sürümü yok)
- Gelişmiş özellikler (JS render, zamanlama) ücretli lisans ister
SEO konusunda ciddiseniz, Screaming Frog olmazsa olmazlardan biridir — ama 10.000 sayfalık sitenizi ücretsiz tarayacağını da beklemeyin.
SiteOne Crawler: Statik Site Dışa Aktarımı ve Dokümantasyon
SiteOne Crawler, teknik denetimler için çok yönlü bir araçtır. Açık kaynaklıdır, platformlar arası çalışır ve sitenizi tarayıp denetlemenin yanında dokümantasyon ya da çevrimdışı kullanım için Markdown formatına da dışa aktarabilir (SiteOne Crawler).
Güçlü Yanları:
- SEO, performans, erişilebilirlik ve güvenlik kontrollerini kapsar
- Siteleri arşivleme veya taşıma için dışa aktarabilir
- Ücretsiz ve açık kaynak; kullanım limiti yok
Sınırlamalar:
- Bazı GUI araçlarına göre daha teknik
- GUI raporu varsayılan olarak 1.000 URL ile sınırlı (ayarlanabilir)
Derin analiz isteyen ve açık kaynak seven bir geliştirici, QA uzmanı veya danışmansanız, SiteOne gizli bir cevherdir.
Crawljax: Dinamik Sayfalar İçin Açık Kaynak Java Web Crawler’ı
Crawljax bir uzman araçtır: Kullanıcı etkileşimlerini (tıklamalar, form doldurma vb.) simüle ederek modern, JavaScript ağırlıklı web uygulamalarını crawl etmek için tasarlanmıştır. Olay tabanlı çalışır ve dinamik bir sitenin statik bir versiyonunu bile üretebilir (Wikipedia: Crawljax).
Güçlü Yanları:
- SPA’lar ve AJAX ağırlıklı siteler için rakipsizdir
- Açık kaynak ve genişletilebilir
- Kullanım sınırı yok
Sınırlamalar:
- Java ve biraz programlama/konfigürasyon gerekir
- Teknik olmayan kullanıcılar için uygun değildir
Eğer bir React veya Angular uygulamasını gerçek bir kullanıcı gibi crawl etmeniz gerekiyorsa, Crawljax sizin dostunuzdur.
Apache Nutch: Ölçeklenebilir Dağıtık Website Crawler’ı
Apache Nutch, açık kaynak crawler’ların büyük dedesidir. Devasa, dağıtık crawling için tasarlanmıştır — kendi arama motorunuzu kurmak veya milyonlarca sayfayı dizine almak gibi işleri düşünün (Martechvibe).
Güçlü Yanları:
- Hadoop ile milyarlarca sayfaya ölçeklenebilir
- Son derece özelleştirilebilir ve genişletilebilir
- Ücretsiz ve açık kaynak
Sınırlamalar:
- Öğrenme eğrisi dik (Java, komut satırı, konfigürasyonlar)
- Küçük siteler veya sıradan kullanıcılar için uygun değildir
Web’i büyük ölçekte crawl etmek istiyor ve biraz komut satırı kullanmaktan çekinmiyorsanız, Nutch tam size göre.
YaCy: Eşler Arası Web Crawler ve Arama Motoru
YaCy benzersiz, merkeziyetsiz bir crawler ve arama motorudur. Her kurulum siteleri ayrı ayrı tarar ve indeksler; isterseniz başkalarıyla indeks paylaşmak için eşler arası ağa katılabilirsiniz (TechRadar: YaCy).
Güçlü Yanları:
- Gizlilik odaklıdır, merkezi sunucu yoktur
- Özel arama veya intranet araması oluşturmak için idealdir
- Ücretsiz ve açık kaynak
Sınırlamalar:
- Sonuçlar ağ kapsamına bağlıdır
- Bir miktar kurulum gerekir (Java, tarayıcı arayüzü)
Merkeziyetsizlik ilginizi çekiyorsa ya da kendi arama motorunuzu kurmak istiyorsanız, YaCy oldukça ilginç bir seçenektir.
PowerMapper: UX ve QA İçin Görsel Site Haritası Oluşturucu
PowerMapper tamamen sitenizin yapısını görselleştirmeye odaklanır. Sitenizi crawl eder, etkileşimli site haritaları oluşturur; ayrıca erişilebilirlik, tarayıcı uyumluluğu ve temel SEO kontrollerini yapar (Slickplan Review).
Güçlü Yanları:
- Görsel site haritaları ajanslar ve tasarımcılar için çok kullanışlıdır
- Erişilebilirlik ve uyumluluk kontrolleri yapar
- Kolay GUI, teknik bilgi gerektirmez
Sınırlamalar:
- Sadece deneme sürümü var (30 gün, tarama başına masaüstünde 100 sayfa / çevrimiçinde 10 sayfa)
- Tam sürüm ücretlidir
Müşterilere bir site haritası sunmanız veya uyumluluk kontrolü yapmanız gerekiyorsa, PowerMapper kullanışlı bir araçtır.
İhtiyacınıza Göre Doğru Ücretsiz Web Crawler’ı Seçmek
Bu kadar seçenek varken hangisini seçmelisin? Kısa rehberim şöyle:
- SEO denetimleri için: Screaming Frog (küçük siteler), PowerMapper (görsel), SiteOne (derin denetimler)
- Dinamik web uygulamaları için: Crawljax
- Büyük ölçekli veya özel arama için: Apache Nutch, YaCy
- API erişimine ihtiyaç duyan geliştiriciler için: Crawlbase, ScraperAPI, Diffbot
- Dokümantasyon veya arşivleme için: SiteOne Crawler
- Küçük bir sürekli ücretsiz katmanla kurumsal ölçek için: Bright Data, Diffbot
Dikkat edilmesi gereken temel faktörler:
- Ölçeklenebilirlik: Siten veya crawl işin ne kadar büyük?
- Kullanım kolaylığı: Koda hâkim misin, yoksa tıkla-çalıştır mı istiyorsun?
- Veri dışa aktarma: CSV, JSON veya başka araçlarla entegrasyon gerekiyor mu?
- Destek: Takıldığında yardım alabileceğin bir topluluk ya da dokümantasyon var mı?
Web Crawling ile Web Scraping Buluştuğunda: Neden Thunderbit Daha Akıllı Bir Seçim?
AI kullanarak herhangi bir web sitesinden veri çekin Thunderbit'in agentic web scraper'ı, crawl etmeniz gereken herhangi bir web sitesini okur ve yapılandırılmış veriyi tek tıkla çıkarır — ayda 6 sayfaya kadar ücretsiz. Get Started Free
Gerçek şu: çoğu insan web sitelerini sadece güzel haritalar çıkarmak için crawl etmez. Asıl amaç genellikle yapılandırılmış veri elde etmektir — ürün listeleri, iletişim bilgileri veya içerik envanteri gibi. İşte Thunderbit burada devreye girer.
Thunderbit yalnızca bir crawler ya da scraper değildir — ikisini birleştiren AI destekli bir Chrome eklentisidir. Nasıl çalıştığına bakalım:
- AI Crawler: Thunderbit, tıpkı bir crawler gibi siteyi keşfeder.
- Waterfall Crawling: Thunderbit’in kendi motoru bir sayfaya ulaşamazsa (örneğin sert bir anti-bot engeline takılırsa), otomatik olarak üçüncü taraf crawling servislerine geçer — manuel kurulum gerekmez.
- AI Veri Yapılandırma: HTML elde edildikten sonra Thunderbit’in AI’sı doğru sütunları önerir ve yapılandırılmış veriyi (isimler, fiyatlar, e-postalar vb.) sen tek bir selector bile yazmadan çıkarır.
- Alt Sayfa Scraping: Her ürün sayfasından ayrıntı mı gerekiyor? Thunderbit her alt sayfayı otomatik ziyaret edip tablonu zenginleştirebilir.
- Veri Temizleme ve Dışa Aktarma: Veriyi tek tıkla özetleyebilir, kategorize edebilir, çevirebilir ve Excel, Google Sheets, Airtable veya Notion’a aktarabilir.
- Kodsuz Basitlik: Tarayıcı kullanabiliyorsan Thunderbit’i de kullanabilirsin. Kod yok, proxy yok, baş ağrısı yok.
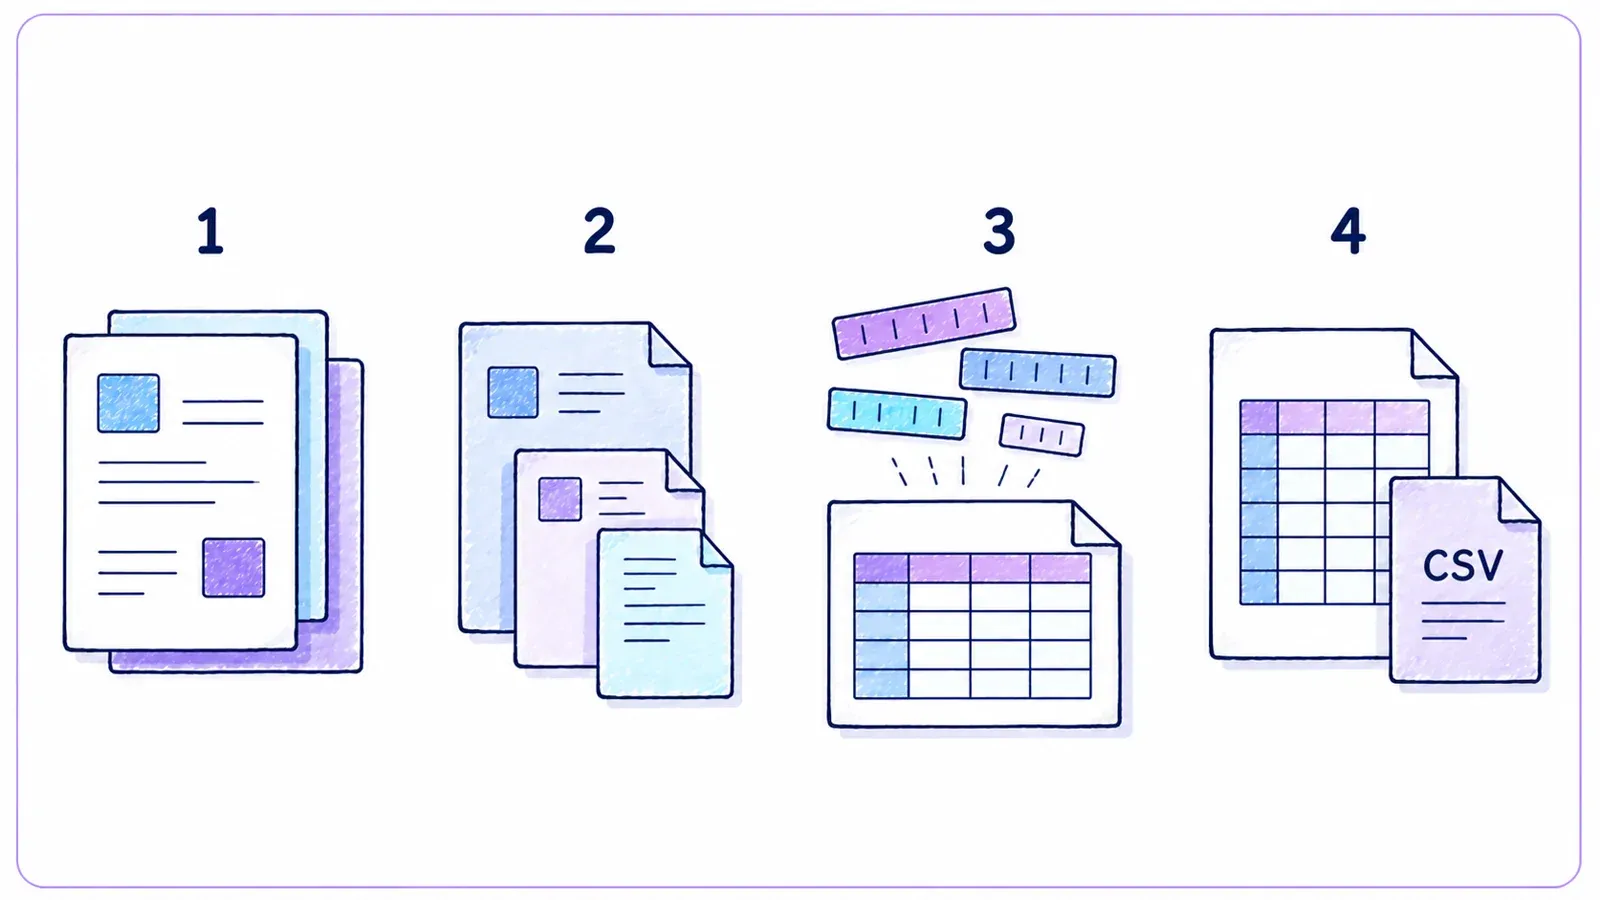
Ne zaman geleneksel bir crawler yerine Thunderbit kullanmalısın?
- Son hedefin yalnızca URL listesi değil, temiz ve kullanılabilir bir tabloysa.
- Crawl, çıkarım, temizleme ve dışa aktarma işlemlerini tek yerde otomatikleştirmek istiyorsan.
- Zamanına ve zihinsel rahatlığına değer veriyorsan.
Thunderbit Chrome eklentisini buradan indirebilirsin ve neden bu kadar çok iş kullanıcısının geçiş yaptığını kendin görebilirsin.
Thunderbit’i Ücretsiz Deneyin – Agentic Web Scraper Ücretsiz Chrome eklentisini yükleyin ve kod gerekmeden tek tıkla herhangi bir web sitesini crawl etmeye başlayın. Get Started Free
Sonuç: Ücretsiz Website Crawler’lardan En İyi Şekilde Yararlanmak
Agentic Web Scraping Nasıl Çalışır, Görün Thunderbit'in AI'sı bir sayfayı insan gibi okur ve neyi çıkaracağına karar verir; böylece manuel crawler yapılandırmasının yerini alır. Get Started Free
Website crawler’lar çok yol kat etti. İster pazarlamacı, ister geliştirici, ister sadece sitenizin sağlığını korumaya çalışan biri ol; senin için ücretsiz bir araç var — ya da en azından ücretsiz deneyebileceğin bir seçenek. Bright Data ve Diffbot gibi kurumsal platformlardan, SiteOne ve Crawljax gibi açık kaynak cevherlerine, PowerMapper gibi görsel haritalayıcılara kadar seçenekler hiç olmadığı kadar çeşitli.
Ama “bu veriye ihtiyacım var” noktasından “işte tablom” aşamasına daha akıllı ve daha entegre bir şekilde geçmek istiyorsan, Thunderbit’i dene. O, sadece rapor değil sonuç isteyen iş kullanıcıları için tasarlandı.
Hazır mısın? Bir araç indir, bir tarama başlat ve neleri kaçırdığını gör. Ve crawl etmeyi tek tıkla aksiyona dönüştürmek istiyorsan, Thunderbit’e göz at.
Daha fazla derin inceleme ve pratik rehber için Thunderbit Blog sayfasını ziyaret et.
Web Sitesi Verilerini Yapay Zekâ ile Tek Tıkla Çekin Thunderbit’i alt sayfaları takip edecek ve zamanlamayla çalışacak şekilde ayarlayın; böylece crawl veriniz manuel tekrar çalıştırmaya gerek kalmadan güncel kalır. Get Started Free
Agentic Web Scraper’ı Deneyin Get Started Free
SSS
Website crawler ile web scraper arasındaki fark nedir?
Crawler, bir sitedeki tüm sayfaları keşfeder ve haritalandırır (örneğin: içindekiler tablosu oluşturmak gibi). Scraper ise bu sayfalardan belirli veri alanlarını çıkarır (fiyatlar, e-postalar, yorumlar gibi). Crawler bulur, scraper veriyi çıkarır (Thunderbit Blog: Web Crawler Nedir?).
Teknik bilgisi olmayan kullanıcılar için en iyi ücretsiz web crawler hangisi?
Küçük siteler ve SEO denetimleri için Screaming Frog kullanıcı dostudur. Görsel haritalama için PowerMapper deneme süresi boyunca çok iyidir. Hedefin yapılandırılmış veri almaksa ve kod yazmadan, tarayıcı tabanlı bir deneyim istiyorsan Thunderbit en kolay seçenektir.
Web crawler’ları engelleyen siteler var mı?
Evet — bazı siteler crawler’ları engellemek için robots.txt dosyaları veya CAPTCHA ve IP engelleme gibi anti-bot önlemleri kullanır. ScraperAPI, Crawlbase ve Thunderbit (waterfall crawling ile) bunları çoğu zaman aşabilir; ancak her zaman sorumlu şekilde crawl et ve site kurallarına saygı göster (Bright Data Pricing).
Ücretsiz website crawler’ların sayfa veya özellik sınırı olur mu?
Çoğunda olur. Örneğin, Screaming Frog’un ücretsiz sürümü tarama başına 500 URL ile sınırlıdır; PowerMapper deneme sürümü 100 sayfa ile sınırlıdır. API tabanlı araçlarda genellikle aylık kredi limitleri vardır. SiteOne veya Crawljax gibi açık kaynak araçlarda ise çoğunlukla sert bir limit yoktur; ama donanımının sınırları geçerlidir.
Web crawler kullanmak yasal ve gizlilik açısından uygun mu?
Genellikle herkese açık web sayfalarını crawl etmek yasaldır; ancak yine de sitenin kullanım şartlarını ve robots.txt dosyasını kontrol et. Özel veya parola korumalı verilere izin olmadan asla erişme. Kişisel veri çıkarıyorsan gizlilik yasalarına da dikkat etmen gerekir (Crawlbase Guide).



