Tumblr-krämare













Lås upp Tumblr-data med Thunderbit
Extrahera enkelt Tumblr-data som inläggsinnehåll och gilla-markeringar.
Få hela Tumblr-historien
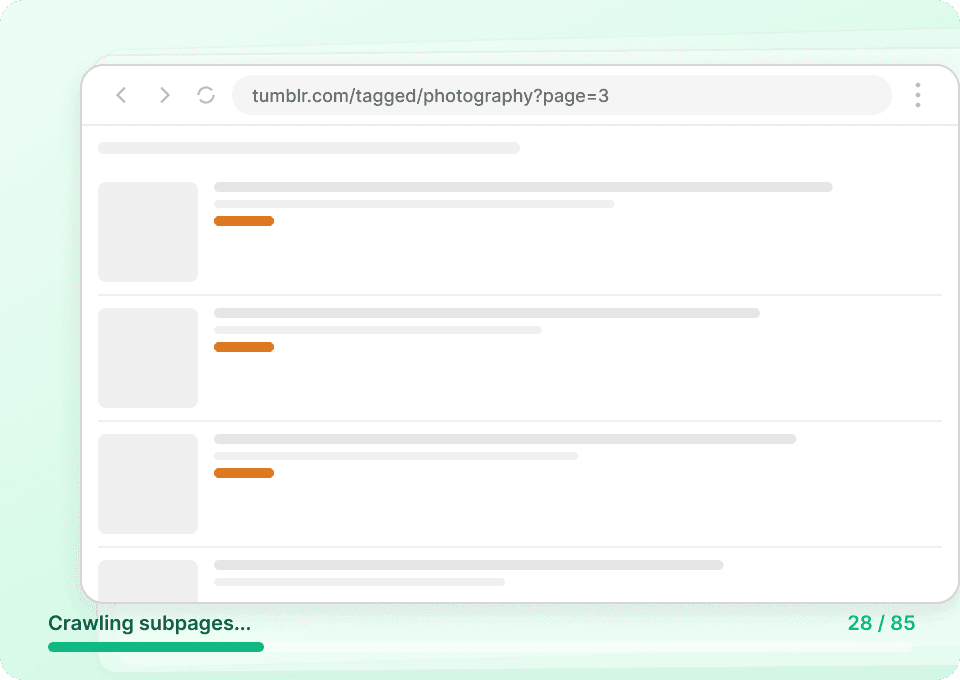
Tumblrs listningssidor visar bara utdrag. För att få hela bilden behöver du hela inläggstexten, författaruppgifter och all tillhörande metadata. Thunderbit besöker automatiskt varje länkad inläggssida, hämtar hela detaljerna och lägger till dem som nya kolumner — så att du kan fånga inläggs-ID:n, publiceringsdatum med mera utan att klicka manuellt.
Automatisera din datainsamling från Tumblr
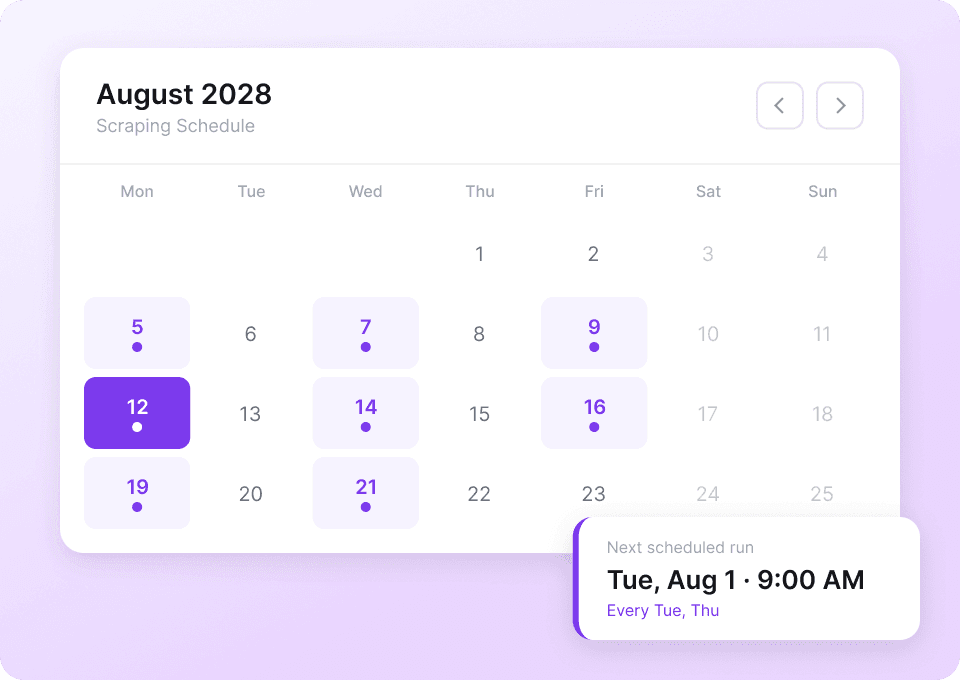
Tumblr-data förändras hela tiden. Att manuellt gå tillbaka till samma bloggar för att hämta om data är tidskrävande och riskerar fel. Med Thunderbits schemalagda scraping kan du ställa in återkommande extraheringar på autopilot. Få färska gilla-markeringar och nytt inläggsinnehåll direkt levererat till Google Sheets — helt utan manuellt arbete.
Hämta Tumblr-inlägg på två klick
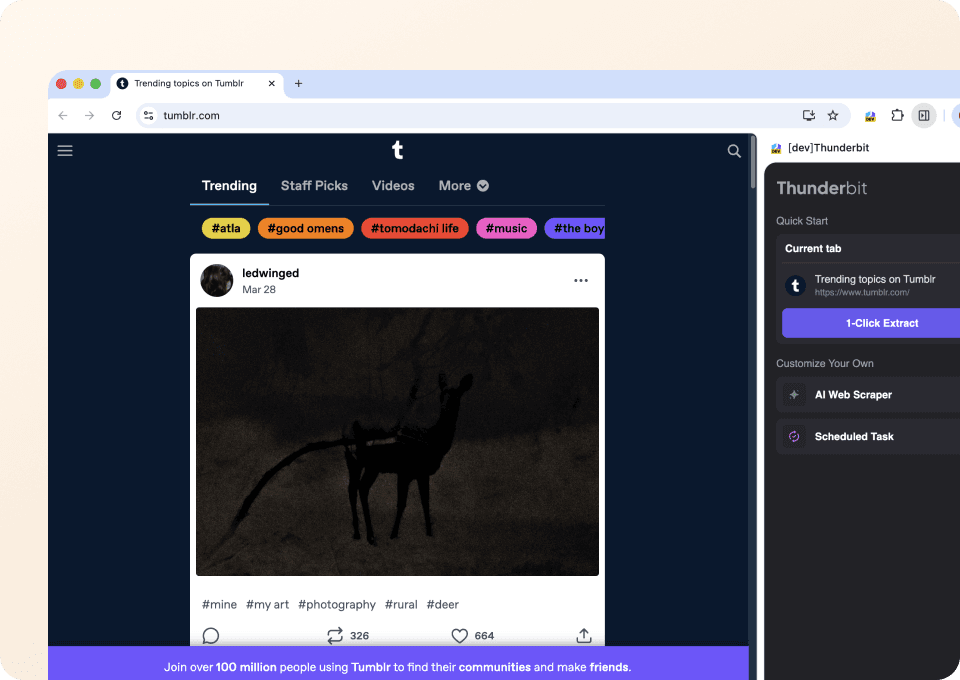
Ingen kod eller CSS-selektorer behövs. Thunderbit låter dig extrahera Tumblr-data på bara två klick. Peka helt enkelt på det du vill ha — inläggstyp, författare, innehåll, gilla-markeringar — så identifierar Thunderbits semantiska AI relevanta fält och hämtar allt automatiskt.
Varför skiljer sig Thunderbit från traditionella Tumblr scrapers?
Extrahera Tumblr-data utan krångel, även när layouter ändras eller skiftar oväntat.
Traditionella scrapers
Det gamla sättet att arbetaThunderbit AI
Det smartare sättet



Vanliga frågor
Relaterat användningsområden
Utforska fler användningsområden för Thunderbits web scraper.
Hashtag Scraper
Thunderbits Hashtag Scraper hjälper dig att samla in inläggslistor för hashtags och viktiga nyckeltal för att följa sociala trender. Använd AI för att hämta inläggs-URL:er, bildtexter, skapare, publiceringsdatum och engagemang – och exportera sedan till Excel, Google Sheets, Airtable eller Notion.
Läs mer ->
Video Scraper
Thunderbits Video Scraper gör det enkelt att hämta video- och kreatörsdata med AI på bara några klick. Skrapa videolistor, prestationsmått och profildetaljer och exportera sedan till Excel, Google Sheets, Airtable eller Notion för uppföljning och influencer-research.
Läs mer ->
9GAG Scraper
Thunderbit 9GAG Scraper låter dig extrahera data från 9GAG:s trending- och WTF-sidor. Använd AI-drivna fältförslag för att snabbt samla in inläggstitlar, länkar, likes, kommentarer, bilder och mer för analys eller innehållsresearch. Perfekt för marknadsförare, forskare och content creators som vill ha strukturerad 9GAG-data.
Läs mer ->
LinkTree Scraper
Extrahera länkarnas titlar, webbadresser och beskrivningar från valfri Linktree-profil på bara 2 klick och exportera sedan direkt till Excel, Google Sheets eller Notion – helt utan kod.
Läs mer ->
MySpace Scraper
Hämta användarnamn, bios och platser från Myspace-profiler med bara 2 klick — och exportera sedan ren, strukturerad data direkt till Excel, Google Sheets eller Notion.
Läs mer ->
Enkel Reddit-scraper
Extrahera Reddit-inlägg, författarnamn, upvotes och tråd-innehåll på 2 klick — helt utan kod. Exportera direkt till Excel, Google Sheets eller Notion för att följa trender, bevaka communities och omvandla Reddit-data till insikter du kan agera på.
Läs mer ->Redo att växla upp din dataextraktion?
Gå med över 200 000 yrkespersoner som redan använder Thunderbit för att automatisera sina arbetsflöden för web scraping.
Gratis provperiod ger obegränsade credits för 8 webbsidor.



