
Mitt första försök med webbläsarautomatisering: sen kväll, kallt kaffe och ett kalkylark fullt av produktlänkar som jag fasade för att kopiera in för hand. Det måste ju finnas ett bättre sätt.
Det gör det. Webbläsarautomatisering har gått från att vara ett nördigt utvecklartrick till ett affärskritiskt verktyg. Men webben blir bara klurigare — sidor laddar innehåll dynamiskt, gömmer data bakom knappar och kastar upp popup-fönster hela tiden.
Här är 15 verktyg för webbläsarautomatisering som jag har testat — inklusive AI-drivna scrapers som Thunderbit — anpassade för olika kunskapsnivåer och användningsområden.
Vad är webbläsarautomatisering? Lås upp kraften i webbautomatisering och web scraping
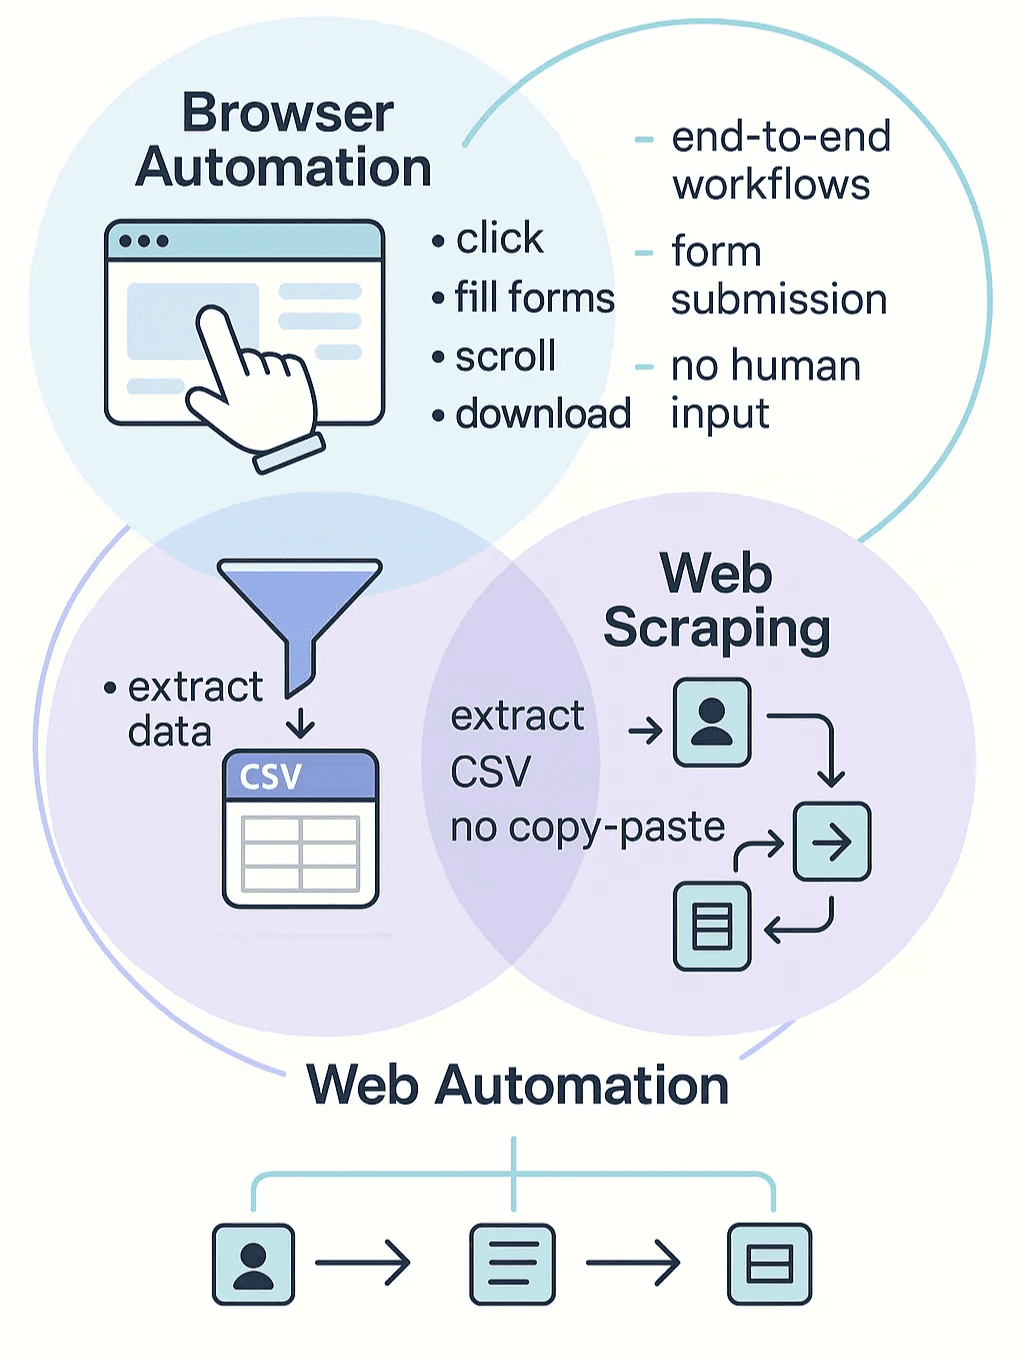
Låt oss reda ut begreppen: webbläsarautomatisering är helt enkelt programvara som efterliknar det du själv skulle göra i webbläsaren — klicka på länkar, fylla i formulär, scrolla, ladda ner filer — utan att du behöver lyfta ett finger. Tänk dig en digital assistent som outtröttligt upprepar de där webbmomenten du helst slipper göra själv (oxylabs.io Pricing).
Web scraping är en särskild form av webbläsarautomatisering som fokuserar på att hämta data från webbplatser och omvandla den till något strukturerat — som ett kalkylark eller en databas — så att du faktiskt kan använda informationen. Inget mer kopiera och klistra in. Webbautomatisering är det bredare samlingsbegreppet som omfattar båda: det handlar om att automatisera alla typer av interaktioner med webbappar, från datautvinning till formulärinlämning eller till och med hela arbetsflöden (proxidize.com Pricing).
Varför är webbläsarautomatisering så stort just nu? Dagens webbplatser är dynamiska och tunga på JavaScript. Innehåll laddas medan du scrollar, knappar visar dold information och ibland måste du logga in eller klicka dig fram för att nå datan. Gamla skrapverktyg som bara hämtar statisk HTML kommer till korta. Verktyg för webbläsarautomatisering styr faktiskt en riktig webbläsare (ibland headless — utan gränssnitt), vilket gör att de kan hantera allt detta dynamiska innehåll och simulera verkliga användaråtgärder (creative-tim.com Pricing).
Kort sagt: webbläsarautomatisering är det som gör det möjligt att extrahera data från och interagera med den moderna webben, särskilt när saker blir röriga.
Varför webbläsarautomatisering är viktig för moderna företag
Låt oss prata affärsnytta. Webbläsarautomatisering och web scraping är inte bara för tekniker — de är nu avgörande för sälj, e-handel, drift och i princip alla team som är beroende av webbdata.
Här är varför:
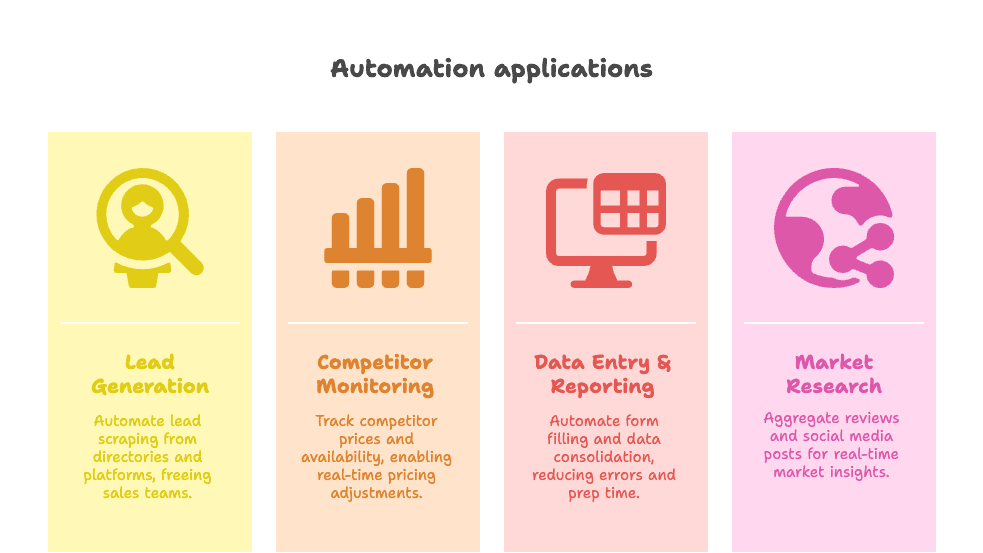
- Leadgenerering: Skrapa företagsregister, LinkedIn eller Google Maps efter nya leads medan du sover. Säljteam som använder automatisering rapporterar att de lägger 82 % mer tid på att faktiskt sälja, inte på att leta kontaktuppgifter (venasolutions.com Pricing).
- Övervakning av konkurrenter och prisbevakning: E-handelsteam använder bottar för att dagligen hålla koll på konkurrenters priser och lagerstatus, och justerar sina egna priser nästan i realtid (groupbwt.com Pricing).
- Datainmatning och rapportering: Automatisera formulär, samla data från flera källor och minska risken för mänskliga fel. Ett vårdföretag minskade manuell datainmatning med 60 % och kortade tiden för rapportförberedelser med 40 % (groupbwt.com Pricing).
- Marknadsundersökningar: Samla in recensioner, listningar eller inlägg i sociala medier för att få insikter i realtid som hade varit omöjliga att få fram manuellt.
Och siffrorna bekräftar det:
- Nästan hälften av all internettrafik består nu av bottar — och mycket av det är automatisering och scraping.
- 65 % av organisationerna använder web scraping för att driva AI- och analysprojekt.
- 30–200 % ROI under det första året är vanligt när företag investerar i digital automatisering.
Här är en snabb tabell över vanliga affärsscenarier och nyttan med webbläsarautomatisering:
| Affärsscenario | Nytta med automatisering |
|---|---|
| Leadgenerering | Bygger snabbt leadlistor och frigör säljarna till att stänga affärer |
| Prisbevakning | Realtidskoll på marknaden, dynamisk prissättning och snabb reaktion på konkurrenters förändringar |
| Datainmatning och rapportering | Tar bort tråkigt copy-paste, minskar fel och håller datan uppdaterad |
| Marknadsundersökningar och konkurrensanalys | Samlar stora datamängder för insikter och stöttar datadriven strategi |
I korthet: webbläsarautomatisering är hur moderna företag håller sig snabba, korrekta och konkurrenskraftiga.
Kategorier för webbläsarautomatisering: från AI Web Scraper till no-code-lösningar
Alla verktyg för webbläsarautomatisering är inte skapade lika. Beroende på din bakgrund och dina behov bör du välja mellan fyra huvudkategorier:
- Utvecklarverktyg: För dig som gillar att koda (tänk Selenium, Puppeteer, Playwright, Cypress). Maximal flexibilitet, men du behöver programmeringsvana.
- No-code/low-code-plattformar: Visuella byggare och inspelare (som Browserflow, Axiom.ai, UI Vision) som låter icke-tekniska användare automatisera uppgifter genom att klicka runt eller dra block.
- Enterprise-RPA-sviter: Kraftfulla plattformar (UiPath, Automation Anywhere, Microsoft Power Automate) byggda för storskalig, end-to-end-affärsautomatisering.
- AI-drivna lösningar: De nya stjärnorna på marknaden — verktyg som Thunderbit som använder AI för att "läsa" webbsidor, anpassa sig till förändringar och låta dig automatisera med bara några klick eller med enkla instruktioner på vanligt språk.
Varje kategori har sina styrkor. Utvecklare får full kontroll, affärsanvändare får fart och enkelhet, och AI-drivna verktyg bygger broar mellan dem — så att avancerad automatisering blir tillgänglig för alla.
Thunderbit: AI Web Scraper för alla
Extrahera data från vilken webbplats som helst med AI Get Started Free
Jag ska vara ärlig: jag är partisk, men det finns en bra anledning. Thunderbit är verktyget jag önskar att jag hade haft för flera år sedan. Det är ett AI-drivet Chrome-tillägg som låter vem som helst — ja, även om du inte kan ett dugg kod — hämta strukturerad data från vilken webbplats som helst på bara två klick.
Därför sticker Thunderbit ut:
- AI Suggest Fields: Klicka bara på "AI Suggest Fields" så läser Thunderbit sidan, rekommenderar de bästa kolumnerna och sätter upp scrapen åt dig.
- Subpage Scraping: Behöver du mer detaljer? Thunderbit kan automatiskt besöka varje undersida (som produkt- eller profilsidor) och fylla på din datatabell.
- Scheduled Scraping: Ställ in och glöm bort. Schemalägg scraping så att det körs regelbundet — perfekt för prisbevakning, lagerkontroller eller återkommande leaduttag.
- Instant Data Scraper Templates: För populära sajter som Amazon, Zillow eller Instagram väljer du bara en mall och exporterar data med ett klick.
- Free Data Export: Ladda ner resultaten som CSV eller Excel, eller skicka dem direkt till Google Sheets, Airtable eller Notion — ingen export bakom betalvägg.
- AI Data Transformation: Sammanfatta, kategorisera, översätt eller omforma data medan du skrapar — AI gör grovjobbet (Thunderbit Blog).
Vem passar det för? Säljteam, e-handelsoperatörer, mäklare, marknadsförare — i princip alla som behöver webbdata men inte vill brottas med kod eller sköra, gamla scrapers.
Det jag gillar mest: Thunderbit anpassar sig till ändringar på sajter (inga fler trasiga skript), hanterar sidor med mycket JavaScript och gör scraping lika enkelt som att beställa takeout. Dessutom är det gratis att prova, och betalplanerna börjar på bara 9 dollar per månad (Thunderbit Pricing). Om du vill se det i praktiken, kolla in Thunderbit Chrome Extension eller läs fler tips på Thunderbit Blog.
Prova Thunderbit AI Web Scraper gratis
Selenium: det klassiska ramverket för webbläsarautomatisering
Selenium är webbläsarautomatiseringens urfader — tänk schweizisk armékniv för utvecklare och QA-ingenjörer. Det är open source, stöder alla stora webbläsare och låter dig skriva skript i Java, Python, C#, JavaScript och mer.
Styrkor:
- Fungerar i flera webbläsare och på flera plattformar: Fungerar överallt, integreras med CI/CD och är ryggraden i många automatiserade testsviter.
- Mogen ekosystem: Massor av plugins, molnbaserade grid-leverantörer och starkt community-stöd.
- Gratis och open source: Inga licensavgifter.
Begränsningar: Kräver programmeringskunskap, kan vara lite pilligt att underhålla (särskilt när webbplatser ändras) och är inte det snabbaste valet för riktigt stora scrapingjobb. Men är du utvecklare eller QA-proffs är Selenium fortfarande ett verktyg du bör kunna.
Puppeteer: headless webbläsarautomatisering för web scraping
Puppeteer, från Google, är ett Node.js-bibliotek som styr Chrome eller Chromium — som standard headless. Det är en favorit bland utvecklare som vill automatisera Chrome, skrapa dynamiskt innehåll eller skapa PDF:er och skärmdumpar.
Styrkor:
- Modernt JavaScript-API: Enkelt att skriva skript för komplexa webbläsaruppgifter.
- Headless-läge: Snabbt och resurssnålt för scraping eller testning.
- Bra för dynamiska sajter: Hanterar JavaScript-tunga sidor utan problem.
Begränsningar: Primärt för JavaScript-/Node.js-användare och fokuserar på Chrome/Chromium (Firefox-stödet blir bättre). Behöver du Safari eller Edge, titta på Playwright.
Playwright: webbläsarautomatisering för moderna webbappar över flera webbläsare
Playwright, från Microsoft, är det nya namnet med riktigt starka meriter. Det stöder Chromium, Firefox och WebKit (Safaris motor) via ett enda API, och fungerar i JavaScript, Python, Java och .NET.

Styrkor:
- Äkta automatisering över flera webbläsare: Ett skript, alla webbläsare.
- Auto-wait och hög stabilitet: Minskar instabila tester och scrapingfel.
- Bra felsökningsverktyg: Inspector, trace viewer och codegen.
Begränsningar: Något nyare ekosystem än Selenium, men det tar snabbt igen försprånget. Om du startar ett nytt projekt är Playwright ett riktigt starkt val.
Cypress: smidig webbautomatisering och testning
Cypress är ett utvecklarvänligt verktyg för end-to-end-testning byggt för moderna webbappar. Det kör tester i själva webbläsaren, erbjuder felsökning i realtid och är mycket uppskattat av frontend-team.
Styrkor:
- Allt-i-ett testkörning: Visuellt, interaktivt och snabbt.
- Automatiska väntetider: Färre fladdriga tester och mindre behov av manuell timingkod.
- Perfekt för SPA:er: Hanterar asynkt beteende smidigt.
Begränsningar: Har historiskt varit fokuserat på Chrome (men stöder nu Firefox/WebKit), och är inte byggt för scraping eller arbetsflöden med flera flikar. Bäst för att testa dina egna appar, inte för att skrapa tredjepartssajter.
No-code- och low-code-verktyg för webbläsarautomatisering
Browserflow
Browserflow är ett Chrome-tillägg som låter dig bygga automatiseringsflöden visuellt — ingen kod behövs. Klicka runt, spela in dina steg, justera och automatisera uppgifter som scraping, formulärifyllning eller datainmatning.
Höjdpunkter:
- Visuell flödesbyggare: Dra och släpp steg, lägg till loopar eller villkor.
- Google Sheets-integration: Exportera data direkt till Sheets.
- Molnschemaläggning: Kör flöden enligt schema (betalda planer).
Perfekt för icke-tekniska användare som vill automatisera repetitiva webbmoment utan att behöva störa IT.
Axiom.ai
Axiom.ai är ett annat no-code-verktyg för Chrome med fokus på affärsprocessautomatisering (Axiom.ai Pricing). Bygg bottar steg för steg, integrera med Google Sheets, API:er och till och med Zapier.
Höjdpunkter:
- Bot-byggare: Sätt ihop åtgärder visuellt.
- Förbyggda mallar: Kom igång snabbt med vanliga arbetsflöden.
- Molnschemaläggning och integrationer: Automatisera mellan webbappar.
Bra för operations-team eller alla som vill automatisera dataöverföringar och webbuppgifter utan att skriva kod.
UI Vision, Browser Automation Studio, TagUI
- UI Vision: Open source-webbläsartillägg med kommandon i stil med Selenium IDE och visuell automatisering (bildigenkänning, OCR). Gratis, plattformsoberoende och kan även automatisera desktop-appar.
- Browser Automation Studio: Windows-app med visuell scripting-IDE, multitrådning och möjlighet att kompilera fristående bottar. Kraftfullt, men med brantare inlärningskurva.
- TagUI: Open source-RPA-verktyg via kommandorad som låter dig skriva automationsskript på enkel engelska (eller andra språk). Perfekt för tekniskt vana användare som vill ha en gratis och flexibel lösning.
RPA-verktyg i enterprise-klass
UiPath
UiPath är en tung RPA-plattform för att automatisera allt från webbläsaruppgifter till desktop-appar. Visuell workflow-designer, AI-baserad datorseende och robust orkestrering gör det till en favorit i stora organisationer.
Styrkor: Skalar för företag, starkt community, stöder både övervakad och oövervakad automatisering.
Begränsningar: Dyrt, och avancerade funktioner har en inlärningskurva. Bäst för företag med stora automationsambitioner.
Automation Anywhere
Automation Anywhere är en annan ledande RPA-svit med moln-först-automatisering, en visuell botbyggare och starka integrationer med affärsappar (Automation Anywhere Pricing).
Styrkor: Användarvänlig, molnbaserad, bra för automatisering både i front office och back office.
Begränsningar: Liknande kostnad och komplexitet som UiPath, men ett stabilt val för företag.
Microsoft Power Automate
Om du redan är i Microsofts ekosystem ger Power Automate webb- och desktopautomatisering till Office 365-användare (Microsoft Power Automate Pricing).
Styrkor: Tät integration med Microsofts appar, prisvärt för befintliga kunder och enkelt för affärsanvändare.
Begränsningar: Mer Windows-centrerat, mindre moget för avancerade RPA-funktioner, men utvecklas snabbt.
BrowserStack Automate
BrowserStack Automate är inte en skriptbyggare — det är en molnplattform för att köra dina Selenium-, Playwright- eller Cypress-skript på tusentals kombinationer av webbläsare och enheter (BrowserStack Pricing).
Styrkor: Enorm täckning, parallell testkörning, ingen infrastruktur att underhålla.
Begränsningar: Inte för att bygga automatisering, men oumbärligt för testning över flera webbläsare i stor skala.
Så väljer du det bästa verktyget för webbläsarautomatisering för dina behov
Jämför de bästa verktygen för web scraping Get Started Free
Att välja rätt verktyg kan kännas som att välja ny mobil — alla har en åsikt, och det beror på vad du faktiskt behöver. Så här skulle jag gå till väga steg för steg:
- Definiera målet: Ska du skrapa data, automatisera affärsprocesser eller testa webbappar?
- Utvärdera teamets kompetens: Utvecklare? Välj kodbaserade verktyg. Affärsanvändare? Kör no-code eller AI-drivna verktyg som Thunderbit.
- Bedöm komplexiteten: Enkel scraping? Testa Thunderbit eller Browserflow. Komplexa arbetsflöden mellan flera appar? Titta på UiPath eller Power Automate.
- Kolla webbläsarkompatibilitet: Behöver du stöd för flera webbläsare? Playwright eller Selenium. Räcker Chrome? Puppeteer, Cypress eller de flesta no-code-verktyg.
- Tänk på skala: För riktigt stora jobb fungerar kodbaserade verktyg eller enterprise-RPA bäst. För medelstora behov räcker ofta webbläsartillägg gott.
- Budget: Open source-verktyg är gratis men kräver mer konfiguration. No-code- och AI-verktyg är prisvärda för små och medelstora företag. RPA-sviter är en investering.
Här är en snabb jämförelse:
| Verktygskategori | Användarvänlighet | Funktioner och kraft | Ideala användare |
|---|---|---|---|
| Kodbaserade ramverk | Brant inlärning | Maximal flexibilitet | Utvecklare, QA-ingenjörer |
| No-code-verktyg | Mycket enkelt | Medelhög komplexitet | Affärsanvändare, analytiker |
| Enterprise-RPA | Medel (utbildning behövs) | End-to-end-automatisering | Stora organisationer, RPA-team |
| AI-drivna verktyg | Enklast | Smart, anpassningsbar scraping | Sälj, drift, icke-tekniska användare |
Framtida trender inom webbläsarautomatisering, web scraping och AI Web Scraper-teknik
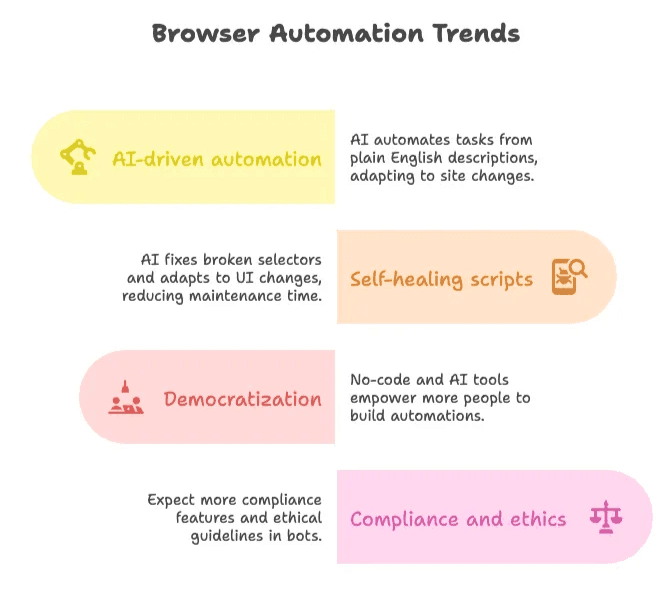
- AI-driven automatisering: Verktyg som Thunderbit leder utvecklingen genom att låta användare beskriva uppgifter på vanligt språk och anpassa sig automatiskt när sajter ändras (Thunderbit Blog).
- Självläkande skript: AI kan nu fixa trasiga selektorer och anpassa sig till UI-förändringar, vilket kan minska underhållstiden med upp till 50 % (lambdatest.com Pricing).
- Demokratisering: Fler "citizen developers" bygger egna automatiseringar tack vare no-code- och AI-verktyg (firecrawl.dev Pricing).
- Efterlevnad och etik: När bottar blir vanligare kan vi räkna med fler inbyggda funktioner för regelefterlevnad och tydligare etiska riktlinjer (browsercat.com Pricing).
Kort sagt: webbläsarautomatisering blir bara kraftfullare och enklare att använda. Om du inte automatiserar än, går du miste om både tid och pengar.
Slutsats: växla upp verksamheten med rätt verktyg för webbläsarautomatisering
Webbläsarautomatisering är inte bara en tekniktrend — det är ryggraden i moderna, datadrivna företag. Oavsett om du driver bolaget själv eller sitter på ett Fortune 500-företag kan rätt verktyg spara timmar, öka precisionen och öppna dörrar till insikter du inte trodde var möjliga.
Mitt råd? Börja i liten skala. Välj ett verktyg från listan — om du vill ha den enklaste och mest träffsäkra web scraping utan kod är Thunderbit ett fantastiskt ställe att börja på. Testa det på en verklig uppgift, se ROI:n med egna ögon och skala sedan upp i takt med att du växer.
Och kom ihåg: framtiden tillhör dem som automatiserar. Så plocka upp din digitala assistent, säg adjö till tråkigt webbjobb och låt oss komma tillbaka till det roliga.
Börja automatisera med Thunderbit
Vanliga frågor
-
Vad är skillnaden mellan webbläsarautomatisering, web scraping och webbautomatisering?
Webbläsarautomatisering efterliknar mänskliga handlingar i en webbläsare — klick, scroll och ifyllning av formulär. Web scraping fokuserar på att extrahera strukturerad data (som tabeller) från webbplatser. Webbautomatisering är den bredare kategorin som omfattar båda och täcker alla uppgifter som automatiseras via en webbläsare — till exempel formulärinlämning, datainsamling eller hela arbetsflöden.
-
Varför investerar företag i webbläsarautomatisering?
För att det sparar tid, minskar fel och förbättrar resultat. Säljteam skrapar leads, e-handlare bevakar priser och driftsteam automatiserar datainmatning. Studier visar 30–200 % ROI redan första året, och 65 % av företagen använder webbdata för att driva AI- och analysprojekt.
-
Jag är inte utvecklare — kan jag ändå skrapa webbplatser?
Ja! Verktyg som Thunderbit är byggda för dig som inte kodar. Installera bara Chrome-tillägget, klicka på "AI Suggest Fields" så skrapar Thunderbit strukturerad data åt dig — även från dynamiska sidor. Det är snabbt, träffsäkert och gratis att prova. Perfekt för sälj-, e-handels- och researchteam.
Läs mer:



